Una propuesta, no una ejecución
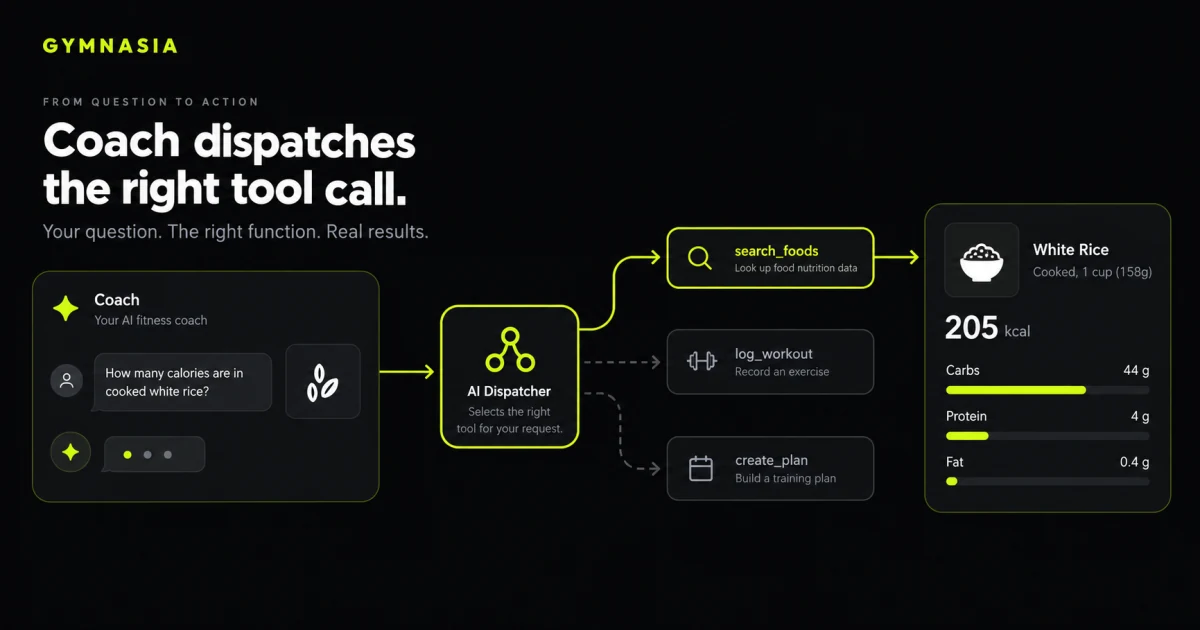
Imagina que una persona pregunta: «¿Cuántos carbohidratos tiene el arroz?». El modelo puede proponer una tool call: search_foods con el argumento {"query":"arroz"}. Esa salida es datos del proveedor, no una llamada directa a una función de la app. El modelo todavía no sabe qué arroces hay en el catálogo ni cuántos carbohidratos tiene cada uno: necesita que la app haga la búsqueda.
El harness es el programa que recibe esa propuesta, decide si la acepta y conecta el nombre con una función local. El identificador de la llamada se conserva aparte para asociar después el resultado con la petición correcta. OpenAI, Anthropic y Google usan formatos distintos para transportar la tool call, pero una vez parseada, el despachador trabaja con el mismo par: name y args.
El recorrido completo
Para responder sobre el arroz, la app comprueba primero que search_foods sea una tool declarada y que la búsqueda esté permitida. Después, el registro entrega la llamada a la función de búsqueda. Esta consulta solo lee el catálogo: devuelve las fichas que coincidan con «arroz», incluidos sus carbohidratos por 100 g, y no modifica la dieta de la persona.
Elegir la función correcta
Un registro es una lista cerrada que relaciona cada nombre de tool con una función de la aplicación. En nuestra pregunta sobre el arroz, el despachador recibe search_foods, encuentra ese nombre en la lista y ejecuta la función que busca alimentos. El registro no elige una variedad de arroz ni calcula sus carbohidratos: solo decide qué función debe atender la petición. Si el nombre no está en la lista, no ejecuta ninguna función. La lista permanece fija durante el turno, así que un mismo nombre siempre lleva a la misma acción.
En el artículo sobre cómo definir las tools vimos que cada una se presenta al LLM con name, description e inputSchema. Para search_foods, esa información ayuda al modelo a enviar «arroz» como texto en query. Pero describir el argumento esperado no garantiza que el modelo lo envíe bien. El despachador busca el name y pasa los argumentos a la función elegida; no corrige un argumento erróneo. Por ejemplo, antes de añadir arroz a una comida, esa función comprueba que el alimento exista y que los gramos sean válidos.
Errores y efectos
Si el modelo escribe mal el nombre y pide search_foodz, el despachador indica que no reconoce esa tool y no ejecuta nada. Si pide search_foods pero la búsqueda no encuentra arroz, el resultado lo dice. Si el catálogo no está disponible, el resultado también informa de esa situación: «no encuentro arroz» y «no puedo consultar el catálogo» no significan lo mismo. Ninguno de esos casos permite inventar una cifra de carbohidratos.
Un fallo al ejecutar una función es otro caso. Por ejemplo, si se intenta añadir arroz a una comida y falla el acceso al almacenamiento, el despachador devuelve un error controlado al modelo para que explique que no se pudo confirmar el guardado, sin romper toda la conversación.
Una consulta termina al devolver el dato encontrado o informar de que no se pudo obtener. Una escritura exige comprobar el efecto: si la persona pide añadir arroz a una comida, no basta con haber llamado a la función; la app solo debe comunicar éxito cuando el alimento se haya guardado. Si no puede determinar si se guardó, no repite la operación automáticamente, porque podría añadirlo dos veces.
el modelo propone la acción; el código de la aplicación decide la autorización, ejecuta el handler y comprueba el resultado. El nombre de la tool nunca concede permiso por sí solo.
Devolver el resultado
Supongamos que search_foods devuelve la ficha «Arroz blanco (cocido)», que en el catálogo indica 28 g de carbohidratos por 100 g. La app envía ese resultado al modelo junto con el identificador de la tool call original, para que sepa a qué búsqueda corresponde. Solo entonces puede contestar: «El arroz blanco cocido del catálogo tiene 28 g de carbohidratos por 100 g». Si aparecen varias variedades de arroz, debe distinguirlas; si no hay resultados, debe decirlo en vez de inventar una cifra.
Cada proveedor tiene su formato para devolver el resultado: function_call_output en OpenAI, tool_result en Anthropic y function_result en Google Interactions. Después de enviarlo, la app pide al modelo que continúe y redacte la respuesta para la persona.
Tests del contrato
Para probar el despachador sin depender de un LLM remoto, los tests simulan sus tool calls. Una prueba envía search_foods con {"query":"Arroz"} y comprueba que la función de búsqueda devuelva el arroz de los datos de prueba. Otras llamadas comprueban el resto de nombres publicados. También se compara esa lista con la de handlers: si se anuncia una tool sin código que la ejecute, el test falla.
Después prueban nombres desconocidos y verifican que no se produzca ninguna escritura. Por último, repiten cada caso con datos de partida independientes: la misma llamada debe seguir la misma ruta y producir el mismo resultado. Así se detectan cambios accidentales en el despachador sin esperar a que un modelo elija la tool durante una conversación real.
Aprender a construir un agente completo
Este artículo forma parte de una serie sobre cómo construir un agente o harness usando una app de gimnasio como caso práctico. El paso anterior fue reconstruir una llamada completa desde el stream; aquí vimos dónde se transforma en código. El siguiente límite es validar sistemáticamente los argumentos antes de cualquier efecto.
Ver el índice completo de la serie sobre el agente de Gymnasia.