Un reintento, dos arroces
El usuario escribe «Apunta 150 g de arroz en la comida de hoy». Coach responde que ya está. El usuario abre su diario y el arroz aparece dos veces: 300 g y el doble de calorías en el total del día.
Nadie pidió dos raciones y el modelo no se equivocó al interpretar la frase. La conexión con el proveedor se cortó a mitad del turno, la app reintentó la petición y, al hacerlo, repitió un guardado que ya había ocurrido.
Una operación es idempotente cuando ejecutarla una vez o varias deja el mismo resultado. Consultar el diario lo es por naturaleza. Añadir un alimento no: cada ejecución suma otra fila. Este artículo explica cómo conseguir que una tool con efectos se comporte como si fuera idempotente, aunque el turno se reintente entero.
Es un ejemplo ilustrativo construido sobre la tool real de Gymnasia que añade alimentos. La prueba automática que lo protege, descrita al final, usa otra tool con efectos: la que registra una sugerencia del usuario.
Quién pide, quién ejecuta y dónde se corta
Para ver dónde se duplica el arroz hay que seguir el turno en orden. El modelo no ejecuta nada: propone una tool call, una petición con el nombre de la función y sus argumentos. El harness, dentro de la app, la valida, la ejecuta sobre los datos locales y envía el resultado al modelo en una segunda petición al proveedor.
- El modelo pide añadir el alimento.
Primera respuesta del proveedor: una tool call con arroz, 150 g y la comida.
- El harness guarda el arroz.
Acción local: el diario ya tiene la fila.
- El harness envía el resultado al modelo.
Segunda petición al proveedor. Aquí falla la red.
- La app reintenta el turno entero.
El modelo vuelve a leer el mensaje del usuario y vuelve a pedir la tool.
Gymnasia reintenta hasta tres veces. No puede retomar la conversación en el paso tres, porque la respuesta interrumpida no se conserva, así que repite el turno desde el mensaje del usuario. Si nada lo impide, el paso dos se ejecuta otra vez.
Reintentar es correcto: las redes fallan y el usuario espera una respuesta. El defecto está en que el harness no distingue entre «me piden una acción nueva» y «me piden otra vez la acción que ya hice».
Por qué no basta el identificador del proveedor
Los tres proveedores asignan un identificador a cada tool call. Sirve para que el modelo asocie cada resultado con su petición: call_id en OpenAI, el id del bloque tool_use en Anthropic y el id de la llamada en Google.
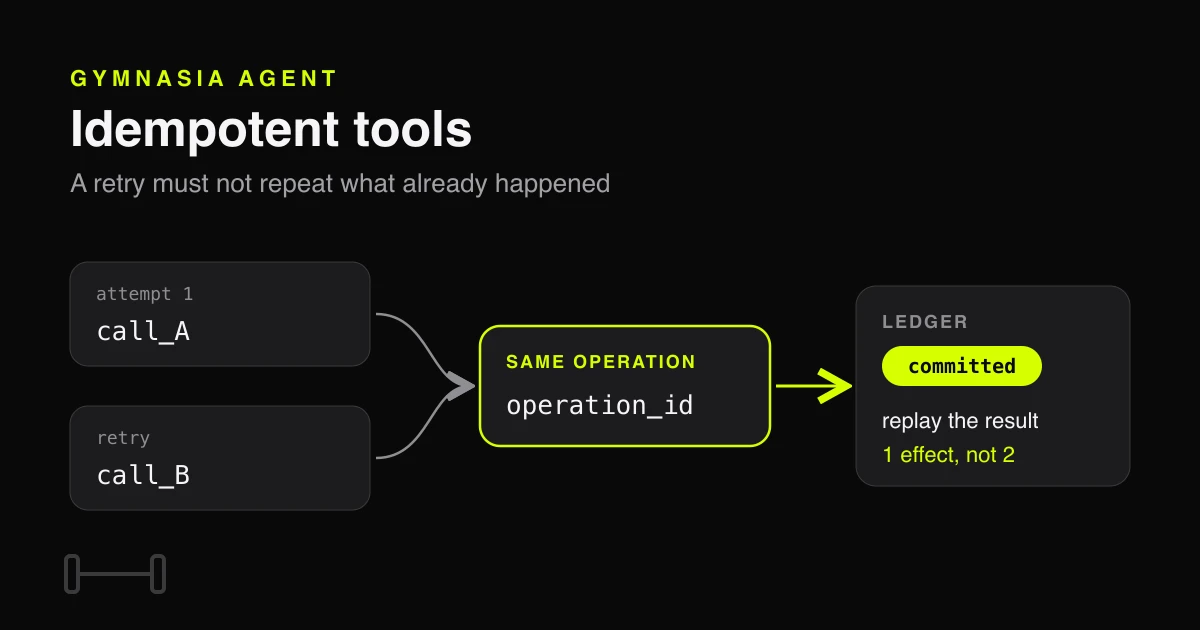
La idea obvia es guardar los identificadores ya ejecutados y saltarse los conocidos. No funciona con este fallo. En el reintento, el modelo genera una respuesta nueva y su tool call trae un identificador nuevo. Para el proveedor son dos llamadas distintas; para el usuario, la misma acción.
| Intento | Identificador del proveedor | Lo que pide |
|---|---|---|
| Primero | call_A | Añadir 150 g de arroz a la comida de hoy |
| Reintento | call_B | Añadir 150 g de arroz a la comida de hoy |
La conclusión es que la identidad de la operación no puede venir del proveedor. Tiene que construirla el harness con datos que no cambien entre un intento y el siguiente.
Una identidad que sobrevive al reintento
Entre el primer intento y el reintento se mantienen estas piezas:
- El mensaje del usuario que originó el turno.
Cada mensaje tiene su propio identificador en la app, y el reintento reutiliza el mismo.
- El proveedor y la tool.
Qué API respondió y qué función se pide ejecutar.
- Los argumentos, normalizados.
Se ordenan las claves antes de compararlos, para que
{grams, food}y{food, grams}cuenten igual. - La ocurrencia dentro del turno.
Cuántas veces se ha pedido ya esa misma tool con esos mismos argumentos en este turno.
La ocurrencia existe porque a veces repetir es legítimo. «Apunta un huevo en el desayuno y otro en la cena» produce dos llamadas con argumentos distintos, porque cambia la comida. Pero si en un turno el modelo pide dos veces exactamente lo mismo, la primera es la ocurrencia 0 y la segunda la 1: dos operaciones. En el reintento vuelven a salir la 0 y la 1, y cada una se reconoce.
operation_id = hash(
  user_message_id,
  provider,
  tool_name,
  arguments_with_sorted_keys,
  occurrence_in_this_turn
)
Fíjate en lo que no aparece: el identificador de la tool call del proveedor. Si el reintento produce la misma petición, produce el mismo operation_id, aunque el proveedor la haya rebautizado de call_A a call_B.
Apuntar antes de hacer, confirmar después
Con una identidad estable falta recordar qué se hizo. Para eso sirve un registro de operaciones, guardado en el almacenamiento persistente de la app para que sobreviva a cerrarla. Cada operación con efectos pasa por estados:
preparada
Se apunta antes de ejecutar la tool: «voy a hacer esto».
confirmada
El efecto se aplicó. Se guarda también el resultado que recibió el modelo.
indeterminada
No se puede demostrar si el efecto ocurrió. La sección siguiente explica qué hacer.
El orden importa. Si la operación se apuntara después de ejecutarla, un cierre de la app entre ambos pasos dejaría un efecto aplicado sin rastro. Apuntándola antes, al menos se sabe que estaba en marcha.
if ledger[operation_id] is committed:
    return ledger[operation_id].result   # replay, do not execute

mark operation_id as prepared
result = execute_tool()
mark operation_id as committed with result
return result
Cuando llega el reintento del arroz, la identidad coincide y el registro dice «confirmada». El harness no vuelve a ejecutar la tool: envía al modelo el mismo resultado de la primera vez, el modelo escribe su respuesta y el diario conserva una sola fila.
Devolver el resultado guardado importa tanto como no ejecutar. Si el harness respondiera «ya estaba hecho», el modelo recibiría algo distinto de lo que vio en el primer intento y podría contestar otra cosa.
El registro no crece sin límite. En Gymnasia, cada entrada caduca a los siete días y caben como máximo 256. Cuando hay que hacer sitio solo se eliminan las confirmadas más antiguas, nunca una que está a medias.
Cuando no se sabe si el efecto ocurrió
El caso difícil es el hueco entre «preparada» y «confirmada». Si la app se cierra justo ahí, al volver encuentra una operación preparada y no sabe si el arroz llegó a guardarse. Hay dos defensas que se complementan.
- Que el propio dato lleve la identidad.
El alimento no recibe un identificador aleatorio, sino uno derivado de
operation_id. Si la tool se ejecuta otra vez, encuentra un alimento con ese identificador y no añade nada. Es una segunda red, en los datos, por si falla la del registro. - Preguntar a los datos antes de repetir.
Antes de ejecutar una operación pendiente, el harness comprueba si su efecto ya está. Si lo encuentra, la marca como confirmada sin ejecutarla. Al arrancar, la app hace lo mismo con todas las operaciones que quedaron a medias.
Esa comprobación tiene tres desenlaces:
Está
El efecto se encuentra en los datos. La operación pasa a confirmada y no se repite.
No está, y se puede demostrar
No hubo efecto. La operación puede ejecutarse.
No se puede saber
La operación queda indeterminada, no se repite y se avisa al usuario.
En el tercer caso el harness no adivina. Gymnasia muestra este mensaje: «Gymnasia no puede confirmar si la acción llegó a completarse. Para evitar duplicarla, no la ha repetido. Revisa tus datos antes de solicitarla de nuevo». Pedirle al usuario que revise su diario es mejor que meterle un dato falso sin avisar.
También se distingue cuándo falló la tool. Si falla antes de tocar nada, por ejemplo porque los argumentos no son válidos, la operación se borra del registro: no hubo efecto y se puede reintentar sin riesgo. Solo un fallo que puede haber ocurrido después del efecto deja la operación pendiente de comprobar.
Para una tool que escribe fuera del dispositivo, como la que registra sugerencias en un servicio externo, la comprobación consiste en preguntar a ese servicio si ya existe una operación con ese identificador. El patrón es el mismo: el harness necesita una forma de saber si el efecto ocurrió que no dependa de la respuesta que se perdió.
En el post sobre errores de tools esta verificación aparecía como opción de diseño. Aquí ya forma parte del harness, y la decide el programa, no el modelo.
Las lecturas no pagan este coste
Nada de lo anterior se aplica a las tools que solo leen, como «muéstrame mis rutinas» o «busca un ejercicio». Repetir una lectura no cambia nada, así que no se apuntan en el registro ni pagan su escritura extra. Cada tool declara si es de lectura o tiene efectos, y solo las segundas pasan por este mecanismo.
Cómo probar que no hay duplicados
Este fallo depende de cortar la red en un instante concreto, así que probarlo a mano no sirve. Hay que provocarlo a propósito y comprobar el estado final, no solo la respuesta visible.
- Con un proveedor simulado: el modelo falso pide una tool con efectos y el harness la ejecuta. La segunda petición al proveedor devuelve un error y la app reintenta el turno entero. El modelo falso vuelve a pedir la tool, esta vez con otro identificador de llamada, como haría uno real. La prueba comprueba que el efecto existe una sola vez, que el modelo recibió exactamente el mismo resultado en los dos intentos y que los identificadores de llamada eran distintos. Esto último demuestra que la protección no depende del proveedor.
- Sobre la identidad: los mismos argumentos con las claves en cualquier orden producen la misma identidad, y una segunda ocurrencia produce otra distinta. Se comprueba con muchas permutaciones generadas, no con un único ejemplo.
- Sobre el registro: la operación se apunta como preparada antes de ejecutarse, y un reinicio después del efecto no la duplica. Una operación preparada que no se puede comprobar nunca se ejecuta otra vez, y una con ausencia demostrada sí. Un fallo de validación no se memoriza como resultado.
- Sobre los límites: las entradas confirmadas caducan, hay un máximo de entradas y las pendientes nunca se expulsan. Ante colisiones o un registro ilegible, el harness se detiene en vez de ejecutar a ciegas.
Estas pruebas demuestran el comportamiento local del harness. No reproducen un móvil que se queda sin batería en el milisegundo exacto entre guardar y apuntar. Para ese caso existe el estado indeterminado: no promete adivinar, solo no mentir.
Construir un agente, paso a paso
Este artículo pertenece a una serie sobre cómo construir un agente y su harness usando una app de gimnasio como ejemplo. Después de ejecutar tools, devolver sus resultados y recuperarse de errores, queda una garantía más: que reintentar no multiplique los efectos.
El patrón sirve igual para crear un pedido o enviar un correo. Construye la identidad con lo que no cambia entre intentos, apunta la operación antes de ejecutarla y confírmala después con su resultado, y decide de antemano qué hacer cuando no sabes si algo ocurrió.
Consulta el índice de la serie y la implementación de Gymnasia que sirve como caso práctico.