Uma nova tentativa, duas porções de arroz
O usuário escreve "Registre 150 g de arroz no almoço de hoje". O Coach responde que está feito. O usuário abre o diário e o arroz aparece duas vezes: 300 g e o dobro de calorias no total do dia.
Ninguém pediu duas porções e o modelo não interpretou mal a frase. A conexão com o provedor caiu no meio do turno, o app repetiu a requisição e, ao fazer isso, repetiu um salvamento que já tinha acontecido.
Uma operação é idempotente quando executá-la uma ou várias vezes deixa o mesmo resultado. Consultar o diário é idempotente por natureza. Adicionar um alimento não: cada execução soma outra linha. Este artigo explica como fazer uma tool com efeitos se comportar como se fosse idempotente, mesmo quando o turno inteiro é repetido.
É um exemplo ilustrativo construído sobre a tool real do Gymnasia que adiciona alimentos. O teste automático que o protege, descrito no final, usa outra tool com efeitos: a que registra uma sugestão do usuário.
Quem pede, quem executa e onde falha
Para ver onde o arroz se duplica, é preciso seguir o turno em ordem. O modelo não executa nada: propõe uma tool call, um pedido com o nome da função e seus argumentos. O harness, dentro do app, valida o pedido, executa a função sobre os dados locais e envia o resultado ao modelo em uma segunda requisição ao provedor.
- O modelo pede para adicionar o alimento.
Primeira resposta do provedor: uma tool call com arroz, 150 g e a refeição.
- O harness salva o arroz.
Ação local: o diário já tem a linha.
- O harness envia o resultado ao modelo.
Segunda requisição ao provedor. Aqui a rede falha.
- O app repete o turno inteiro.
O modelo lê de novo a mensagem do usuário e pede a tool de novo.
O Gymnasia tenta até três vezes. Ele não consegue retomar a conversa no passo três, porque a resposta interrompida não é guardada, então repete o turno a partir da mensagem do usuário. Se nada impedir, o passo dois é executado outra vez.
Tentar de novo é correto: redes falham e o usuário espera uma resposta. O defeito é que o harness não distingue entre "estão me pedindo uma ação nova" e "estão me pedindo de novo a ação que eu já fiz".
Por que o identificador do provedor não basta
Os três provedores atribuem um identificador a cada tool call. Ele serve para o modelo associar cada resultado ao seu pedido: call_id na OpenAI, o id do bloco tool_use na Anthropic e o id da chamada no Google.
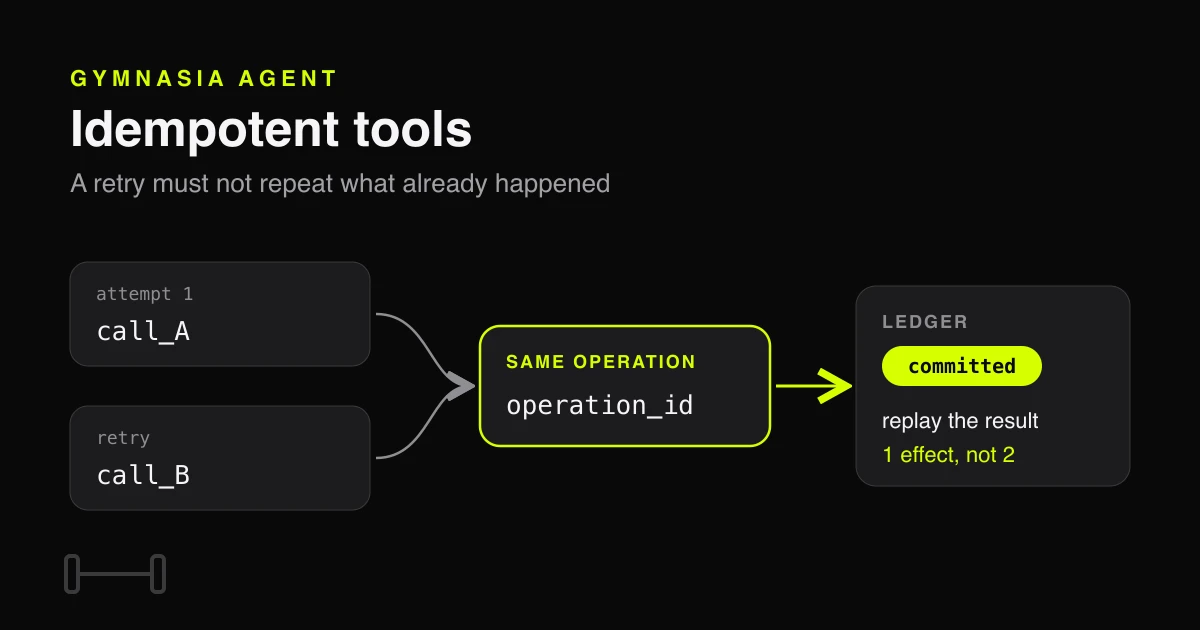
A ideia óbvia é guardar os identificadores já executados e pular os conhecidos. Não funciona com essa falha. Na nova tentativa, o modelo gera uma resposta nova e sua tool call traz um identificador novo. Para o provedor são duas chamadas diferentes; para o usuário, a mesma ação.
| Tentativa | Identificador do provedor | O que pede |
|---|---|---|
| Primeira | call_A | Adicionar 150 g de arroz ao almoço de hoje |
| Nova tentativa | call_B | Adicionar 150 g de arroz ao almoço de hoje |
A conclusão é que a identidade da operação não pode vir do provedor. O harness precisa construí-la com dados que não mudam de uma tentativa para a outra.
Uma identidade que sobrevive à nova tentativa
Entre a primeira tentativa e a nova, estas peças continuam iguais:
- A mensagem do usuário que originou o turno.
Cada mensagem tem seu próprio identificador no app, e a nova tentativa reutiliza o mesmo.
- O provedor e a tool.
Qual API respondeu e qual função se pede para executar.
- Os argumentos, normalizados.
As chaves são ordenadas antes da comparação, para que
{grams, food}e{food, grams}contem como iguais. - A ocorrência dentro do turno.
Quantas vezes essa mesma tool com esses mesmos argumentos já foi pedida neste turno.
A ocorrência existe porque às vezes repetir é legítimo. "Registre um ovo no café da manhã e outro no jantar" produz duas chamadas com argumentos diferentes, porque a refeição muda. Mas, se em um turno o modelo pede duas vezes exatamente a mesma coisa, a primeira é a ocorrência 0 e a segunda a 1: duas operações. Na nova tentativa saem de novo a 0 e a 1, e cada uma é reconhecida.
operation_id = hash(
  user_message_id,
  provider,
  tool_name,
  arguments_with_sorted_keys,
  occurrence_in_this_turn
)
Repare no que não aparece: o identificador da tool call do provedor. Se a nova tentativa produz o mesmo pedido, produz o mesmo operation_id, mesmo que o provedor o tenha rebatizado de call_A para call_B.
Registrar antes de fazer, confirmar depois
Com uma identidade estável, falta lembrar o que foi feito. Para isso serve um registro de operações, guardado no armazenamento persistente do app para sobreviver ao fechamento. Cada operação com efeitos passa por estados:
preparada
É registrada antes de executar a tool: "vou fazer isto".
confirmada
O efeito foi aplicado. O resultado que o modelo recebeu também é guardado.
indeterminada
Não é possível demonstrar se o efeito aconteceu. A próxima seção explica o que fazer.
A ordem importa. Se a operação fosse registrada depois de executada, um fechamento do app entre os dois passos deixaria um efeito aplicado sem rastro. Registrando antes, pelo menos se sabe que ela estava em andamento.
if ledger[operation_id] is committed:
    return ledger[operation_id].result   # replay, do not execute

mark operation_id as prepared
result = execute_tool()
mark operation_id as committed with result
return result
Quando chega a nova tentativa do arroz, a identidade coincide e o registro diz "confirmada". O harness não executa a tool de novo: envia ao modelo o mesmo resultado da primeira vez, o modelo escreve sua resposta e o diário mantém uma única linha.
Devolver o resultado guardado importa tanto quanto não executar. Se o harness respondesse "já estava feito", o modelo receberia algo diferente do que viu na primeira tentativa e poderia responder outra coisa.
O registro não cresce sem limite. No Gymnasia, cada entrada expira em sete dias e cabem no máximo 256. Quando é preciso abrir espaço, só são removidas as confirmadas mais antigas, nunca uma que está pela metade.
Quando não se sabe se o efeito aconteceu
O caso difícil é o intervalo entre "preparada" e "confirmada". Se o app fecha exatamente aí, ao voltar encontra uma operação preparada e não sabe se o arroz chegou a ser salvo. Há duas defesas que se complementam.
- Fazer o próprio dado carregar a identidade.
O alimento não recebe um identificador aleatório, e sim um derivado de
operation_id. Se a tool for executada de novo, encontra um alimento com esse identificador e não adiciona nada. É uma segunda rede de segurança, nos dados, caso a do registro falhe. - Perguntar aos dados antes de repetir.
Antes de executar uma operação pendente, o harness verifica se o efeito já está lá. Se encontrar, marca a operação como confirmada sem executá-la. Ao iniciar, o app faz o mesmo com todas as operações que ficaram pela metade.
Essa verificação tem três desfechos:
Está lá
O efeito é encontrado nos dados. A operação passa a confirmada e não se repete.
Não está, e é possível demonstrar
Não houve efeito. A operação pode ser executada.
Não é possível saber
A operação fica indeterminada, não se repete e o usuário é avisado.
No terceiro caso, o harness não adivinha. O Gymnasia mostra esta mensagem, em espanhol: "O Gymnasia não consegue confirmar se a ação foi concluída. Para evitar duplicá-la, não a repetiu. Revise seus dados antes de pedi-la de novo". Pedir ao usuário que revise o diário é melhor do que inserir um dado falso sem avisar.
Também importa quando a tool falhou. Se ela falha antes de tocar em qualquer coisa, por exemplo porque os argumentos não são válidos, a operação é apagada do registro: não houve efeito e dá para tentar de novo sem risco. Só uma falha que pode ter acontecido depois do efeito deixa a operação pendente de verificação.
Para uma tool que escreve fora do dispositivo, como a que registra sugestões em um serviço externo, a verificação consiste em perguntar a esse serviço se já existe uma operação com esse identificador. O padrão é o mesmo: o harness precisa de uma forma de saber se o efeito aconteceu que não dependa da resposta que se perdeu.
No post sobre erros de tools, essa verificação aparecia como opção de design. Aqui ela já faz parte do harness, e quem decide é o programa, não o modelo.
As leituras não pagam esse custo
Nada disso se aplica às tools que só leem, como "mostre minhas rotinas" ou "busque um exercício". Repetir uma leitura não muda nada, então elas não entram no registro nem pagam sua escrita extra. Cada tool declara se é de leitura ou tem efeitos, e só as segundas passam por esse mecanismo.
Como testar que não há duplicados
Essa falha depende de cortar a rede em um instante exato, então testar à mão não serve. É preciso provocá-la de propósito e verificar o estado final, não só a resposta visível.
- Com um provedor simulado: o modelo falso pede uma tool com efeitos e o harness a executa. A segunda requisição ao provedor devolve um erro e o app repete o turno inteiro. O modelo falso pede a tool de novo, desta vez com outro identificador de chamada, como faria um real. O teste verifica que o efeito existe uma única vez, que o modelo recebeu exatamente o mesmo resultado nas duas tentativas e que os identificadores de chamada eram diferentes. Este último ponto demonstra que a proteção não depende do provedor.
- Sobre a identidade: os mesmos argumentos com as chaves em qualquer ordem produzem a mesma identidade, e uma segunda ocorrência produz outra diferente. Isso é verificado com muitas permutações geradas, não com um único exemplo.
- Sobre o registro: a operação é registrada como preparada antes de ser executada, e um reinício depois do efeito não a duplica. Uma operação preparada que não pode ser verificada nunca é executada de novo, e uma com ausência demonstrada sim. Uma falha de validação não é memorizada como resultado.
- Sobre os limites: as entradas confirmadas expiram, há um máximo de entradas e as pendentes nunca são removidas. Diante de colisões ou de um registro ilegível, o harness para em vez de executar às cegas.
Esses testes demonstram o comportamento local do harness. Eles não reproduzem um celular que fica sem bateria no milissegundo exato entre salvar e registrar. Para esse caso existe o estado indeterminado: ele não promete adivinhar, só não mentir.
Construir um agente, passo a passo
Este artigo pertence a uma série sobre como construir um agente e seu harness usando um app de academia como exemplo. Depois de executar tools, devolver seus resultados e se recuperar de erros, falta mais uma garantia: tentar de novo não pode multiplicar os efeitos.
O padrão serve igualmente para criar um pedido ou enviar um e-mail. Construa a identidade com o que não muda entre tentativas, registre a operação antes de executá-la e confirme-a depois com seu resultado, e decida antecipadamente o que fazer quando não souber se algo aconteceu.
Consulte o índice da série e a implementação do Gymnasia que serve como caso prático.