Empieza varias consultas juntas
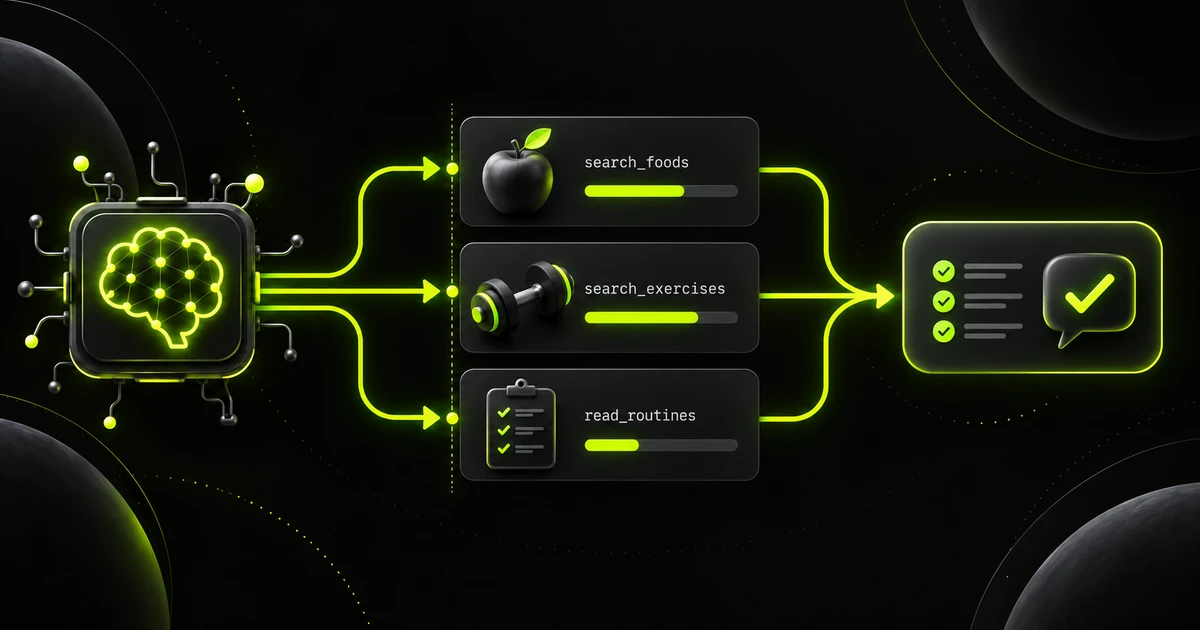
Imagina que el agente necesita consultar alimentos, ejercicios y rutinas para preparar una recomendación. Ya sabe qué buscar en cada caso y ninguna consulta necesita el resultado de las otras. Tu programa puede empezar las tres juntas.
Si cada consulta tarda 300 milisegundos, ejecutarlas una tras otra requiere unos 900 milisegundos. Si las tres pasan la mayor parte de ese tiempo esperando una descarga, empezarlas juntas puede acercar el tiempo total a 300 milisegundos. La idea es aprovechar el tiempo de espera de una consulta para avanzar con las demás.
Una tras otra
Tiempo total: unos 900 ms
Las tres juntas
Tiempo total: unos 300 ms
El modelo puede pedir varias tools en una misma respuesta, pero es tu programa el que las ejecuta. Recibir tres peticiones no basta: el código tiene que empezar las consultas antes de ponerse a esperar sus resultados.
Decide qué puede ejecutarse junto
La primera decisión es distinguir las tools que consultan datos de las que cambian datos. Después comprueba sus dependencias: una consulta puede empezar junto a otra si ya tiene todos sus argumentos y no necesita un resultado ni un cambio pendiente. Define estas reglas en el código; no dependas de que el modelo adivine cuáles son seguras.
Por ejemplo, el agente pide buscar alimentos, buscar ejercicios, guardar un peso y consultar el peso guardado. Podemos organizar esas cuatro operaciones así:
- Buscar alimentos y buscar ejercicios.
Son dos consultas independientes. Empiezan juntas y esperamos a que ambas terminen.
- Guardar un peso de 75 kg.
Ahora cambiamos un dato. Esta operación se ejecuta sola y esperamos a que termine de guardarlo.
- Consultar el peso guardado.
Esta consulta empieza después del guardado, para leer los 75 kg. Adelantarla podría devolver el peso anterior.
También hay que evitar que dos cambios se pisen. Imagina un almacén que guarda la lista completa de alimentos: dos operaciones leen la misma lista vacía; una prepara una lista con una manzana y la otra una lista con un yogur. Si guardan esas listas por separado, el segundo guardado puede borrar lo que añadió el primero. Al ejecutarlas una tras otra, la segunda puede leer la lista que ya contiene la manzana y añadir el yogur.
Gymnasia toma una decisión sencilla: ejecuta todos los cambios uno tras otro, aunque afecten a datos distintos. Una tool que el programa no conoce también espera su turno. Si una acción necesita confirmación del usuario, espera esa decisión y la finalización de la acción antes de continuar. Y una consulta posterior debe leer el dato actualizado, en lugar de reutilizar una copia anterior al guardado.
Cómo implementarlo, paso a paso
Necesitas un componente que reciba las peticiones del modelo y decida cuándo empezar cada una. Puedes construirlo con estas reglas:
- Declara qué hace cada tool.
Indica si consulta o modifica datos y qué condiciones permiten ejecutarla junto a otras.
- Prepara cada petición.
Comprueba los datos de entrada de la tool, por ejemplo que una búsqueda incluya el texto que debe buscar. Conserva también el identificador que viene con la petición del LLM. Cuando la tool termine, enviarás su resultado de nuevo al LLM junto a ese identificador, para que el modelo sepa a qué petición corresponde.
- Pon un límite a las consultas activas.
Gymnasia permite hasta cuatro. Si llega una quinta, espera a que termine alguna. Es un punto de partida que debes ajustar con mediciones, no una cifra óptima para todas las apps.
- Respeta los cambios de datos.
Recorre las peticiones en su orden original. Antes de modificar un dato, espera todas las consultas anteriores. Termina ese cambio antes de empezar las siguientes peticiones.
- Recoge los resultados.
Cuando terminen las tools, reúne sus resultados y envíaselos al LLM para que continúe la conversación y prepare la respuesta al usuario. En esta implementación los enviamos en el orden de las peticiones originales y cada uno conserva su identificador. Así el modelo distingue el resultado de buscar alimentos del resultado de buscar ejercicios.
Este pseudocódigo muestra la decisión central. Un «hueco» es simplemente permiso para iniciar otra consulta sin superar el límite:
for each call in the order requested:
    if the call can run independently:
        wait until a read slot is free
        start the call; save its result or error with its label
    else:
        wait for all running calls
        run this call on its own and wait for it to finish
        save its result or error with its label

wait for all running calls
send every result or error to the LLM in request order, with its label
Así, varias consultas consecutivas pueden empezar juntas, pero ninguna se adelanta a un cambio anterior. Decide también cómo representar los errores: si una consulta falla, conserva ese error junto a su petición sin perder las respuestas de las demás. Si el fallo obliga a detener el turno, deja de iniciar operaciones y espera las que ya empezaron. Evita repetir automáticamente un cambio cuando no sabes si llegó a guardarse.
Relaciona cada respuesta con su petición
Supongamos que el LLM pide estas consultas: A busca alimentos, B busca ejercicios y C consulta rutinas. Puede que C termine primero. Su resultado sigue correspondiendo a la consulta de rutinas, aunque sea el primero que recibe tu programa.
Tu programa guarda cada resultado con el identificador de su petición en cuanto llega. Cuando todas las consultas han terminado, prepara el siguiente mensaje al LLM con A y sus alimentos, B y sus ejercicios, y C y sus rutinas. El modelo puede usar esos datos para continuar la conversación y redactar la respuesta que verá el usuario.
La etiqueta conecta la petición del LLM con el resultado de la tool; no es un número que deba ver el usuario. Conserva el identificador que viene con cada petición. El nombre de la tool no basta: el LLM podría pedir dos búsquedas de alimentos distintas en el mismo turno.
Tests para comprobar que el patrón funciona
Primero prueba el componente que decide cuándo ejecutar las tools usando funciones de prueba: tú controlas cuándo empiezan, cuándo terminan y qué devuelven. Así compruebas las reglas sin depender de una conexión ni de un modelo real. Incluye estos casos:
- Las consultas independientes empiezan juntas.
Deja dos consultas esperando y comprueba que ambas han empezado antes de permitir que termine ninguna. Esto demuestra que la segunda no espera a la primera.
- El límite de operaciones se respeta.
Con un límite de cuatro, prepara cinco consultas. Comprueba que empiezan cuatro, que la quinta espera y que puede empezar cuando termina una de las anteriores.
- Guardar termina antes de consultar el dato nuevo.
Usa el ejemplo de las dos búsquedas, el guardado de 75 kg y la lectura del peso. El guardado espera a las búsquedas; la lectura espera al guardado y devuelve 75 kg.
- Los resultados vuelven a la petición correcta del LLM.
Haz que las consultas terminen C, A y B. Comprueba que el mensaje enviado al LLM contiene A con alimentos, B con ejercicios y C con rutinas, en ese orden y con sus identificadores originales.
- Un error no hace desaparecer los demás resultados.
Haz que una consulta falle y que otras dos terminen bien. Si ese error permite continuar, el LLM debe recibir los dos resultados y el error asociado a la petición que falló. Prueba aparte que un fallo que obliga a detener el turno impide iniciar más operaciones.
- Dos cambios conservan lo que guardó el anterior.
Añade una manzana y después un yogur. Vuelve a leer la lista guardada y comprueba que contiene ambos. El test verifica los datos que quedaron guardados, además del orden de las operaciones.
Después prueba el recorrido completo con un LLM simulado: entrega las peticiones A, B y C, ejecuta las tools y comprueba el siguiente mensaje que tu programa enviaría al modelo. Debe contener los resultados correctos, sus identificadores y el orden elegido. Esta prueba comprueba que la planificación y el envío al LLM encajan; medir solo la velocidad no detectaría un resultado asociado a la petición equivocada.
También funciona en un móvil
Un móvil puede iniciar varias descargas mientras espera sus respuestas. Esta técnica aprovecha esas esperas; no distribuye por sí sola los cálculos locales entre varios núcleos. Si las tools hacen mucho cálculo, iniciarlas juntas no garantiza una mejora. Mide en el dispositivo y con la conexión que usará tu app.
Comprueba la mejora y los resultados
Compara las mismas consultas antes y después del cambio. Para saber qué aporta esta implementación, mide desde que empiezan las tools hasta que están disponibles sus resultados. Mide aparte el tiempo que tarda el modelo en generar la respuesta final.
Repite la comparación cuando la app necesita descargar los datos y cuando ya los tiene guardados. La mejora puede ser grande en el primer caso y pequeña en el segundo. Usa varias ejecuciones, no una sola, y compara el tiempo típico y los casos más lentos.
Comprueba además que cada respuesta conserva su petición, que una lectura posterior al guardado devuelve el dato nuevo, que nunca se supera el límite de operaciones activas y que los errores no hacen desaparecer otros resultados. La velocidad solo es útil si la app sigue dando respuestas correctas.
Un ejemplo medido en Gymnasia
Comparamos tres búsquedas de ejercicios en la versión web de Gymnasia. Un modelo simulado entregaba siempre las mismas peticiones y cada descarga de datos de búsqueda tenía una espera controlada. Cuando esos datos aún debían descargarse, el tiempo mediano bajó de unos 696 a 264 milisegundos.
La medición incluía recibir las peticiones, ejecutar las búsquedas y preparar sus resultados para continuar la conversación. No incluía la generación de una respuesta por un modelo real. Es una comparación controlada en web; la mejora en un móvil todavía requiere medirla en el dispositivo. Método y resultados completos.
Una pieza del agente que estamos construyendo
En la serie usamos una app de gimnasio para explicar cómo construir un agente que consulta y modifica datos. Ejecutar tools en paralelo añade una decisión al programa que lo controla: qué puede empezar junto y qué debe esperar. Puedes aplicar el mismo patrón a otros agentes, conservando el límite de operaciones y la relación entre cada petición y su respuesta.
Sigue la serie sobre cómo construir un agente con Gymnasia. Si quieres ver la implementación concreta de este ejemplo, consulta el cambio de código y sus pruebas.