Inicie várias consultas juntas
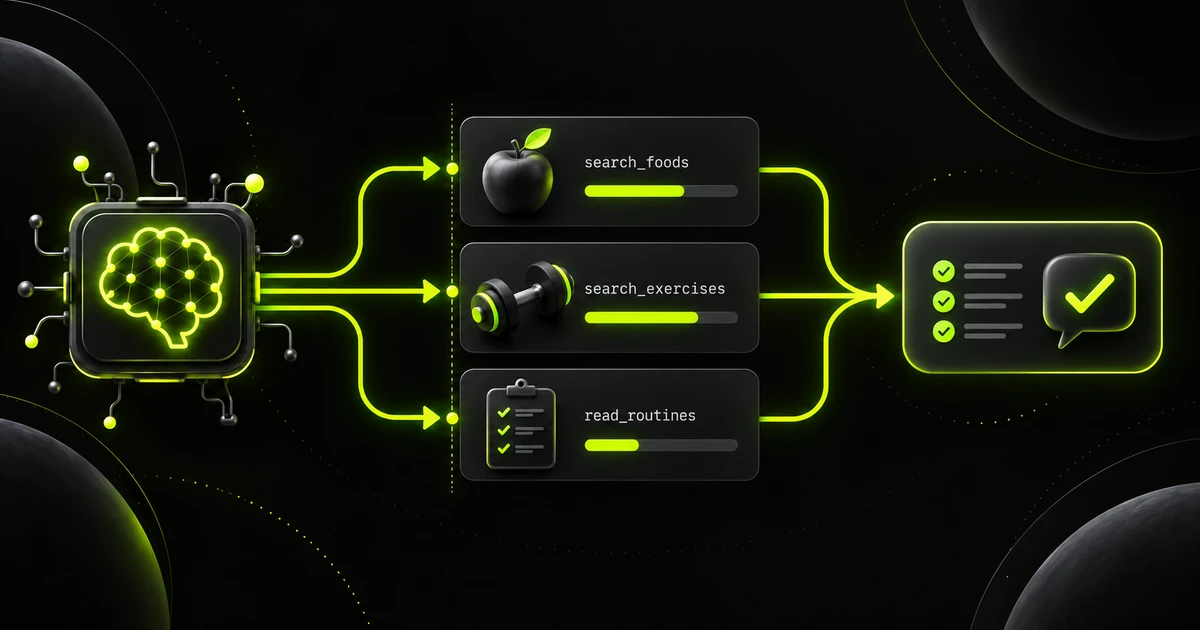
Imagine que o agente precisa consultar alimentos, exercícios e rotinas de treino para preparar uma recomendação. Ele já sabe o que buscar em cada caso, e nenhuma consulta precisa do resultado das outras. Seu programa pode iniciar as três juntas.
Se cada consulta demora 300 milissegundos, executá-las uma após a outra leva cerca de 900 milissegundos. Se elas passam a maior parte desse tempo esperando um download, iniciá-las juntas pode aproximar o tempo total de 300 milissegundos. A ideia é aproveitar a espera de uma consulta para avançar com as demais.
Uma após a outra
Tempo total: cerca de 900 ms
As três juntas
Tempo total: cerca de 300 ms
O modelo pode solicitar várias tools em uma única resposta, mas é o seu programa que as executa. Receber três solicitações não basta: o código precisa iniciar as consultas antes de começar a esperar seus resultados.
Decida o que pode rodar junto
A primeira decisão é distinguir as tools que consultam dados das que alteram dados. Depois verifique suas dependências: uma consulta pode começar junto a outra se já tem todos os argumentos e não precisa de um resultado ou de uma alteração pendente. Defina essas regras no código; não dependa de o modelo adivinhar quais chamadas são seguras.
Por exemplo, o agente solicita buscar alimentos, buscar exercícios, salvar um peso e consultar o peso salvo. Podemos organizar essas quatro operações assim:
- Buscar alimentos e buscar exercícios.
São duas consultas independentes. Elas começam juntas, e esperamos as duas terminarem.
- Salvar um peso de 75 kg.
Agora alteramos um dado. Essa operação roda sozinha, e esperamos até que termine de salvar.
- Consultar o peso salvo.
Essa consulta começa depois de salvar, para ler os 75 kg. Antecipá-la poderia devolver o peso anterior.
Também é preciso evitar que duas alterações sobrescrevam uma à outra. Imagine um armazenamento que salva a lista completa de alimentos: duas operações leem a mesma lista vazia; uma prepara uma lista com uma maçã e a outra uma lista com um iogurte. Se salvarem essas listas separadamente, a segunda gravação pode apagar o que a primeira adicionou. Ao executá-las uma após a outra, a segunda pode ler a lista que já contém a maçã e adicionar o iogurte.
O Gymnasia faz uma escolha simples: executa todas as alterações uma após a outra, mesmo quando afetam dados diferentes. Uma tool que o programa não conhece também espera sua vez. Se uma ação precisa de confirmação do usuário, espere essa decisão e a conclusão da ação antes de continuar. E uma consulta posterior deve ler o dado atualizado, em vez de reutilizar uma cópia anterior à gravação.
Como implementar, passo a passo
Você precisa de um componente que receba as solicitações do modelo e decida quando iniciar cada uma. Pode construí-lo com estas regras:
- Declare o que cada tool faz.
Indique se ela consulta ou altera dados e quais condições permitem executá-la junto a outras.
- Prepare cada solicitação.
Verifique os dados de entrada da tool, por exemplo se uma busca inclui o texto que deve procurar. Mantenha também o identificador que chega com a solicitação do LLM. Quando a tool terminar, envie seu resultado de volta ao LLM com esse identificador, para que o modelo saiba a qual solicitação ele corresponde.
- Limite as consultas ativas.
O Gymnasia permite até quatro. Se chegar uma quinta, ela espera alguma terminar. É um ponto de partida que você deve ajustar com medições, não um número ideal para todos os apps.
- Respeite as alterações de dados.
Percorra as solicitações na ordem original. Antes de alterar um dado, espere todas as consultas anteriores. Termine essa alteração antes de iniciar as próximas solicitações.
- Reúna os resultados.
Quando as tools terminarem, reúna seus resultados e envie-os ao LLM para que ele continue a conversa e prepare a resposta ao usuário. Nesta implementação, enviamos os resultados na ordem das solicitações originais, cada um com seu identificador. Assim o modelo distingue o resultado da busca de alimentos do resultado da busca de exercícios.
Este pseudocódigo mostra a decisão central. Uma “vaga” é simplesmente a permissão para iniciar outra consulta sem ultrapassar o limite:
for each call in the order requested:
    if the call can run independently:
        wait until a read slot is free
        start the call; save its result or error with its label
    else:
        wait for all running calls
        run this call on its own and wait for it to finish
        save its result or error with its label

wait for all running calls
send every result or error to the LLM in request order, with its label
Assim, várias consultas consecutivas podem começar juntas, mas nenhuma passa à frente de uma alteração anterior. Decida também como representar os erros: se uma consulta falhar, mantenha esse erro junto à sua solicitação sem perder as respostas das demais. Se a falha exigir encerrar o turno, pare de iniciar operações e espere as que já começaram. Evite repetir automaticamente uma alteração quando não sabe se ela chegou a ser salva.
Associe cada resposta à sua solicitação
Suponha que o LLM peça estas consultas: A busca alimentos, B busca exercícios e C consulta rotinas. C pode terminar primeiro. Seu resultado continua correspondendo à consulta de rotinas, mesmo que seja o primeiro que seu programa recebe.
Seu programa guarda cada resultado com o identificador da sua solicitação assim que ele chega. Quando todas as consultas terminam, prepara a próxima mensagem ao LLM com A e seus alimentos, B e seus exercícios, e C e suas rotinas. O modelo pode usar esses dados para continuar a conversa e escrever a resposta que o usuário verá.
A etiqueta conecta a solicitação do LLM ao resultado da tool; não é um número que o usuário precisa ver. Mantenha o identificador que chega com cada solicitação. O nome da tool não basta: o LLM poderia pedir duas buscas de alimentos diferentes no mesmo turno.
Testes para verificar se o padrão funciona
Primeiro teste o componente que decide quando executar as tools usando funções de teste: você controla quando elas começam, quando terminam e o que devolvem. Assim verifica as regras sem depender de uma conexão ou de um modelo real. Inclua estes casos:
- As consultas independentes começam juntas.
Deixe duas consultas esperando e verifique se ambas começaram antes de permitir que qualquer uma termine. Isso demonstra que a segunda não espera a primeira.
- O limite de operações é respeitado.
Com um limite de quatro, prepare cinco consultas. Verifique se quatro começam, se a quinta espera e se ela pode começar quando uma das anteriores termina.
- Salvar termina antes de consultar o dado novo.
Use o exemplo das duas buscas, da gravação de 75 kg e da leitura do peso. A gravação espera as buscas; a leitura espera a gravação e devolve 75 kg.
- Os resultados voltam à solicitação correta do LLM.
Faça as consultas terminarem C, A e B. Verifique se a mensagem enviada ao LLM contém A com alimentos, B com exercícios e C com rotinas, nessa ordem e com seus identificadores originais.
- Um erro não faz os outros resultados desaparecerem.
Faça uma consulta falhar e outras duas terminarem bem. Se esse erro permitir continuar, o LLM deve receber os dois resultados e o erro associado à solicitação que falhou. Teste separadamente se uma falha que exige encerrar o turno impede iniciar mais operações.
- Duas alterações preservam o que a anterior salvou.
Adicione uma maçã e depois um iogurte. Leia novamente a lista salva e verifique se ela contém os dois. O teste verifica os dados que foram salvos, além da ordem das operações.
Depois teste o percurso completo com um LLM simulado: forneça as solicitações A, B e C, execute as tools e verifique a próxima mensagem que seu programa enviaria ao modelo. Ela deve conter os resultados corretos, seus identificadores e a ordem escolhida. Esse teste verifica se o planejamento e o envio ao LLM funcionam juntos; medir apenas a velocidade não detectaria um resultado associado à solicitação errada.
Isso também funciona no celular
Um celular pode iniciar vários downloads enquanto espera suas respostas. Essa técnica aproveita as esperas; ela não distribui, por si só, os cálculos locais entre vários núcleos. Se as tools fazem muito cálculo, iniciá-las juntas não garante uma melhoria. Meça no dispositivo e na conexão que seu app usará.
Verifique a melhoria e os resultados
Compare as mesmas consultas antes e depois da alteração. Para saber o que essa implementação oferece, meça desde o início das tools até seus resultados estarem disponíveis. Meça separadamente o tempo que o modelo leva para gerar a resposta final.
Repita a comparação quando o app precisa baixar os dados e quando já os tem armazenados. A melhoria pode ser grande no primeiro caso e pequena no segundo. Faça várias execuções, não apenas uma, e compare o tempo típico e os casos mais lentos.
Verifique também se cada resposta continua associada à sua solicitação, se uma consulta depois de salvar devolve o dado novo, se o limite de operações ativas nunca é ultrapassado e se os erros não fazem outros resultados desaparecerem. A velocidade só é útil se o app continuar dando respostas corretas.
Um exemplo medido no Gymnasia
Comparamos três buscas de exercícios na versão web do Gymnasia. Um modelo simulado fornecia sempre as mesmas solicitações, e cada download de dados de busca tinha uma espera controlada. Quando esses dados ainda precisavam ser baixados, o tempo mediano caiu de cerca de 696 para 264 milissegundos.
A medição incluía receber as solicitações, executar as buscas e preparar os resultados para continuar a conversa. Ela não incluía a geração de uma resposta por um modelo real. É uma comparação controlada na web; a melhoria no celular ainda precisa ser medida no dispositivo. Método e resultados completos.
Uma parte do agente que estamos construindo
Na série usamos um app de academia para explicar como construir um agente que consulta e altera dados. Executar tools em paralelo acrescenta uma decisão ao programa que o controla: o que pode começar junto e o que precisa esperar. Você pode aplicar o mesmo padrão a outros agentes, mantendo o limite de operações e a relação entre cada solicitação e sua resposta.
Continue a série sobre como construir um agente com o Gymnasia. Para ver a implementação concreta deste exemplo, consulte a alteração de código e seus testes.