Mismo modelo, otro resultado
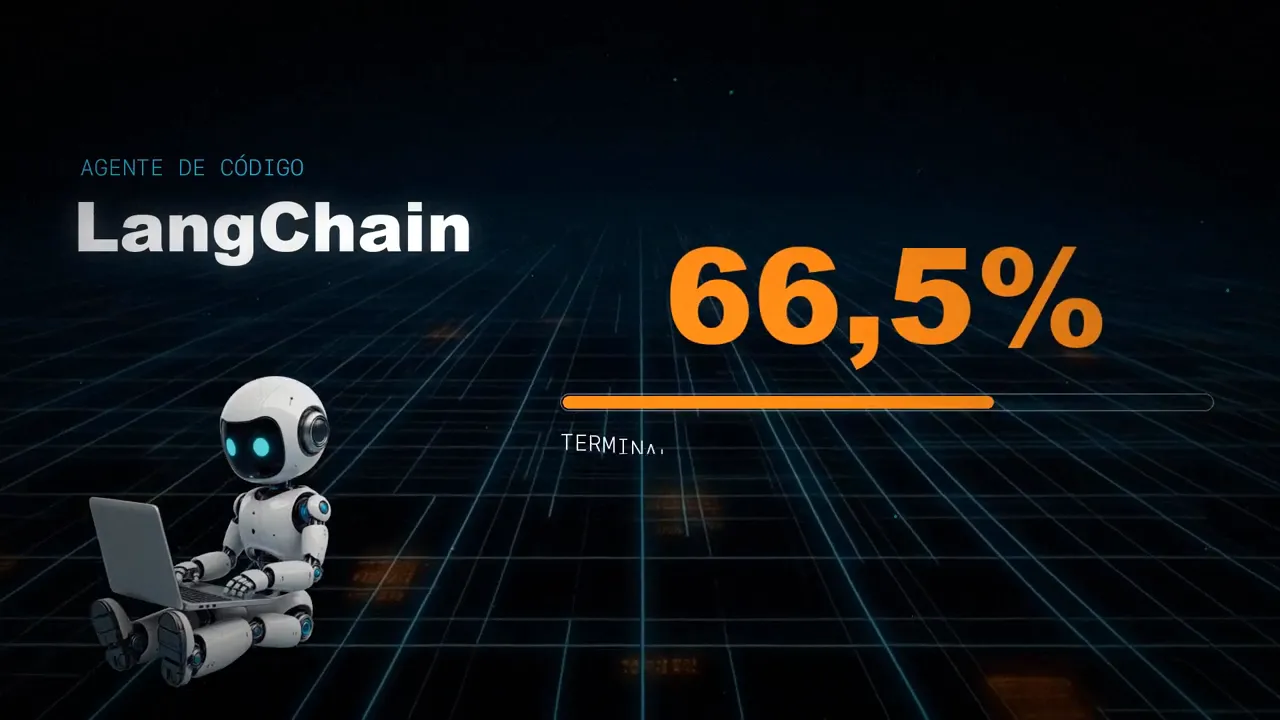
El artículo arranca con un dato que desmonta la intuición más extendida. El agente de programación de LangChain pasó del 52,8 % al 66,5 % en Terminal Bench 2.0, un banco de pruebas de tareas reales en la terminal. Subió del puesto 30 al top 5 de la clasificación. Y lo consiguió sin cambiar ni un solo parámetro del modelo: lo único que cambió fue lo que había alrededor.
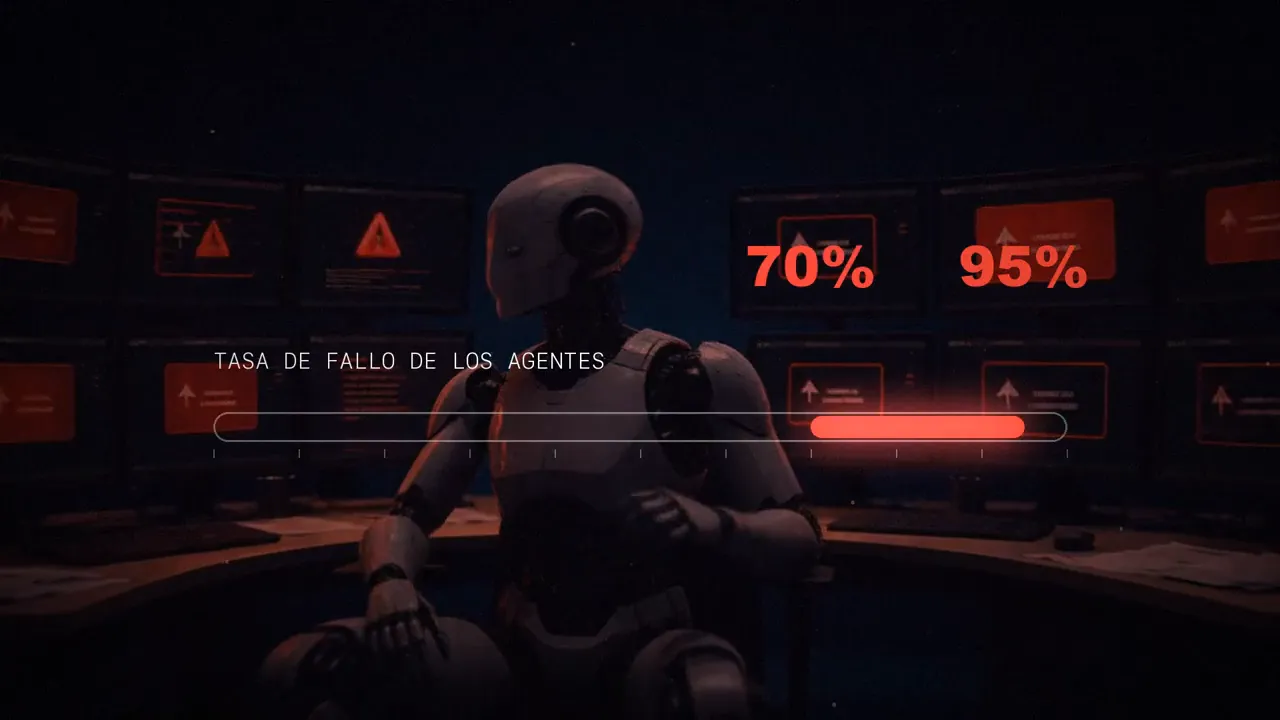
A la vez, el autor recoge dos cifras que explican por qué el tema importa. Gartner prevé que más del 40 % de los proyectos de IA agéntica se cancelarán antes de 2027, y siete estudios independientes coinciden en que los agentes fallan entre el 70 y el 95 % de las veces en tareas empresariales complejas.
Ante esos fracasos, lo habitual es culpar al modelo. Pero el artículo sostiene lo contrario: los modelos se han convertido en una materia prima. Claude, GPT y Gemini convergen en capacidades cada trimestre, y los equipos que llevan agentes a producción no son los que tienen acceso al mejor modelo, sino los que han construido el mejor sistema a su alrededor. La pregunta importante deja de ser qué modelo eliges y pasa a ser qué sistema lo envuelve.
Qué es un arnés
Un arnés (harness, en inglés) es la infraestructura que envuelve al modelo y gestiona cómo trabaja. No es el modelo, que es el que razona, ni tampoco el prompt, que es lo que le pides en cada momento. Es todo lo demás: qué información le llega, qué herramientas tiene, qué comprobaciones pasan sus resultados y qué se guarda para la próxima vez.
El ejemplo que da el autor es de OpenAI: construyeron una aplicación de producción de más de un millón de líneas de código sin que una sola la escribiera una persona. Los ingenieros no programaron la aplicación; diseñaron el arnés. Pusieron restricciones, bucles de retroalimentación, documentación, linters (programas que revisan el código de forma automática) y gestión del ciclo de vida, de modo que el modelo pudiera escribir código de forma fiable.
Según el artículo, el arnés tiene tres trabajos:
Decidir qué información ve el modelo en cada paso, ni más ni menos.
Imponer lo que el modelo puede hacer y lo que no puede hacer.
Que el modelo aprenda de su propia historia en lugar de empezar de cero.
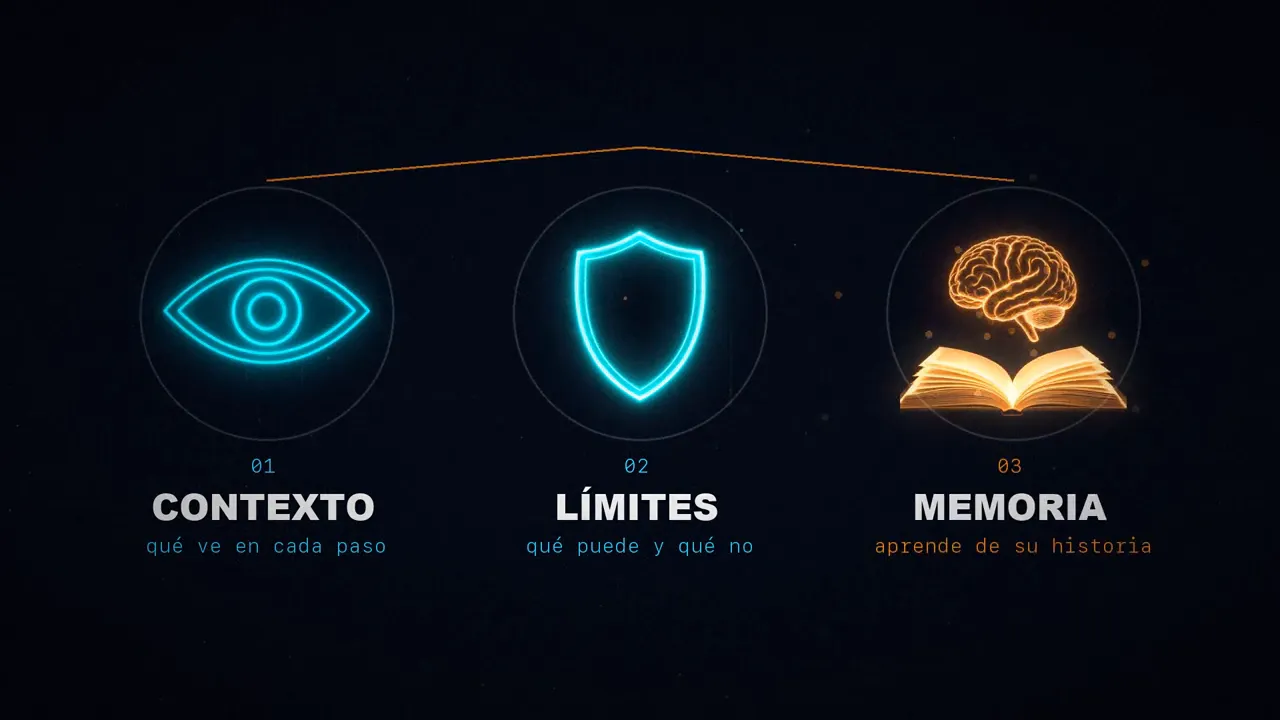
Sin arnés, un modelo razona bien de forma aislada, pero falla en producción. Con él, tienes un sistema que mejora con el tiempo.
Por qué falla el archivo de instrucciones gigante
El primer error que señala el artículo es muy común en quien trabaja con agentes de programación. Empiezas con un CLAUDE.md o un AGENTS.md, el archivo de instrucciones que el agente lee al empezar, y poco a poco se convierte en una enciclopedia. Cada caso raro añade una regla y cada fallo añade una instrucción, hasta que el archivo llega a las 2.000 líneas y el modelo empieza a ignorar la mitad.
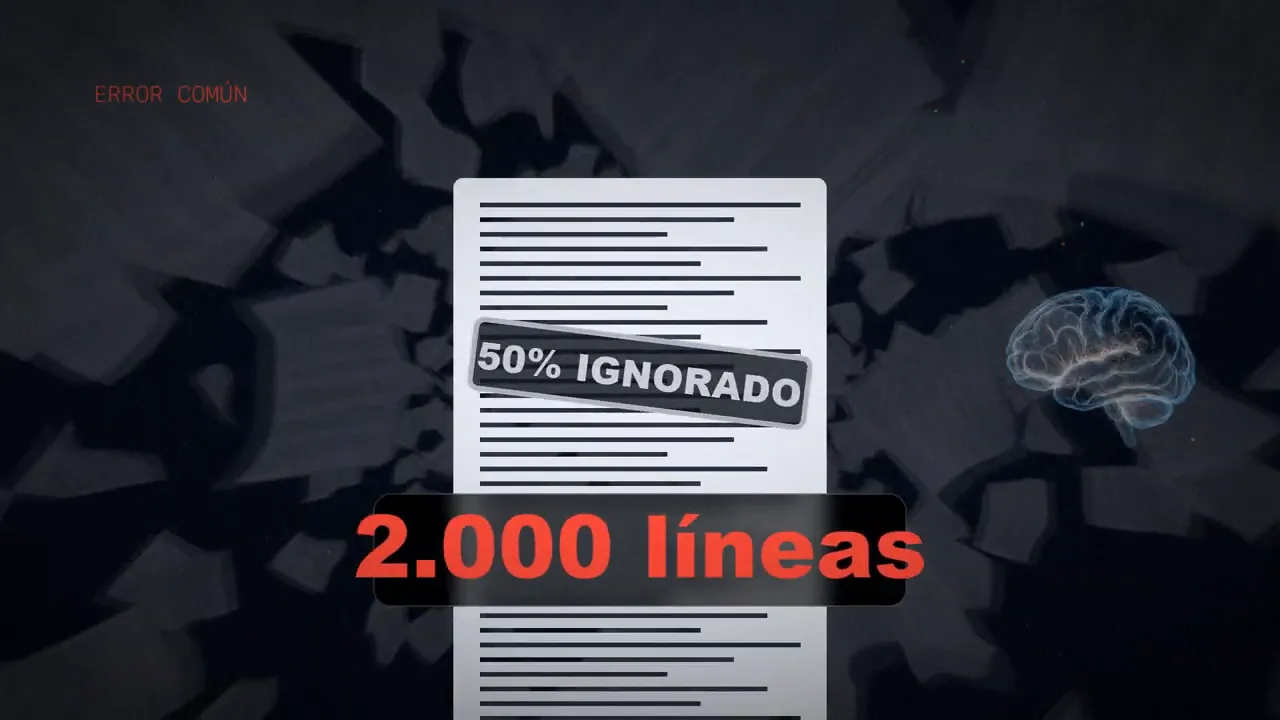
El motivo es que el contexto es un recurso escaso. Todo lo que el modelo lee ocupa espacio en su ventana de contexto, y un archivo de instrucciones gigante desplaza lo que de verdad importa: la tarea, el código y la documentación relevante. Cuando todo es «importante», nada lo es.
El equipo de Codex de OpenAI lo resolvió tratando el archivo de instrucciones como un índice. El conocimiento vive en una carpeta docs/ organizada por temas, y el modelo recibe el contexto adecuado en el momento adecuado, en lugar de ahogarse en todo el contexto todo el tiempo.
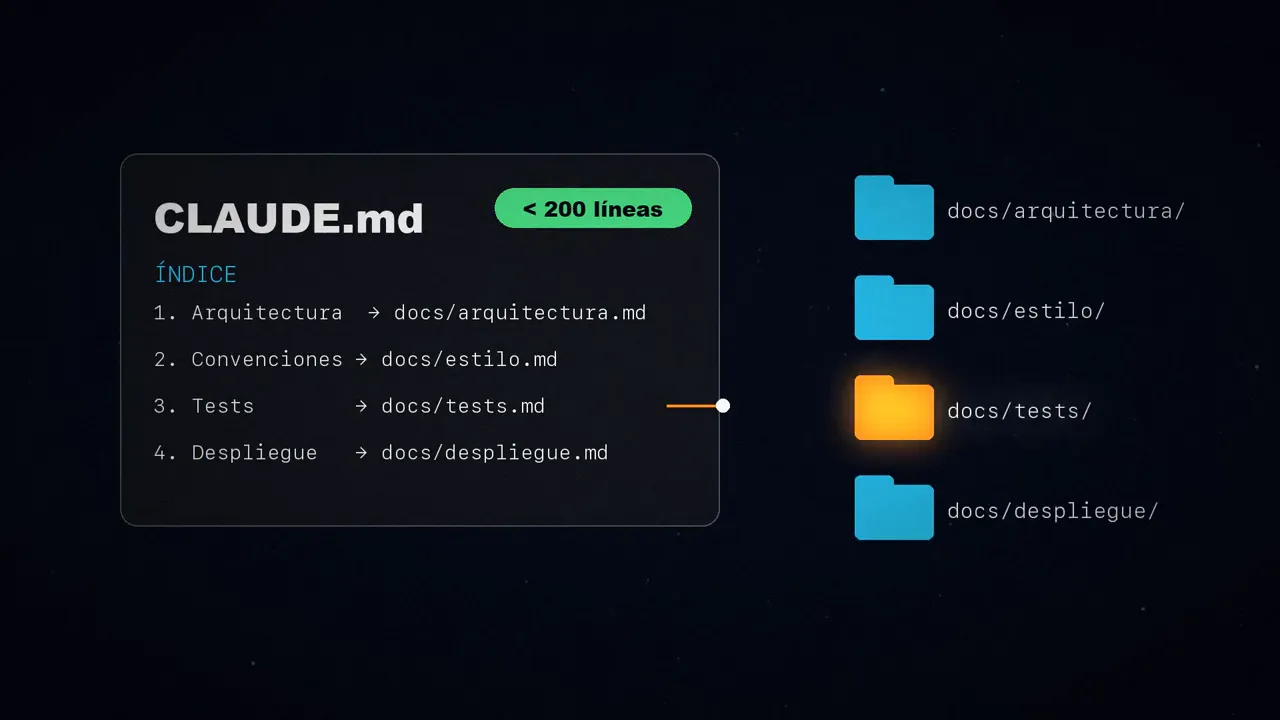
docs/.El patrón que propone tiene cuatro reglas:
- Archivo raíz corto: menos de 200 líneas.
- Conocimiento por temas: organizado en un directorio estructurado.
- Contexto dinámico: cargar la documentación relevante para cada tarea, no todo en cada sesión.
- Poda agresiva: si una regla no ha evitado ningún fallo en 30 días, se elimina.
Es lo que hago en el proyecto con el que preparo estos vídeos: el CLAUDE.md es un índice corto, y todo lo que hay que recordar entre sesiones vive en una carpeta docs/, con un documento por tema.
Los cuatro pilares
La ingeniería de arneses descansa, según el autor, sobre cuatro pilares. Las configuraciones habituales construyen uno o dos; la producción exige los cuatro.
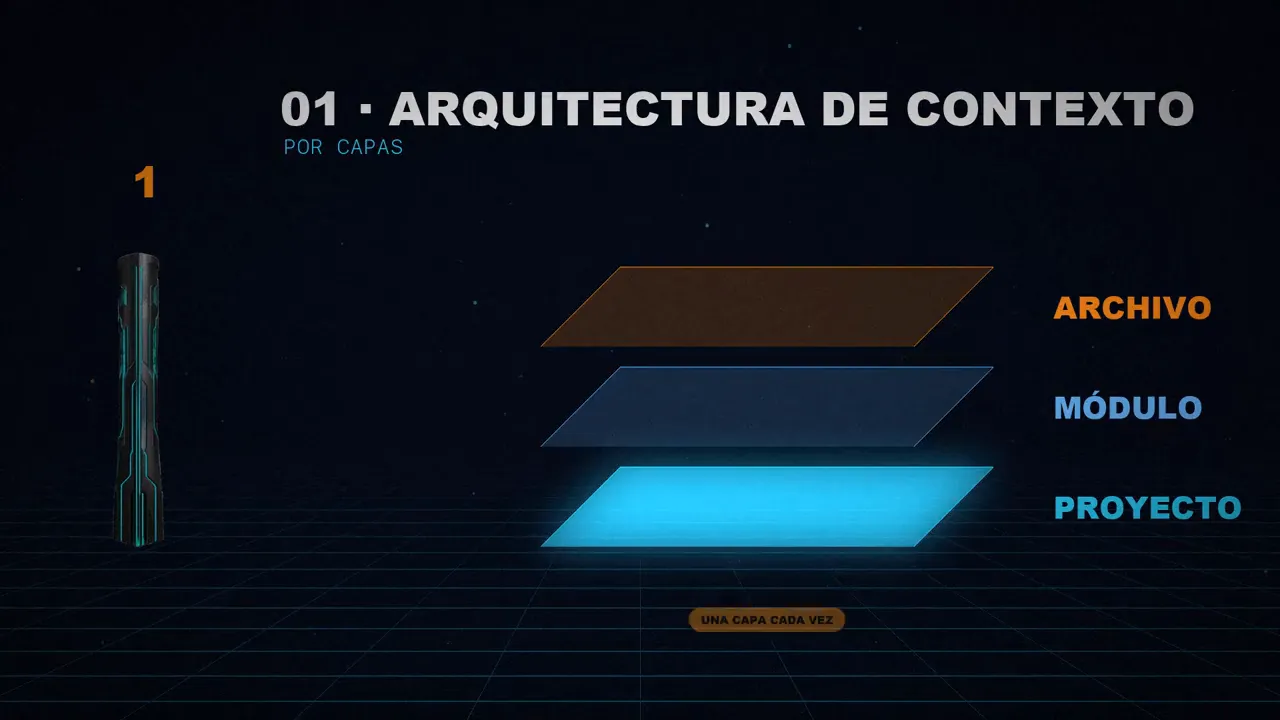
1. Arquitectura de contexto por capas
El modelo no ve todo a la vez: la información se le revela de forma progresiva. Primero el proyecto, luego el módulo y por último el archivo.
- Capa 1, proyecto: arquitectura, convenciones e invariantes. Se carga siempre.
- Capa 2, módulo: documentación, esquemas y restricciones del módulo. Se carga por tarea.
- Capa 3, archivo: historial del archivo, cambios recientes y resultados de tests relacionados. Se carga por archivo.
Además, propone llevar un presupuesto de contexto: medir cuántos tokens usa cada capa y avisar cuando alguna supera el 40 % de la ventana.
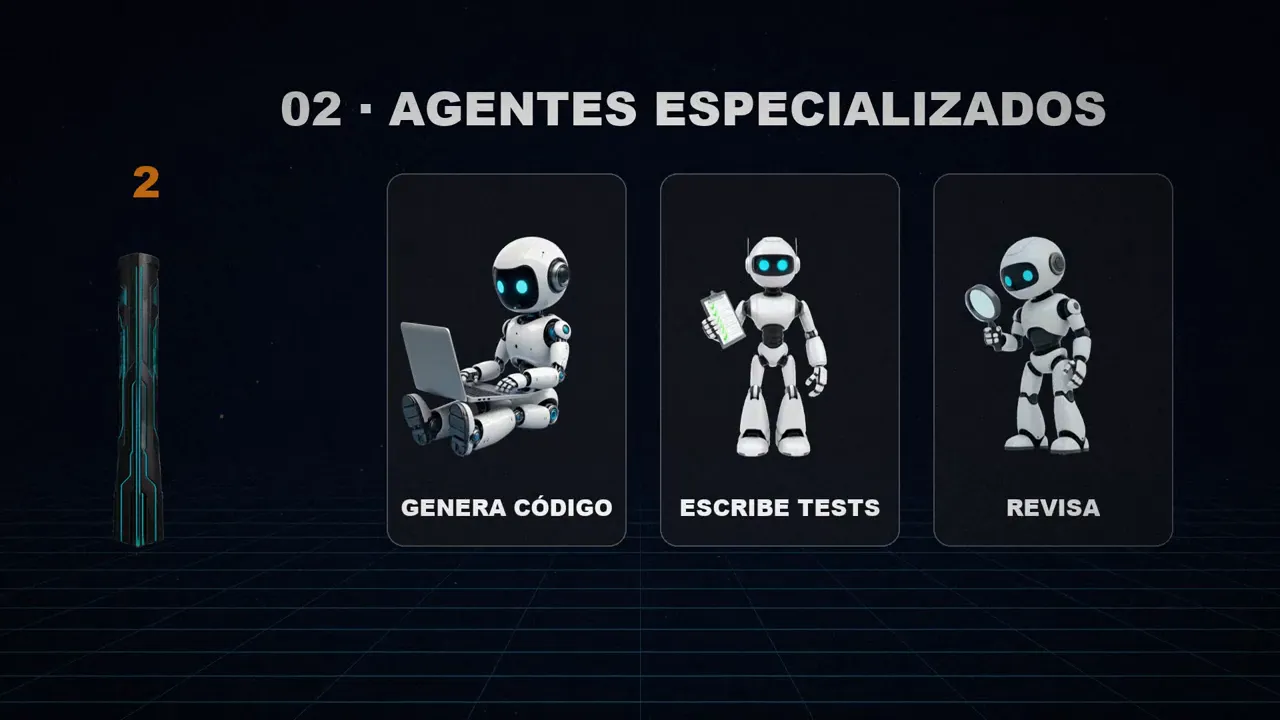
2. Agentes especializados
Un único agente generalista no escala. Los sistemas en producción usan agentes especializados, con responsabilidades estrechas y herramientas acotadas.
- Un agente por dominio: generación de código, tests, revisión y despliegue.
- Solo las herramientas que necesita: nada de acceso universal.
- Traspasos estructurados: los agentes se comunican con entregas definidas, no compartiendo la misma ventana de contexto.
- Un prompt de sistema por rol: un agente que escribe tests no necesita instrucciones de despliegue.
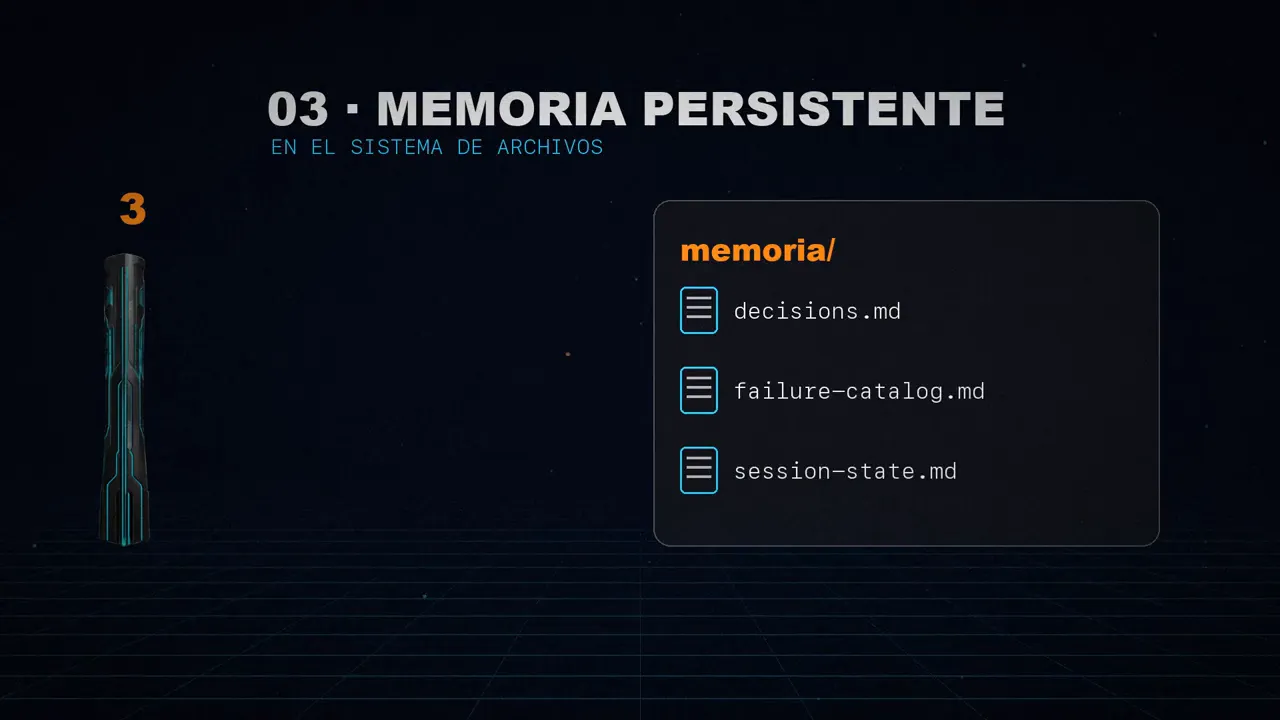
3. Memoria persistente
El historial de la conversación desaparece cuando se cierra la ventana, y eso no es memoria. La memoria real vive en el sistema de archivos:
decisions.md: las decisiones de arquitectura, con su razón y su fecha.failure-catalog.md: un catálogo indexado de fallos y de cómo se resolvieron.session-state.md: qué cambió en la última sesión, qué tests se rompieron y qué aprendió el agente.
El agente lee la memoria al empezar cada sesión y la escribe al terminar. La memoria solo crece, para que quede un rastro auditable, y se poda en un proceso de revisión aparte.
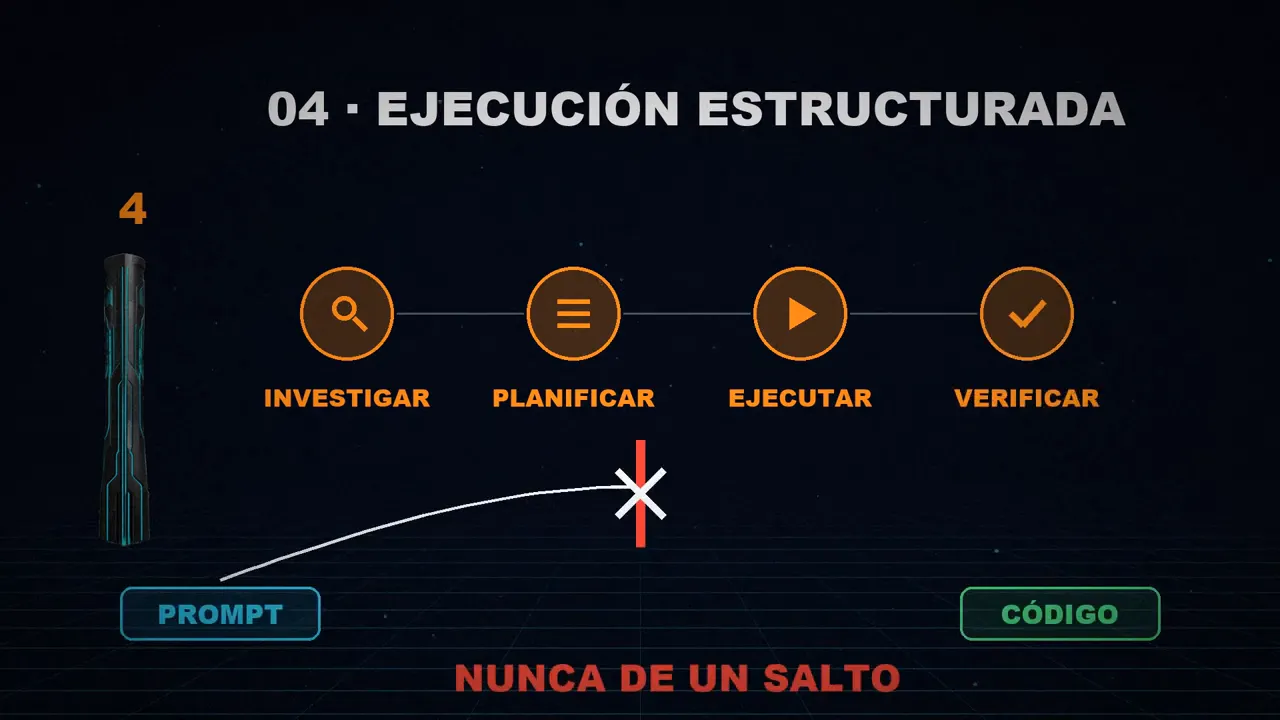
4. Ejecución estructurada
El modelo nunca debería pasar del prompt al código de un salto. La ejecución estructurada impone un flujo de trabajo: investigar, planificar, ejecutar y verificar. El artículo lo concreta en seis pasos:
- Leer: el agente lee el contexto relevante y su memoria.
- Planificar: produce un plan con los archivos que va a cambiar, los tests que va a escribir y los riesgos.
- Revisar el plan: una persona o un proceso automático lo revisa antes de ejecutar.
- Ejecutar con barreras: con un máximo de archivos por sesión, listas de archivos protegidos y simulación antes de desplegar.
- Verificar: tests, linting y análisis de seguridad.
- Recordar: el agente escribe los resultados de la sesión en la memoria.
Barreras que no se negocian
Por encima de los cuatro pilares están las barreras (guardrails). El autor insiste en tratarlas como una política de obligado cumplimiento que el agente no puede saltarse, y las ordena en una jerarquía:
- Límites duros: el agente no puede relajarlos.
- Redes de seguridad: atrapan los fallos antes de que lleguen a producción.
- Caminos dorados: guían al agente hacia los patrones correctos.
- Auditoría: permite reconstruir qué pasó.
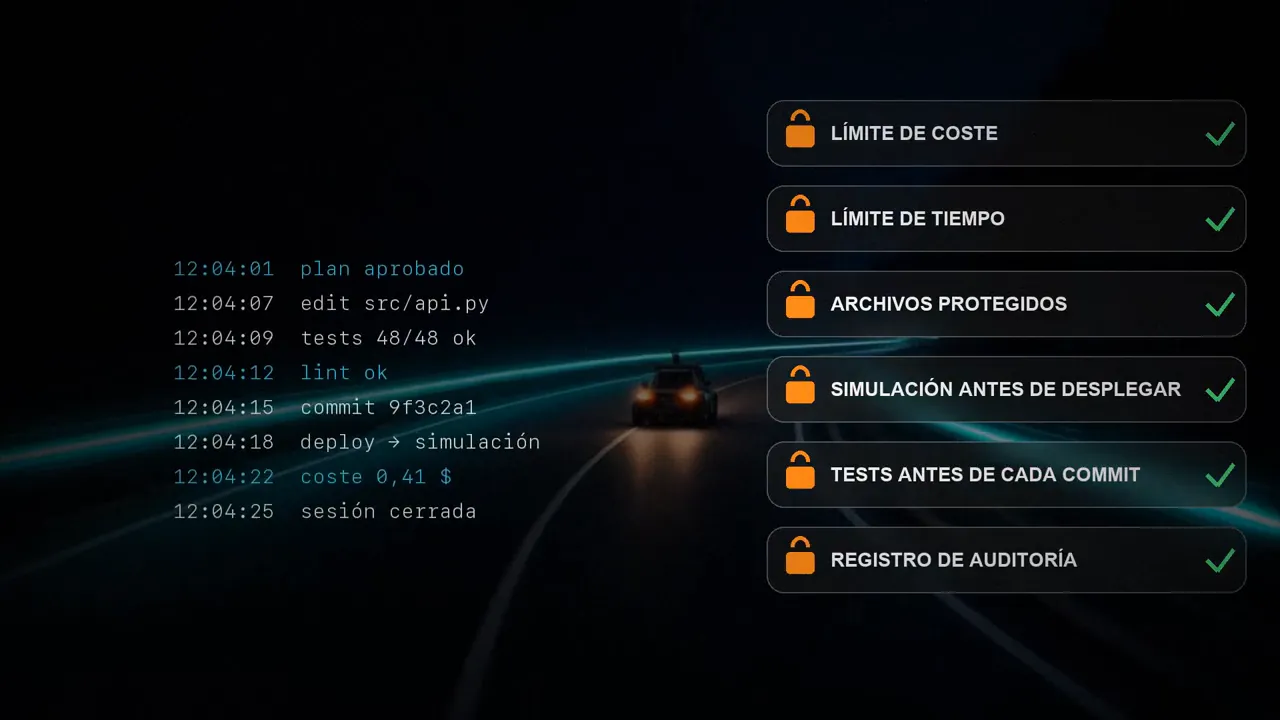
En la práctica, se traducen en un límite de coste por sesión, un límite de tiempo con pausa automática, listas de archivos protegidos, simulación antes de cada despliegue, tests obligatorios antes de cada commit y un registro de auditoría de cada acción del agente.
El efecto compuesto: el verdadero foso
Un agente sin arnés empieza de cero en cada sesión: redescubre patrones, repite errores y no acumula conocimiento. Un agente con arnés, en cambio, suma. Cada sesión añade entradas al catálogo de fallos, cada decisión queda registrada con su razón y cada patrón de interacción se indexa para reutilizarlo.
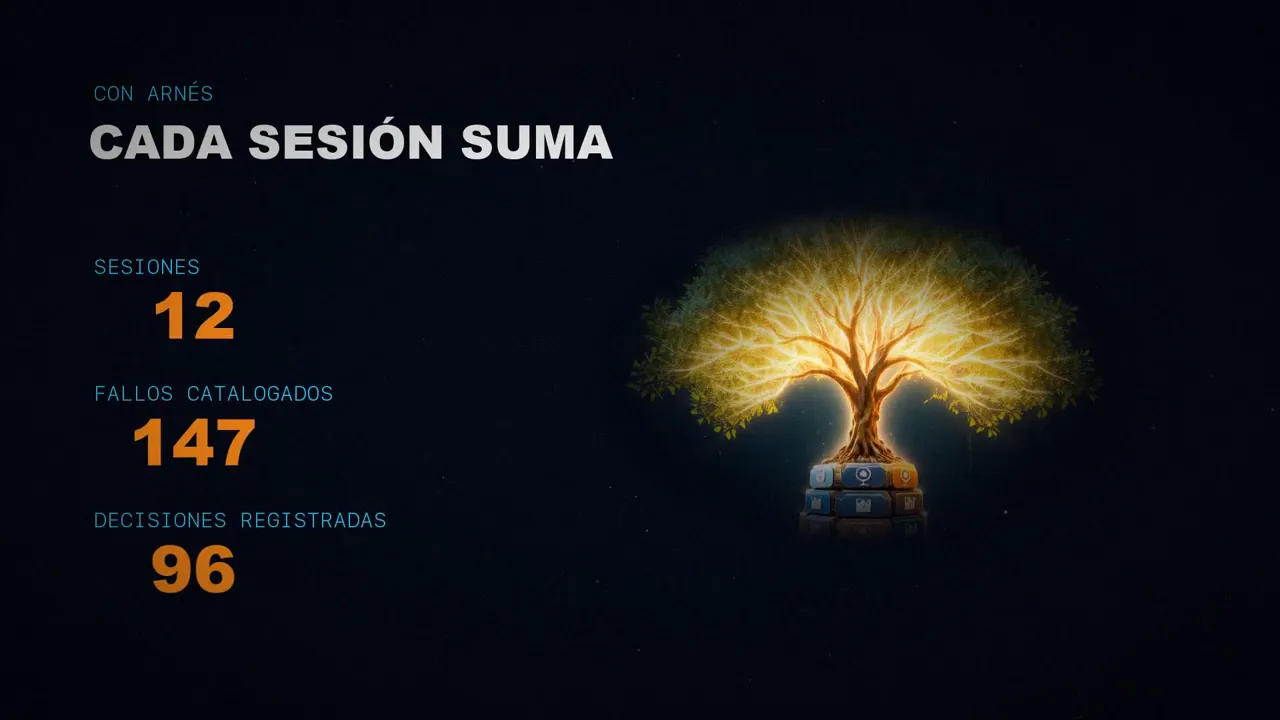
Según el artículo, el equipo de Codex de OpenAI observó que sus agentes se volvían más fiables con el tiempo. No era porque el modelo mejorase, sino porque el arnés acumulaba contexto que le facilitaba el trabajo.
Ese es el verdadero foso defensivo, la ventaja que la competencia no puede copiar. El modelo es intercambiable; el arnés, no. Seis meses de contexto acumulado, patrones de fallo y decisiones de arquitectura no se replican cambiando de modelo ni de framework.
El modelo es el motor
Para quien construye agentes, la conclusión es clara. La capa del modelo se está convirtiendo en una materia prima, y la distancia entre los mejores se estrecha con cada versión. El autor cita a Carnegie Mellon: los agentes completan solo el 24 % de las tareas de oficina habituales, y el fallo es de infraestructura, no de inteligencia.
Los equipos que ganan construyen arneses en lugar de ir de compras en busca del mejor modelo. LangChain lo demostró: mismo modelo, mejor arnés, top 5.
Y hay un giro que me parece la idea más interesante del artículo: la ingeniería de arneses importa más cuanto mejores son los modelos. Un modelo mejor permite darle más autonomía al agente, y más autonomía exige mejores barreras.
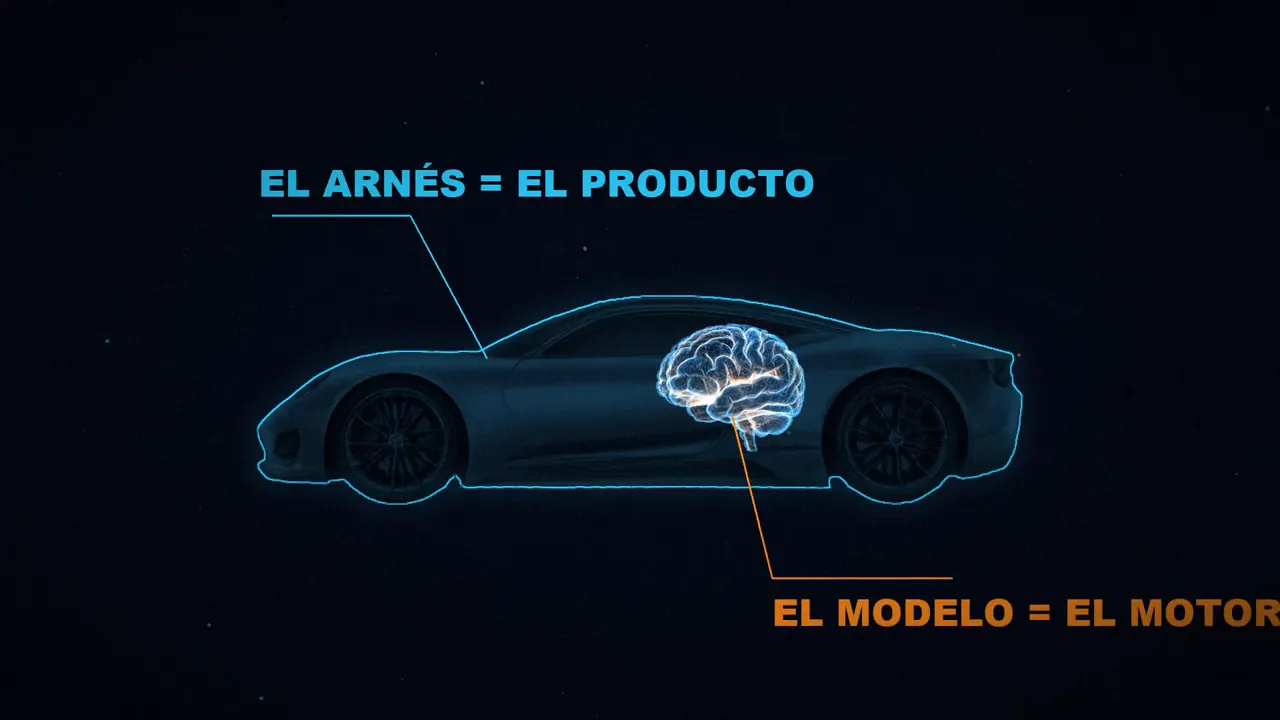
El arnés es el producto. El modelo es el motor. Y nadie se compra un coche solo por el motor.
La lista para producción
El artículo termina con una lista de comprobación que resume todo lo anterior. La reproduzco porque es lo más útil para revisar el arnés de tus propios agentes:
- Archivo de instrucciones raíz de menos de 200 líneas.
- Conocimiento organizado por temas en un directorio.
- Documentación cargada por tarea.
- Presupuesto de contexto por capa, con alertas.
- Reglas obsoletas podadas cada mes.
- Agentes distintos para generar código, testear y revisar.
- Herramientas acotadas para cada agente.
- Traspasos entre agentes documentados.
- Prompt de sistema por rol.
- Decisiones, fallos y estado de sesión en archivos.
- El agente lee la memoria al empezar.
- El agente escribe los resultados al terminar.
- Memoria que solo crece, con una poda aparte.
- Flujo investigar → planificar → ejecutar → verificar.
- Planes revisados antes de ejecutar en las partes críticas.
- Máximo de archivos por sesión.
- Archivos protegidos frente a cambios no autorizados.
- Verificación después de cada paso.
- Límite de coste por sesión.
- Límite de tiempo con pausa automática.
- Simulación antes de cada despliegue.
- Tests que pasan antes de cada commit.
- Registro de auditoría de cada acción.
En resumen: el modelo pone la potencia, y el arnés, todo lo demás. ¿Cómo es el arnés de tus agentes?
Fuentes
Las cifras de este post son las que cita el artículo original; no las he medido yo.
- «The Harness Is The Product. The Model Never Was», de nyk (@nykdotdev), 10 de marzo de 2026.
- El vídeo, en mis tres canales: español, inglés y portugués.