Mesmo modelo, outro resultado
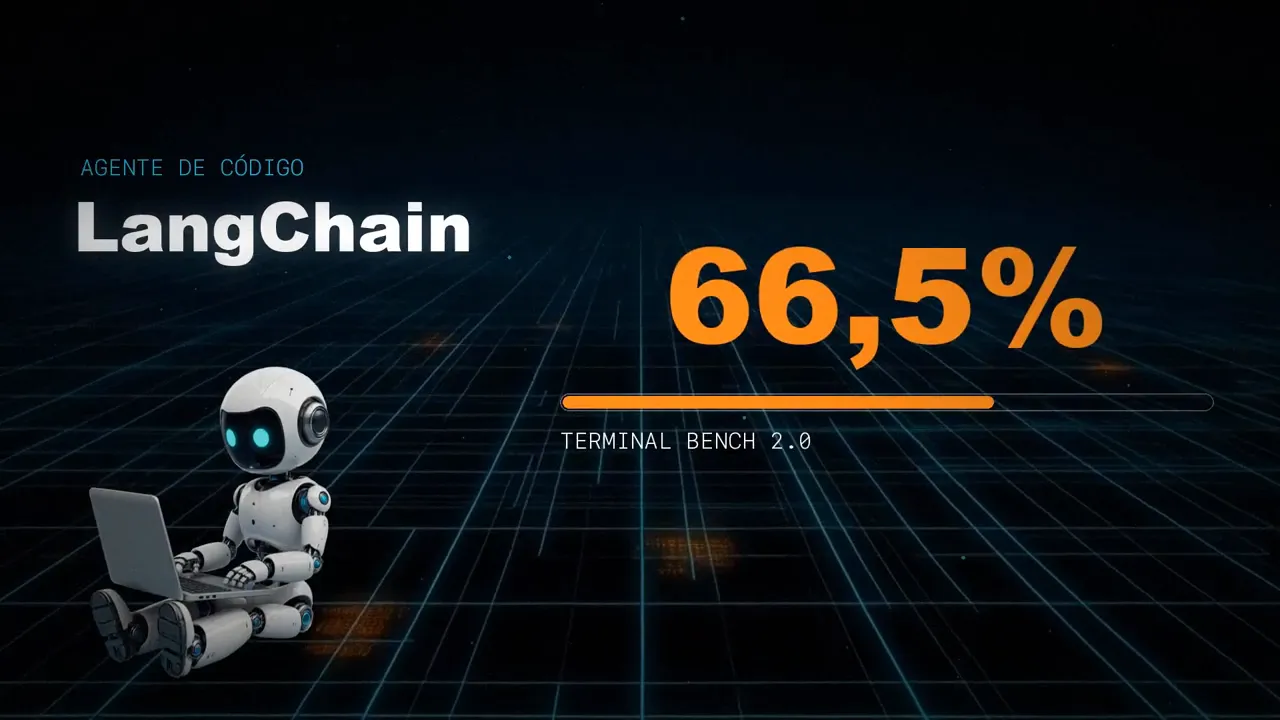
O artigo começa com um dado que derruba a intuição mais comum. O agente de programação da LangChain passou de 52,8% para 66,5% no Terminal Bench 2.0, um benchmark de tarefas reais no terminal. Subiu do 30º lugar para o top 5 do ranking. E conseguiu isso sem mudar um único parâmetro do modelo: a única coisa que mudou foi o que estava em volta dele.
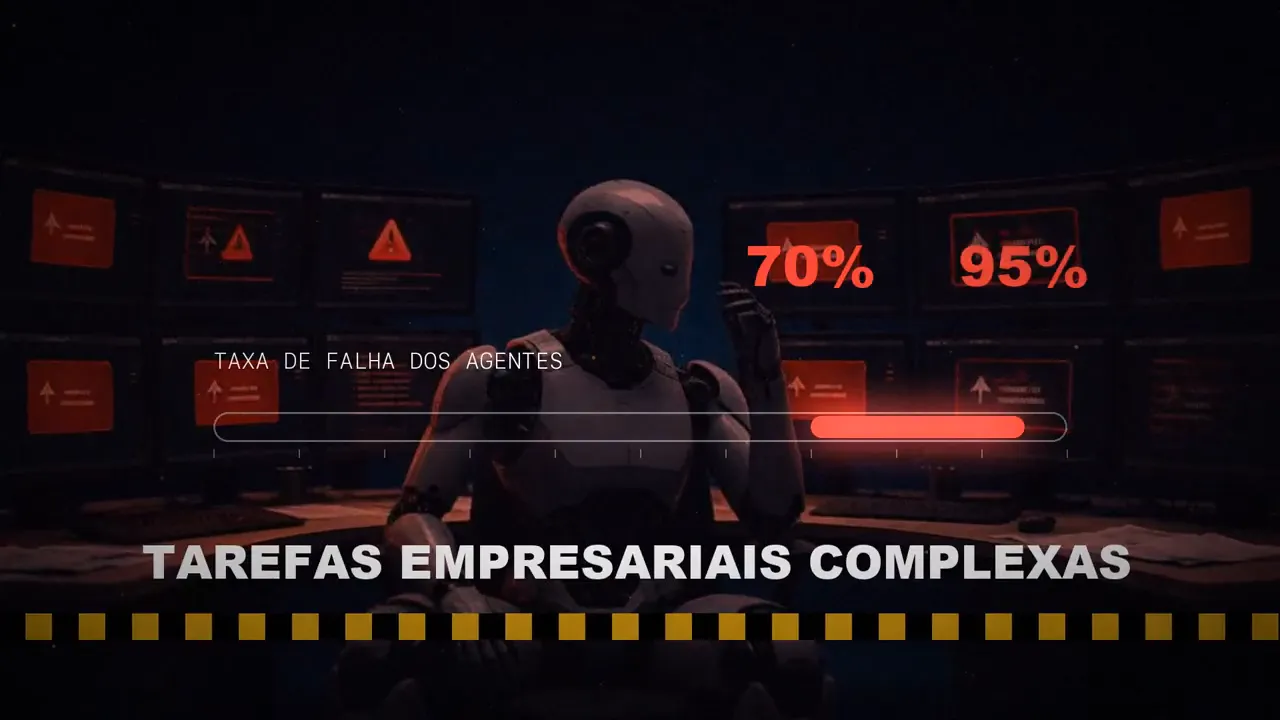
O autor junta a isso dois números que mostram por que o tema importa. A Gartner prevê que mais de 40% dos projetos de IA agêntica serão cancelados até 2027, e sete estudos independentes concordam que os agentes falham entre 70% e 95% das vezes em tarefas empresariais complexas.
Diante dessas falhas, o mais comum é culpar o modelo. O artigo defende o contrário: os modelos viraram uma commodity. Claude, GPT e Gemini convergem em capacidades a cada trimestre, e as equipes que levam agentes para produção não são as que têm acesso ao melhor modelo, mas as que construíram o melhor sistema em volta dele. A pergunta importante deixa de ser qual modelo você escolhe e passa a ser qual sistema o envolve.
O que é um arnês
Um arnês (harness, em inglês) é a infraestrutura que envolve o modelo e gerencia como ele trabalha. Não é o modelo, que é quem raciocina, nem o prompt, que é o que você pede a cada momento. É todo o resto: que informação chega ao modelo, que ferramentas ele tem, por quais verificações passam os resultados e o que fica guardado para a próxima vez.
O exemplo do autor vem da OpenAI: eles construíram uma aplicação de produção com mais de um milhão de linhas de código, sem nenhuma escrita por uma pessoa. Os engenheiros não programaram a aplicação; projetaram o arnês. Colocaram restrições, ciclos de feedback, documentação, linters (programas que revisam o código automaticamente) e gestão do ciclo de vida, para que o modelo pudesse escrever código de forma confiável.
Segundo o artigo, o arnês tem três funções:
Decidir que informação o modelo vê em cada passo, nem mais nem menos.
Impor o que o modelo pode e o que não pode fazer.
Fazer o modelo aprender com a própria história em vez de começar do zero.
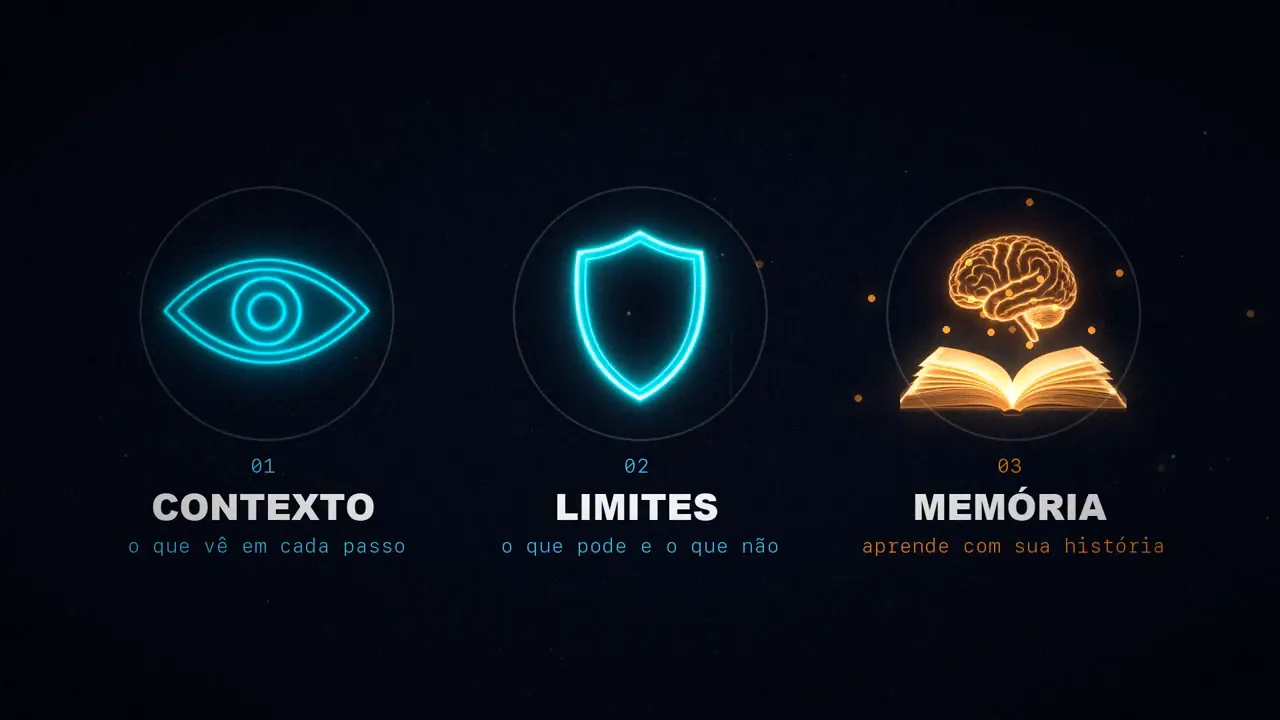
Sem arnês, um modelo raciocina bem isolado, mas falha em produção. Com ele, você tem um sistema que melhora com o tempo.
Por que o arquivo de instruções gigante falha
O primeiro erro que o artigo aponta é muito comum entre quem trabalha com agentes de programação. Você começa com um CLAUDE.md ou um AGENTS.md, o arquivo de instruções que o agente lê ao começar, e aos poucos ele vira uma enciclopédia. Cada caso estranho acrescenta uma regra e cada falha acrescenta uma instrução, até o arquivo chegar a 2.000 linhas e o modelo começar a ignorar metade.
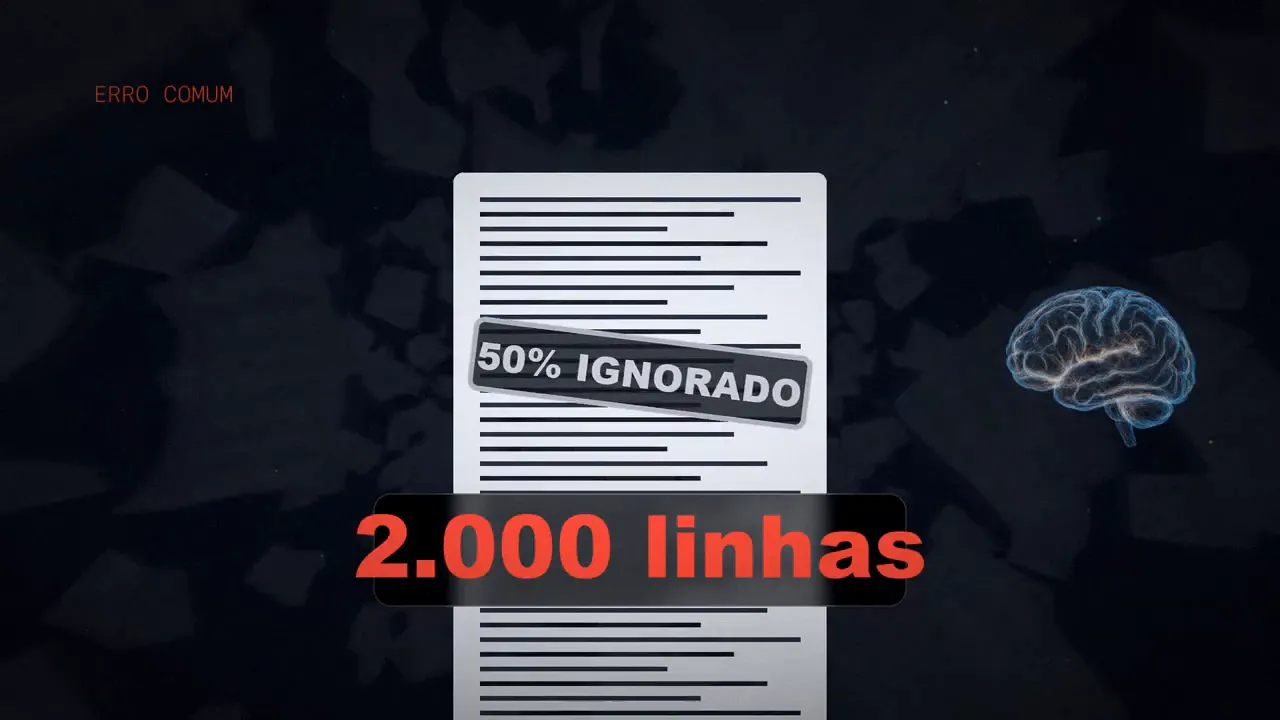
O motivo é que o contexto é um recurso escasso. Tudo o que o modelo lê ocupa espaço na janela de contexto, e um arquivo de instruções gigante empurra para fora o que realmente importa: a tarefa, o código e a documentação relevante. Quando tudo é «importante», nada é.
A equipe do Codex, da OpenAI, resolveu isso tratando o arquivo de instruções como um índice. O conhecimento fica em uma pasta docs/ organizada por temas, e o modelo recebe o contexto certo na hora certa, em vez de se afogar em todo o contexto o tempo todo.
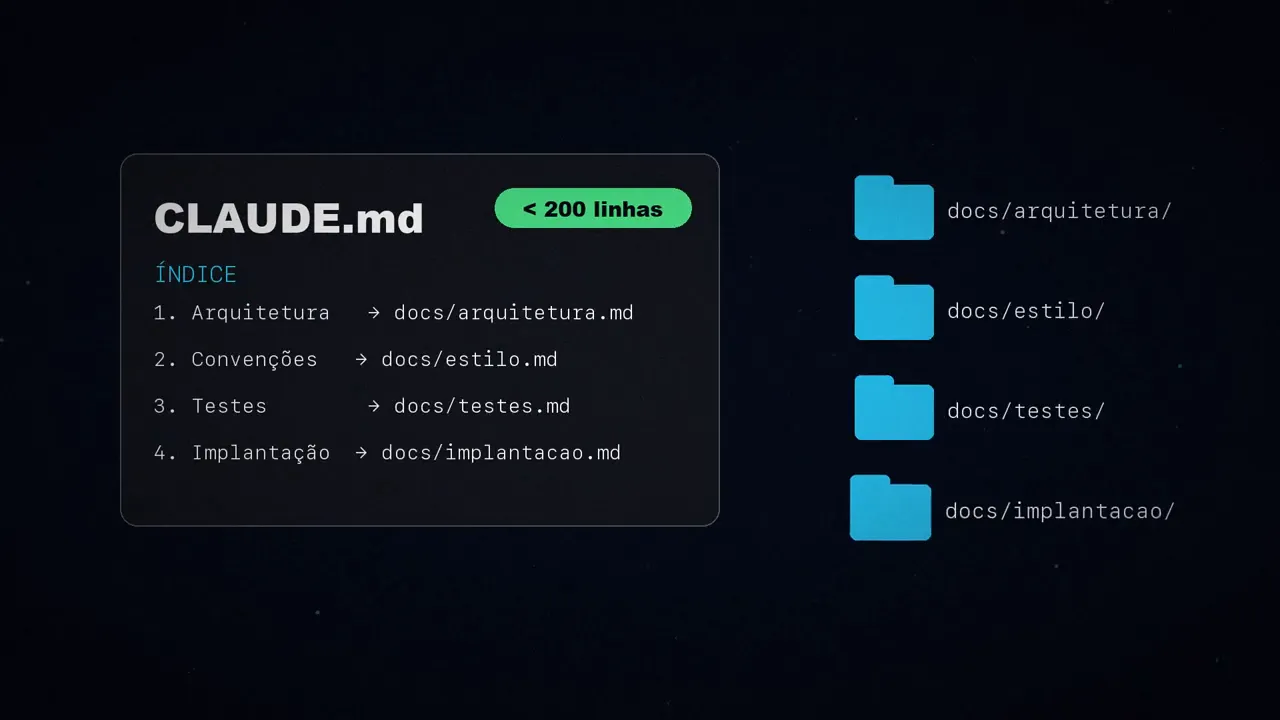
docs/.O padrão proposto tem quatro regras:
- Arquivo raiz curto: menos de 200 linhas.
- Conhecimento por temas: organizado em um diretório estruturado.
- Contexto dinâmico: carregar a documentação relevante para cada tarefa, não tudo em cada sessão.
- Poda agressiva: se uma regra não evitou nenhuma falha em 30 dias, ela sai.
É o que eu faço no projeto que uso para preparar estes vídeos: o CLAUDE.md é um índice curto, e tudo o que precisa ser lembrado entre sessões fica em uma pasta docs/, com um documento por tema.
Os quatro pilares
A engenharia de arneses se apoia, segundo o autor, em quatro pilares. As configurações comuns constroem um ou dois; a produção exige os quatro.
1. Arquitetura de contexto em camadas
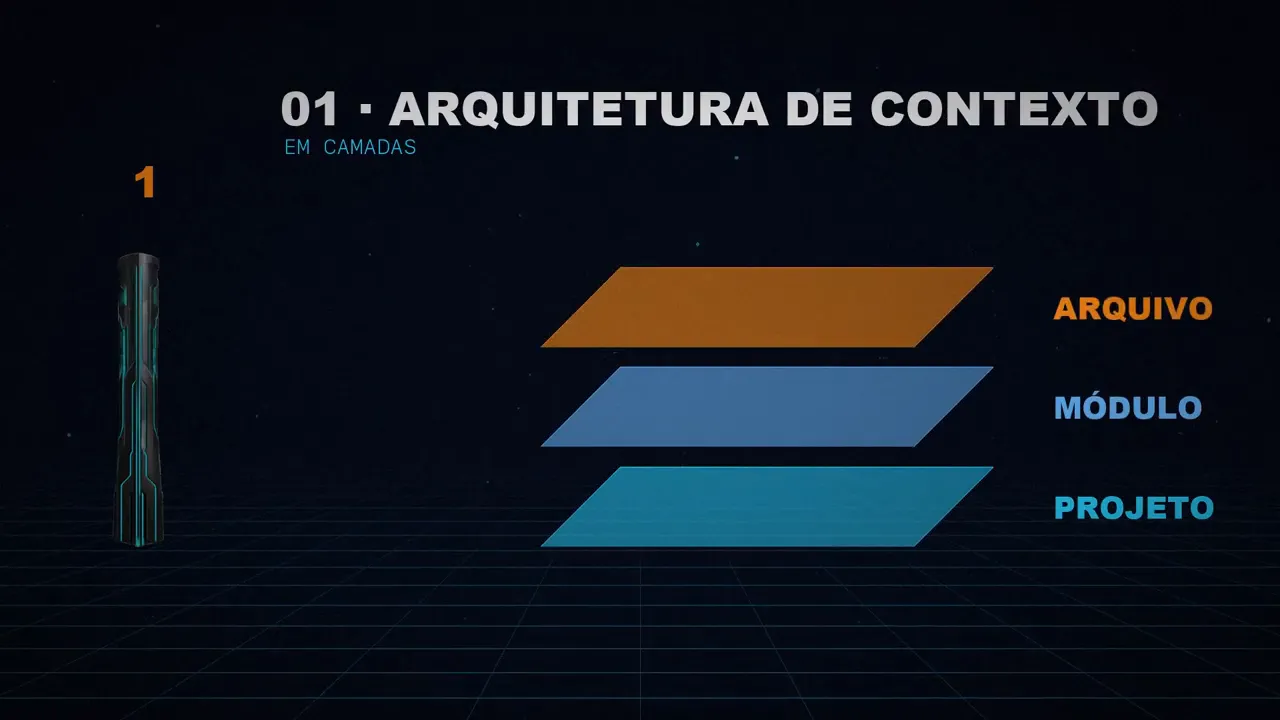
O modelo não vê tudo de uma vez: a informação é revelada aos poucos. Primeiro o projeto, depois o módulo e por último o arquivo.
- Camada 1, projeto: arquitetura, convenções e invariantes. Sempre carregada.
- Camada 2, módulo: documentação, esquemas e restrições do módulo. Carregada por tarefa.
- Camada 3, arquivo: histórico do arquivo, mudanças recentes e resultados de testes relacionados. Carregada por arquivo.
Ele também propõe um orçamento de contexto: medir quantos tokens cada camada usa e avisar quando alguma passar de 40% da janela.
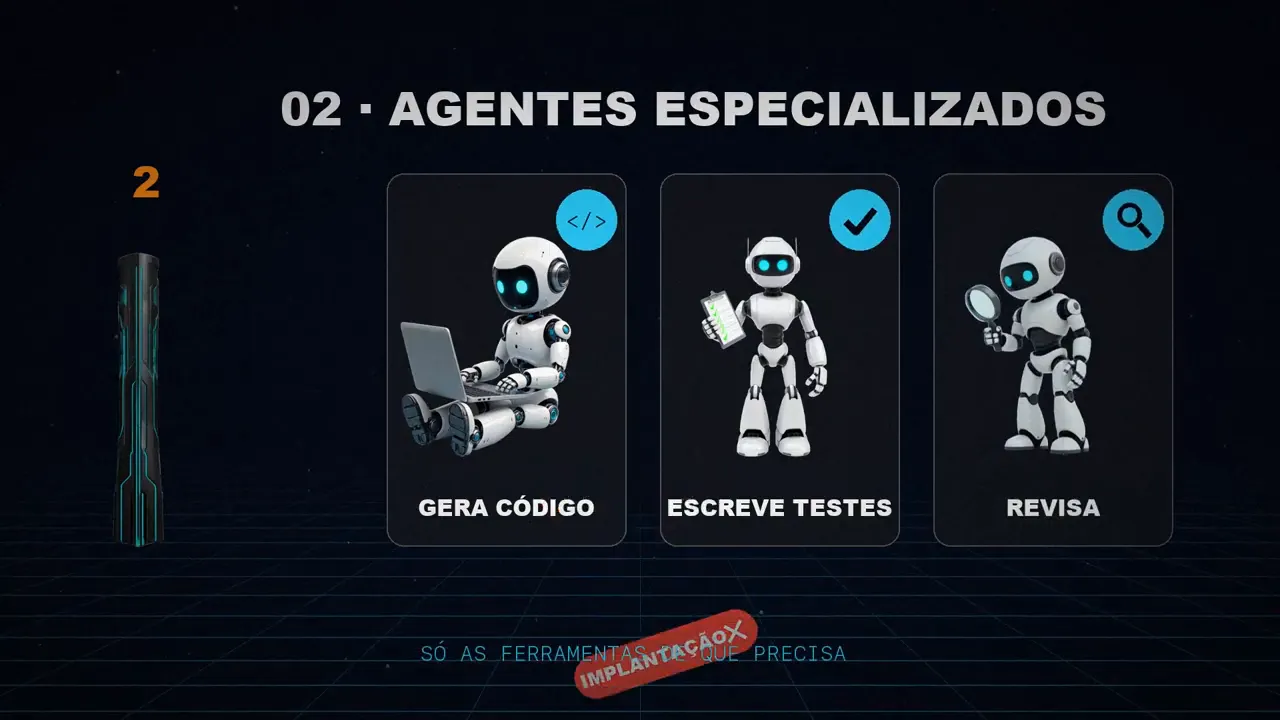
2. Agentes especializados
Um único agente generalista não escala. Os sistemas em produção usam agentes especializados, com responsabilidades estreitas e ferramentas limitadas.
- Um agente por domínio: geração de código, testes, revisão e implantação.
- Só as ferramentas de que precisa: nada de acesso universal.
- Passagens estruturadas: os agentes se comunicam por entregas definidas, não compartilhando a mesma janela de contexto.
- Um prompt de sistema por papel: um agente que escreve testes não precisa de instruções de implantação.
3. Memória persistente
O histórico da conversa desaparece quando a janela fecha, e isso não é memória. A memória de verdade fica no sistema de arquivos:
decisions.md: as decisões de arquitetura, com o motivo e a data.failure-catalog.md: um catálogo indexado de falhas e de como foram resolvidas.session-state.md: o que mudou na última sessão, quais testes quebraram e o que o agente aprendeu.
O agente lê a memória ao começar cada sessão e a escreve ao terminar. A memória só cresce, para deixar um rastro auditável, e é podada em um processo de revisão separado.
4. Execução estruturada
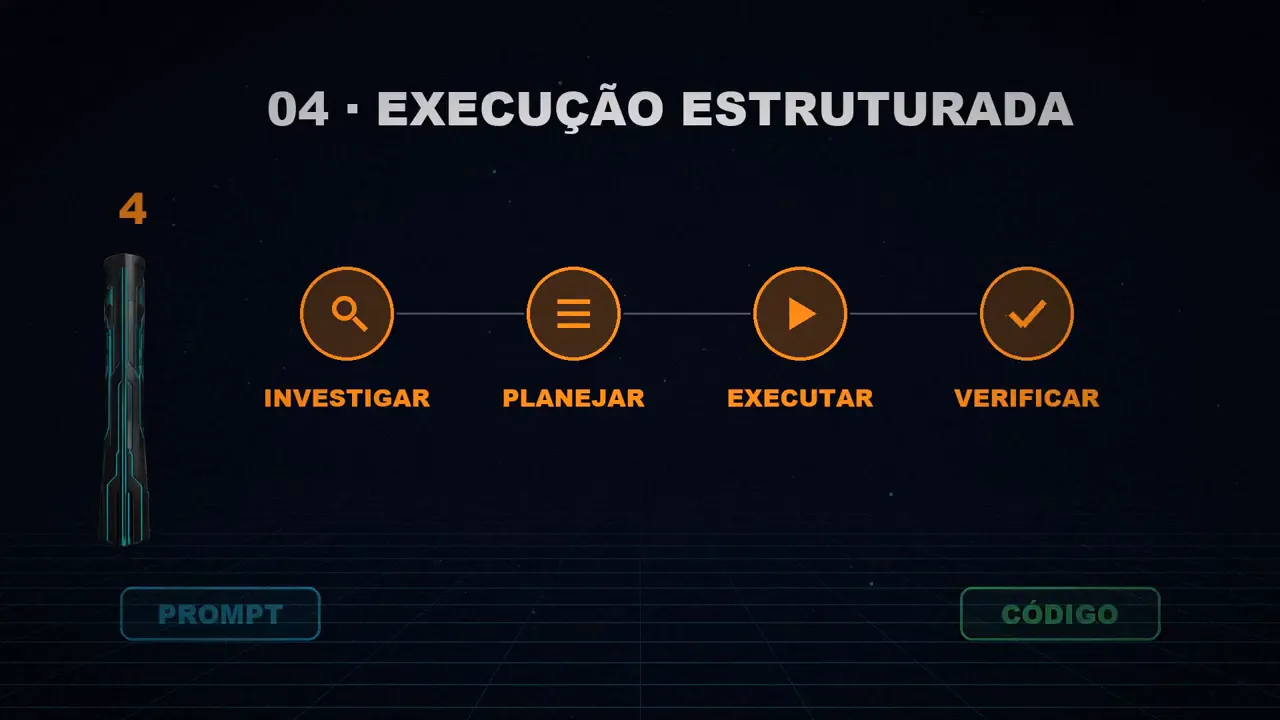
O modelo nunca deveria passar do prompt ao código de um salto. A execução estruturada impõe um fluxo de trabalho: investigar, planejar, executar e verificar. O artigo detalha isso em seis passos:
- Ler: o agente lê o contexto relevante e a sua memória.
- Planejar: produz um plano com os arquivos que vai mudar, os testes que vai escrever e os riscos.
- Revisar o plano: uma pessoa ou um processo automático revisa antes da execução.
- Executar com barreiras: com um máximo de arquivos por sessão, listas de arquivos protegidos e simulação antes de implantar.
- Verificar: testes, linting e análise de segurança.
- Lembrar: o agente escreve os resultados da sessão na memória.
Barreiras inegociáveis
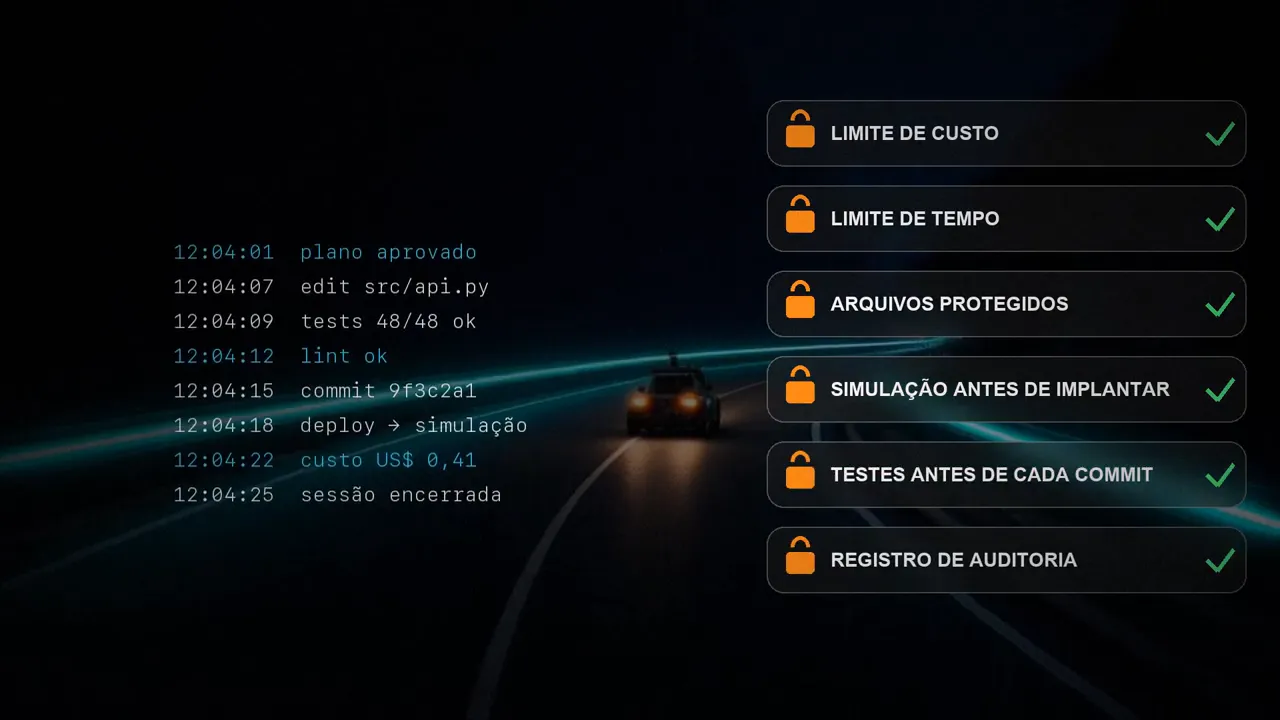
Acima dos quatro pilares ficam as barreiras (guardrails). O autor insiste em tratá-las como uma política obrigatória que o agente não pode contornar, e as organiza em uma hierarquia:
- Limites rígidos: o agente não pode relaxá-los.
- Redes de segurança: pegam as falhas antes que cheguem à produção.
- Caminhos dourados: guiam o agente para os padrões corretos.
- Auditoria: permite reconstruir o que aconteceu.
Na prática, isso se traduz em um limite de custo por sessão, um limite de tempo com pausa automática, listas de arquivos protegidos, simulação antes de cada implantação, testes obrigatórios antes de cada commit e um registro de auditoria de cada ação do agente.
O efeito composto: o verdadeiro fosso
Um agente sem arnês começa do zero a cada sessão: redescobre padrões, repete erros e não acumula conhecimento. Um agente com arnês, por outro lado, soma. Cada sessão acrescenta entradas ao catálogo de falhas, cada decisão fica registrada com o seu motivo e cada padrão de interação é indexado para ser reutilizado.
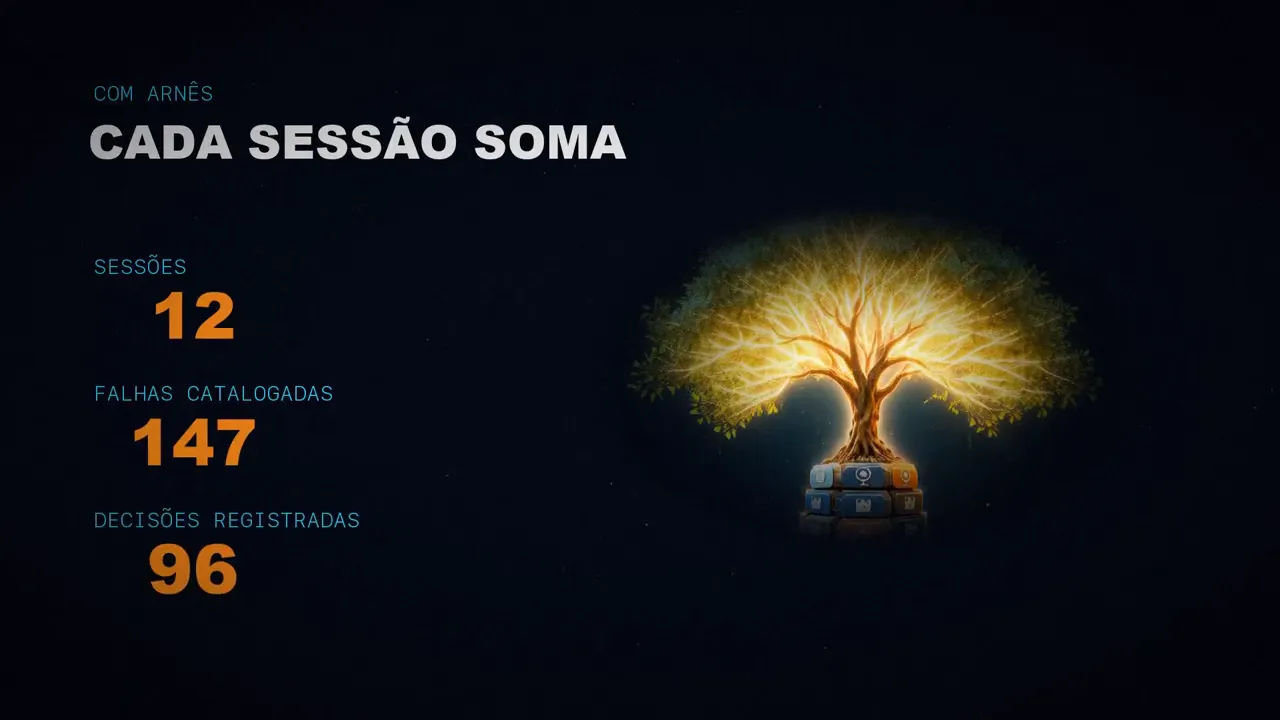
Segundo o artigo, a equipe do Codex, da OpenAI, viu os seus agentes ficarem mais confiáveis com o tempo. Não porque o modelo melhorou, mas porque o arnês acumulou contexto que facilitava o trabalho do modelo.
Esse é o verdadeiro fosso defensivo, a vantagem que a concorrência não consegue copiar. O modelo é intercambiável; o arnês, não. Seis meses de contexto acumulado, padrões de falha e decisões de arquitetura não se replicam trocando de modelo nem de framework.
O modelo é o motor
Para quem constrói agentes, a conclusão é clara. A camada do modelo está virando commodity, e a distância entre os melhores diminui a cada versão. O autor cita a Carnegie Mellon: os agentes completam só 24% das tarefas de escritório comuns, e a falha é de infraestrutura, não de inteligência.
As equipes que vencem constroem arneses em vez de sair às compras atrás do melhor modelo. A LangChain provou isso: mesmo modelo, arnês melhor, top 5.
E tem uma virada que, para mim, é a ideia mais interessante do artigo: a engenharia de arneses importa mais quanto melhores ficam os modelos. Um modelo melhor permite dar mais autonomia ao agente, e mais autonomia exige barreiras melhores.
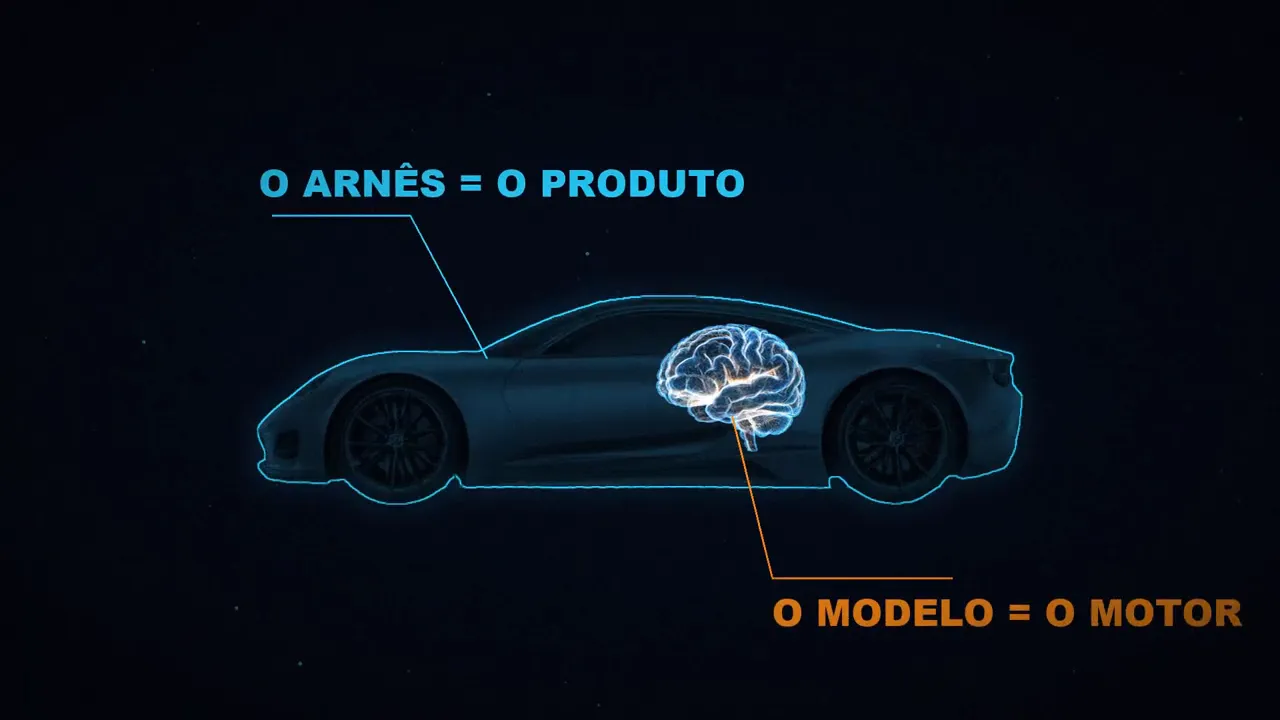
O arnês é o produto. O modelo é o motor. E ninguém compra um carro só pelo motor.
O checklist para produção
O artigo termina com um checklist que resume tudo o que vimos. Eu o reproduzo porque é a parte mais útil para revisar o arnês dos seus próprios agentes:
- Arquivo de instruções raiz com menos de 200 linhas.
- Conhecimento organizado por temas em um diretório.
- Documentação carregada por tarefa.
- Orçamento de contexto por camada, com alertas.
- Regras obsoletas podadas todo mês.
- Agentes separados para gerar código, testar e revisar.
- Ferramentas limitadas para cada agente.
- Passagens entre agentes documentadas.
- Prompt de sistema por papel.
- Decisões, falhas e estado da sessão em arquivos.
- O agente lê a memória ao começar.
- O agente escreve os resultados ao terminar.
- Memória que só cresce, com poda separada.
- Fluxo investigar → planejar → executar → verificar.
- Planos revisados antes da execução nas partes críticas.
- Máximo de arquivos por sessão.
- Arquivos protegidos contra mudanças não autorizadas.
- Verificação depois de cada passo.
- Limite de custo por sessão.
- Limite de tempo com pausa automática.
- Simulação antes de cada implantação.
- Testes passando antes de cada commit.
- Registro de auditoria de cada ação.
Resumindo: o modelo entra com a potência, e o arnês, com todo o resto. Como é o arnês dos seus agentes?
Fontes
Os números deste post são os citados no artigo original; não fui eu que os medi.
- «The Harness Is The Product. The Model Never Was», do nyk (@nykdotdev), 10 de março de 2026.
- O vídeo, nos meus três canais: português, espanhol e inglês.