Señal y ruido
Cada día sale un framework nuevo, un benchmark nuevo y otro lanzamiento que promete multiplicar por diez. La pregunta deja de ser «¿cómo me mantengo al día?» y pasa a ser «¿qué es señal aquí y qué es ruido disfrazado de urgencia?».
Cualquier hoja de ruta queda obsoleta un mes después de publicarse. El framework que dominabas el trimestre pasado ya es legado, y el benchmark que optimizabas lo trucaron y lo sustituyeron. Nos enseñaron un camino lento (temas por niveles, puestos, años de antigüedad) y la IA lo ha cambiado: con buenos prompts y buen criterio, cualquiera saca hoy lo que antes le llevaba un sprint a un ingeniero con dos años de experiencia.
La experiencia sigue contando. Nada sustituye haber visto romperse sistemas, haber depurado una fuga de memoria a las dos de la madrugada o haber defendido la opción aburrida frente a la ingeniosa, y acertar. Ese criterio se acumula. Lo que ya no se acumula es conocer la interfaz del framework de esta semana, que dentro de seis meses será otra.
El campo, además, no tiene destino todavía. Los grandes laboratorios iteran en público, publican regresiones y las parchean en directo. Según el autor, el equipo de Claude Code llegó a sacar una versión un 47 % peor y fueron los usuarios quienes lo detectaron. Nadie tiene el mapa, y eso cambia la pregunta de las credenciales: entre alguien de 22 años que publica demos de agentes y un ingeniero sénior de 35 ya no hay diez años de ventaja. Los dos tienen el mismo lienzo en blanco, y lo que les suma es lanzar cosas y dominar unas pocas piezas que no caducan.
El filtro: cinco preguntas
No puedes seguir los lanzamientos de cada semana, ni deberías intentarlo. Necesitas un filtro, no un feed. El autor propone cinco preguntas que le han funcionado durante dieciocho meses:
- ¿Importará dentro de dos años? Un envoltorio sobre un modelo puntero, una opción de la terminal o «lo mismo que Devin pero para tal cosa» casi nunca. Una pieza básica (un protocolo, un patrón de memoria, una forma de aislar la ejecución), más a menudo sí. Los envoltorios caducan en meses; las piezas básicas duran años.
- ¿Alguien a quien respetas lo ha usado de verdad y lo ha contado con honestidad? El marketing no cuenta; los análisis de fallos, sí. Un «probamos esto en producción y esto es lo que se rompió» vale más que diez anuncios.
- ¿Te obliga a tirar tus trazas, tus reintentos, tu configuración o tu autenticación? Entonces es un framework que quiere ser plataforma, y esos, según el autor, mueren en un 90 % de los casos. Las buenas piezas encajan sin obligarte a migrar.
- ¿Qué te cuesta saltártelo seis meses? Casi siempre, nada: en medio año sabrás más y la versión ganadora estará más clara. Es la pregunta que te deja ignorar nueve de cada diez lanzamientos sin ansiedad.
- ¿Puedes medir si ayuda a tus agentes? Si no, estás adivinando. Los equipos sin evaluaciones funcionan por intuición y publican regresiones.
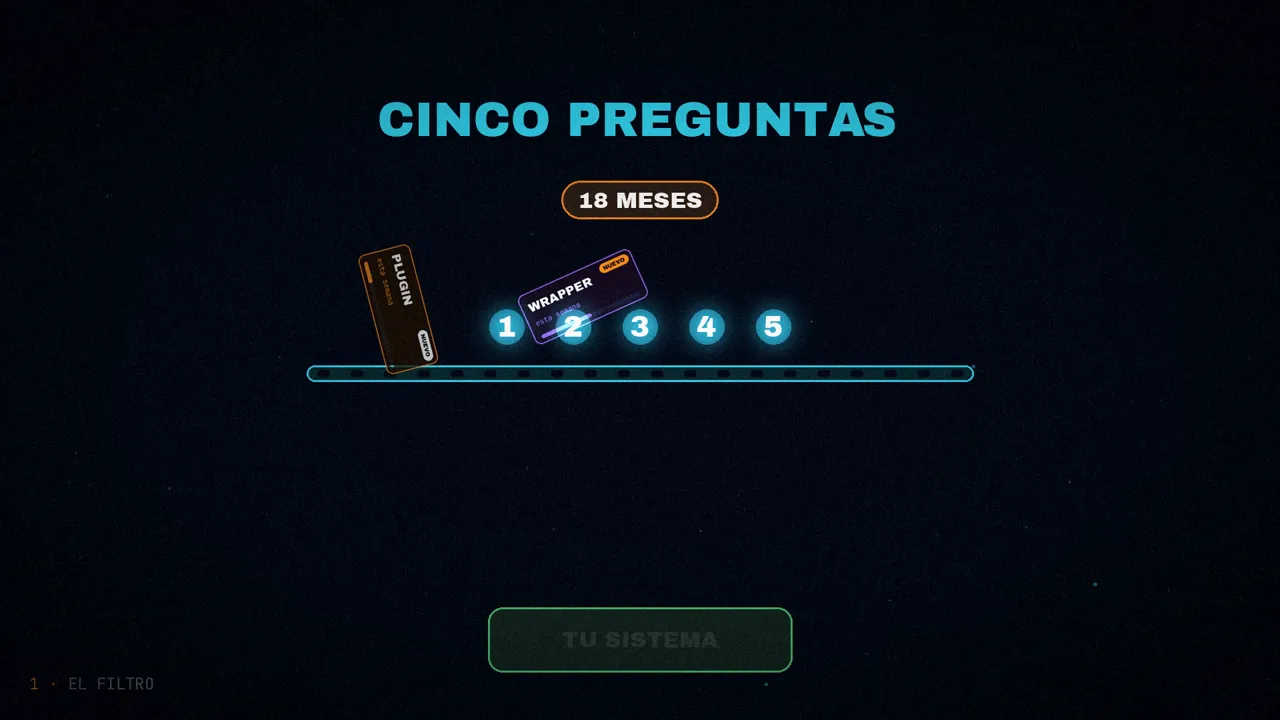
Si te quedas con un solo hábito, que sea este: cuando salga algo nuevo, apunta qué tendrías que ver dentro de seis meses para creer que importa, y vuelve a comprobarlo. Casi siempre la pregunta se habrá respondido sola.
Debajo hay una habilidad más difícil de nombrar: aceptar quedar poco moderno por lo que no adoptas. El framework viral de esta semana tendrá dos semanas de fans; medio año después, la mitad están abandonados. Esperar, observar y decir «lo sabré en seis meses» es, para el autor, la verdadera habilidad profesional de este campo. Todos saben leer lanzamientos; casi nadie sabe no reaccionar a ellos.
Aprender: ingeniería de contexto
Lo que merece la pena aprender son conceptos, patrones y la forma de las cosas: ideas que sobreviven a los cambios de modelo, de framework y de paradigma. Si las entiendes, aprendes cualquier herramienta en un fin de semana. El autor elige siete, y la primera es la ingeniería de contexto.
El cambio de nombre de «ingeniería de prompts» a «ingeniería de contexto» no es cosmético. Al modelo ya no le escribes una instrucción ingeniosa: en cada paso le montas un contexto de trabajo con instrucciones, esquemas de herramientas, documentos recuperados, salidas anteriores, notas y un historial comprimido. El comportamiento del agente sale de lo que metes en esa ventana.
El contexto es estado. Cada token de ruido resta calidad al razonamiento, y la degradación del contexto es un fallo real: en el paso ocho de una tarea de diez, el objetivo original puede quedar enterrado bajo salidas de herramientas. Los equipos con agentes fiables resumen, comprimen y podan, versionan las descripciones de sus herramientas, cachean solo lo que no cambia y tratan la ventana de contexto como un buen ingeniero trata la RAM.
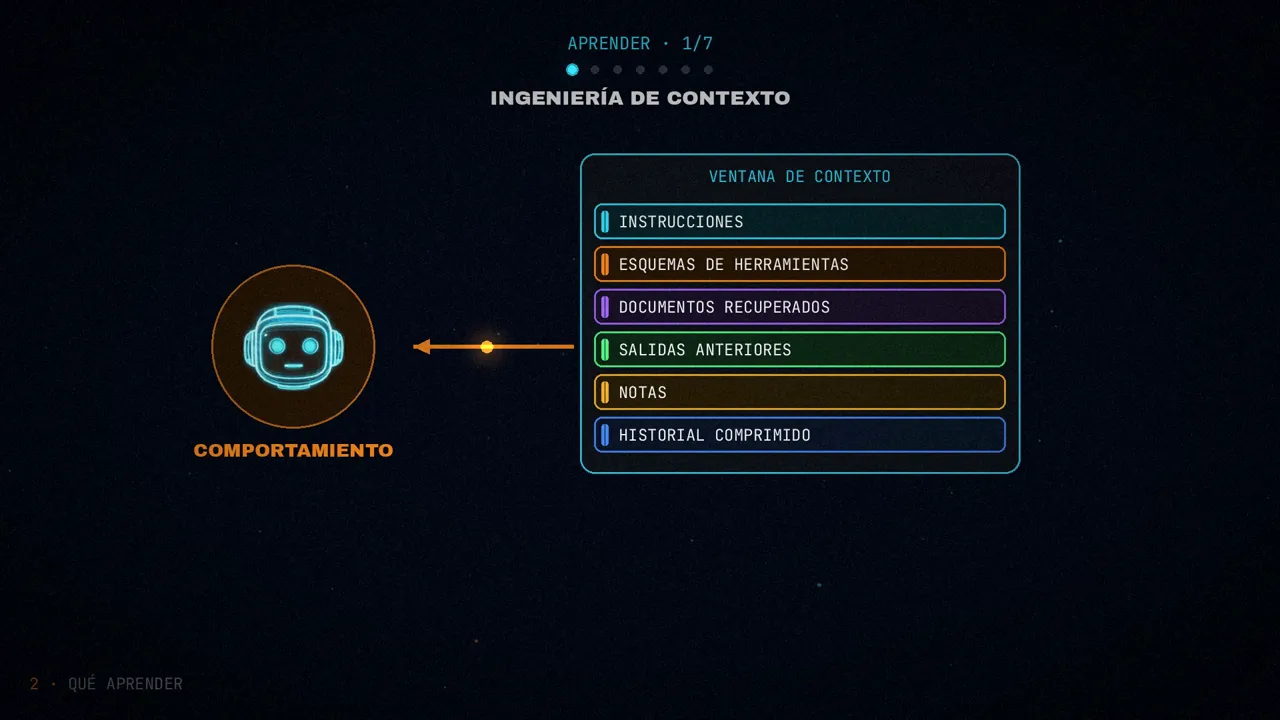
La prueba que propone: activa el registro completo de trazas de un agente en producción, mira el contexto en el paso uno y en el paso siete, y cuenta cuántos tokens siguen aportando algo. La primera vez da vergüenza; al arreglarlo, el mismo agente gana fiabilidad sin tocar el modelo ni el prompt. Para empezar, recomienda la guía de Anthropic «Effective Context Engineering for AI Agents» y su análisis del sistema de investigación multiagente.
Aprender: diseño de herramientas
Las herramientas son donde los agentes tocan tu negocio. El modelo elige herramienta por su nombre y su descripción, reintenta según el mensaje de error que recibe, y acierta o falla según si el contrato de la herramienta encaja con lo que un modelo de lenguaje sabe expresar.
- De cinco a diez herramientas con buen nombre ganan a veinte mediocres.
- Los nombres deberían leerse como verbos en inglés llano.
- Las descripciones dicen cuándo usarla y cuándo no.
- Los errores son algo con lo que el modelo puede actuar: «superados los 500 tokens, prueba a resumir antes» gana por goleada a «Error: 400 Bad Request».
Según la guía, un equipo informó de un 40 % menos de bucles de reintento solo por reescribir sus mensajes de error. Las mayores mejoras de fiabilidad, insiste el autor, suelen estar en las herramientas, no en seguir retocando el prompt. Su punto de partida: «Writing tools for agents», de Anthropic.
Aprender: orquestador y subagentes
El debate multiagente de 2024 y 2025 terminó en una síntesis. Los sistemas ingenuos, con varios agentes escribiendo a la vez en un estado compartido, fallan de forma catastrófica porque los errores se acumulan. Un solo agente en bucle llega más lejos de lo que parece. Y solo hay una forma multiagente que funciona en producción: un orquestador que delega tareas acotadas y de solo lectura en subagentes aislados, y luego junta sus resultados.
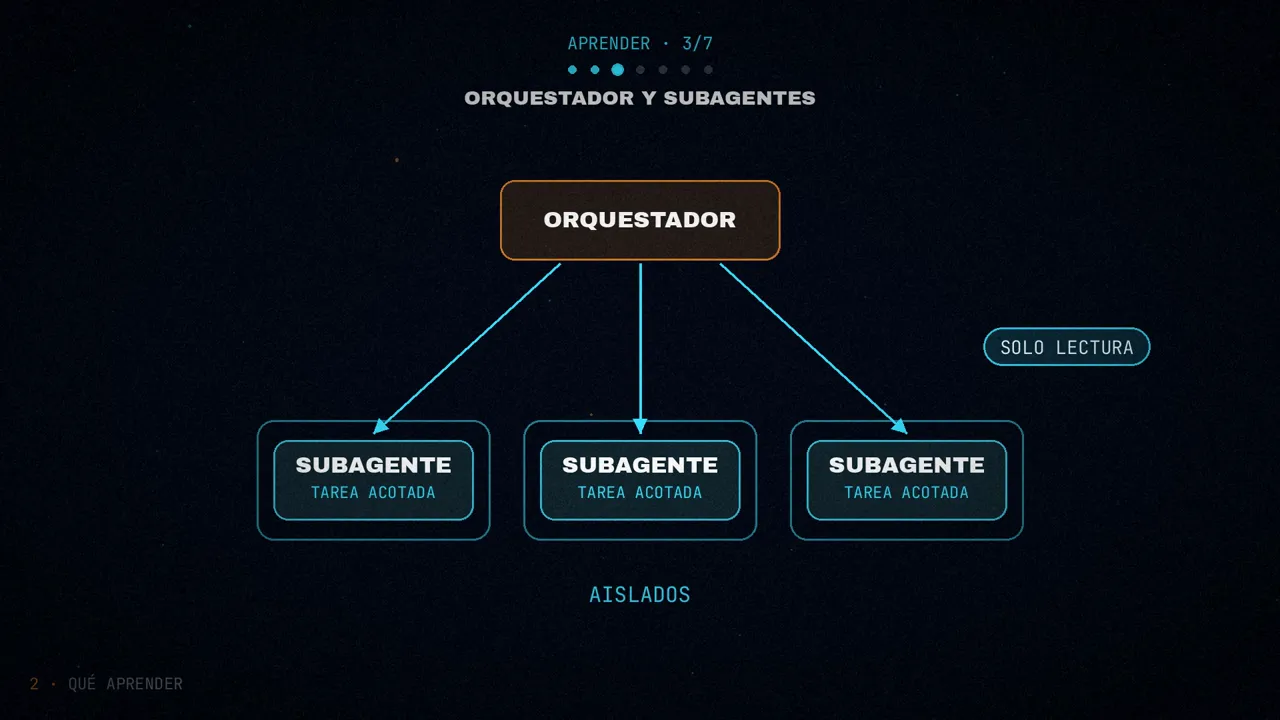
Así funcionan el sistema de investigación de Anthropic y los subagentes de Claude Code: contextos pequeños y enfocados que no pueden modificar el estado compartido. El autor recomienda leer juntos «Don't Build Multi-Agents», de Cognition, y «How we built our multi-agent research system», de Anthropic: parecen opuestos y dicen lo mismo. Su consejo: por defecto, un solo agente; el orquestador solo cuando choques contra un muro real (presión de contexto, latencia por llamadas en serie o tareas tan distintas que piden contextos separados).
Aprender: evaluaciones
Todos los equipos con agentes fiables tienen evaluaciones; para el autor es el hábito con más palanca del campo y también en el que menos se invierte. Lo que funciona: recoger las trazas de producción, etiquetar los fallos y convertirlos en un conjunto de regresión al que se suma cada fallo nuevo. Un modelo como juez para lo subjetivo, comprobaciones exactas o por código para el resto, y toda la batería antes de cambiar un prompt, un modelo o una herramienta.
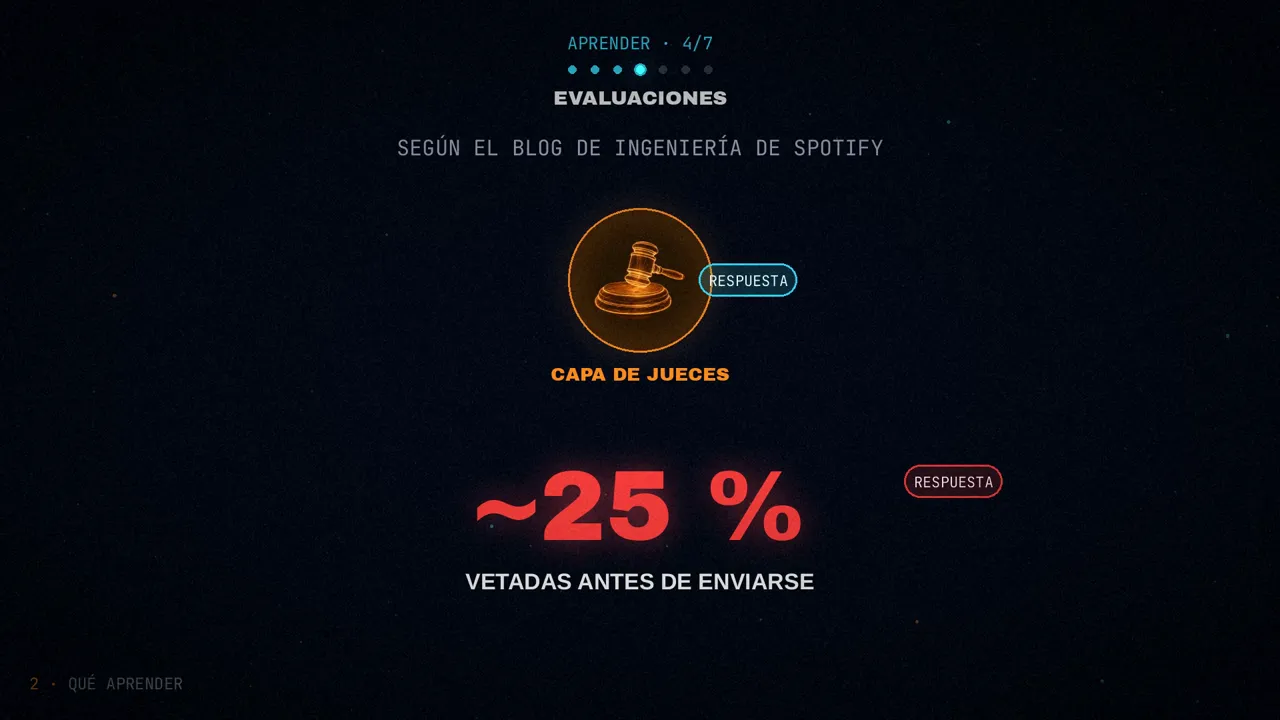
El blog de ingeniería de Spotify contó que su capa de jueces veta alrededor del 25 % de las respuestas de su agente antes de enviarlas: sin ella, uno de cada cuatro resultados malos habría llegado a los usuarios.
Sale una versión nueva del modelo, el framework rompe algo o el proveedor retira un servicio, y tus evaluaciones son lo único que te dice si el agente sigue haciendo su trabajo. Las herramientas (Braintrust, Langfuse, LangSmith) están bien; ninguna es el cuello de botella. El cuello es no tener ejemplos etiquetados, y los primeros cincuenta se etiquetan a mano en una tarde.
Aprender: el arnés, MCP y el aislamiento
El sistema de archivos como estado y el bucle pensar, actuar, observar. Para un agente que hace trabajo real de varios pasos, la arquitectura duradera es esa: piensa, actúa, observa y repite, con los archivos (o un almacén estructurado) como fuente de verdad y cada acción registrada y reproducible. Claude Code, Cursor, Devin, Aider, OpenHands y goose llegaron a lo mismo. El modelo no guarda estado, así que el arnés tiene que guardarlo.
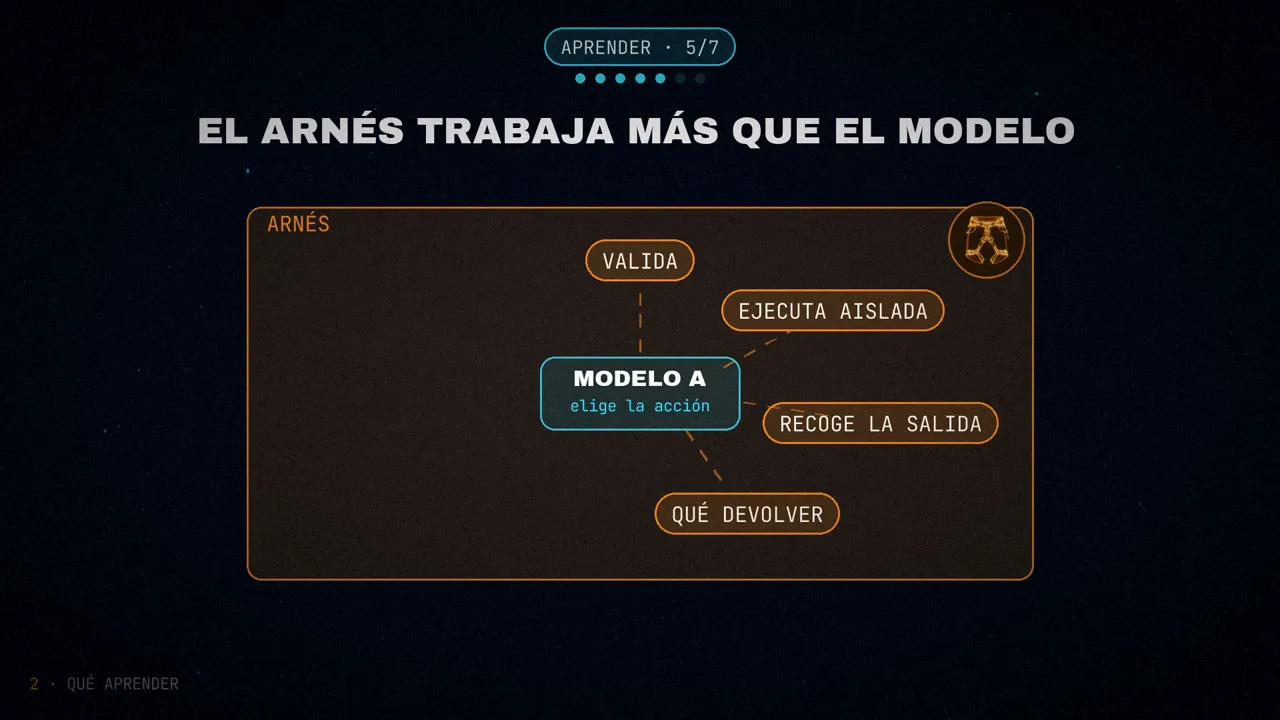
De ahí sale una idea más profunda: en cualquier agente serio, el arnés trabaja más que el modelo. El modelo elige la siguiente acción; el arnés la valida, la ejecuta aislada, recoge la salida, decide qué devolver, cuándo parar, cuándo guardar un punto de control y cuándo lanzar un subagente. Cambia el modelo por otro parecido y, con un buen arnés, todo sigue funcionando; pon un arnés peor y hasta el mejor modelo olvida a ratos qué estaba haciendo.
MCP, como modelo. No basta con saber llamar a sus servidores: hay que entender la separación limpia entre capacidades del agente, herramientas y recursos, con autenticación y transporte ampliables por debajo. Cuando lo entiendes, cualquier otro framework de integración parece una versión peor. Hoy lo custodia la Linux Foundation y lo apoyan los grandes proveedores; lo de «el USB-C de la IA» ya no suena irónico.
El aislamiento como pieza básica. Todos los agentes de programación en producción se ejecutan aislados, y todos los agentes de navegador han sufrido inyecciones de prompt indirectas. Lo básico: aislar procesos, controlar la salida a la red, limitar los secretos y poner fronteras de permisos entre el agente y sus herramientas. Quien lo añade tras la auditoría de seguridad del cliente pierde la venta; quien lo construye desde la primera semana pasa las compras de las grandes empresas sin sudar.
Con qué construir
Son las elecciones del autor en abril de 2026, y su consejo es elegir lo aburrido:
| Capa | Elección del autor |
|---|---|
| Orquestación | LangGraph por defecto (según él, lo usa alrededor de un tercio de las grandes empresas con agentes; es verboso, pero esa verbosidad es lo que necesitas controlar). Mastra si vives en TypeScript. Pydantic AI para empezar de cero con tipos (llegó a la v1.0 a finales de 2025). Los SDK de agentes de Anthropic y OpenAI, dentro de los nodos de LangGraph, no como orquestador principal. |
| Protocolo | MCP, sin más: casi siempre encuentras un servidor antes de tener que construirlo. |
| Memoria | Por nivel de autonomía: Mem0 para personalizar chats, Zep para conversaciones en producción que siguen entidades, Letta para agentes coherentes durante días o semanas. El error es coger un framework de memoria antes de tener un problema de memoria. |
| Observabilidad y evals | Langfuse como opción abierta por defecto; LangSmith si ya usas LangChain; Braintrust para comparaciones rigurosas; OpenLLMetry/Traceloop para OpenTelemetry neutral. Necesitas trazas (qué hizo el agente) y evaluaciones (si hoy es mejor que ayer). |
| Ejecución aislada | E2B para ejecutar código, Browserbase (con Stagehand) para el navegador, Computer Use de Anthropic para controlar un escritorio y Modal para ráfagas cortas. Nunca código sin aislar. |
| Modelos | Claude Opus 4.7 y Sonnet 4.6 para usar herramientas con fiabilidad (Sonnet, el mejor equilibrio coste-rendimiento); GPT-5.4 y 5.5 para razonar en la terminal; Gemini 2.5 y 3 para contextos largos o multimodales; DeepSeek-V3.2 o Qwen 3.6 cuando manda el coste. |
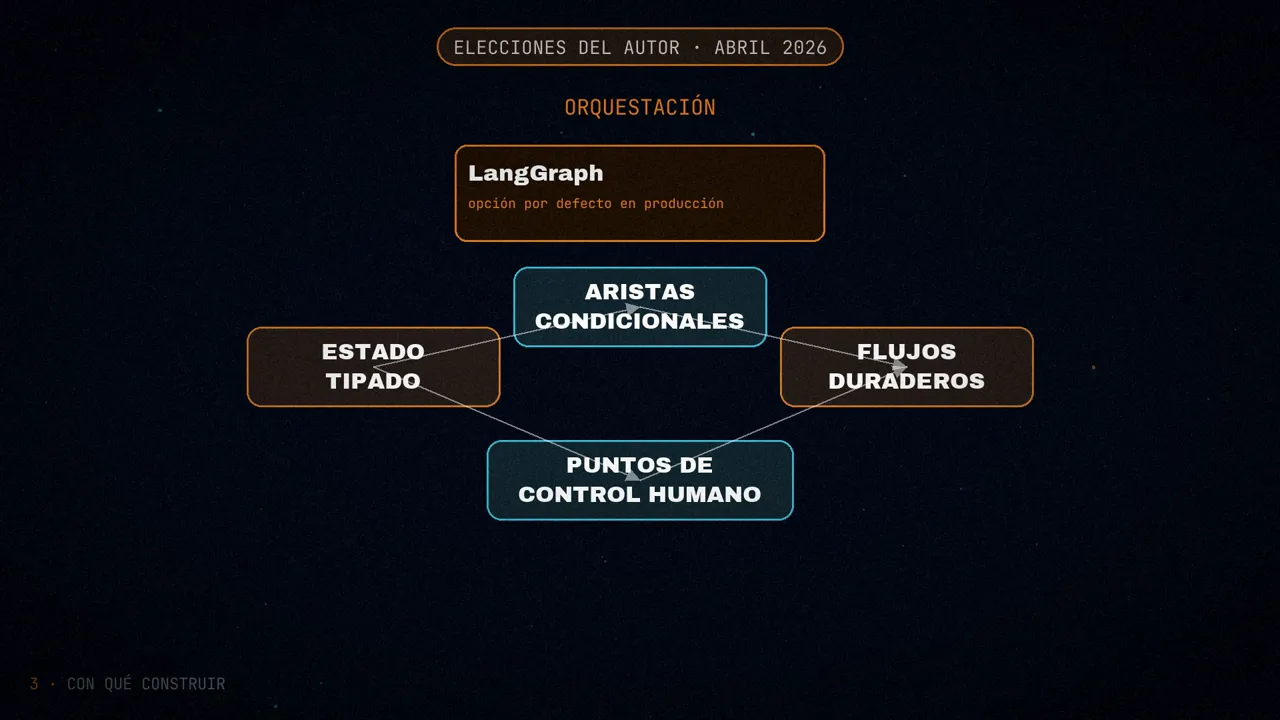
Y una regla para los modelos: trátalos como piezas intercambiables. Si tu agente solo funciona con uno, eso es un mal olor, no una ventaja. Que decidan tus evaluaciones, y reevalúa cada trimestre, no cada semana.
Qué saltarse
Te dirán que lo aprendas todo. Saltártelo cuesta poco y ahorra mucho tiempo. La lista del autor:
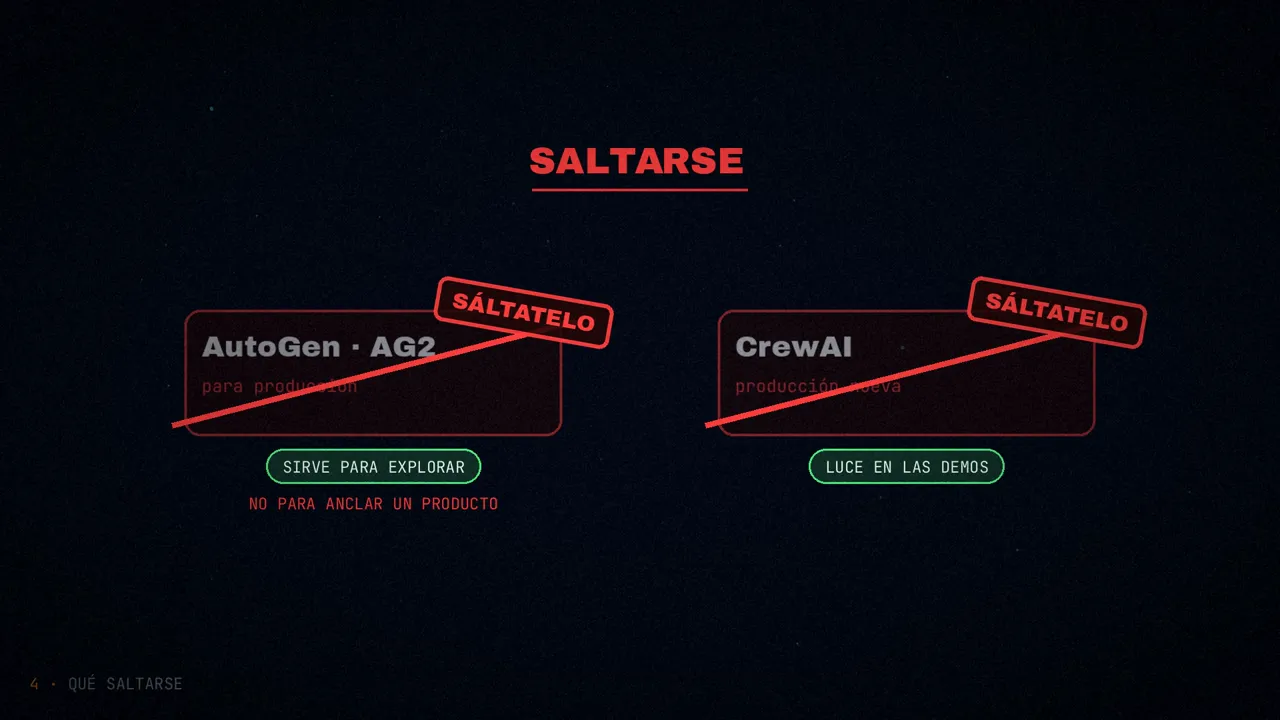
- AutoGen y AG2 para producción: pasó a mantenimiento comunitario y las versiones se frenaron. Bien para explorar, no para anclar un producto.
- CrewAI para sistemas nuevos en producción: está en todas partes porque luce en las demos; úsalo para prototipos si quieres.
- Semantic Kernel, salvo que estés atado al ecosistema de Microsoft. DSPy, salvo que optimices programas de prompts a escala.
- Agentes que escriben código como arquitectura base: investigación interesante, pero no un patrón de producción todavía.
- Las promesas de agentes autónomos: la línea de AutoGPT y BabyAGI está muerta como producto. El sector se quedó con la ingeniería agéntica: supervisada, acotada y evaluada.
- Tiendas de agentes y plataformas horizontales para construir cualquier agente como cliente (con las excepciones de Salesforce Agentforce y ServiceNow Now Assist, que viven dentro de herramientas que ya usas).
- Perseguir SWE-bench u OSWorld: investigadores de Berkeley documentaron en 2025 que casi cualquier benchmark público se puede trucar sin resolver la tarea.
- Multiagentes en paralelo ingenuos: si no puedes dibujar el orquestador con sus límites de lectura y escritura en una servilleta, no lo lances.
- El precio por asiento en productos nuevos de agentes: el mercado se ha movido a cobrar por resultado y por uso.
- El próximo framework de Hacker News: espera seis meses.
Cómo moverse, paso a paso
Si quieres adoptar agentes, y no solo seguirles el ritmo, esta secuencia es aburrida y funciona:
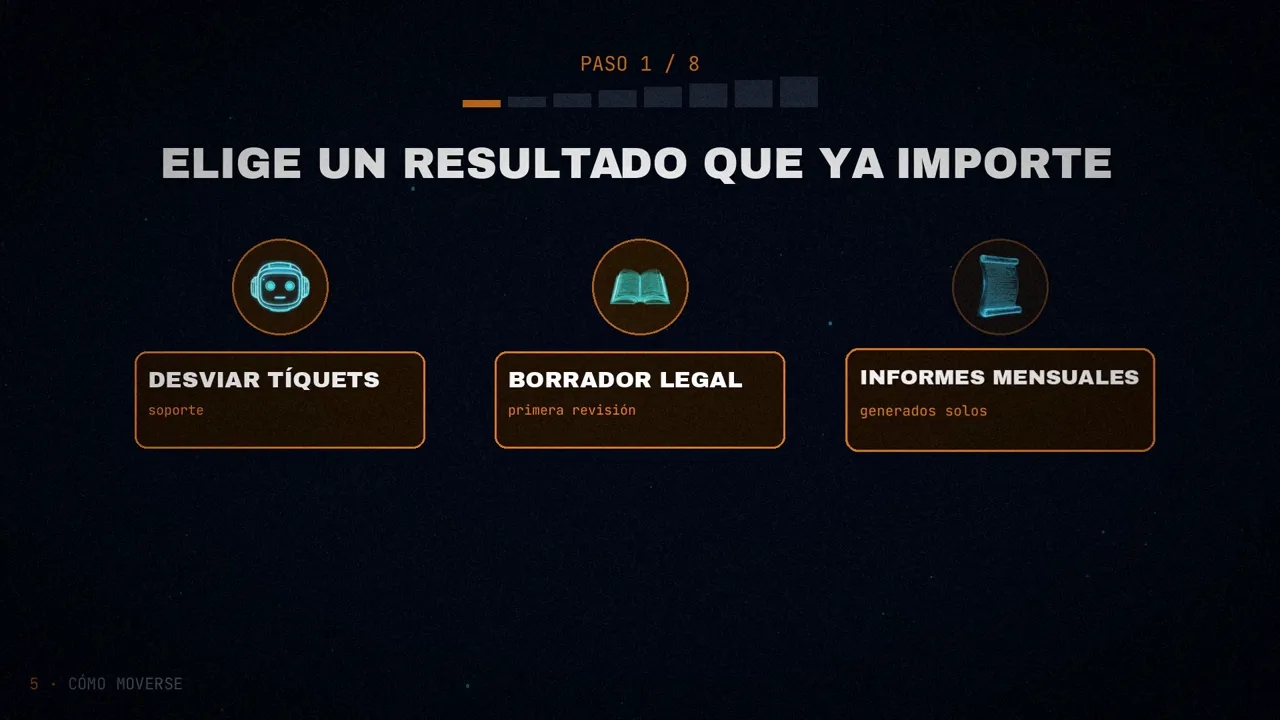
- Elige un resultado que ya importe. Nada de proyectos lunáticos ni de «plataformas de agentes»: desviar tíquets de soporte, un primer borrador de revisión legal, cualificar contactos, informes mensuales. Ese número es tu objetivo de evaluación desde el primer día, y restringe todo lo demás: el framework, el modelo, la memoria o los subagentes salen de ahí.
- Trazas y evaluaciones antes de lanzar nada. Langfuse o LangSmith, y cincuenta ejemplos etiquetados a mano. Montarlo después cuesta, según el autor, unas diez veces más.
- Un solo agente. LangGraph o Pydantic AI, un modelo como Sonnet o GPT, de tres a siete herramientas bien diseñadas y los archivos o una base de datos como estado. A poca gente, mirando las trazas.
- Trátalo como un producto, no como un proyecto. Sus fallos son tu hoja de ruta; cada cambio pasa por las evaluaciones.
- Amplía el alcance cuando te lo hayas ganado. Subagentes cuando el contexto sea el cuello; memoria cuando una ventana no dé para más; uso del ordenador cuando no haya API.
- Infraestructura aburrida: MCP, E2B o Browserbase, la base de datos que ya tienes y tus sistemas de siempre.
- Vigila la economía unitaria desde el primer día. El ejemplo del autor: una prueba de 0,50 $ por ejecución se convierte en 50.000 $ al mes con un volumen moderado.
- Reevalúa los modelos cada trimestre, no cada semana.
Leer la marea
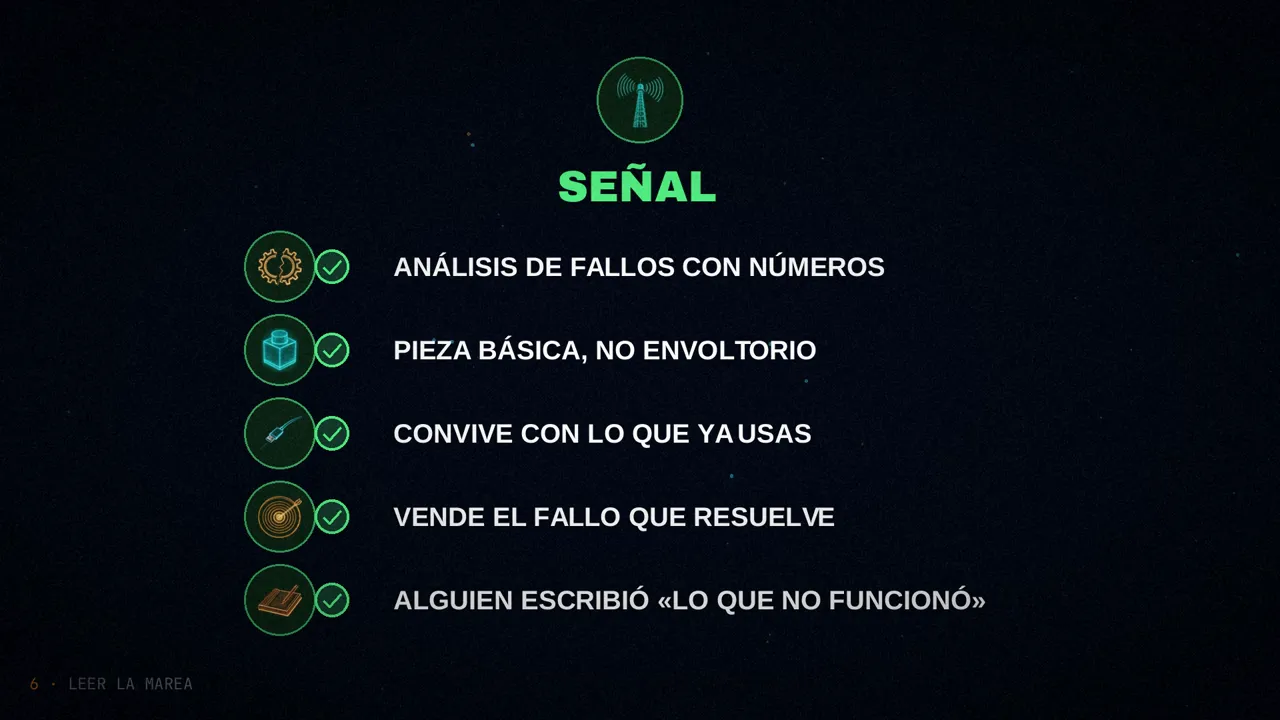
Un equipo respetado publica un análisis de fallos con números. Es una pieza básica, no un envoltorio. Convive con lo que ya usas. Vende el fallo que resuelve, no la capacidad que habilita. Lleva el tiempo suficiente para que alguien haya escrito «lo que no funcionó».
Hay demos sin casos en producción tras treinta días. Los saltos de benchmark son demasiado limpios. Promete «autónomo», «sistema operativo de agentes» o «construye cualquier agente» sin matices. Su documentación da por hecho que tirarás tus trazas y tu configuración. Las estrellas en GitHub suben sin commits ni versiones.
Y un hábito semanal: treinta minutos el viernes para leer tres cosas (el blog de ingeniería de Anthropic, las notas de Simon Willison y Latent Space), uno o dos análisis de fallos si los hay, y nada más.
Qué vigilar
Seis cosas cuya pregunta «¿es señal?» aún no está resuelta:
- El modelo de Replit Agent 4, que bifurca agentes en paralelo sin pisarse el estado.
- El precio por resultado, que Sierra y Harvey validan en sus nichos.
- Las skills como forma de empaquetar capacidades (AGENTS.md y carpetas de skills): ¿se estandarizarán como MCP?
- La regresión de calidad de Claude Code en abril de 2026 y su análisis posterior: que los usuarios la vieran antes que la monitorización dice lo inmaduras que siguen siendo las evaluaciones en producción.
- La voz como canal principal de soporte: en Sierra superó al texto a finales de 2025.
- Los modelos abiertos acortando distancias, como DeepSeek y Qwen.
Para cada una vale la misma pregunta: qué tendrías que ver dentro de seis meses para creerlo.
La apuesta poco convencional
Cada framework que no adoptas es una migración que no debes, y cada benchmark que no persigues es un trimestre de foco que conservas. Las empresas que ganan este ciclo (Sierra, Harvey, Cursor) eligieron objetivos estrechos, construyeron una disciplina aburrida y dejaron pasar el ruido.
El camino de siempre era elegir una pila, dominarla durante años y subir la escalera. Pero la pila cambia cada trimestre, y las empresas, sus frameworks y sus protocolos tienen meses o pocos años. No hay escalera, porque el edificio cambia de planta continuamente. Lo que queda es el método más antiguo: haz algo, ponlo en internet y deja que tu trabajo te presente. La credencial es lo que construyes.
La habilidad que necesitas no es «agentes»: es saber qué trabajo rinde a largo plazo. La ingeniería de contexto, el diseño de herramientas, el patrón orquestador, la disciplina de evaluar y la mentalidad del arnés rinden; saberte la interfaz del framework que salió el martes, no.
Cómo leer este artículo
- Es una guía de opinión. Las elecciones de herramientas y modelos son del autor, en abril de 2026.
- Las cifras sin fuente son suyas: el 90 % de mortalidad de los frameworks-plataforma, el «un tercio» de LangGraph o el «diez veces más caro» son estimaciones, no medidas.
- Las de terceros, como de terceros: el 47 % de la regresión de Claude Code lo cuenta el autor; el 40 % es de un equipo sin nombre; el 25 % de Spotify, de su blog de ingeniería.
- «Saltarse» no es «malo»: el propio autor deja AutoGen para explorar y CrewAI para prototipos.
En resumen
Lo que me llevo: no hace falta aprenderlo todo, sino lo que rinde, y saltarse lo demás. Elige un resultado, monta trazas y evaluaciones antes de lanzar, usa MCP, aísla la ejecución, empieza con un solo agente, reevalúa los modelos cada trimestre y lee tres cosas cada viernes.
La era premia a quien hace la cosa más que a quien sabe describirla: construye y ponlo en internet.
¿Qué framework te vas a saltar este año?
Fuentes
- «What to Learn, Build, and Skip in AI Agents (2026)», de Rohit (@rohit4verse), en X (29 de abril de 2026).
- El vídeo, en mis canales: español e inglés.