Sinal e ruído
Todo dia sai um framework novo, um benchmark novo e mais um lançamento que promete multiplicar tudo por dez. A pergunta deixa de ser «como eu acompanho tudo isso?» e passa a ser «o que é sinal aqui e o que é ruído fantasiado de urgência?».
Qualquer roteiro fica obsoleto um mês depois de publicado. O framework que você dominava no trimestre passado já é legado, e o benchmark que você otimizava foi burlado e substituído. Ensinaram um caminho lento (temas por nível, cargos, anos de casa) e a IA reescreveu isso: com bons prompts e bom critério, qualquer pessoa entrega hoje o que antes levava um sprint para um engenheiro com dois anos de experiência.
A experiência continua contando. Nada substitui ter visto sistemas quebrarem, ter depurado um vazamento de memória às duas da manhã ou ter defendido a opção chata contra a engenhosa, e acertado. Esse critério se acumula. O que já não se acumula é conhecer a interface do framework desta semana, que daqui a seis meses será outra.
O campo, além disso, ainda não tem destino. Os grandes laboratórios iteram em público, lançam regressões e corrigem ao vivo. Segundo o autor, a equipe do Claude Code chegou a lançar uma versão 47 % pior, e foram os usuários que perceberam. Ninguém tem o mapa, e isso muda a questão das credenciais: entre alguém de 22 anos que publica demos de agentes e um engenheiro sênior de 35 já não há dez anos de vantagem. Os dois têm a mesma tela em branco, e o que soma para eles é lançar coisas e dominar umas poucas peças que não vencem.
O filtro: cinco perguntas
Você não consegue acompanhar os lançamentos de cada semana, e nem deveria tentar. Você precisa de um filtro, não de um feed. O autor propõe cinco perguntas que funcionaram para ele nos últimos dezoito meses:
- Isso vai importar daqui a dois anos? Um wrapper sobre um modelo de ponta, uma opção de linha de comando ou «o Devin, só que para tal coisa»: quase nunca. Uma peça básica (um protocolo, um padrão de memória, uma forma de isolar a execução): com mais frequência, sim. Wrappers vencem em meses; peças básicas duram anos.
- Alguém que você respeita construiu algo real em cima e contou com honestidade? Marketing não conta; análises de falhas, sim. Um «testamos isso em produção e foi isto que quebrou» vale mais que dez anúncios.
- Adotar isso obriga você a jogar fora seus traces, retries, configuração ou autenticação? Então é um framework querendo ser plataforma, e esses, segundo o autor, morrem em 90 % dos casos. As boas peças se encaixam sem forçar uma migração.
- Quanto custa pular isso por seis meses? Quase sempre, nada: em meio ano você vai saber mais e a versão vencedora vai estar mais clara. É a pergunta que deixa você ignorar nove de cada dez lançamentos sem ansiedade.
- Dá para medir se ajuda seus agentes? Se não dá, você está chutando. Equipes sem avaliações funcionam na intuição e lançam regressões.
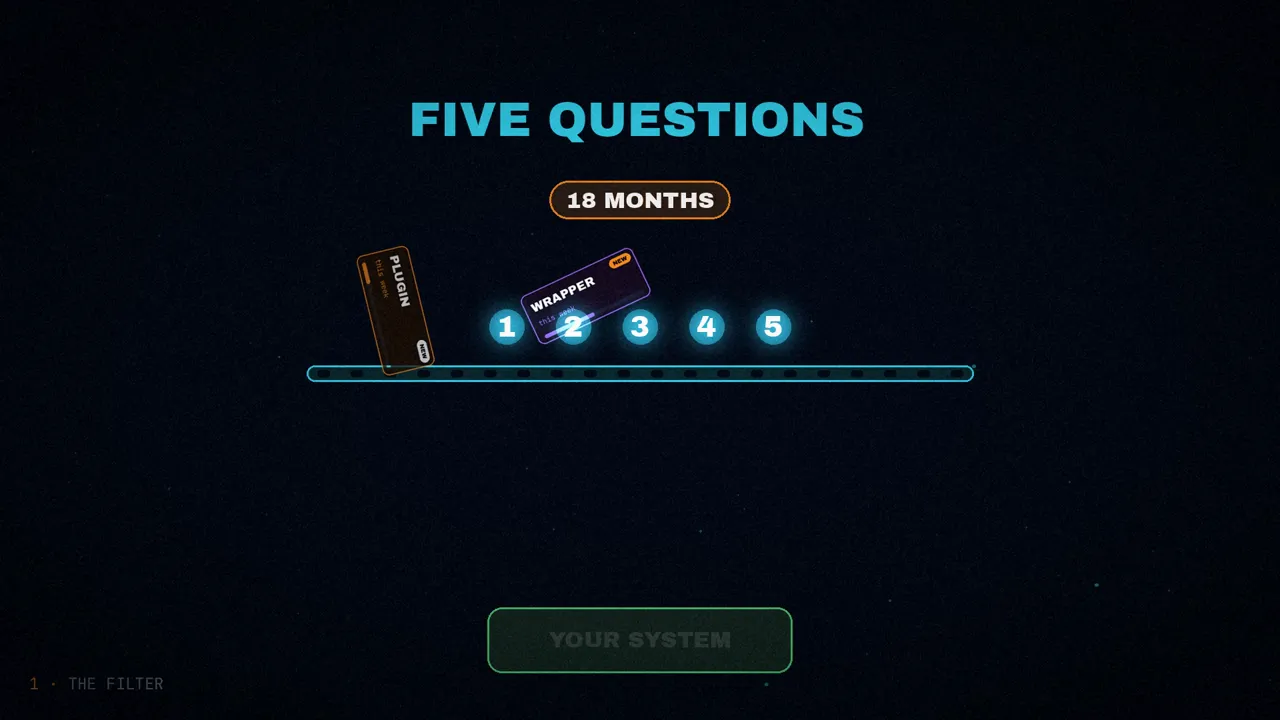
Se for para ficar com um único hábito, que seja este: quando sair algo novo, anote o que você precisaria ver daqui a seis meses para acreditar que importa, e volte para conferir. Quase sempre a pergunta terá se respondido sozinha.
Por baixo há uma habilidade mais difícil de nomear: aceitar ficar pouco descolado pelo que você não adota. O framework viral desta semana terá duas semanas de fãs; seis meses depois, metade está abandonada. Esperar, observar e dizer «vou saber em seis meses» é, para o autor, a verdadeira habilidade profissional deste campo. Todo mundo sabe ler lançamentos; quase ninguém sabe não reagir a eles.
Aprender: engenharia de contexto
O que vale a pena aprender são conceitos, padrões e a forma das coisas: ideias que sobrevivem a trocas de modelo, de framework e de paradigma. Se você as entende, aprende qualquer ferramenta em um fim de semana. O autor escolhe sete, e a primeira é a engenharia de contexto.
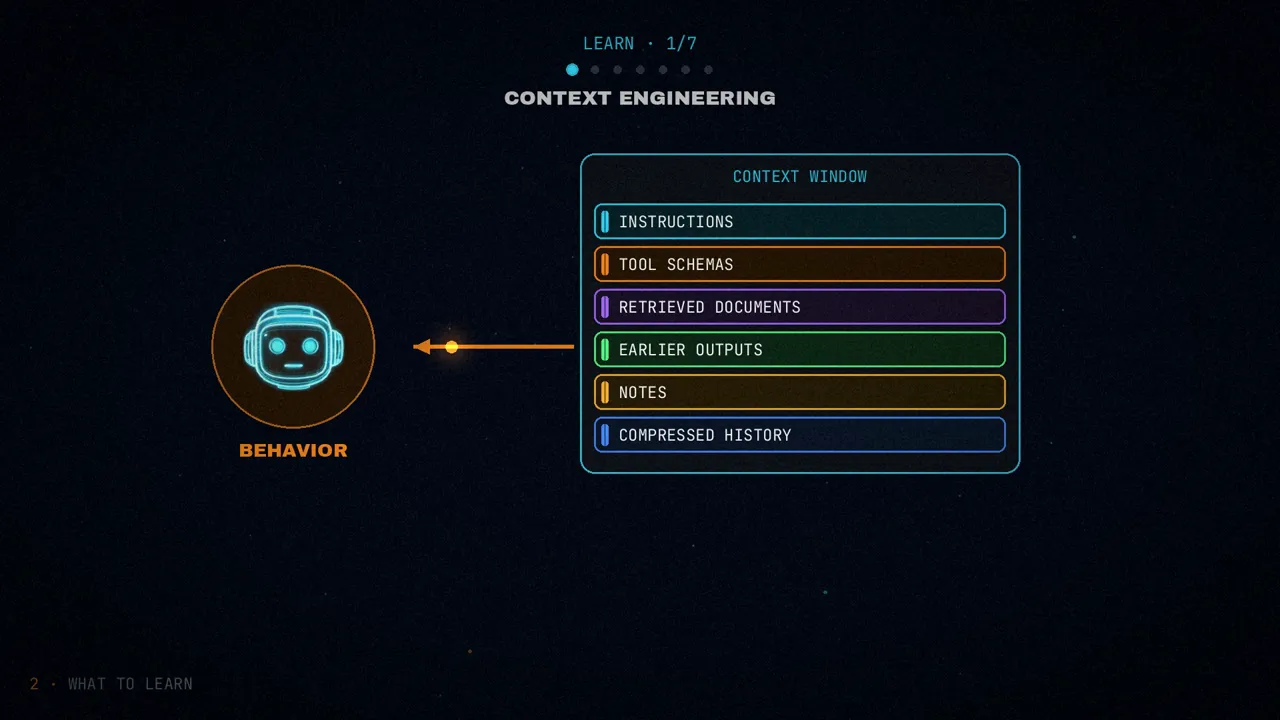
A troca de nome de «engenharia de prompts» para «engenharia de contexto» não é cosmética. Você já não escreve uma instrução engenhosa para o modelo: a cada passo monta um contexto de trabalho com instruções, esquemas de ferramentas, documentos recuperados, saídas anteriores, anotações e um histórico comprimido. O comportamento do agente sai do que você coloca nessa janela.
Contexto é estado. Cada token de ruído tira qualidade do raciocínio, e a degradação do contexto é uma falha real: no passo oito de uma tarefa de dez, o objetivo original pode ficar enterrado sob saídas de ferramentas. As equipes com agentes confiáveis resumem, comprimem e podam, versionam as descrições das ferramentas, fazem cache só do que não muda e tratam a janela de contexto como um bom engenheiro trata a RAM.
O teste que ele propõe: ative o registro completo de traces de um agente em produção, olhe o contexto no passo um e no passo sete, e conte quantos tokens ainda contribuem com algo. Na primeira vez dá vergonha; ao corrigir, o mesmo agente ganha confiabilidade sem mexer no modelo nem no prompt. Para começar, ele recomenda o guia da Anthropic «Effective Context Engineering for AI Agents» e a análise do sistema de pesquisa multiagente deles.
Aprender: design de ferramentas
As ferramentas são onde os agentes tocam o seu negócio. O modelo escolhe a ferramenta pelo nome e pela descrição, tenta de novo de acordo com a mensagem de erro que recebe, e acerta ou erra conforme o contrato da ferramenta combina ou não com o que um modelo de linguagem sabe expressar.
- De cinco a dez ferramentas bem nomeadas ganham de vinte medíocres.
- Os nomes deveriam soar como verbos em inglês simples.
- As descrições dizem quando usar a ferramenta e quando não.
- Os erros são algo com que o modelo pode agir: «limite de 500 tokens excedido, tente resumir antes» ganha de lavada de «Error: 400 Bad Request».
Segundo o guia, uma equipe relatou 40 % menos loops de nova tentativa só por reescrever as mensagens de erro. Os maiores ganhos de confiabilidade, insiste o autor, costumam estar nas ferramentas, não em continuar mexendo no prompt. O ponto de partida dele: «Writing tools for agents», da Anthropic.
Aprender: orquestrador e subagentes
O debate multiagente de 2024 e 2025 terminou numa síntese. Os sistemas ingênuos, com vários agentes escrevendo ao mesmo tempo num estado compartilhado, falham de forma catastrófica porque os erros se acumulam. Um único agente em loop vai mais longe do que parece. E só existe uma forma multiagente que funciona em produção: um orquestrador que delega tarefas delimitadas e somente leitura a subagentes isolados, e depois junta os resultados.
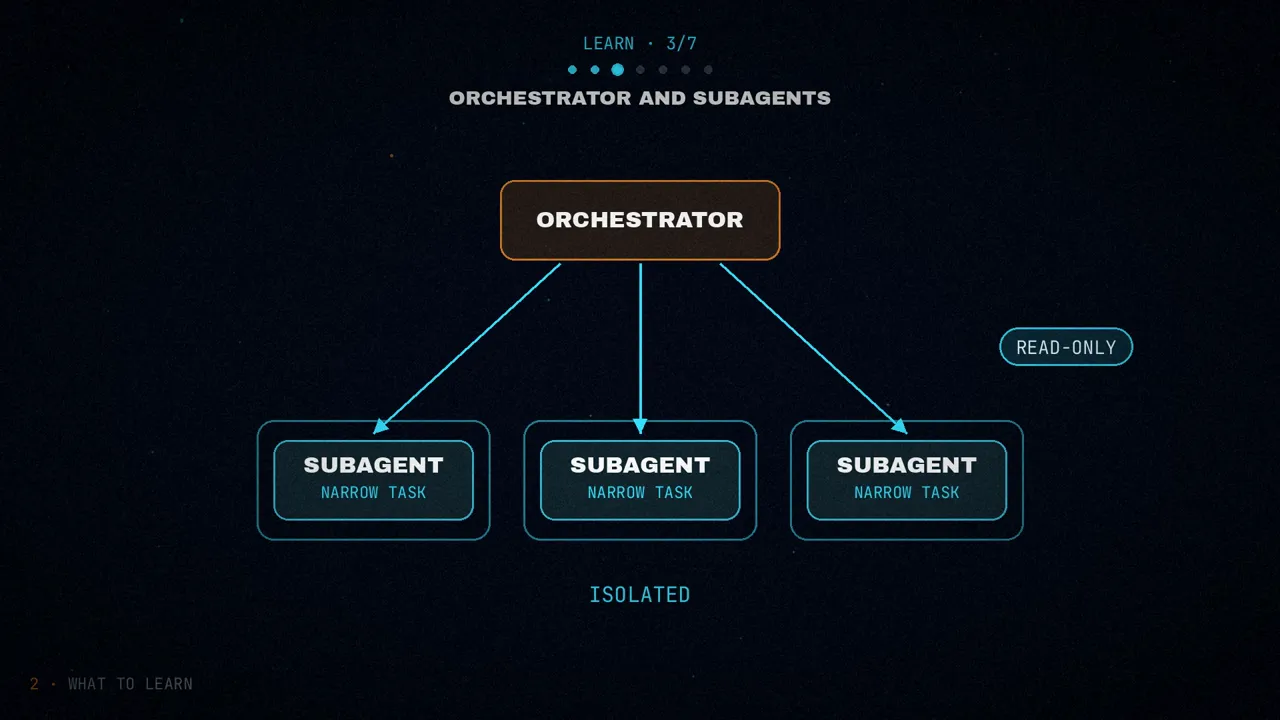
É assim que funcionam o sistema de pesquisa da Anthropic e os subagentes do Claude Code: contextos pequenos e focados que não podem alterar o estado compartilhado. O autor recomenda ler juntos «Don't Build Multi-Agents», da Cognition, e «How we built our multi-agent research system», da Anthropic: parecem opostos e dizem a mesma coisa. O conselho dele: por padrão, um único agente; o orquestrador só quando você bater num muro de verdade (pressão de contexto, latência por chamadas em série ou tarefas tão diferentes que pedem contextos separados).
Aprender: avaliações
Toda equipe com agentes confiáveis tem avaliações; para o autor é o hábito com mais alavanca do campo e também o que recebe menos investimento. O que funciona: recolher os traces de produção, rotular as falhas e transformá-las num conjunto de regressão que cresce a cada falha nova. Um modelo como juiz para o que é subjetivo, verificações exatas ou por código para o resto, e a bateria inteira antes de trocar um prompt, um modelo ou uma ferramenta.
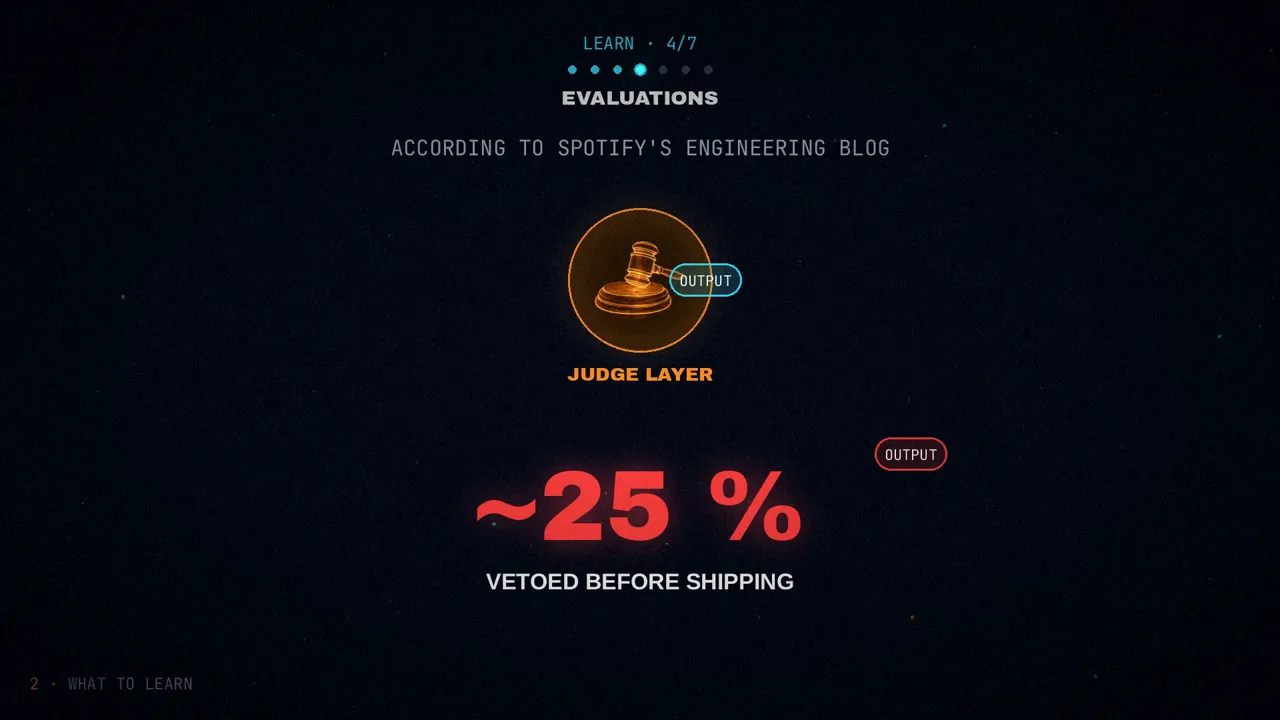
O blog de engenharia do Spotify contou que a camada de juízes deles veta cerca de 25 % das respostas do agente antes de enviá-las: sem ela, um em cada quatro resultados ruins teria chegado aos usuários.
Sai uma versão nova do modelo, o framework quebra algo ou o fornecedor desativa um serviço, e suas avaliações são a única coisa que diz se o agente continua fazendo o trabalho. As ferramentas (Braintrust, Langfuse, LangSmith) são boas; nenhuma é o gargalo. O gargalo é não ter exemplos rotulados, e os primeiros cinquenta se rotulam à mão numa tarde.
Aprender: o harness, MCP e o isolamento
O sistema de arquivos como estado e o loop pensar, agir, observar. Para um agente que faz trabalho real de vários passos, a arquitetura duradoura é essa: pensa, age, observa e repete, com os arquivos (ou um armazenamento estruturado) como fonte da verdade e cada ação registrada e reproduzível. Claude Code, Cursor, Devin, Aider, OpenHands e goose chegaram ao mesmo lugar. O modelo não guarda estado, então o harness (a estrutura que roda o modelo) precisa guardar.
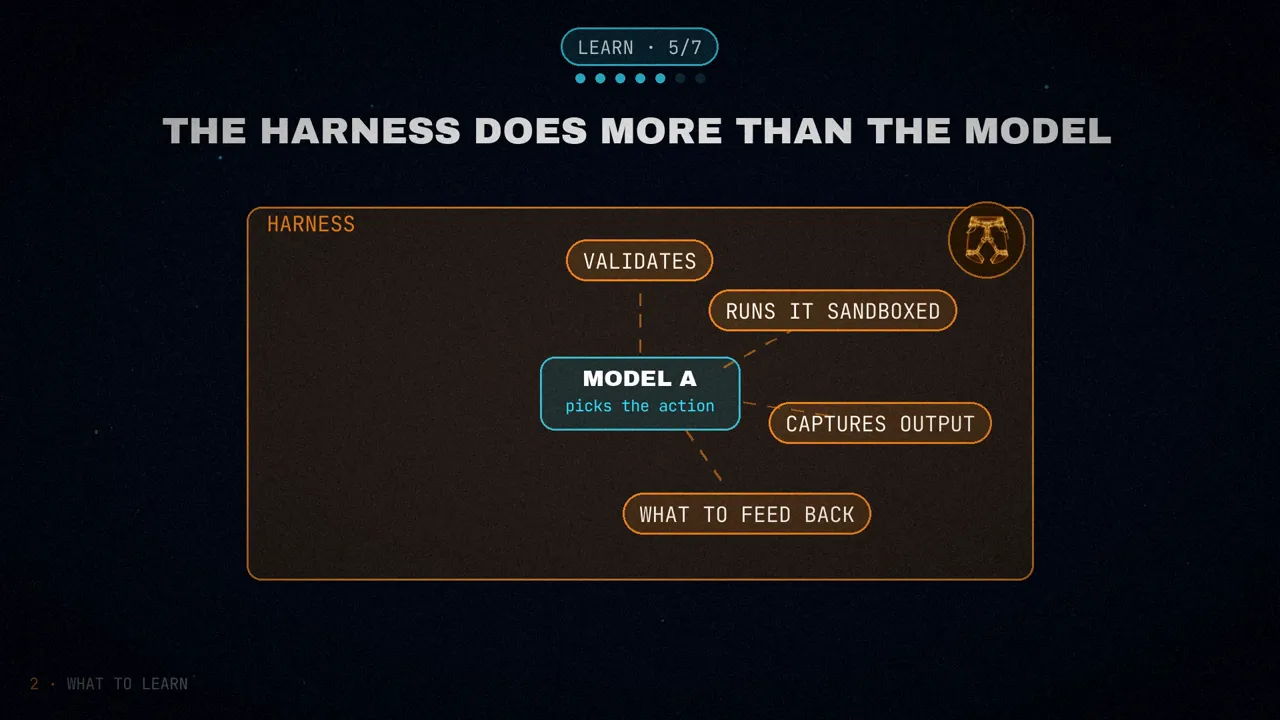
Daí sai uma ideia mais profunda: em qualquer agente sério, o harness trabalha mais que o modelo. O modelo escolhe a próxima ação; o harness a valida, executa isolada, recolhe a saída, decide o que devolver, quando parar, quando salvar um checkpoint e quando lançar um subagente. Troque o modelo por outro parecido e, com um bom harness, tudo continua funcionando; coloque um harness pior e até o melhor modelo esquece de vez em quando o que estava fazendo.
MCP, como modelo. Não basta saber chamar os servidores: é preciso entender a separação limpa entre capacidades do agente, ferramentas e recursos, com autenticação e transporte extensíveis por baixo. Quando você entende, qualquer outro framework de integração parece uma versão pior. Hoje quem cuida dele é a Linux Foundation, e os grandes fornecedores o apoiam; chamá-lo de «o USB-C da IA» já não soa irônico.
O isolamento como peça básica. Todos os agentes de programação em produção rodam isolados, e todos os agentes de navegador já sofreram injeção de prompt indireta. O básico: isolar processos, controlar a saída para a rede, limitar os segredos e pôr fronteiras de permissão entre o agente e as ferramentas. Quem acrescenta isso depois da auditoria de segurança do cliente perde a venda; quem constrói desde a primeira semana passa pelas compras das grandes empresas sem suar.
Com o que construir
São as escolhas do autor em abril de 2026, e o conselho dele é escolher o chato:
| Camada | Escolha do autor |
|---|---|
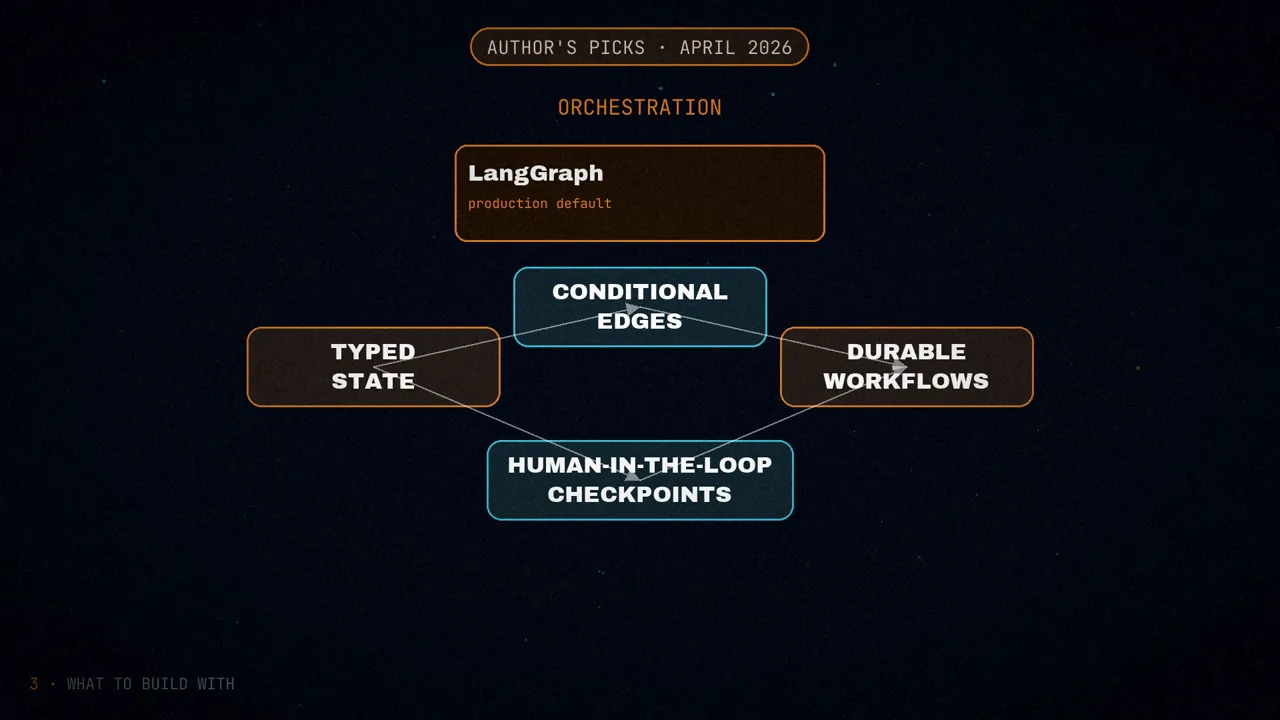
| Orquestração | LangGraph por padrão (segundo ele, cerca de um terço das grandes empresas com agentes o usa; é verboso, mas essa verbosidade é o que você precisa controlar). Mastra se você vive em TypeScript. Pydantic AI para começar do zero com tipos (chegou à v1.0 no fim de 2025). Os SDKs de agentes da Anthropic e da OpenAI dentro dos nós do LangGraph, não como orquestrador principal. |
| Protocolo | MCP, ponto final: quase sempre você encontra um servidor antes de precisar construir um. |
| Memória | Pelo nível de autonomia: Mem0 para personalizar chats, Zep para conversas em produção que acompanham entidades, Letta para agentes coerentes por dias ou semanas. O erro é pegar um framework de memória antes de ter um problema de memória. |
| Observabilidade e evals | Langfuse como opção aberta padrão; LangSmith se você já usa LangChain; Braintrust para comparações rigorosas; OpenLLMetry/Traceloop para OpenTelemetry neutro. Você precisa de traces (o que o agente fez) e de avaliações (se hoje ele está melhor que ontem). |
| Execução isolada | E2B para executar código, Browserbase (com Stagehand) para o navegador, Computer Use da Anthropic para controlar um desktop e Modal para rajadas curtas. Nunca código sem isolar. |
| Modelos | Claude Opus 4.7 e Sonnet 4.6 para usar ferramentas com confiabilidade (Sonnet, o melhor equilíbrio entre custo e desempenho); GPT-5.4 e 5.5 para raciocinar no terminal; Gemini 2.5 e 3 para contextos longos ou multimodais; DeepSeek-V3.2 ou Qwen 3.6 quando o custo manda. |
E uma regra para os modelos: trate-os como peças trocáveis. Se o seu agente só funciona com um, isso é um mau sinal, não uma vantagem. Deixe as avaliações decidirem, e reavalie a cada trimestre, não a cada semana.
O que pular
Vão dizer que você precisa aprender tudo. Pular custa pouco e economiza muito tempo. A lista do autor:
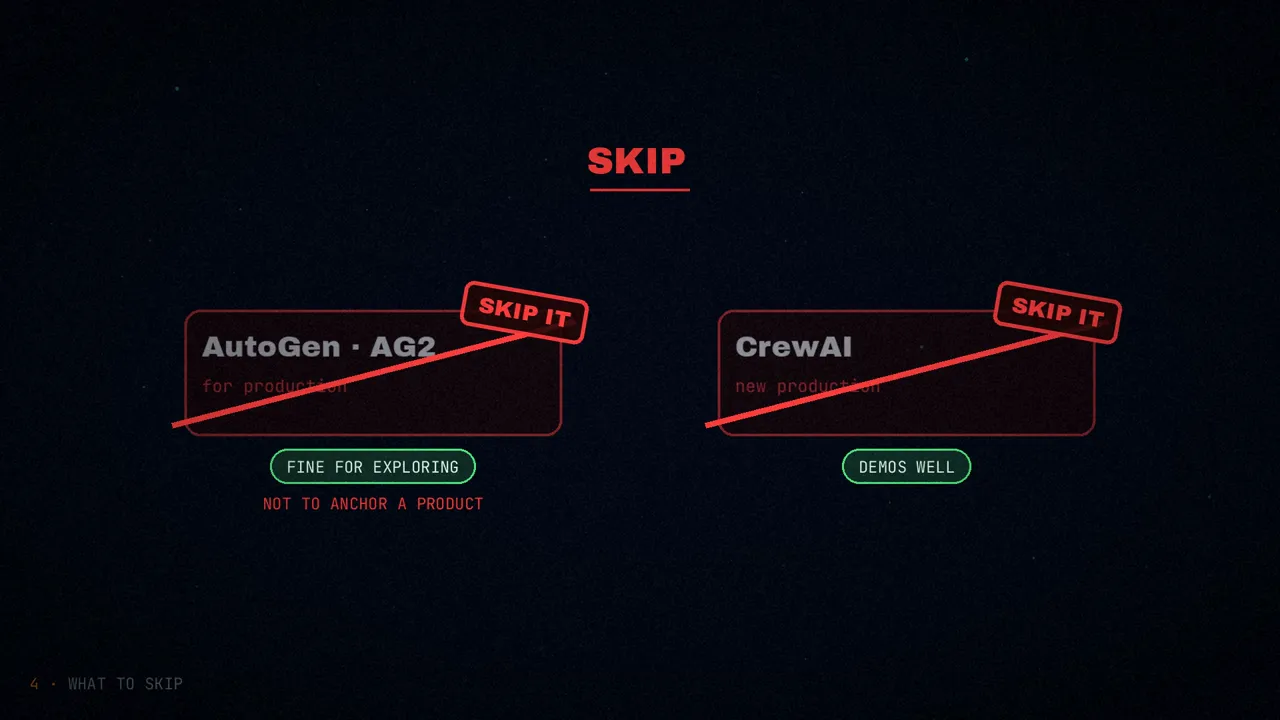
- AutoGen e AG2 para produção: passou para manutenção da comunidade e as versões pararam. Bom para explorar, não para ancorar um produto.
- CrewAI para sistemas novos em produção: está em todo lugar porque fica bonito em demos; use para protótipos, se quiser.
- Semantic Kernel, a menos que você esteja preso ao ecossistema da Microsoft. DSPy, a menos que otimize programas de prompts em escala.
- Agentes que escrevem código como arquitetura base: pesquisa interessante, mas ainda não é padrão de produção.
- As promessas de agentes autônomos: a linhagem do AutoGPT e do BabyAGI está morta como produto. O setor ficou com a engenharia agêntica: supervisionada, delimitada e avaliada.
- Lojas de agentes e plataformas horizontais para construir qualquer agente como cliente (com as exceções do Salesforce Agentforce e do ServiceNow Now Assist, que vivem dentro de ferramentas que você já usa).
- Correr atrás do SWE-bench ou do OSWorld: pesquisadores de Berkeley documentaram em 2025 que quase qualquer benchmark público pode ser burlado sem resolver a tarefa.
- Multiagentes em paralelo ingênuos: se você não consegue desenhar o orquestrador com os limites de leitura e escrita num guardanapo, não lance.
- O preço por assento em produtos novos de agentes: o mercado passou a cobrar por resultado e por uso.
- O próximo framework do Hacker News: espere seis meses.
Como avançar, passo a passo
Se você quer adotar agentes, e não só acompanhar o ritmo, esta sequência é chata e funciona:
- Escolha um resultado que já importa. Nada de projetos mirabolantes nem de «plataformas de agentes»: desviar tíquetes de suporte, um primeiro rascunho de revisão jurídica, qualificar leads, relatórios mensais. Esse número é a sua meta de avaliação desde o primeiro dia, e ele restringe todo o resto: framework, modelo, memória ou subagentes saem daí.
- Traces e avaliações antes de lançar qualquer coisa. Langfuse ou LangSmith, e cinquenta exemplos rotulados à mão. Montar isso depois custa, segundo o autor, umas dez vezes mais.
- Um único agente. LangGraph ou Pydantic AI, um modelo como Sonnet ou GPT, de três a sete ferramentas bem desenhadas e os arquivos ou um banco de dados como estado. Para pouca gente, olhando os traces.
- Trate como produto, não como projeto. As falhas são o seu roteiro; cada mudança passa pelas avaliações.
- Amplie o escopo quando tiver merecido. Subagentes quando o contexto for o gargalo; memória quando uma janela não der conta; uso do computador quando não houver API.
- Infraestrutura chata: MCP, E2B ou Browserbase, o banco de dados que você já tem e seus sistemas de sempre.
- Acompanhe a economia unitária desde o primeiro dia. O exemplo do autor: uma prova de conceito de US$ 0,50 por execução vira US$ 50 mil por mês com um volume moderado.
- Reavalie os modelos a cada trimestre, não a cada semana.
Lendo a maré
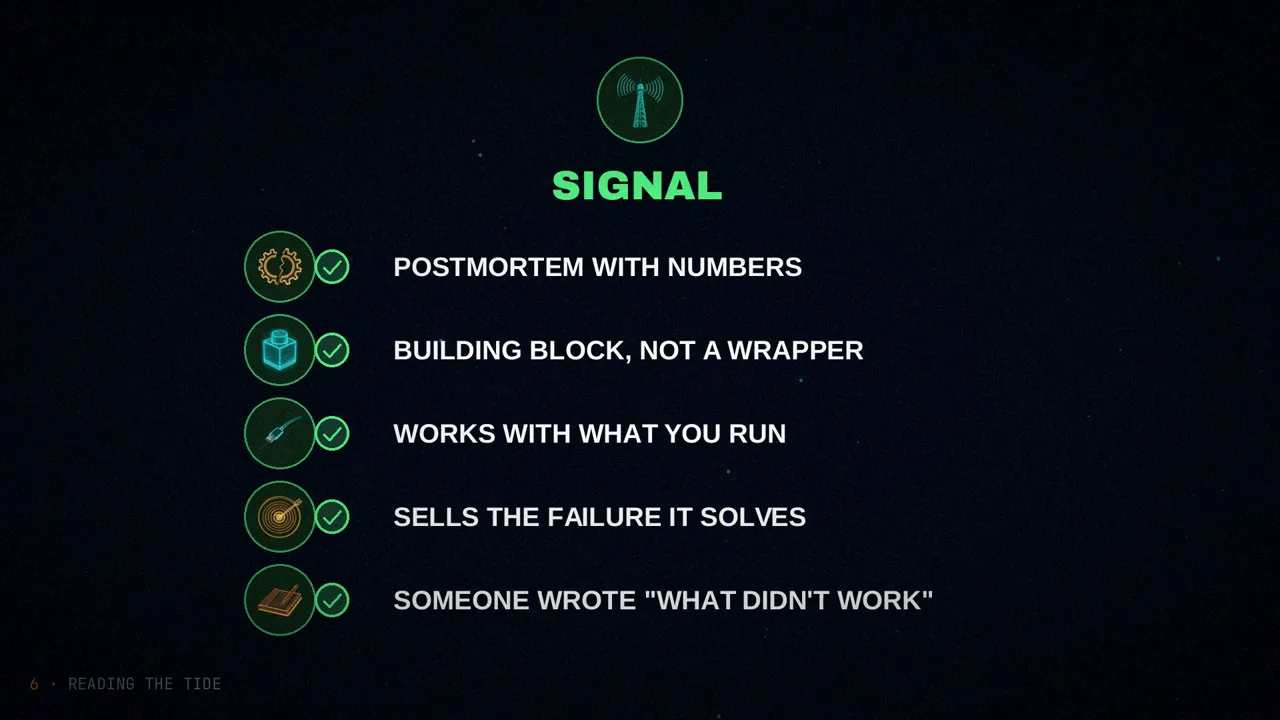
Uma equipe respeitada publica uma análise de falhas com números. É uma peça básica, não um wrapper. Convive com o que você já usa. Vende a falha que resolve, não a capacidade que habilita. Existe há tempo suficiente para alguém ter escrito «o que não funcionou».
Há demos sem casos em produção depois de trinta dias. Os saltos de benchmark são limpos demais. Promete «autônomo», «sistema operacional de agentes» ou «construa qualquer agente» sem ressalvas. A documentação supõe que você vai jogar fora seus traces e sua configuração. As estrelas no GitHub sobem sem commits nem versões.
E um hábito semanal: trinta minutos na sexta-feira para ler três coisas (o blog de engenharia da Anthropic, as notas de Simon Willison e o Latent Space), uma ou duas análises de falhas, se houver, e mais nada.
O que acompanhar
Seis coisas cuja pergunta «é sinal?» ainda não foi respondida:
- O modelo do Replit Agent 4, que bifurca agentes em paralelo sem atropelar o estado.
- O preço por resultado, que Sierra e Harvey validam nos seus nichos.
- As skills como forma de empacotar capacidades (AGENTS.md e pastas de skills): vão se padronizar como o MCP?
- A regressão de qualidade do Claude Code em abril de 2026 e a análise posterior: os usuários perceberem antes do monitoramento interno mostra como as avaliações em produção ainda são imaturas.
- A voz como canal principal de suporte: na Sierra, ela superou o texto no fim de 2025.
- Os modelos abertos encurtando a distância, como DeepSeek e Qwen.
Para cada uma vale a mesma pergunta: o que você precisaria ver daqui a seis meses para acreditar.
A aposta pouco convencional
Cada framework que você não adota é uma migração que você não deve, e cada benchmark que você não persegue é um trimestre de foco que você mantém. As empresas que estão ganhando este ciclo (Sierra, Harvey, Cursor) escolheram alvos estreitos, construíram uma disciplina chata e deixaram o ruído passar.
O caminho de sempre era escolher uma stack, dominá-la por anos e subir a escada. Mas a stack muda a cada trimestre, e as empresas, seus frameworks e seus protocolos têm meses ou poucos anos. Não há escada, porque o prédio muda de andar o tempo todo. O que sobra é o método mais antigo: faça algo, coloque na internet e deixe o seu trabalho apresentar você. A credencial é o que você constrói.
A habilidade de que você precisa não é «agentes»: é saber que trabalho rende a longo prazo. Engenharia de contexto, design de ferramentas, o padrão orquestrador, a disciplina de avaliar e a mentalidade do harness rendem; decorar a interface do framework que saiu na terça, não.
Como ler este artigo
- É um guia de opinião. As escolhas de ferramentas e modelos são do autor, em abril de 2026.
- Os números sem fonte são dele: os 90 % de mortalidade dos frameworks-plataforma, o «um terço» do LangGraph ou o «dez vezes mais caro» são estimativas, não medições.
- Os de terceiros, como de terceiros: os 47 % da regressão do Claude Code são relato do autor; os 40 % vêm de uma equipe sem nome; os 25 % do Spotify, do blog de engenharia deles.
- «Pular» não é «ruim»: o próprio autor deixa o AutoGen para explorar e o CrewAI para protótipos.
Em resumo
O que eu levo: não é preciso aprender tudo, só o que rende, e pular o resto. Escolha um resultado, monte traces e avaliações antes de lançar, use MCP, isole a execução, comece com um único agente, reavalie os modelos a cada trimestre e leia três coisas toda sexta-feira.
A era premia quem faz a coisa mais do que quem sabe descrevê-la: construa e coloque na internet.
Qual framework você vai pular este ano?
Fontes
- «What to Learn, Build, and Skip in AI Agents (2026)», de Rohit (@rohit4verse), no X (29 de abril de 2026; em inglês).
- O vídeo, nos meus canais: inglês e espanhol.