Modelo, razonamiento y agente: el motor y el coche
Raschka empieza con una idea que comparto: gran parte del progreso reciente en sistemas con modelos de lenguaje no viene de modelos mejores, sino de cómo los usamos. Las herramientas, la gestión del contexto y la memoria pesan tanto como el propio modelo. Y para hablar de ello conviene separar tres conceptos que solemos mezclar:
- Modelo de lenguaje: el núcleo. Predice el siguiente token.
- Modelo de razonamiento: sigue siendo un modelo de lenguaje, pero entrenado o instruido para gastar más cálculo al responder: razona paso a paso, se verifica o busca entre varias respuestas candidatas.
- Agente: una capa por encima, un bucle de control alrededor del modelo. Dado un objetivo, decide qué mirar después, qué herramientas llamar, cómo actualizar su estado y cuándo parar.
Su analogía es la de un coche: el modelo de lenguaje es el motor; el de razonamiento, un motor más potente, pero más caro de usar; y el arnés del agente es el coche entero, lo que te permite sacarle partido a ese motor.
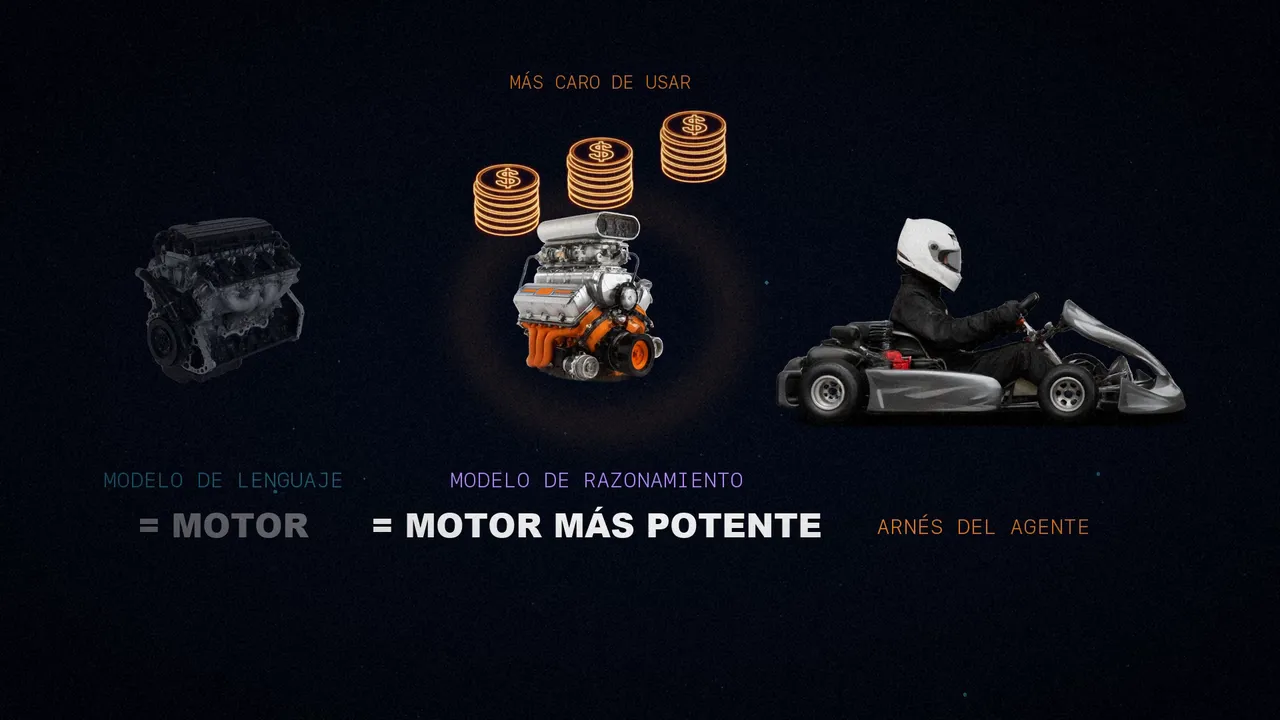
Dos términos más. El arnés de un agente es el andamiaje de software que lo rodea: gestiona el contexto, las herramientas, los prompts, el estado y el flujo de control. Un arnés de programación es un caso particular, pensado para la ingeniería de software. Claude Code y Codex son arneses de programación; OpenClaw, en cambio, es un arnés de agente más general.
El arnés de programación
Un modelo puede resolver tareas de programación por su cuenta, pero programar es solo en parte generar texto. También es moverse por el repositorio, buscar, encontrar funciones, aplicar cambios, ejecutar los tests, leer los errores y no perder de vista lo importante. Raschka lo resume con humor: es un trabajo mental duro, y por eso no nos gusta que nos interrumpan.
Un arnés de programación tiene tres capas:
Pone el motor: un modelo base o uno de razonamiento.
Resuelve el problema por iteraciones: observa, analiza, decide y actúa.
La fontanería: contexto del repositorio, herramientas, permisos, memoria y caché.
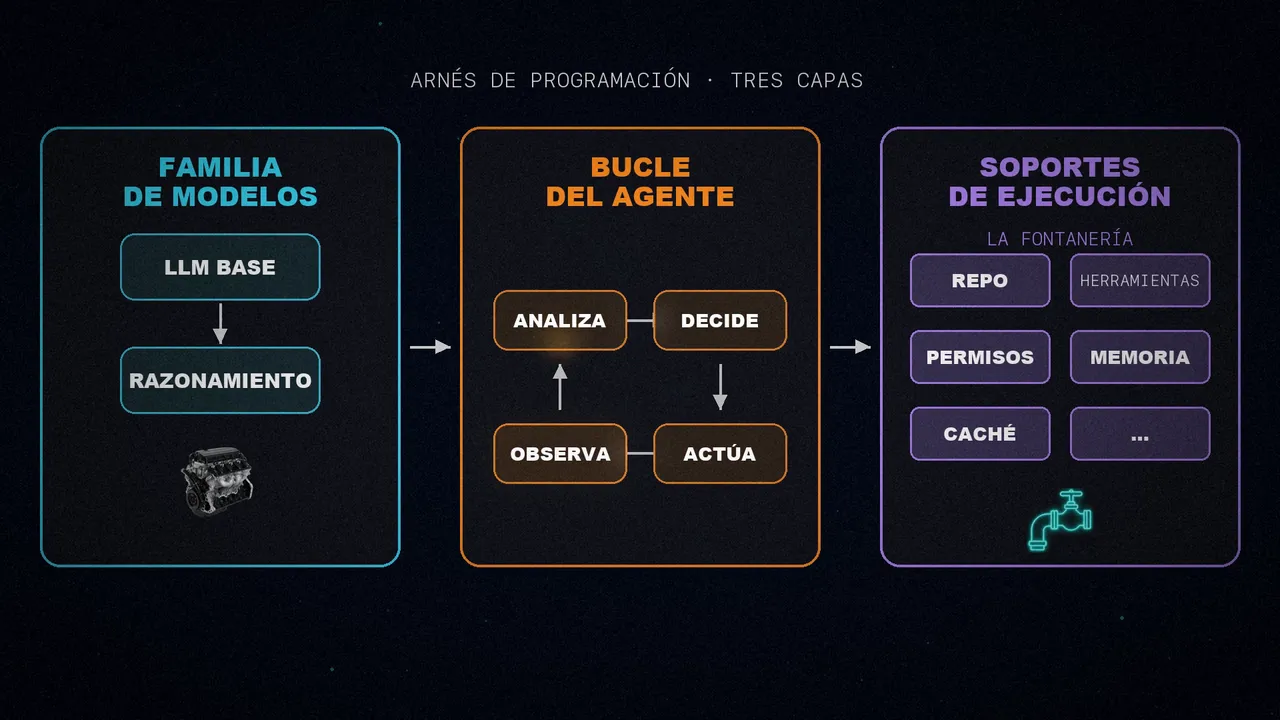
Cuando hablamos del arnés, hablamos de la capa que monta los prompts, ofrece las herramientas, sigue el estado de los ficheros, aplica las ediciones, ejecuta comandos, gestiona los permisos, guarda en caché lo que no cambia y almacena la memoria. Hoy, esa capa define casi toda la experiencia de uso. Un chat en la web, en cambio, se parece más a «charlar con unos archivos adjuntos».
Aquí Raschka se moja. Cree que las versiones básicas de los mejores modelos ya rinden de forma muy parecida, así que el arnés suele ser lo que marca la diferencia. Y especula: si metiéramos un modelo abierto puntero, como GLM, en un arnés similar, podría rendir al nivel de GPT en Codex o de Claude Opus en Claude Code. Eso sí, entrenar el modelo para su arnés suele ayudar: OpenAI ha mantenido una variante general de su modelo y otra especializada en Codex.
Para enseñar las piezas, Raschka escribió su propio agente mínimo, en Python puro y sin dependencias. Su código marca con comentarios los seis componentes que vienen a continuación.
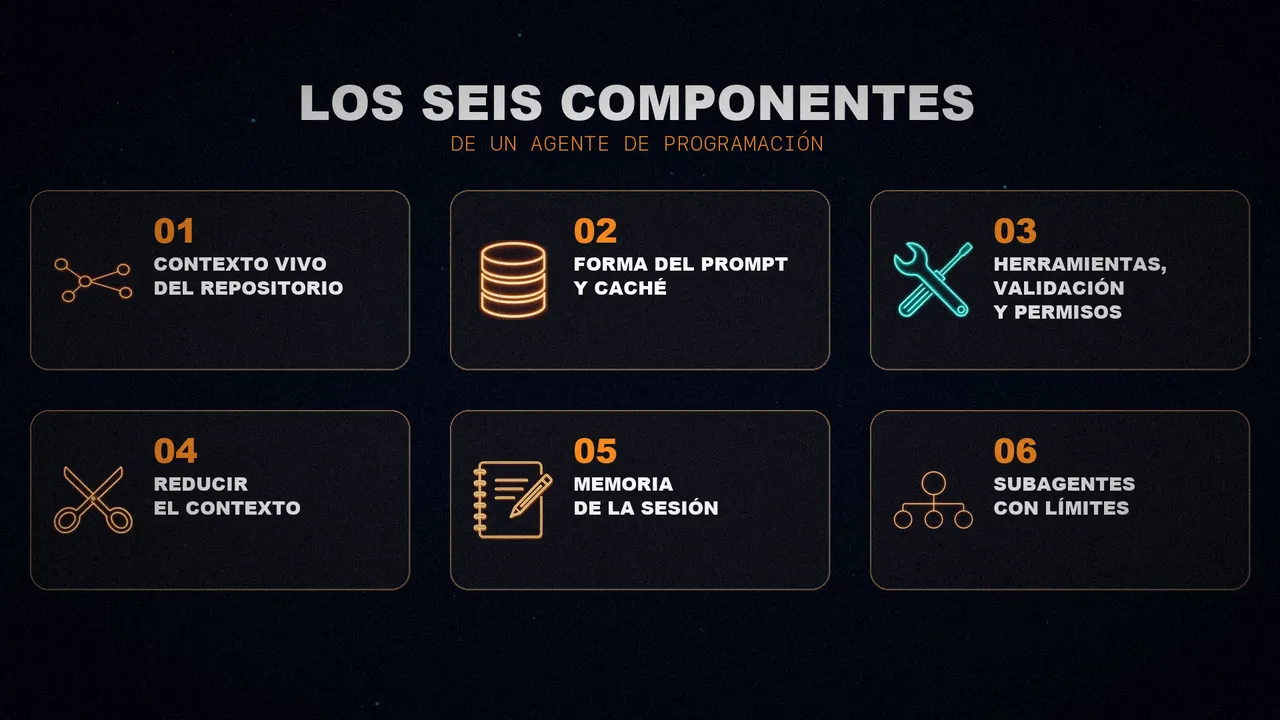
1. Contexto vivo del repositorio
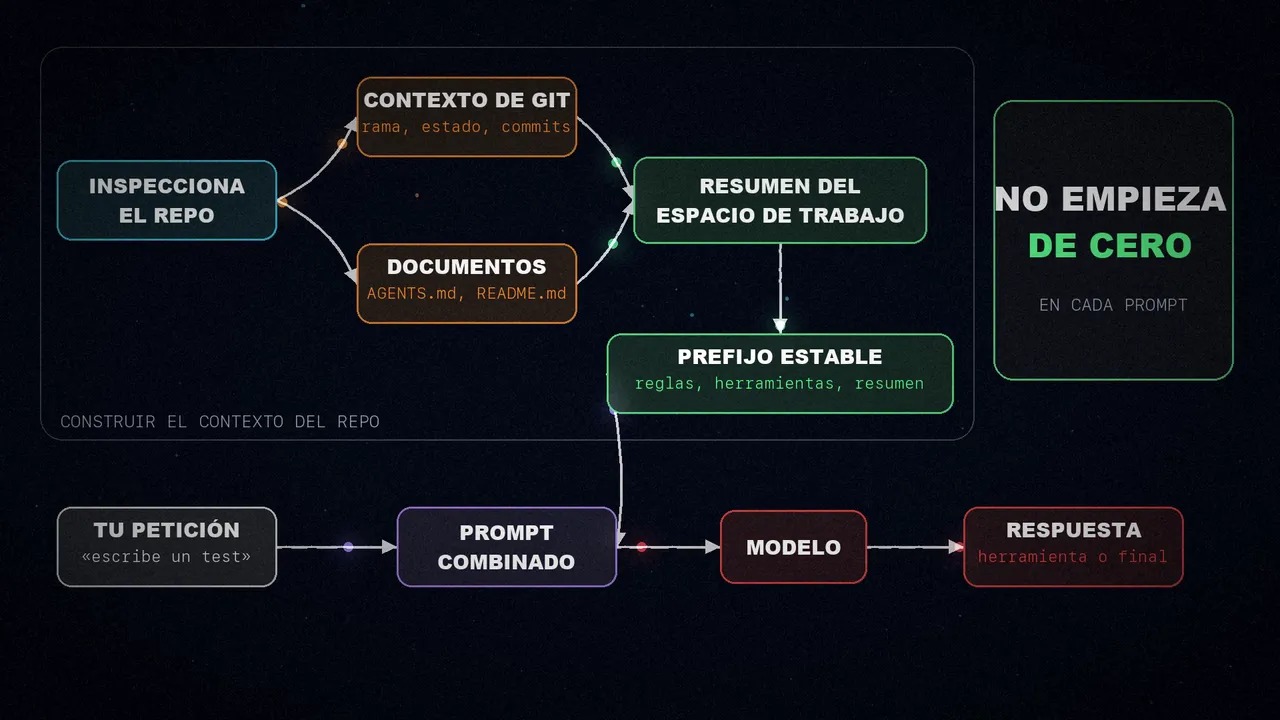
Quizá sea el más obvio, pero es de los más importantes. Cuando le pides «arregla los tests», el modelo debería saber si está en un repositorio de Git, en qué rama y qué documentos del proyecto pueden traer instrucciones. Esa orden no se entiende sola:
- Si el agente ve un
AGENTS.mdo elREADMEdel proyecto, puede aprender con qué comando se ejecutan las pruebas. - Si conoce la raíz y la estructura del repositorio, busca en el sitio correcto en vez de adivinar.
- La rama, el estado y los últimos commits le dicen qué cambios hay en marcha.
Así que, antes de trabajar, el arnés inspecciona el repositorio, saca el contexto de Git y los documentos del proyecto, y los condensa en un resumen del espacio de trabajo. Ese resumen se combina con tu petición, y así el agente no empieza de cero en cada prompt.
2. Forma del prompt y caché
Ya tenemos los datos del repositorio. Pero sería un desperdicio volver a montarlos y procesarlos en cada petición. Las sesiones de programación son repetitivas: las reglas del agente no cambian, la descripción de las herramientas tampoco, y el resumen del proyecto, casi nada. Lo que sí cambia en cada turno es tu última petición, la conversación reciente y la memoria de corto plazo.
Por eso un arnés inteligente separa el prompt en dos partes:
- Un prefijo estable, con las instrucciones, las herramientas y el resumen del espacio de trabajo, que reutiliza de la caché.
- El estado de la sesión, que añade al final en cada turno.
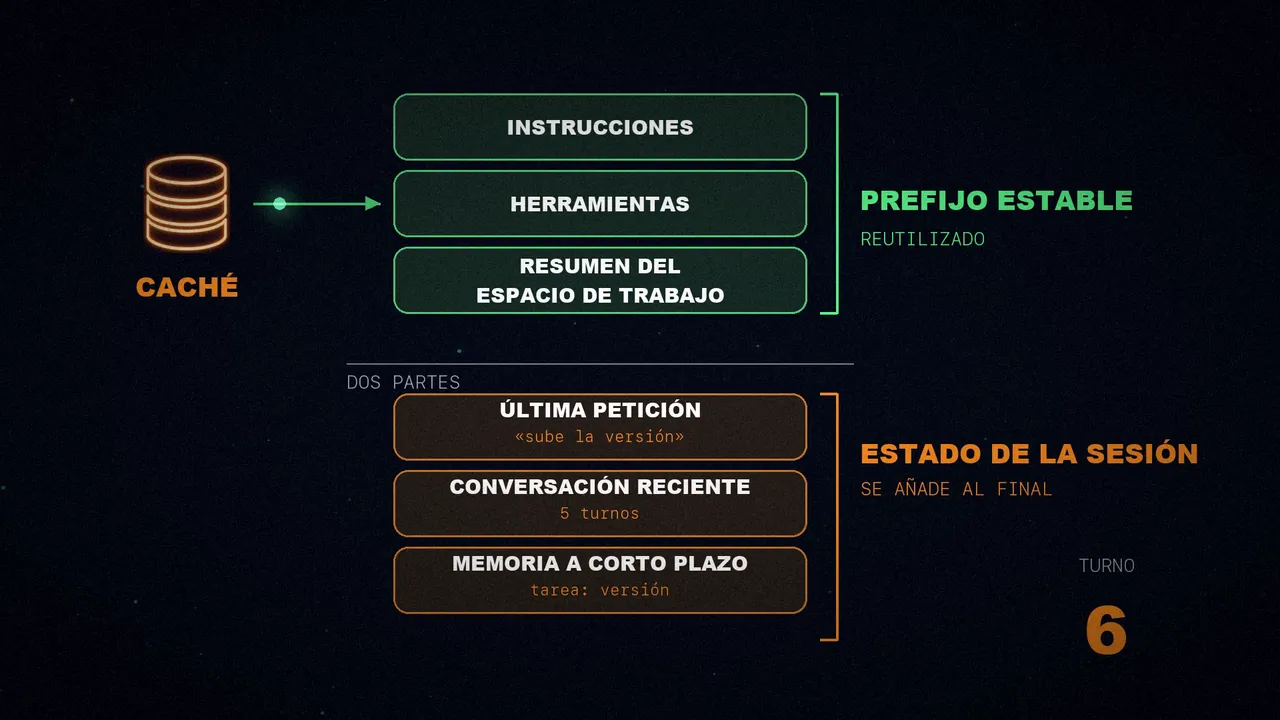
La diferencia con el componente uno: aquel reúne los hechos del repositorio; este los empaqueta y los guarda en caché para las llamadas repetidas al modelo. No tiene sentido gastar cálculo en reconstruir desde cero lo que no ha cambiado.
3. Herramientas, validación y permisos
Aquí es donde deja de parecer un chat y empieza a parecer un agente. Un modelo a secas te sugiere comandos en texto, y tú los ejecutas y le pegas el resultado. En un arnés de programación, el modelo ejecuta el comando él mismo y recibe la salida.
Pero el arnés no le deja improvisar cualquier sintaxis. Le da una lista cerrada de herramientas con nombre, con entradas claras y límites claros: listar el directorio, leer, buscar, ejecutar un comando en la terminal o escribir un fichero. Y el modelo tiene que pasar los argumentos con una forma que el arnés pueda comprobar. Cuando el modelo pide una acción, el arnés se para y se hace cuatro preguntas:
Solo las de la lista cerrada.
Con la forma que el arnés sabe comprobar.
Escribir un archivo, por ejemplo, pide permiso.
El agente no sale del repositorio.
Solo cuando pasa todas las comprobaciones se ejecuta algo. Después, el resultado se recorta y vuelve al bucle.
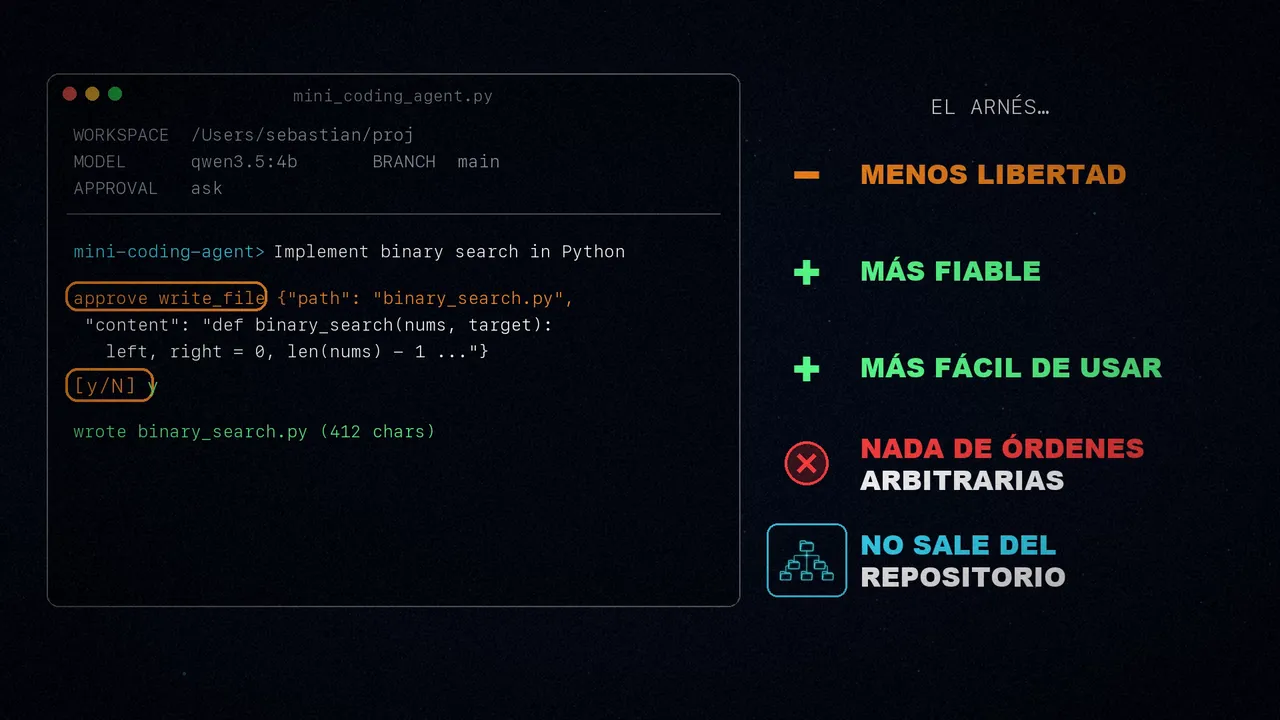
En el Mini Coding Agent se ve así: le pides «implementa la búsqueda binaria en Python», y antes de escribir el archivo te pregunta si lo apruebas. El arnés le da al modelo menos libertad, pero así es más fiable y más fácil de usar: no ejecuta órdenes arbitrarias y no sale del repositorio.
4. Reducir el contexto
Que el contexto se hinche es un problema de todos los modelos de lenguaje. Cada vez admiten contextos más largos, pero siguen siendo caros y pueden meter ruido. Y un agente de programación lo sufre aún más: lee los mismos archivos varias veces y acumula salidas de herramientas y logs muy largos. Si lo guardara todo tal cual, se quedaría sin tokens enseguida.
Un arnés mínimo usa al menos dos estrategias:
- Recortar: acorta los fragmentos de documentos, las salidas largas, las notas de memoria y las entradas del historial, para que ningún texto se coma el presupuesto del prompt solo por ser largo.
- Resumir el historial: convierte la sesión entera en un resumen pequeño que quepa en el prompt. El truco es guardar lo reciente con más detalle, porque importa más para el paso actual, y comprimir más lo antiguo.
Además, se quitan las lecturas repetidas de un mismo archivo, para que el modelo no lo vea una y otra vez.
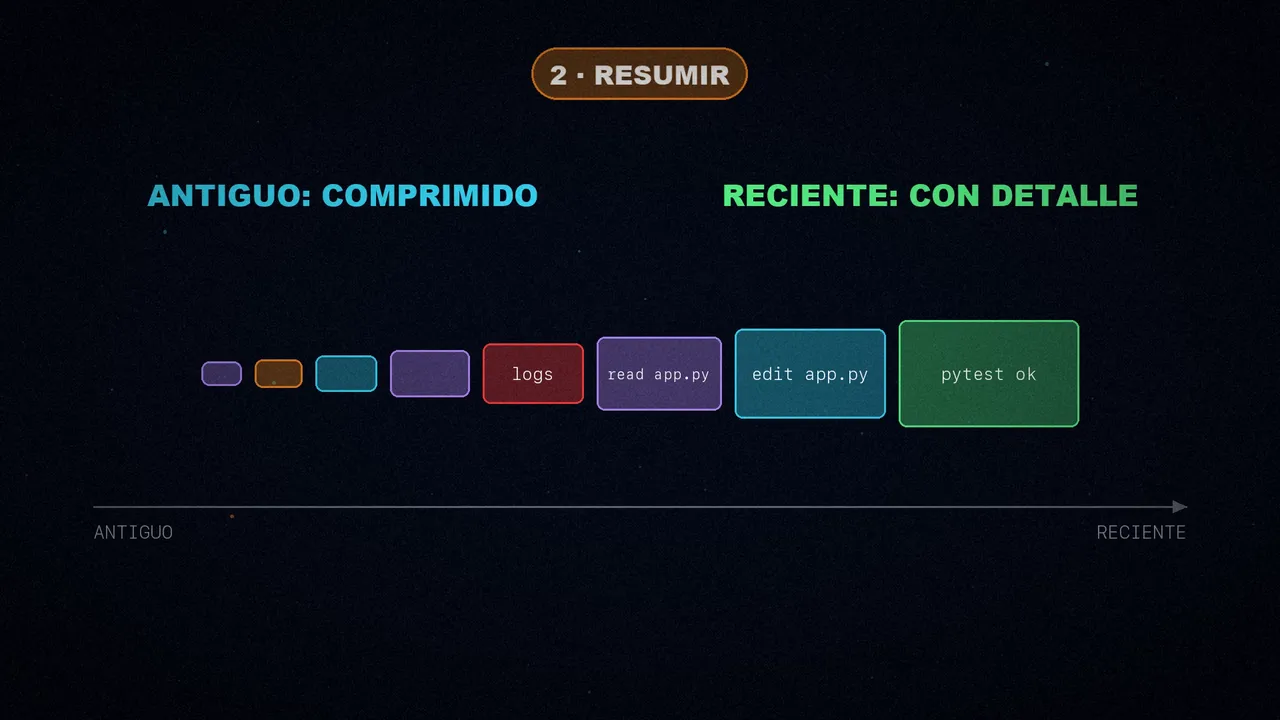
Para Raschka, esta es una de las partes más aburridas e infravaloradas del diseño de un agente. Pero me quedo con su frase: mucho de lo que parece calidad del modelo es, en realidad, calidad del contexto.
5. Memoria de la sesión
El componente anterior respondía a cuánto pasado vuelve al modelo en el siguiente turno. Este responde a otra pregunta: qué guarda el agente como registro permanente. Y lo separa en al menos dos capas, que suelen guardarse en disco como archivos JSON:
Todas tus peticiones, las salidas de las herramientas y las respuestas del modelo. Se puede retomar aunque cierres el agente.
Un estado pequeño y destilado, con la tarea actual, los archivos importantes y las notas recientes. No solo crece: se edita y se compacta.
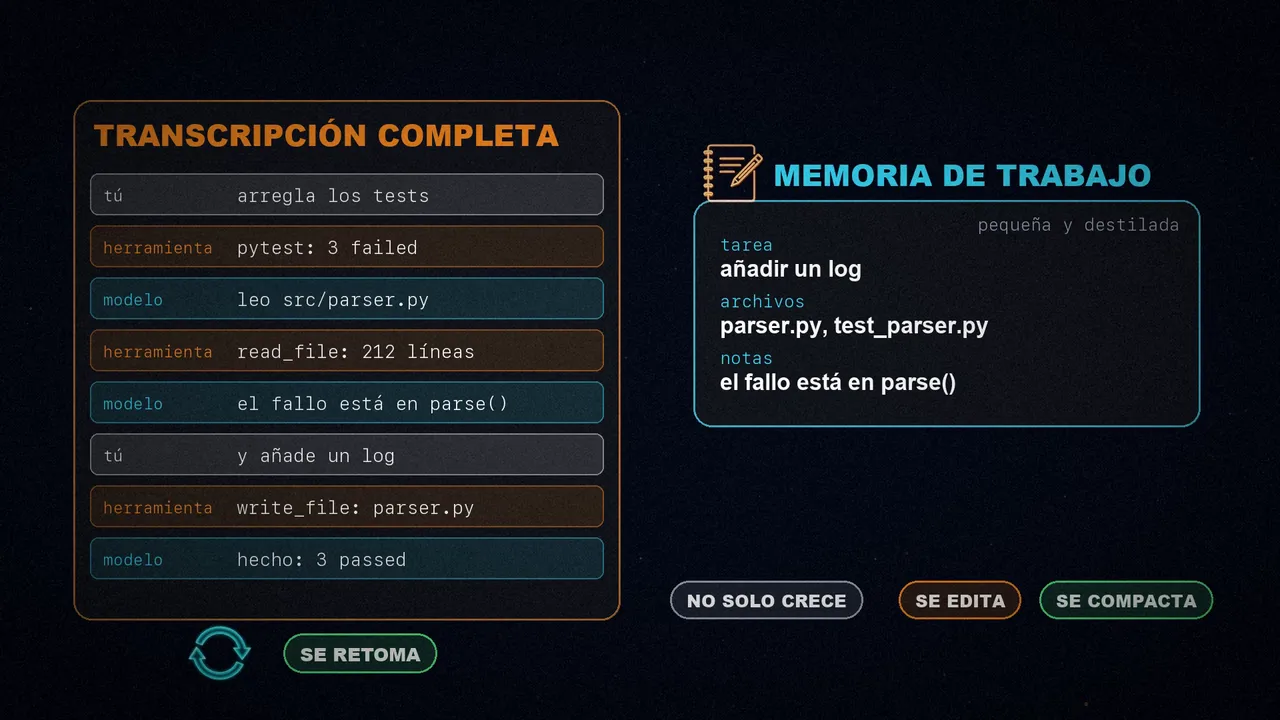
La memoria de trabajo parece lo mismo que el historial compacto del componente cuatro, pero cumple otra función. El historial compacto sirve para reconstruir el prompt: le da al modelo una vista comprimida de lo reciente. La memoria de trabajo sirve para no perder el hilo de la tarea entre turnos. Y cada evento nuevo se anota en las dos capas.
6. Subagentes con límites
Cuando un agente ya tiene herramientas y estado, lo siguiente es delegar. A mitad de una tarea, puede necesitar una respuesta lateral: qué archivo define un símbolo, qué dice una configuración o por qué falla un test. Mejor separarla en una subtarea acotada, que puede ir en paralelo y acelerar el trabajo.
Un subagente solo sirve si hereda contexto suficiente para trabajar de verdad. Pero si no lo limitamos, tendremos varios agentes repitiendo trabajo, tocando los mismos archivos o lanzando más subagentes. Raschka lo dice así: el problema difícil no es cómo crear un subagente, sino cómo atarlo. Por ejemplo, con acceso de solo lectura y una profundidad de recursión limitada.
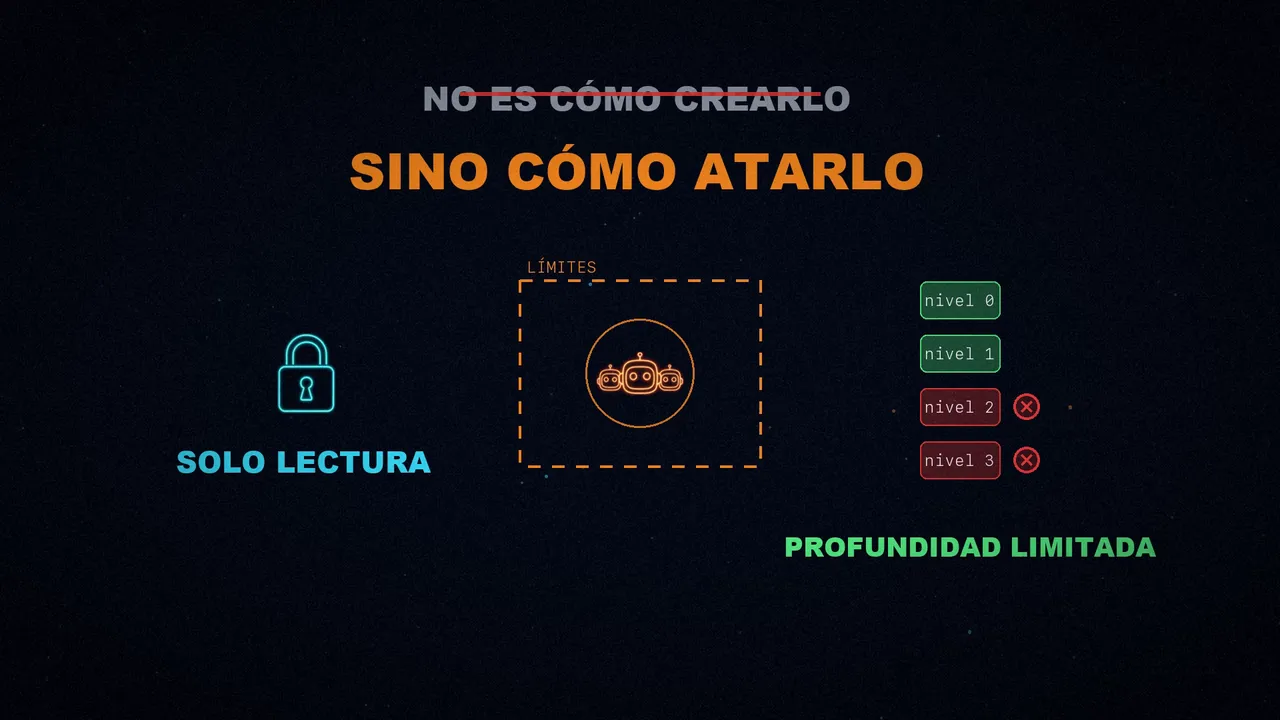
En el agente de Raschka, el subagente aún corre sin paralelismo, pero la idea es la misma. Claude Code tiene subagentes desde hace tiempo, y Codex los añadió más tarde. Codex no los obliga a ser de solo lectura: suelen heredar el entorno aislado y los permisos del agente principal. Ahí, el límite está en acotar la tarea, el contexto y la profundidad.
¿Y OpenClaw?
Los seis componentes están muy entrelazados en el código, pero verlos uno a uno ayuda a entender cómo funciona un arnés de programación y por qué hace al modelo mucho más útil que un chat de varios turnos. Raschka cierra comparándolo con OpenClaw, que tiene mucho en común:
- Archivos de instrucciones en el espacio de trabajo, como
AGENTS.md,SOUL.mdyTOOLS.md. - Sesiones guardadas con compactación del historial.
- Subagentes y sesiones de ayuda.
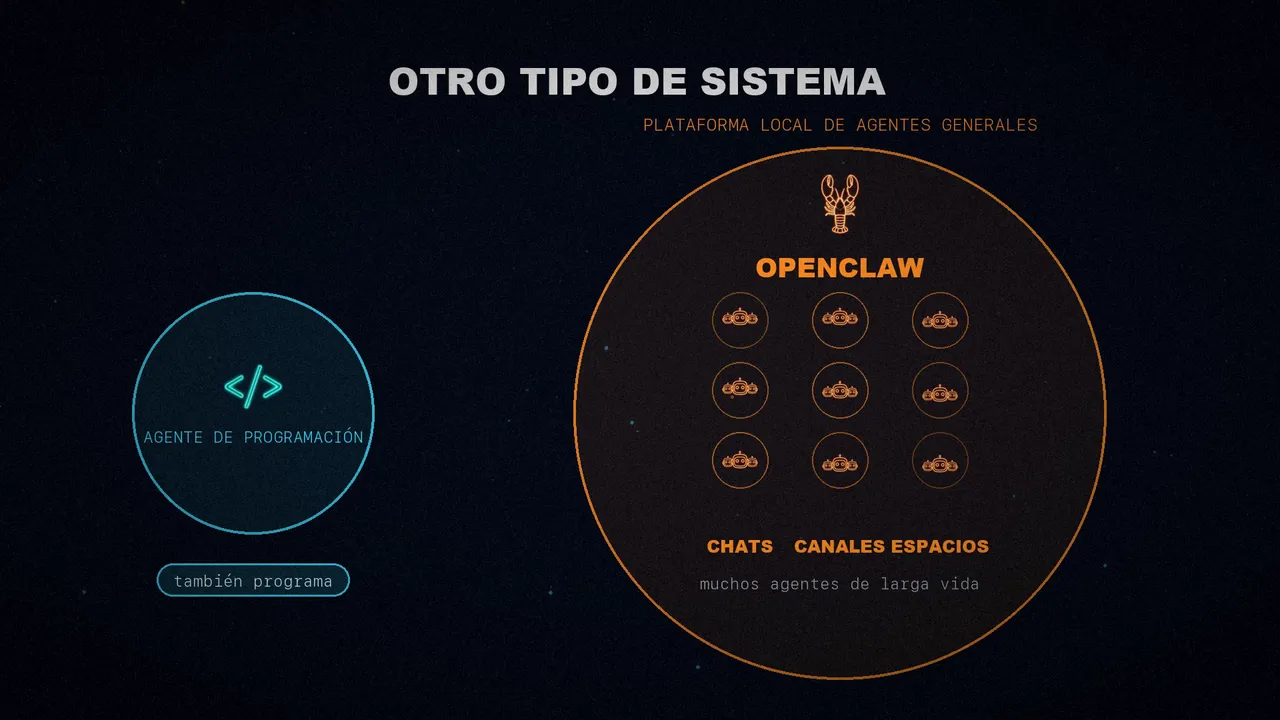
Pero es otro tipo de sistema: una plataforma local de agentes generales que también programan, pensada para muchos agentes de larga vida repartidos por chats, canales y espacios de trabajo. Un agente de programación, en cambio, está optimizado para una persona que trabaja en un repositorio y le pide inspeccionar archivos, editar código y ejecutar herramientas locales de forma eficiente. En OpenClaw, programar es una tarea importante, pero una más entre varias.
El modelo es el motor, pero el arnés lo convierte en un agente: contexto del repositorio, prompt con caché, herramientas con permisos, contexto recortado, memoria de sesión y subagentes con límites.
¿Qué componente echas más en falta en tu agente?
Fuentes
- «Components of A Coding Agent», de Sebastian Raschka (@rasbt), Ahead of AI, 4 de abril de 2026.
- El código del agente mínimo: rasbt/mini-coding-agent.
- El vídeo, en mis tres canales: español, inglés y portugués.