Modelo, raciocínio e agente: o motor e o carro
O Raschka começa com uma ideia que eu compartilho: grande parte do progresso recente em sistemas com modelos de linguagem não vem de modelos melhores, mas de como os usamos. As ferramentas, a gestão do contexto e a memória pesam tanto quanto o próprio modelo. E, para falar disso, vale separar três conceitos que costumamos misturar:
- Modelo de linguagem: o núcleo. Ele prevê o próximo token.
- Modelo de raciocínio: continua sendo um modelo de linguagem, mas treinado ou instruído para gastar mais computação ao responder: raciocina passo a passo, se verifica ou busca entre várias respostas candidatas.
- Agente: uma camada acima, um loop de controle em volta do modelo. Dado um objetivo, ele decide o que olhar em seguida, quais ferramentas chamar, como atualizar seu estado e quando parar.
A analogia dele é a de um carro: o modelo de linguagem é o motor; o de raciocínio, um motor mais potente, mas mais caro de usar; e o arnês do agente é o carro inteiro, o que permite tirar proveito desse motor.
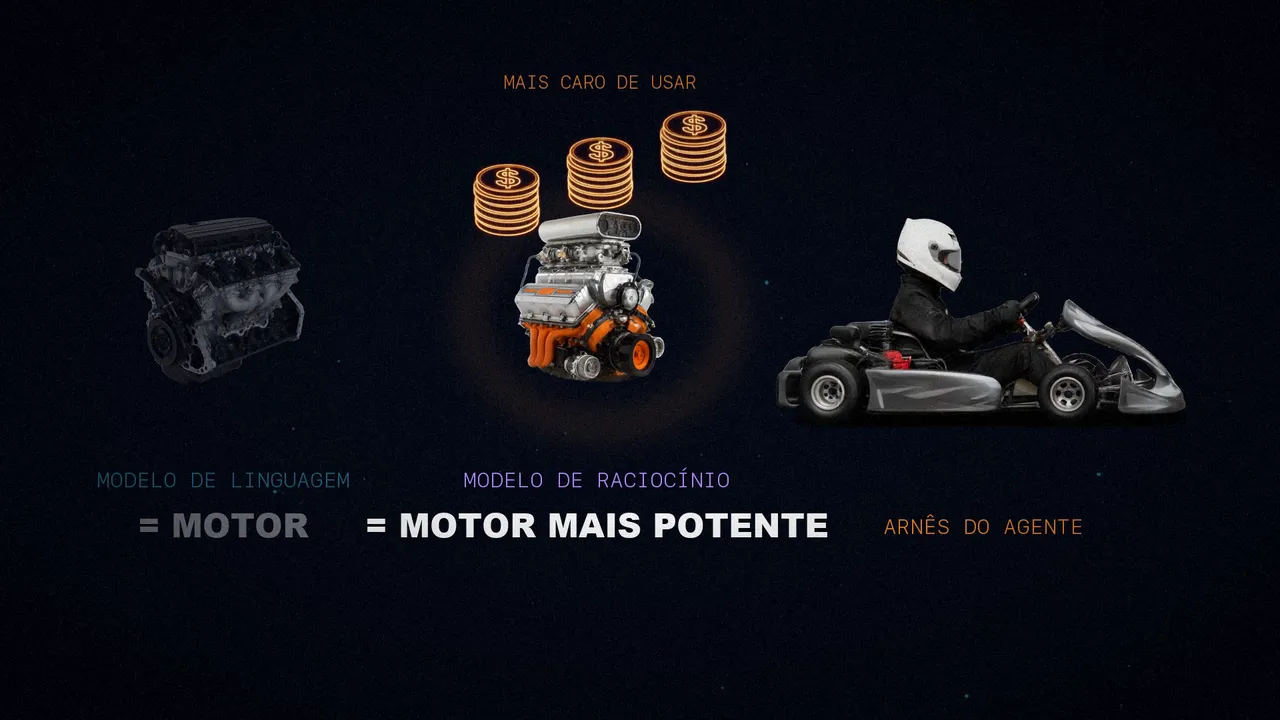
Mais dois termos. O arnês de um agente é a estrutura de software em volta dele: gerencia o contexto, as ferramentas, os prompts, o estado e o fluxo de controle. Um arnês de programação é um caso particular, pensado para a engenharia de software. O Claude Code e o Codex são arneses de programação; já o OpenClaw é um arnês de agente mais geral.
O arnês de programação
Um modelo consegue resolver tarefas de programação sozinho, mas programar é só em parte gerar texto. Também é navegar pelo repositório, buscar, encontrar funções, aplicar mudanças, rodar os testes, ler os erros e não perder de vista o que importa. O Raschka brinca: é um trabalho mental pesado, e por isso não gostamos de ser interrompidos.
Um arnês de programação tem três camadas:
Entra com o motor: um modelo base ou um de raciocínio.
Resolve o problema por iterações: observa, analisa, decide e age.
O encanamento: contexto do repositório, ferramentas, permissões, memória e cache.
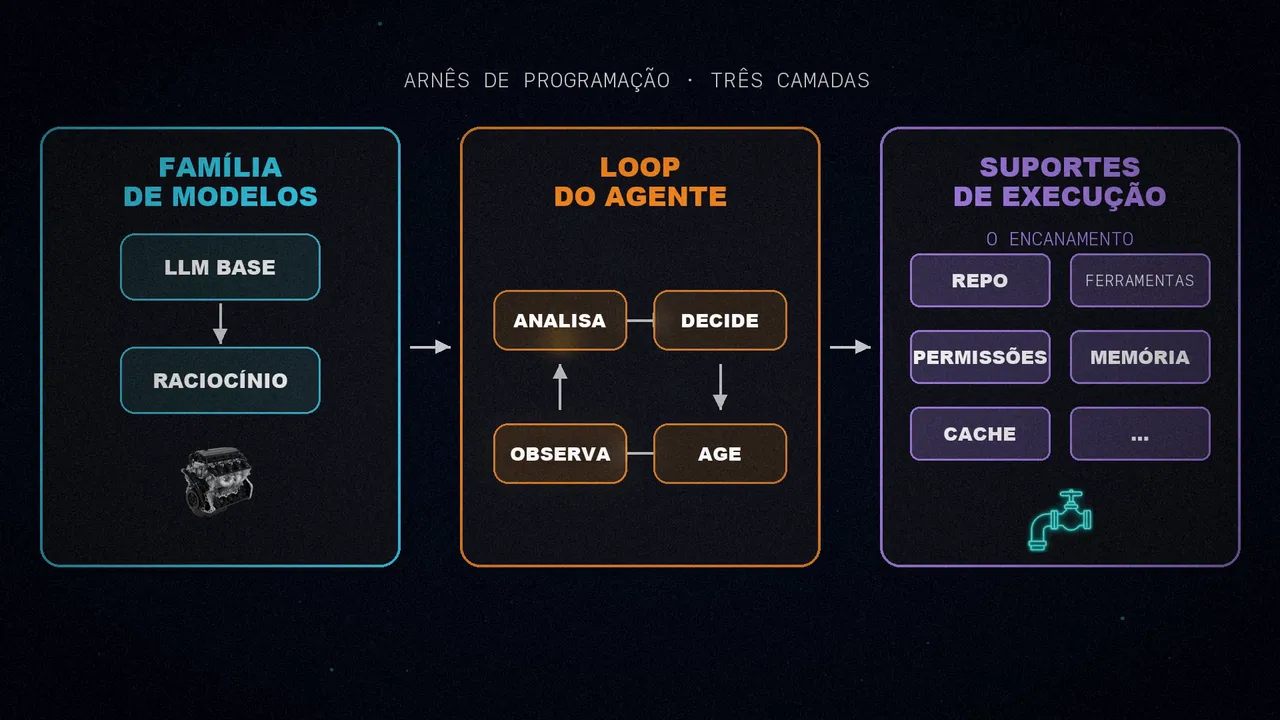
Quando falamos do arnês, falamos da camada que monta os prompts, oferece as ferramentas, acompanha o estado dos arquivos, aplica as edições, executa comandos, gerencia as permissões, guarda em cache o que não muda e armazena a memória. Hoje, essa camada define quase toda a experiência de uso. Um chat na web, por outro lado, se parece mais com "conversar com alguns arquivos anexados".
Aqui o Raschka se arrisca. Ele acha que as versões básicas dos melhores modelos já têm um desempenho muito parecido, então o arnês costuma ser o que faz a diferença. E especula: se colocássemos um modelo aberto de ponta, como o GLM, em um arnês parecido, ele poderia render no nível do GPT no Codex ou do Claude Opus no Claude Code. Mas treinar o modelo para o seu arnês costuma ajudar: a OpenAI manteve uma variante geral do seu modelo e outra especializada no Codex.
Para mostrar as peças, o Raschka escreveu seu próprio agente mínimo, em Python puro e sem dependências. O código dele marca com comentários os seis componentes a seguir.
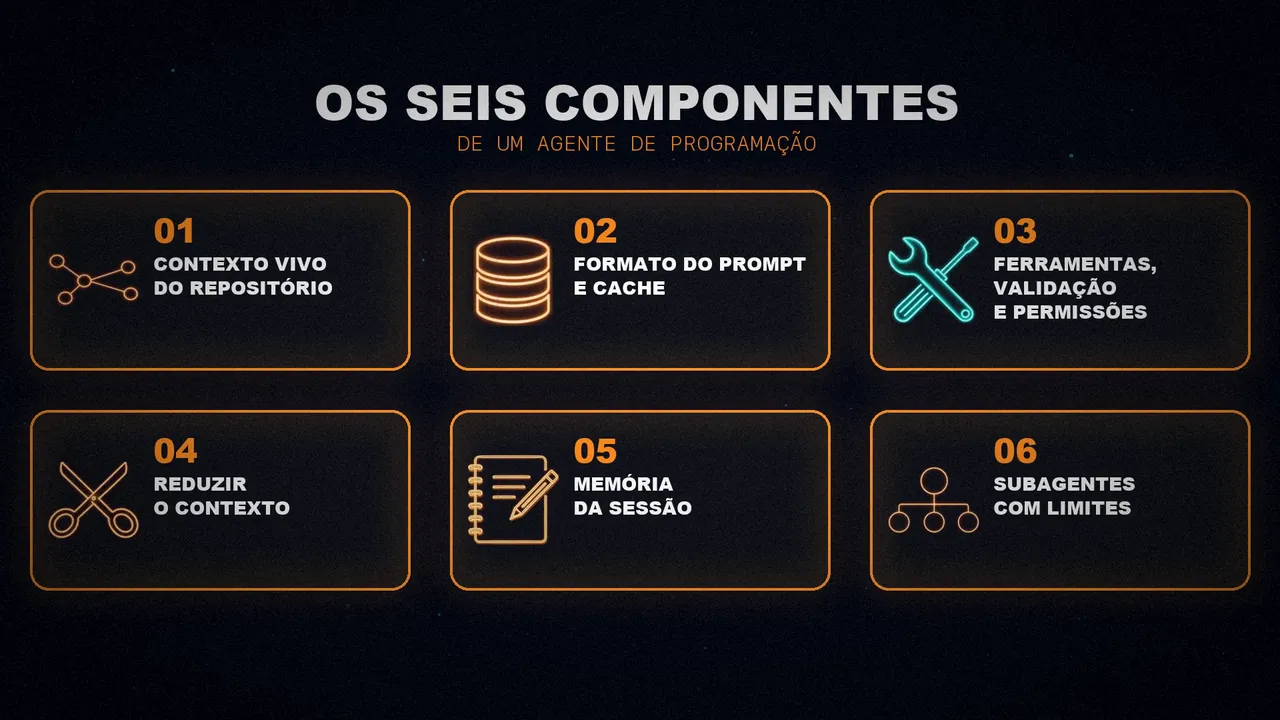
1. Contexto vivo do repositório
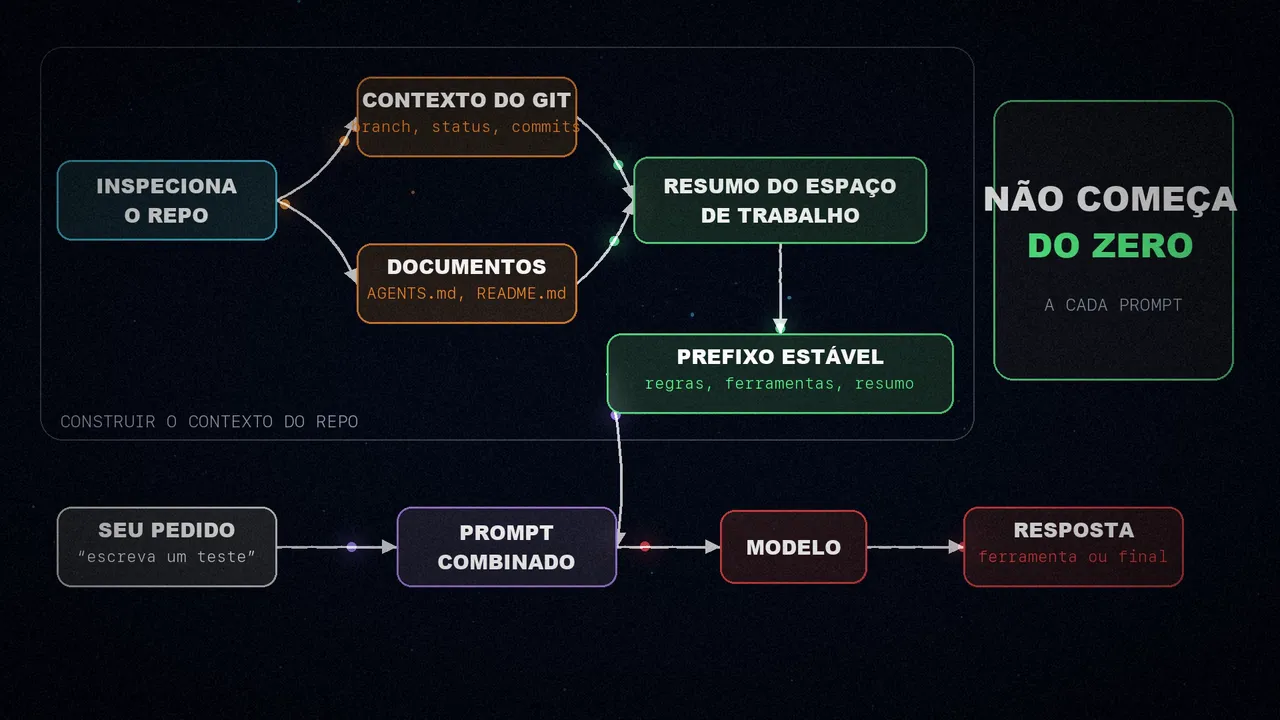
Talvez seja o mais óbvio, mas é um dos mais importantes. Quando você pede "conserte os testes", o modelo deveria saber se está em um repositório Git, em qual branch e quais documentos do projeto podem trazer instruções. Esse pedido não se entende sozinho:
- Se o agente vê um
AGENTS.mdou oREADMEdo projeto, pode aprender com qual comando os testes rodam. - Se conhece a raiz e a estrutura do repositório, busca no lugar certo em vez de adivinhar.
- A branch, o status e os últimos commits dizem quais mudanças estão em andamento.
Então, antes de trabalhar, o arnês inspeciona o repositório, extrai o contexto do Git e os documentos do projeto e os condensa em um resumo do espaço de trabalho. Esse resumo se combina com o seu pedido, e assim o agente não começa do zero a cada prompt.
2. Formato do prompt e cache
Já temos os dados do repositório. Mas seria um desperdício montá-los e processá-los de novo a cada pedido. As sessões de programação são repetitivas: as regras do agente não mudam, a descrição das ferramentas também não, e o resumo do projeto quase nada. O que muda a cada turno é o seu último pedido, a conversa recente e a memória de curto prazo.
Por isso um arnês inteligente divide o prompt em duas partes:
- Um prefixo estável, com as instruções, as ferramentas e o resumo do espaço de trabalho, que ele reaproveita do cache.
- O estado da sessão, que ele acrescenta no final a cada turno.
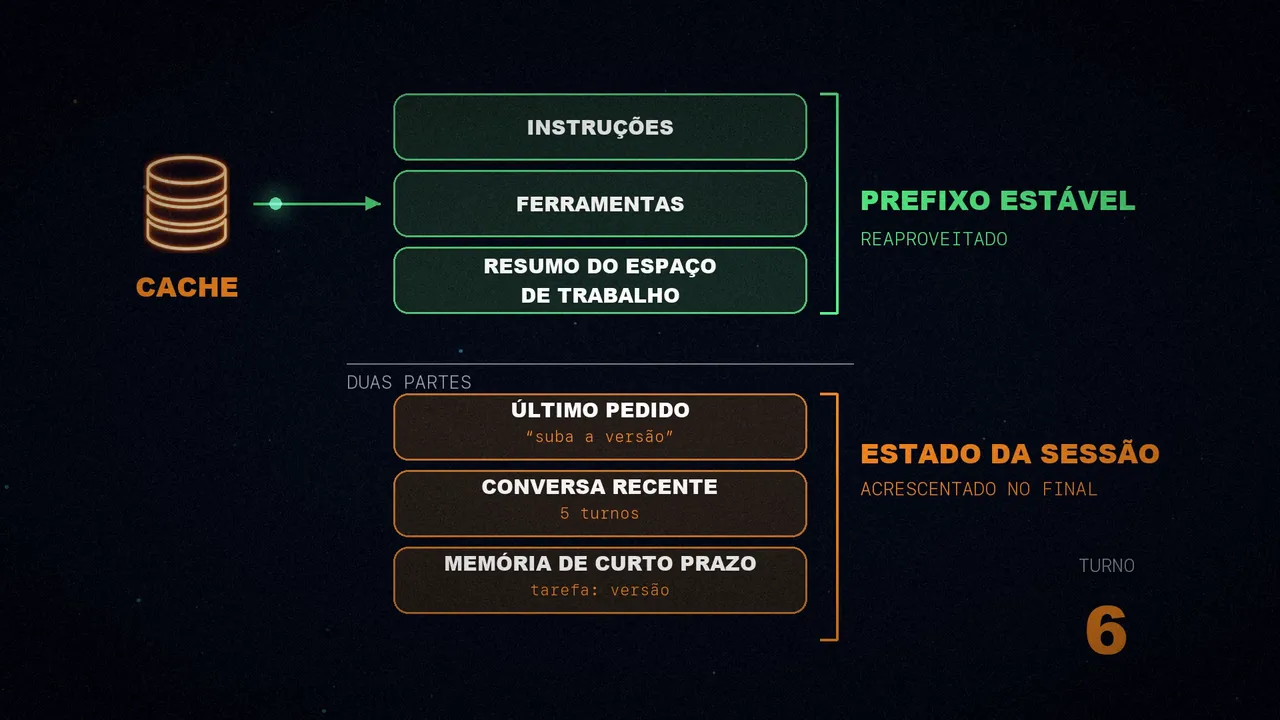
A diferença para o componente um: aquele reúne os fatos do repositório; este os empacota e guarda em cache para as chamadas repetidas ao modelo. Não faz sentido gastar computação reconstruindo do zero o que não mudou.
3. Ferramentas, validação e permissões
É aqui que deixa de parecer um chat e começa a parecer um agente. Um modelo sozinho sugere comandos em texto, e você os executa e cola o resultado para ele. Em um arnês de programação, o próprio modelo executa o comando e recebe a saída.
Mas o arnês não deixa o modelo improvisar qualquer sintaxe. Ele dá uma lista fechada de ferramentas com nome, com entradas claras e limites claros: listar o diretório, ler, buscar, executar um comando no terminal ou escrever um arquivo. E o modelo tem que passar os argumentos em um formato que o arnês consiga verificar. Quando o modelo pede uma ação, o arnês para e se faz quatro perguntas:
Só as da lista fechada.
No formato que o arnês sabe verificar.
Escrever um arquivo, por exemplo, pede permissão.
O agente não sai do repositório.
Só quando passa por todas as verificações algo é executado. Depois, o resultado é cortado e volta para o loop.
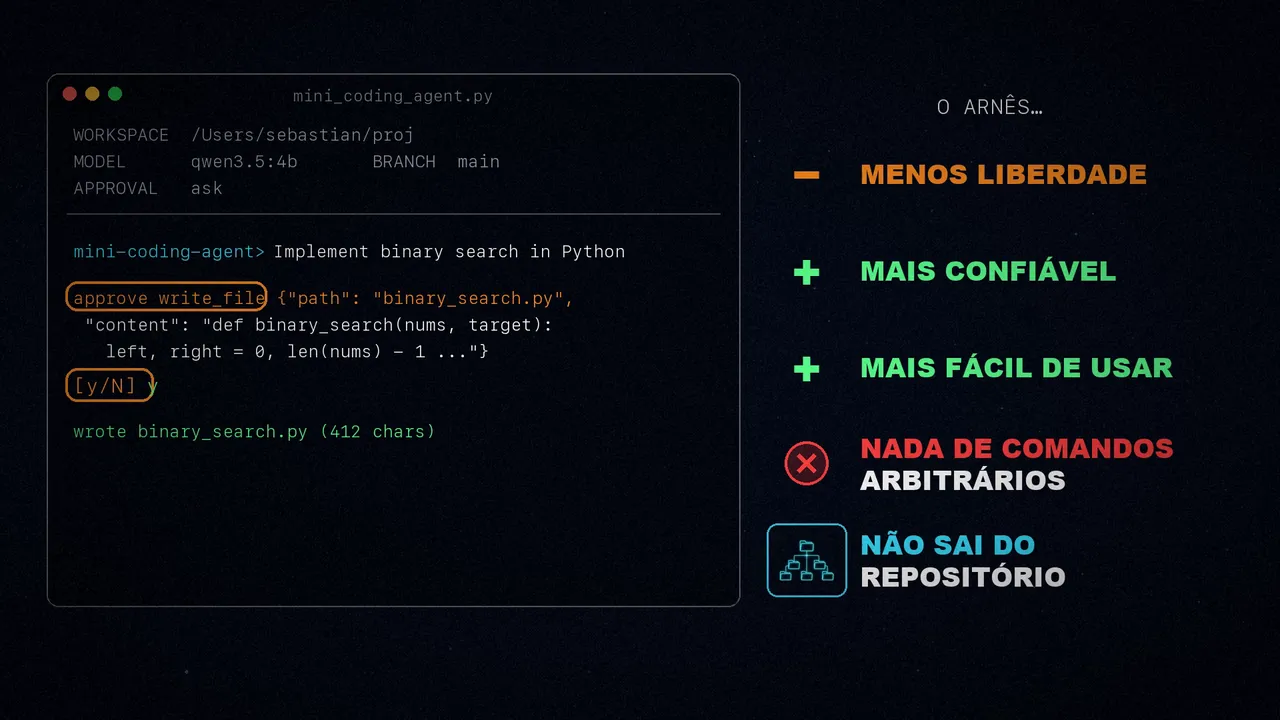
No Mini Coding Agent fica assim: você pede "implemente a busca binária em Python", e antes de escrever o arquivo ele pergunta se você aprova. O arnês dá ao modelo menos liberdade, mas assim ele fica mais confiável e mais fácil de usar: não executa comandos arbitrários e não sai do repositório.
4. Reduzir o contexto
O inchaço do contexto é um problema de todos os modelos de linguagem. Eles aceitam contextos cada vez mais longos, mas continuam sendo caros e podem trazer ruído. E um agente de programação sofre ainda mais: lê os mesmos arquivos várias vezes e acumula saídas de ferramentas e logs muito longos. Se guardasse tudo do jeito que está, ficaria sem tokens rapidinho.
Um arnês mínimo usa pelo menos duas estratégias:
- Cortar: encurta os trechos de documentos, as saídas longas, as notas de memória e as entradas do histórico, para que nenhum texto devore o orçamento do prompt só por ser longo.
- Resumir o histórico: transforma a sessão inteira em um resumo pequeno que caiba no prompt. O truque é guardar o recente com mais detalhe, porque importa mais para o passo atual, e comprimir mais o antigo.
Além disso, as leituras repetidas de um mesmo arquivo são removidas, para que o modelo não o veja de novo e de novo.
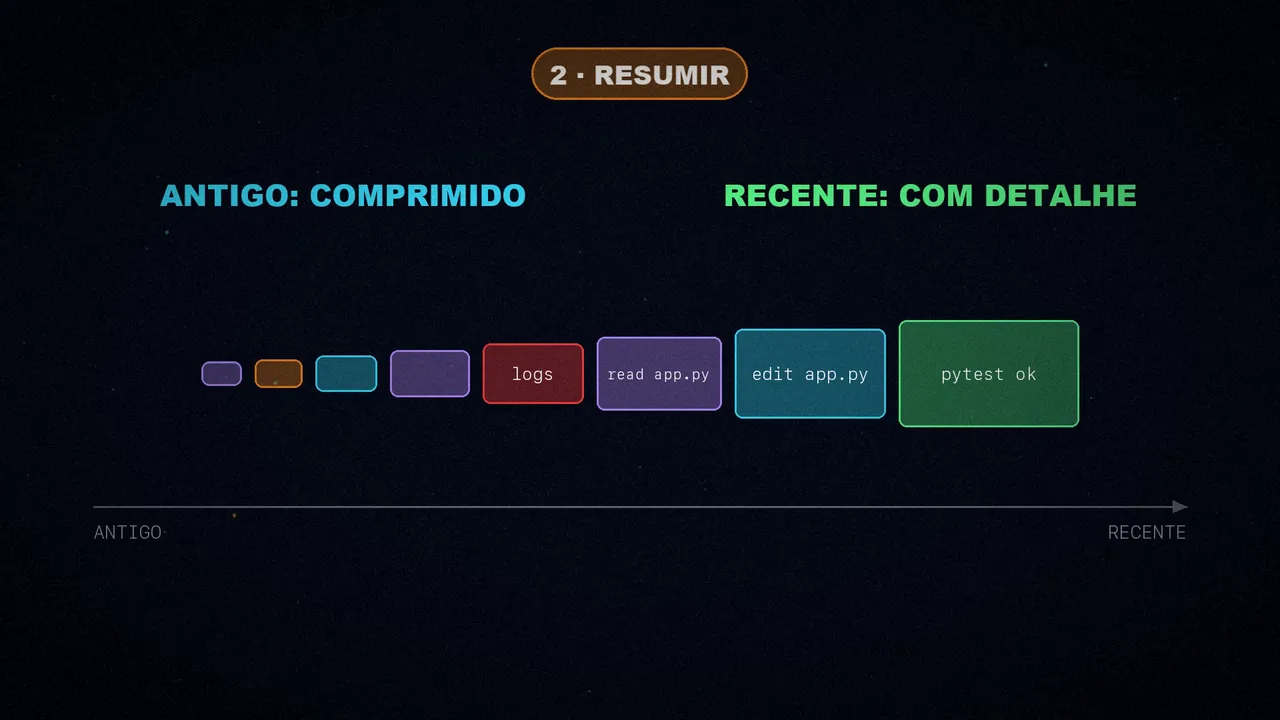
Para o Raschka, essa é uma das partes mais chatas e subestimadas do design de um agente. Mas fico com a frase dele: muito do que parece qualidade do modelo é, na verdade, qualidade do contexto.
5. Memória da sessão
O componente anterior respondia a quanto do passado volta para o modelo no próximo turno. Este responde a outra pergunta: o que o agente guarda como registro permanente? E ele separa isso em pelo menos duas camadas, que costumam ser salvas em disco como arquivos JSON:
Todos os seus pedidos, as saídas das ferramentas e as respostas do modelo. Dá para retomar mesmo se você fechar o agente.
Um estado pequeno e destilado, com a tarefa atual, os arquivos importantes e as notas recentes. Ela não só cresce: é editada e compactada.
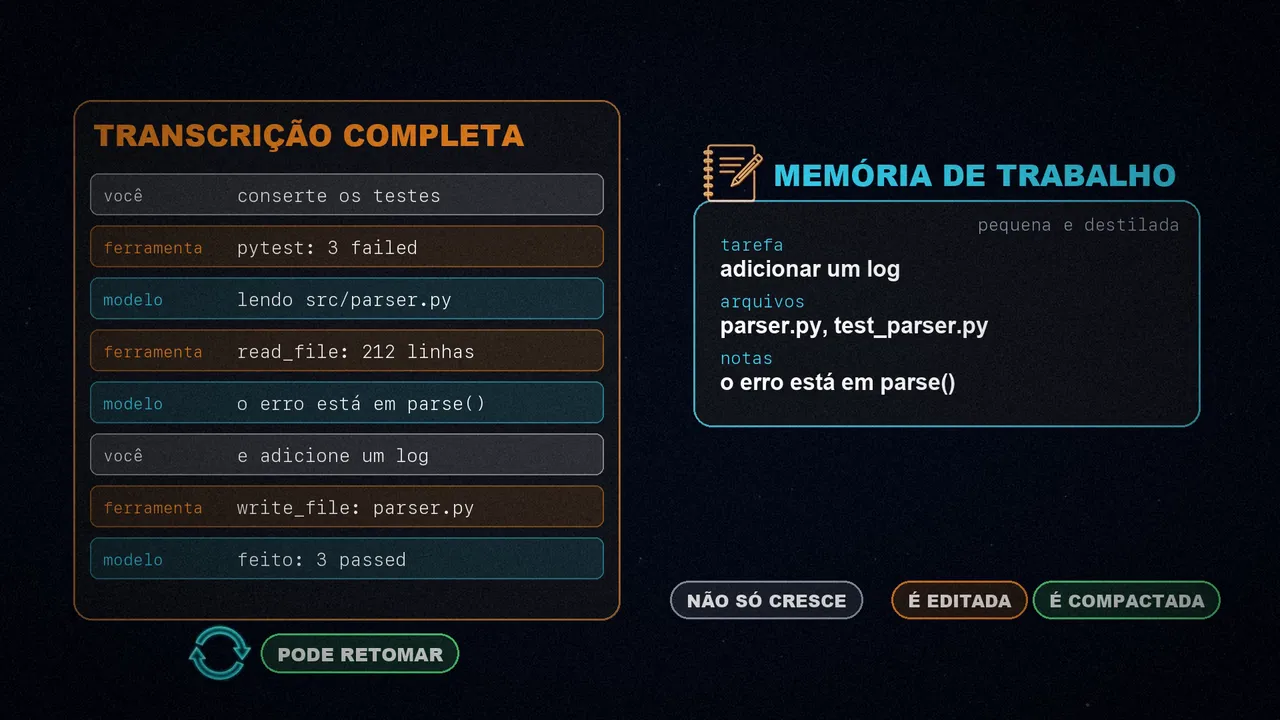
A memória de trabalho parece a mesma coisa que o histórico compacto do componente quatro, mas cumpre outra função. O histórico compacto serve para reconstruir o prompt: dá ao modelo uma visão comprimida do que é recente. A memória de trabalho serve para não perder o fio da tarefa entre os turnos. E cada evento novo é anotado nas duas camadas.
6. Subagentes com limites
Quando um agente já tem ferramentas e estado, o próximo passo é delegar. No meio de uma tarefa, ele pode precisar de uma resposta lateral: qual arquivo define um símbolo, o que diz uma configuração ou por que um teste falha. Melhor separar isso em uma subtarefa delimitada, que pode rodar em paralelo e acelerar o trabalho.
Um subagente só serve se herdar contexto suficiente para trabalhar de verdade. Mas, se não o limitarmos, teremos vários agentes repetindo trabalho, mexendo nos mesmos arquivos ou lançando mais subagentes. Como diz o Raschka: o problema difícil não é como criar um subagente, mas como amarrá-lo. Por exemplo, com acesso só de leitura e uma profundidade de recursão limitada.
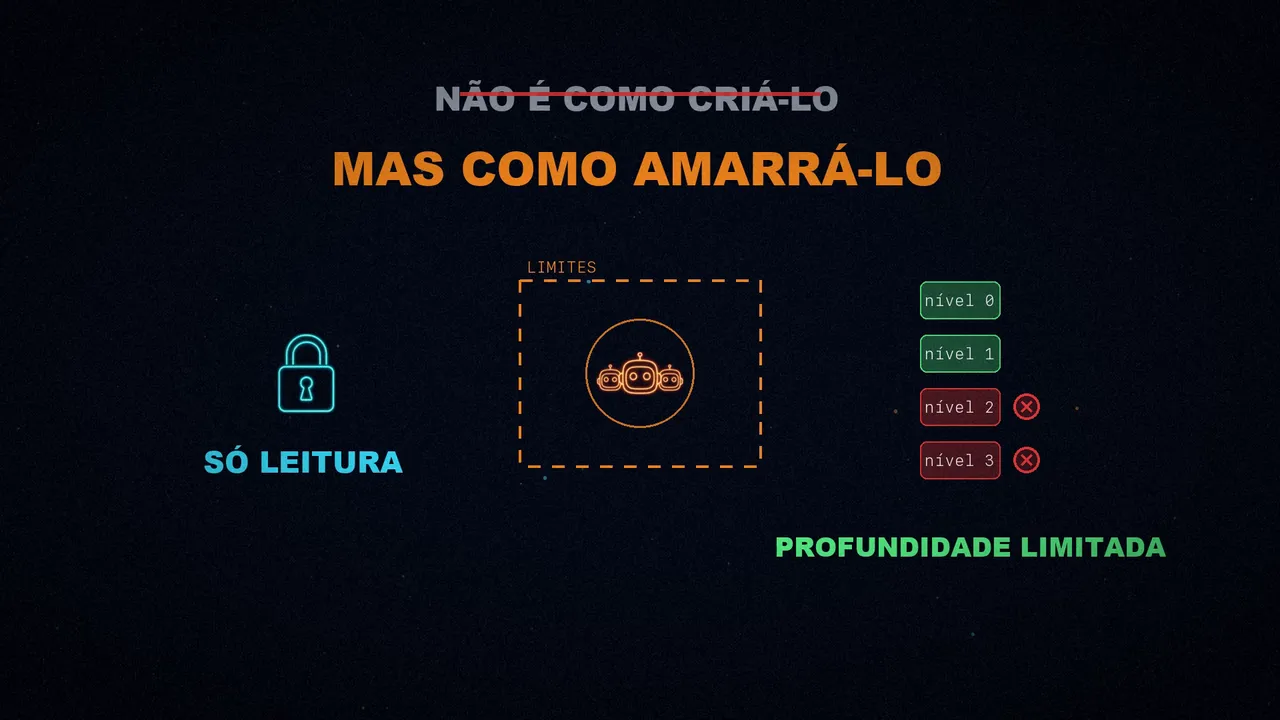
No agente do Raschka, o subagente ainda roda sem paralelismo, mas a ideia é a mesma. O Claude Code tem subagentes há algum tempo, e o Codex os adicionou mais tarde. O Codex não os obriga a ser só de leitura: eles costumam herdar o ambiente isolado e as permissões do agente principal. Ali, o limite está em delimitar a tarefa, o contexto e a profundidade.
E o OpenClaw?
Os seis componentes estão muito entrelaçados no código, mas olhar para eles um por um ajuda a entender como funciona um arnês de programação e por que ele torna o modelo muito mais útil que um chat de vários turnos. O Raschka fecha comparando com o OpenClaw, que tem muito em comum:
- Arquivos de instruções no espaço de trabalho, como
AGENTS.md,SOUL.mdeTOOLS.md. - Sessões salvas com compactação do histórico.
- Subagentes e sessões auxiliares.
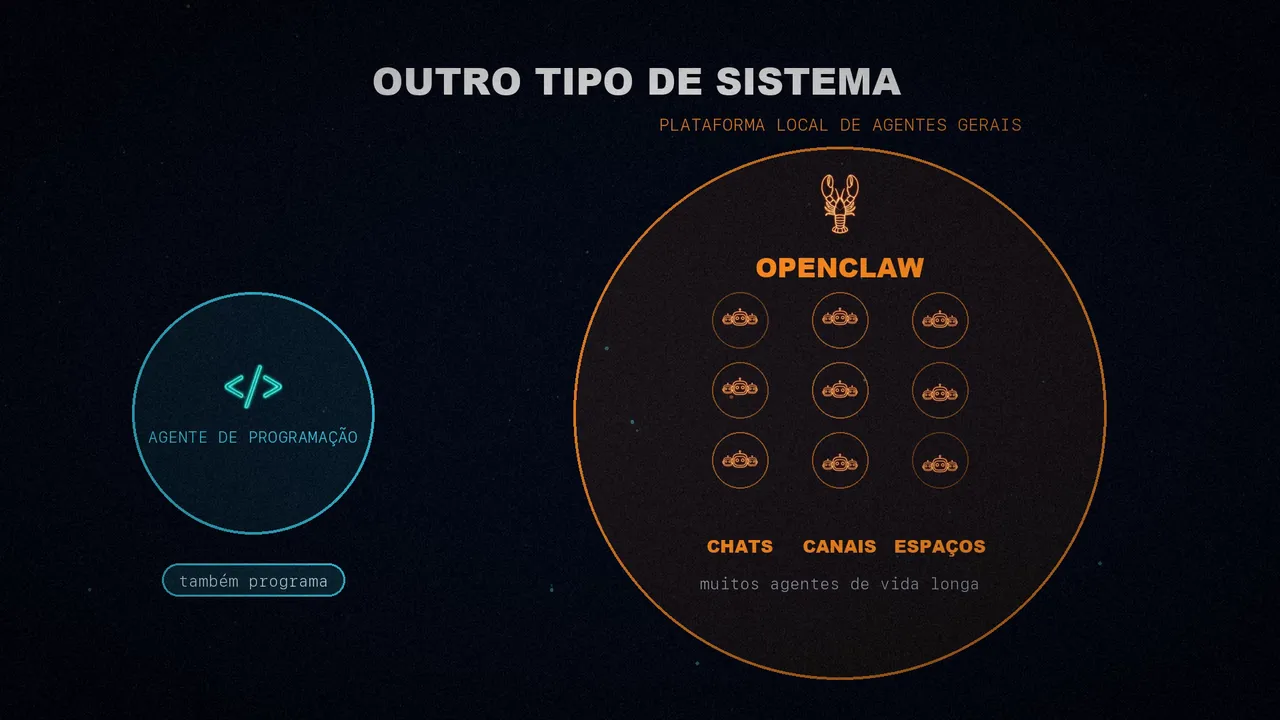
Mas é outro tipo de sistema: uma plataforma local de agentes gerais que também programam, pensada para muitos agentes de vida longa espalhados por chats, canais e espaços de trabalho. Já um agente de programação é otimizado para uma pessoa que trabalha em um repositório e pede para ele inspecionar arquivos, editar código e executar ferramentas locais de forma eficiente. No OpenClaw, programar é uma tarefa importante, mas só mais uma entre várias.
O modelo é o motor, mas o arnês o transforma em um agente: contexto do repositório, prompt com cache, ferramentas com permissões, contexto cortado, memória de sessão e subagentes com limites.
De qual componente você mais sente falta no seu agente?
Fontes
- "Components of A Coding Agent", de Sebastian Raschka (@rasbt), Ahead of AI, 4 de abril de 2026.
- O código do agente mínimo: rasbt/mini-coding-agent.
- O vídeo, nos meus três canais: espanhol, inglês e português.