Qué es comprimir el contexto
Un agente trabaja con una memoria limitada: su ventana de contexto, donde caben las instrucciones, la conversación, los resultados de las herramientas y todo lo que ha leído. Comprimir el contexto es sustituir los mensajes antiguos por un resumen de lo que lleva hecho, que conserve solo lo relevante para la tarea.
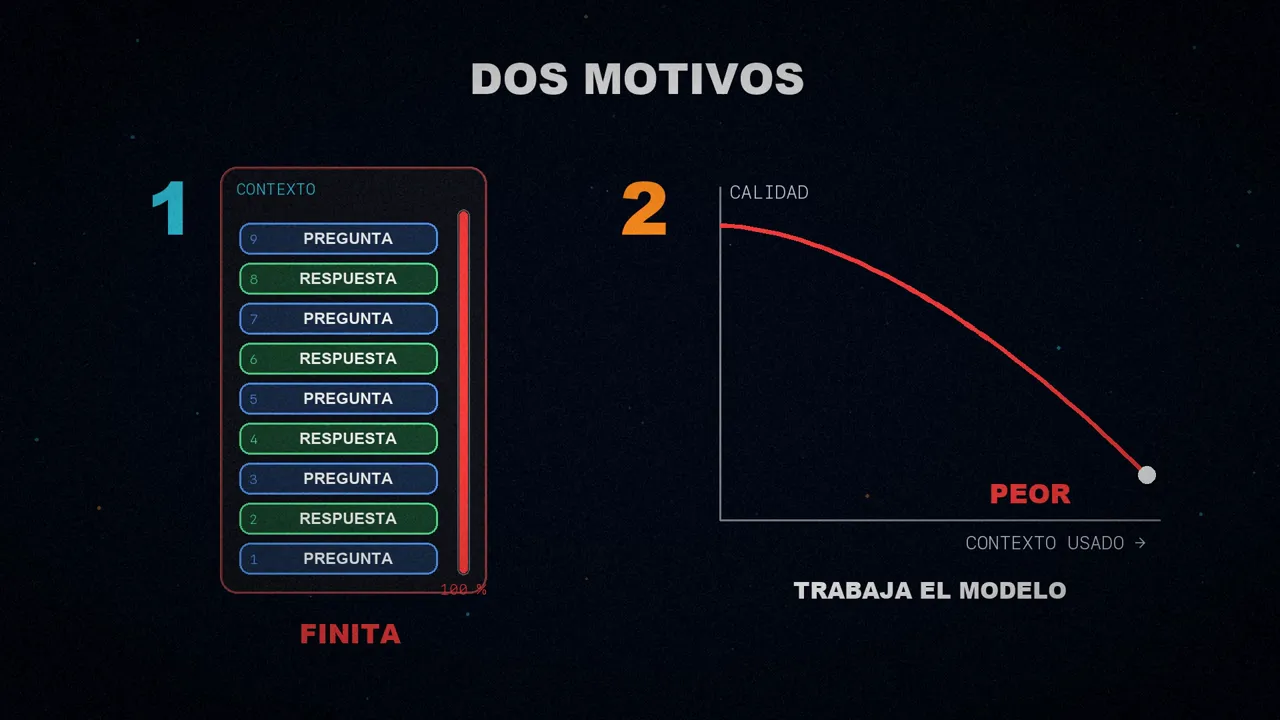
Hace falta por dos motivos. El primero es obvio: las ventanas de contexto son finitas, y en una tarea larga se acaban llenando. El segundo es menos evidente: cuanto más se llena la ventana, peor trabaja el modelo con ella. Es lo que se conoce como deterioro del contexto, o context rot.
El problema del umbral fijo
Lo habitual es que el arnés, el software que envuelve al modelo, controle la compresión con un umbral fijo de tokens. Deep Agents, por ejemplo, usa perfiles de modelo para compactar al llegar al 85 % del límite de contexto de cada modelo.
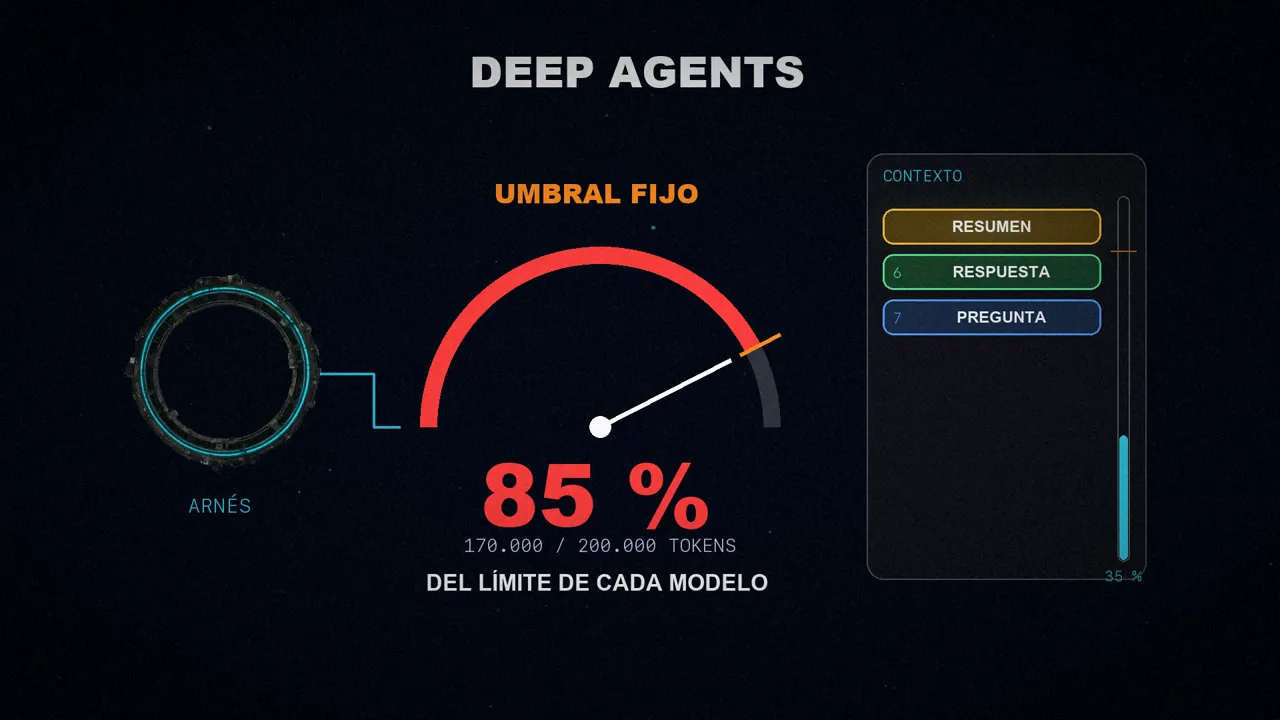
El artículo explica por qué eso no es lo ideal: hay momentos buenos y momentos malos para compactar, y un umbral no distingue unos de otros.
- Mal momento: en mitad de una refactorización compleja. El agente pierde los detalles justo cuando más los necesita.
- Buen momento: al empezar una tarea nueva, o cuando el contexto anterior va a dejar de ser útil.
Una herramienta para el agente
Muchas herramientas de programación con agentes tienen un comando /compact para que el usuario comprima el contexto a mano cuando le parezca oportuno. LangChain va un paso más allá: le da al agente una herramienta para lanzar la compresión él mismo.
La ventaja es que compacta en el momento oportuno sin que los usuarios de tu aplicación tengan que saber que el contexto es finito, ni escribir ningún comando.
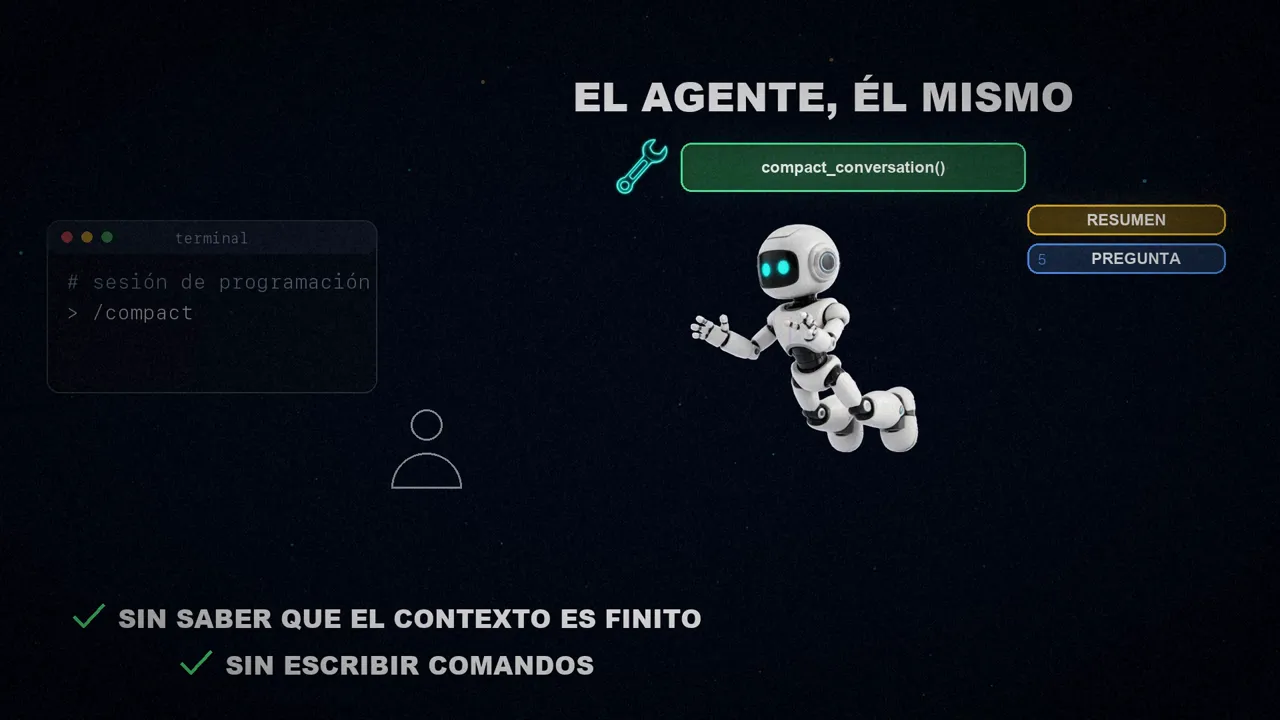
/compact a mano a una herramienta que el agente llama solo.Detrás hay una idea más grande. LangChain cree que el arnés debe apartarse siempre que pueda y aprovechar que los modelos razonan cada vez mejor. Es la famosa lección amarga (the bitter lesson): en lugar de ajustar el arnés a mano con reglas cada vez más finas, darle al agente más control sobre su propio contexto.
Cuándo compactar: cinco situaciones
Si el agente decide, ¿cuándo debería hacerlo? El artículo agrupa los buenos momentos en cinco situaciones:
El usuario pasa a otra cosa para la que el contexto anterior seguramente no sirve, o el agente termina un entregable y el usuario lo da por bueno.
El agente ha obtenido un dato, una conclusión o un resumen consumiendo mucho contexto, como en una tarea de investigación.
Va a escribir un borrador largo o a leer muchos documentos.
Va a empezar una refactorización, una migración, una edición de muchos archivos o la respuesta a un incidente; por ejemplo, cuando ya tiene el plan y va a ejecutarlo.
Llegan requisitos nuevos que invalidan el contexto anterior, o hay muchas tangentes y callejones sin salida que caben en un resumen.
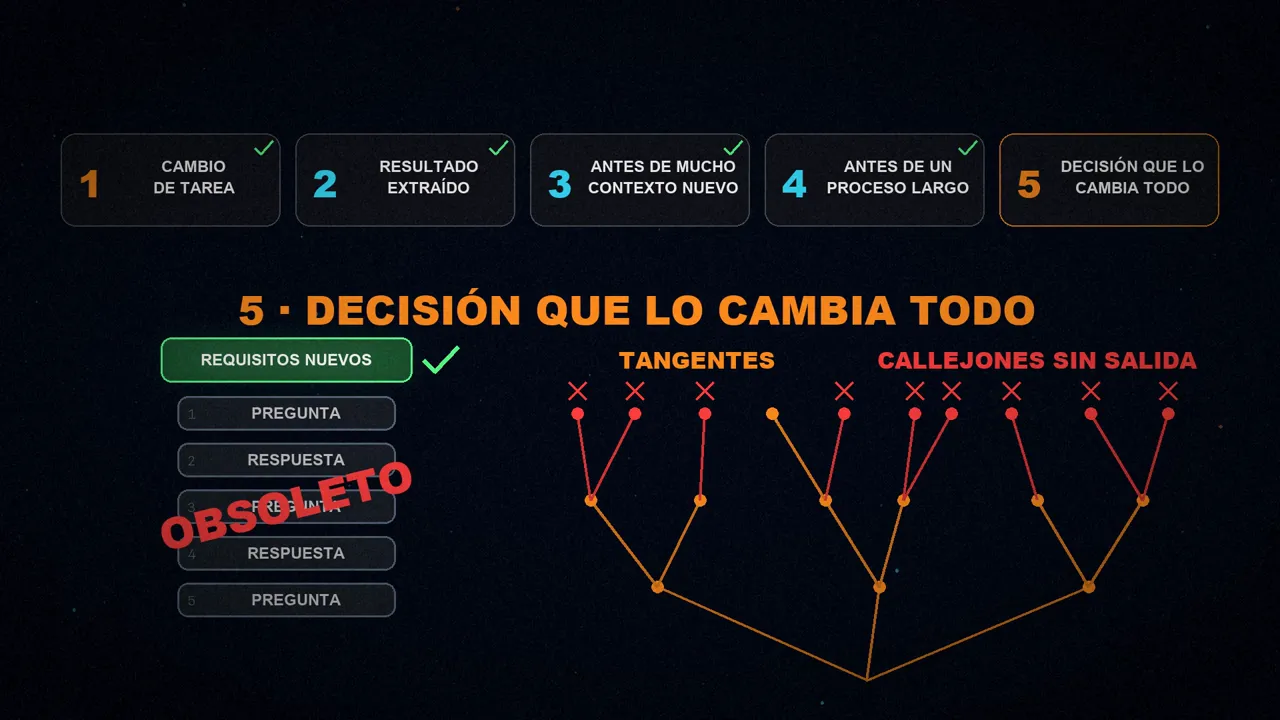
No se pueden enumerar todos los casos, pero según LangChain las personas y los modelos de lenguaje saben reconocerlos. Por eso le explican al modelo estos criterios en las instrucciones de la herramienta. Y compactar a tiempo tiene una ventaja añadida: evita tener que hacerlo a la fuerza más tarde, cuando la ventana está a punto de llenarse.
Qué pasa al llamar a la herramienta
La herramienta funciona igual que el resumen automático que ya tenía Deep Agents, con los mismos parámetros:
- Se conservan los mensajes recientes: un 10 % del contexto disponible. Entre ellos queda la propia llamada a la herramienta, con su respuesta.
- Lo anterior se resume: todo lo que viene antes pasa a ser un único mensaje de resumen.
- No se pierde nada: los mensajes originales se guardan en un archivo,
/conversation_history/{thread_id}.md, en el sistema de archivos virtual del agente. - El resumen lleva un puntero: en el contexto queda el resumen con una referencia a ese archivo, por si el agente necesita volver a los detalles.
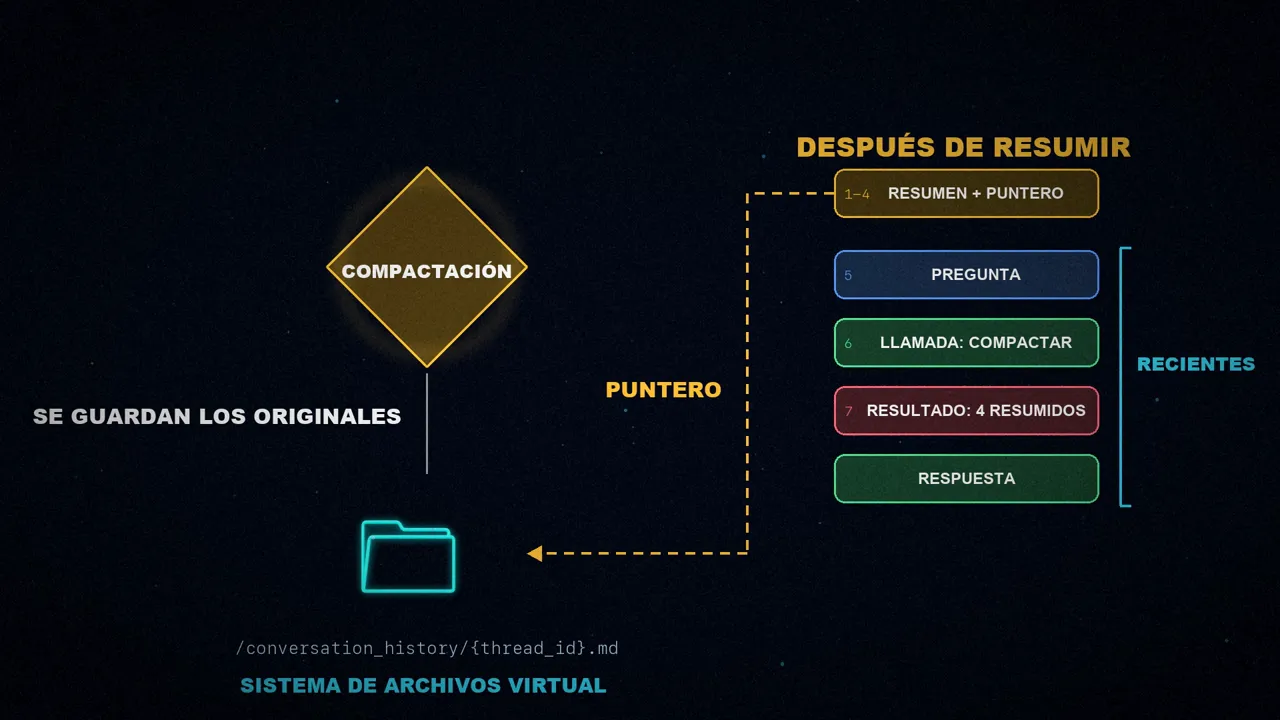
Es la idea que más me gusta del diseño: resumir no es olvidar, es guardar en otro sitio.
Cómo usarla
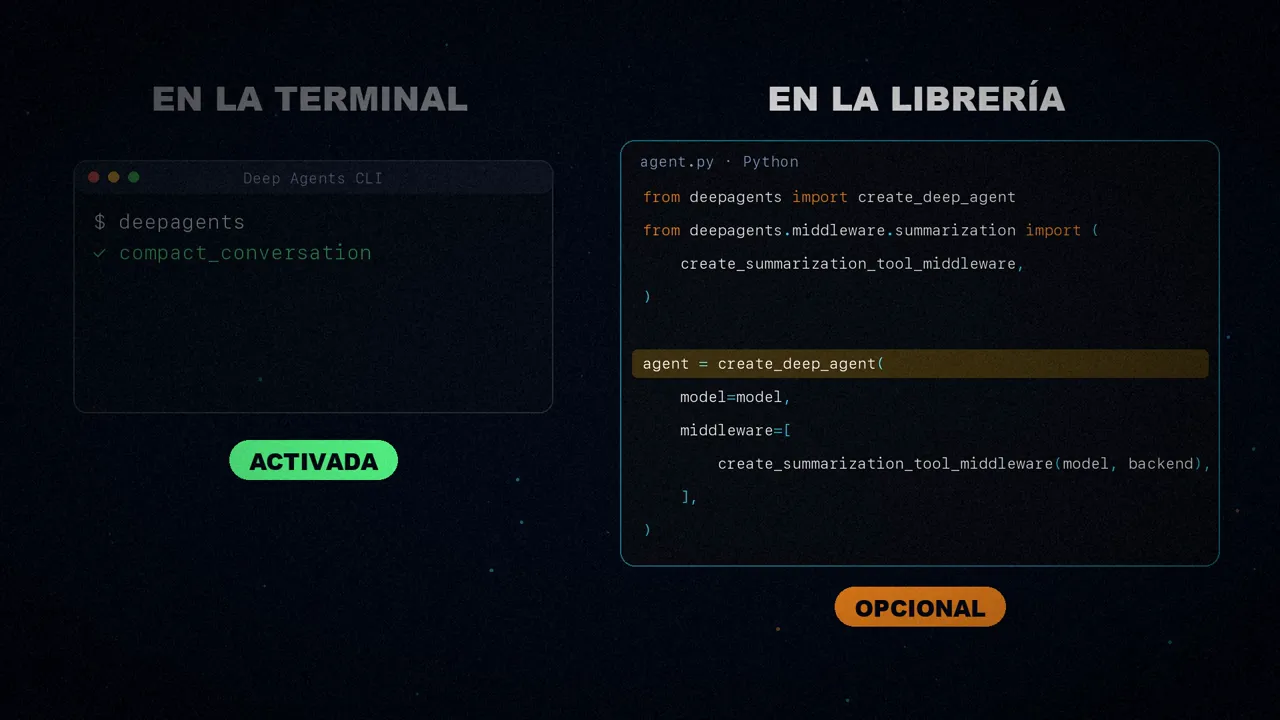
En la herramienta de terminal de Deep Agents (Deep Agents CLI) ya viene activada. En la librería de Python es opcional: es un middleware aparte que se añade a la lista middleware al crear el agente. Este es el ejemplo del artículo:
from deepagents import create_deep_agent
from deepagents.backends import StateBackend
from deepagents.middleware.summarization import (
    create_summarization_tool_middleware,
)

backend = StateBackend  # si usas el backend por defecto
model = "openai:gpt-5.4"
agent = create_deep_agent(
    model=model,
    middleware=[
        create_summarization_tool_middleware(model, backend),
    ],
)
Y en la terminal también puedes escribir tú /compact cuando quieras recortar el contexto o cambiar de tarea.
Cómo la probaron
LangChain ajustó la herramienta para que fuera conservadora. Deep Agents guarda todo el historial, así que el contexto se puede recuperar después de resumir, pero una compresión a destiempo interrumpe el trabajo. La probaron de tres formas:
- Una batería de evaluación propia: sobre conversaciones reales, sacadas de sus trazas de LangSmith, inyectaban preguntas de seguimiento; unas merecían compactar y otras no.
- Terminal Bench 2: un banco de pruebas de tareas en la terminal, donde el agente no compactó por su cuenta ni una sola vez.
- Sus propias tareas de programación con la herramienta de terminal de Deep Agents.
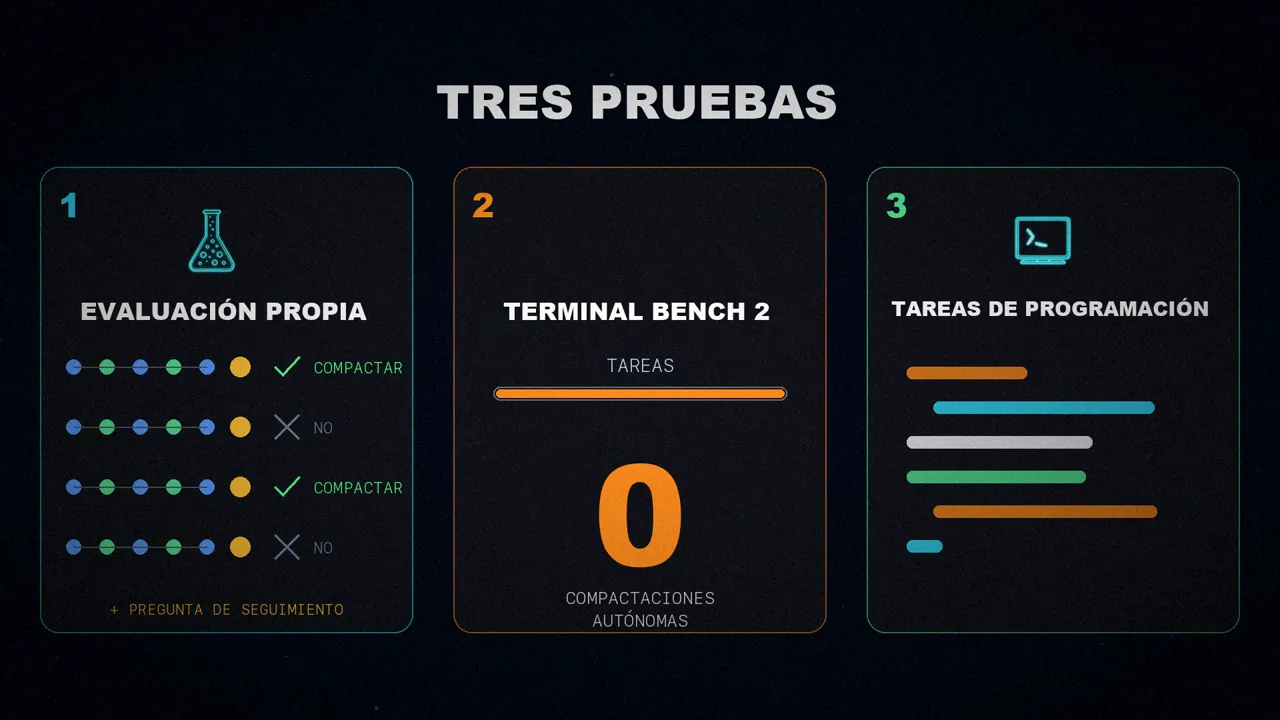
¿El resultado? Los agentes son prudentes y compactan poco. Pero, cuando lo hacen, suelen elegir momentos en los que el flujo de trabajo mejora claramente.
¿Es mala señal que no compactara nunca?
Ese cero en Terminal Bench me llamó la atención. Si dejas que el modelo decida cuándo compactar y no lo hace nunca, a primera vista parece una mala noticia. El artículo no lo explica, así que lo he contrastado con el código de Deep Agents, y creo que no es necesariamente mala señal, por dos razones.
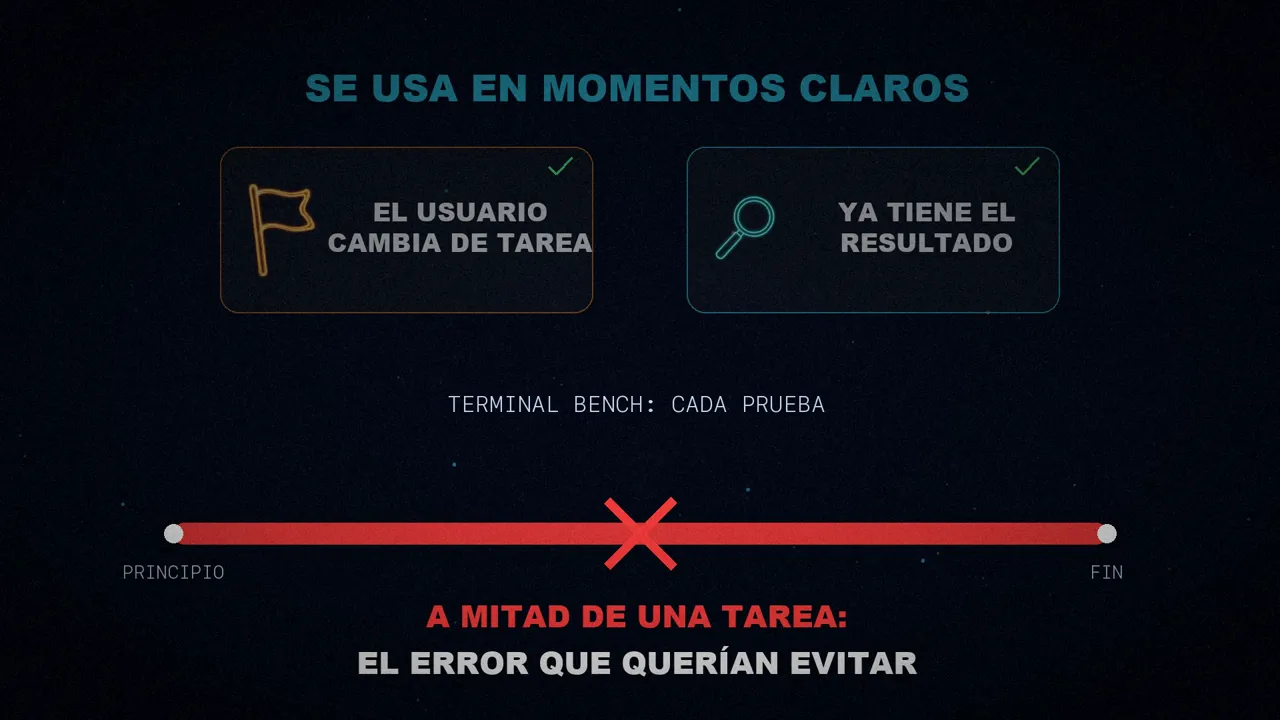
La primera: esos momentos no llegan. A la herramienta se le pide usarla en momentos claros, como cuando el usuario cambia de tarea o cuando el agente ya ha sacado el resultado que buscaba. En Terminal Bench, cada prueba es una sola tarea, de principio a fin, sin cambios de tema. Y comprimir a mitad de una tarea es justo el error que querían evitar.
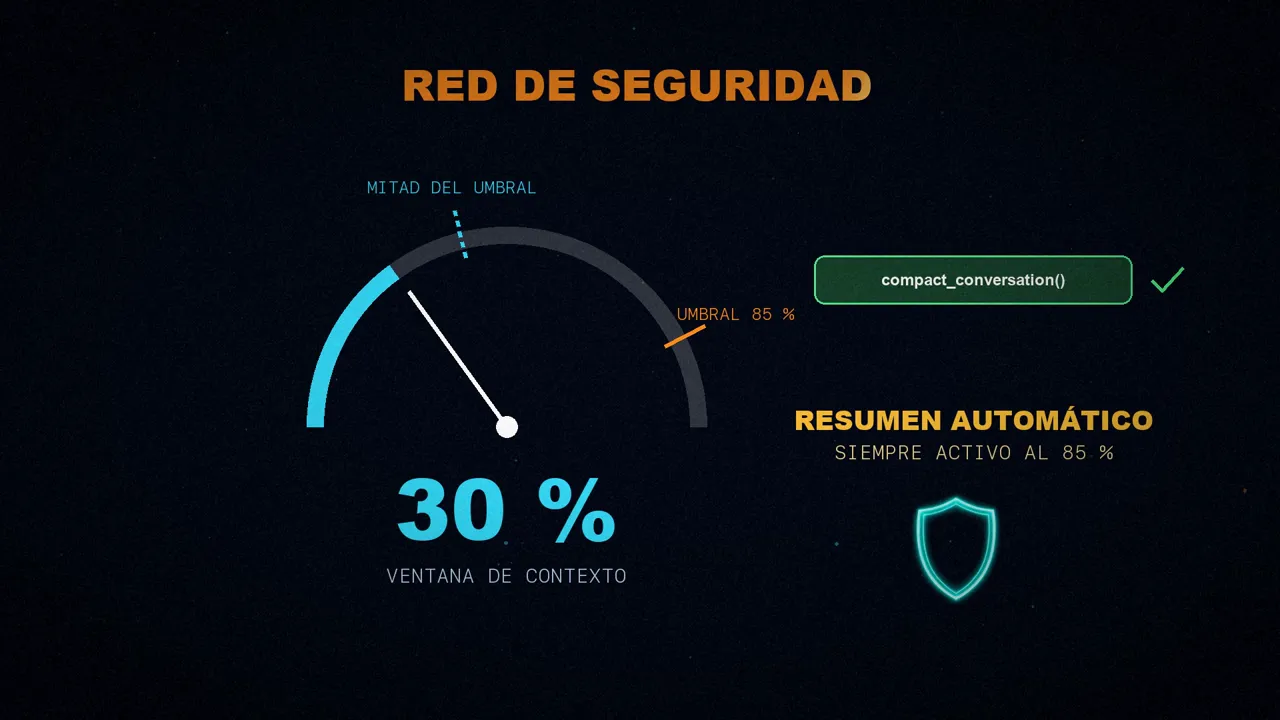
La segunda: no compactar no significa desbordarse. En el código, la herramienta ni siquiera acepta comprimir hasta que la conversación llega a la mitad del umbral; antes responde «Nothing to compact yet». Y la herramienta se añade al resumen automático, no lo sustituye: create_deep_agent lo incluye siempre, así que cuando la ventana se llena el resumen automático del 85 % sigue actuando como red de seguridad.
Lo que el artículo no da son cifras: no sabemos cuántas veces debería haber compactado el agente y no lo hizo. Así que el cero no demuestra que la herramienta funcione, pero tampoco que falle.
Una dirección más amplia
La compresión autónoma del contexto es una función pequeña, pero apunta a una dirección más amplia en el diseño de agentes: dar a los modelos más control sobre su propia memoria de trabajo y menos reglas rígidas ajustadas a mano en el arnés.
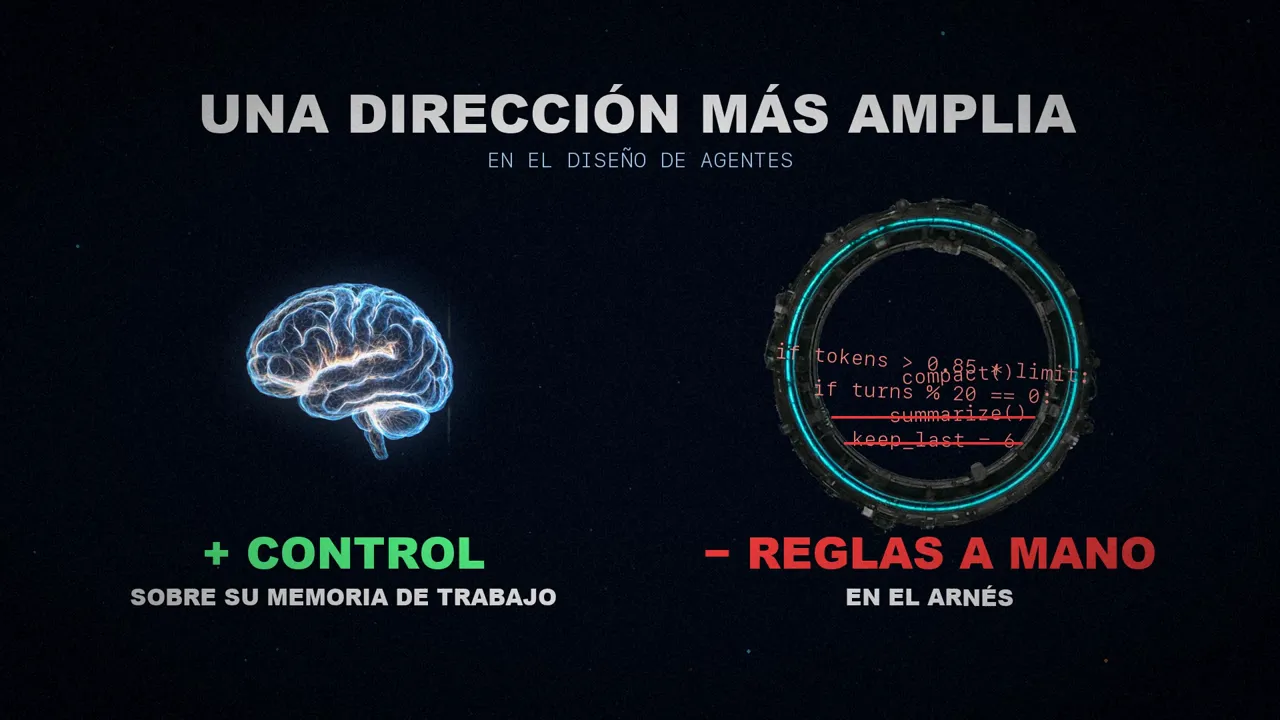
En lugar de compactar siempre al 85 %, el agente decide cuándo resumir su contexto y elige los momentos en los que le ayuda.
¿Dejarías que tu agente decidiera cuándo olvidar?
Fuentes
- «Autonomous context compression», del equipo de LangChain (@LangChain), 11 de marzo de 2026.
- El middleware de resumen de Deep Agents, donde se ve el mínimo de la mitad del umbral y el mensaje «Nothing to compact yet»:
summarization.py. - El vídeo, en mis tres canales: español, inglés y portugués.