O que é comprimir o contexto
Um agente trabalha com uma memória limitada: sua janela de contexto, onde cabem as instruções, a conversa, os resultados das ferramentas e tudo o que ele leu. Comprimir o contexto é substituir as mensagens antigas por um resumo do que ele já fez, que mantenha só o que é relevante para a tarefa.
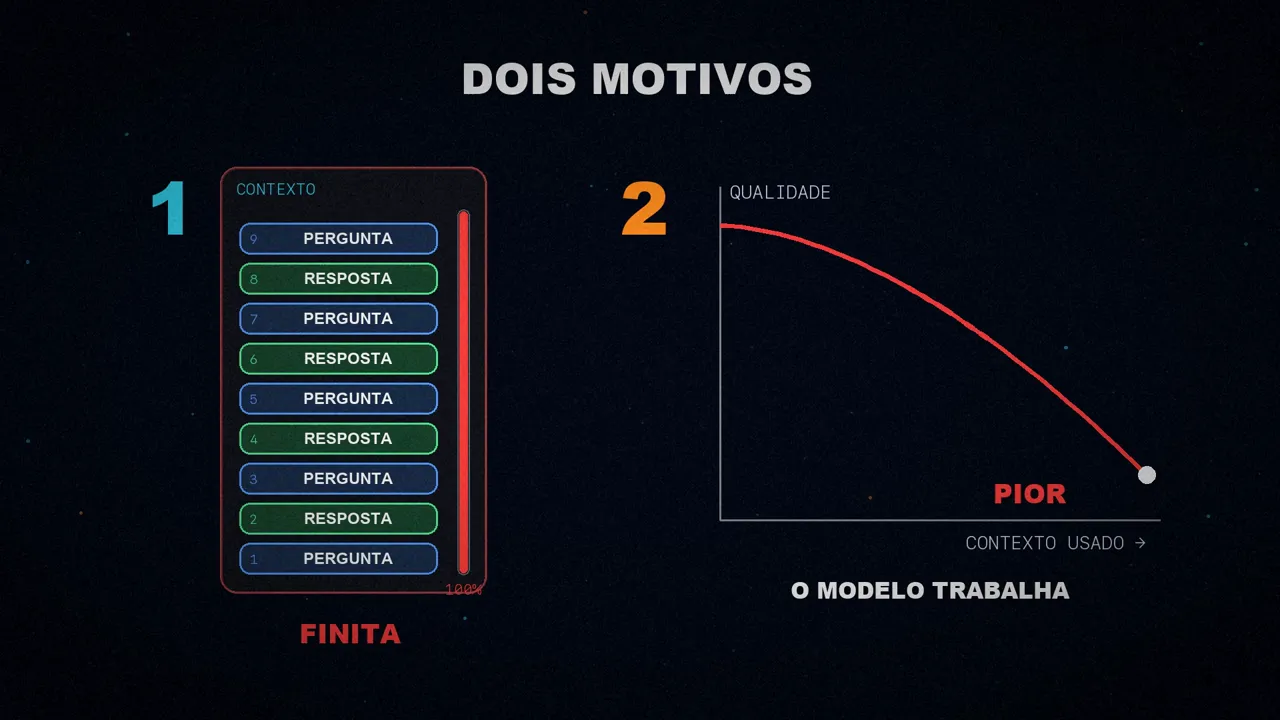
Isso é necessário por dois motivos. O primeiro é óbvio: as janelas de contexto são finitas, e uma tarefa longa acaba enchendo a janela. O segundo é menos evidente: quanto mais a janela enche, pior o modelo trabalha com ela. É o que se chama de deterioração do contexto, ou context rot.
O problema do limite fixo
O normal é que o arnês, o software que envolve o modelo, controle a compressão com um limite fixo de tokens. O Deep Agents, por exemplo, usa perfis de modelo para compactar ao chegar a 85% do limite de contexto de cada modelo.
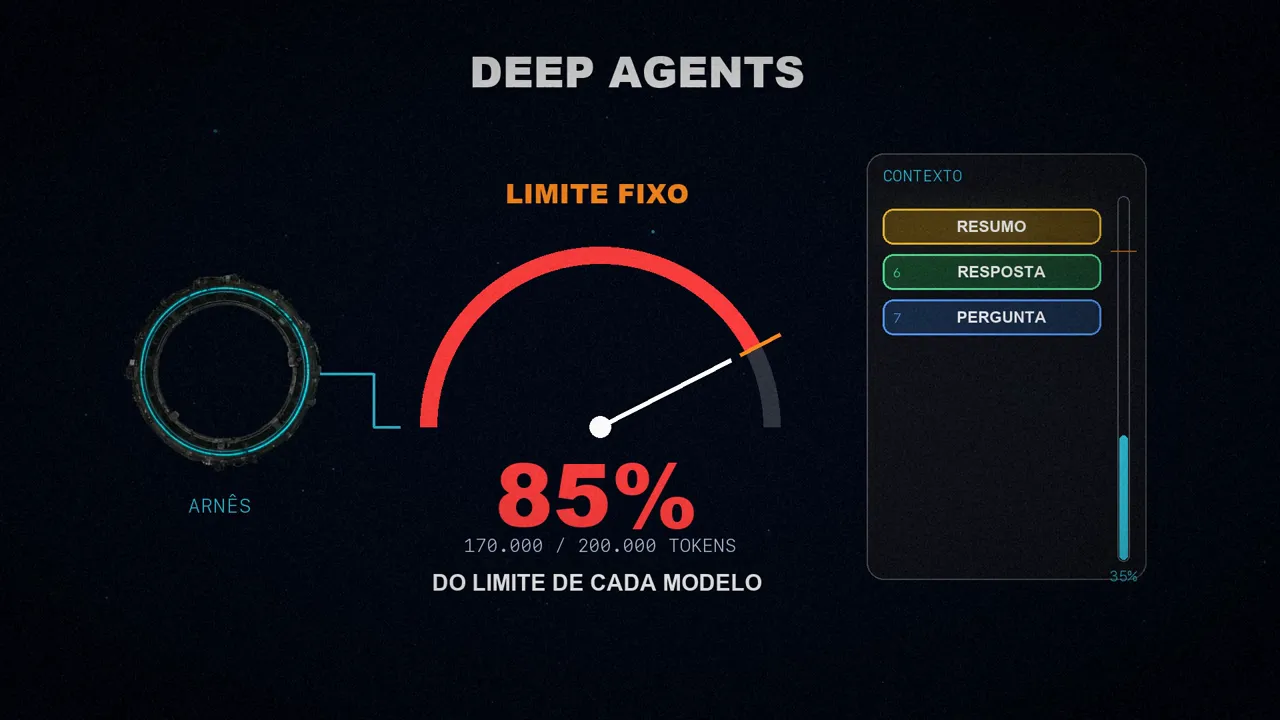
O artigo explica por que isso não é o ideal: há momentos bons e momentos ruins para compactar, e um limite não distingue uns dos outros.
- Momento ruim: no meio de uma refatoração complexa. O agente perde os detalhes justamente quando mais precisa deles.
- Momento bom: ao começar uma tarefa nova, ou quando o contexto anterior vai deixar de ser útil.
Uma ferramenta para o agente
Muitas ferramentas de programação com agentes têm um comando /compact para que o usuário comprima o contexto manualmente quando achar oportuno. A LangChain vai um passo além: dá ao agente uma ferramenta para disparar a compressão ele mesmo.
A vantagem é que ele compacta no momento certo sem que os usuários da sua aplicação precisem saber que o contexto é finito, nem digitar comando nenhum.
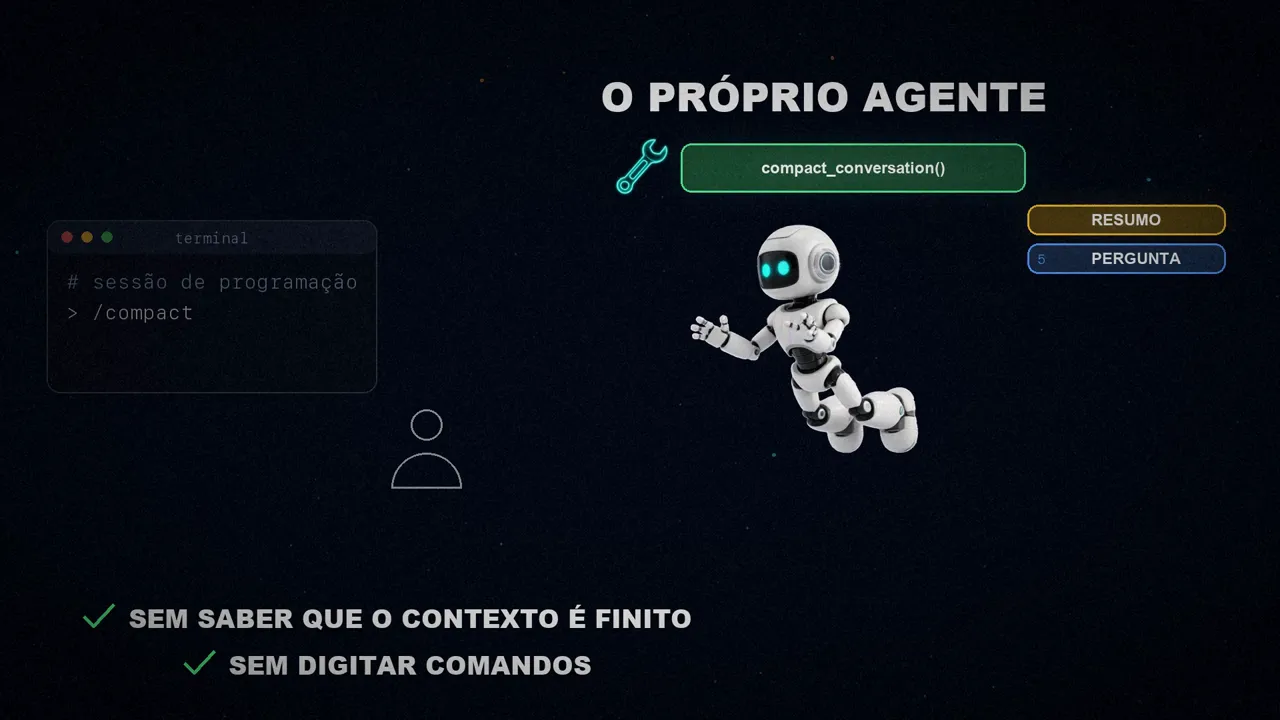
/compact manual a uma ferramenta que o agente chama sozinho.Por trás há uma ideia maior. A LangChain acredita que o arnês deve sair do caminho sempre que puder e aproveitar que os modelos raciocinam cada vez melhor. É a famosa lição amarga (the bitter lesson): em vez de ajustar o arnês à mão com regras cada vez mais finas, dar ao agente mais controle sobre o próprio contexto.
Quando compactar: cinco situações
Se o agente decide, quando ele deveria fazer isso? O artigo agrupa os bons momentos em cinco situações:
O usuário passa para outra coisa para a qual o contexto anterior provavelmente não serve, ou o agente termina uma entrega e o usuário a aprova.
O agente obteve um dado, uma conclusão ou um resumo consumindo muito contexto, como numa tarefa de pesquisa.
Ele vai escrever um rascunho longo ou ler muitos documentos.
Ele vai começar uma refatoração, uma migração, uma edição de muitos arquivos ou a resposta a um incidente; por exemplo, quando já tem o plano e vai executá-lo.
Chegam requisitos novos que invalidam o contexto anterior, ou há muitas tangentes e becos sem saída que cabem num resumo.
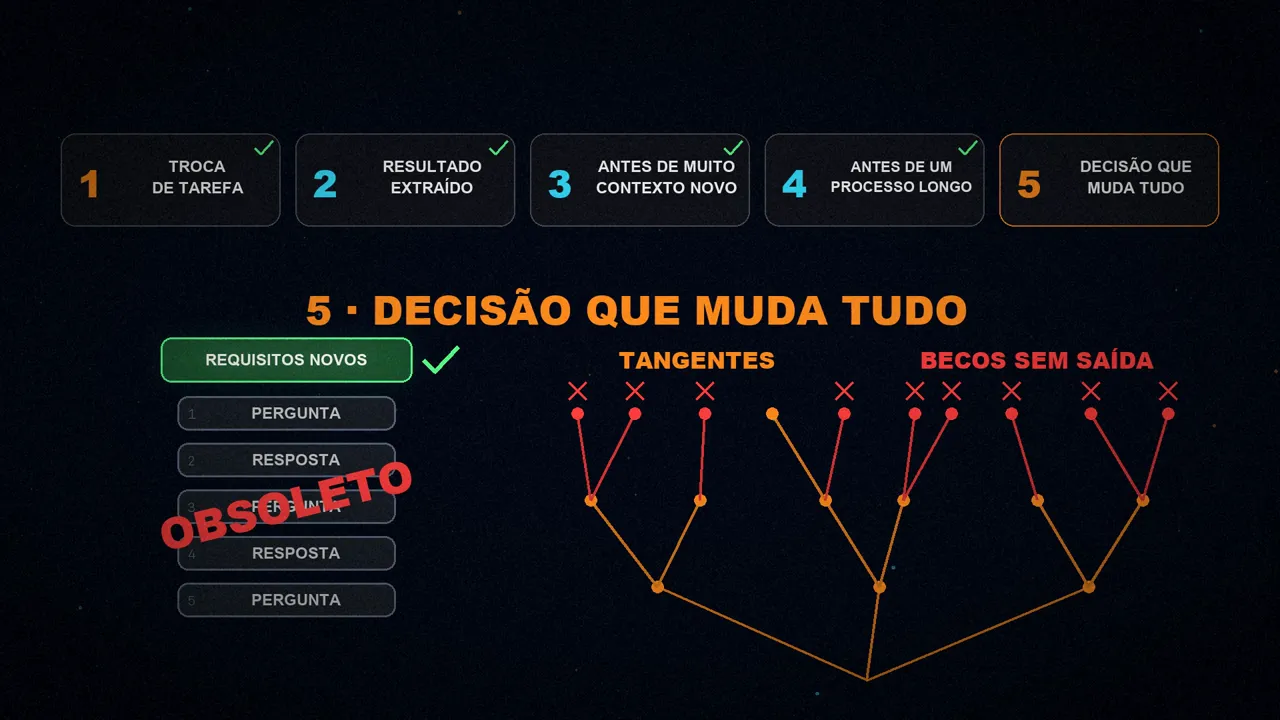
Não dá para listar todos os casos, mas, segundo a LangChain, as pessoas e os modelos de linguagem sabem reconhecê-los. Por isso eles explicam esses critérios ao modelo nas instruções da ferramenta. E compactar a tempo tem uma vantagem extra: evita ter que fazer isso à força mais tarde, quando a janela está prestes a encher.
O que acontece ao chamar a ferramenta
A ferramenta funciona igual ao resumo automático que o Deep Agents já tinha, com os mesmos parâmetros:
- As mensagens recentes são mantidas: 10% do contexto disponível. Entre elas fica a própria chamada à ferramenta, com sua resposta.
- O que veio antes é resumido: tudo vira uma única mensagem de resumo.
- Nada se perde: as mensagens originais são salvas num arquivo,
/conversation_history/{thread_id}.md, no sistema de arquivos virtual do agente. - O resumo leva um ponteiro: no contexto fica o resumo com uma referência a esse arquivo, caso o agente precise voltar aos detalhes.
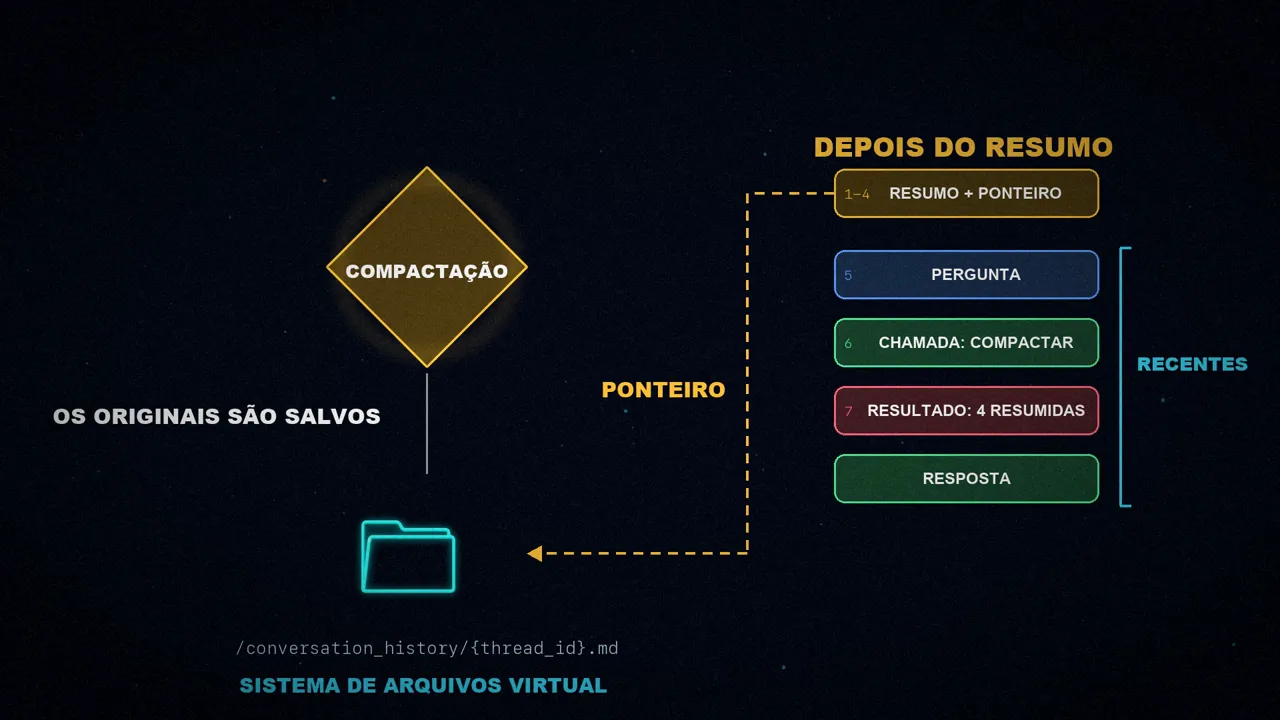
É a parte do design de que mais gosto: resumir não é esquecer, é guardar em outro lugar.
Como usar
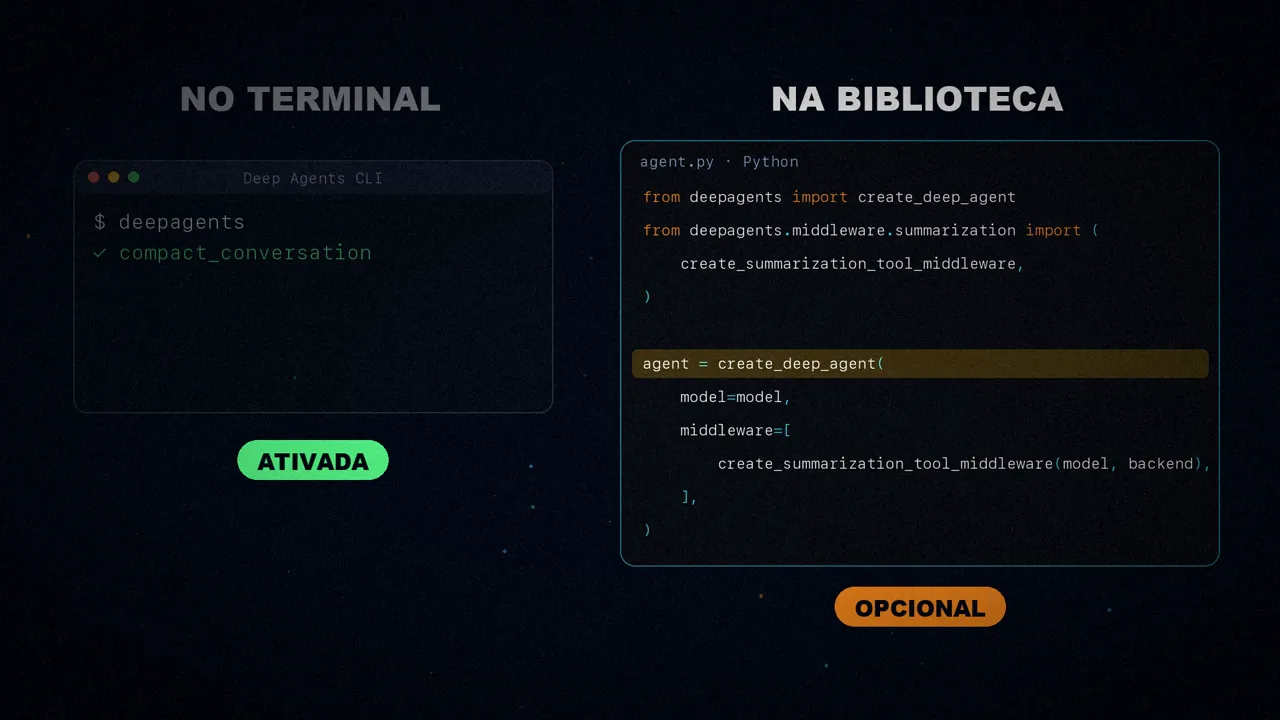
Na ferramenta de terminal do Deep Agents (Deep Agents CLI), ela já vem ativada. Na biblioteca de Python, é opcional: é um middleware à parte que você adiciona à lista middleware ao criar o agente. Este é o exemplo do artigo:
from deepagents import create_deep_agent
from deepagents.backends import StateBackend
from deepagents.middleware.summarization import (
    create_summarization_tool_middleware,
)

backend = StateBackend  # se usar o backend padrão
model = "openai:gpt-5.4"
agent = create_deep_agent(
    model=model,
    middleware=[
        create_summarization_tool_middleware(model, backend),
    ],
)
E no terminal você também pode digitar /compact quando quiser reduzir o contexto ou trocar de tarefa.
Como a testaram
A LangChain configurou a ferramenta para ser conservadora. O Deep Agents guarda todo o histórico, então o contexto pode ser recuperado depois do resumo, mas uma compressão na hora errada atrapalha o trabalho. Eles a testaram de três formas:
- Uma bateria de avaliação própria: em conversas reais, tiradas dos traces do LangSmith, injetavam perguntas de acompanhamento; umas pediam compactação e outras não.
- Terminal Bench 2: um benchmark de tarefas no terminal, onde o agente não compactou por conta própria nem uma única vez.
- Suas próprias tarefas de programação com a ferramenta de terminal do Deep Agents.
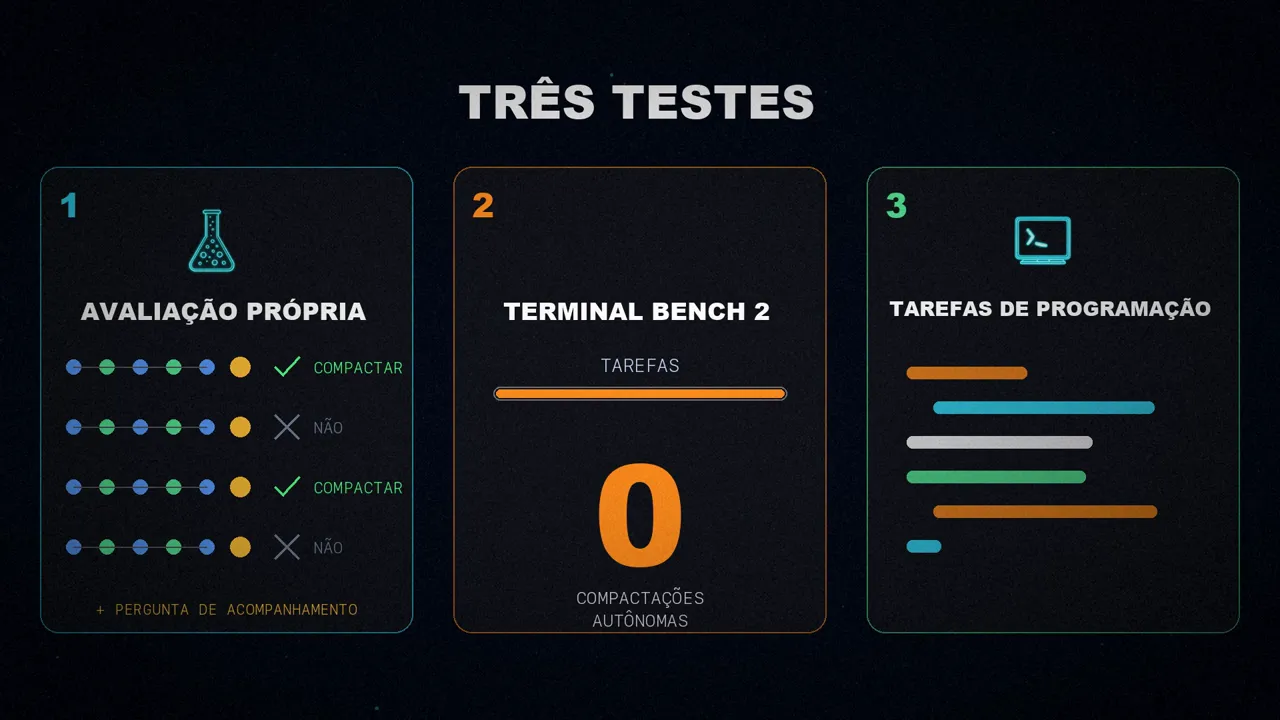
O resultado? Os agentes são cautelosos e compactam pouco. Mas, quando compactam, costumam escolher momentos em que o fluxo de trabalho melhora claramente.
É mau sinal que ele nunca tenha compactado?
Esse zero no Terminal Bench me chamou a atenção. Se você deixa o modelo decidir quando compactar e ele nunca compacta, à primeira vista parece uma má notícia. O artigo não explica isso, então conferi no código do Deep Agents, e acho que não é necessariamente mau sinal, por dois motivos.
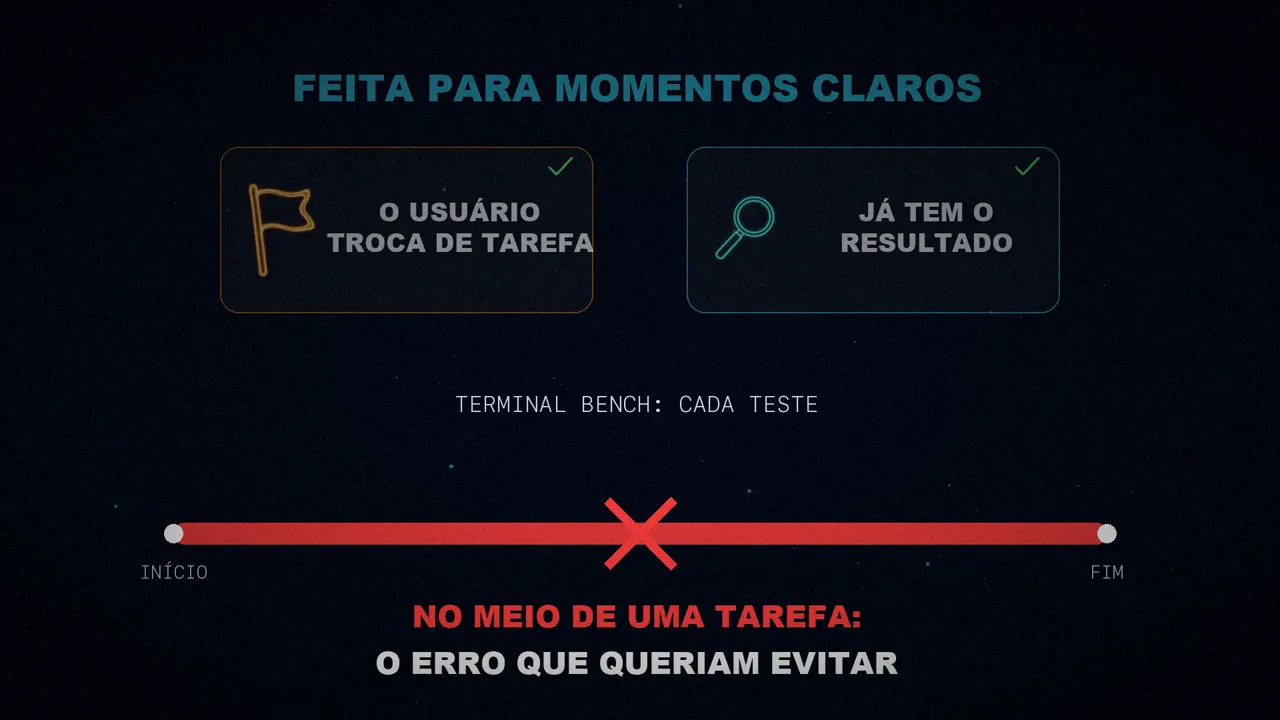
O primeiro: esses momentos não chegam. A ferramenta deve ser usada em momentos claros, como quando o usuário muda de tarefa ou quando o agente já obteve o resultado que procurava. No Terminal Bench, cada teste é uma única tarefa, do começo ao fim, sem mudança de assunto. E comprimir no meio de uma tarefa é justamente o erro que eles queriam evitar.
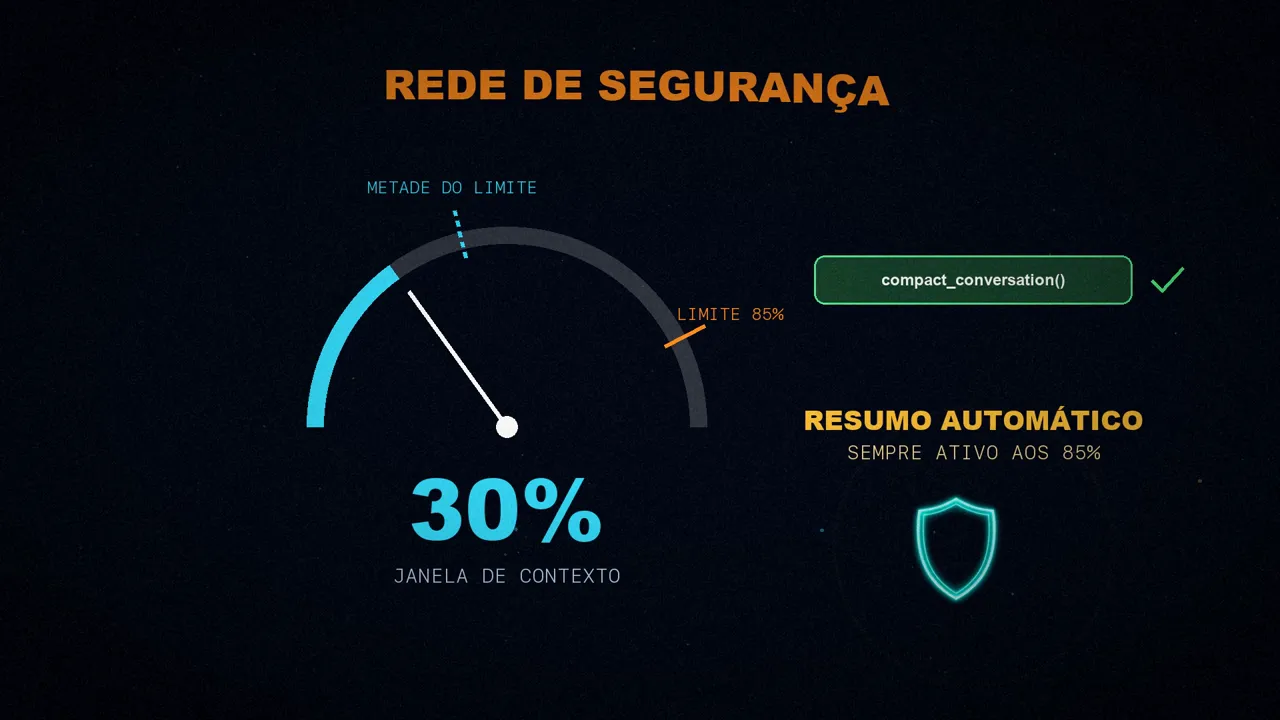
O segundo: não compactar não significa transbordar. No código, a ferramenta nem sequer aceita comprimir até que a conversa chegue à metade do limite; antes disso ela responde "Nothing to compact yet". E a ferramenta se soma ao resumo automático, não o substitui: o create_deep_agent sempre o inclui, então, quando a janela enche, o resumo automático dos 85% continua agindo como rede de segurança.
O que o artigo não traz são números: não sabemos quantas vezes o agente deveria ter compactado e não compactou. Então o zero não prova que a ferramenta funciona, mas também não prova que ela falha.
Uma direção mais ampla
A compressão de contexto autônoma é uma função pequena, mas aponta para uma direção mais ampla no design de agentes: dar aos modelos mais controle sobre a própria memória de trabalho e menos regras rígidas ajustadas à mão no arnês.
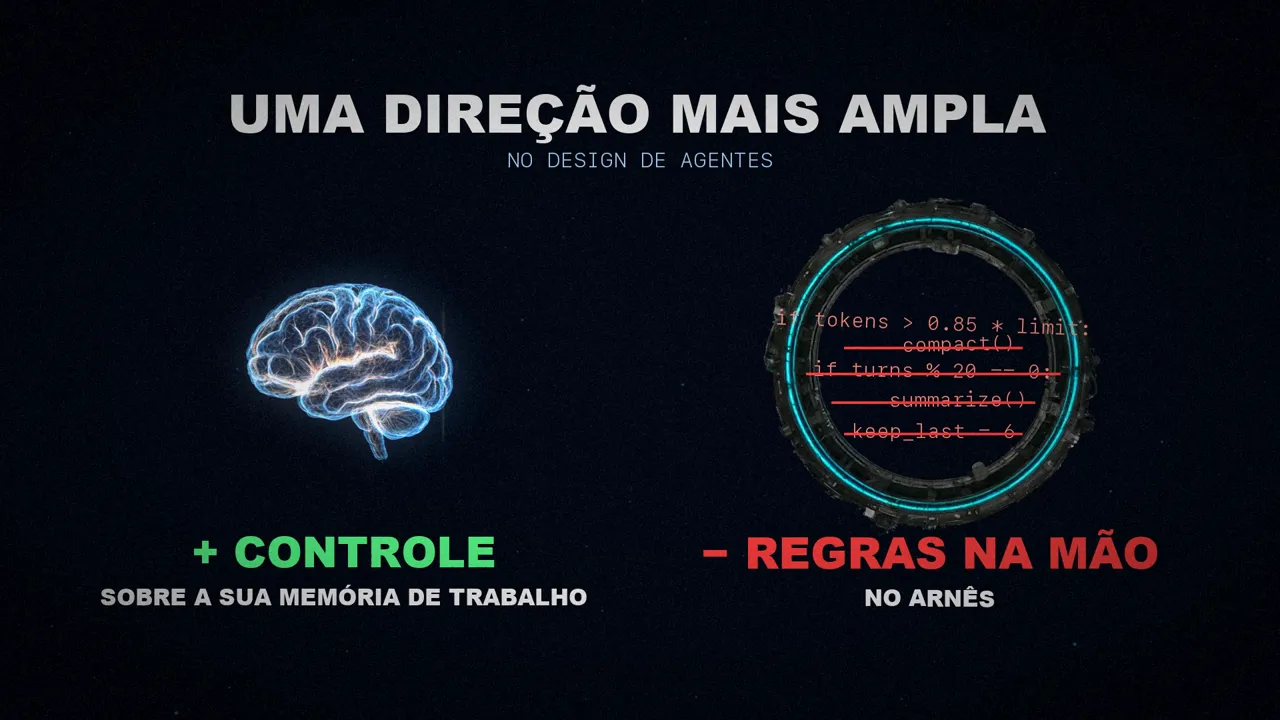
Em vez de compactar sempre aos 85%, o agente decide quando resumir seu contexto e escolhe os momentos em que isso o ajuda.
Você deixaria seu agente decidir quando esquecer?
Fontes
- "Autonomous context compression", da equipe da LangChain (@LangChain), 11 de março de 2026.
- O middleware de resumo do Deep Agents, onde aparecem o mínimo da metade do limite e a mensagem "Nothing to compact yet":
summarization.py. - O vídeo, nos meus três canais: português, espanhol e inglês.