Streaming no es pintar tokens
Sin streaming, la app envía la pregunta y espera varios segundos a que el modelo termine. Con streaming, el proveedor empieza a enviar la respuesta mientras el modelo todavía la está escribiendo, y la interfaz puede mostrarla poco a poco. La idea parece sencilla: cada vez que llega un trozo, se añade al mensaje en pantalla.
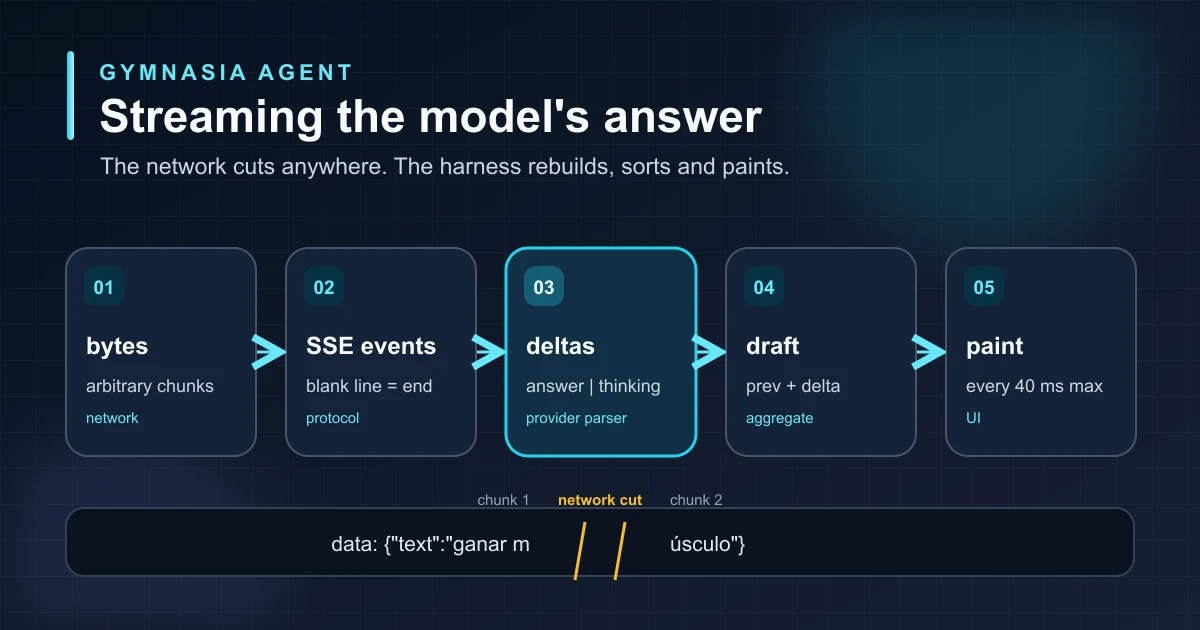
En la práctica, entre la red y la pantalla hay tres problemas que esa idea ignora. La red no respeta los límites de los mensajes: un trozo puede cortar un evento por la mitad, o incluso un carácter. La respuesta no es un único flujo de texto: muchos modelos envían su razonamiento y su respuesta por canales distintos. Y pintar cada trozo en cuanto llega obliga a la interfaz a redibujar la conversación decenas de veces por segundo.
el streaming de un agente consiste en reconstruir unidades completas a partir de trozos arbitrarios, clasificarlas y decidir cuándo merece la pena enseñarlas. Pintar es el último paso, no el único.
Las capas del camino
Cada capa trabaja con una unidad distinta: bytes, texto, eventos, deltas y, al final, el mensaje que ve la persona. Un delta es el fragmento nuevo de texto que trae un evento, por ejemplo "ganar ". El agregado es todo lo recibido hasta ese momento, por ejemplo "Tu objetivo es ganar ". Separar las capas permite probar cada una por su cuenta y cambiar una sin tocar las demás: el troceado SSE es el mismo para los tres proveedores, y el pintado no sabe qué proveedor hay detrás.
Trocear eventos SSE
Los tres proveedores que usa Gymnasia, OpenAI, Anthropic y Google, envían la respuesta como SSE (Server-Sent Events): un formato de texto en el que cada evento ocupa varias líneas y termina con una línea en blanco. Las líneas que empiezan por event: dan el tipo y las que empiezan por data: llevan el contenido, normalmente un JSON:
event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"text_delta","text":"ganar "}}

event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"text_delta","text":"músculo"}}
El problema es que la red no entrega eventos, sino trozos. Un mismo trozo puede traer medio evento, tres eventos y el principio de un cuarto, o cortar justo entre data: y su JSON. Si el parser intenta interpretar lo que tiene en cuanto llega, leerá un JSON incompleto o, peor, un evento con el campo data vacío que parece válido.
La solución es un buffer: se acumula todo lo recibido, se extraen los eventos que ya tienen su línea en blanco de cierre y lo que sobra se guarda para el siguiente trozo.
buffer = empty

when a chunk arrives:
    append the chunk to the end of buffer
    while buffer contains a blank line:
        event = everything before that blank line
        remove that event from the start of buffer
        process(event)
    # what is left in buffer is half an event:
    # wait for the next chunk
Fíjate en lo que no hace: nunca interpreta un evento que no tenga su línea en blanco de cierre. Hay además detalles del formato que conviene respetar: un evento puede tener varias líneas data:, que se unen con un salto de línea; las líneas que empiezan por : son comentarios que algunos servidores envían para mantener viva la conexión; algunos servidores terminan las líneas con \r\n en vez de \n, y tras data: se quita un único espacio, no todos. Anthropic, por ejemplo, intercala eventos ping que el parser debe ignorar sin romperse.
Bytes, texto y transportes que acumulan
Antes de trocear eventos hay que convertir bytes en texto, y ahí hay otra frontera que la red no respeta. En UTF-8, la ú ocupa dos bytes y un emoji como 💪 ocupa cuatro. Si un trozo termina en mitad de esos bytes y se convierte a texto por separado, el carácter se pierde y aparece un símbolo de reemplazo. La solución es la misma idea que con los eventos: convertir solo los caracteres completos y guardar los bytes sueltos hasta que llegue el resto.
pending = no bytes

when bytes arrive:
    data = pending + bytes
    text = the complete characters in data
    pending = the trailing bytes of a half character
    send text to the parser
El segundo problema es que no todos los entornos entregan la respuesta a trozos. Algunos clientes HTTP, como el de la app móvil de Gymnasia, solo ofrecen todo lo recibido hasta el momento y avisan cada vez que crece. Si el harness enviara ese texto completo al parser en cada aviso, procesaría el principio de la respuesta una y otra vez, y el mensaje en pantalla repetiría frases. La solución es recordar cuánto se ha leído ya y pasar al parser solo la parte nueva:
read = 0

each time the received text grows:
    new = the received text from position read onwards
    read = length of the received text
    send new to the parser
Así, el transporte puede cambiar de una plataforma a otra, pero el parser recibe siempre lo mismo: texto nuevo, en el orden en que llegó. No sabe por qué camino ha llegado, y un test comprueba que los dos transportes que usa Gymnasia producen exactamente el mismo resultado con el mismo stream grabado.
Separar la respuesta del razonamiento
Los modelos con razonamiento visible envían dos flujos de texto en la misma respuesta: lo que piensan y lo que contestan. Mezclarlos sería un error: el razonamiento no está escrito para la persona y puede contradecir la respuesta final. Cada proveedor marca la diferencia a su manera:
| Proveedor | Delta de respuesta | Delta de razonamiento | Evento que cierra el turno |
|---|---|---|---|
| OpenAI (Responses) | response.output_text.delta | response.reasoning_summary_text.delta | response.completed |
| Anthropic (Messages) | content_block_delta con text_delta | content_block_delta con thinking_delta | message_stop |
| Google (Interactions) | step.delta de tipo text en un paso model_output | step.delta de tipo thought_summary en un paso thought | interaction.completed |
El parser de cada proveedor traduce esos eventos a dos canales comunes, uno para la respuesta y otro para el razonamiento. A cada canal le entrega dos cosas: el delta nuevo y el agregado de ese canal.
when reading a provider event:
    if it is answer text:
        notify the answer channel with (delta, answer so far)
    if it is reasoning text:
        notify the reasoning channel with (delta, reasoning so far)
    otherwise:
        ignore it for the screen
Entregar el agregado además del delta simplifica la interfaz: no tiene que llevar su propia suma y no puede desincronizarse del parser. En Gymnasia, el razonamiento se muestra en un bloque plegable que está abierto mientras el modelo escribe y se pliega al terminar, para que la respuesta quede en primer plano.
Entre el parser y la pantalla puede haber, además, una capa de política. En Gymnasia, un filtro sanitario revisa el texto antes de enseñarlo y solo deja pasar frases completas, porque no puede juzgar media frase. Por eso la respuesta aparece frase a frase y no palabra a palabra, y en consultas sobre salud el texto no se muestra hasta que la respuesta está completa. El streaming sigue funcionando por debajo; lo que cambia es cuánto se decide enseñar.
Agrupar los renders
Un modelo rápido puede emitir decenas de deltas por segundo. Si cada uno actualiza el estado de la conversación, la interfaz redibuja la lista de mensajes decenas de veces por segundo, y en un móvil eso se nota: el scroll se vuelve pesado y los toques tardan en responder. El ojo humano no necesita tanta frecuencia para percibir que el texto fluye.
La solución es separar recibir de pintar. Cada delta solo guarda el agregado en una variable, lo cual no cuesta nada, y programa un pintado si no hay otro pendiente. El pintado lee el valor más reciente de esa variable. Así, como mucho se pinta una vez cada 40 milisegundos, unas 25 veces por segundo, por muchos deltas que lleguen:
draft = ""
paint_pending = no

when a delta arrives:
    draft = aggregate                # cheap: just store it
    if no paint_pending:
        paint_pending = yes
        in 40 ms:
            paint_pending = no
            paint(draft)             # reads the latest value

when clearing the draft to retry:
    cancel the pending paint and paint now

when the answer finishes:
    cancel the pending paint and write the final answer
Los tres casos cubren el ciclo de vida del mensaje. Cada delta programa, como mucho, un pintado. Cuando el borrador cambia de golpe, por ejemplo al vaciarlo antes de reintentar, se pinta en el acto. Y al terminar, el pintado pendiente se cancela antes de escribir la respuesta definitiva: si se ejecutara después, sobrescribiría el mensaje final con el borrador. Como el pintado siempre lee el agregado, cada fotograma es un prefijo del texto final: la persona nunca ve algo que luego desaparece.
Qué pasa si el stream se corta
Una conexión móvil puede caerse en mitad de una respuesta. Cuando eso ocurre, la interfaz ya ha enseñado parte del texto, y la tentación es dejarlo ahí como si fuera la respuesta. No lo es: un texto cortado puede terminar en mitad de una recomendación. Por eso cada parser comprueba si llegó el evento que cierra el turno. Si falta, OpenAI y Anthropic marcan el turno como truncated y Google lanza un error truncated; en los tres casos el harness rechaza el turno.
El mensaje a medias no se guarda como respuesta. Se sustituye por un error que explica que la respuesta se cortó y que se puede volver a intentar. Si el fallo es de red y el harness reintenta por su cuenta, primero vacía el borrador, para no mezclar el principio de una respuesta con el de la siguiente.
lo que se pinta durante el stream es un borrador. Solo pasa a ser la respuesta cuando el proveedor confirma que ha terminado.
Tests
Todo lo anterior se puede probar sin red y sin modelo, reproduciendo streams grabados de los tres proveedores. Los streams de prueba incluyen razonamiento, respuesta, tildes y un emoji de cuatro bytes, para que cualquier corte mal gestionado se note.
Cortar en cada posición
El stream se parte en dos en cada carácter posible, con saltos de línea normales y con CRLF. El texto reconstruido debe ser siempre el mismo. Esto incluye el corte clásico entre data: y su JSON.
Troceado aleatorio
Un test property-based genera cientos de particiones aleatorias del stream y comprueba que la suma de deltas coincide siempre con la respuesta final.
Dos canales
El razonamiento nunca llega al canal de la respuesta ni al revés, y cada agregado es exactamente el anterior más su delta.
Transporte
Un emoji partido entre dos trozos de bytes llega entero; los dos transportes producen el mismo turno; el texto aparece antes de que termine la petición.
Cortes
Un stream sin evento de cierre se rechaza aunque ya se haya pintado parte del texto, y un error HTTP llega con el mensaje del proveedor.
Pintado
Con temporizadores falsos: cien deltas en la misma ventana producen un solo pintado, cancelar el pintado pendiente impide que uno tardío pise la respuesta final y el último fotograma muestra el texto completo.
El test de cortar en cada posición es el más valioso porque convierte un fallo intermitente, el que solo aparece cuando la red corta en el sitio exacto, en un fallo determinista que se reproduce en cada ejecución.
Aprender a construir un agente completo
Este artículo forma parte de una serie sobre cómo construir un agente o harness usando una app de gimnasio como caso práctico. Aquí hemos visto la capa que lleva la respuesta del modelo hasta la pantalla; en el streaming de tool calls se ve la misma idea aplicada a los argumentos de una tool, donde esperar al final no es una cuestión de fluidez sino de seguridad.
Ver el índice completo de la serie sobre el agente de Gymnasia.