Streaming não é pintar tokens
Sem streaming, o aplicativo envia a pergunta e espera vários segundos até o modelo terminar. Com streaming, o provedor começa a enviar a resposta enquanto o modelo ainda a escreve, e a interface pode mostrá-la aos poucos. A ideia parece simples: sempre que chega um pedaço, ele é acrescentado à mensagem na tela.
Na prática, entre a rede e a tela existem três problemas que essa ideia ignora. A rede não respeita os limites das mensagens: um pedaço pode cortar um evento ao meio, ou até um caractere. A resposta não é um único fluxo de texto: muitos modelos enviam o raciocínio e a resposta por canais diferentes. E pintar cada pedaço assim que chega obriga a interface a redesenhar a conversa dezenas de vezes por segundo.
o streaming de um agente consiste em reconstruir unidades completas a partir de pedaços arbitrários, classificá-las e decidir quando vale a pena mostrá-las. Pintar é o último passo, não o único.
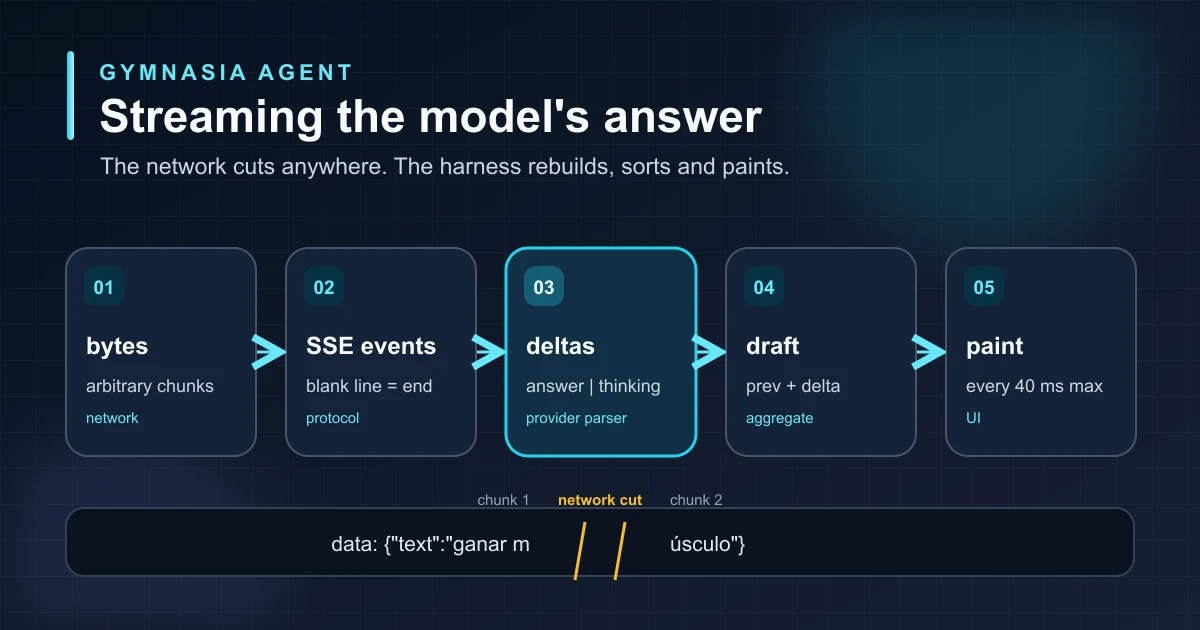
As camadas do caminho
Cada camada trabalha com uma unidade diferente: bytes, texto, eventos, deltas e, no fim, a mensagem que a pessoa vê. Um delta é o pedaço novo de texto que um evento traz, por exemplo "ganhar ". O agregado é tudo o que foi recebido até aquele momento, por exemplo "Seu objetivo é ganhar ". Separar as camadas permite testar cada uma isoladamente e mudar uma sem mexer nas outras: a divisão SSE é a mesma para os três provedores, e a pintura não sabe qual provedor está por trás.
Dividir eventos SSE
Os três provedores que o Gymnasia usa, OpenAI, Anthropic e Google, enviam a resposta como SSE (Server-Sent Events): um formato de texto em que cada evento ocupa várias linhas e termina com uma linha em branco. As linhas que começam com event: dão o tipo e as que começam com data: trazem o conteúdo, normalmente um JSON:
event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"text_delta","text":"ganhar "}}

event: content_block_delta
data: {"type":"content_block_delta","index":1,"delta":{"type":"text_delta","text":"músculo"}}
O problema é que a rede não entrega eventos, e sim pedaços. Um mesmo pedaço pode trazer meio evento, três eventos e o começo de um quarto, ou cortar exatamente entre data: e o seu JSON. Se o parser tenta interpretar o que tem assim que chega, vai ler um JSON incompleto ou, pior, um evento com o campo data vazio que parece válido.
A solução é um buffer: acumula-se tudo o que foi recebido, extraem-se os eventos que já têm a sua linha em branco de fechamento e o que sobra é guardado para o próximo pedaço.
buffer = empty

when a chunk arrives:
    append the chunk to the end of buffer
    while buffer contains a blank line:
        event = everything before that blank line
        remove that event from the start of buffer
        process(event)
    # what is left in buffer is half an event:
    # wait for the next chunk
Repare no que ele não faz: nunca interpreta um evento que não tenha a sua linha em branco de fechamento. Há também detalhes do formato que convém respeitar: um evento pode ter várias linhas data:, que se unem com uma quebra de linha; as linhas que começam com : são comentários que alguns servidores enviam para manter a conexão viva; alguns servidores terminam as linhas com \r\n em vez de \n, e depois de data: remove-se um único espaço, não todos. A Anthropic, por exemplo, intercala eventos ping que o parser deve ignorar sem quebrar.
Bytes, texto e transportes que acumulam
Antes de dividir eventos é preciso converter bytes em texto, e aí existe outra fronteira que a rede não respeita. Em UTF-8, o ú ocupa dois bytes e um emoji como 💪 ocupa quatro. Se um pedaço termina no meio desses bytes e é convertido em texto separadamente, o caractere se perde e aparece um símbolo de substituição. A solução é a mesma ideia dos eventos: converter só os caracteres completos e guardar os bytes soltos até que chegue o resto.
pending = no bytes

when bytes arrive:
    data = pending + bytes
    text = the complete characters in data
    pending = the trailing bytes of a half character
    send text to the parser
O segundo problema é que nem todo ambiente entrega a resposta em pedaços. Alguns clientes HTTP, como o do aplicativo móvel do Gymnasia, só oferecem tudo o que foi recebido até o momento e avisam cada vez que isso cresce. Se o harness enviasse esse texto completo ao parser a cada aviso, processaria o começo da resposta de novo e de novo, e a mensagem na tela repetiria frases. A solução é lembrar quanto já foi lido e passar ao parser só a parte nova:
read = 0

each time the received text grows:
    new = the received text from position read onwards
    read = length of the received text
    send new to the parser
Assim, o transporte pode mudar de uma plataforma para outra, mas o parser recebe sempre a mesma coisa: texto novo, na ordem em que chegou. Ele não sabe por qual caminho o texto chegou, e um teste verifica que os dois transportes que o Gymnasia usa produzem exatamente o mesmo resultado com o mesmo stream gravado.
Separar a resposta do raciocínio
Os modelos com raciocínio visível enviam dois fluxos de texto na mesma resposta: o que pensam e o que respondem. Misturá-los seria um erro: o raciocínio não foi escrito para a pessoa e pode contradizer a resposta final. Cada provedor marca a diferença à sua maneira:
| Provedor | Delta de resposta | Delta de raciocínio | Evento que fecha o turno |
|---|---|---|---|
| OpenAI (Responses) | response.output_text.delta | response.reasoning_summary_text.delta | response.completed |
| Anthropic (Messages) | content_block_delta com text_delta | content_block_delta com thinking_delta | message_stop |
| Google (Interactions) | step.delta do tipo text em um passo model_output | step.delta do tipo thought_summary em um passo thought | interaction.completed |
O parser de cada provedor traduz esses eventos para dois canais comuns, um para a resposta e outro para o raciocínio. A cada canal ele entrega duas coisas: o delta novo e o agregado daquele canal.
when reading a provider event:
    if it is answer text:
        notify the answer channel with (delta, answer so far)
    if it is reasoning text:
        notify the reasoning channel with (delta, reasoning so far)
    otherwise:
        ignore it for the screen
Entregar o agregado além do delta simplifica a interface: ela não precisa manter a sua própria soma e não pode ficar dessincronizada do parser. No Gymnasia, o raciocínio aparece em um bloco recolhível que fica aberto enquanto o modelo escreve e se recolhe ao terminar, para que a resposta fique em primeiro plano.
Entre o parser e a tela pode haver, além disso, uma camada de política. No Gymnasia, um filtro de segurança em saúde revisa o texto antes de mostrá-lo e só deixa passar frases completas, porque não consegue julgar meia frase. Por isso a resposta aparece frase a frase e não palavra a palavra, e em perguntas sobre saúde o texto só é mostrado quando a resposta está completa. O streaming continua funcionando por baixo; o que muda é quanto se decide mostrar.
Agrupar os renders
Um modelo rápido pode emitir dezenas de deltas por segundo. Se cada um atualiza o estado da conversa, a interface redesenha a lista de mensagens dezenas de vezes por segundo, e no celular isso se nota: a rolagem fica pesada e os toques demoram a responder. O olho humano não precisa de tanta frequência para perceber que o texto flui.
A solução é separar receber de pintar. Cada delta só guarda o agregado em uma variável, o que não custa nada, e agenda uma pintura se não houver outra pendente. A pintura lê o valor mais recente dessa variável. Assim, pinta-se no máximo uma vez a cada 40 milissegundos, cerca de 25 vezes por segundo, por mais deltas que cheguem:
draft = ""
paint_pending = no

when a delta arrives:
    draft = aggregate                # cheap: just store it
    if no paint_pending:
        paint_pending = yes
        in 40 ms:
            paint_pending = no
            paint(draft)             # reads the latest value

when clearing the draft to retry:
    cancel the pending paint and paint now

when the answer finishes:
    cancel the pending paint and write the final answer
Os três casos cobrem o ciclo de vida da mensagem. Cada delta agenda, no máximo, uma pintura. Quando o rascunho muda de uma vez, por exemplo ao esvaziá-lo antes de uma nova tentativa, ele é pintado na hora. E no final, a pintura pendente é cancelada antes de escrever a resposta definitiva: se rodasse depois, sobrescreveria a mensagem final com o rascunho. Como a pintura sempre lê o agregado, cada quadro é um prefixo do texto final: a pessoa nunca vê algo que depois desaparece.
O que acontece se o stream cair
Uma conexão móvel pode cair no meio de uma resposta. Quando isso acontece, a interface já mostrou parte do texto, e a tentação é deixá-lo ali como se fosse a resposta. Não é: um texto cortado pode terminar no meio de uma recomendação. Por isso cada parser verifica se chegou o evento que fecha o turno. Se ele falta, a OpenAI e a Anthropic marcam o turno como truncated e o Google lança um erro truncated; nos três casos o harness rejeita o turno.
A mensagem pela metade não é salva como resposta. Ela é substituída por um erro que explica que a resposta foi cortada e que é possível tentar de novo. Se a falha é de rede e o harness tenta de novo por conta própria, primeiro esvazia o rascunho, para não misturar o começo de uma resposta com o da seguinte.
o que se pinta durante o stream é um rascunho. Só passa a ser a resposta quando o provedor confirma que terminou.
Testes
Tudo isso pode ser testado sem rede e sem modelo, reproduzindo streams gravados dos três provedores. Os streams de teste incluem raciocínio, resposta, acentos e um emoji de quatro bytes, para que qualquer corte mal tratado apareça.
Cortar em cada posição
O stream é partido em dois em cada caractere possível, com quebras de linha normais e com CRLF. O texto reconstruído deve ser sempre o mesmo. Isso inclui o corte clássico entre data: e o seu JSON.
Divisão aleatória
Um teste property-based gera centenas de partições aleatórias do stream e verifica que a soma dos deltas coincide sempre com a resposta final.
Dois canais
O raciocínio nunca chega ao canal da resposta nem o contrário, e cada agregado é exatamente o anterior mais o seu delta.
Transporte
Um emoji partido entre dois pedaços de bytes chega inteiro; os dois transportes produzem o mesmo turno; o texto aparece antes de a requisição terminar.
Cortes
Um stream sem evento de fechamento é rejeitado mesmo que parte do texto já tenha sido pintada, e um erro HTTP chega com a mensagem do provedor.
Pintura
Com timers falsos: cem deltas na mesma janela produzem uma única pintura, cancelar a pintura pendente impede que uma atrasada sobrescreva a resposta final e o último quadro mostra o texto completo.
O teste de cortar em cada posição é o mais valioso porque transforma uma falha intermitente, a que só aparece quando a rede corta exatamente no lugar errado, em uma falha determinística que se reproduz em toda execução.
Aprender a construir um agente completo
Este artigo faz parte de uma série sobre como construir um agente ou harness usando um aplicativo de academia como caso prático. Aqui vimos a camada que leva a resposta do modelo até a tela; no streaming de tool calls a mesma ideia é aplicada aos argumentos de uma tool, onde esperar o final não é uma questão de fluidez, mas de segurança.