Un problema, tres dialectos
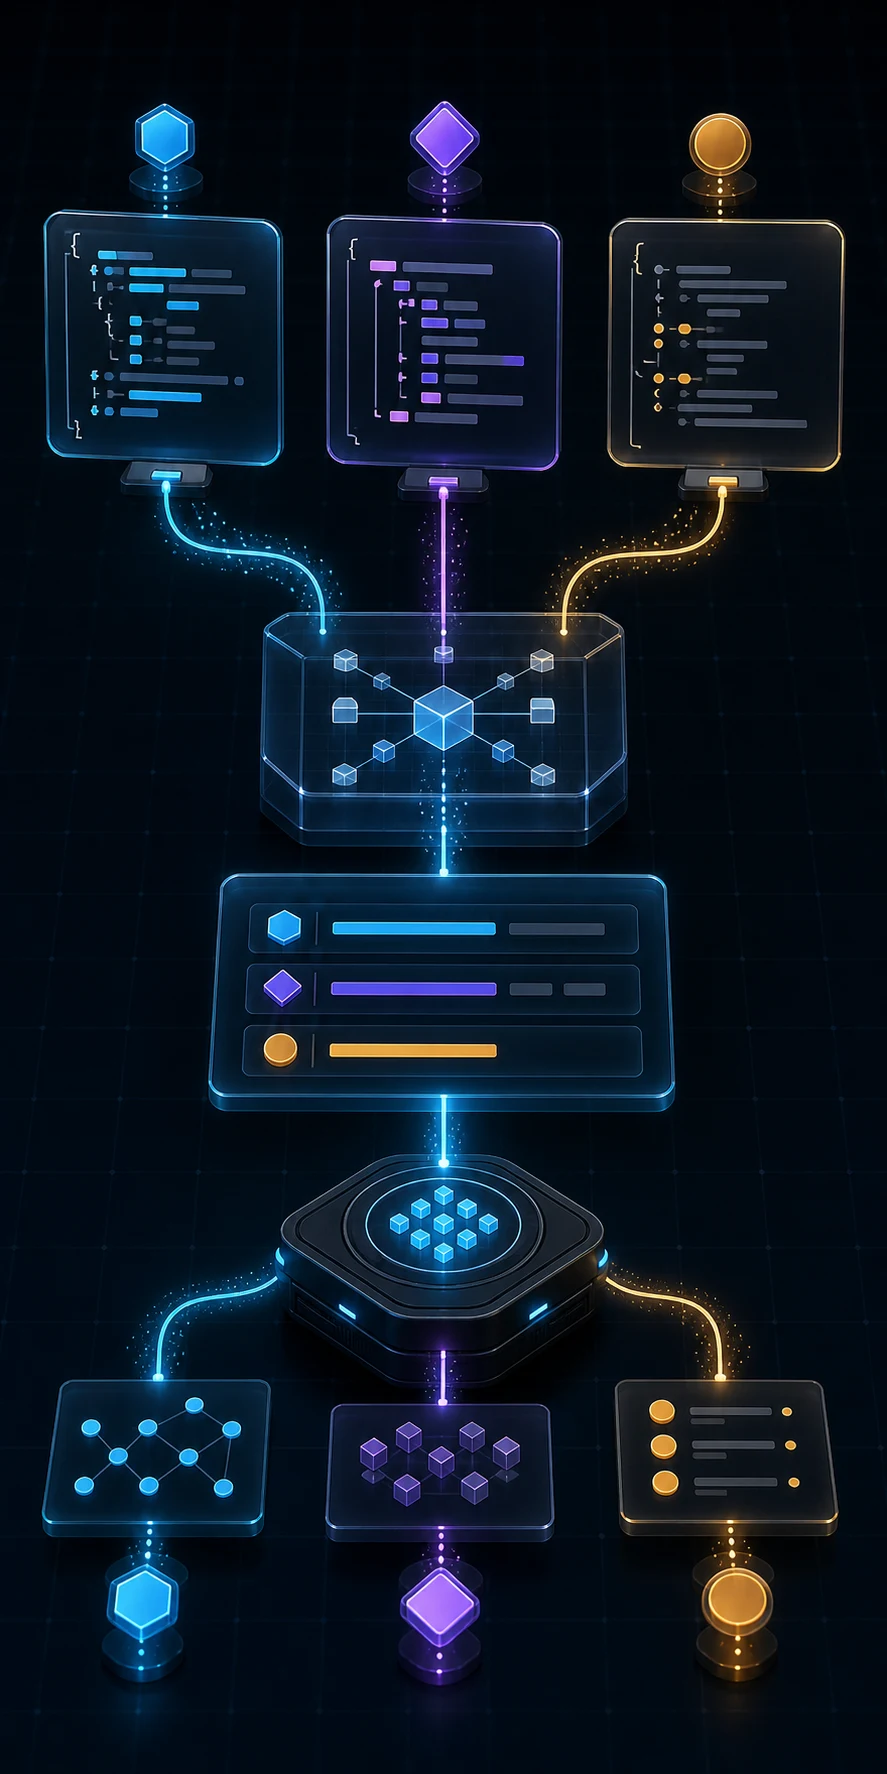
OpenAI, Anthropic y Google describen la misma intención: «quiero ejecutar esta función con estos argumentos». Lo que cambia es la envoltura. OpenAI devuelve un elemento function_call, Anthropic un bloque tool_use y Google una parte functionCall.
Un harness no debería propagar esas tres formas por todo el código. Conviene traducirlas en la frontera del proveedor a una orden común para el harness. A esa traducción la llamamos normalización: recibimos estructuras diferentes y producimos siempre los mismos campos, como name, args, provider y callId, para que el resto del código no necesite conocer el formato de cada API.
Esa orden común debe responder tres preguntas sencillas: qué función ha pedido el modelo, con qué argumentos y a qué llamada concreta pertenece el futuro resultado. La tercera es fácil de pasar por alto. Cada proveedor asigna un identificador a la petición, o permite enviarlo, para que, cuando el harness termine de ejecutar la función, pueda devolver el resultado a la llamada correcta. La normalización unifica la forma que utiliza nuestro código, pero conserva en provider y callId la «dirección de vuelta» que exige la API.
function_call
Los argumentos llegan como una cadena JSON. call_id enlaza la salida de la función.
tool_use
El input ya es un objeto. El resultado referencia tool_use_id.
functionCall
Los argumentos suelen ser un objeto y id es opcional, pero debe devolverse si existe.
El JSON que devuelve cada API
lookup_demo_value es una función ficticia creada para el ejemplo. Su trabajo es consultar un dato del usuario: recibe una clave, como height para la altura o weight para el peso, y devuelve el valor guardado.
Los tres ejemplos representan la misma petición: consultar la altura mediante lookup_demo_value con la clave height. Fíjate en que el nombre, los argumentos y el identificador están presentes en los tres casos, pero no ocupan el mismo lugar ni usan el mismo nombre.
{
  "type": "function_call",
  "id": "fc_openai_1",
  "call_id": "call_openai_1",
  "name": "lookup_demo_value",
  "arguments": "{\"key\":\"height\"}",
  "status": "completed"
}{
"type": "tool_use",
"id": "toolu_anthropic_1",
"name": "lookup_demo_value",
"input": {
"key": "height"
}
}{
"functionCall": {
"name": "lookup_demo_value",
"args": {
"key": "height"
},
"id": "call_google_1"
}
}| Concepto | OpenAI | Anthropic | |
|---|---|---|---|
| Nombre | name | name | functionCall.name |
| Argumentos | arguments, string JSON | input, objeto | args, objeto o string tolerado |
| Correlación | call_id | id → tool_use_id | id opcional en llamada y respuesta |
| Resultado | function_call_output | tool_result | functionResponse |
Una forma común sin perder contexto
Sigamos una llamada de principio a fin. El usuario pregunta «¿cuánto mido?». El modelo no conoce ese dato, pero sabe que puede pedir al harness que ejecute lookup_demo_value con el argumento height.
- El proveedor entrega la petición
La intención es la misma, aunque cada API la escriba de una forma distinta.
OpenAIfunction_callAnthropictool_useGooglefunctionCall - El parser la traduce
El resto del harness recibe siempre los mismos datos, independientemente del proveedor.
Para ejecutarname: lookup_demo_valueargs: { key: "height" }Para devolver el resultadoprovider: openaicallId: call_height - El handler ejecuta la función
Busca
heighty obtiene170 cm. Para hacer ese trabajo solo necesitanameyargs. - El adaptador devuelve el resultado
Recupera
providerycallId, construye la respuesta que espera esa API y el modelo ya puede contestar: «Mides 170 cm».
description?Sí hace falta, pero antes. En el post anterior vimos las llamadas a tools desde el lado del LLM: el harness le enviaba un catálogo con el nombre, la descripción y el esquema de argumentos de cada tool. Allí la descripción era necesaria para que el LLM supiera qué tool debía pedir. En este post estamos al otro lado. El LLM ya le ha dicho al harness qué tool quiere ejecutar y con qué argumentos, así que el handler solo necesita name y args. El harness conserva además el identificador, no para ejecutar la función, sino para devolver después el resultado a la llamada correcta.
Por qué el identificador importa aunque el nombre sea el mismo
El nombre indica qué función hay que ejecutar; el identificador indica qué petición concreta estamos resolviendo. Imagina que, en el mismo turno, el modelo pide la altura y el peso. Las dos peticiones ejecutan lookup_demo_value, pero tienen argumentos e identificadores distintos:
call_heightheight → 170 cm
call_weightweight → 70 kg
Cuando el harness devuelve los resultados al proveedor, ambos tienen el mismo nombre de función. Si solo enviara ese nombre, no habría forma de saber cuál corresponde a la altura y cuál al peso. Por eso devuelve 170 cm asociado a call_height y 70 kg asociado a call_weight. Es parecido al número de un resguardo: dos personas pueden haber pedido el mismo trámite, pero el número permite entregar cada resultado a quien corresponde.
Cómo reconstruir una respuesta que llega por partes
Con streaming, el proveedor del LLM empieza a enviar la respuesta antes de haberla terminado. Eso está bien porque reduce la espera y parece que tenemos la respuesta antes, pero implica que nuestro programa no siempre recibe un JSON completo de una vez. El proveedor del LLM puede entregar {"key":"hei en una lectura y ght"} en la siguiente. En una misma lectura también pueden llegar dos mensajes completos seguidos: por ejemplo, uno que anuncia la llamada a la tool y otro que añade sus argumentos. El parser debe separarlos; no puede suponer que cada lectura contiene exactamente un mensaje.
{"key":"height"}Trozo 1 {"key":"heiTrozo 2 ght"}Los proveedores suelen usar SSE, un formato de texto en el que una línea en blanco marca el final de un mensaje. Esa marca, no el tamaño del fragmento que entrega la red, es la que nos dice cuándo ya podemos interpretar el contenido.
- Guardar lo que llega.
Cada trozo nuevo se añade al texto que quedó pendiente de la lectura anterior.
- Buscar mensajes completos.
Si hay una línea en blanco, se extrae el mensaje que termina ahí. El proceso se repite por si la misma lectura contiene más mensajes completos. Si el último trozo no tiene esa marca, se conserva y se espera a la siguiente lectura.
- Reconstruir cada llamada.
Un mensaje puede anunciar una llamada y los siguientes completar sus argumentos. El identificador permite añadir cada pieza a la llamada correcta.
- Revisar el final.
Cuando se cierra la conexión, se intenta procesar el texto pendiente si ya forma un mensaje válido. Si sigue incompleto, se descarta o se informa como error controlado; nunca se ejecuta a medias.
OpenAI suele anunciar primero que empieza una llamada y enviar después los argumentos en varios mensajes. Anthropic hace algo parecido con nombres de evento distintos. Google normalmente entrega juntos el nombre y los argumentos. El parser esconde esas diferencias: quien lo usa recibe la misma llamada completa aunque la red haya cortado el texto en dos trozos o en veinte.
Múltiples llamadas y datos rotos
Un parser correcto no solo funciona cuando recibe una llamada perfecta. También debe decidir qué hacer cuando llegan varias, cuando faltan datos o cuando el proveedor comunica un error.
No te quedes solo con la primera
El modelo puede pedir altura y peso en el mismo turno. El parser conserva las dos llamadas, su orden y sus identificadores; el harness devuelve exactamente un resultado por cada una.
No adivines lo que falta
Si la conexión termina en mitad del JSON, no sabemos qué quería pedir el modelo. El parser no fabrica una llamada con los caracteres disponibles: devuelve un error controlado o ignora ese mensaje incompleto.
Trátalo como un error
Si la API envía un evento de error, no debe parecer una respuesta vacía. El adaptador detiene el flujo y entrega al harness un fallo reconocible, con el que podrá aplicar la política de reintentos y comunicación que explicamos a continuación.
Hay otra frontera importante. El parser puede convertir unos argumentos que no sean JSON válido en {} para no romper todo el stream, pero eso no autoriza a ejecutar. En una implementación robusta, la capa de tools comprueba después el esquema: si key es obligatorio y no existe, rechaza la llamada antes de ejecutar el handler. Para acciones con efectos también comprueba permisos y reglas de negocio.
Qué debe ver el usuario cuando algo falla
No todos los fallos permiten la misma recuperación. Antes de reintentar o mostrar un mensaje, el harness debe distinguir si ha fallado el proveedor, si el LLM ha pedido una tool con argumentos inválidos o si el handler ha fallado al ejecutarla.
| Dónde falla | Qué hace el harness | Qué ve el usuario |
|---|---|---|
| Proveedor o stream | Reintenta solo errores transitorios, como un timeout o un límite temporal, con pocos intentos y una espera creciente. | Si el proveedor se recupera, nada especial. Si no, un mensaje local y claro: «No he podido obtener una respuesta. Inténtalo de nuevo». |
| Argumentos inválidos | No ejecuta la tool. Devuelve al LLM un resultado de error asociado al mismo identificador para que pueda corregir los argumentos o pedir el dato que falta. | Una aclaración del asistente, como «¿De qué fecha quieres consultar la medición?». Si la corrección también falla, se usa el mensaje local de reserva. |
| Fallo del handler | Puede reintentar una lectura segura. No repite automáticamente una escritura porque podría duplicar el efecto. Si el proveedor sigue disponible, le devuelve el error de la tool. | El LLM puede explicar que no pudo completar la acción. La interfaz conserva un mensaje local de reserva por si tampoco llega esa respuesta. |
¿Quién escribe el mensaje de error?
Si el proveedor sigue funcionando, el harness puede devolverle un error estructurado de la tool con el mismo identificador de la llamada. El LLM recibe ese resultado igual que recibiría un resultado correcto y puede corregir una vez la petición, pedir una aclaración o explicar el fallo con lenguaje natural.
Si ha fallado el propio proveedor, no podemos pedirle que redacte nada. En ese caso la interfaz debe tener un mensaje local, escrito de antemano y traducido por la aplicación. Los detalles técnicos, como el código HTTP o el JSON recibido, se guardan para diagnóstico; no se muestran como si fueran una respuesta del asistente.
Reintentar no siempre es seguro
Una consulta de solo lectura puede repetirse normalmente. Una acción con efectos, como guardar una medición o crear una rutina, no debe repetirse a ciegas: el primer intento podría haberse completado aunque la confirmación se perdiera. Para reintentarla con seguridad hacen falta identificadores de idempotencia o un registro de llamadas ya ejecutadas que impida duplicar el cambio.
El LLM puede explicar el fallo de una tool mientras el proveedor siga disponible. La interfaz debe poder explicar por sí sola que el proveedor ha fallado. Ningún reintento debe ejecutar de nuevo una acción con efectos sin una garantía contra duplicados.
El contrato de pruebas
El objetivo de las pruebas no es demostrar que el modelo siempre escogerá la tool adecuada. Eso depende del modelo y del prompt. Lo que sí podemos exigir es que el harness interprete de forma predecible cualquier respuesta que reciba.
Ejemplos de cada proveedor
Guardamos respuestas representativas de OpenAI, Anthropic y Google. Para cada una comprobamos tres situaciones: ninguna llamada, una llamada y varias llamadas en el mismo turno.
La respuesta vuelve a su origen
Verificamos que el resultado reutiliza el identificador correcto: call_id en OpenAI, tool_use_id en Anthropic y el id opcional de Google. Así una respuesta de altura no puede acabar asociada a la petición de peso.
Cortes en cualquier posición
Una prueba basada en propiedades corta el mismo stream en muchos puntos distintos, incluso dentro de una palabra, y comprueba que el parser siempre reconstruye la misma llamada final.
Fallos visibles y reintentos seguros
Simulamos argumentos inválidos, un handler que falla y un proveedor que deja de responder. Comprobamos que ninguna tool se ejecuta a medias, que el usuario siempre recibe un mensaje y que una acción con efectos no se duplica durante un reintento.
Por último, añadimos casos de regresión para problemas que ya conocemos: JSON truncado, errores explícitos, argumentos con una forma inesperada y llamadas de Google sin identificador. El recorrido E2E completa la comprobación: reproduce una conversación, ejecuta una tool falsa, devuelve el resultado al proveedor simulado y exige que el asistente produzca la respuesta final.
Fuentes oficiales
Aprender a construir un agente completo
Este artículo pertenece a una serie sobre cómo desarrollar un agente o harness de principio a fin. Gymnasia sirve como ejemplo práctico, pero el parser por proveedor, la forma común y las pruebas de fragmentación son patrones trasladables a otros productos.
Ver el índice completo de la serie sobre el agente de Gymnasia.