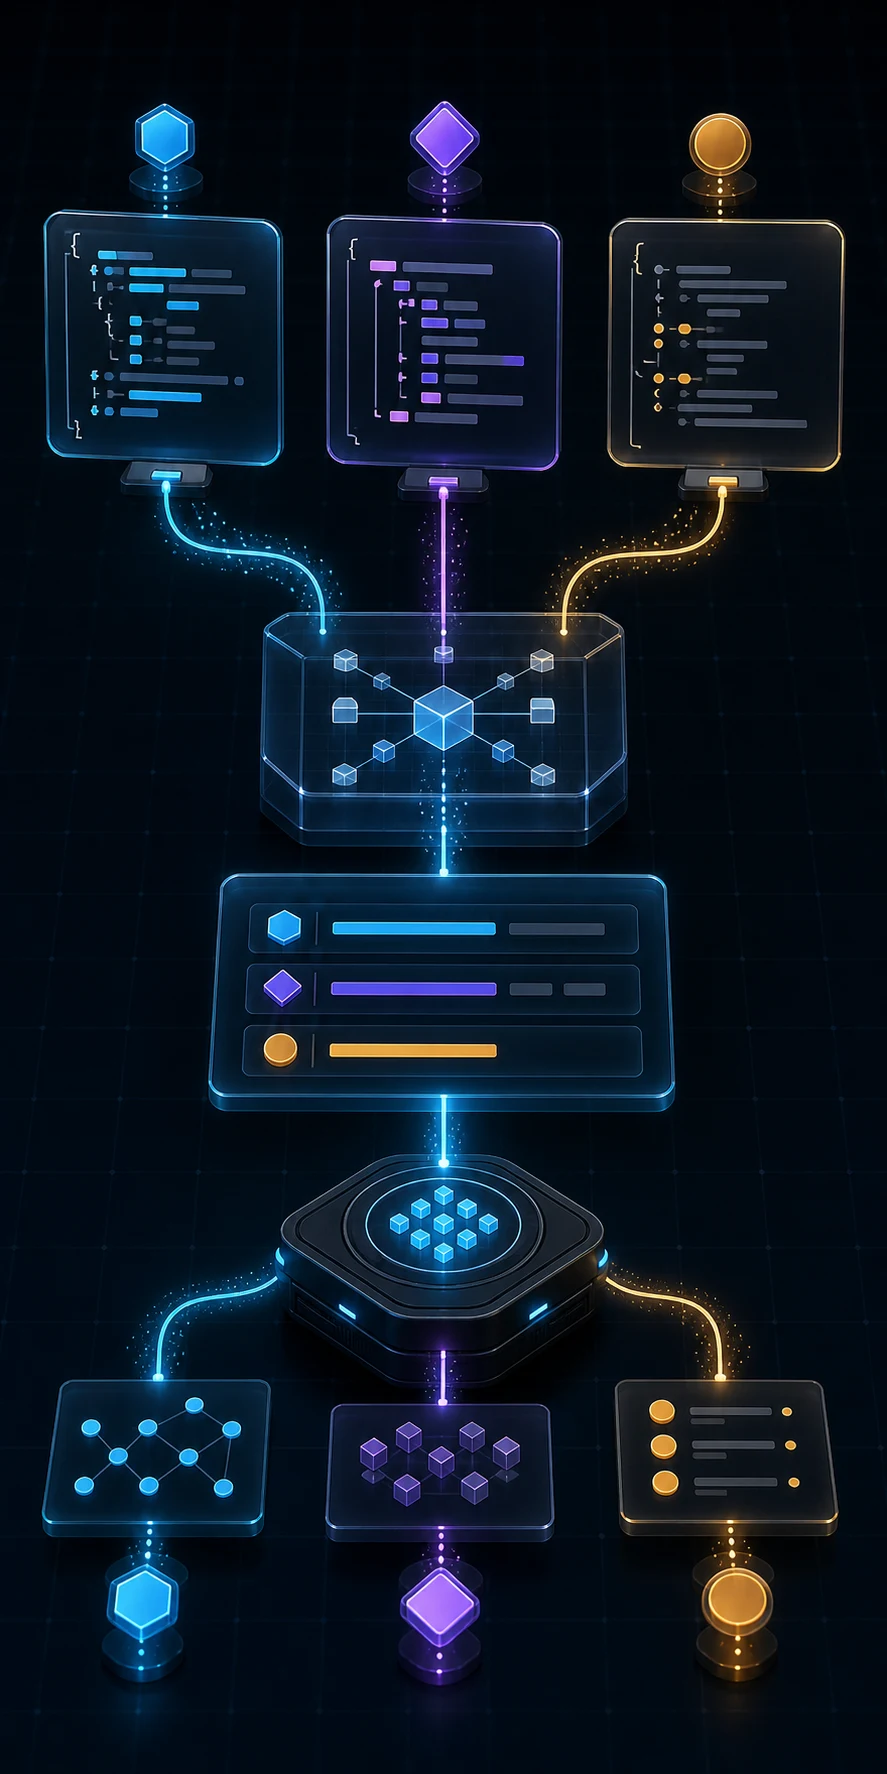
Um problema, três dialetos
OpenAI, Anthropic e Google expressam a mesma intenção: “quero executar esta função com estes argumentos”. O envelope muda. A OpenAI retorna um item function_call, a Anthropic um bloco tool_use e o Google uma parte functionCall.
Um harness não deveria espalhar esses três formatos por todo o código. Convém traduzi-los na fronteira do provedor para um comando comum do harness. Chamamos essa tradução de normalização: recebemos estruturas diferentes e sempre produzimos os mesmos campos, como name, args, provider e callId, para que o restante do código não precise conhecer o formato de cada API.
Esse comando comum deve responder a três perguntas simples: qual função o modelo pediu, quais argumentos enviou e a qual chamada específica pertence o futuro resultado. A terceira pergunta é fácil de esquecer. Cada provedor atribui um identificador à solicitação, ou permite enviá-lo, para que o harness devolva o resultado da função à chamada correta. A normalização unifica o formato usado pelo nosso código, mas preserva em provider e callId o “endereço de retorno” exigido pela API.
function_call
Os argumentos chegam como string JSON. call_id conecta a saída da função.
tool_use
O input já é um objeto. O resultado referencia tool_use_id.
functionCall
Os argumentos normalmente são um objeto e id é opcional, mas precisa ser devolvido quando existe.
O JSON retornado por cada API
lookup_demo_value é uma função fictícia criada para o exemplo. Seu trabalho é consultar um dado do usuário: ela recebe uma chave, como height para altura ou weight para peso, e devolve o valor armazenado.
Os três exemplos representam a mesma solicitação: consultar a altura por meio de lookup_demo_value com a chave height. O nome da função, os argumentos e o identificador existem nos três casos, mas não ficam no mesmo lugar nem usam os mesmos nomes.
{
  "type": "function_call",
  "id": "fc_openai_1",
  "call_id": "call_openai_1",
  "name": "lookup_demo_value",
  "arguments": "{\"key\":\"height\"}",
  "status": "completed"
}{
"type": "tool_use",
"id": "toolu_anthropic_1",
"name": "lookup_demo_value",
"input": {
"key": "height"
}
}{
"functionCall": {
"name": "lookup_demo_value",
"args": {
"key": "height"
},
"id": "call_google_1"
}
}| Conceito | OpenAI | Anthropic | |
|---|---|---|---|
| Nome | name | name | functionCall.name |
| Argumentos | arguments, string JSON | input, objeto | args, objeto ou string tolerada |
| Correlação | call_id | id → tool_use_id | id opcional na chamada e resposta |
| Resultado | function_call_output | tool_result | functionResponse |
Uma forma comum sem perder contexto
Vamos acompanhar uma chamada do início ao fim. O usuário pergunta: “Qual é a minha altura?”. O modelo não conhece esse dado, mas sabe que pode pedir ao harness para executar lookup_demo_value com o argumento height.
- O provedor entrega a solicitação
A intenção é a mesma, embora cada API a escreva de uma forma diferente.
OpenAIfunction_callAnthropictool_useGooglefunctionCall - O parser traduz a solicitação
O restante do harness sempre recebe os mesmos campos, independentemente do provedor.
Para executarname: lookup_demo_valueargs: { key: "height" }Para devolver o resultadoprovider: openaicallId: call_height - O handler executa a função
Ele procura
heighte obtém170 cm. Para fazer esse trabalho, precisa apenas denameeargs. - O adaptador devolve o resultado
Ele recupera
providerecallId, monta a resposta esperada por essa API e o modelo finalmente pode responder: “Sua altura é 170 cm”.
description?Ela é necessária antes. No post anterior vimos as chamadas de tools pelo ponto de vista do LLM: o harness enviava um catálogo com o nome, a descrição e o esquema de argumentos de cada tool. Ali, a descrição era necessária para o LLM decidir qual tool pedir. Neste post estamos do outro lado. O LLM já informou ao harness qual tool quer executar e com quais argumentos, então o handler precisa apenas de name e args. O harness também preserva o identificador, não para executar a função, mas para devolver depois o resultado à chamada correta.
Por que o identificador importa mesmo quando o nome é igual
O nome indica qual função deve ser executada; o identificador indica qual solicitação específica estamos resolvendo. Imagine que, no mesmo turno, o modelo pede altura e peso. As duas solicitações executam lookup_demo_value, mas têm argumentos e identificadores diferentes:
call_heightheight → 170 cm
call_weightweight → 70 kg
Quando o harness devolve os resultados ao provedor, ambos têm o mesmo nome de função. Se enviasse apenas esse nome, não haveria como saber qual resultado corresponde à altura e qual corresponde ao peso. Por isso ele envia 170 cm associado a call_height e 70 kg associado a call_weight. O identificador funciona como o número de um comprovante: duas pessoas podem pedir o mesmo serviço, mas o número permite entregar cada resultado à solicitação correta.
Como reconstruir uma resposta enviada em partes
Com streaming, o provedor do LLM começa a enviar a resposta antes de terminar de gerá-la. Isso é bom porque reduz a espera e dá a impressão de que recebemos a resposta mais cedo, mas implica que nosso programa nem sempre recebe um JSON completo de uma só vez. O provedor do LLM pode entregar {"key":"hei em uma leitura e ght"} na seguinte. Uma mesma leitura também pode conter duas mensagens completas seguidas: por exemplo, uma anunciando a chamada da tool e outra acrescentando seus argumentos. O parser precisa separá-las; não pode supor que cada leitura contém exatamente uma mensagem.
{"key":"height"}Parte 1 {"key":"heiParte 2 ght"}Os provedores costumam usar SSE, um formato de texto em que uma linha em branco marca o fim de uma mensagem. Essa marca, e não o tamanho do fragmento entregue pela rede, indica quando o conteúdo já pode ser interpretado.
- Guardar o que chega.
Cada novo fragmento é acrescentado ao texto que ficou pendente da leitura anterior.
- Encontrar mensagens completas.
Se houver uma linha em branco, extraímos a mensagem que termina ali. O processo se repete caso a mesma leitura contenha outras mensagens completas. Se o último fragmento não tiver essa marca, ele é guardado até a próxima leitura.
- Reconstruir cada chamada.
Uma mensagem pode anunciar uma chamada e as seguintes completar seus argumentos. O identificador indica a qual chamada pertence cada parte.
- Verificar o final.
Quando a conexão fecha, tentamos processar o texto restante se ele já formar uma mensagem válida. Se ainda estiver incompleto, descartamos ou informamos um erro controlado; nunca executamos meia chamada.
A OpenAI costuma anunciar primeiro que uma chamada começou e enviar os argumentos em mensagens posteriores. A Anthropic faz algo parecido com nomes de evento diferentes. O Google normalmente envia juntos o nome e os argumentos. O parser esconde essas diferenças: quem o usa recebe a mesma chamada completa, quer a rede tenha dividido o texto em duas partes ou em vinte.
Várias chamadas e dados quebrados
Um parser correto precisa funcionar além de uma única chamada perfeita. Ele também deve decidir o que fazer quando chegam várias chamadas, quando faltam dados ou quando o provedor informa um erro.
Não fique apenas com a primeira
O modelo pode pedir altura e peso no mesmo turno. O parser preserva as duas chamadas, sua ordem e seus identificadores; o harness devolve exatamente um resultado para cada uma.
Não adivinhe o que falta
Se a conexão termina no meio do JSON, não sabemos o que o modelo pretendia. O parser não inventa uma chamada com os caracteres disponíveis: ele retorna um erro controlado ou ignora a mensagem incompleta.
Trate-o como erro
Se a API envia um evento de erro, ele não deve parecer uma resposta vazia. O adaptador interrompe o fluxo e entrega ao harness uma falha reconhecível para que ele aplique a política de novas tentativas e comunicação explicada a seguir.
Existe outra fronteira importante. O parser pode transformar argumentos que não sejam JSON válido em {} para não quebrar todo o stream, mas isso não autoriza a execução. Em uma implementação robusta, a camada de tools valida o esquema em seguida: se key for obrigatório e estiver ausente, ela rejeita a chamada antes de executar o handler. Ações com efeitos também precisam verificar permissões e regras de negócio.
O que o usuário deve ver quando algo falha
Nem todas as falhas permitem a mesma recuperação. Antes de tentar novamente ou mostrar uma mensagem, o harness precisa distinguir se houve uma falha no provedor, se o LLM pediu uma tool com argumentos inválidos ou se o handler falhou durante a execução.
| Onde falha | O que o harness faz | O que o usuário vê |
|---|---|---|
| Provedor ou stream | Tenta novamente apenas falhas transitórias, como timeout ou limite temporário, com poucas tentativas e esperas crescentes. | Se o provedor se recuperar, nada especial. Caso contrário, uma mensagem local clara: “Não consegui obter uma resposta. Tente novamente”. |
| Argumentos inválidos | Não executa a tool. Devolve ao LLM um resultado de erro associado ao mesmo identificador para que ele corrija os argumentos ou peça o dado que falta. | Uma pergunta do assistente, como “De qual data você quer consultar a medição?”. Se a correção também falhar, a mensagem local de reserva é usada. |
| Falha do handler | Pode repetir uma leitura segura. Não repete automaticamente uma escrita porque isso poderia duplicar o efeito. Se o provedor continuar disponível, devolve a ele o erro da tool. | O LLM pode explicar que não conseguiu concluir a ação. A interface mantém uma mensagem local de reserva caso essa resposta também não chegue. |
Quem escreve a mensagem de erro?
Se o provedor continuar funcionando, o harness pode devolver um erro estruturado da tool com o mesmo identificador da chamada. O LLM recebe esse resultado da mesma forma que receberia um resultado correto e pode corrigir a solicitação uma vez, pedir um esclarecimento ou explicar a falha em linguagem natural.
Se o próprio provedor falhou, não podemos pedir que ele escreva nada. Nesse caso, a interface precisa de uma mensagem de reserva local, escrita antecipadamente e traduzida pelo aplicativo. Detalhes técnicos, como o status HTTP ou o JSON recebido, ficam no diagnóstico; não aparecem como se fossem a resposta do assistente.
Tentar novamente nem sempre é seguro
Uma consulta somente de leitura normalmente pode ser repetida. Uma ação com efeitos, como salvar uma medição ou criar uma rotina, não deve ser repetida às cegas: a primeira tentativa pode ter sido concluída mesmo que a confirmação tenha se perdido. Tentativas seguras exigem identificadores de idempotência ou um registro das chamadas concluídas que impeça alterações duplicadas.
O LLM pode explicar a falha de uma tool enquanto o provedor continuar disponível. A interface precisa conseguir explicar sozinha uma falha do provedor. Nenhuma nova tentativa deve repetir uma ação com efeitos sem uma garantia contra duplicações.
O contrato de testes
O objetivo dos testes não é provar que o modelo sempre escolherá a tool certa. Isso depende do modelo e do prompt. O que podemos exigir é que o harness interprete de forma previsível qualquer resposta que receber.
Exemplos de cada provedor
Guardamos respostas representativas da OpenAI, Anthropic e Google. Para cada uma verificamos três situações: nenhuma chamada, uma chamada e várias chamadas no mesmo turno.
O resultado volta à sua origem
Verificamos que o resultado reutiliza o identificador correto: call_id na OpenAI, tool_use_id na Anthropic e o id opcional do Google. Assim, um resultado de altura não pode acabar associado à solicitação de peso.
Cortes em qualquer posição
Um teste baseado em propriedades divide o mesmo stream em muitos pontos diferentes, até no meio de uma palavra, e verifica que o parser sempre reconstrói a mesma chamada final.
Falhas visíveis e tentativas seguras
Simulamos argumentos inválidos, um handler que falha e um provedor que deixa de responder. Verificamos que nenhuma tool seja executada pela metade, que o usuário sempre receba uma mensagem e que uma ação com efeitos não seja duplicada durante uma nova tentativa.
Por fim, adicionamos casos de regressão para problemas conhecidos: JSON truncado, erros explícitos, formatos inesperados de argumentos e chamadas do Google sem identificador. Um teste de ponta a ponta completa a verificação: reproduz uma conversa, executa uma tool falsa, devolve o resultado ao provedor simulado e exige que o assistente produza a resposta final.
Fontes oficiais
Aprender a construir um agente completo
Este artigo faz parte de uma série sobre como desenvolver um agente ou harness de ponta a ponta. Gymnasia é o exemplo prático, mas os parsers por provedor, a forma comum e os testes de fragmentação podem ser aplicados a outros produtos.