Qué es un arnés
El artículo abre con una regla: cada vez que descubres que el agente comete un error, te tomas el tiempo de diseñar una solución para que no vuelva a cometerlo. Y con un diagnóstico: llevamos dos años discutiendo qué modelo es más listo, cuando el modelo es solo una de las entradas de un agente en marcha. El resto es el arnés: los prompts, las herramientas, las políticas de contexto, los hooks, los sandboxes, los subagentes, los bucles de retroalimentación y las vías de recuperación.
La tesis de Osmani es que un modelo decente con un gran arnés gana a un modelo excelente con uno malo. Dice haberlo visto una y otra vez en su propio trabajo. La definición la toma de Viv Trivedy, a quien atribuye el término harness engineering:
Agent = Model + Harness. If you’re not the model, you’re the harness.
Un arnés es cada pieza de código, de configuración y de lógica de ejecución que no es el modelo. Un modelo a secas no es un agente; se convierte en uno cuando el arnés le da estado, ejecución de herramientas, bucles de retroalimentación y restricciones que se pueden hacer cumplir. En concreto, dentro caben:
- Prompts: el prompt de sistema,
CLAUDE.md,AGENTS.md, los archivos de skills y los prompts de los subagentes. - Herramientas: las herramientas, las skills y los servidores MCP, con sus descripciones.
- Infraestructura incluida: sistema de archivos, sandbox y navegador.
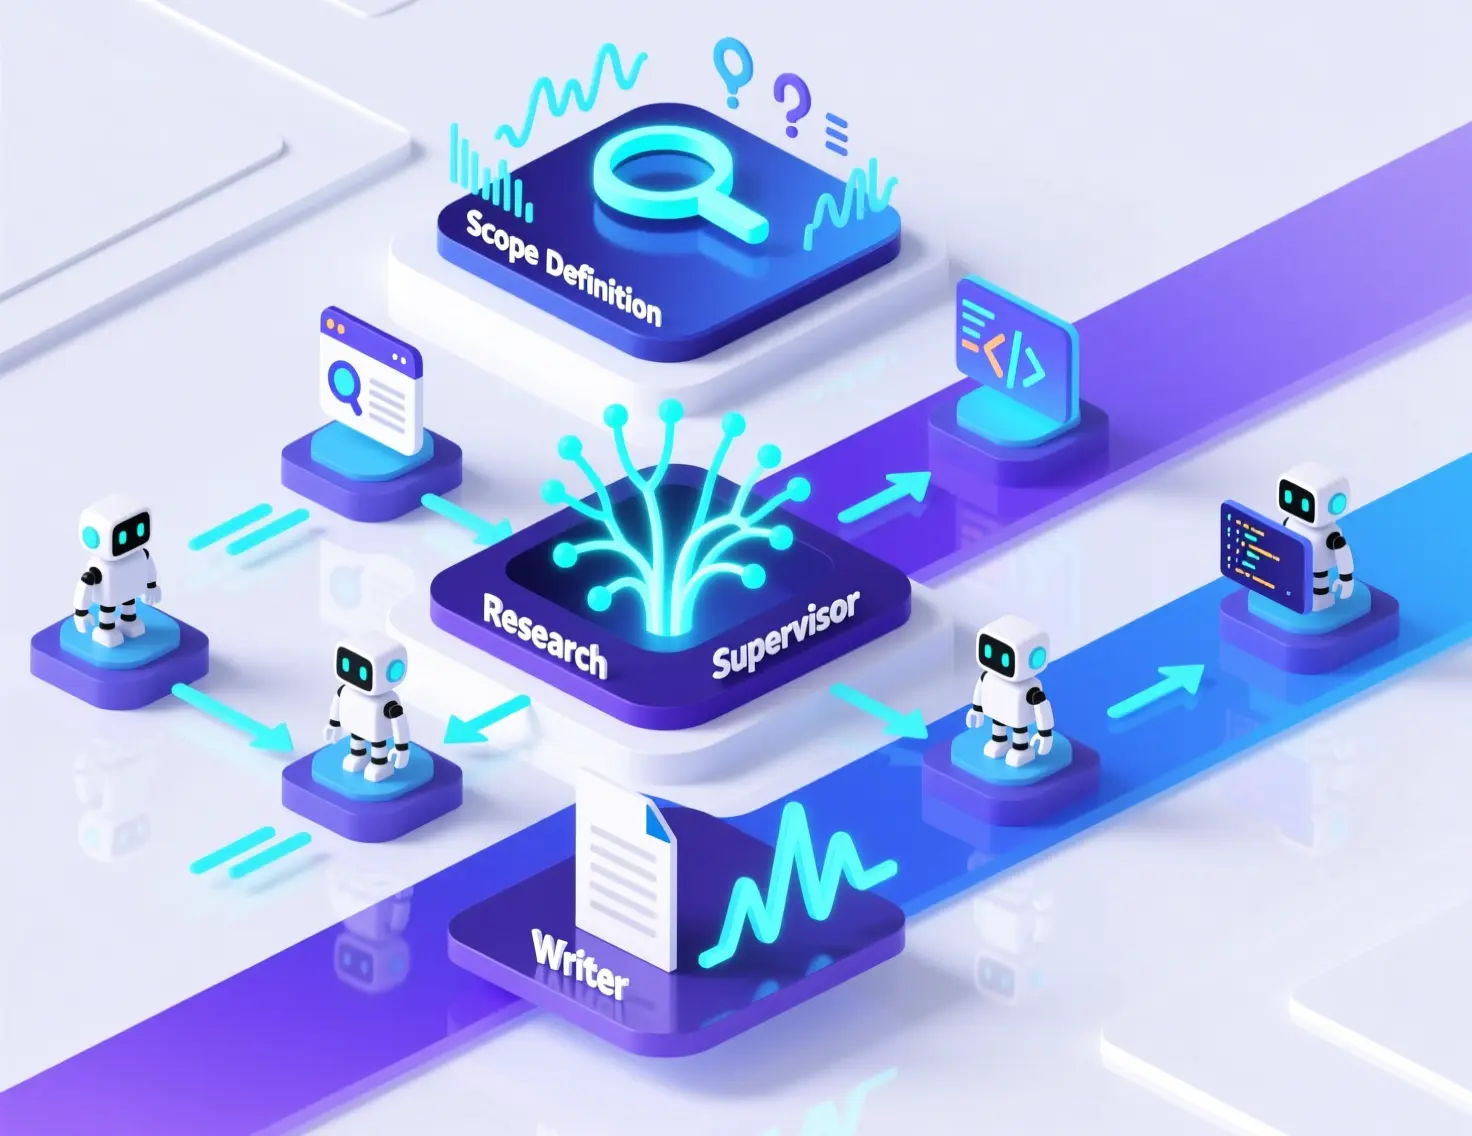
- Orquestación: lanzar subagentes, traspasos y enrutado entre modelos.
- Hooks y middleware para lo determinista: compactación, continuación y comprobaciones de lint.
- Observabilidad: registros, trazas y medición de coste y latencia.
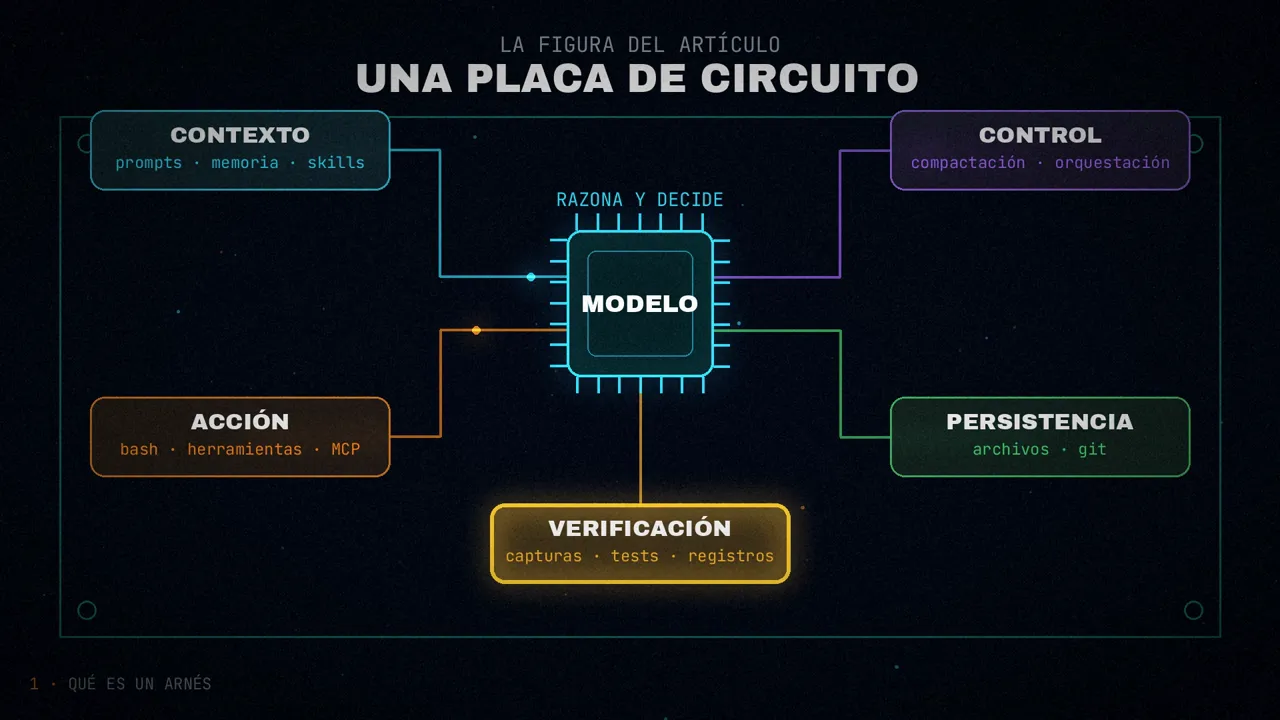
Simon Willison reduce la parte del bucle a su esencia: un agente es un sistema que «ejecuta herramientas en bucle para lograr un objetivo». La habilidad está en diseñar las dos cosas, las herramientas y el bucle.
Es mucha superficie, y es tuya, no del proveedor del modelo. Claude Code, Cursor, Codex, Aider y Cline son todos arneses. Por debajo el modelo a veces coincide, pero lo que notas al usarlos depende sobre todo de lo que hace el arnés. El debate ruidoso está en el lado del modelo; casi toda la palanca, dice Osmani, está en el otro.
Si quieres la derivación completa de Trivedy, la conté en La anatomía de un agente de IA.
No es el modelo, es la configuración
Hay un patrón en el que caen muchos ingenieros: el agente hace una tontería, se culpa al modelo y el problema se archiva en «esperar a la próxima versión». La mentalidad del arnés rechaza esa salida, porque el fallo casi siempre se puede leer:
| Lo que falló | Lo que cambias en el arnés |
|---|---|
| El agente no conocía una convención | La añades a AGENTS.md |
| Lanzó un comando destructivo | Pones un hook que lo bloquea |
| Se perdió en una tarea de 40 pasos | La partes en un planificador y un ejecutor |
| Daba por «terminado» código roto | Conectas la comprobación de tipos al bucle como contrapresión |
HumanLayer lo resume así: «no es un problema del modelo, es un problema de configuración». Lo llaman skill issue.
Osmani recoge además un dato que aparece tanto en el texto de Trivedy como en el de HumanLayer: en Terminal Bench 2.0, Claude Opus 4.6 puntúa dentro de Claude Code muy por debajo de lo que logra el mismo modelo en un arnés hecho a medida, y el equipo de Trivedy subió un agente del Top 30 al Top 5 cambiando solo el arnés. El artículo no da las puntuaciones.
La explicación que ofrece es que los modelos se postentrenan acoplados al arnés con el que se entrenaron. Llevarlos a otro, con mejores herramientas para tu código, un prompt más ajustado y una contrapresión más afilada, puede sacar capacidad que el arnés original dejaba sin usar. Es lo contrario de «espera a GPT-6»: la distancia entre lo que los modelos de hoy pueden hacer y lo que les ves hacer es, en gran parte, una distancia de arnés.
El trinquete: cada error se vuelve regla
El hábito más importante, según Osmani, es tratar los errores del agente como señales permanentes. No como anécdotas ni como «malas ejecuciones» que se reintentan. Lo llama trinquete (ratchet), la rueda dentada que solo gira en un sentido.
Su ejemplo: el agente envía una PR con un test comentado y él la fusiona sin darse cuenta. Eso es una entrada, y produce tres cambios:
- En
AGENTS.md: «nunca comentes los tests; bórralos o arréglalos». - En el hook de pre-commit: busca
.skip(yxit(en el diff. - En el subagente revisor: un test comentado bloquea la revisión.
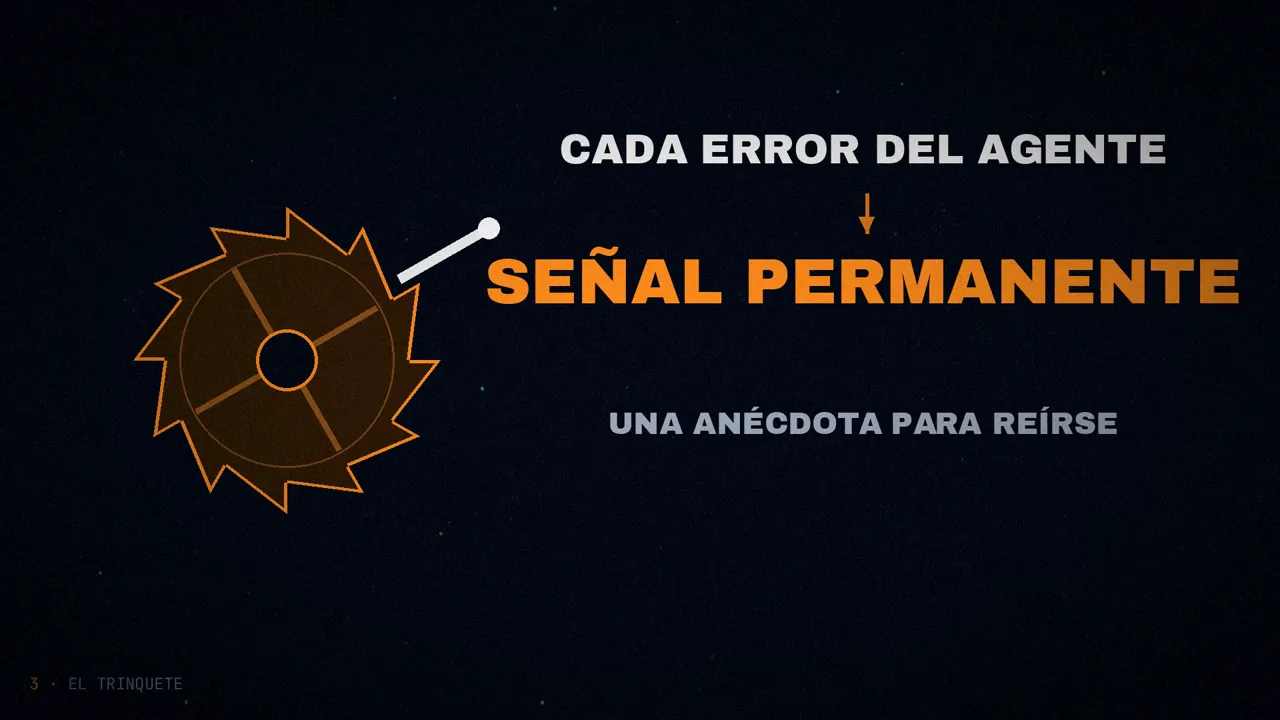
La disciplina funciona en los dos sentidos. Solo añades una restricción cuando has visto un fallo real, y solo la quitas cuando un modelo más capaz la vuelve redundante. Cada línea de un buen AGENTS.md debería poder rastrearse hasta algo concreto que salió mal.
Por eso Osmani habla de una disciplina y no de un framework: el arnés adecuado para tu código tiene la forma de tu historial de fallos. No se puede descargar.
Del comportamiento a la pieza
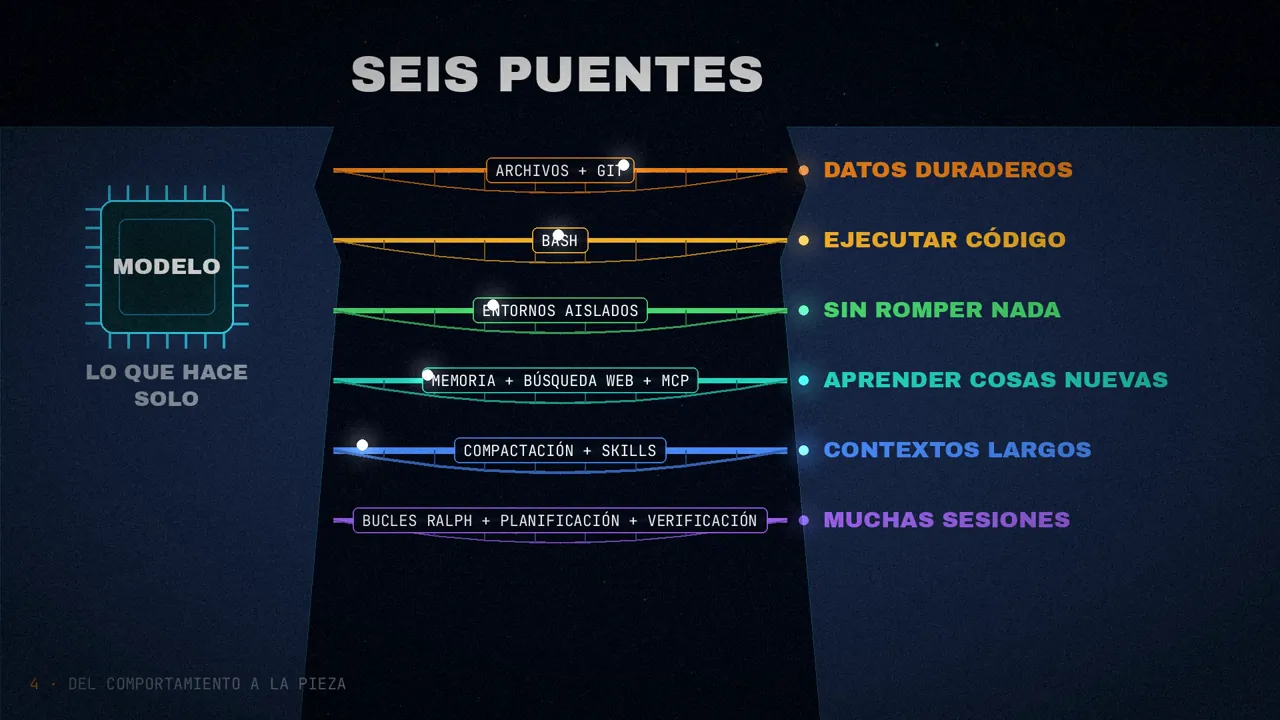
Para diseñar un arnés, el enfoque de Trivedy que a Osmani le resulta más útil es trabajar hacia atrás: partes del comportamiento que quieres (o que quieres arreglar) y de ahí deduces la pieza que lo consigue. Si no sabes nombrar qué comportamiento entrega un componente, probablemente sobra.
| Comportamiento que quieres | Pieza del arnés |
|---|---|
| Trabajar con datos reales de forma duradera | Sistema de archivos y Git |
| Escribir y ejecutar código | Bash y ejecución de código |
| Ejecutar sin romper nada | Sandboxes con buenas herramientas por defecto |
| Recordar y aprender cosas nuevas | Archivos de memoria, búsqueda web y MCP |
| Rendir con contextos largos | Compactación, descarga de salidas y skills |
| Trabajo de largo recorrido | Bucles Ralph, planificación y verificación |
La primitiva más básica y la más infravalorada, porque es aburrida. Un modelo solo opera sobre lo que cabe en su contexto. Con archivos, el agente tiene un espacio donde leer datos, código y documentación, donde dejar trabajo intermedio y donde coordinarse con otros agentes y con personas. Git añade versiones: seguir el progreso, deshacer errores y probar en ramas.
El bucle principal es de tipo ReAct: el modelo razona, actúa con una llamada a herramienta, observa y repite. Pero el arnés solo ejecuta las herramientas para las que tiene lógica. O fabricas una para cada acción posible, o le das bash y dejas que el agente se construya las que necesite. Osmani lo compara con enseñar a usar un utensilio o entregar la cocina entera.
Bash solo sirve si corre en un sitio seguro. Ejecutar en tu portátil código generado por un agente es arriesgado, y un único entorno local no escala a muchos agentes en paralelo. El sandbox permite listas de comandos permitidos, aislamiento de red y entornos que se crean y se destruyen por tarea. Uno bueno trae lenguajes y paquetes instalados, Git, CLIs de tests y un navegador sin interfaz: es lo que deja al agente observar su trabajo y verificarse.
Un modelo no sabe más que lo que hay en sus pesos y en su contexto, así que la única vía para añadir conocimiento es inyectarlo. El arnés carga AGENTS.md en cada arranque; cuando el agente lo edita, lo aprendido pasa a la sesión siguiente. Es una forma tosca pero eficaz de aprendizaje continuo. Para lo que no existía al entrenar, la búsqueda web y herramientas MCP como Context7 salvan la fecha de corte.
Osmani subraya que el modelo no configura su entorno de ejecución: decidir dónde corre el agente, qué tiene disponible y cómo verifica su trabajo son decisiones del arnés.
La pudrición del contexto
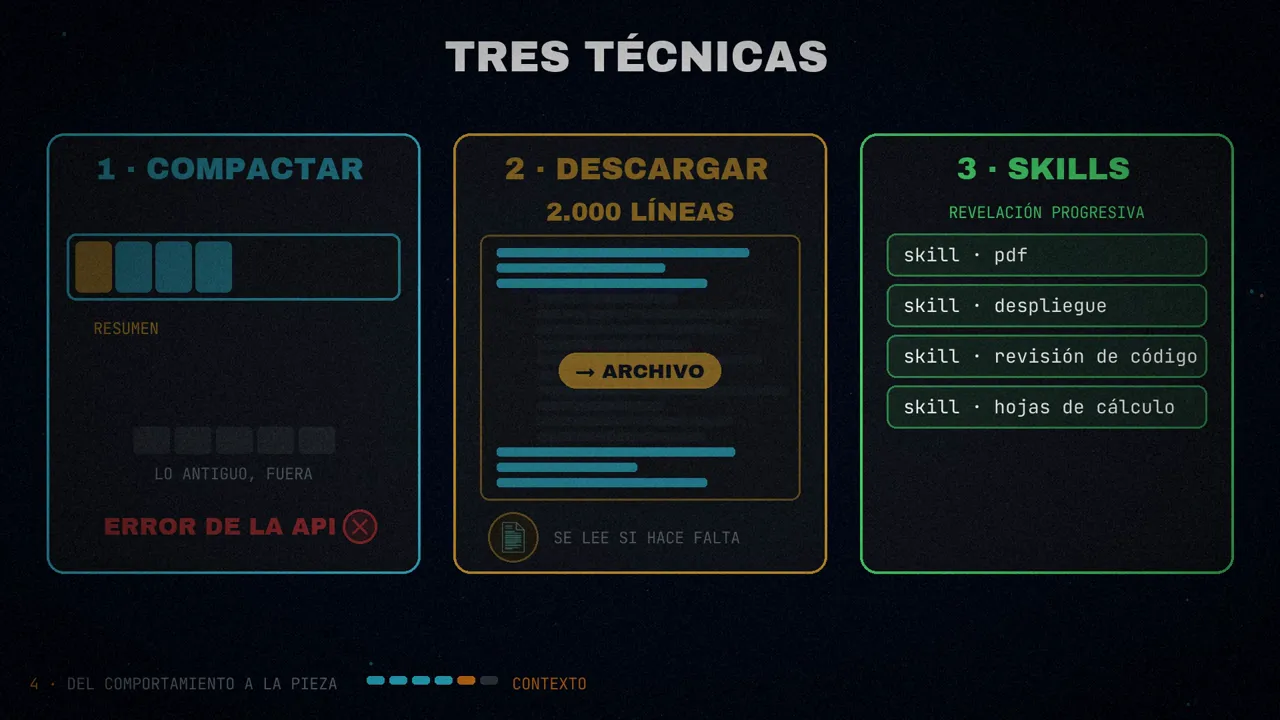
Context rot es la observación de que los modelos razonan y rematan peor las tareas a medida que la ventana de contexto se llena. El contexto es escaso, y un arnés es en gran parte un mecanismo para repartirlo bien. El artículo recoge tres técnicas que se repiten y una cuarta que añade Anthropic:
- Compactación. Cuando la ventana está casi llena, el arnés resume y saca fuera el contexto antiguo para que el agente siga trabajando. Dejar que la API devuelva un error no es opción en producción.
- Descarga de salidas de herramientas. De un registro de 2.000 líneas, el arnés deja en contexto el principio y el final y guarda el resto en un archivo, que el agente lee si lo necesita.
- Skills con revelación progresiva. Cargar todas las herramientas y los MCP al arrancar degrada el rendimiento antes de la primera acción. Las skills revelan instrucciones y herramientas solo cuando la tarea las pide.
- Reinicio completo. Para trabajos muy largos, el arnés derriba la sesión y la reconstruye a partir de un archivo de traspaso compacto. Anthropic dice expresamente que la compactación sola no bastaba. Osmani lo compara con incorporar a un ingeniero nuevo al equipo.
Trabajo de largo recorrido
Es lo más difícil de conseguir. Los modelos de hoy paran antes de tiempo, descomponen mal los problemas complejos y pierden coherencia cuando el trabajo cruza varias ventanas de contexto. El arnés tiene que diseñarse alrededor de las tres cosas.
Un hook intercepta al modelo cuando intenta salir y reinyecta el prompt original en una ventana de contexto limpia. Cada vuelta empieza de cero, pero lee del sistema de archivos el estado que dejó la anterior. Convierte un agente de una sesión en uno de varias.
El modelo descompone el objetivo en pasos, normalmente en un archivo de plan en disco, y el arnés le recuerda cómo usarlo. Tras cada paso se verifica: unos hooks lanzan los tests y devuelven los fallos al modelo con el texto del error, o el modelo revisa su salida contra criterios explícitos.
Anthropic informa de que separar la generación y la evaluación en agentes distintos funciona mejor que autoevaluarse, porque los agentes tienden a puntuarse al alza. Osmani lo compara con las GAN, pero para texto.
Relacionado con el último está el contrato de sprint: generador y evaluador acuerdan qué significa «terminado» antes de escribir código. Osmani cuenta que, en su trabajo, dejar escrita la condición de terminado antes de empezar le ha evitado más desvíos de alcance que cualquier cambio de prompt. Es su experiencia, no una medición.
Hooks: la capa que hace cumplir
Los hooks separan «le dije al agente que hiciera X» de «el sistema impone X». Un hook es un script que se ejecuta en un punto concreto del ciclo de vida: antes de una llamada a herramienta, después de editar un archivo, antes de un commit o al empezar la sesión. Sirven para lo que el agente no debería olvidar y olvida:
- Comprobar tipos, lint y tests después de cada edición, y enseñar los fallos.
- Bloquear comandos destructivos:
rm -rf,git push --force,DROP TABLE. - Pedir aprobación antes de abrir una PR o de subir cambios a
main. - Formatear al escribir, para que el agente no gaste tokens en espacios.
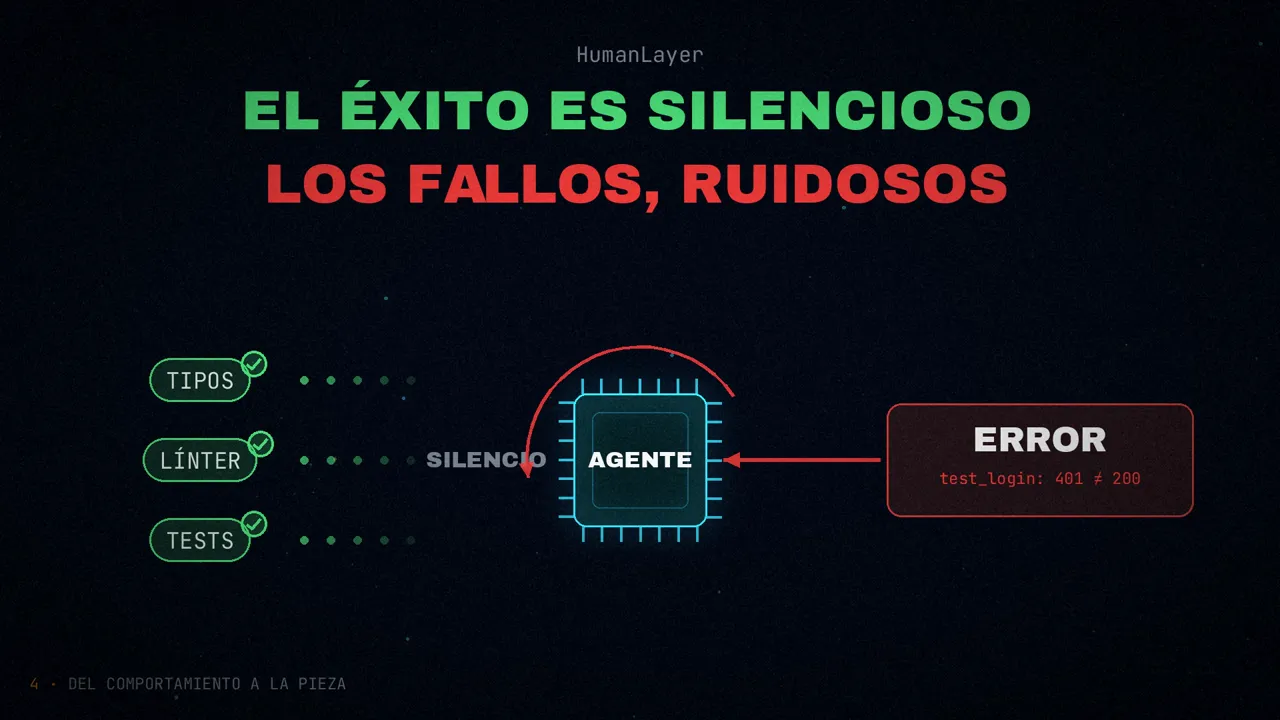
El principio que Osmani toma de HumanLayer es que el éxito es silencioso y los fallos, ruidosos. Si la comprobación de tipos pasa, el agente no oye nada. Si falla, el texto del error entra en el bucle y el agente se corrige. Así la retroalimentación sale casi gratis en el caso normal y es directamente accionable cuando algo va mal.
AGENTS.md y las herramientas
El archivo de reglas en la raíz del repositorio sigue siendo, para Osmani, el punto de configuración con más palanca, porque entra en el prompt de sistema en cada turno. Ahí van las convenciones: gestor de paquetes, framework de tests, formato, «no toques /legacy», «usa siempre nuestro logger». Da dos lecciones:
- Que sea corto. HumanLayer mantiene el suyo por debajo de 60 líneas. Cada línea compite por la atención, y cuantas más reglas hay, menos pesa cada una. Una lista de comprobación de piloto, no una guía de estilo.
- Que cada línea se gane el sitio. Una regla debe venir de un fallo concreto o de una restricción externa firme. Si no, es ruido. Trinquete, no lluvia de ideas.
La misma disciplina vale para las herramientas. El nombre, la descripción y el esquema de cada una se estampan en el prompt en cada petición. Osmani sostiene que diez herramientas enfocadas rinden más que cincuenta solapadas, porque el modelo puede tener el menú entero en la cabeza.
HumanLayer señala además un riesgo de seguridad: como las descripciones de las herramientas pueblan el prompt, cualquier servidor MCP que instales es texto de confianza que el modelo va a leer. Un MCP descuidado o malicioso puede inyectar instrucciones en tu agente antes de que hayas escrito nada.
Cómo se ve en producción
La imagen pública más clara de un arnés maduro, para Osmani, es el desglose que hizo Fareed Khan de la arquitectura de Claude Code. Es una estimación, no un plano oficial. En el centro está el bucle maestro del agente y, alrededor, siete capas:
| Capa | Qué contiene |
|---|---|
| Entrada | Interfaz de usuario, gestor de sesiones y puerta de permisos |
| Conocimiento | Registro de skills, compresor de contexto, grafo de tareas y almacén de memoria |
| Integración | Runtime de MCP y servidores externos |
| Ejecución | Despacho de herramientas, runtime en streaming y caché de prompts |
| Salida | Resultados de tarea verificados |
| Observabilidad | Bus de eventos y ejecutor en segundo plano |
| Multiagente | Lanzamiento de subagentes, buzones entre compañeros, protocolo de máquina de estados, tablero autónomo y aislador de worktrees |
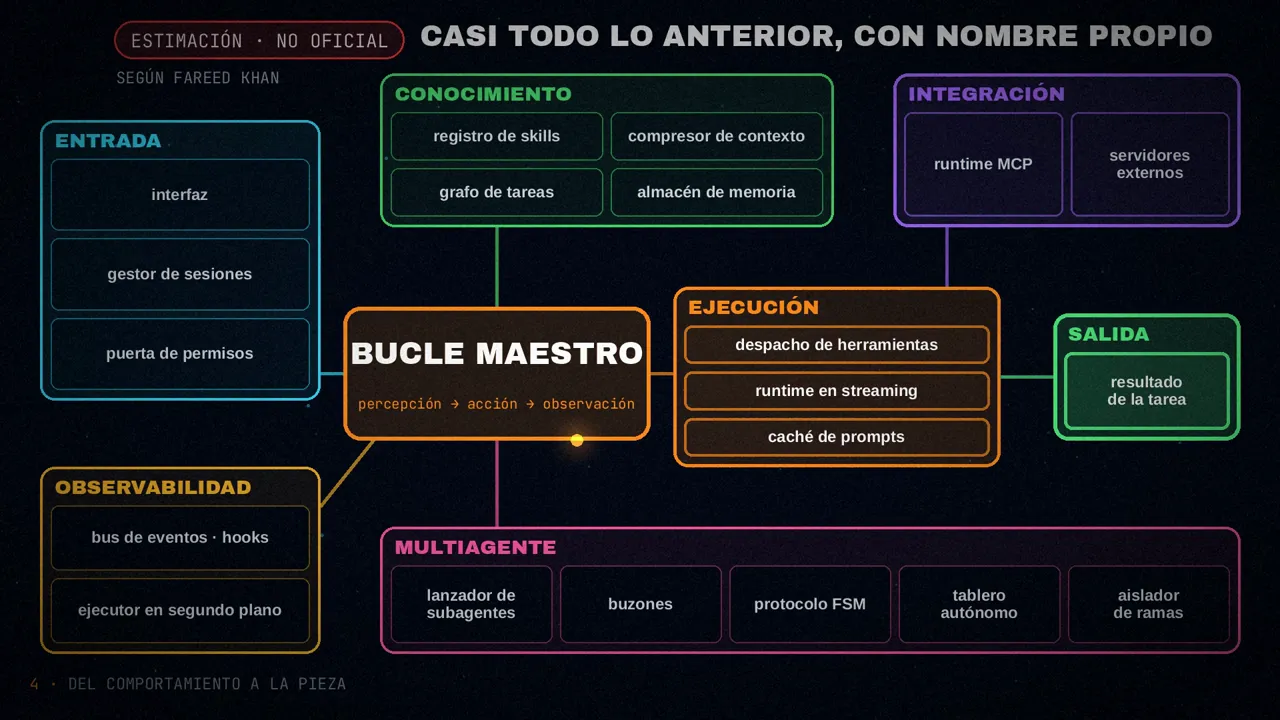
Casi todos los conceptos anteriores aparecen ahí con nombre propio. La inyección de contexto es la capa de conocimiento. El estado del bucle vive en el almacén de memoria y en el aislador de worktrees. Los hooks contra acciones destructivas están detrás de la puerta de permisos. Los cortafuegos de contexto entre subagentes son la capa multiagente entera. Y el registro de despacho de herramientas es donde se enchufan tanto los servidores MCP como bash.
Los arneses no encogen, se mueven
La historia ingenua dice que un modelo mejor vuelve obsoleto el arnés: si el modelo planifica, sobra el planificador; si aguanta tareas largas, sobran los reinicios de contexto. Algo hay de eso. Según Osmani, Opus 4.6 casi eliminó la «ansiedad de contexto» (Sonnet 4.5 cerraba el trabajo antes de tiempo al acercarse a lo que creía su límite), y todo el andamiaje que él escribía contra ese fallo hace seis meses es hoy código muerto.
Pero el techo se movió con el modelo. Hay tareas alcanzables que antes no lo eran, y traen sus propios fallos: ahora hace falta una política de memoria de varios días, coordinar tres agentes especializados o evaluadores de la calidad del diseño en interfaces generadas. Anthropic lo dice así:
Every component in a harness encodes an assumption about what the model can’t do on its own.
Cuando el modelo aprende a hacer algo, esa pieza ya no sostiene nada y debe salir. Cuando desbloquea algo nuevo, hace falta andamiaje nuevo para llegar al nuevo techo.
Hay además un bucle entre el diseño del arnés y el entrenamiento, que Trivedy nombra expresamente: se descubre una primitiva útil en el arnés, se estandariza en el producto, se usa al entrenar la siguiente generación y el modelo nuevo mejora justo en esa primitiva.
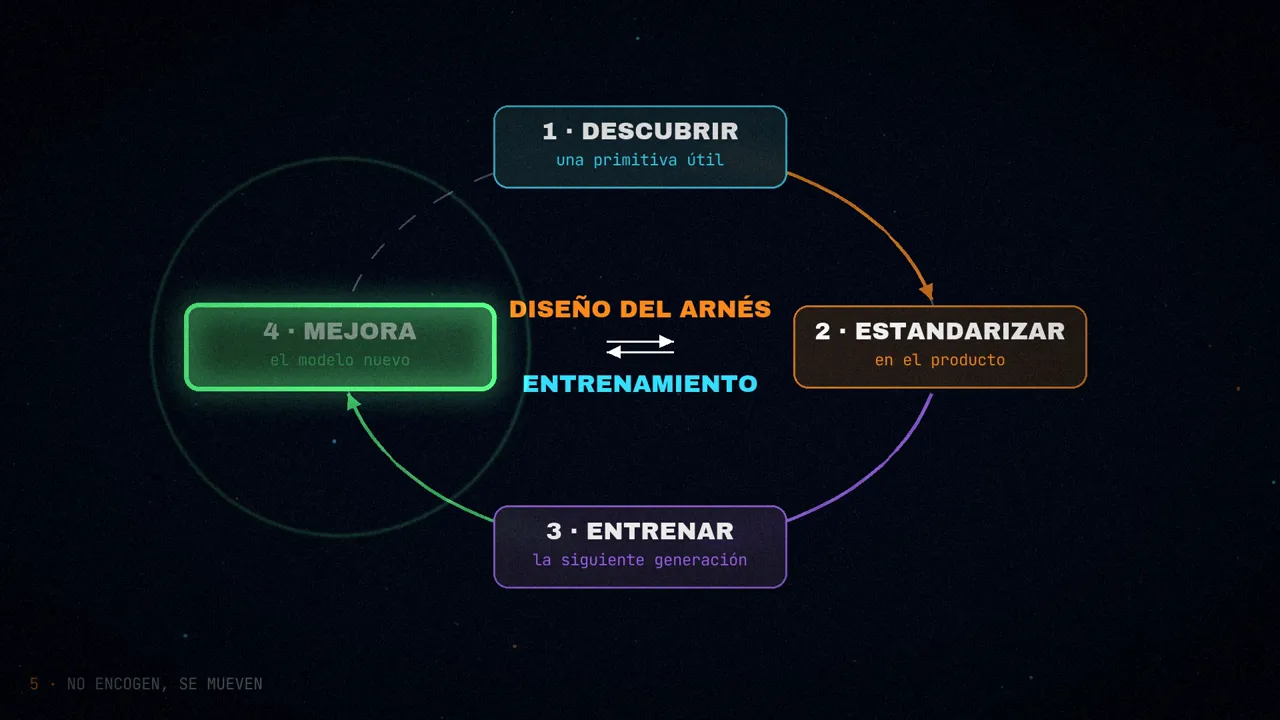
Los productos de agentes de hoy se postentrenan con el arnés en el bucle. Por eso Opus 4.6 se siente distinto dentro de Claude Code que en otro arnés, y por eso cambiar la lógica de una herramienta causa a veces regresiones extrañas. A un modelo de verdad general le daría igual editar con apply_patch o con str_replace, pero el coentrenamiento produce sobreajuste.
De ahí salen dos consecuencias prácticas: un arnés es un sistema vivo, no un archivo de configuración que se escribe una vez; y el «mejor» arnés no es necesariamente aquel en el que se entrenó el modelo, sino el diseñado para tu tarea.
El arnés como servicio
Otra idea de Trivedy es el Harness-as-a-Service: estamos pasando de construir sobre la API de un modelo, que devuelve una respuesta, a construir sobre la API de un arnés, que entrega un entorno de ejecución. El Claude Agent SDK, el Codex SDK y el OpenAI Agents SDK apuntan en esa dirección: traen el bucle, las herramientas, la gestión del contexto, los hooks y las primitivas de sandbox, y tú los adaptas.
Antes, el camino por defecto era montarlo todo: tu bucle, tus llamadas a herramientas, el estado de la conversación y el flujo de aprobaciones. Ahora es elegir un framework de arnés, configurarlo en sus cuatro pilares (prompt de sistema, herramientas, contexto y subagentes) y poner el esfuerzo en los prompts y las herramientas de tu dominio. Eso es lo que hace manejable el skill issue: no reconstruyes el agente cada vez que algo falla, ajustas una superficie de configuración que ya viene bien separada.
Y es el mejor argumento para empezar aunque quede feo. La frase es de Trivedy:
Good agent building is an exercise in iteration. You can’t do iterations if you don’t have a v0.1.
Hacia dónde va
Si pones los mejores agentes de programación uno junto a otro (Claude Code, Cursor, Codex, Aider, Cline), se parecen entre sí más que sus modelos. Los modelos son distintos; los patrones de arnés convergen. Osmani no cree que sea casualidad: la industria va encontrando las piezas de andamiaje que de verdad sostienen el peso.
Los problemas abiertos que plantea Trivedy son tres:
- Orquestar muchos agentes en paralelo sobre una misma base de código.
- Agentes que analizan sus propias trazas para encontrar y arreglar fallos del arnés.
- Arneses que ensamblan las herramientas y el contexto justo a tiempo para cada tarea, en lugar de venir configurados desde el arranque.
Con el último, dice Osmani, el arnés deja de ser configuración estática y empieza a parecerse a un compilador.
Qué es dato y qué es opinión
El artículo es una síntesis con opinión, y conviene separar las cosas:
- Terminal Bench no trae cifras. Que Opus 4.6 puntúe «muy por debajo» dentro de Claude Code y el salto del Top 30 al Top 5 son resultados de terceros (Trivedy y HumanLayer) que Osmani cita sin puntuaciones.
- «Un modelo decente con un gran arnés gana» es la tesis del autor, apoyada en su experiencia. No es una medición.
- Diez herramientas frente a cincuenta también es una opinión, no un experimento.
- Las 60 líneas son la práctica de HumanLayer, no una regla general.
- El diagrama de Claude Code es una estimación de Fareed Khan.
- La regla que abre el artículo aparece como cita, pero sin atribución en la página.
Hay además un detalle que no casa en la última figura del artículo. Su texto alternativo describe el bucle entre arnés y entrenamiento, pero la imagen muestra otra cosa: «The harness doesn’t shrink. It moves.», en tres generaciones de modelo. El bucle solo está en el texto.
En resumen
El agente es el modelo más el arnés, y el arnés es tuyo. Cuando el agente falla, la pregunta útil no es qué modelo viene después, sino qué pieza del arnés habría evitado el fallo: una línea en AGENTS.md, un hook, un sandbox, un evaluador aparte. Y cuando el modelo mejora, el arnés no desaparece: se quitan las piezas que ya no sostienen nada y se añaden las que hacen falta para el nuevo techo.
Cada error del agente es una señal para apretar el trinquete: añade una regla cuando algo falla y quítala cuando el modelo ya no la necesite.
¿De qué fallo concreto viene cada línea de tu AGENTS.md?
Fuentes
- «Agent Harness Engineering», de Addy Osmani, 19 de abril de 2026.
- Sobre arneses en este blog: La anatomía de un agente de IA, el artículo de Viv Trivedy que Osmani toma como base, y El arnés es el producto.
- El vídeo, en mis canales: español e inglés.