O que é um arnês
O artigo abre com uma regra: toda vez que você descobre que o agente comete um erro, você dedica tempo a projetar uma solução para que ele não volte a cometê-lo. E com um diagnóstico: passamos dois anos discutindo qual modelo é mais inteligente, quando o modelo é só uma das entradas de um agente em execução. O resto é o arnês: os prompts, as ferramentas, as políticas de contexto, os hooks, os sandboxes, os subagentes, os ciclos de feedback e os caminhos de recuperação.
A tese de Osmani é que um modelo decente com um ótimo arnês vence um modelo excelente com um arnês ruim. Ele diz ter visto isso repetidas vezes no próprio trabalho. A definição vem de Viv Trivedy, a quem ele atribui o termo harness engineering:
Agent = Model + Harness. If you’re not the model, you’re the harness.
Um arnês é cada pedaço de código, de configuração e de lógica de execução que não é o modelo. Um modelo sozinho não é um agente; ele se torna um quando o arnês lhe dá estado, execução de ferramentas, ciclos de feedback e restrições que podem ser impostas. Em concreto, cabem nele:
- Prompts: o prompt de sistema,
CLAUDE.md,AGENTS.md, os arquivos de skills e os prompts dos subagentes. - Ferramentas: as ferramentas, as skills e os servidores MCP, com suas descrições.
- Infraestrutura incluída: sistema de arquivos, sandbox e navegador.
- Orquestração: criação de subagentes, repasses e roteamento entre modelos.
- Hooks e middleware para o que é determinístico: compactação, continuação e verificações de lint.
- Observabilidade: logs, traces e medição de custo e latência.
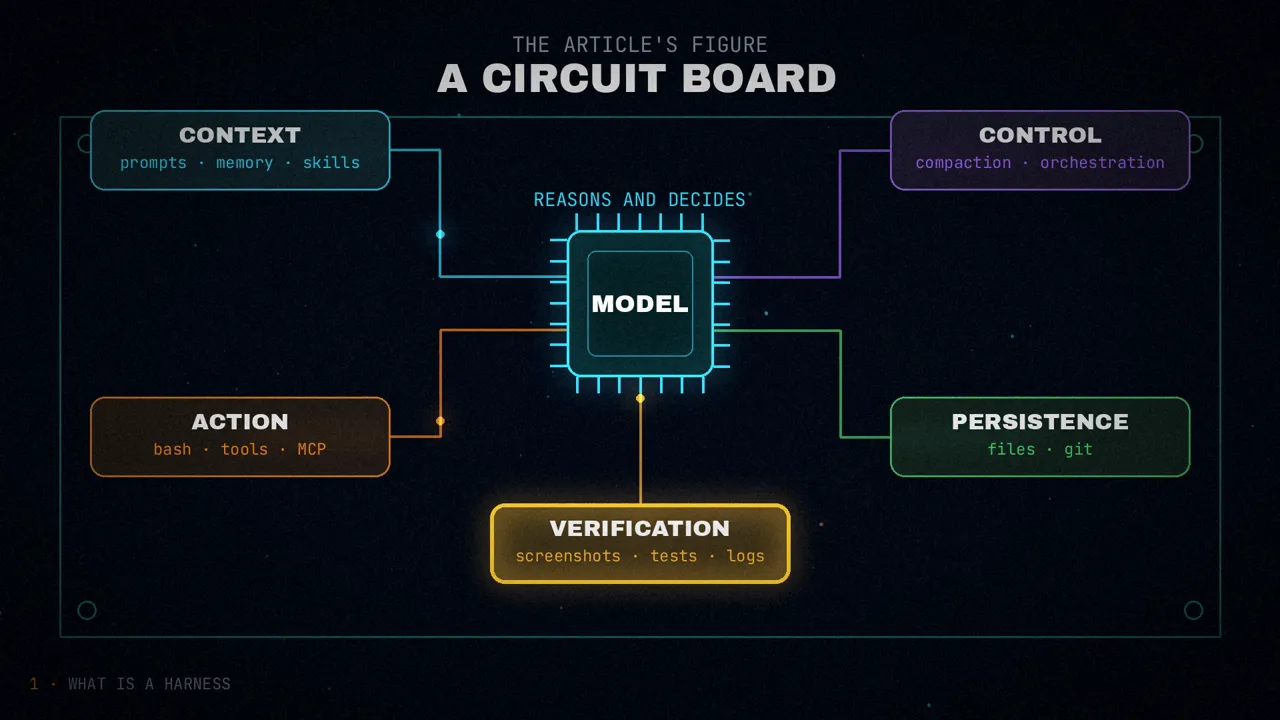
Simon Willison reduz a parte do loop à sua essência: um agente é um sistema que «executa ferramentas em loop para atingir um objetivo». A habilidade está em projetar as duas coisas, as ferramentas e o loop.
É muita superfície, e ela é sua, não do provedor do modelo. Claude Code, Cursor, Codex, Aider e Cline são todos arneses. Por baixo, o modelo às vezes é o mesmo, mas o que você percebe ao usá-los depende sobretudo do que o arnês faz. O debate barulhento está no lado do modelo; quase toda a alavanca, diz Osmani, está no outro.
Se você quiser a derivação completa de Trivedy, eu a contei em A anatomia de um agente de IA.
Não é o modelo, é a configuração
Há um padrão em que muitos engenheiros caem: o agente faz uma bobagem, a culpa vai para o modelo e o problema é arquivado em «esperar a próxima versão». A mentalidade do arnês rejeita essa saída, porque a falha quase sempre pode ser lida:
| O que falhou | O que você muda no arnês |
|---|---|
| O agente não conhecia uma convenção | Você a adiciona ao AGENTS.md |
| Executou um comando destrutivo | Você coloca um hook que o bloqueia |
| Se perdeu em uma tarefa de 40 passos | Você a divide em um planejador e um executor |
| Dava por «terminado» um código quebrado | Você liga a checagem de tipos ao loop como contrapressão |
A HumanLayer resume assim: «não é um problema do modelo, é um problema de configuração». Eles chamam isso de skill issue.
Osmani também traz um dado que aparece tanto no texto de Trivedy quanto no da HumanLayer: no Terminal Bench 2.0, o Claude Opus 4.6 pontua dentro do Claude Code muito abaixo do que o mesmo modelo consegue em um arnês feito sob medida, e a equipe de Trivedy levou um agente do Top 30 ao Top 5 mudando só o arnês. O artigo não dá as pontuações.
A explicação que ele oferece é que os modelos são pós-treinados acoplados ao arnês com o qual foram treinados. Levá-los a outro, com ferramentas melhores para o seu código, um prompt mais ajustado e uma contrapressão mais afiada, pode liberar capacidade que o arnês original deixava sem uso. É o contrário de «espere o GPT-6»: a distância entre o que os modelos de hoje conseguem fazer e o que você os vê fazendo é, em grande parte, uma distância de arnês.
A catraca: cada erro vira regra
O hábito mais importante, segundo Osmani, é tratar os erros do agente como sinais permanentes. Não como anedotas, nem como «execuções ruins» que se repetem. Ele chama isso de catraca (ratchet), a roda dentada que só gira em um sentido.
O exemplo dele: o agente envia um PR com um teste comentado e ele faz o merge sem perceber. Isso é uma entrada, e produz três mudanças:
- No
AGENTS.md: «nunca comente os testes; apague-os ou conserte-os». - No hook de pre-commit: procura
.skip(exit(no diff. - No subagente revisor: um teste comentado bloqueia a revisão.
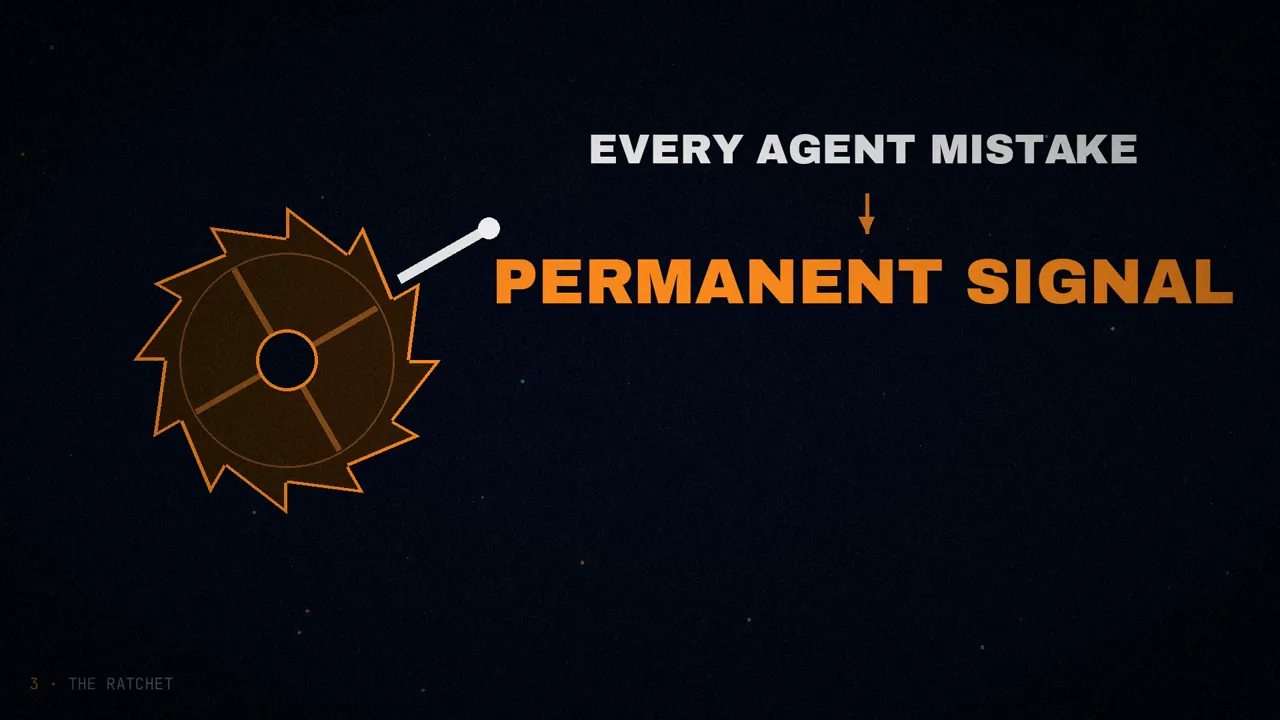
A disciplina vale nos dois sentidos. Você só adiciona uma restrição quando viu uma falha real, e só a remove quando um modelo mais capaz a torna redundante. Cada linha de um bom AGENTS.md deveria poder ser rastreada até algo concreto que deu errado.
Por isso Osmani fala de uma disciplina e não de um framework: o arnês certo para o seu código tem a forma do seu histórico de falhas. Não dá para baixar.
Do comportamento à peça
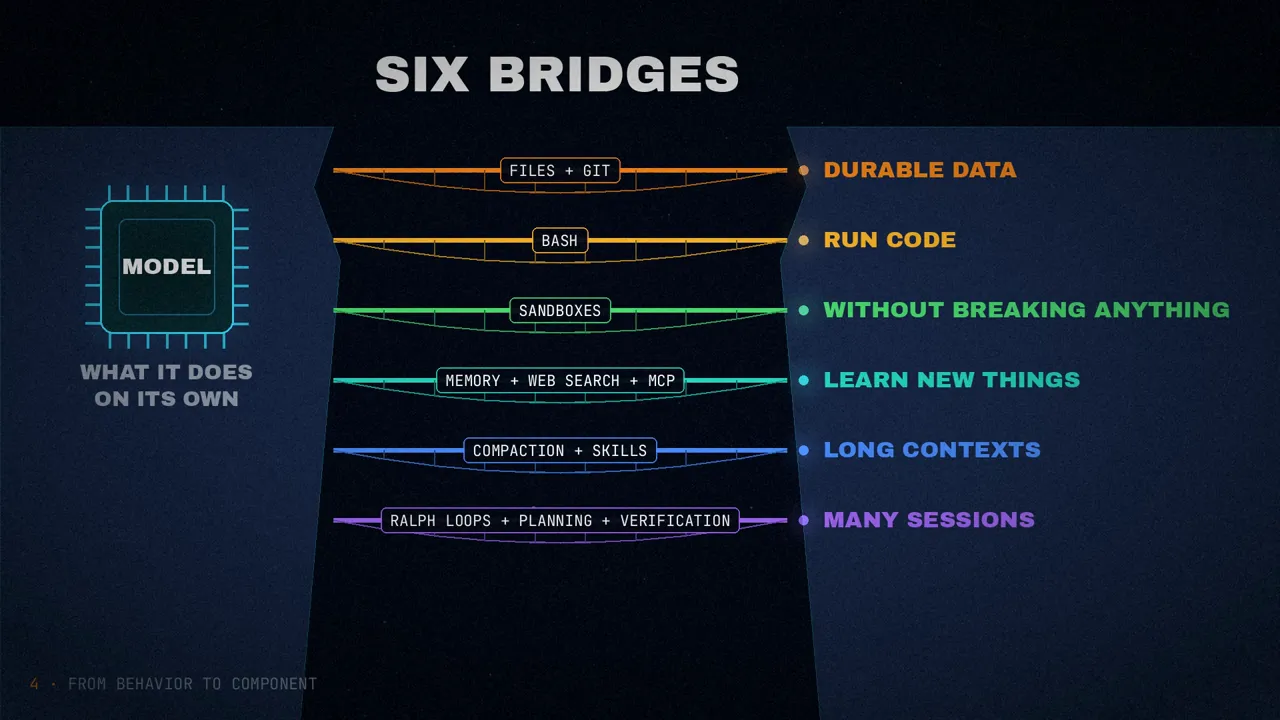
Para projetar um arnês, a abordagem de Trivedy que Osmani acha mais útil é trabalhar de trás para frente: você parte do comportamento que quer (ou que quer consertar) e deduz a peça que o entrega. Se você não sabe nomear qual comportamento um componente entrega, ele provavelmente está sobrando.
| Comportamento que você quer | Peça do arnês |
|---|---|
| Trabalhar com dados reais de forma durável | Sistema de arquivos e Git |
| Escrever e executar código | Bash e execução de código |
| Executar sem quebrar nada | Sandboxes com boas ferramentas por padrão |
| Lembrar e aprender coisas novas | Arquivos de memória, busca na web e MCP |
| Render bem com contextos longos | Compactação, descarga de saídas e skills |
| Trabalho de longo prazo | Loops Ralph, planejamento e verificação |
A primitiva mais básica e a mais subestimada, porque é sem graça. Um modelo só opera sobre o que cabe no contexto. Com arquivos, o agente ganha um espaço para ler dados, código e documentação, para deixar trabalho intermediário e para se coordenar com outros agentes e com pessoas. O Git acrescenta versões: acompanhar o progresso, desfazer erros e testar em branches.
O loop principal é do tipo ReAct: o modelo raciocina, age com uma chamada de ferramenta, observa e repete. Mas o arnês só executa as ferramentas para as quais tem lógica. Ou você fabrica uma para cada ação possível, ou entrega o bash e deixa o agente construir as que precisar. Osmani compara com ensinar a usar um utensílio ou entregar a cozinha inteira.
O bash só serve se rodar em um lugar seguro. Executar no seu notebook código gerado por um agente é arriscado, e um único ambiente local não escala para muitos agentes em paralelo. O sandbox permite listas de comandos permitidos, isolamento de rede e ambientes criados e destruídos por tarefa. Um bom sandbox traz linguagens e pacotes instalados, Git, CLIs de testes e um navegador headless: é o que deixa o agente observar o próprio trabalho e se verificar.
Um modelo não sabe nada além do que está nos pesos e no contexto, então o único jeito de acrescentar conhecimento é injetá-lo. O arnês carrega o AGENTS.md a cada início; quando o agente o edita, o que foi aprendido passa para a sessão seguinte. É uma forma tosca, mas eficaz, de aprendizado contínuo. Para o que não existia no treinamento, a busca na web e ferramentas MCP como o Context7 cobrem a data de corte.
Osmani ressalta que o modelo não configura seu ambiente de execução: decidir onde o agente roda, o que ele tem disponível e como verifica o trabalho são decisões do arnês.
O apodrecimento do contexto
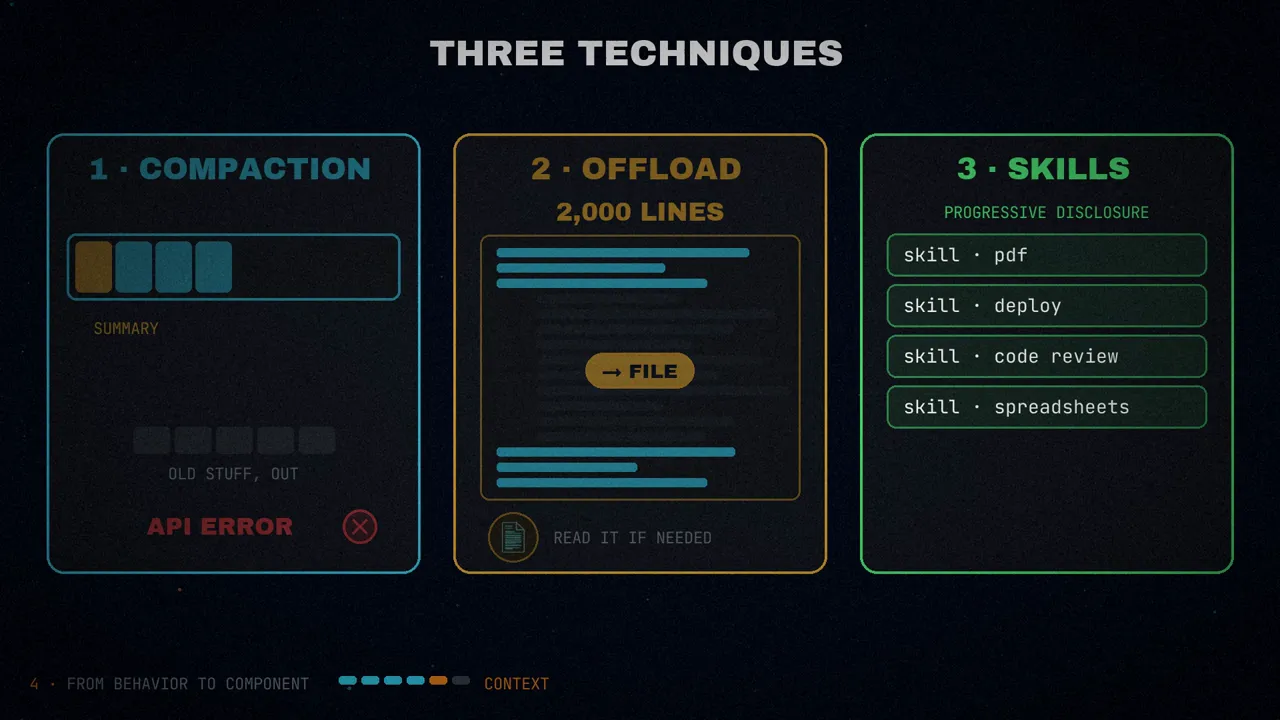
Context rot é a observação de que os modelos raciocinam e concluem tarefas pior à medida que a janela de contexto enche. O contexto é escasso, e um arnês é em grande parte um mecanismo para distribuí-lo bem. O artigo traz três técnicas que se repetem e uma quarta que a Anthropic acrescenta:
- Compactação. Quando a janela está quase cheia, o arnês resume e tira o contexto antigo para que o agente continue trabalhando. Deixar a API devolver um erro não é opção em produção.
- Descarga de saídas de ferramentas. De um log de 2.000 linhas, o arnês mantém no contexto o começo e o fim e guarda o resto em um arquivo, que o agente lê se precisar.
- Skills com revelação progressiva. Carregar todas as ferramentas e os MCPs na inicialização degrada o desempenho antes da primeira ação. As skills revelam instruções e ferramentas só quando a tarefa pede.
- Reinício completo. Para trabalhos muito longos, o arnês derruba a sessão e a reconstrói a partir de um arquivo de repasse compacto. A Anthropic diz expressamente que só a compactação não bastava. Osmani compara com integrar um engenheiro novo à equipe.
Trabalho de longo prazo
É o mais difícil de acertar. Os modelos de hoje param antes da hora, decompõem mal os problemas complexos e perdem coerência quando o trabalho atravessa várias janelas de contexto. O arnês precisa ser projetado em torno das três coisas.
Um hook intercepta o modelo quando ele tenta sair e reinjeta o prompt original em uma janela de contexto limpa. Cada volta começa do zero, mas lê do sistema de arquivos o estado que a anterior deixou. Transforma um agente de uma sessão em um de várias.
O modelo decompõe o objetivo em passos, normalmente em um arquivo de plano em disco, e o arnês o lembra de como usá-lo. Depois de cada passo ele se verifica: hooks rodam os testes e devolvem as falhas ao modelo com o texto do erro, ou o modelo revisa sua saída contra critérios explícitos.
A Anthropic relata que separar a geração e a avaliação em agentes distintos funciona melhor do que a autoavaliação, porque os agentes tendem a se dar notas altas. Osmani compara com as GANs, mas para texto.
Relacionado ao último está o contrato de sprint: gerador e avaliador combinam o que significa «pronto» antes de escrever código. Osmani conta que, no trabalho dele, deixar escrita a condição de pronto antes de começar evitou mais desvios de escopo do que qualquer mudança de prompt. É a experiência dele, não uma medição.
Hooks: a camada que faz cumprir
Os hooks separam «eu disse ao agente para fazer X» de «o sistema impõe X». Um hook é um script que roda em um ponto específico do ciclo de vida: antes de uma chamada de ferramenta, depois de editar um arquivo, antes de um commit ou no início da sessão. Servem para o que o agente não deveria esquecer e esquece:
- Checar tipos, lint e testes depois de cada edição, e mostrar as falhas.
- Bloquear comandos destrutivos:
rm -rf,git push --force,DROP TABLE. - Pedir aprovação antes de abrir um PR ou de enviar mudanças para a
main. - Formatar ao escrever, para que o agente não gaste tokens com espaços.
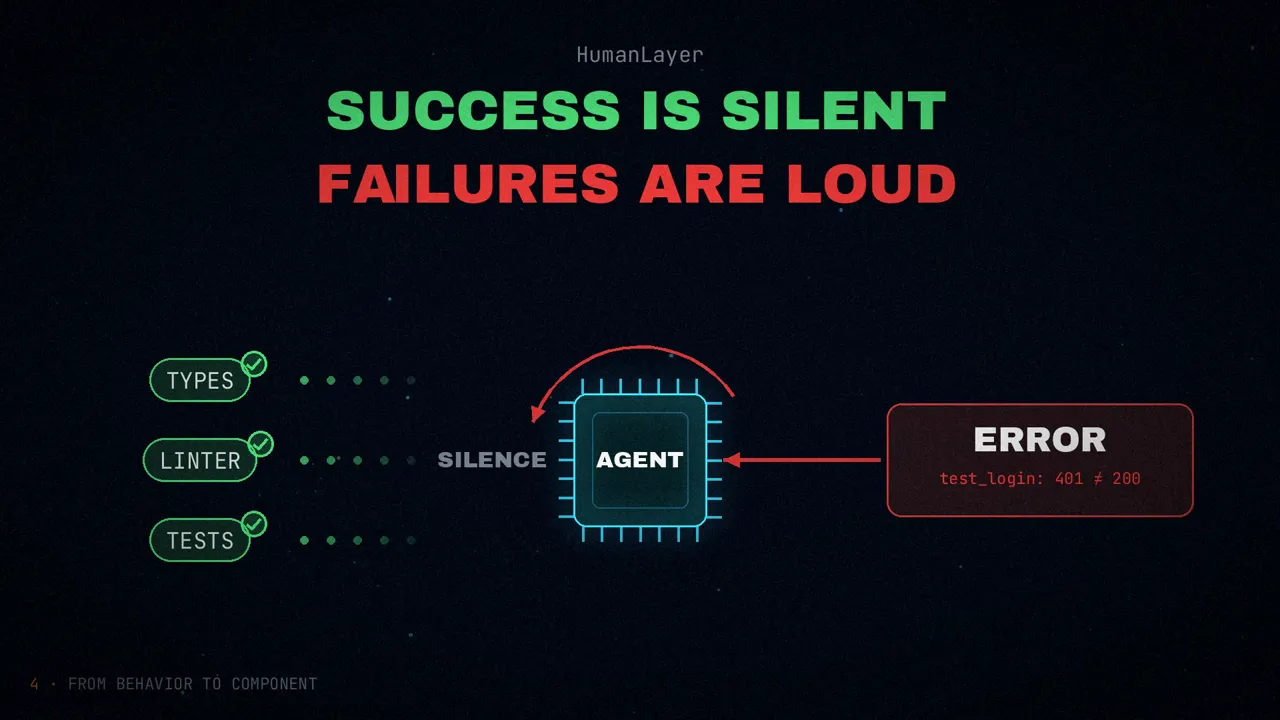
O princípio que Osmani pega da HumanLayer é que o sucesso é silencioso e as falhas são barulhentas. Se a checagem de tipos passa, o agente não ouve nada. Se falha, o texto do erro entra no loop e o agente se corrige. Assim o feedback sai quase de graça no caso normal e é diretamente acionável quando algo dá errado.
AGENTS.md e as ferramentas
O arquivo de regras na raiz do repositório continua sendo, para Osmani, o ponto de configuração com mais alavanca, porque entra no prompt de sistema a cada turno. Ali vão as convenções: gerenciador de pacotes, framework de testes, formatação, «não toque em /legacy», «use sempre o nosso logger». Ele dá duas lições:
- Que seja curto. A HumanLayer mantém o dela abaixo de 60 linhas. Cada linha disputa atenção, e quanto mais regras há, menos pesa cada uma. Um checklist de piloto, não um guia de estilo.
- Que cada linha mereça o lugar. Uma regra deve vir de uma falha concreta ou de uma restrição externa firme. Se não, é ruído. Catraca, não brainstorming.
A mesma disciplina vale para as ferramentas. O nome, a descrição e o esquema de cada uma são carimbados no prompt a cada requisição. Osmani defende que dez ferramentas focadas rendem mais do que cinquenta sobrepostas, porque o modelo consegue ter o cardápio inteiro na cabeça.
A HumanLayer aponta ainda um risco de segurança: como as descrições das ferramentas povoam o prompt, qualquer servidor MCP que você instalar é texto de confiança que o modelo vai ler. Um MCP descuidado ou malicioso pode injetar instruções no seu agente antes de você digitar qualquer coisa.
Como isso aparece em produção
A imagem pública mais clara de um arnês maduro, para Osmani, é o detalhamento que Fareed Khan fez da arquitetura do Claude Code. É uma estimativa, não uma planta oficial. No centro está o loop mestre do agente e, ao redor, sete camadas:
| Camada | O que contém |
|---|---|
| Entrada | Interface do usuário, gerenciador de sessões e portão de permissões |
| Conhecimento | Registro de skills, compressor de contexto, grafo de tarefas e armazenamento de memória |
| Integração | Runtime de MCP e servidores externos |
| Execução | Despacho de ferramentas, runtime em streaming e cache de prompts |
| Saída | Resultados de tarefa verificados |
| Observabilidade | Barramento de eventos e executor em segundo plano |
| Multiagente | Criação de subagentes, caixas de correio entre colegas, protocolo de máquina de estados, quadro autônomo e isolador de worktrees |
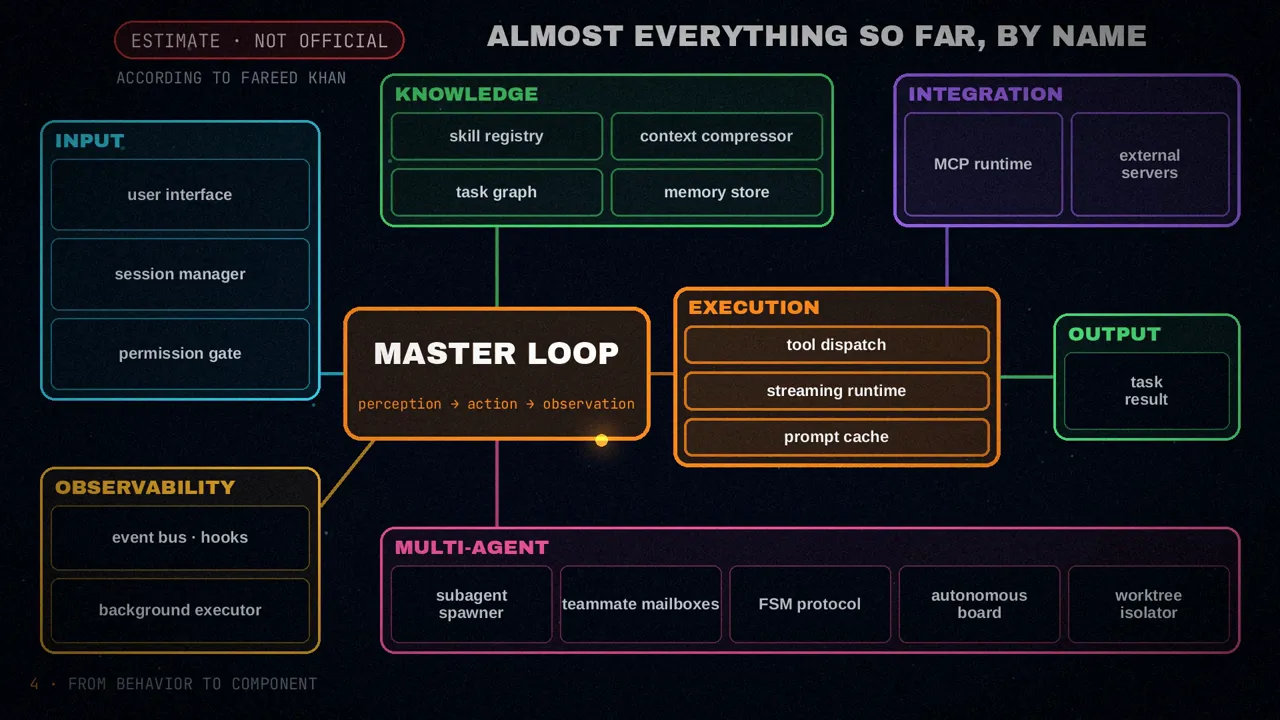
Quase todos os conceitos anteriores aparecem ali com nome próprio. A injeção de contexto é a camada de conhecimento. O estado do loop vive no armazenamento de memória e no isolador de worktrees. Os hooks contra ações destrutivas ficam atrás do portão de permissões. Os firewalls de contexto entre subagentes são a camada multiagente inteira. E o registro de despacho de ferramentas é onde se conectam tanto os servidores MCP quanto o bash.
Os arneses não encolhem, se movem
A história ingênua diz que um modelo melhor torna o arnês obsoleto: se o modelo planeja, sobra o planejador; se aguenta tarefas longas, sobram os reinícios de contexto. Há algo de verdade nisso. Segundo Osmani, o Opus 4.6 quase eliminou a «ansiedade de contexto» (o Sonnet 4.5 encerrava o trabalho antes da hora ao se aproximar do que achava ser o seu limite), e todo o andaime que ele escrevia contra essa falha seis meses atrás hoje é código morto.
Mas o teto se moveu junto com o modelo. Há tarefas alcançáveis que antes não eram, e elas trazem suas próprias falhas: agora é preciso uma política de memória de vários dias, coordenar três agentes especializados ou avaliadores da qualidade do design em interfaces geradas. A Anthropic diz assim:
Every component in a harness encodes an assumption about what the model can’t do on its own.
Quando o modelo aprende a fazer algo, essa peça já não sustenta nada e deve sair. Quando ele desbloqueia algo novo, é preciso andaime novo para chegar ao novo teto.
Há ainda um ciclo entre o design do arnês e o treinamento, que Trivedy nomeia expressamente: descobre-se uma primitiva útil no arnês, ela é padronizada no produto, usada no treinamento da geração seguinte, e o modelo novo melhora justamente nessa primitiva.
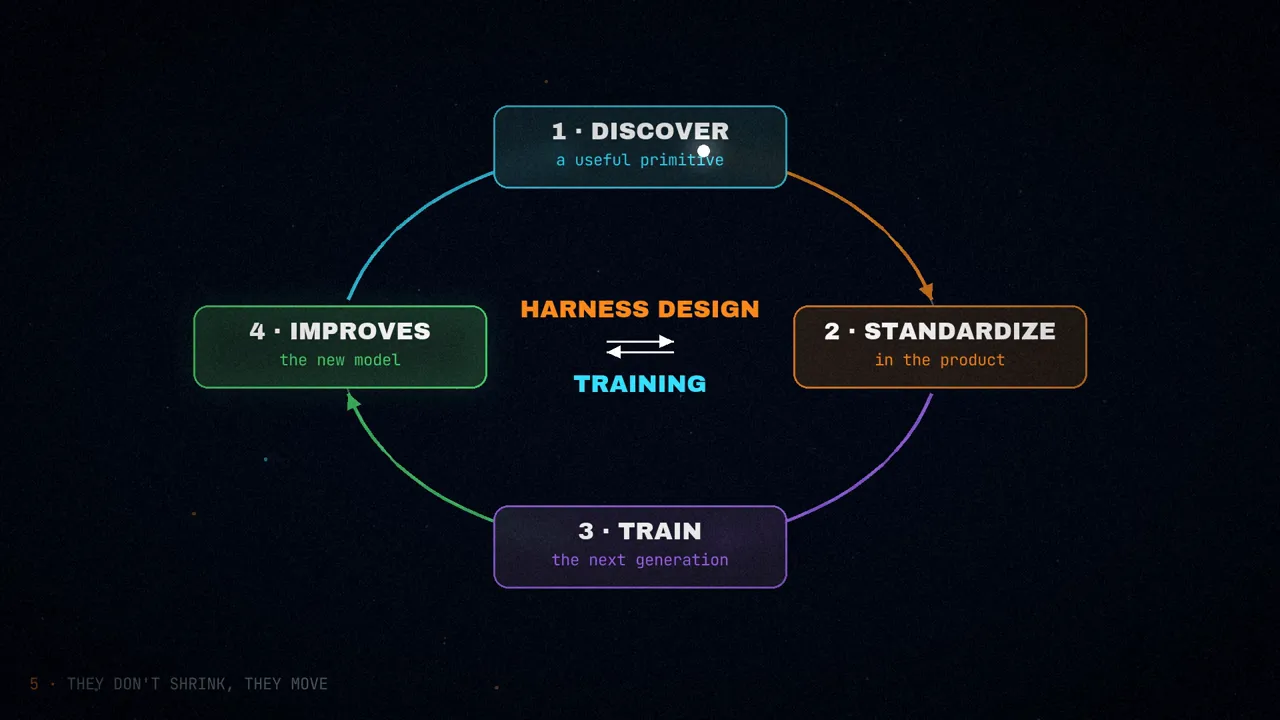
Os produtos de agentes de hoje são pós-treinados com o arnês no loop. Por isso o Opus 4.6 parece diferente dentro do Claude Code e em outro arnês, e por isso mudar a lógica de uma ferramenta às vezes causa regressões estranhas. Para um modelo realmente geral, tanto faria editar com apply_patch ou com str_replace, mas o cotreinamento produz overfitting.
Daí saem duas consequências práticas: um arnês é um sistema vivo, não um arquivo de configuração que se escreve uma vez; e o «melhor» arnês não é necessariamente aquele em que o modelo foi treinado, e sim o projetado para a sua tarefa.
O arnês como serviço
Outra ideia de Trivedy é o Harness-as-a-Service: estamos passando de construir sobre a API de um modelo, que devolve uma resposta, para construir sobre a API de um arnês, que entrega um ambiente de execução. O Claude Agent SDK, o Codex SDK e o OpenAI Agents SDK apontam nessa direção: trazem o loop, as ferramentas, a gestão de contexto, os hooks e as primitivas de sandbox, e você os adapta.
Antes, o caminho padrão era montar tudo: o seu loop, as suas chamadas de ferramentas, o estado da conversa e o fluxo de aprovações. Agora é escolher um framework de arnês, configurá-lo em seus quatro pilares (prompt de sistema, ferramentas, contexto e subagentes) e colocar o esforço nos prompts e nas ferramentas do seu domínio. É isso que torna o skill issue tratável: você não reconstrói o agente toda vez que algo falha, ajusta uma superfície de configuração que já vem bem separada.
E é o melhor argumento para começar mesmo que fique feio. A frase é de Trivedy:
Good agent building is an exercise in iteration. You can’t do iterations if you don’t have a v0.1.
Para onde isso vai
Se você colocar os melhores agentes de programação lado a lado (Claude Code, Cursor, Codex, Aider, Cline), eles se parecem entre si mais do que os seus modelos. Os modelos são diferentes; os padrões de arnês convergem. Osmani não acha que seja coincidência: a indústria vai encontrando as peças de andaime que de fato sustentam o peso.
Os problemas em aberto que Trivedy levanta são três:
- Orquestrar muitos agentes em paralelo sobre uma mesma base de código.
- Agentes que analisam os próprios traces para encontrar e consertar falhas do arnês.
- Arneses que montam as ferramentas e o contexto just-in-time para cada tarefa, em vez de virem configurados desde a inicialização.
Com o último, diz Osmani, o arnês deixa de ser configuração estática e começa a se parecer com um compilador.
O que é dado e o que é opinião
O artigo é uma síntese com opinião, e convém separar as coisas:
- O Terminal Bench vem sem números. O Opus 4.6 pontuar «muito abaixo» dentro do Claude Code e o salto do Top 30 ao Top 5 são resultados de terceiros (Trivedy e HumanLayer) que Osmani cita sem pontuações.
- «Um modelo decente com um ótimo arnês vence» é a tese do autor, apoiada na experiência dele. Não é uma medição.
- Dez ferramentas contra cinquenta também é uma opinião, não um experimento.
- As 60 linhas são a prática da HumanLayer, não uma regra geral.
- O diagrama do Claude Code é uma estimativa de Fareed Khan.
- A regra que abre o artigo aparece como citação, mas sem atribuição na página.
Há ainda um detalhe que não bate na última figura do artigo. O texto alternativo dela descreve o ciclo entre arnês e treinamento, mas a imagem mostra outra coisa: «The harness doesn’t shrink. It moves.», em três gerações de modelo. O ciclo só está no texto.
Em resumo
O agente é o modelo mais o arnês, e o arnês é seu. Quando o agente falha, a pergunta útil não é qual modelo vem depois, e sim qual peça do arnês teria evitado a falha: uma linha no AGENTS.md, um hook, um sandbox, um avaliador separado. E quando o modelo melhora, o arnês não desaparece: saem as peças que já não sustentam nada e entram as que o novo teto exige.
Cada erro do agente é um sinal para apertar a catraca: adicione uma regra quando algo falhar e remova-a quando o modelo já não precisar dela.
De qual falha concreta vem cada linha do seu AGENTS.md?
Fontes
- «Agent Harness Engineering», de Addy Osmani, 19 de abril de 2026.
- Sobre arneses neste blog: A anatomia de um agente de IA, o artigo de Viv Trivedy que Osmani toma como base, e O arnês é o produto.
- O vídeo, nos meus canais: inglês e espanhol.