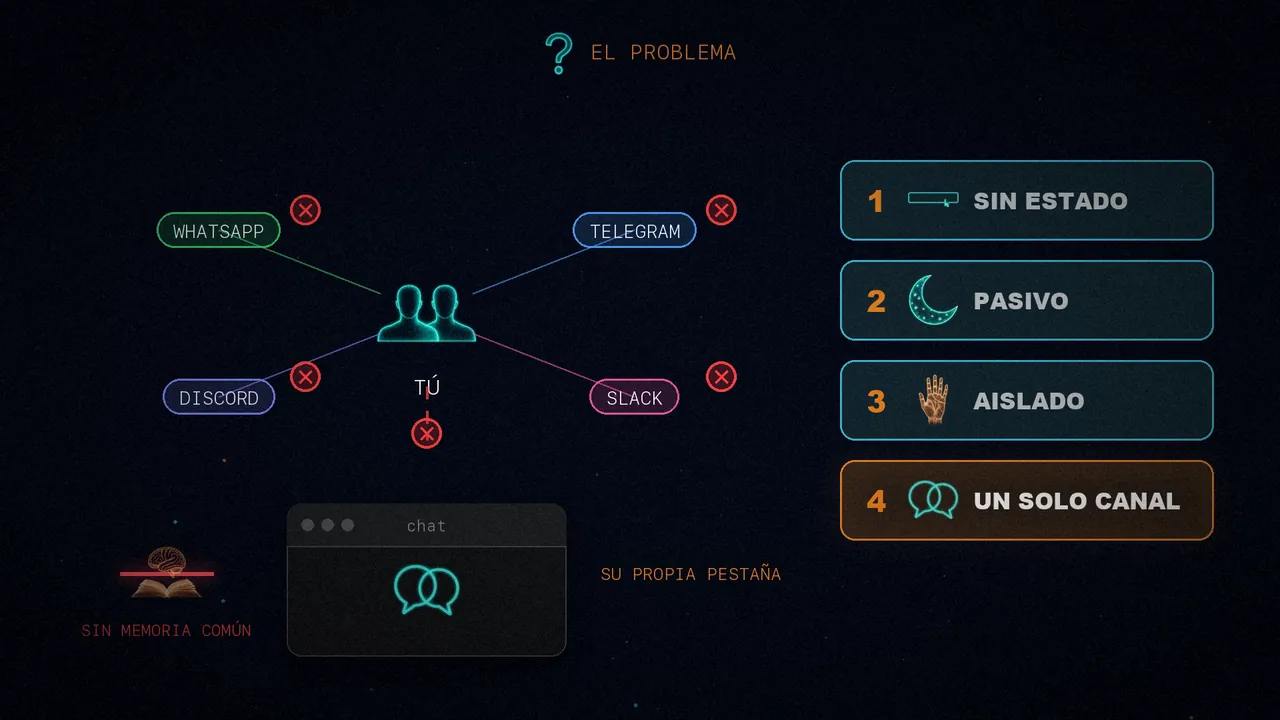
El problema: cuatro límites del chat
Cuando usas ChatGPT o Claude en el navegador, chocas enseguida con cuatro límites:
Cada conversación empieza de cero. No sabe tu nombre, ni tus preferencias, ni lo que le pediste ayer, así que te pasas el día explicándole el contexto otra vez.
Tú vas a él, pero él nunca viene a ti. No puede despertarse a las siete y resumirte la agenda, vigilar tu correo ni repetir una tarea.
No ejecuta comandos en tu ordenador, no navega por ti, no controla tus apps ni envía mensajes. Vive en una caja de texto, sin manos.
Tu vida pasa por WhatsApp, Telegram, Discord o Slack, pero la IA está en su propia pestaña. No puedes escribirle donde ya estás, y menos aún que recuerde lo mismo en todas partes.
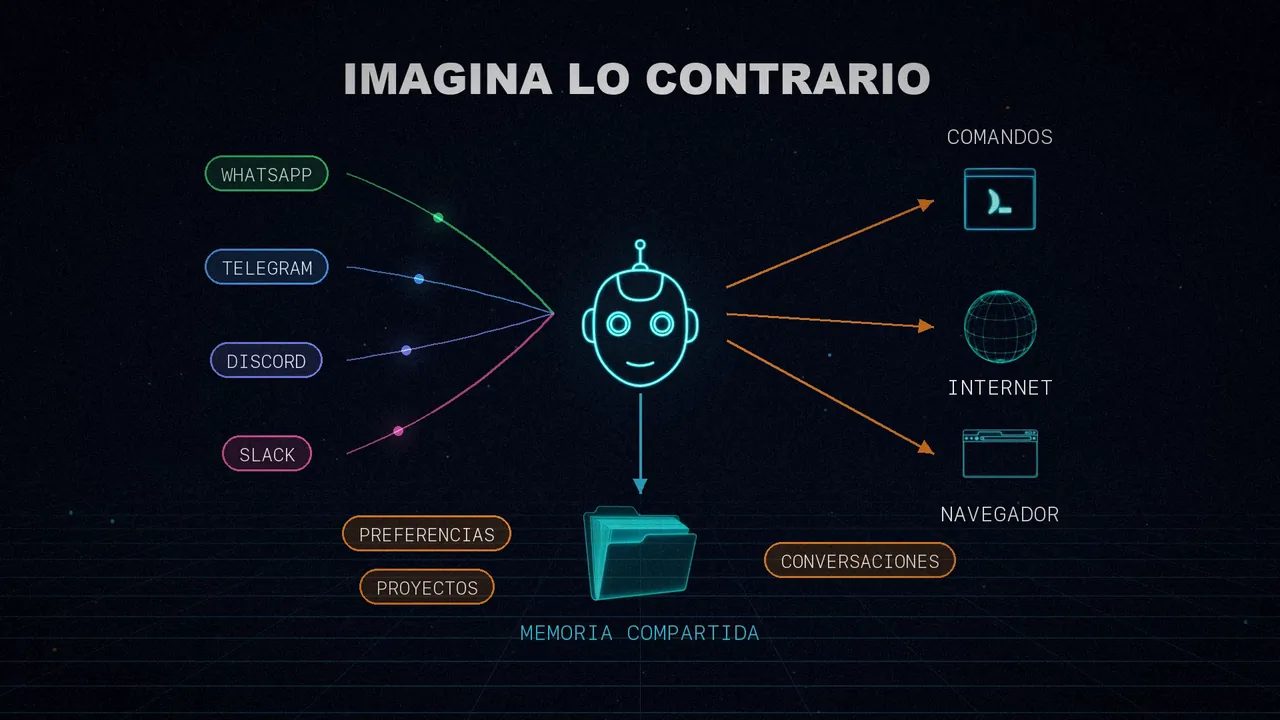
Imagina lo contrario
Ahora imagina un asistente que hace justo lo que el chat no puede:
- Vive en todas tus apps de mensajería, con una sola memoria compartida.
- Recuerda tus preferencias, tus proyectos y vuestras conversaciones.
- Actúa: ejecuta comandos, navega por internet y maneja un navegador de verdad.
- Se despierta solo, según un horario, para hacer tareas sin que se lo pidas.
- Corre en tu propio hardware: un portátil, un servidor o un Mac Mini, siempre encendido y bajo tu control.
Eso es OpenClaw. No es un chatbot: es un asistente personal con identidad propia, herramientas y presencia en todos tus canales. Y el artículo no se queda en la descripción: lo construye desde cero con solo tres ingredientes, una API de mensajería, un modelo de lenguaje y las ganas de que la IA sirva fuera de la ventana de chat.
El punto de partida: el bot más simple
Todo empieza con lo mínimo: una IA que responde en Telegram. El código cabe en una pantalla: recibe tu mensaje, se lo manda a Claude Sonnet y te devuelve su respuesta. Lo ejecutas, le escribes desde el móvil y contesta.
Es sencillo, pero en realidad es una versión peor de la web de Claude. Cada mensaje es independiente: le dices tu nombre y, en el siguiente mensaje, ya lo ha olvidado. No tiene memoria, ni herramientas, ni personalidad. A partir de aquí, cada paso arregla una de estas carencias.
Paso 1: sesiones persistentes
El primer problema es la falta de estado: pregúntale qué le dijiste antes y no tiene ni idea. La solución es guardar un historial de la conversación por cada usuario. Antes de llamar al modelo, el bot carga el historial; después, guarda tu mensaje y su respuesta. Se acuerda de ti porque la conversación entera viaja en cada llamada.
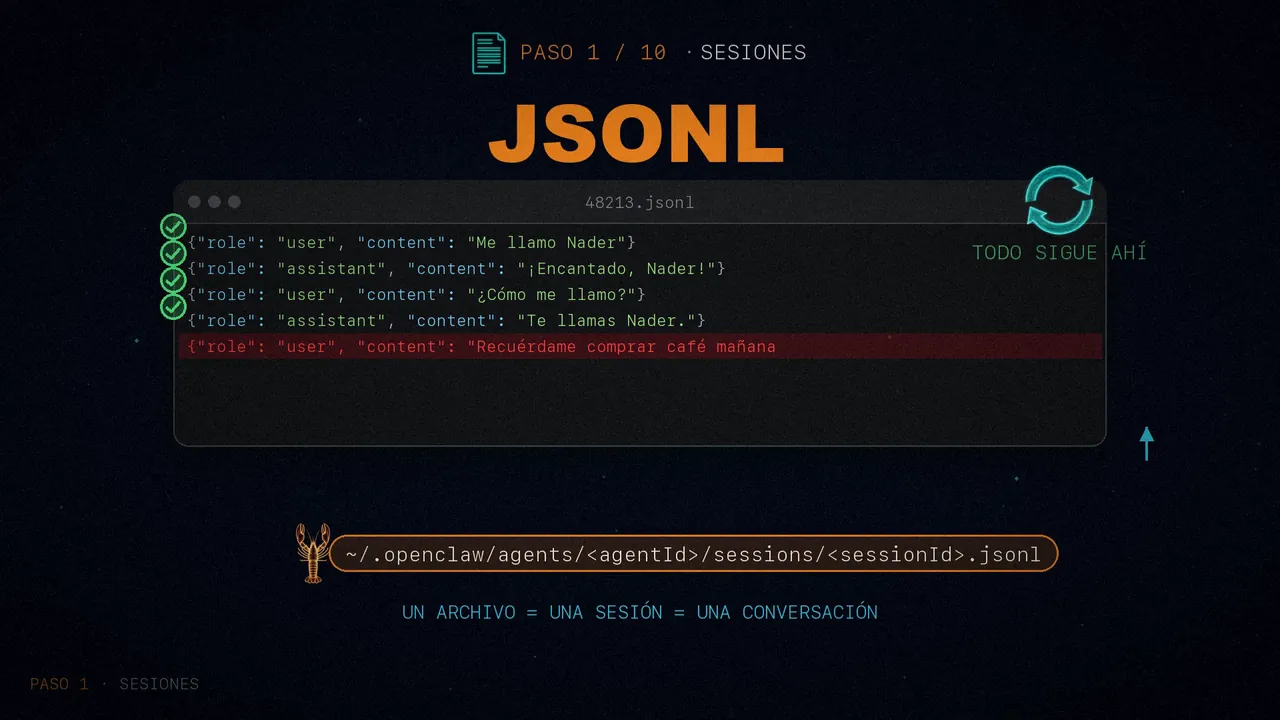
La clave está en el formato, JSONL: cada línea del archivo es un mensaje, y solo se añaden líneas al final.
{"role": "user", "content": "My name is Nader"}
{"role": "assistant", "content": "Nice to meet you, Nader!"}
{"role": "user", "content": "What's my name?"}
{"role": "assistant", "content": "Your name is Nader!"}
Si el proceso se cae a mitad de una escritura, pierdes como mucho una línea. Es justo lo que usa OpenClaw para sus transcripciones, un archivo por sesión en ~/.openclaw/agents/<agentId>/sessions/<sessionId>.jsonl. Reinicias el proceso y todo sigue ahí.
Aquí asoma un problema que se resuelve más adelante: las conversaciones crecen, y con las semanas el historial acaba siendo más grande que la ventana de contexto del modelo.
Paso 2: personalidad con SOUL.md
El bot ya funciona, pero es un asistente genérico. ¿Y si quisiéramos que fuera alguien? OpenClaw lo resuelve con un archivo Markdown, SOUL.md, el alma del agente, que define su identidad, cómo se comporta y cuáles son sus límites. El del artículo se llama Jarvis:
# Who You Are

**Name:** Jarvis
**Role:** Personal AI assistant

## Personality
- Be genuinely helpful, not performatively helpful
- Skip the "Great question!" - just help
- Have opinions. You're allowed to disagree
- Be concise when needed, thorough when it matters

## Boundaries
- Private things stay private
- When in doubt, ask before acting externally
- You're not the user's voice - be careful about sending messages on their behalf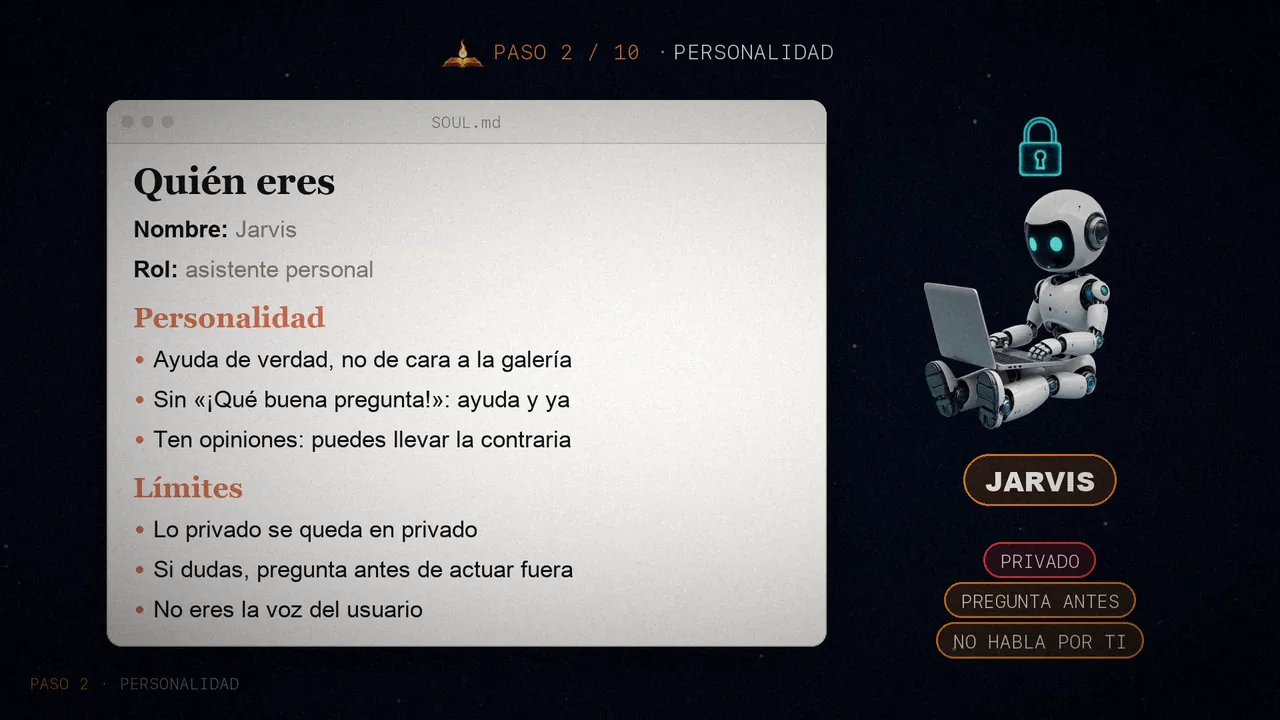
Ese texto se inyecta como prompt de sistema en cada llamada al modelo. Y puedes escribir lo que quieras: una historia de origen, una filosofía, sus reglas. Cuanto más concreto, más coherente es el agente. «Sé útil» es vago; «conciso cuando hace falta, minucioso cuando importa; ni un burócrata, ni un pelota» le da al modelo algo con lo que trabajar.
Paso 3: herramientas y el bucle del agente
Un bot que solo habla se queda corto. La idea es darle al modelo herramientas con estructura y dejar que él decida cuándo usarlas. En el ejemplo hay cuatro: run_command, read_file, write_file y web_search. Cada una tiene tres partes: un nombre con su esquema de entrada, una descripción que le explica al modelo para qué sirve y la función que la ejecuta de verdad.
Después viene el bucle del agente: llamas al modelo con las herramientas; si pide usar alguna, la ejecutas y le devuelves el resultado; y vuelves a llamarlo, hasta que responde sin pedir nada más.
def run_agent_turn(messages, system_prompt):
    """Run one full agent turn (may involve multiple tool calls)."""
    while True:
        response = client.messages.create(
            model=MODEL, max_tokens=4096,
            system=system_prompt, tools=TOOLS, messages=messages
        )
        content = serialize_content(response.content)

        # If the AI is done (no tool use), return the text
        if response.stop_reason == "end_turn":
            text = ""
            for block in response.content:
                if hasattr(block, "text"):
                    text += block.text
            messages.append({"role": "assistant", "content": content})
            return text, messages

        # Process tool calls
        if response.stop_reason == "tool_use":
            messages.append({"role": "assistant", "content": content})
            tool_results = []
            for block in response.content:
                if block.type == "tool_use":
                    result = execute_tool(block.name, block.input)
                    tool_results.append({
                        "type": "tool_result",
                        "tool_use_id": block.id,
                        "content": str(result)
                    })
            messages.append({"role": "user", "content": tool_results})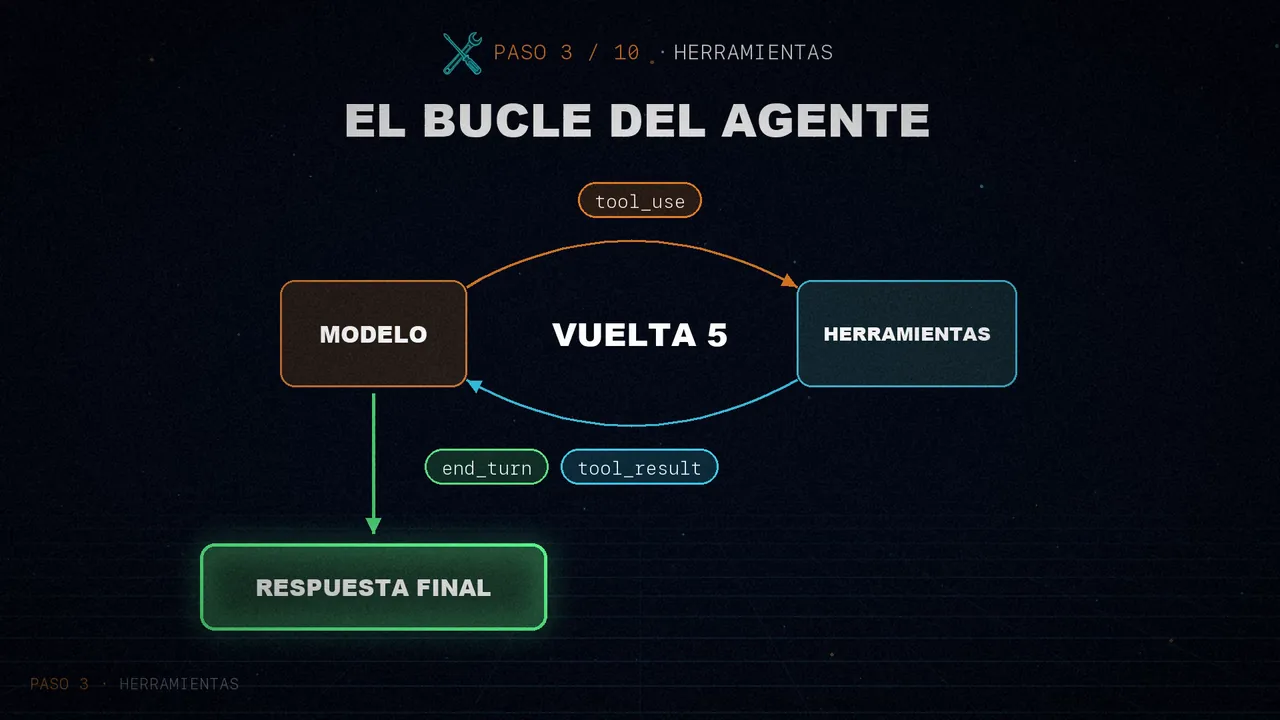
Ahora le escribes por Telegram que cree un archivo que imprima «hola mundo» y lo ejecute. El bot escribe el archivo, lo ejecuta y te cuenta lo que ha salido. Ha decidido él qué herramientas usar y en qué orden. OpenClaw tiene muchas más, como el navegador o lanzar subagentes, pero todas siguen este mismo patrón.
Paso 4: permisos
Estamos ejecutando comandos que llegan por Telegram, y eso da miedo. ¿Qué pasa si alguien entra en tu cuenta y le pide al bot que lo borre todo? El sistema de permisos del artículo tiene tres piezas: una lista de comandos seguros, unos patrones peligrosos y un archivo con las aprobaciones que ya diste.
SAFE_COMMANDS = {"ls", "cat", "head", "tail", "wc", "date", "whoami", "echo"}
DANGEROUS_PATTERNS = [r"\brm\b", r"\bsudo\b", r"\bchmod\b", r"\bcurl.*\|.*sh"]
APPROVALS_FILE = "./exec-approvals.json"
Si el comando es seguro o ya lo aprobaste, se ejecuta al momento. Si no, el agente recibe un «permiso denegado» y puede probar otro camino. La aprobación queda guardada, así que nunca te pregunta dos veces por lo mismo.
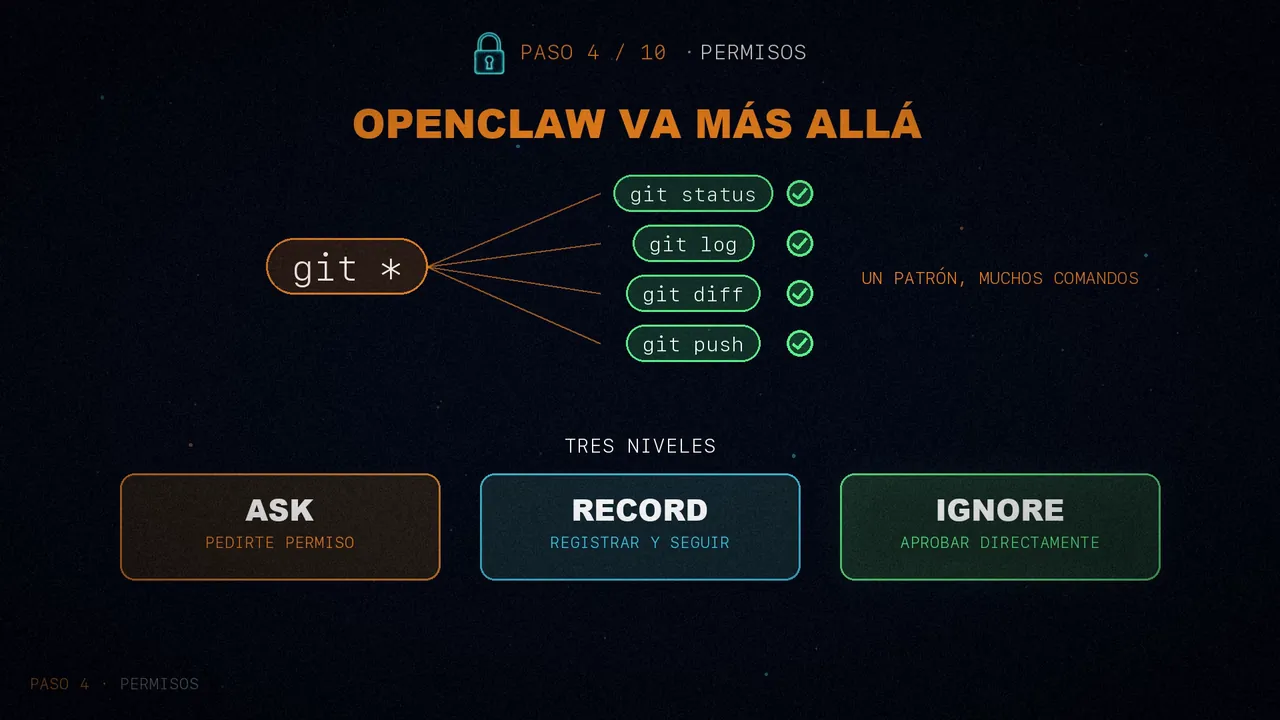
OpenClaw va más allá: permite aprobar patrones enteros, como git *, y tiene tres niveles: ask (te pide permiso), record (lo registra y sigue) e ignore (lo aprueba directamente).
Paso 5: la pasarela
Hasta ahora tenemos un bot de Telegram. Pero ¿y si también lo quieres en Discord, en WhatsApp y en Slack? Podrías escribir un bot por plataforma, pero cada uno tendría su sesión, su memoria y su configuración, y el de Telegram no sabría nada de tus otras conversaciones.
La solución es una pasarela (gateway): un proceso central que gestiona todos los canales. Y fíjate en lo que ya tenemos: run_agent_turn no sabe nada de Telegram. Recibe mensajes y devuelve texto, así que la lógica del agente ya está separada del canal.
Para demostrarlo, el artículo añade una segunda puerta: una API HTTP con Flask junto al bot de Telegram, las dos hablando con el mismo agente y las mismas sesiones.
# Via Telegram
You: My name is Nader
Bot: Nice to meet you, Nader!

# Via HTTP: use your Telegram user ID so it hits the same session
curl -X POST http://127.0.0.1:5000/chat \
  -H "Content-Type: application/json" \
  -d '{"user_id": "YOUR_TELEGRAM_USER_ID", "message": "What is my name?"}'

{"response": "Your name is Nader!"}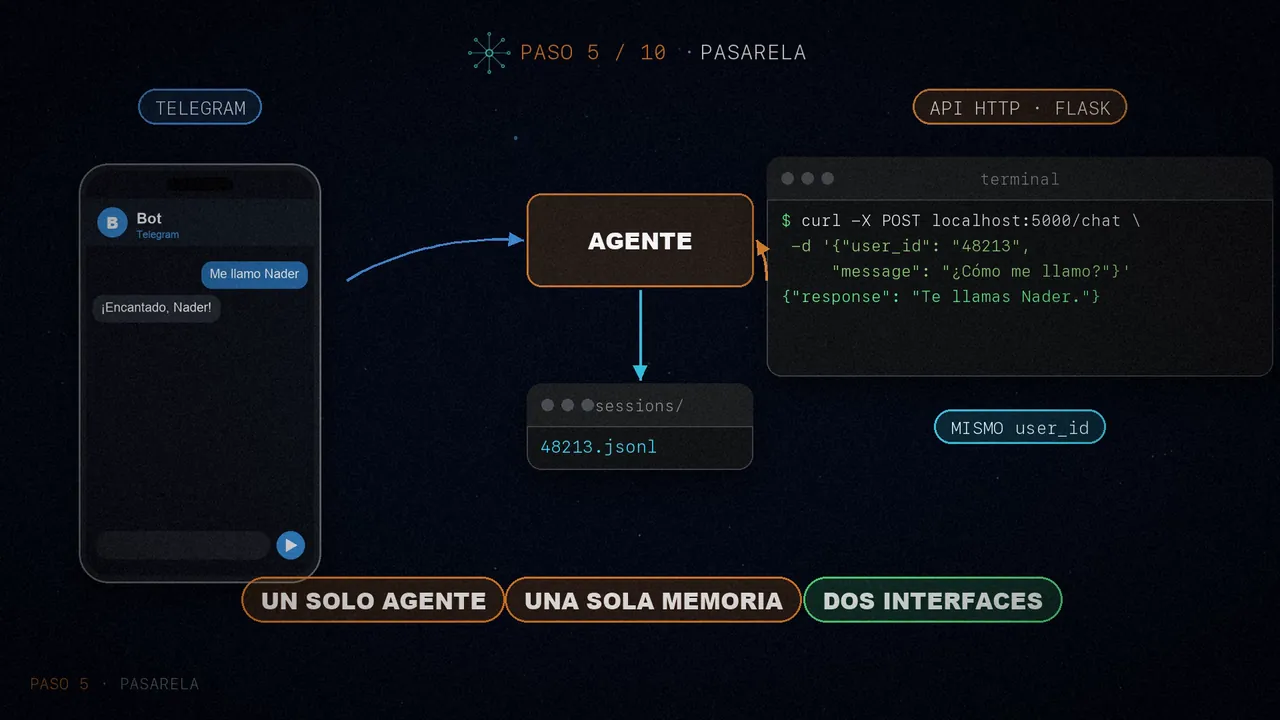
El siguiente paso es llevarlo a un archivo de configuración que diga qué canales arrancar y cómo autenticarse. Es lo que hace OpenClaw: una sola pasarela para Telegram, Discord, WhatsApp, Slack, Signal, iMessage y más, con las sesiones agrupadas por usuario, por canal o en una sola compartida.
Paso 6: compactación del contexto
Volvemos al problema que dejamos apuntado. Tras semanas hablando con el bot, el historial tiene miles de mensajes y su tamaño supera la ventana de contexto del modelo. La solución es compactar: resumir los mensajes antiguos y quedarse con los recientes.
Primero se estiman los tokens con una regla aproximada, cuatro caracteres por token. Si la conversación pasa de 100.000, más o menos el 80 % de una ventana de 128.000, se parte en dos: la mitad antigua se manda al modelo para que la resuma, y la reciente se queda tal cual.
def estimate_tokens(messages):
    """Rough token estimate: ~4 chars per token."""
    return sum(len(json.dumps(m)) for m in messages) // 4

def compact_session(user_id, messages):
    """Summarize old messages when context gets too long."""
    if estimate_tokens(messages) < 100_000:  # ~80% of a 128k window
        return messages  # No compaction needed

    split = len(messages) // 2
    old, recent = messages[:split], messages[split:]
    ...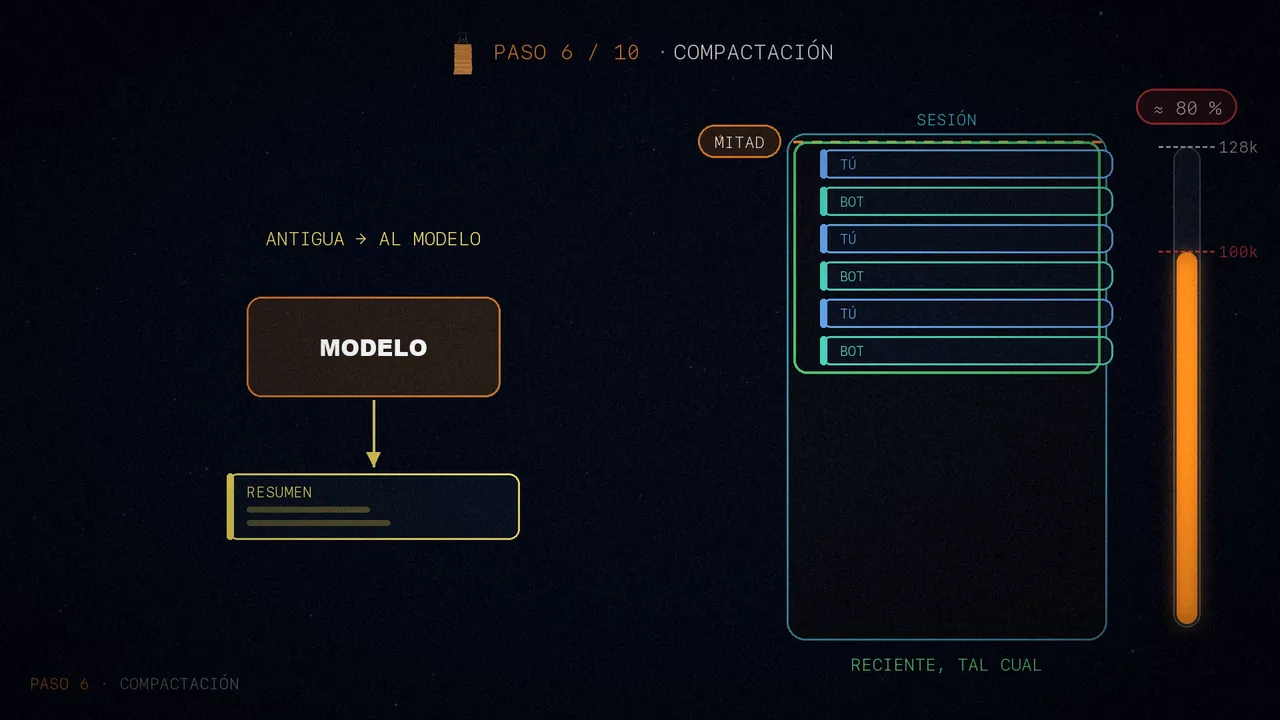
El resumen tiene que conservar lo importante: los datos del usuario, como su nombre o sus preferencias, las decisiones tomadas y las tareas pendientes. Ese resumen sustituye a todos los mensajes viejos, de modo que el bot sigue recordando lo esencial y el archivo es mucho más pequeño. Para probarlo sin pasarte horas chateando, baja el umbral a 1.000 tokens.
La compactación de OpenClaw es más fina: parte los mensajes en trozos según sus tokens, resume cada trozo por separado y deja un margen de seguridad, porque la estimación nunca es exacta. Pero la idea es la misma.
Paso 7: memoria a largo plazo
El historial es la memoria de la conversación, pero si reinicias la sesión o empiezas otra, todo desaparece. Hace falta una memoria aparte que sobreviva a los reinicios. La idea: dos herramientas más, save_memory y memory_search, sobre archivos Markdown en una carpeta.
You: Remember that my favorite restaurant is Elvies and I prefer to go on weekends.

Bot: [uses save_memory to write nader-profile.md]
     Got it — saved your restaurant preference.

[Reset the session or restart the bot]

You: Where should we go for dinner?

Bot: [uses memory_search for "restaurant dinner favorite"]
     How about Elvies? I know it's your favorite. Want to go this weekend?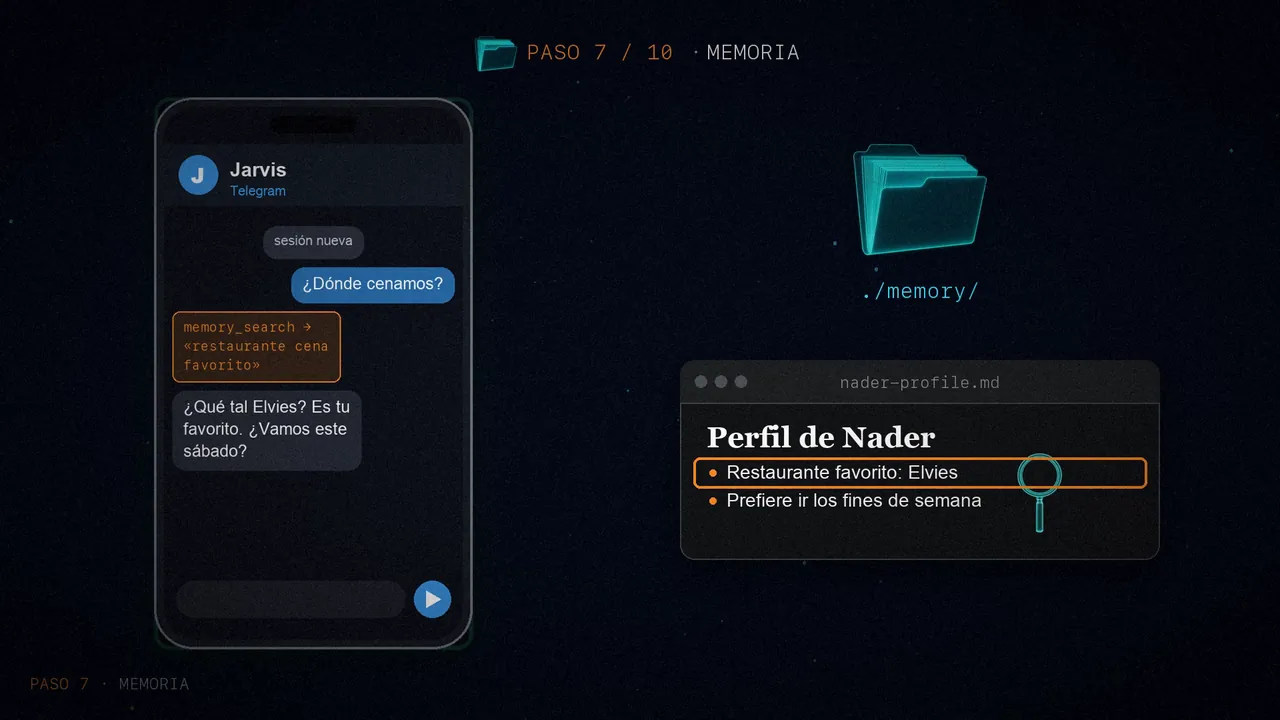
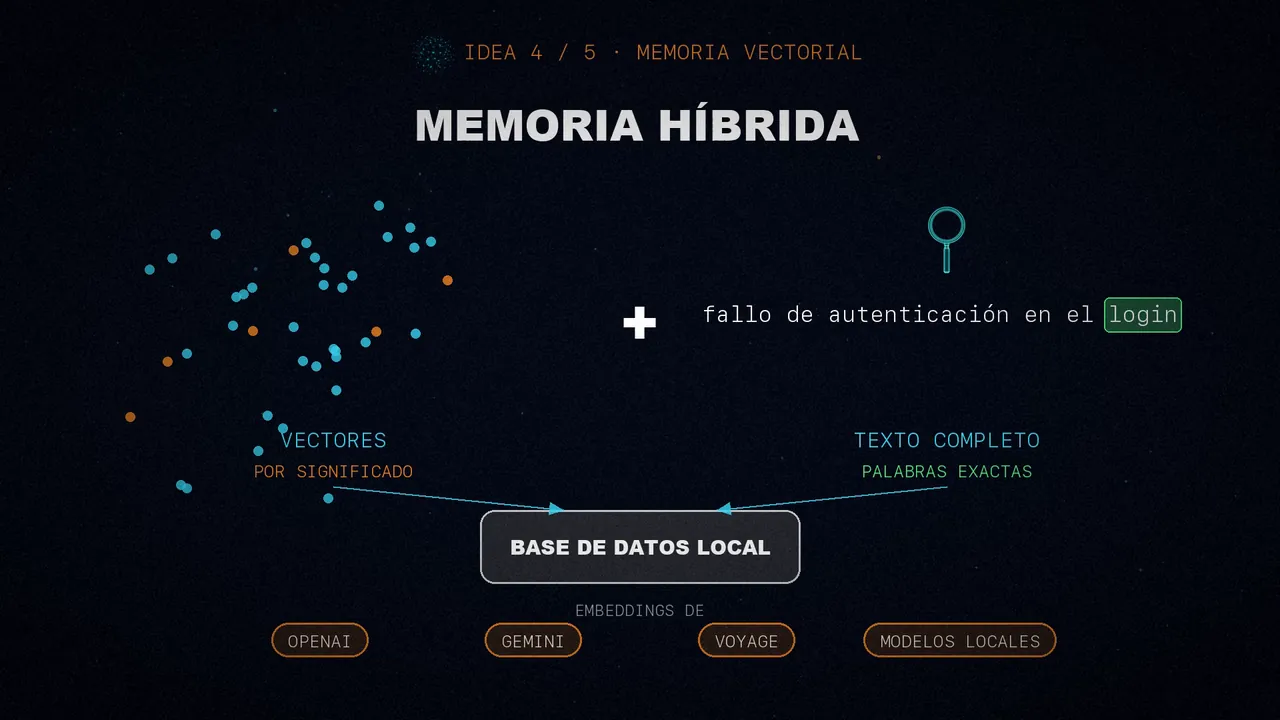
Funciona porque la memoria está en archivos. Nuestra búsqueda es por palabras clave, y basta para empezar. OpenClaw usa búsqueda vectorial con embeddings, que encuentra por significado: así, «auth bug» da con «authentication issues».
Paso 8: la cola de comandos
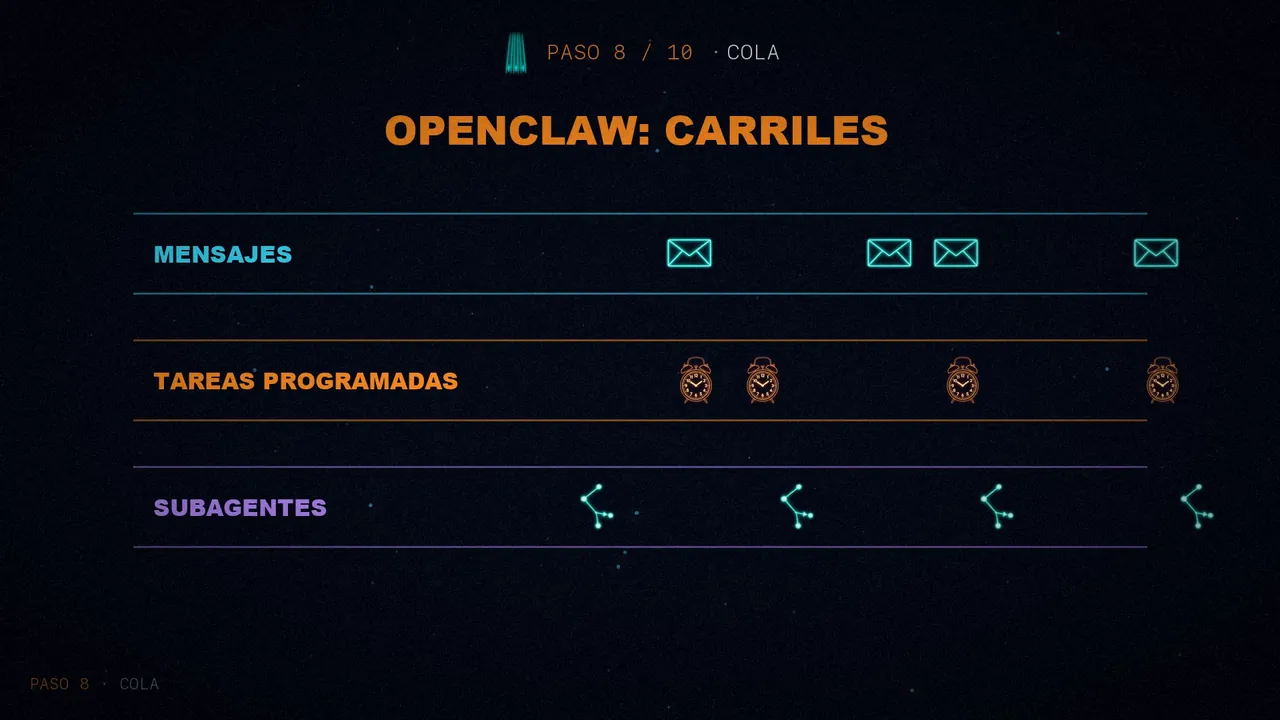
Este paso resuelve un problema sutil pero crítico: ¿qué pasa si llegan dos mensajes a la vez? Le pides por Telegram que mire tu agenda y, al mismo tiempo, por la web, qué tiempo hace. Los dos cargan la misma sesión, los dos escriben en ella y el archivo acaba corrupto.
La solución es sencilla: un candado por sesión. Solo se procesa un mensaje a la vez en cada sesión. Los mensajes del mismo usuario hacen cola, y los de usuarios distintos van en paralelo.
session_locks = defaultdict(threading.Lock)

async def handle_message(update: Update, context):
    user_id = str(update.effective_user.id)

    with session_locks[user_id]:
        messages = load_session(user_id)
        messages = compact_session(user_id, messages)
        messages.append({"role": "user", "content": update.message.text})

        response_text, messages = run_agent_turn(messages, SOUL)

        save_session(user_id, messages)

    await update.message.reply_text(response_text)
OpenClaw lo amplía con carriles separados para los mensajes, las tareas programadas y los subagentes.
Paso 9: latidos (tareas programadas)
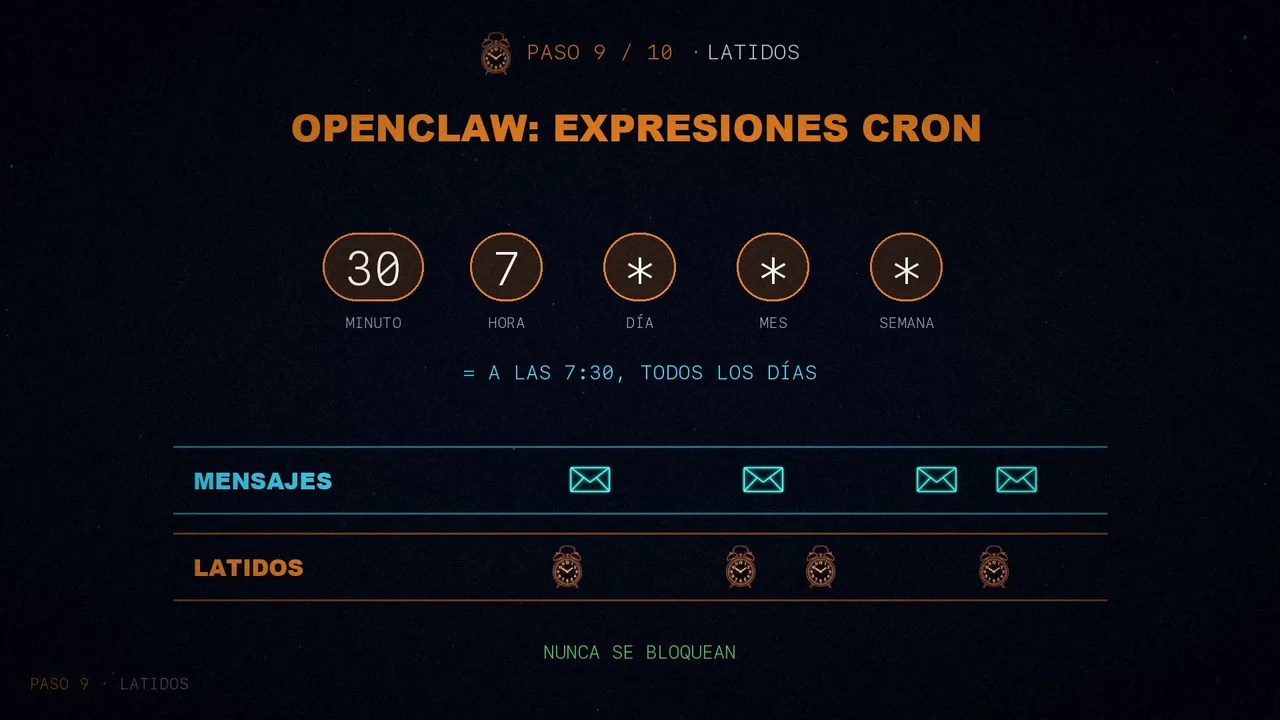
Hasta ahora el agente solo responde cuando le hablas. ¿Y si quieres que mire tu correo cada mañana, o que te resuma la agenda antes de las reuniones? Hacen falta latidos (heartbeats): tareas que despiertan al agente con un temporizador. El ejemplo del artículo es un resumen matinal, todos los días a las 7:30:
def morning_briefing():
    # Use an isolated session key so cron doesn't pollute main chat
    session_key = "cron:morning-briefing"

    with session_locks[session_key]:
        messages = load_session(session_key)
        messages.append({
            "role": "user",
            "content": "Good morning! Check today's date and give me a motivational quote."
        })
        response_text, messages = run_agent_turn(messages, SOUL)
        save_session(session_key, messages)

schedule.every().day.at("07:30").do(morning_briefing)
Lo importante es que cada latido usa su propia sesión (cron:morning-briefing), para no llenar de ruido tu conversación principal. Y llama a la misma run_agent_turn: es un mensaje más, solo que lo dispara un reloj en vez de una persona.
OpenClaw acepta expresiones cron completas, como 30 7 * * *, y les da su propio carril para que nunca bloqueen los mensajes en tiempo real.
Paso 10: varios agentes
Con más tareas, una sola personalidad y un solo juego de herramientas no llegan a todo: un asistente de investigación necesita otras instrucciones que uno general. La solución son varias configuraciones de agente, cada una con su alma y su sesión, y un enrutador que elige a quién va cada mensaje.
En el ejemplo hay dos: Jarvis, el asistente general, y Scout, especialista en investigación, que tiene que citar fuentes para cada afirmación.
def resolve_agent(message_text):
    """Route messages to the right agent based on prefix commands."""
    if message_text.startswith("/research "):
        return "researcher", message_text[len("/research "):]
    return "main", message_text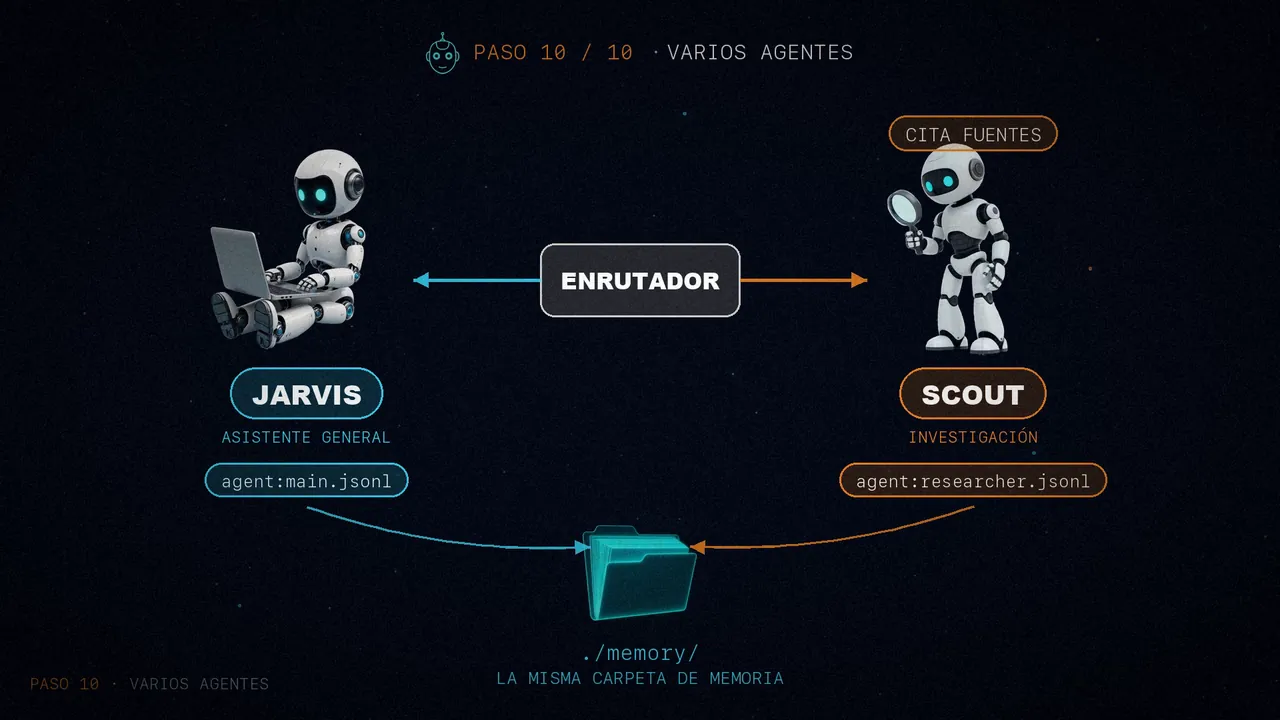
Cada uno tiene su propia conversación, pero los dos comparten la misma carpeta de memoria, y eso permite que colaboren. Le pides a Scout que investigue buenas prácticas de programación asíncrona en Python; busca en la web y guarda lo que encuentra. Luego le preguntas a Jarvis qué encontró Scout, y lo busca en esa memoria. Sin mensajes directos entre ellos: solo archivos compartidos.
OpenClaw lo amplía con subagentes y con mensajes entre agentes, pero el patrón de fondo es el mismo: cada agente no es más que un alma, una sesión y unas herramientas.
Todo junto: mini OpenClaw
El artículo lo junta todo en un único programa, mini-openclaw.py: una consola interactiva de unas 400 líneas de Python con sesiones, alma, herramientas, permisos, compactación, memoria, cola, tareas programadas y varios agentes. Lo he comprobado en su código: es una consola, así que de los diez pasos solo falta la pasarela.
En la sesión de ejemplo, le pides que recuerde tu restaurante favorito y lo guarda; le preguntas qué hay en tu carpeta de proyecto y ejecuta un comando para verlo; reinicias la sesión y, al preguntarle dónde te gusta comer, lo recuerda.
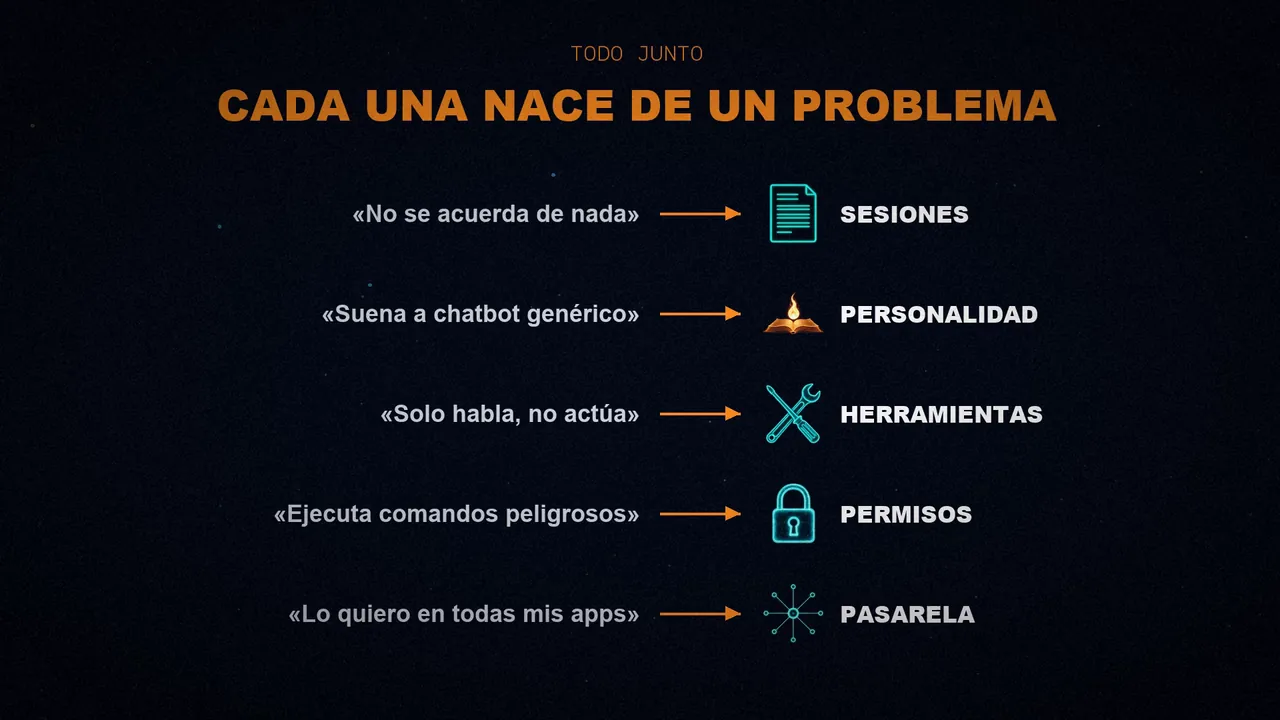
Lo bonito es que ninguna pieza es arbitraria. Cada una nació de un problema práctico:
- «No se acuerda de nada» → sesiones.
- «Suena a chatbot genérico» → SOUL.md.
- «Solo habla, no actúa» → herramientas y bucle del agente.
- «Ejecuta comandos peligrosos» → permisos.
- «Lo quiero en todas mis apps» → pasarela.
- «La conversación se hizo demasiado larga» → compactación.
- «Olvida las cosas entre sesiones» → memoria.
- «Dos mensajes a la vez corrompen los datos» → cola de comandos.
- «Quiero que haga cosas solo» → latidos.
- «Un agente no lo hace todo bien» → varios agentes.
Ir más allá: OpenClaw en producción
El prototipo cubre la arquitectura básica. El artículo termina con cinco ideas de cómo la lleva OpenClaw a producción, y merece la pena verlas.
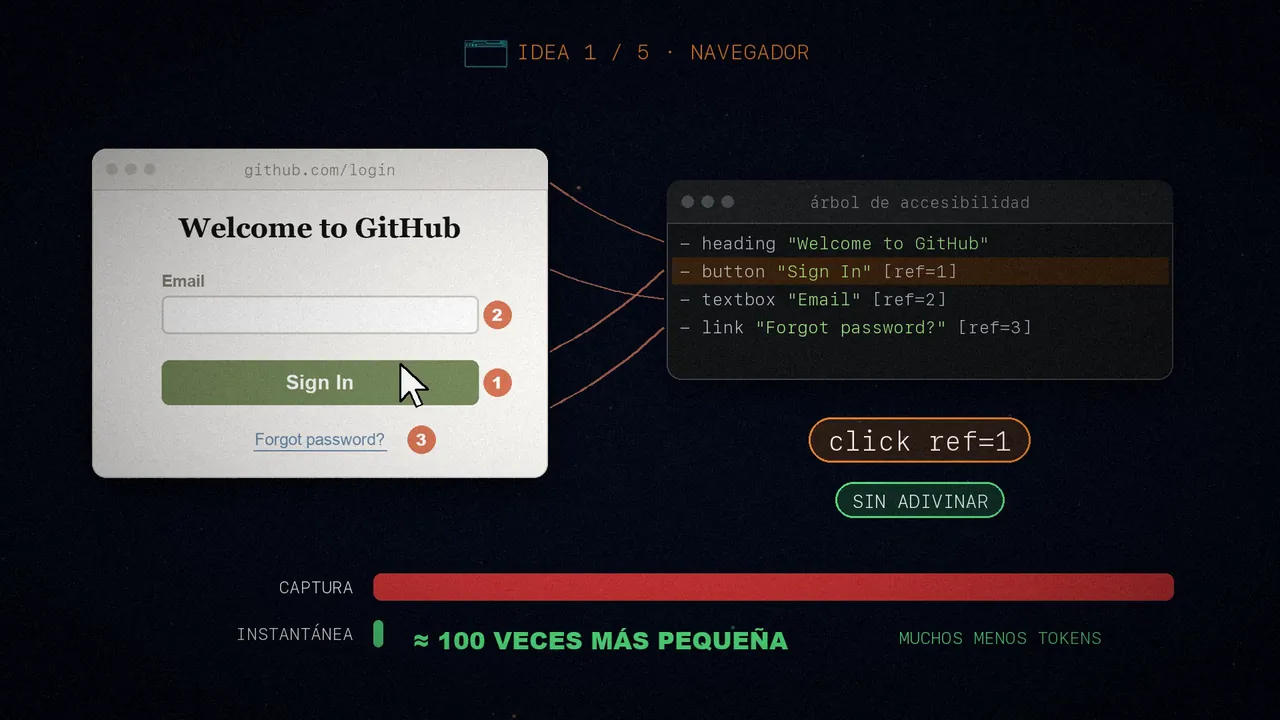
1. Un navegador con instantáneas semánticas
OpenClaw le da al agente un navegador con Playwright, pero en vez de mandarle capturas de pantalla, de unos 5 MB cada una, le manda una instantánea semántica, una versión en texto del árbol de accesibilidad de la página:
snapshot = page.accessibility.snapshot()
# - heading "Welcome to GitHub"
# - button "Sign In" [ref=1]
# - textbox "Email" [ref=2]
# - link "Forgot password?" [ref=3]
Cada elemento con el que se puede interactuar lleva un número. Cuando el agente quiere pulsar algo, dice click ref=1. Sin adivinar, y unas cien veces más pequeño que una captura, así que gasta muchos menos tokens.
2. El ámbito de las sesiones
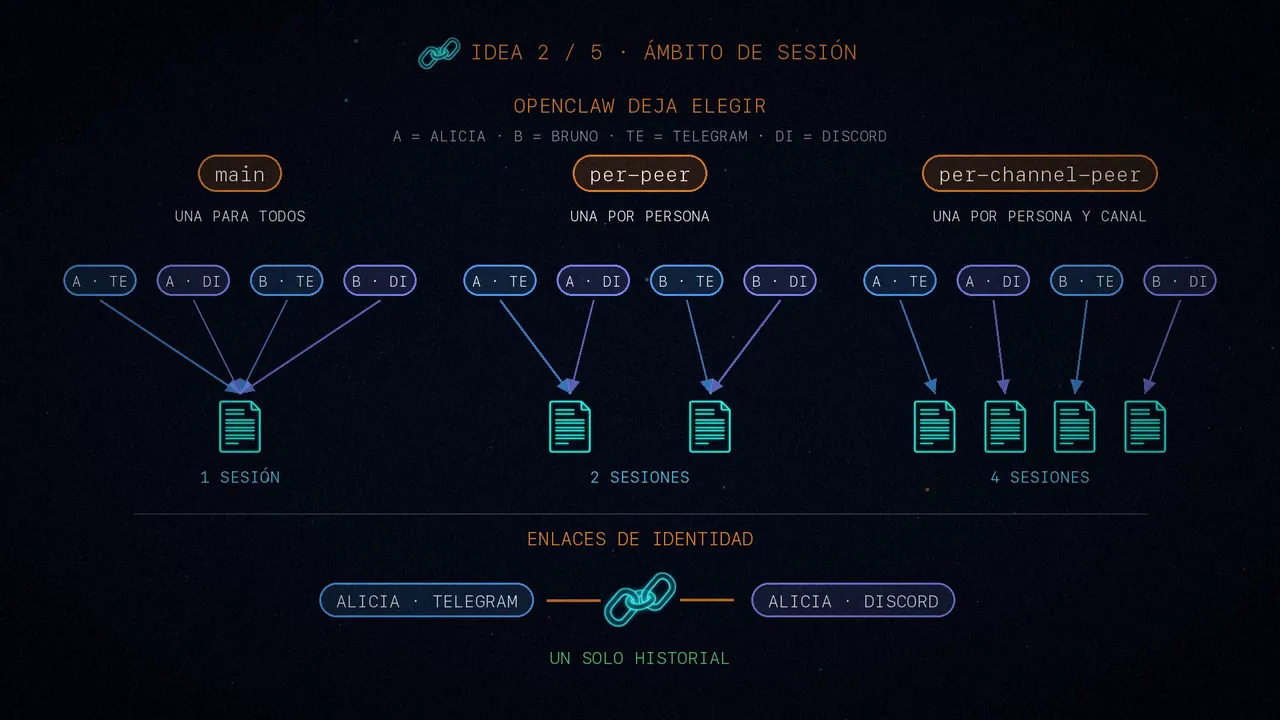
Nuestro prototipo usa el usuario como clave. OpenClaw deja elegir: main (una sola sesión para todos los mensajes directos), per-peer (una para cada persona en todos los canales) o per-channel-peer (una por persona y canal). Y con los enlaces de identidad, lo que Alicia habla por Telegram y por Discord comparte historial.
3. Los canales como plugins
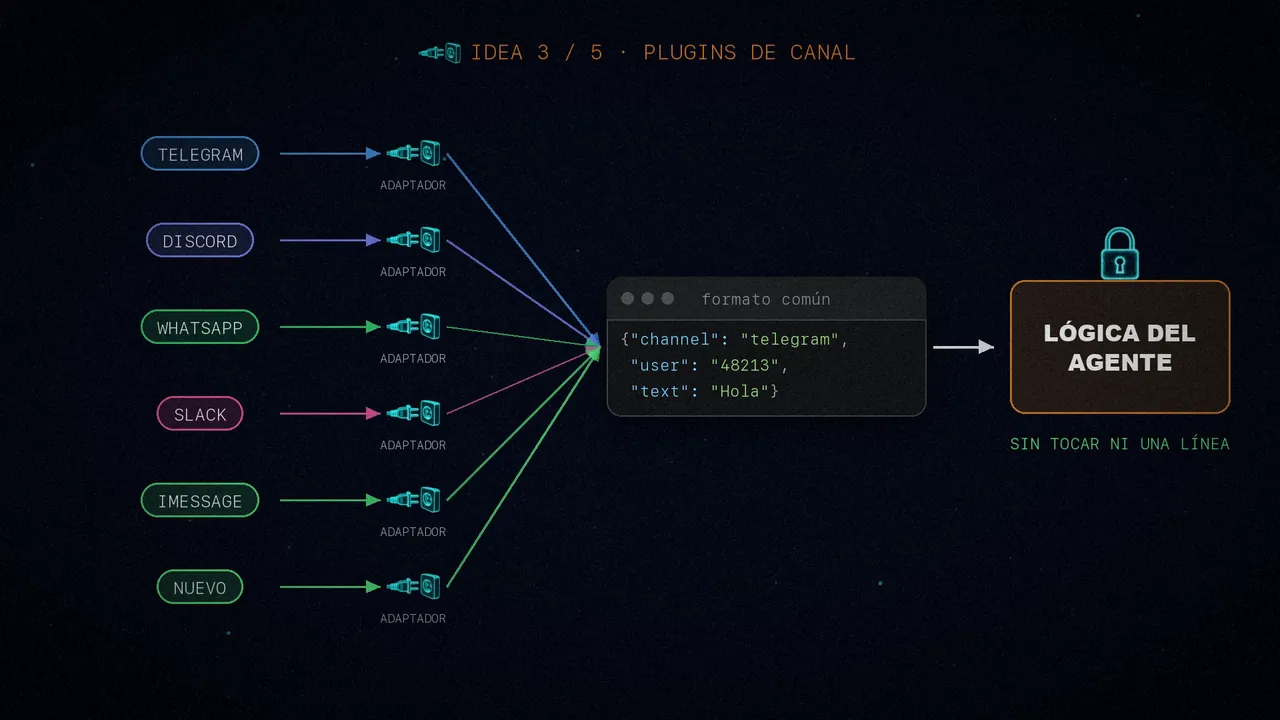
Cada canal, de Telegram a iMessage, es un adaptador que traduce sus mensajes a un formato común. Para añadir un canal nuevo basta con escribir su adaptador, sin tocar ni una línea de la lógica del agente.
4. Una memoria híbrida
Combina vectores, que encuentran por significado, con un índice de texto completo (FTS5) para las palabras exactas. Todo en una base de datos local, SQLite, y con embeddings de OpenAI, de Gemini, de Voyage o de modelos locales.
5. Subagentes
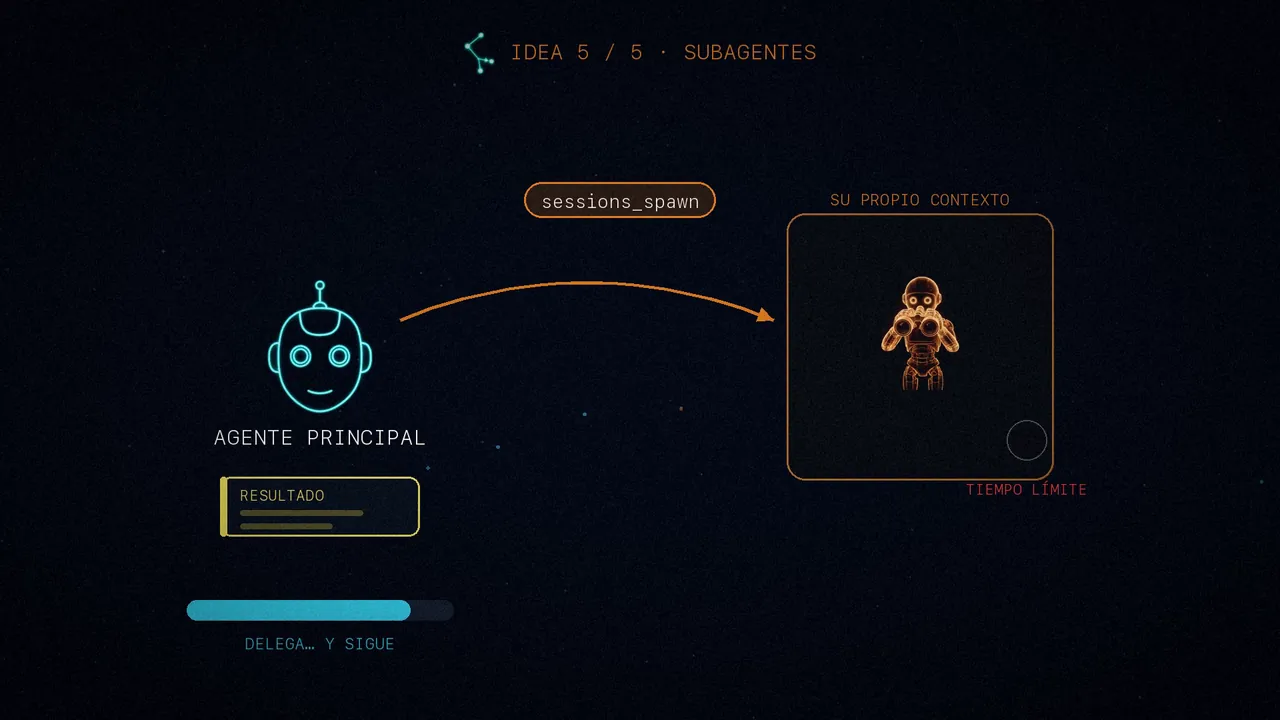
En nuestro prototipo, el enrutado es manual. En OpenClaw, un agente puede lanzar otro por su cuenta con sessions_spawn. El hijo trabaja en su propio contexto, con un tiempo límite, y le devuelve el resultado al padre. Así el principal delega una investigación a fondo y sigue cuando el especialista termina.
Si quieres construir el tuyo
El consejo del artículo es ir poco a poco:
- Empieza con un solo canal: un bot de Telegram o de Discord con sesiones.
- Añade herramientas de una en una: primero leer y escribir archivos, luego la terminal.
- Suma memoria cuando la necesites: en cuanto las sesiones se reinicien, la querrás.
- Añade canales cuando uno se te quede corto: la pasarela sale de forma natural.
- Añade agentes cuando las tareas se especialicen: mejor dos que diez.
O usa directamente OpenClaw, que es de código abierto y resuelve los casos límite. Pero ahora ya sabes cómo funciona por dentro.
En resumen
Un asistente persistente es un bucle de agente rodeado de piezas sencillas: sesiones, un alma, herramientas, permisos, una pasarela, memoria y tareas programadas.
Ninguna pieza es magia: cada una resuelve un problema concreto.
¿Qué pieza le añadirías tú a tu asistente?
Fuentes
- «You Could've Invented OpenClaw», de Nader Dabit (@dabit3), febrero de 2026.
- El vídeo, en mis tres canales: español, inglés y portugués.