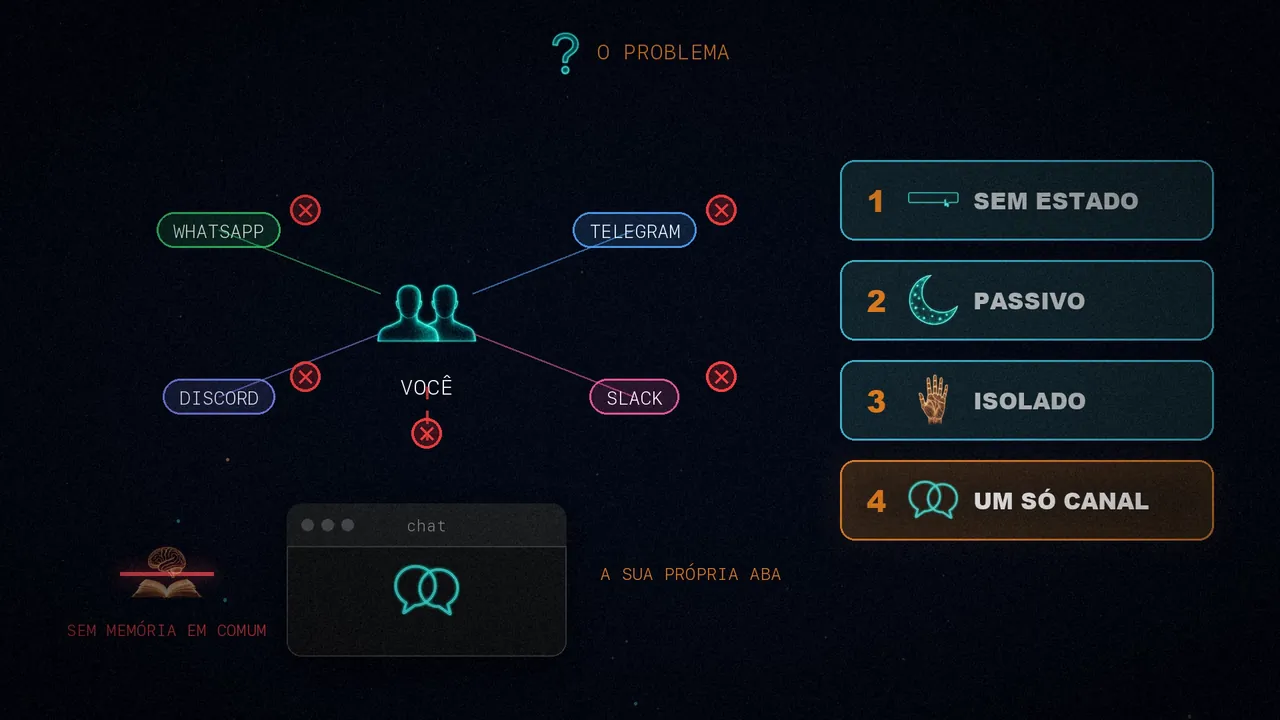
O problema: quatro limites do chat
Quando você usa o ChatGPT ou o Claude no navegador, logo esbarra em quatro limites:
Cada conversa começa do zero. Ele não sabe o seu nome, as suas preferências nem o que você pediu ontem, então você passa o dia explicando o contexto de novo.
Você vai até ele, mas ele nunca vem até você. Não consegue acordar às sete e resumir a sua agenda, vigiar o seu e-mail nem repetir uma tarefa.
Não executa comandos no seu computador, não navega por você, não controla os seus aplicativos nem envia mensagens. Vive numa caixa de texto, sem mãos.
A sua vida acontece no WhatsApp, no Telegram, no Discord ou no Slack, mas a IA fica na própria aba. Você não consegue escrever para ela onde já está, muito menos fazer com que ela lembre das mesmas coisas em todo lugar.
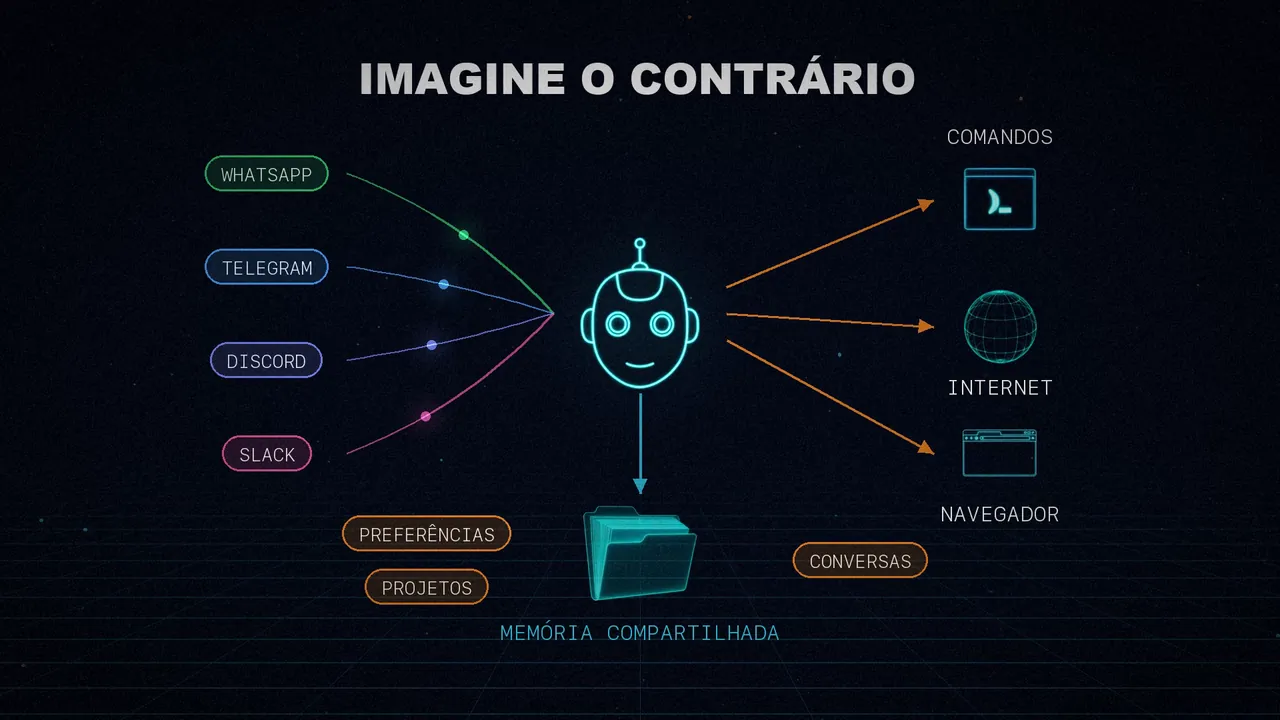
Imagine o contrário
Agora imagine um assistente que faz exatamente o que o chat não consegue:
- Vive em todos os seus aplicativos de mensagens, com uma só memória compartilhada.
- Lembra das suas preferências, dos seus projetos e das suas conversas.
- Age: executa comandos, navega na internet e controla um navegador de verdade.
- Acorda sozinho, de acordo com um horário, para fazer tarefas sem você pedir.
- Roda no seu próprio hardware: um notebook, um servidor ou um Mac Mini, sempre ligado e sob o seu controle.
Isso é o OpenClaw. Não é um chatbot: é um assistente pessoal com identidade própria, ferramentas e presença em todos os seus canais. E o artigo não fica na descrição: constrói um do zero com apenas três ingredientes, uma API de mensagens, um modelo de linguagem e a vontade de que a IA sirva fora da janela de chat.
O ponto de partida: o bot mais simples
Tudo começa com o mínimo: uma IA que responde no Telegram. O código cabe em uma tela: recebe a sua mensagem, manda para o Claude Sonnet e devolve a resposta. Você executa, escreve pelo celular e ele responde.
É simples, mas na verdade é uma versão pior do Claude na web. Cada mensagem é independente: você diz o seu nome e, na mensagem seguinte, ele já esqueceu. Não tem memória, ferramentas ou personalidade. A partir daqui, cada passo resolve uma dessas faltas.
Passo 1: sessões persistentes
O primeiro problema é a falta de estado: pergunte o que você disse antes e ele não faz ideia. A solução é guardar um histórico da conversa por usuário. Antes de chamar o modelo, o bot carrega o histórico; depois, salva a sua mensagem e a resposta. Ele lembra de você porque a conversa inteira viaja em cada chamada.
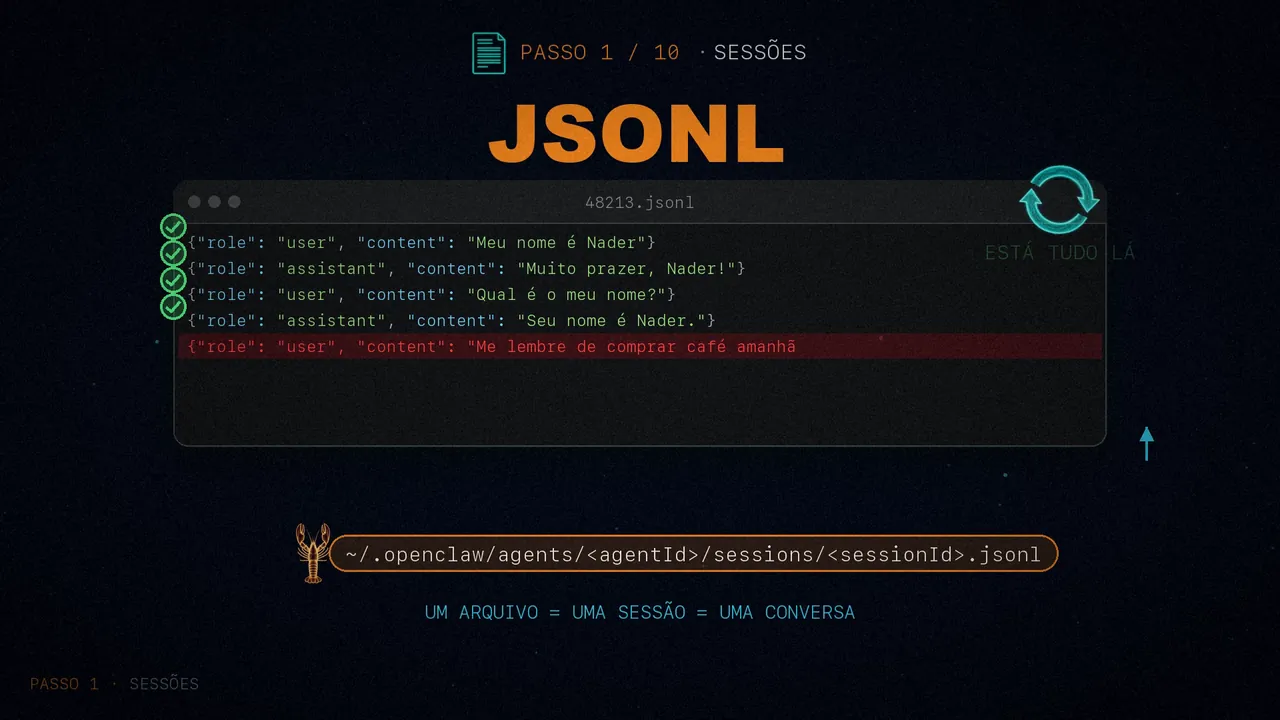
O segredo está no formato, JSONL: cada linha do arquivo é uma mensagem, e só se acrescentam linhas no final.
{"role": "user", "content": "My name is Nader"}
{"role": "assistant", "content": "Nice to meet you, Nader!"}
{"role": "user", "content": "What's my name?"}
{"role": "assistant", "content": "Your name is Nader!"}
Se o processo cair no meio de uma gravação, você perde no máximo uma linha. É exatamente o que o OpenClaw usa nas suas transcrições, um arquivo por sessão em ~/.openclaw/agents/<agentId>/sessions/<sessionId>.jsonl. Você reinicia o processo e está tudo lá.
Aqui aparece um problema que será resolvido mais adiante: as conversas crescem, e depois de algumas semanas o histórico já não cabe na janela de contexto do modelo.
Passo 2: personalidade com SOUL.md
O bot já funciona, mas é um assistente genérico. E se quiséssemos que ele fosse alguém? O OpenClaw resolve isso com um arquivo Markdown, o SOUL.md, a alma do agente, que define a identidade dele, como ele se comporta e quais são os seus limites. O do artigo se chama Jarvis:
# Who You Are

**Name:** Jarvis
**Role:** Personal AI assistant

## Personality
- Be genuinely helpful, not performatively helpful
- Skip the "Great question!" - just help
- Have opinions. You're allowed to disagree
- Be concise when needed, thorough when it matters

## Boundaries
- Private things stay private
- When in doubt, ask before acting externally
- You're not the user's voice - be careful about sending messages on their behalf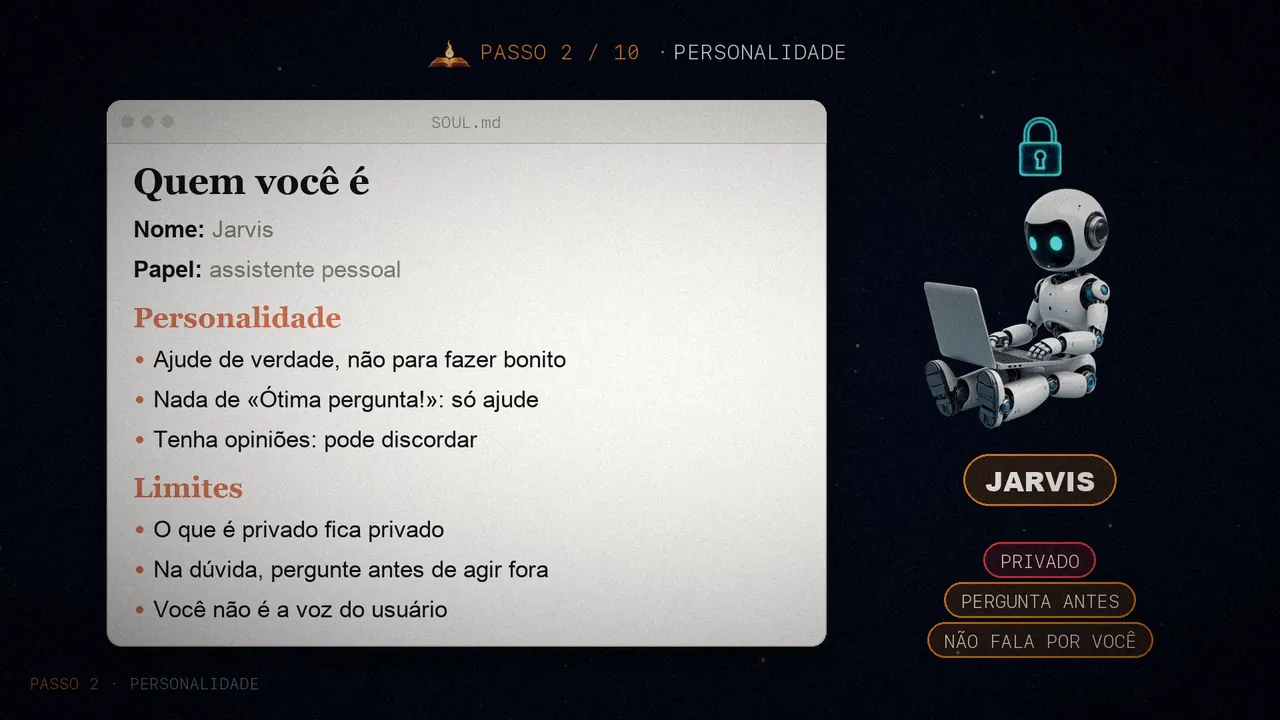
Esse texto é injetado como prompt de sistema em cada chamada ao modelo. E você pode escrever o que quiser: uma história de origem, uma filosofia, as regras dele. Quanto mais concreto, mais coerente é o agente. «Seja útil» é vago; «conciso quando precisa, minucioso quando importa; nem burocrata, nem bajulador» dá ao modelo algo com que trabalhar.
Passo 3: ferramentas e o loop do agente
Um bot que só fala não basta. A ideia é dar ao modelo ferramentas com estrutura e deixar que ele decida quando usá-las. No exemplo são quatro: run_command, read_file, write_file e web_search. Cada uma tem três partes: um nome com o seu esquema de entrada, uma descrição que explica ao modelo para que ela serve e a função que de fato a executa.
Depois vem o loop do agente: você chama o modelo com as ferramentas; se ele pedir alguma, você a executa e devolve o resultado; e chama de novo, até ele responder sem pedir mais nada.
def run_agent_turn(messages, system_prompt):
    """Run one full agent turn (may involve multiple tool calls)."""
    while True:
        response = client.messages.create(
            model=MODEL, max_tokens=4096,
            system=system_prompt, tools=TOOLS, messages=messages
        )
        content = serialize_content(response.content)

        # If the AI is done (no tool use), return the text
        if response.stop_reason == "end_turn":
            text = ""
            for block in response.content:
                if hasattr(block, "text"):
                    text += block.text
            messages.append({"role": "assistant", "content": content})
            return text, messages

        # Process tool calls
        if response.stop_reason == "tool_use":
            messages.append({"role": "assistant", "content": content})
            tool_results = []
            for block in response.content:
                if block.type == "tool_use":
                    result = execute_tool(block.name, block.input)
                    tool_results.append({
                        "type": "tool_result",
                        "tool_use_id": block.id,
                        "content": str(result)
                    })
            messages.append({"role": "user", "content": tool_results})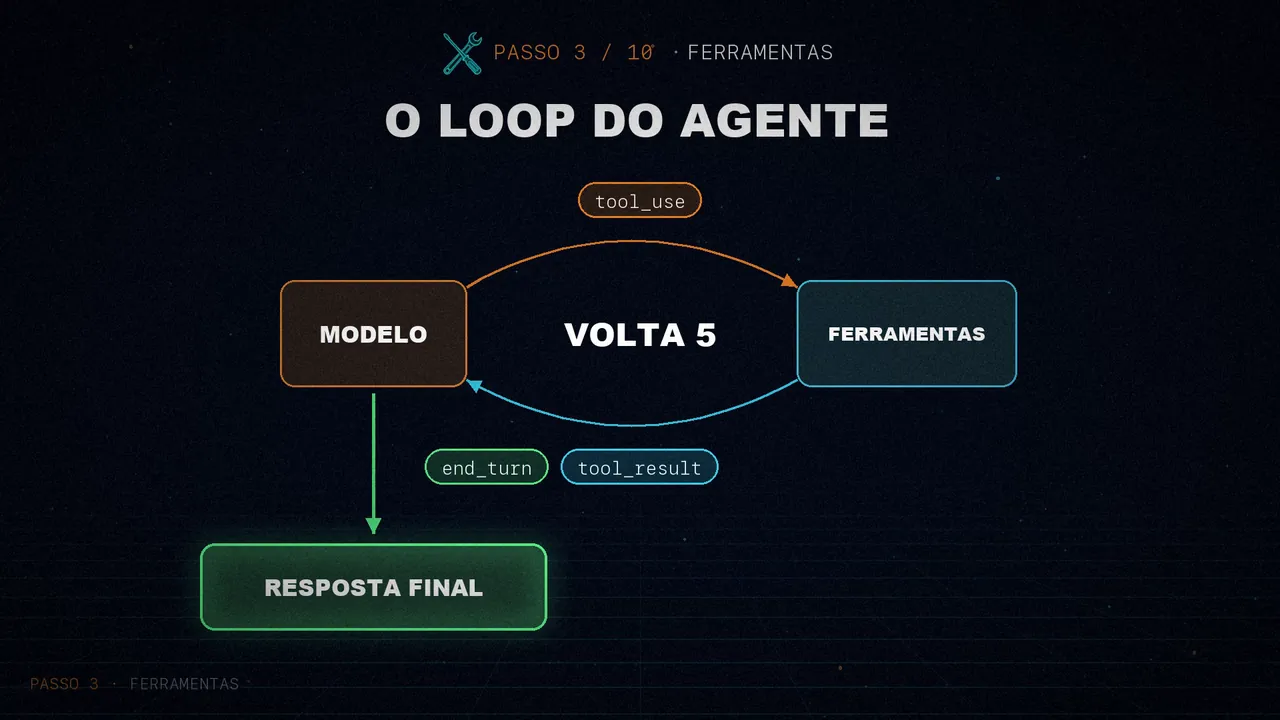
Agora você escreve no Telegram para ele criar um arquivo que imprima «olá mundo» e executá-lo. O bot escreve o arquivo, executa e te conta o que saiu. Foi ele quem decidiu quais ferramentas usar e em que ordem. O OpenClaw tem muitas outras, como o navegador ou criar subagentes, mas todas seguem esse mesmo padrão.
Passo 4: permissões
Estamos executando comandos que chegam pelo Telegram, e isso dá medo. E se alguém entrar na sua conta e pedir ao bot que apague tudo? O sistema de permissões do artigo tem três peças: uma lista de comandos seguros, alguns padrões perigosos e um arquivo com as aprovações que você já deu.
SAFE_COMMANDS = {"ls", "cat", "head", "tail", "wc", "date", "whoami", "echo"}
DANGEROUS_PATTERNS = [r"\brm\b", r"\bsudo\b", r"\bchmod\b", r"\bcurl.*\|.*sh"]
APPROVALS_FILE = "./exec-approvals.json"
Se o comando for seguro ou já tiver sido aprovado, ele roda na hora. Se não, o agente recebe um «permissão negada» e pode tentar outro caminho. A aprovação fica salva, então ele nunca te pergunta duas vezes a mesma coisa.
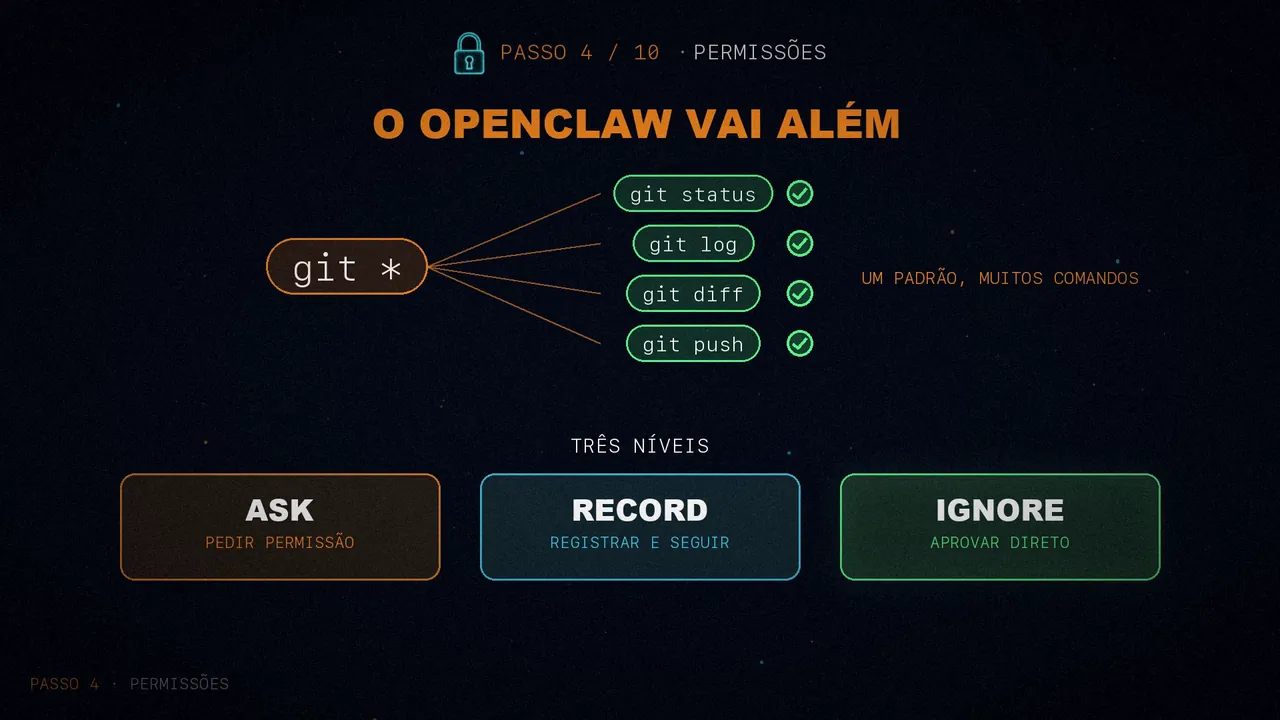
O OpenClaw vai além: aprova padrões inteiros, como git *, e tem três níveis: ask (pede a sua permissão), record (registra e segue) e ignore (aprova direto).
Passo 5: o gateway
Até agora temos um bot do Telegram. Mas e se você também o quiser no Discord, no WhatsApp e no Slack? Daria para escrever um bot por plataforma, mas cada um teria a sua sessão, a sua memória e a sua configuração, e o do Telegram não saberia nada das suas outras conversas.
A solução é um gateway: um processo central que gerencia todos os canais. E repare no que já temos: run_agent_turn não sabe nada do Telegram. Recebe mensagens e devolve texto, então a lógica do agente já está separada do canal.
Para provar isso, o artigo acrescenta uma segunda porta: uma API HTTP com Flask ao lado do bot do Telegram, as duas falando com o mesmo agente e as mesmas sessões.
# Via Telegram
You: My name is Nader
Bot: Nice to meet you, Nader!

# Via HTTP: use your Telegram user ID so it hits the same session
curl -X POST http://127.0.0.1:5000/chat \
  -H "Content-Type: application/json" \
  -d '{"user_id": "YOUR_TELEGRAM_USER_ID", "message": "What is my name?"}'

{"response": "Your name is Nader!"}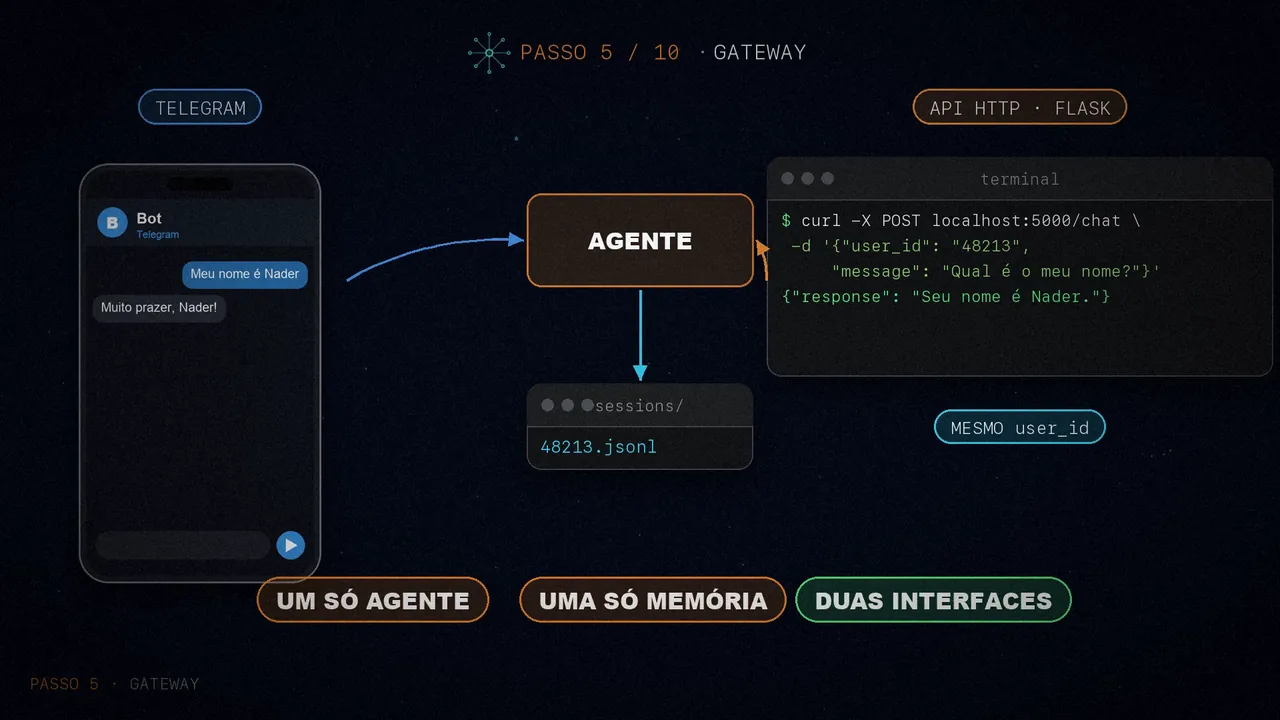
O passo seguinte é levar isso para um arquivo de configuração que diga quais canais iniciar e como se autenticar. É o que o OpenClaw faz: um único gateway para Telegram, Discord, WhatsApp, Slack, Signal, iMessage e mais, com as sessões agrupadas por usuário, por canal ou numa só, compartilhada.
Passo 6: compactação do contexto
Voltamos ao problema que deixamos anotado. Depois de semanas conversando com o bot, o histórico tem milhares de mensagens e o tamanho dele passa da janela de contexto do modelo. A solução é compactar: resumir as mensagens antigas e ficar com as recentes.
Primeiro, estimam-se os tokens com uma regra aproximada, quatro caracteres por token. Se a conversa passar de 100.000, mais ou menos 80% de uma janela de 128.000, ela é dividida em duas: a metade antiga vai para o modelo resumir, e a recente fica como está.
def estimate_tokens(messages):
    """Rough token estimate: ~4 chars per token."""
    return sum(len(json.dumps(m)) for m in messages) // 4

def compact_session(user_id, messages):
    """Summarize old messages when context gets too long."""
    if estimate_tokens(messages) < 100_000:  # ~80% of a 128k window
        return messages  # No compaction needed

    split = len(messages) // 2
    old, recent = messages[:split], messages[split:]
    ...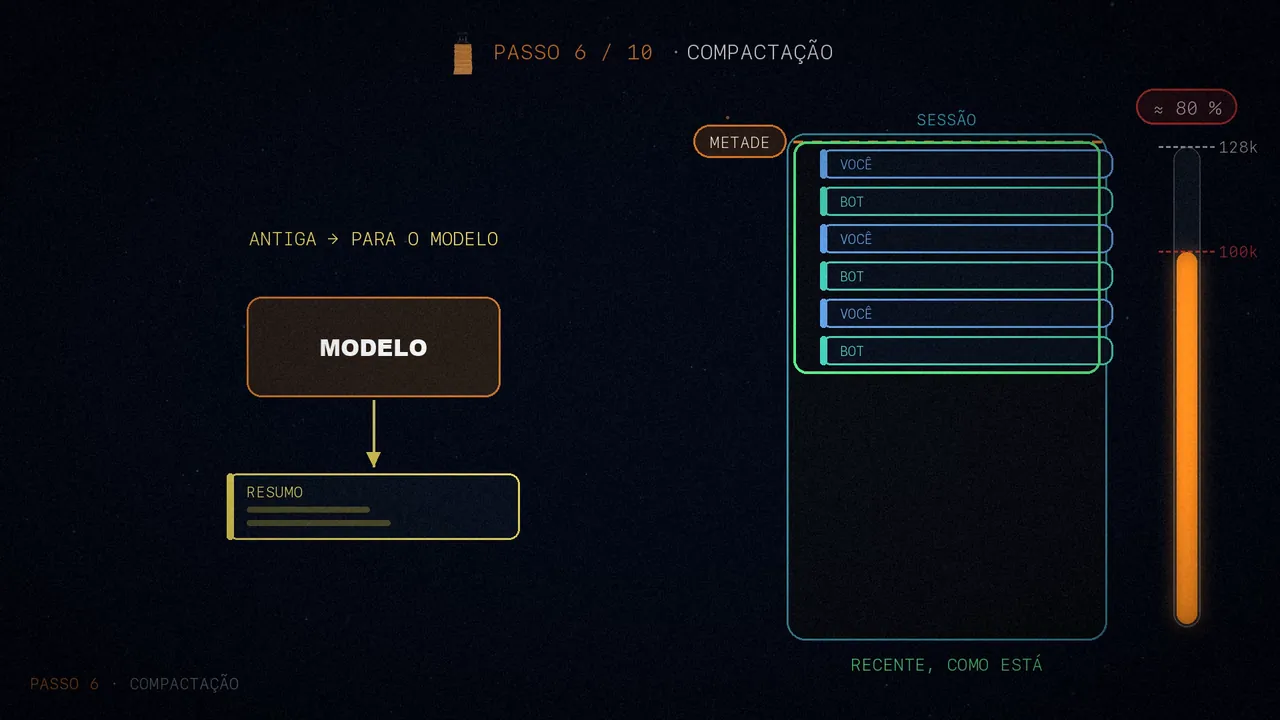
O resumo precisa guardar o que importa: os dados do usuário, como o nome ou as preferências, as decisões tomadas e as tarefas pendentes. Esse resumo substitui todas as mensagens velhas, de modo que o bot continua lembrando do essencial e o arquivo fica bem menor. Para testar sem passar horas conversando, baixe o limite para 1.000 tokens.
A compactação do OpenClaw é mais refinada: divide as mensagens em blocos de acordo com os tokens, resume cada bloco separadamente e deixa uma margem de segurança, porque a estimativa nunca é exata. Mas a ideia é a mesma.
Passo 7: memória de longo prazo
O histórico é a memória da conversa, mas se você reiniciar a sessão ou começar outra, tudo some. É preciso uma memória à parte, que sobreviva às reinicializações. A ideia: mais duas ferramentas, save_memory e memory_search, sobre arquivos Markdown em uma pasta.
You: Remember that my favorite restaurant is Elvies and I prefer to go on weekends.

Bot: [uses save_memory to write nader-profile.md]
     Got it — saved your restaurant preference.

[Reset the session or restart the bot]

You: Where should we go for dinner?

Bot: [uses memory_search for "restaurant dinner favorite"]
     How about Elvies? I know it's your favorite. Want to go this weekend?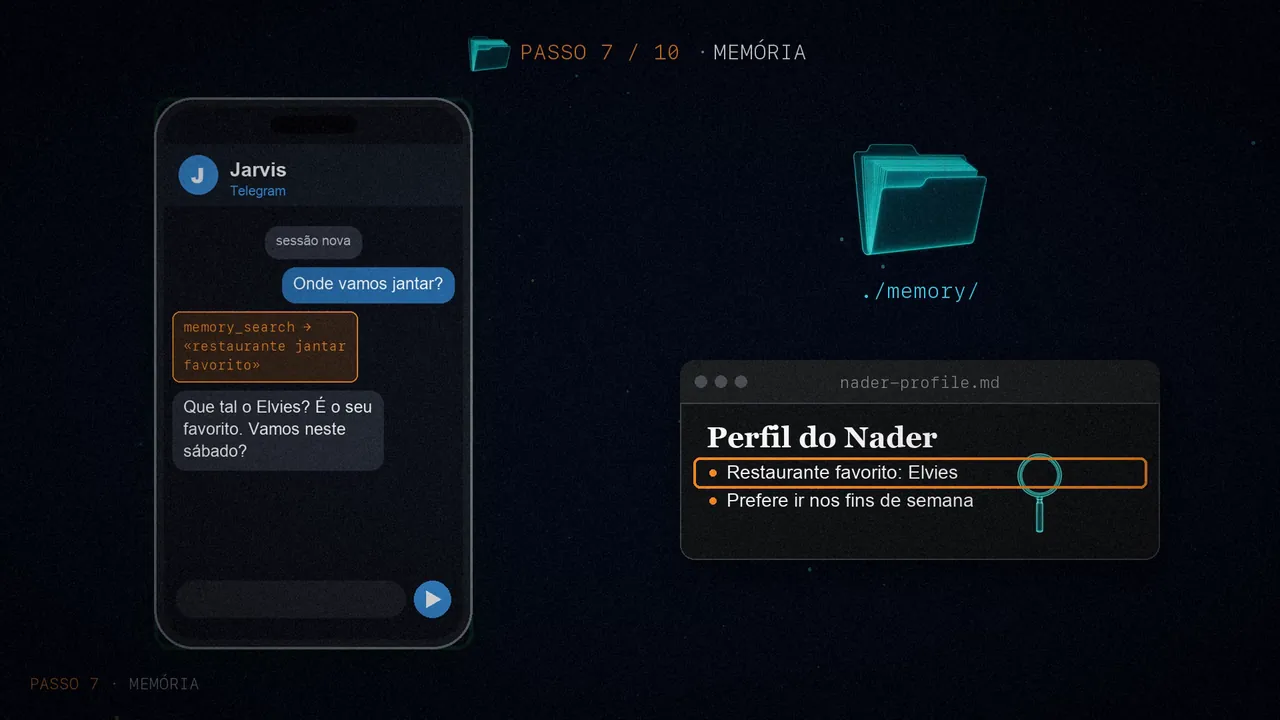
Funciona porque a memória está em arquivos. A nossa busca é por palavras-chave, e isso basta para começar. O OpenClaw usa busca vetorial com embeddings, que encontra pelo significado: assim, «auth bug» encontra «authentication issues».
Passo 8: a fila de comandos
Este passo resolve um problema sutil, mas crítico: o que acontece se duas mensagens chegarem ao mesmo tempo? Você pede pelo Telegram que ele olhe a sua agenda e, ao mesmo tempo, pela web, como está o tempo. Ambas carregam a mesma sessão, escrevem nela, e o arquivo acaba corrompido.
A solução é simples: uma trava por sessão. Só uma mensagem é processada de cada vez em cada sessão. As mensagens do mesmo usuário entram na fila, enquanto usuários diferentes rodam em paralelo.
session_locks = defaultdict(threading.Lock)

async def handle_message(update: Update, context):
    user_id = str(update.effective_user.id)

    with session_locks[user_id]:
        messages = load_session(user_id)
        messages = compact_session(user_id, messages)
        messages.append({"role": "user", "content": update.message.text})

        response_text, messages = run_agent_turn(messages, SOUL)

        save_session(user_id, messages)

    await update.message.reply_text(response_text)
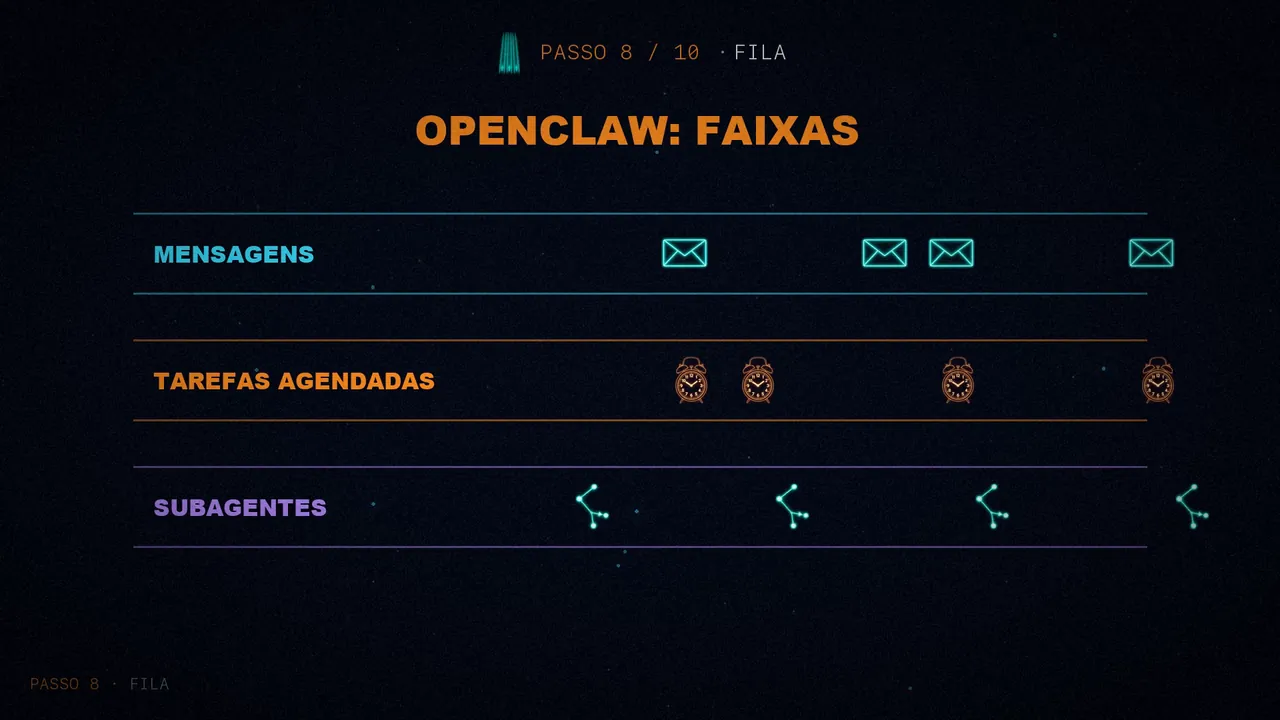
O OpenClaw amplia isso com faixas separadas para as mensagens, as tarefas agendadas e os subagentes.
Passo 9: batimentos (tarefas agendadas)
Até agora o agente só responde quando você fala com ele. E se você quiser que ele olhe o seu e-mail toda manhã, ou que resuma a sua agenda antes das reuniões? Você precisa de batimentos (heartbeats): tarefas que acordam o agente com um temporizador. O exemplo do artigo é um resumo matinal, todos os dias às 7h30:
def morning_briefing():
    # Use an isolated session key so cron doesn't pollute main chat
    session_key = "cron:morning-briefing"

    with session_locks[session_key]:
        messages = load_session(session_key)
        messages.append({
            "role": "user",
            "content": "Good morning! Check today's date and give me a motivational quote."
        })
        response_text, messages = run_agent_turn(messages, SOUL)
        save_session(session_key, messages)

schedule.every().day.at("07:30").do(morning_briefing)
O importante é que cada batimento usa a própria sessão (cron:morning-briefing), para não encher de ruído a sua conversa principal. E chama a mesma run_agent_turn: é só mais uma mensagem, mas disparada por um relógio em vez de uma pessoa.
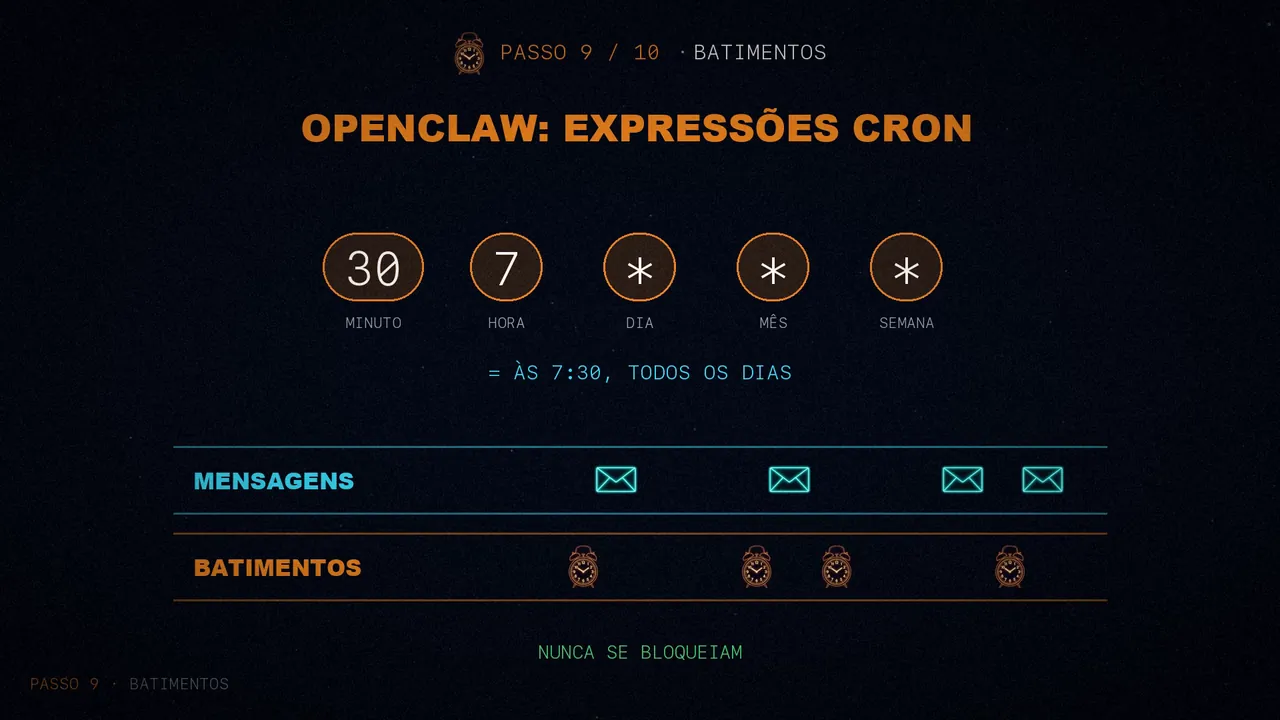
O OpenClaw aceita expressões cron completas, como 30 7 * * *, e dá a elas a própria faixa, para que nunca bloqueiem as mensagens em tempo real.
Passo 10: vários agentes
Com mais tarefas, uma só personalidade e um só conjunto de ferramentas não dão conta de tudo: um assistente de pesquisa precisa de instruções diferentes das de um geral. A solução são várias configurações de agente, cada uma com a sua alma e a sua sessão, e um roteador que escolhe para quem vai cada mensagem.
No exemplo há dois: Jarvis, o assistente geral, e Scout, especialista em pesquisa, que precisa citar fontes para cada afirmação.
def resolve_agent(message_text):
    """Route messages to the right agent based on prefix commands."""
    if message_text.startswith("/research "):
        return "researcher", message_text[len("/research "):]
    return "main", message_text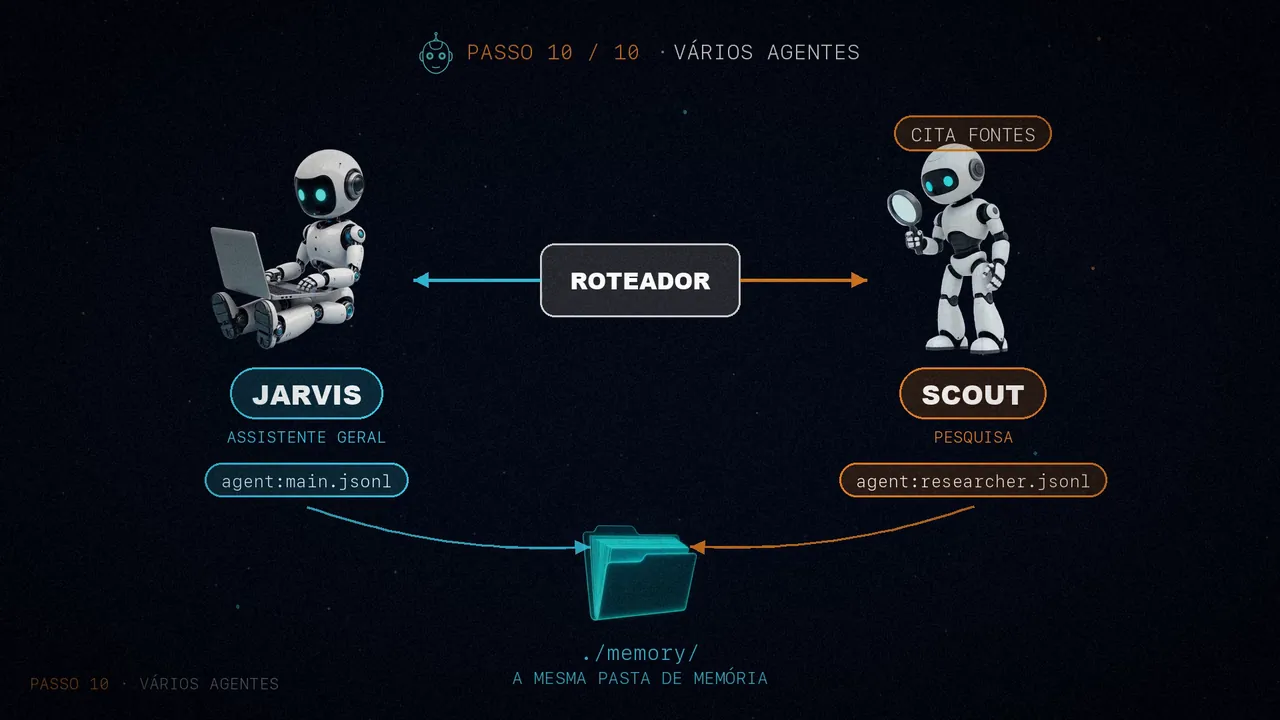
Cada um tem a própria conversa, mas os dois compartilham a mesma pasta de memória, e isso permite que colaborem. Você pede ao Scout que pesquise boas práticas de programação assíncrona em Python; ele busca na web e salva o que encontra. Depois, você pergunta ao Jarvis o que o Scout encontrou, e ele busca nessa memória. Sem mensagens diretas entre eles: só arquivos compartilhados.
O OpenClaw amplia isso com subagentes e mensagens entre agentes, mas o padrão de fundo é o mesmo: cada agente não passa de uma alma, uma sessão e algumas ferramentas.
Tudo junto: mini OpenClaw
O artigo junta tudo em um único programa, o mini-openclaw.py: um console interativo de umas 400 linhas de Python com sessões, alma, ferramentas, permissões, compactação, memória, fila, tarefas agendadas e vários agentes. Conferi no código dele: é um console, então dos dez passos só falta o gateway.
Na sessão de exemplo, você pede que ele lembre do seu restaurante favorito e ele salva; pergunta o que há na pasta do seu projeto e ele executa um comando para ver; reinicia a sessão e, ao perguntar onde você gosta de comer, ele lembra.
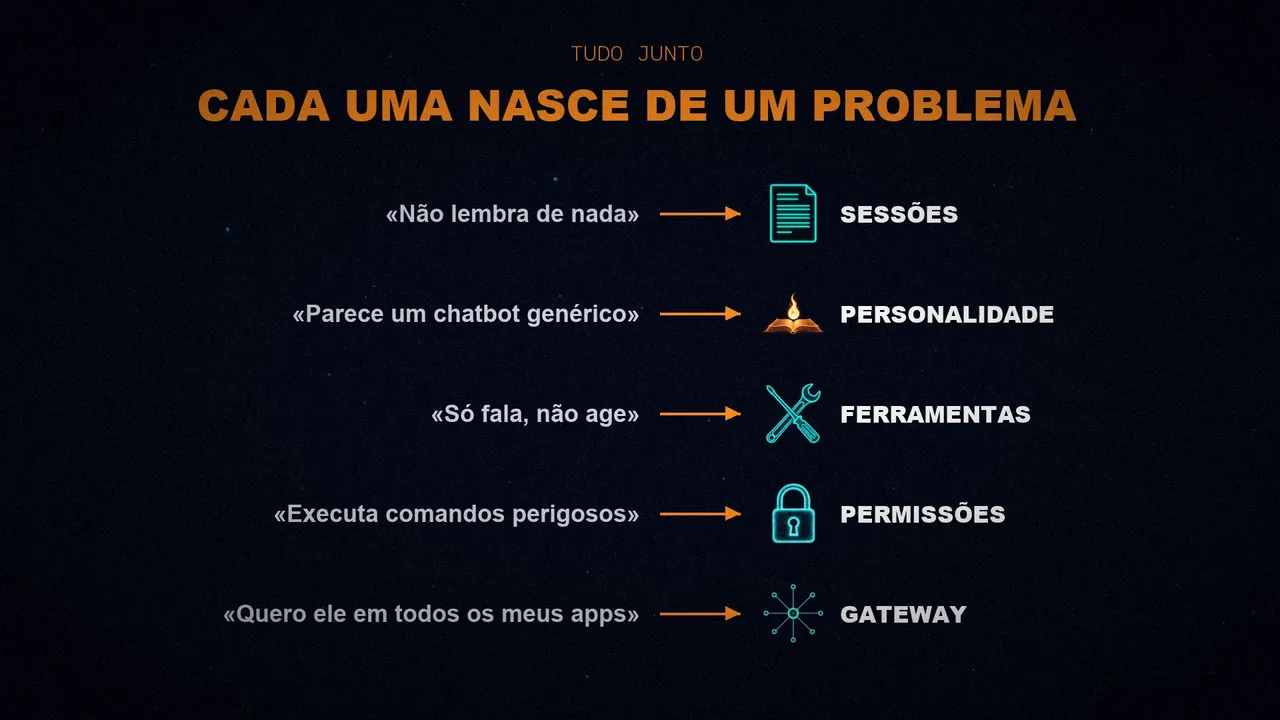
O bonito é que nenhuma peça é arbitrária. Cada uma nasceu de um problema prático:
- «Não lembra de nada» → sessões.
- «Parece um chatbot genérico» → SOUL.md.
- «Só fala, não age» → ferramentas e loop do agente.
- «Executa comandos perigosos» → permissões.
- «Quero ele em todos os meus aplicativos» → gateway.
- «A conversa ficou longa demais» → compactação.
- «Esquece as coisas entre as sessões» → memória.
- «Duas mensagens ao mesmo tempo corrompem os dados» → fila de comandos.
- «Quero que ele faça coisas sozinho» → batimentos.
- «Um agente não faz tudo bem» → vários agentes.
Indo além: o OpenClaw em produção
O protótipo cobre a arquitetura básica. O artigo termina com cinco ideias de como o OpenClaw leva isso para produção, e vale a pena vê-las.
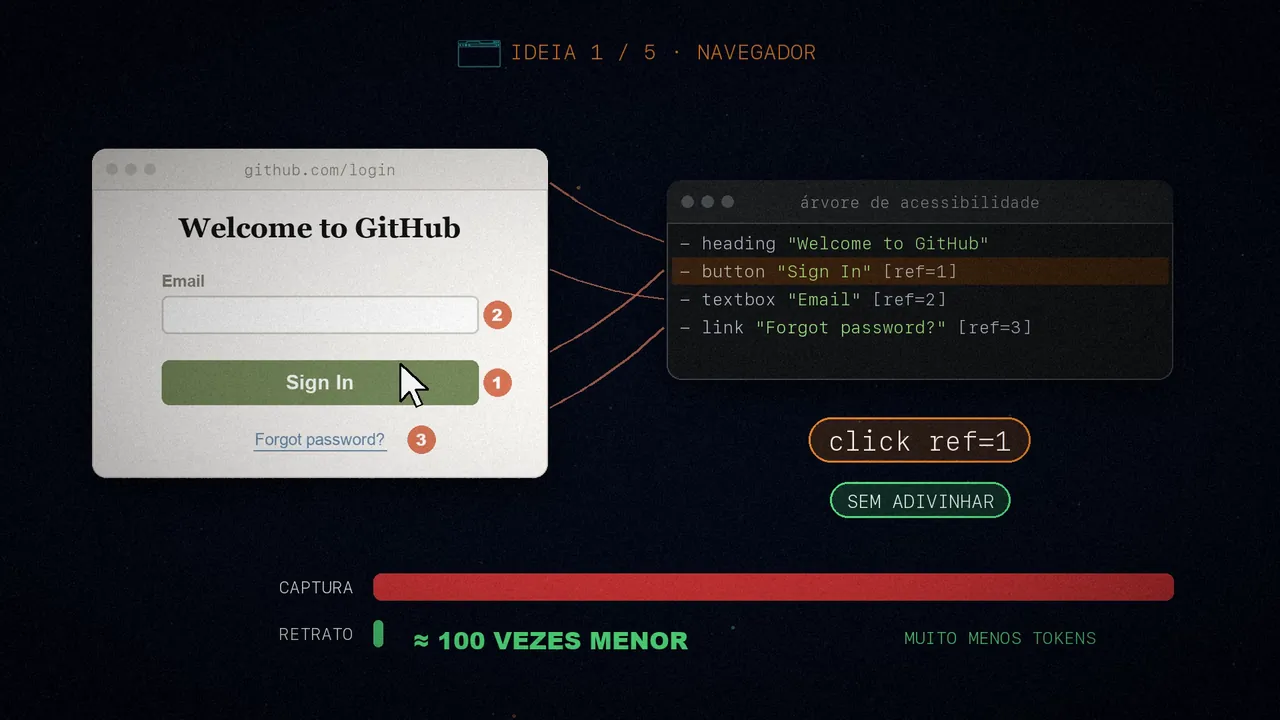
1. Um navegador com retratos semânticos
O OpenClaw dá ao agente um navegador com Playwright, mas em vez de mandar capturas de tela, de uns 5 MB cada, manda um retrato semântico (semantic snapshot), uma versão em texto da árvore de acessibilidade da página:
snapshot = page.accessibility.snapshot()
# - heading "Welcome to GitHub"
# - button "Sign In" [ref=1]
# - textbox "Email" [ref=2]
# - link "Forgot password?" [ref=3]
Cada elemento com que dá para interagir recebe um número. Quando o agente quer clicar em algo, ele diz click ref=1. Sem adivinhar, e umas cem vezes menor que uma captura, então gasta muito menos tokens.
2. O escopo das sessões
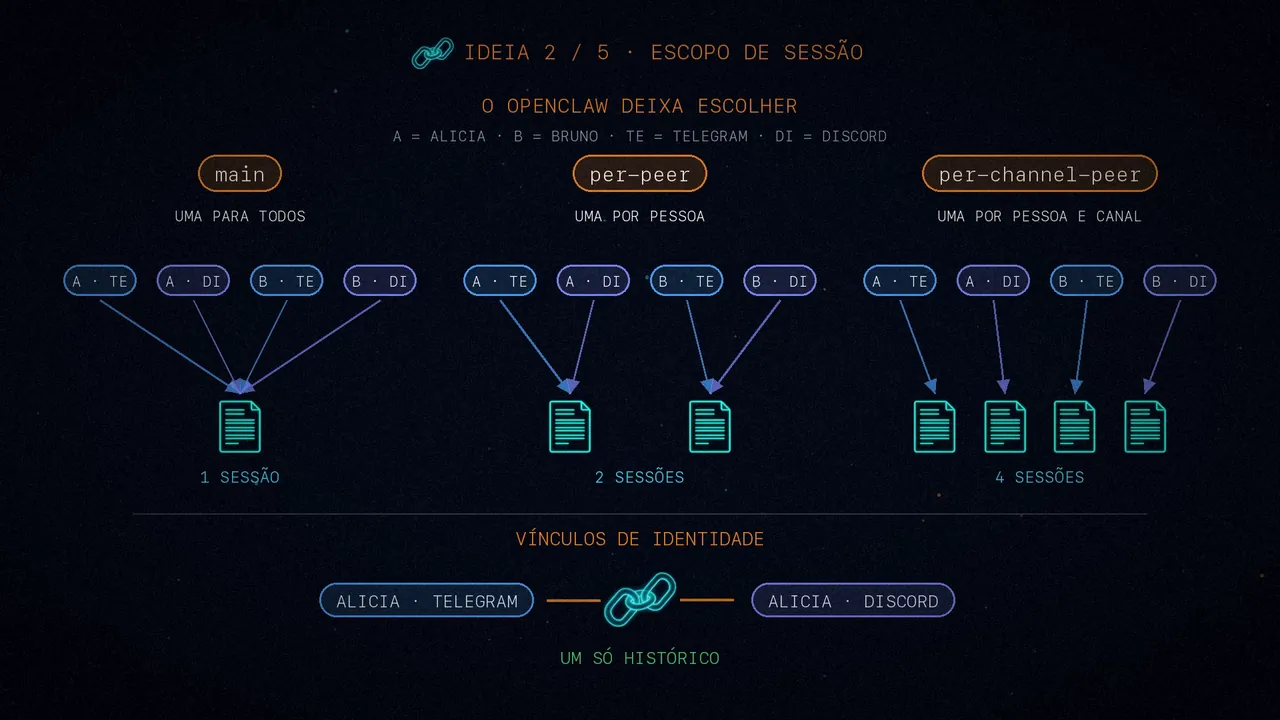
O nosso protótipo usa o usuário como chave. O OpenClaw deixa escolher: main (uma só sessão para todas as mensagens diretas), per-peer (uma para cada pessoa em todos os canais) ou per-channel-peer (uma por pessoa e canal). E com os vínculos de identidade, o que a Alice fala pelo Telegram e pelo Discord compartilha o mesmo histórico.
3. Os canais como plugins
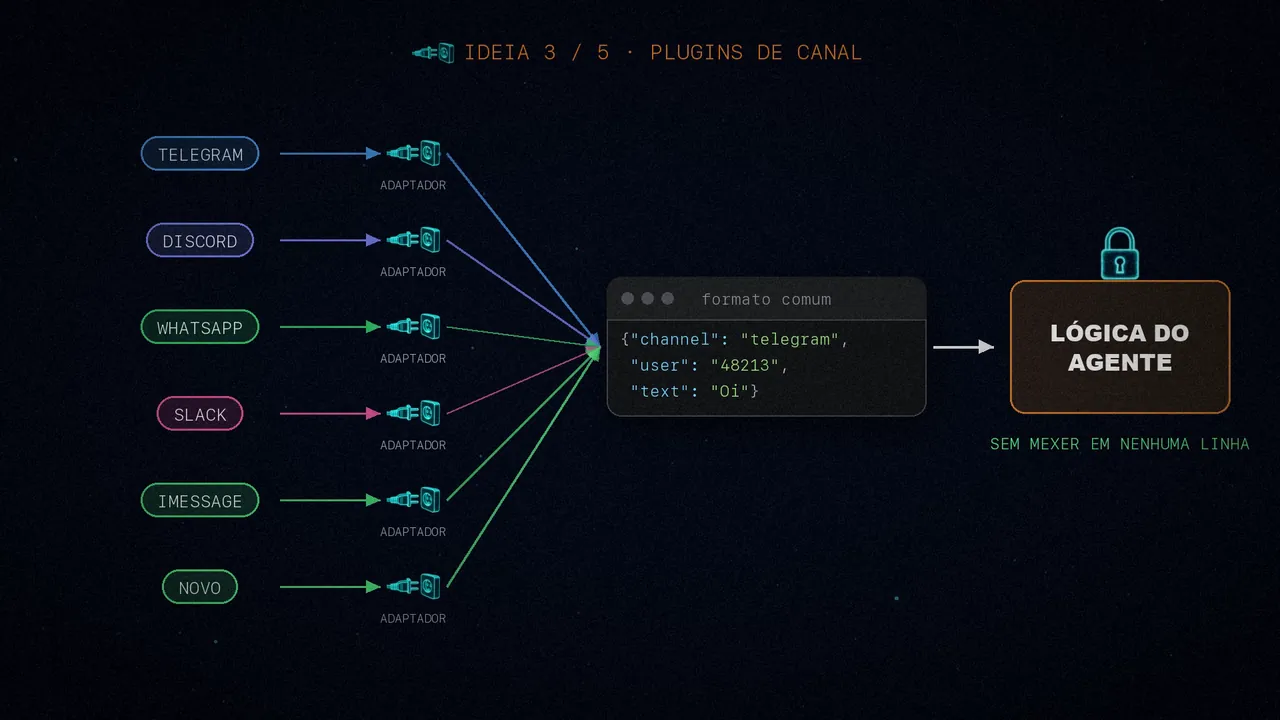
Cada canal, do Telegram ao iMessage, é um adaptador que traduz as mensagens para um formato comum. Para acrescentar um canal novo, basta escrever o adaptador dele, sem mexer em nenhuma linha da lógica do agente.
4. Uma memória híbrida
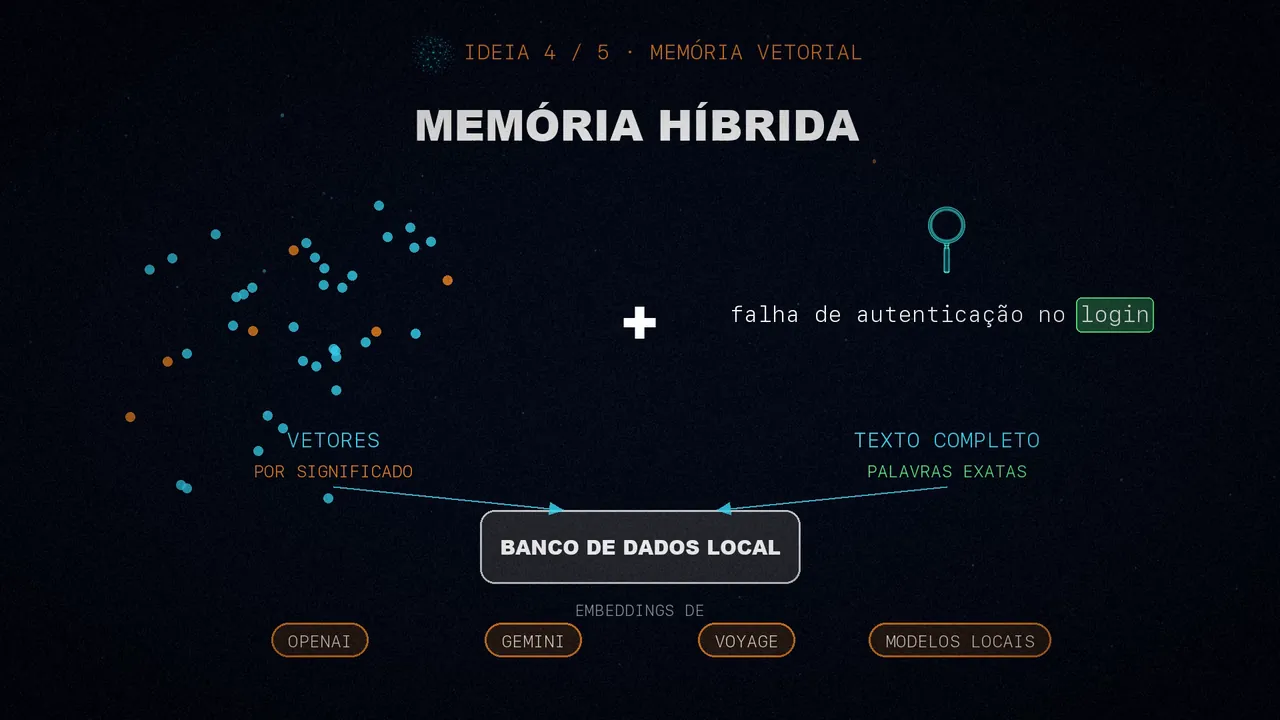
Combina vetores, que encontram pelo significado, com um índice de texto completo (FTS5) para as palavras exatas. Tudo em um banco de dados local, SQLite, e com embeddings da OpenAI, do Gemini, da Voyage ou de modelos locais.
5. Subagentes
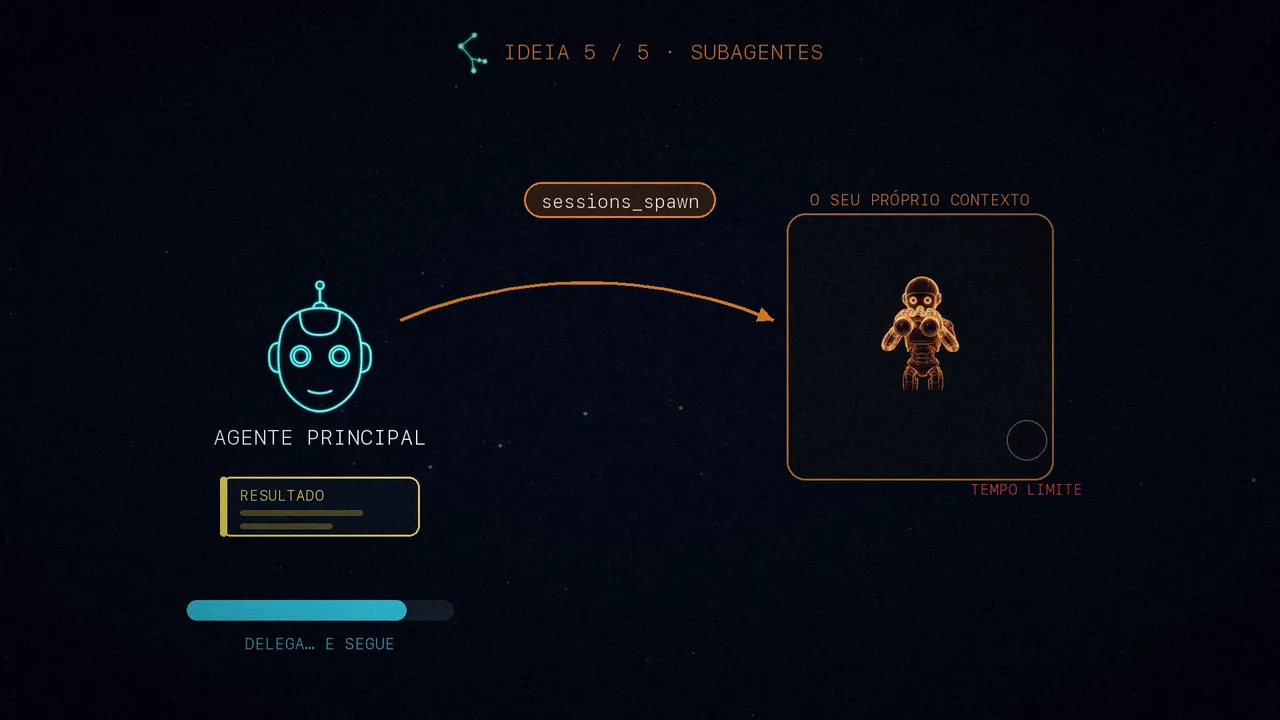
No nosso protótipo, o roteamento é manual. No OpenClaw, um agente pode criar outro por conta própria com sessions_spawn. O filho trabalha no próprio contexto, com um tempo limite, e devolve o resultado ao pai. Assim, o principal delega uma pesquisa a fundo e segue quando o especialista termina.
Se você quer construir o seu
O conselho do artigo é ir aos poucos:
- Comece com um único canal: um bot do Telegram ou do Discord com sessões.
- Acrescente ferramentas uma de cada vez: primeiro ler e escrever arquivos, depois o terminal.
- Some a memória quando precisar: assim que as sessões reiniciarem, você vai querer.
- Acrescente canais quando um não bastar: o gateway surge naturalmente.
- Acrescente agentes quando as tarefas se especializarem: melhor dois do que dez.
Ou use direto o OpenClaw, que é de código aberto e resolve os casos-limite. Mas agora você já sabe como ele funciona por dentro.
Resumindo
Um assistente persistente é um loop de agente cercado de peças simples: sessões, uma alma, ferramentas, permissões, um gateway, memória e tarefas agendadas.
Nenhuma peça é mágica: cada uma resolve um problema concreto.
Que peça você acrescentaria ao seu assistente?
Fontes
- «You Could've Invented OpenClaw», de Nader Dabit (@dabit3), fevereiro de 2026.
- O vídeo, nos meus três canais: espanhol, inglês e português.