El examen: LongMemEval
LongMemEval mide la memoria a largo plazo de los asistentes de chat. Su versión S tiene 500 preguntas, y antes de cada una el sistema lee un pajar de unas cincuenta sesiones de conversación; la respuesta está escondida en alguna de ellas. En total son unos 57 millones de tokens, unos 115.000 por pregunta.
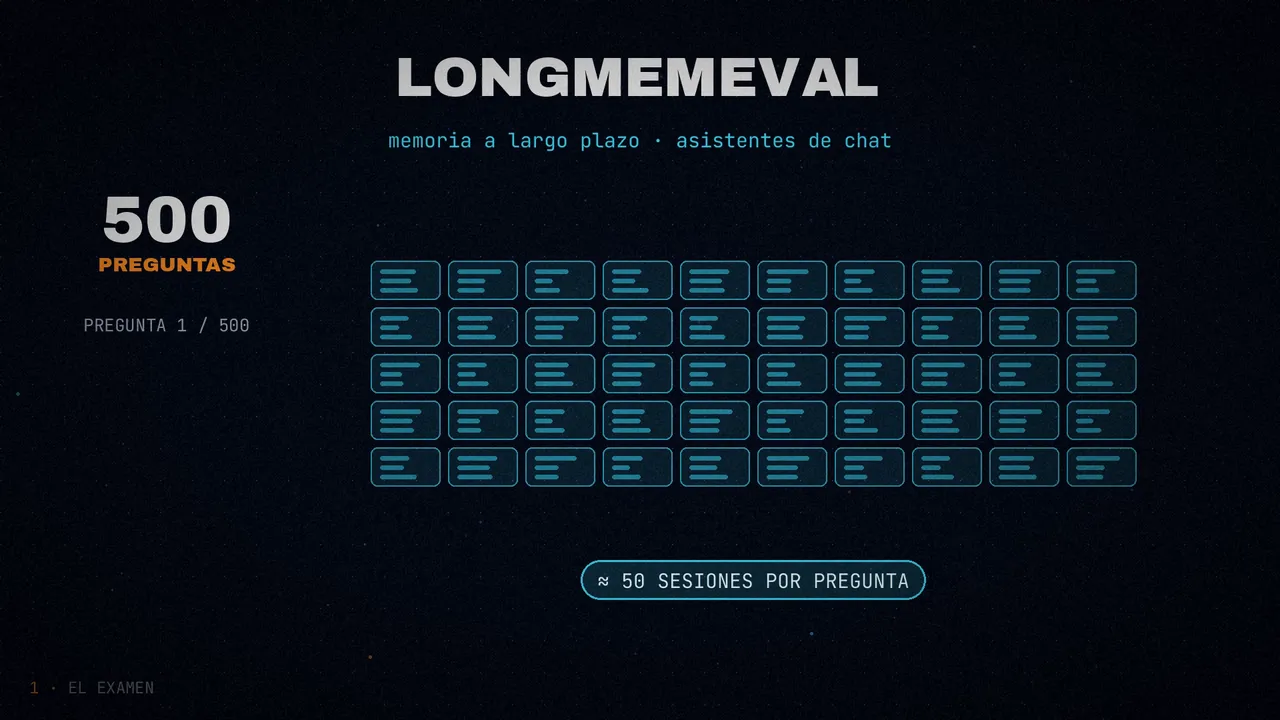
Las preguntas son de seis tipos. Tres miran una sola sesión: algo que dijo el usuario, algo que respondió el asistente y una preferencia mencionada de pasada. Las otras tres son más difíciles: juntar datos de varias sesiones, saber cuál es la versión actual de algo que cambió y razonar con fechas («¿cuánto hace que pasó?»).
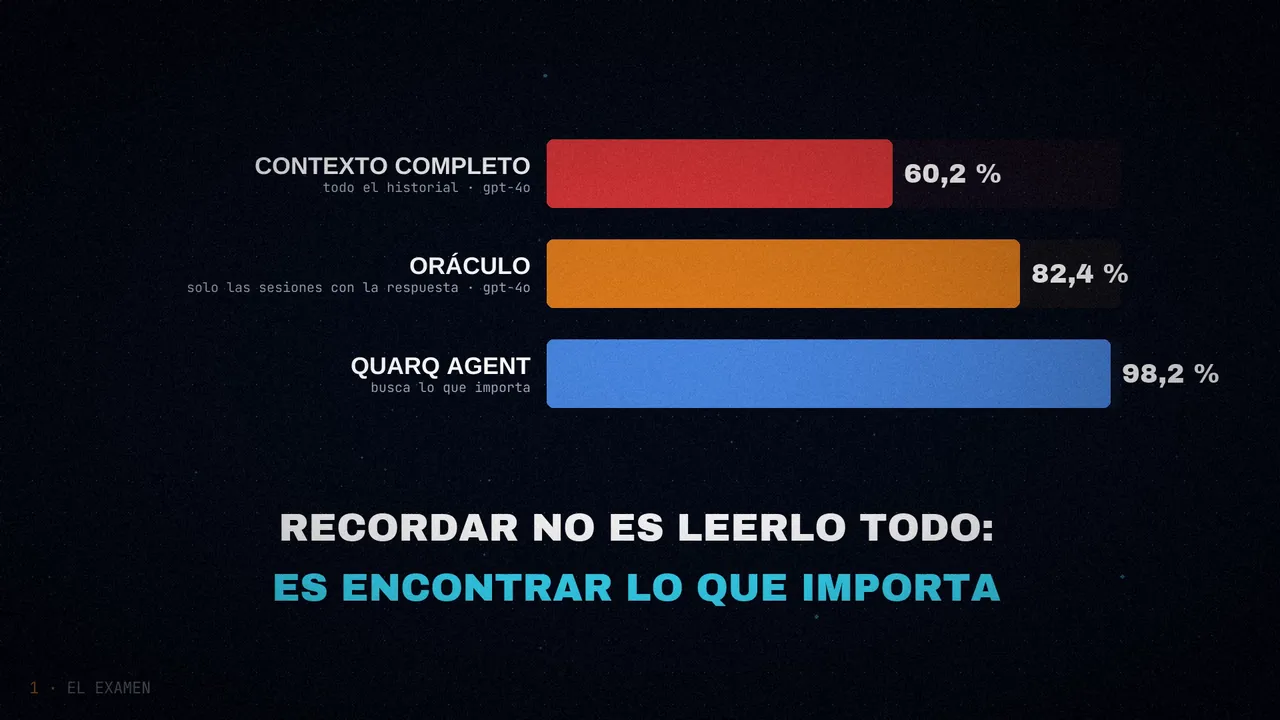
¿Y por qué no meter toda la conversación en el contexto y listo? Porque no funciona. En la tabla del artículo, GPT-4o con todo el historial delante acierta solo el 60,2 %; si le das únicamente las sesiones que contienen la respuesta (el «oráculo»), el 82,4 %. Recordar no es leerlo todo: es encontrar lo que importa.
Los resultados
Quarq Agent acierta 491 de las 500 preguntas: solo falla nueve. Es el 98,2 %. Y lo consigue con la memoria en tu propio ordenador: un índice de vectores FAISS en local y una arquitectura de memoria por capas.
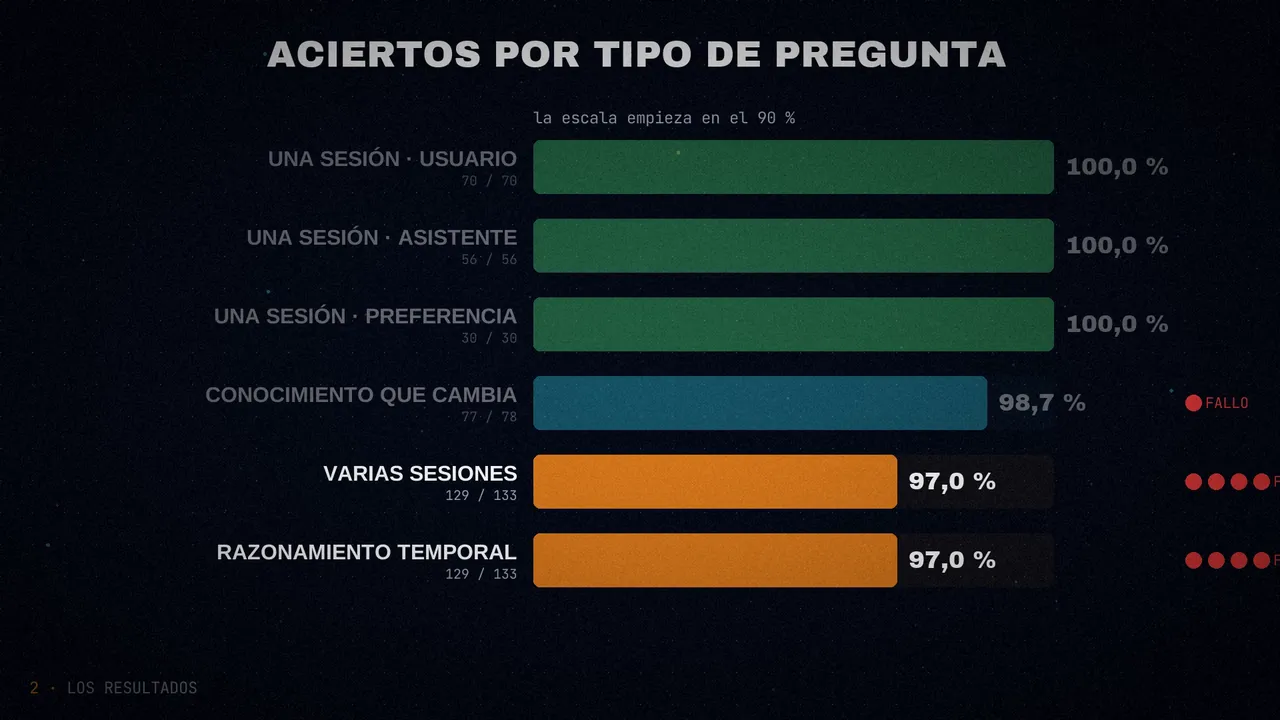
Por tipos, las tres categorías de una sola sesión llegan al 100 %. La de conocimiento que se actualiza, al 98,7 %, con un solo fallo. Y las dos más difíciles, varias sesiones y razonamiento temporal, se quedan en el 97 %, con cuatro fallos cada una.
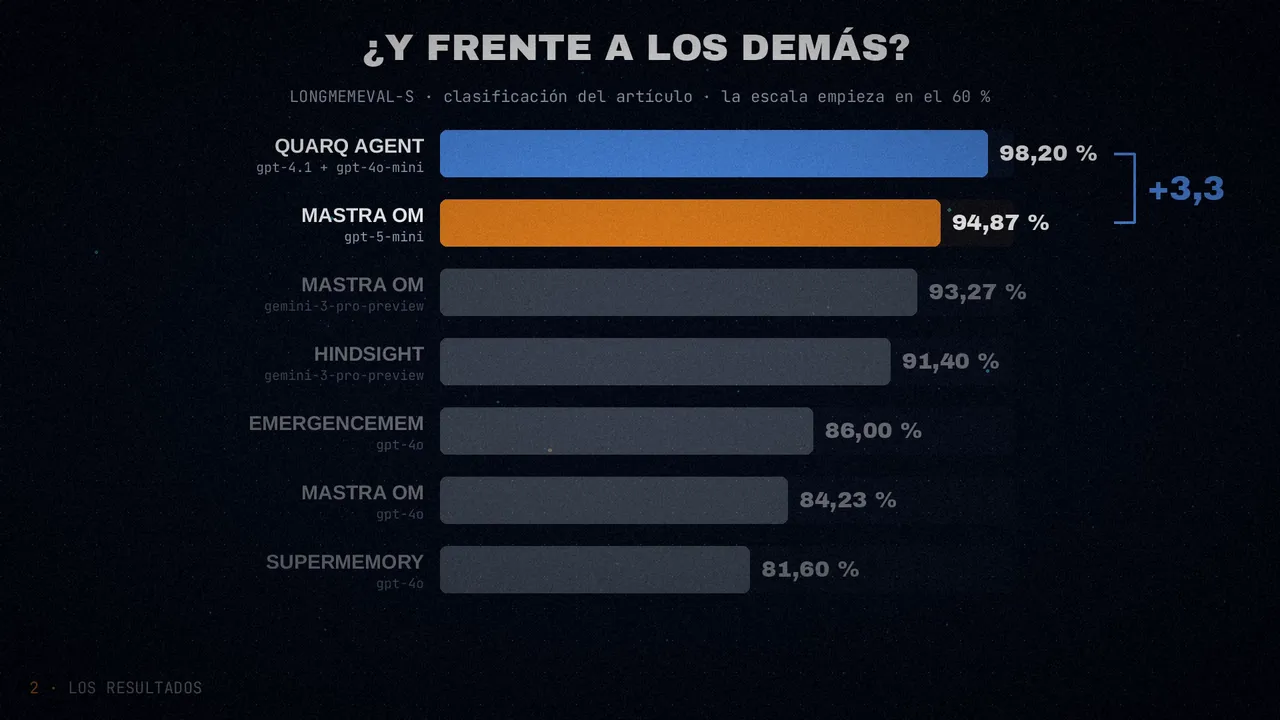
En la clasificación que publican, el segundo es Mastra (con GPT-5 mini), con el 94,87 %, y le sigue Hindsight (con Gemini 3 Pro), con el 91,4 %. Varios sistemas con GPT-4o se quedan entre el 81,6 y el 86 %. Quarq les saca 3,3 puntos.
El artículo destaca tres cosas. Primero, su generador (GPT-4.1) es menos capaz que los modelos más recientes que usan muchos rivales. Además, el razonamiento temporal es la categoría más difícil, y su protocolo ataca el fallo más común: confundir cuándo se guardó un dato con cuándo ocurrió. Y por último, todo funciona en local, mientras casi todos los demás dependen de bases de vectores en la nube.
Con cautela
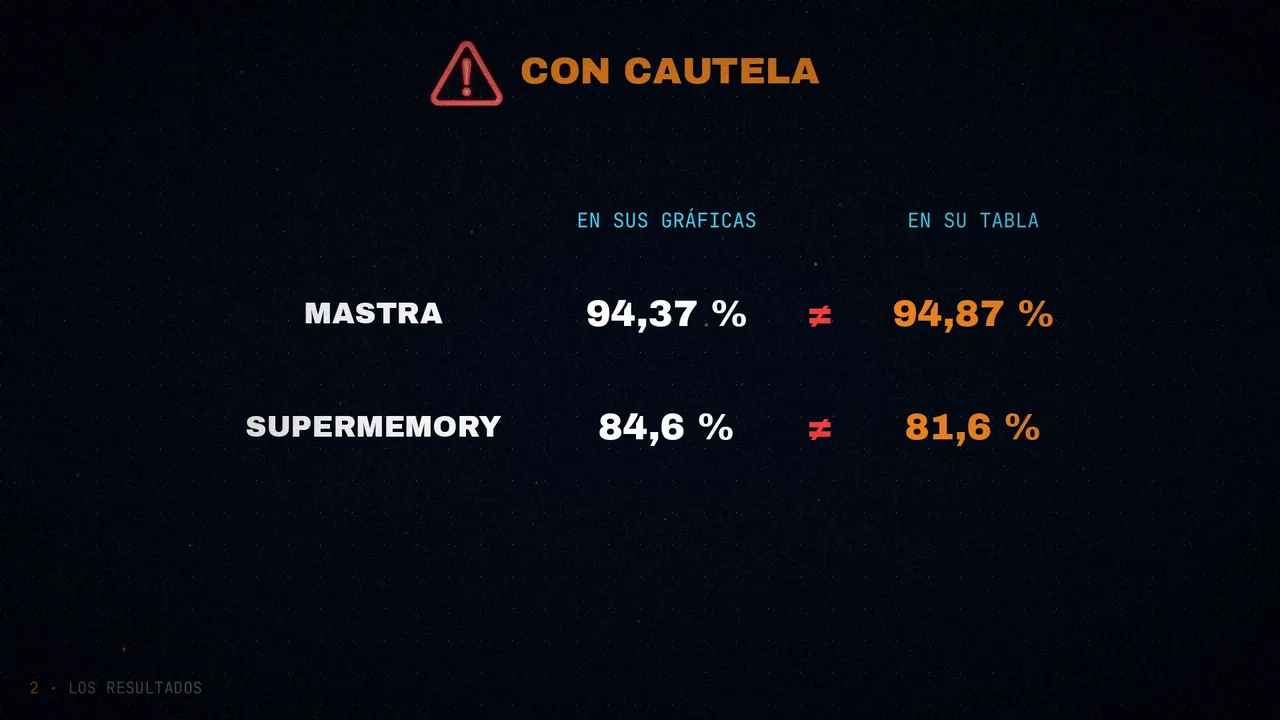
Conviene tomar la comparación con cautela. Cada equipo monta su propia evaluación, con su juez y sus modelos: Quarq juzga las respuestas con GPT-5. Y en las gráficas del propio artículo, las cifras de algunos rivales no coinciden del todo con las de su tabla: Mastra sale con un 94,37 % en una y un 94,87 % en la otra, y Supermemory con un 84,6 % frente a un 81,6 %.
Ellos mismos avisan de que el resultado es provisional: puede cambiar al repetir las preguntas dudosas a medida que añaden arreglos.
La memoria en tres capas
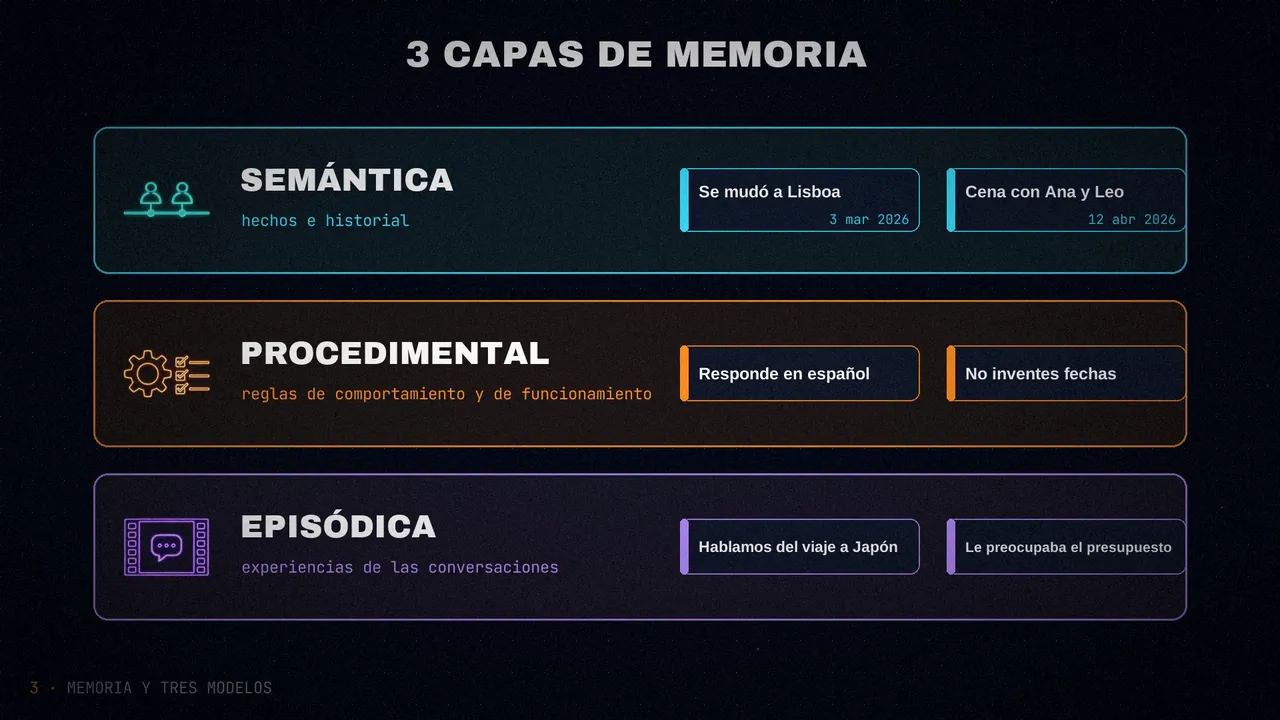
Por dentro, la memoria tiene tres capas:
- Semántica: hechos e historial de las interacciones, qué pasó, cuándo y quién estaba.
- Procedimental: reglas de comportamiento y de funcionamiento.
- Episódica: experiencias de las conversaciones, con su contexto.
Tres modelos en vez de uno
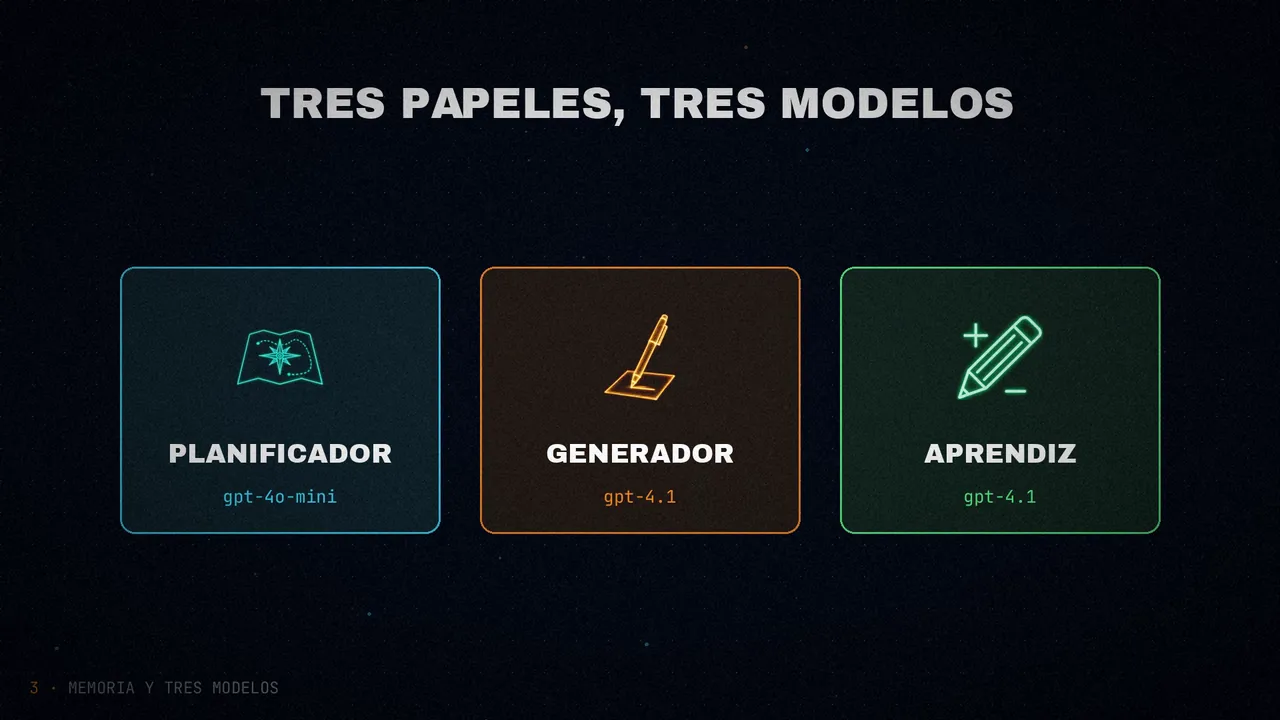
La mayoría de los sistemas de memoria usan un solo modelo de lenguaje para todo: buscar, responder y gestionar la memoria. Es como un hombre orquesta, que toca todos los instrumentos a la vez y ninguno del todo bien. Quarq reparte esas tareas en tres papeles, cada uno con su modelo:
Un modelo pequeño y barato. Antes de cada búsqueda prepara una estrategia: reescribe la pregunta de varias formas parecidas, saca las palabras clave y elige un modo de búsqueda según lo compleja que sea.
Recibe los recuerdos encontrados, las reglas procedimentales y el historial de la conversación, y se dedica únicamente a escribir la respuesta.
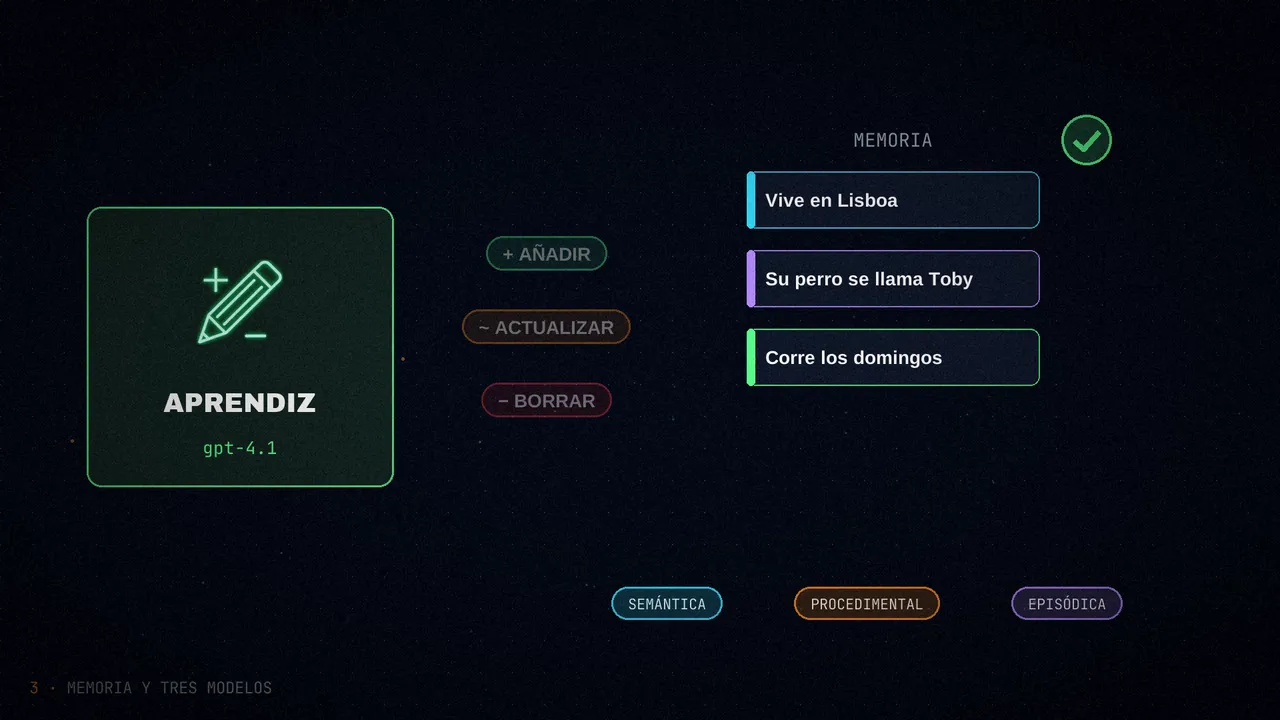
No vuelca texto en bruto en la memoria: hace ediciones concretas. Añade hechos nuevos, actualiza los que se han quedado viejos y borra las contradicciones, viendo lo que hay en las otras capas para no duplicar nada.
Buscar bien: HyDE y la búsqueda híbrida
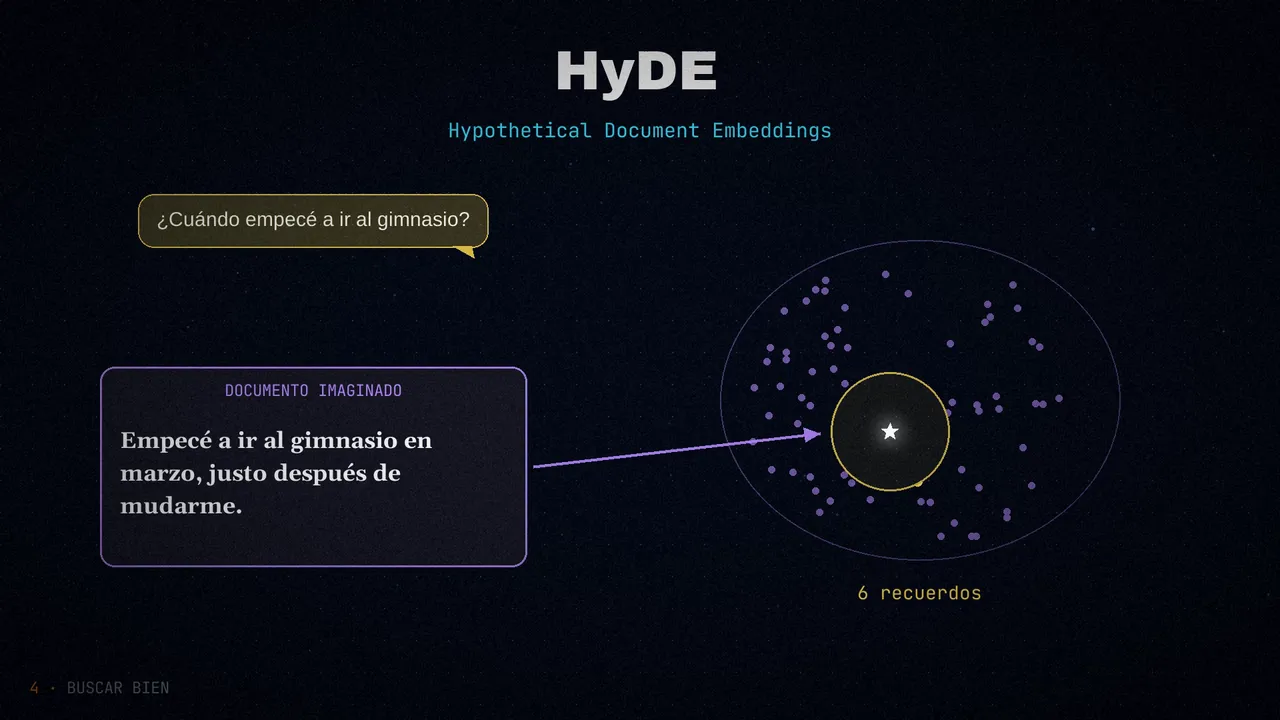
El planificador usa HyDE (Hypothetical Document Embeddings): en lugar de buscar con la pregunta tal cual, imagina cómo sería un documento que la respondiera y busca con eso. Es como el retrato robot de la policía: no tienes la foto del sospechoso, pero un dibujo aproximado ayuda a encontrarlo entre la gente.
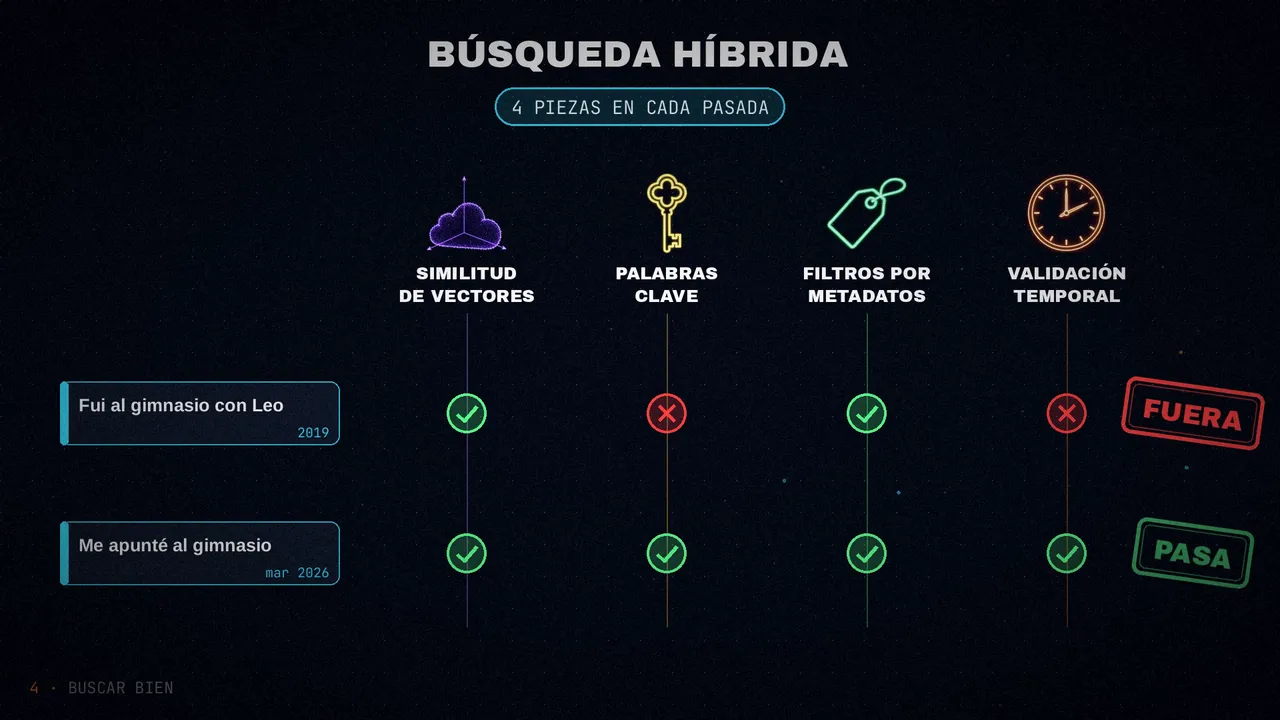
Cada pasada de búsqueda combina cuatro piezas: similitud de vectores, palabras clave, filtros por metadatos y una validación temporal. Parecerse en el significado no basta: el recuerdo también tiene que contener lo que importa y encajar en el tiempo.
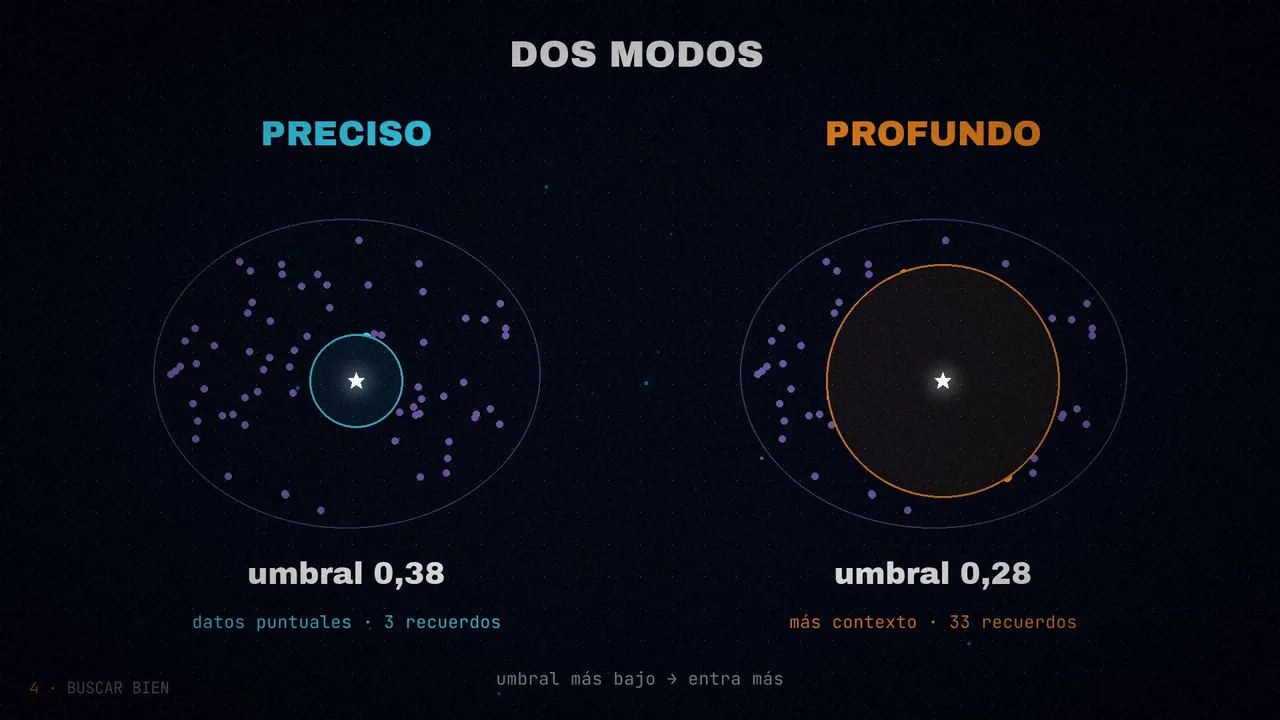
Y hay dos modos. El preciso usa un umbral de similitud de 0,38, para datos puntuales. El profundo lo baja a 0,28, para recordar con más contexto. Es la diferencia entre pescar con caña y echar la red.
Una búsqueda que se corrige sola
¿Y si lo que encuentra no basta? Cuando la primera búsqueda no da pruebas suficientes para responder con seguridad, el generador puede pedir otra. El sistema lanza entonces búsquedas nuevas con el umbral profundo, junta lo nuevo con lo que ya tenía y vuelve a escribir la respuesta con reglas más estrictas contra las alucinaciones.
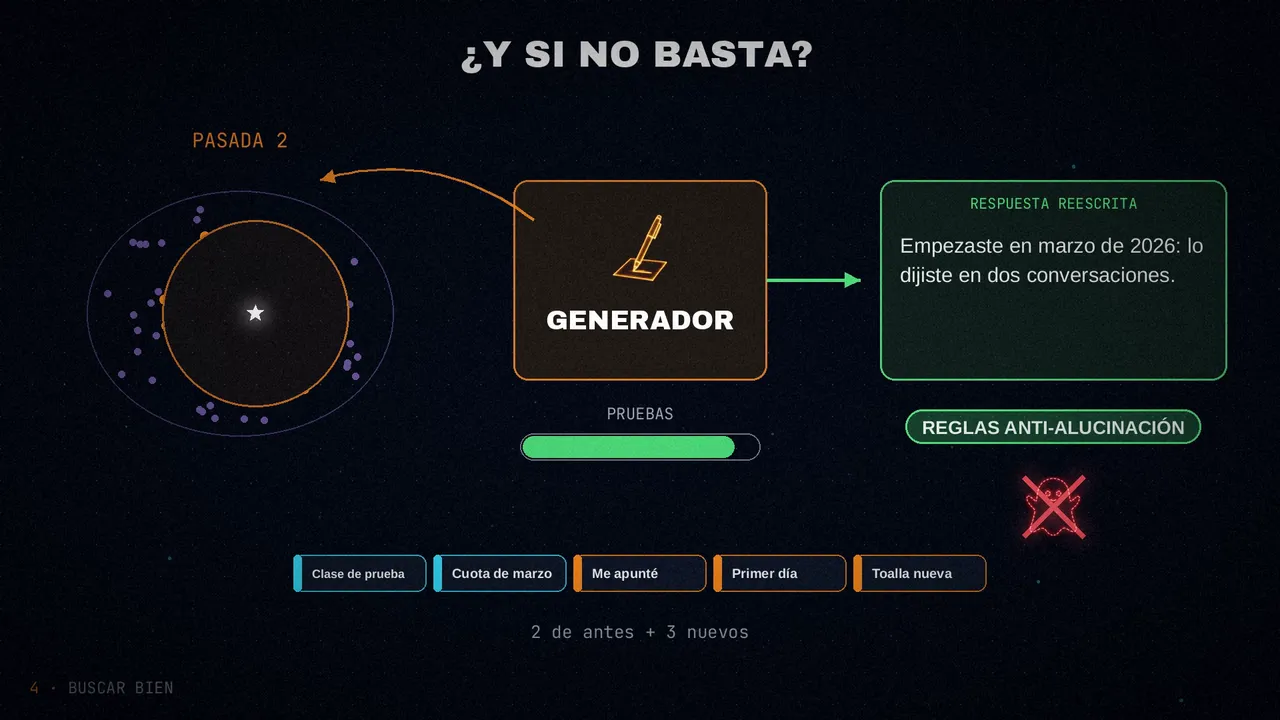
La idea de fondo es sencilla: el modelo puede pedir mejores pruebas en lugar de inventarse lo que le falta.
El protocolo de la verdad temporal
Razonar con el tiempo es uno de los problemas más difíciles de la memoria a largo plazo. Quarq separa cuatro fechas: la de almacenamiento (cuándo se guardó el recuerdo), la del evento (cuándo pasó de verdad), la narrativa (la línea temporal simulada de la prueba) y las relativas, como «la semana pasada», que se resuelven al buscar.
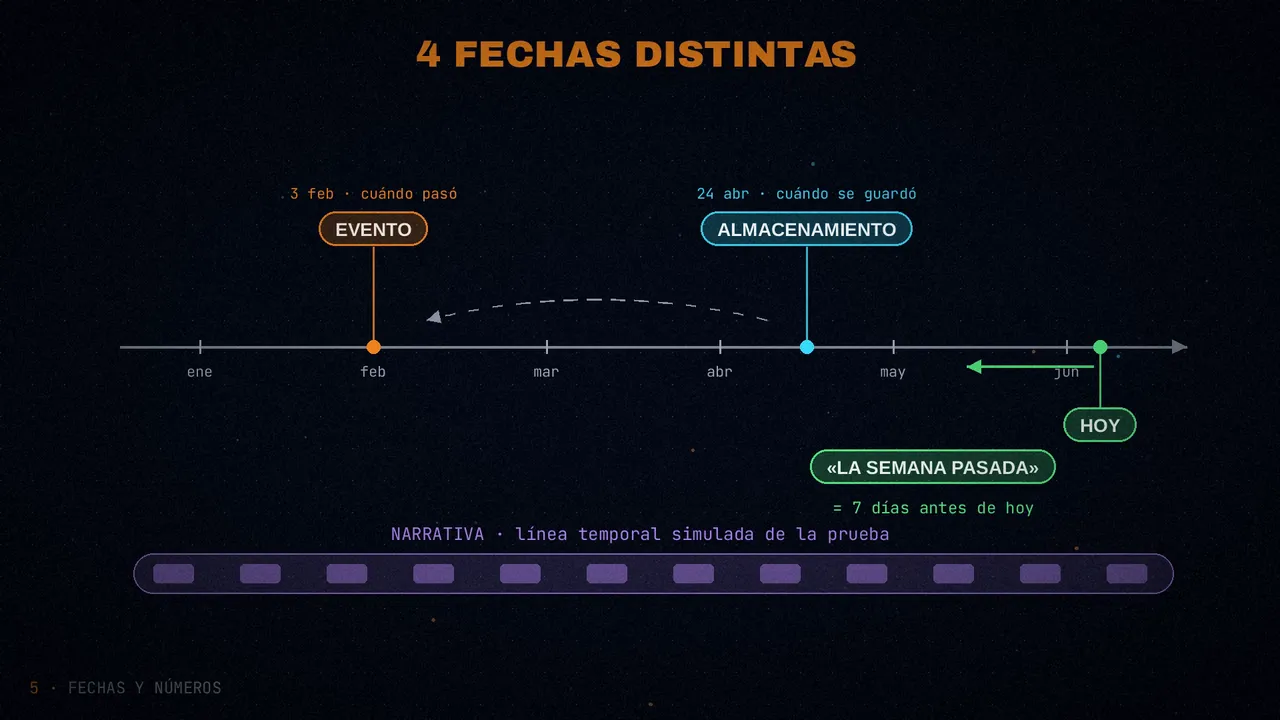
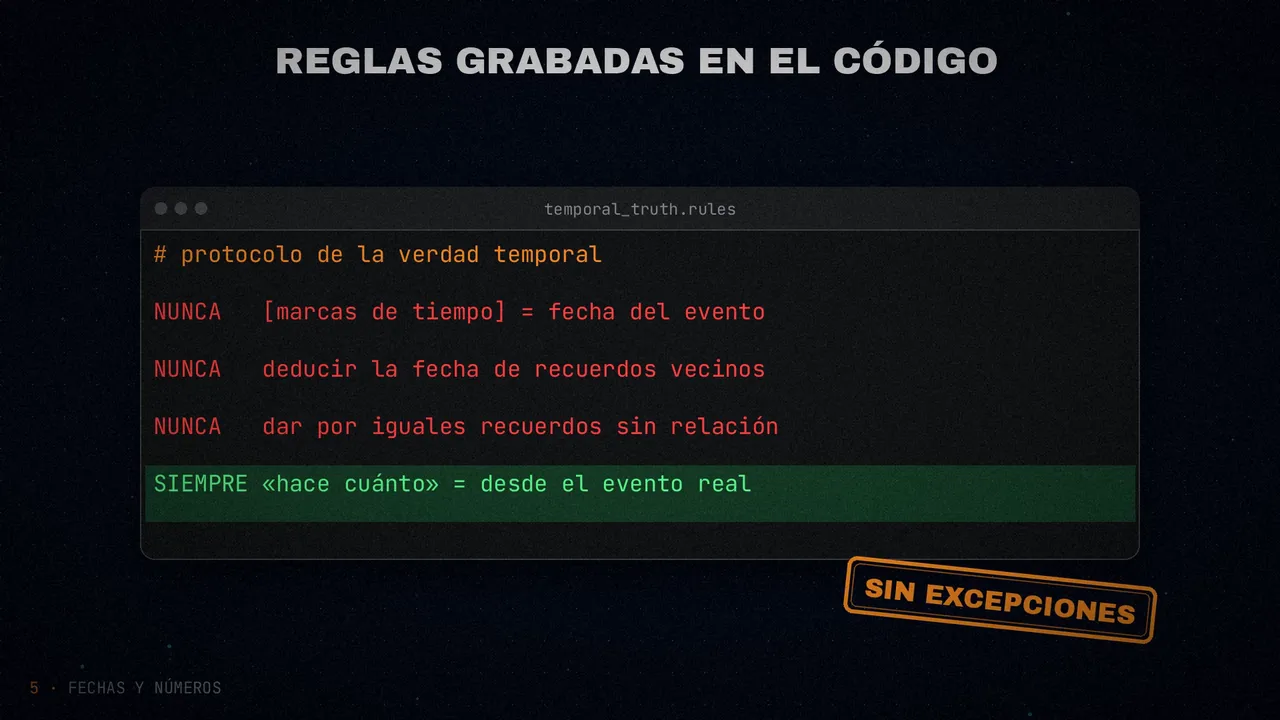
Piénsalo como una foto antigua que hoy guardas en una caja nueva: la caja dice 2026, pero la foto es de tu infancia. Si te preguntan cuánto hace de aquel verano, la respuesta no puede salir de la etiqueta de la caja. Por eso las reglas están grabadas en el código: las marcas de tiempo entre corchetes no son la fecha del evento; no se deduce una fecha de los recuerdos vecinos; no se supone que dos recuerdos sin relación hablan de lo mismo; y el «hace cuánto» se calcula siempre desde el evento real.
Fidelidad con los números
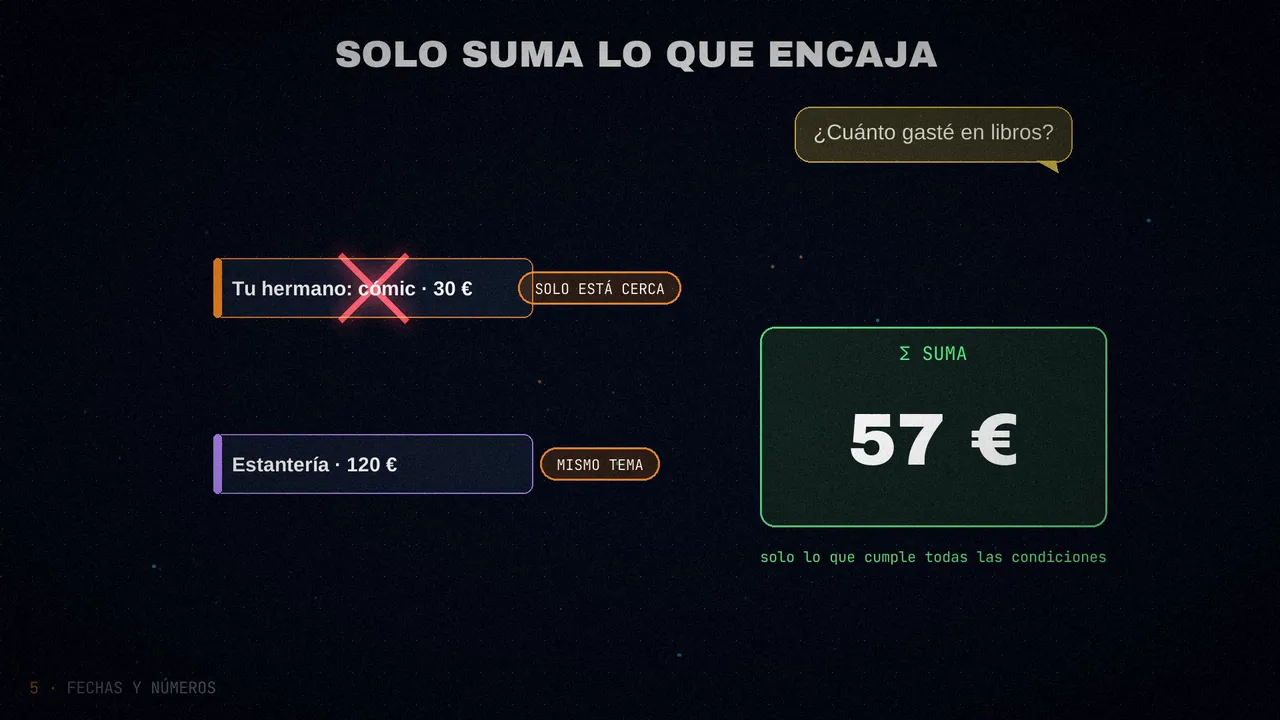
Con los números pasa algo parecido: las pruebas de memoria castigan las cuentas descuidadas. Para totales, duraciones, precios, cantidades y recuentos, Quarq identifica cuatro cosas: quién actúa, qué acción se mide, sobre qué evento u objeto y cuánta exactitud hace falta. Y descarta los números que solo están cerca o tratan del mismo tema: suma únicamente los que cumplen todas las condiciones.
Un ejemplo mío: si preguntas cuánto gastaste en libros, no cuenta lo que gastó tu hermano, ni lo que pagaste por la estantería.
Aprender sin hacerte esperar
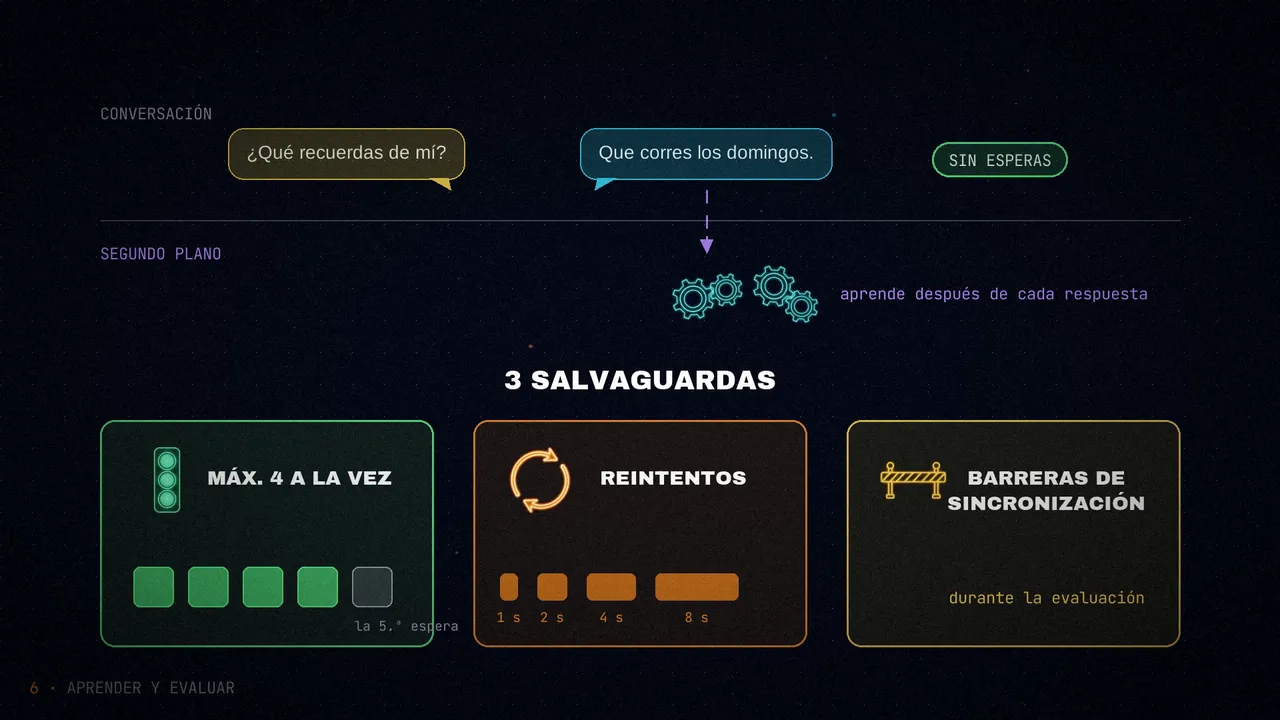
Para que no notes retrasos, el agente aprende en segundo plano, después de cada respuesta, con tres salvaguardas: como mucho cuatro tareas de aprendizaje a la vez, reintentos persistentes que esperan cada vez más entre uno y otro, y barreras de sincronización durante la evaluación.
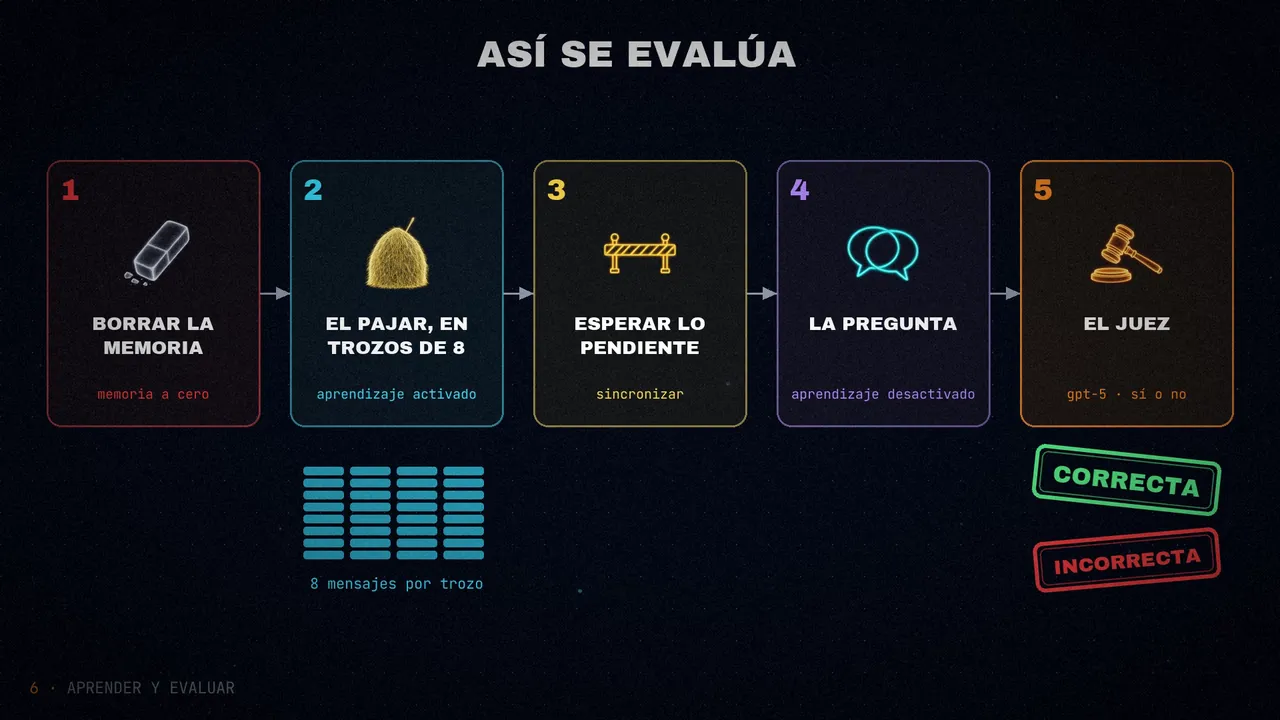
Y así se evalúa: se borra toda la memoria; se le pasan las sesiones del pajar en trozos de ocho mensajes, con el aprendizaje activado; se espera a que termine lo pendiente; se hace la pregunta con el aprendizaje desactivado, y GPT-5 decide si la respuesta es correcta o no.
Cada pieza, de un fallo
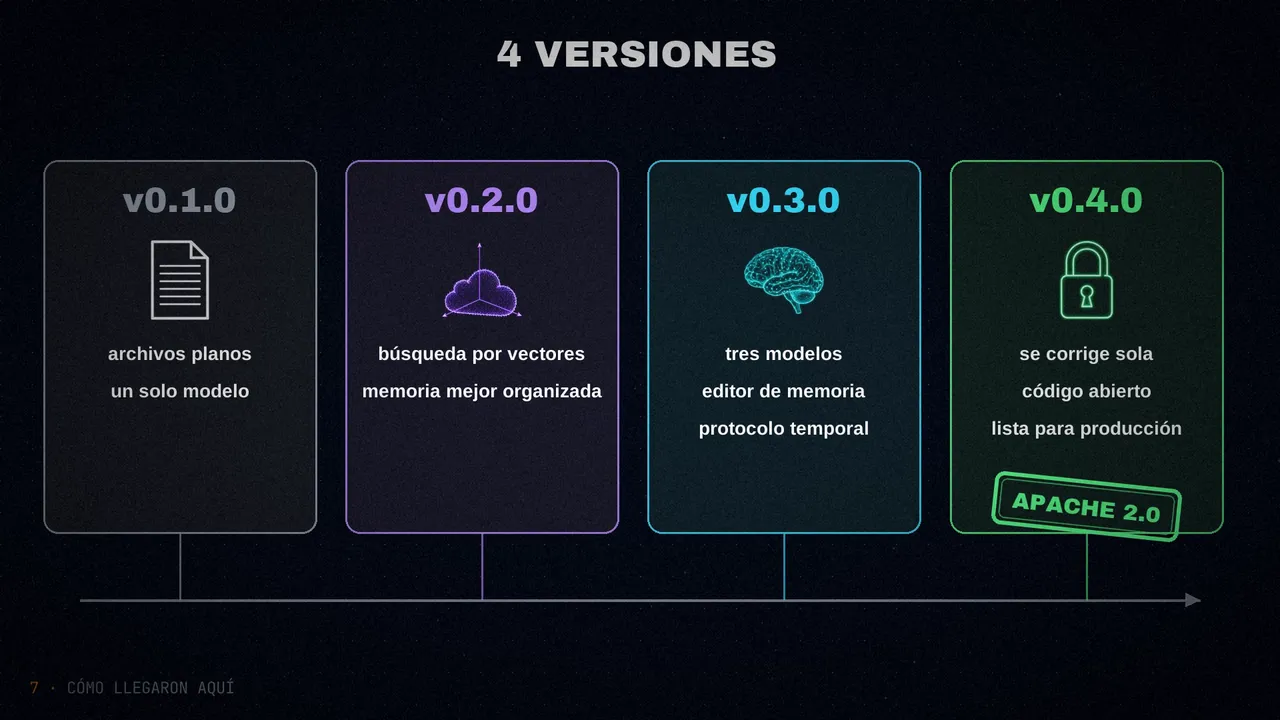
La primera versión de Quarq usaba archivos de texto planos, que se cargaban enteros en el contexto en cada petición. Funcionaba mal, pero les enseñó algo: un solo modelo no puede optimizar a la vez la calidad de la búsqueda, la de la respuesta y el coste. De ahí salieron cuatro versiones: la 0.1, con archivos planos y un solo modelo; la 0.2, con búsqueda por vectores y una memoria mejor organizada; la 0.3, con los tres modelos, el editor de memoria y el protocolo temporal; y la 0.4, con la búsqueda que se corrige sola, ya en código abierto y lista para producción.
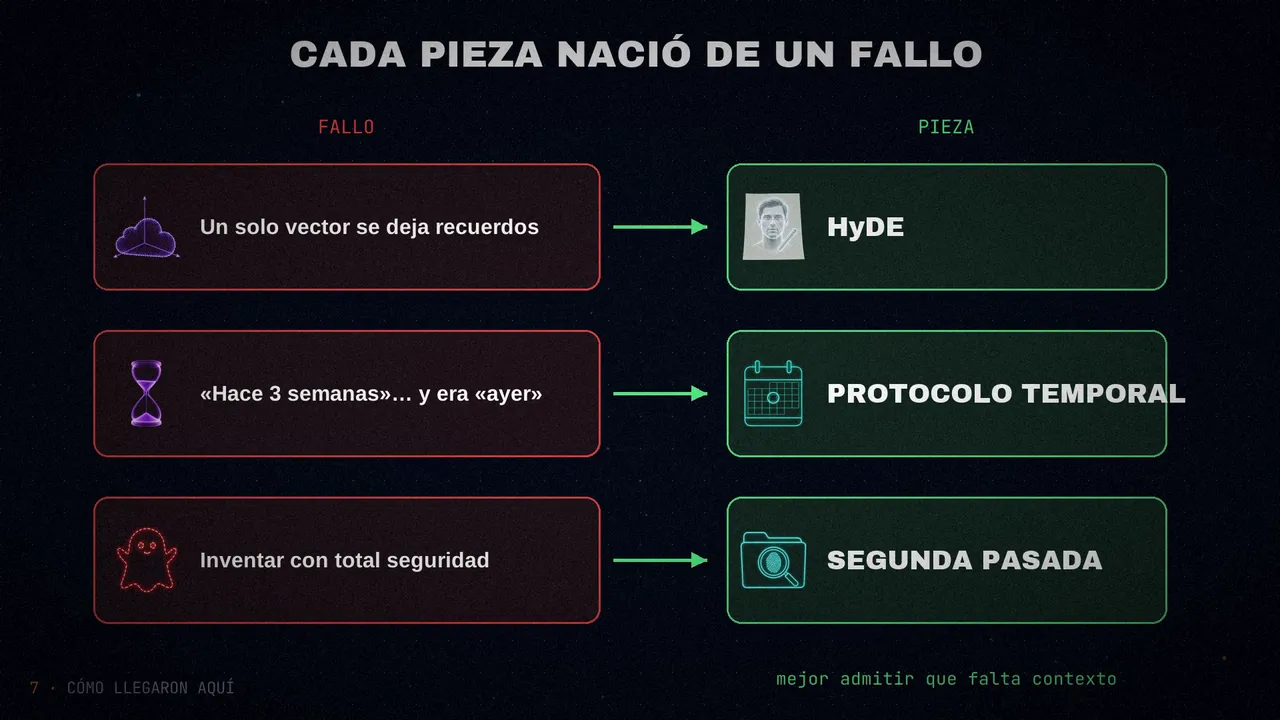
Y cada pieza nació de un fallo concreto. HyDE, de ver que buscar con un solo vector se dejaba recuerdos importantes. El protocolo temporal, de alucinaciones como responder «hace tres semanas» cuando la respuesta era «ayer». Y la segunda pasada, de modelos que se inventaban respuestas con total seguridad en vez de admitir que les faltaba contexto.
Pruébalo tú
Junto al agente han liberado el programa con el que pasaron la prueba, quarqlabs/benchmarks. Va separado: habla con el agente por HTTP, como cualquier cliente, en lugar de importar su código, así que es más fácil reproducir la evaluación y revisarla por tu cuenta. Incluye el conjunto de datos limpio, evaluaciones que se retoman donde se quedaron, un registro del contexto recuperado, memoria aislada para cada pregunta, ejecución en paralelo y una guía de costes. La meta: resultados reproducibles, en lugar de cifras opacas en una clasificación.
Para probarlo, estos son los comandos del artículo:
git clone https://github.com/quarqlabs/agent-oss
cd agent-oss
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
# .env: OPENAI_API_KEY=sk-...  USER_ID=local_user  AGENT_ID=my_agent
python agent.py                      # el agente en la terminal
uvicorn main:app --reload            # o como servidor
curl -X POST http://127.0.0.1:8000/api/chat \
  -H "Content-Type: application/json" \
  -d '{"prompt": "What do you remember about me?"}'
python run_dataset_evals.py          # la evaluación completa
EVAL_WORKERS=4 python run_dataset_evals_parallel.py   # en paralelo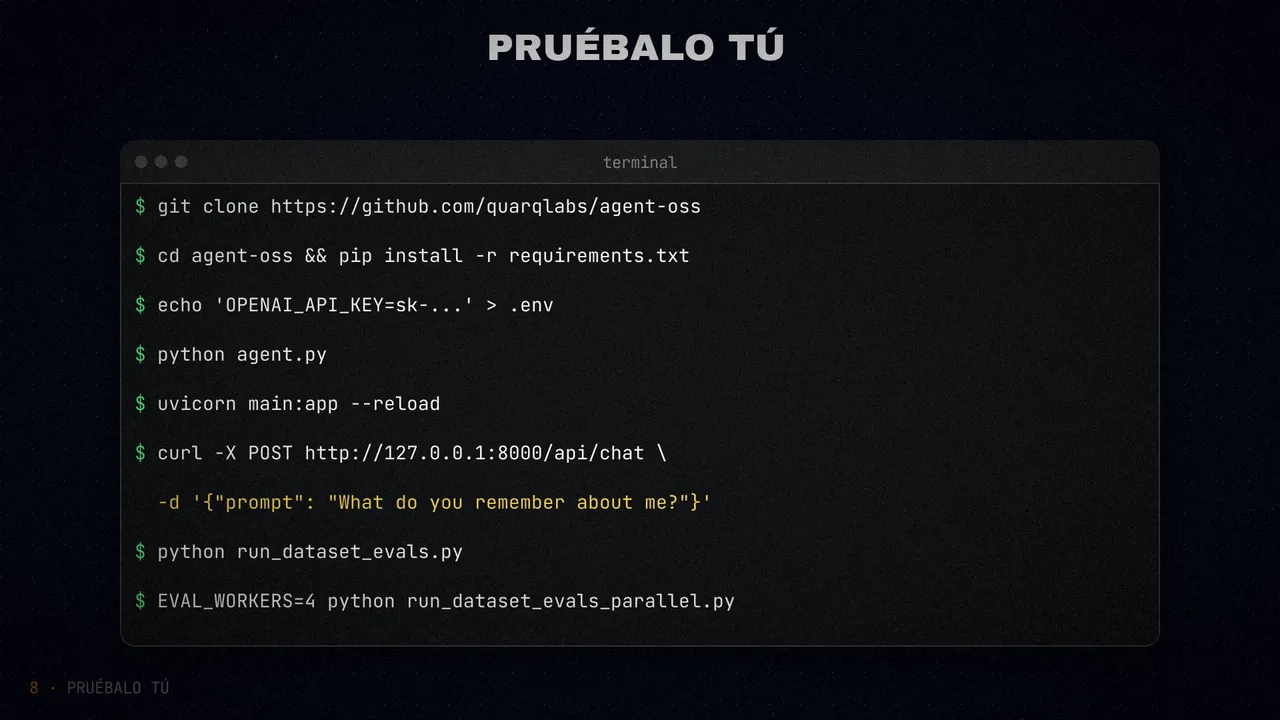
Un aviso si lo vas a buscar: el repositorio se llama hoy quarqlabs/argus («Argus Agent»). Su documentación advierte de que una pasada completa de LongMemEval-S ha costado unos 2.500 dólares, unos cinco por pregunta, así que mejor empezar con unas pocas. Todo está publicado con licencia Apache 2.0.
En resumen
Quarq Agent llega al 98,2 % en LongMemEval con una arquitectura sencilla a propósito: tres modelos especializados, búsqueda híbrida en local, reglas estrictas para fechas y números, y una segunda búsqueda cuando le faltan pruebas.
Recordar no es leerlo todo: es encontrar lo que importa, saber cuándo pasó y pedir más pruebas antes que inventar.
¿Qué te gustaría que recordara tu agente?
Fuentes
- «98.2% on LongMemEval: How We Built an Open-Source Agent That Actually Remembers», de Quarq (@quarqlabs), 1 de junio de 2026.
- El código: quarqlabs/argus (antes agent-oss) y el evaluador, quarqlabs/benchmarks.
- Sobre otra forma de memoria para agentes: mi post sobre la LLM Wiki de Karpathy.
- El vídeo, en mis canales: español e inglés.