O exame: LongMemEval
O LongMemEval mede a memória de longo prazo dos assistentes de chat. A versão S tem 500 perguntas, e antes de cada uma o sistema lê um palheiro de umas cinquenta sessões de conversa; a resposta está escondida em alguma delas. No total, são uns 57 milhões de tokens, cerca de 115 mil por pergunta.
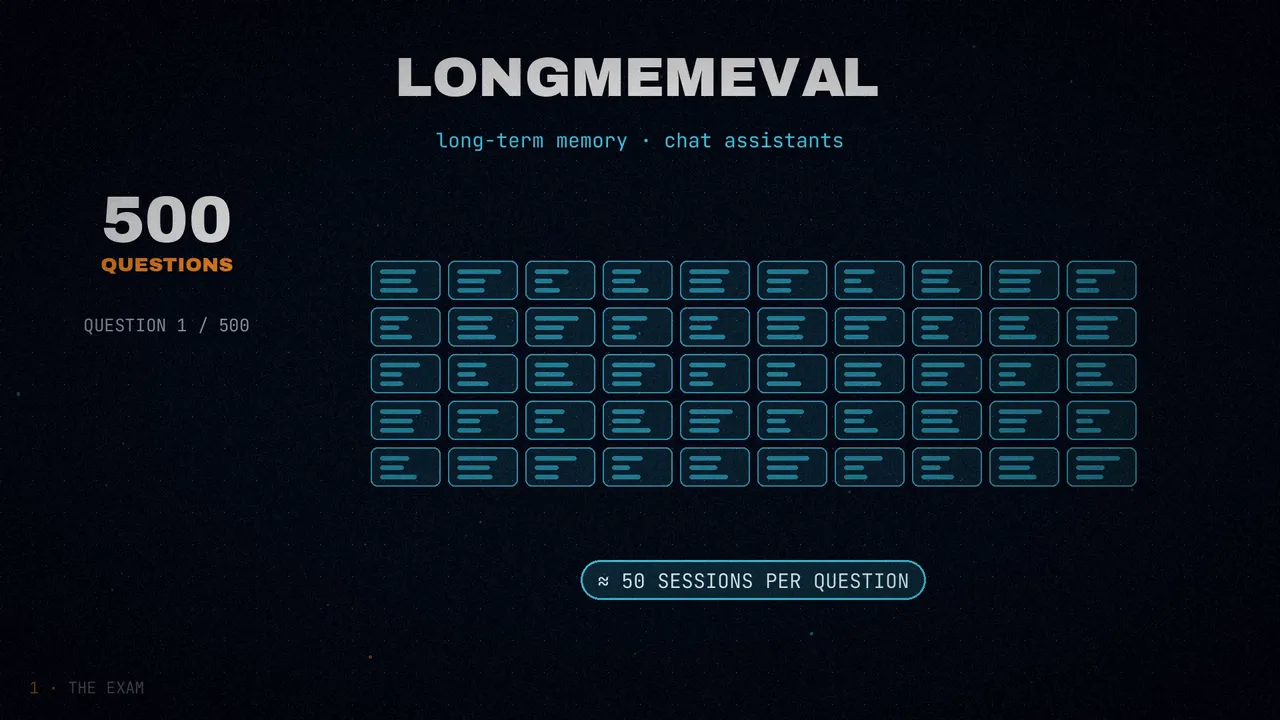
As perguntas são de seis tipos. Três olham para uma única sessão: algo que o usuário disse, algo que o assistente respondeu e uma preferência mencionada de passagem. As outras três são mais difíceis: juntar dados de várias sessões, saber qual é a versão atual de algo que mudou e raciocinar com datas («quanto tempo faz que aconteceu?»).
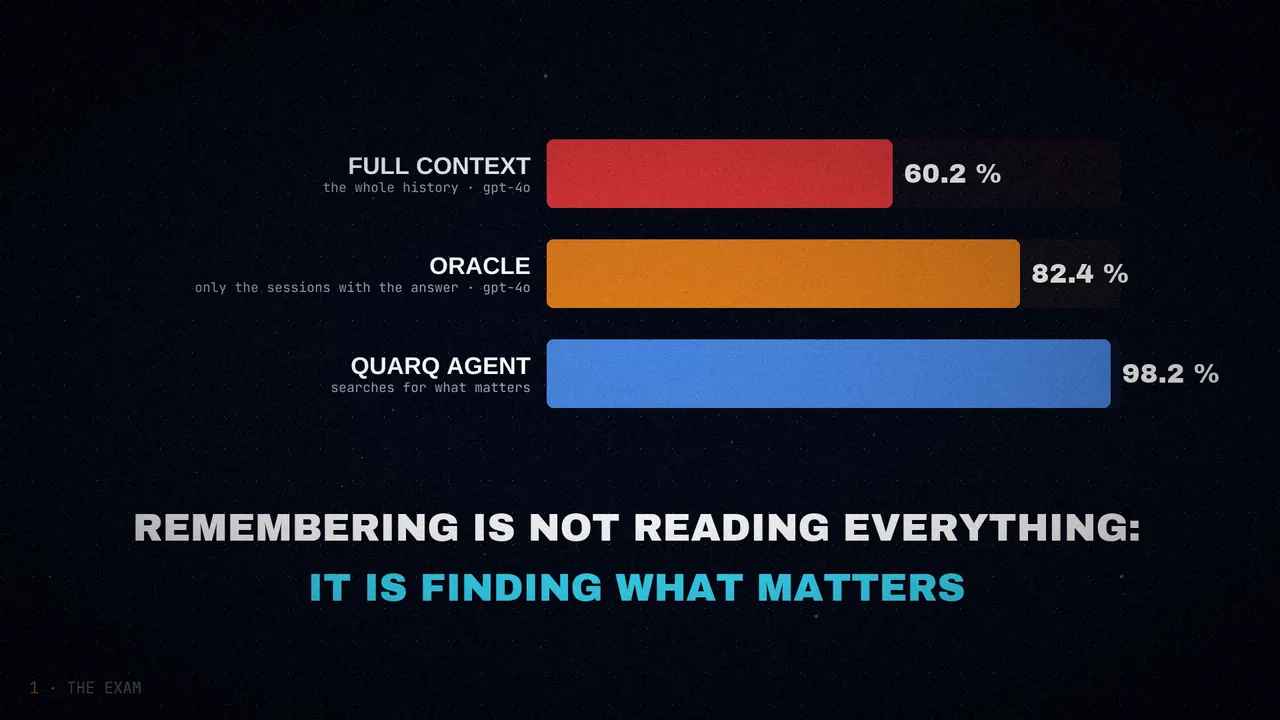
E por que não colocar a conversa inteira no contexto e pronto? Porque não funciona. Na tabela do artigo, o GPT-4o com todo o histórico na frente acerta só 60,2%; se você der apenas as sessões que contêm a resposta (o «oráculo»), 82,4%. Lembrar não é ler tudo: é encontrar o que importa.
Os resultados
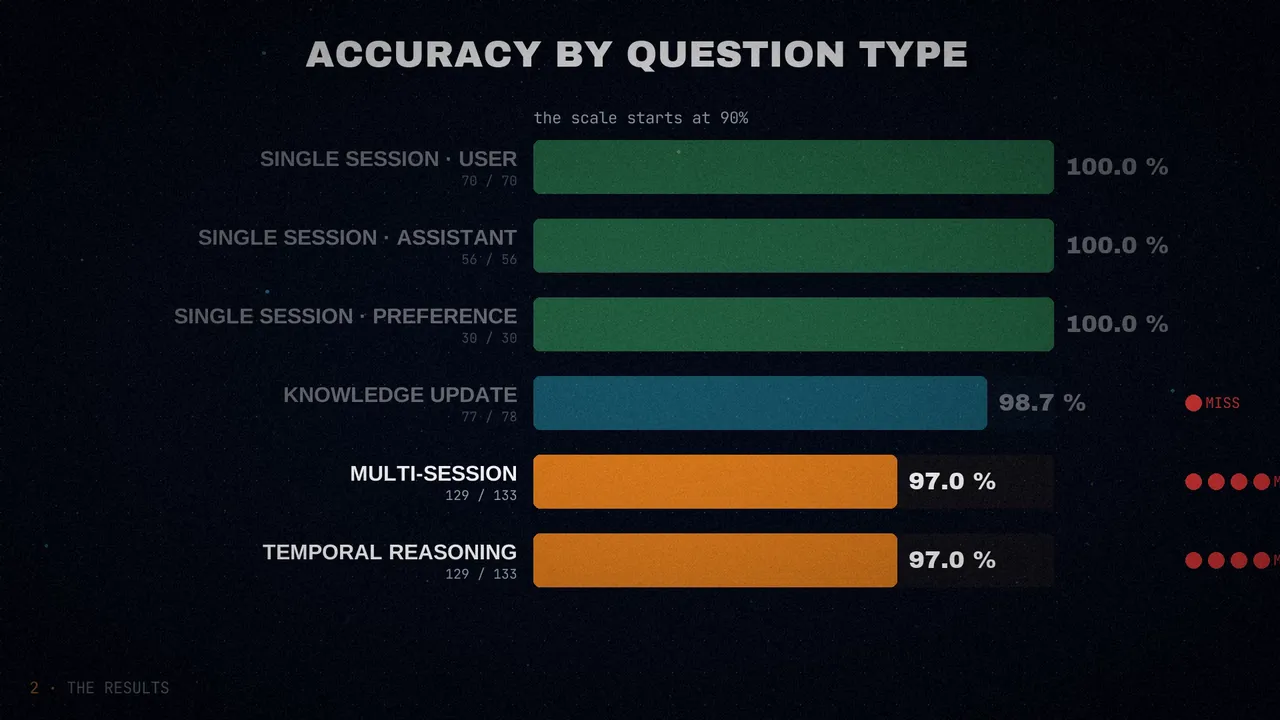
O Quarq Agent acerta 491 das 500 perguntas: erra só nove. São 98,2%. E consegue isso com a memória no seu próprio computador: um índice de vetores FAISS local e uma arquitetura de memória em camadas.
Por tipo, as três categorias de uma única sessão chegam a 100%. A de conhecimento que muda, a 98,7%, com um único erro. E as duas mais difíceis, várias sessões e raciocínio temporal, ficam em 97%, com quatro erros cada uma.
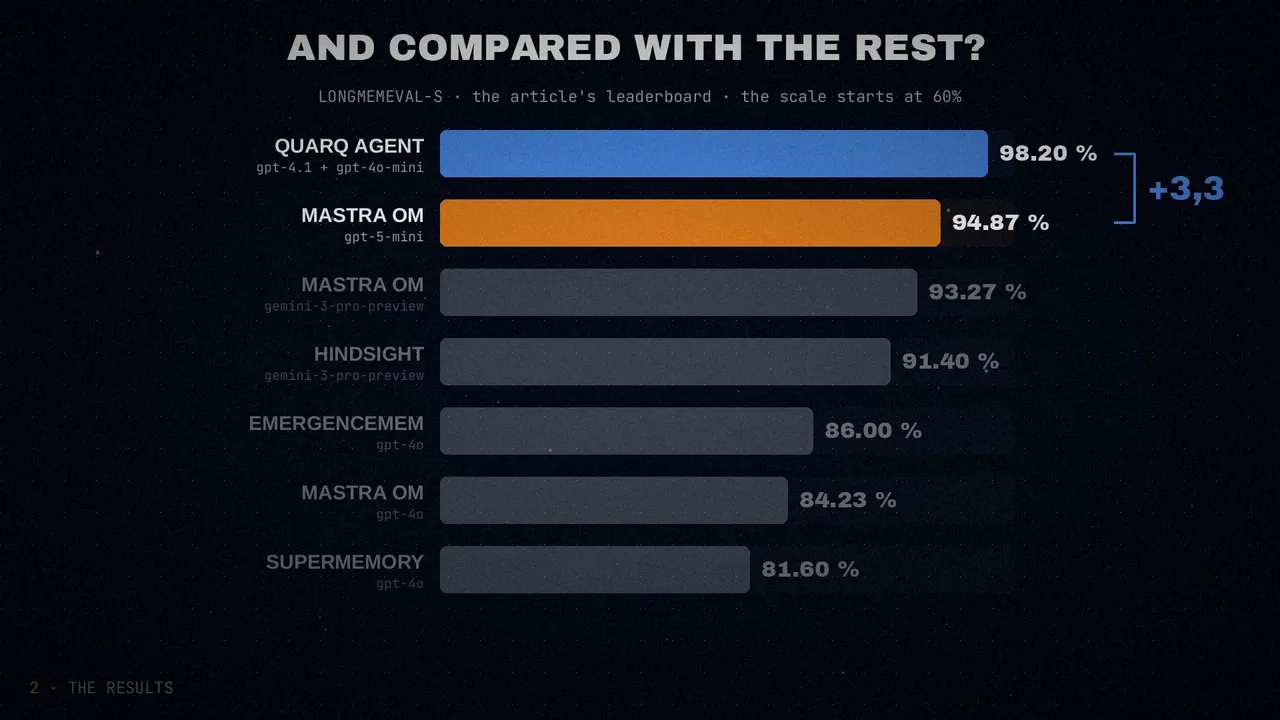
Na classificação que eles publicam, o segundo lugar é do Mastra (com GPT-5 mini), com 94,87%, seguido pelo Hindsight (com Gemini 3 Pro), com 91,4%. Vários sistemas com GPT-4o ficam entre 81,6% e 86%. O Quarq abre 3,3 pontos de vantagem.
O artigo destaca três coisas. Primeiro, o gerador (GPT-4.1) é menos capaz que os modelos mais recentes que muitos concorrentes usam. Além disso, o raciocínio temporal é a categoria mais difícil, e o protocolo deles ataca a falha mais comum: confundir quando um dado foi guardado com quando aconteceu. E por fim, tudo roda localmente, enquanto quase todos os outros dependem de bancos de vetores na nuvem.
Com cautela
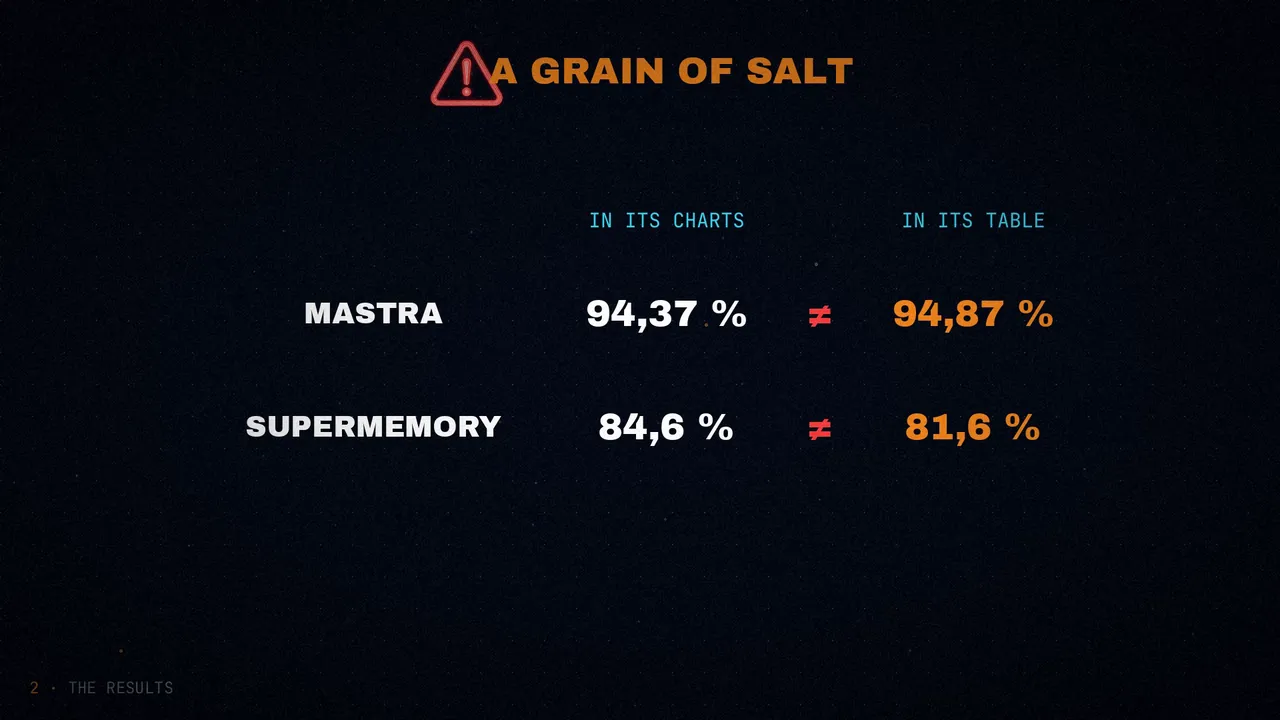
Vale a pena olhar a comparação com cautela. Cada equipe monta a própria avaliação, com o próprio juiz e os próprios modelos: a Quarq julga as respostas com o GPT-5. E nos gráficos do próprio artigo, os números de alguns concorrentes não batem totalmente com os da tabela: o Mastra aparece com 94,37% num e 94,87% no outro, e o Supermemory com 84,6% contra 81,6%.
Eles mesmos avisam que o resultado é provisório: pode mudar quando as perguntas duvidosas forem repetidas e novas correções forem adicionadas.
A memória em três camadas
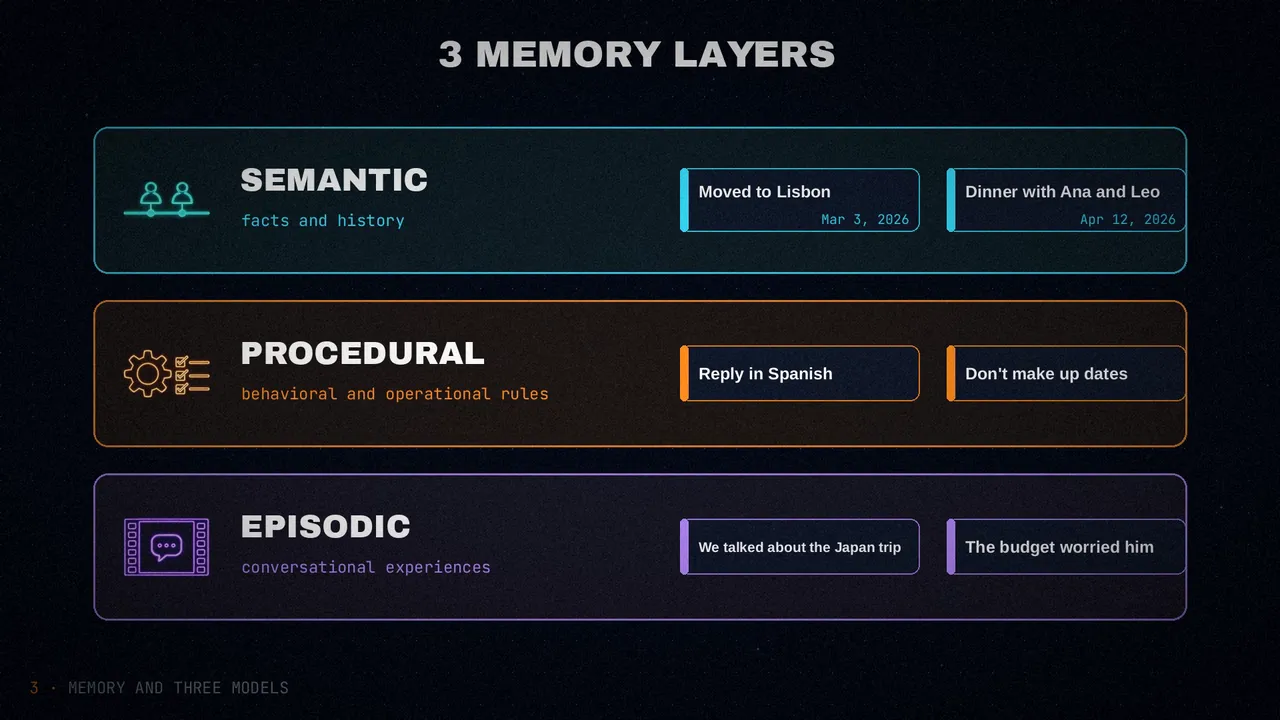
Por dentro, a memória tem três camadas:
- Semântica: fatos e histórico das interações, o que aconteceu, quando e quem estava.
- Procedural: regras de comportamento e de funcionamento.
- Episódica: experiências das conversas, com seu contexto.
Três modelos em vez de um
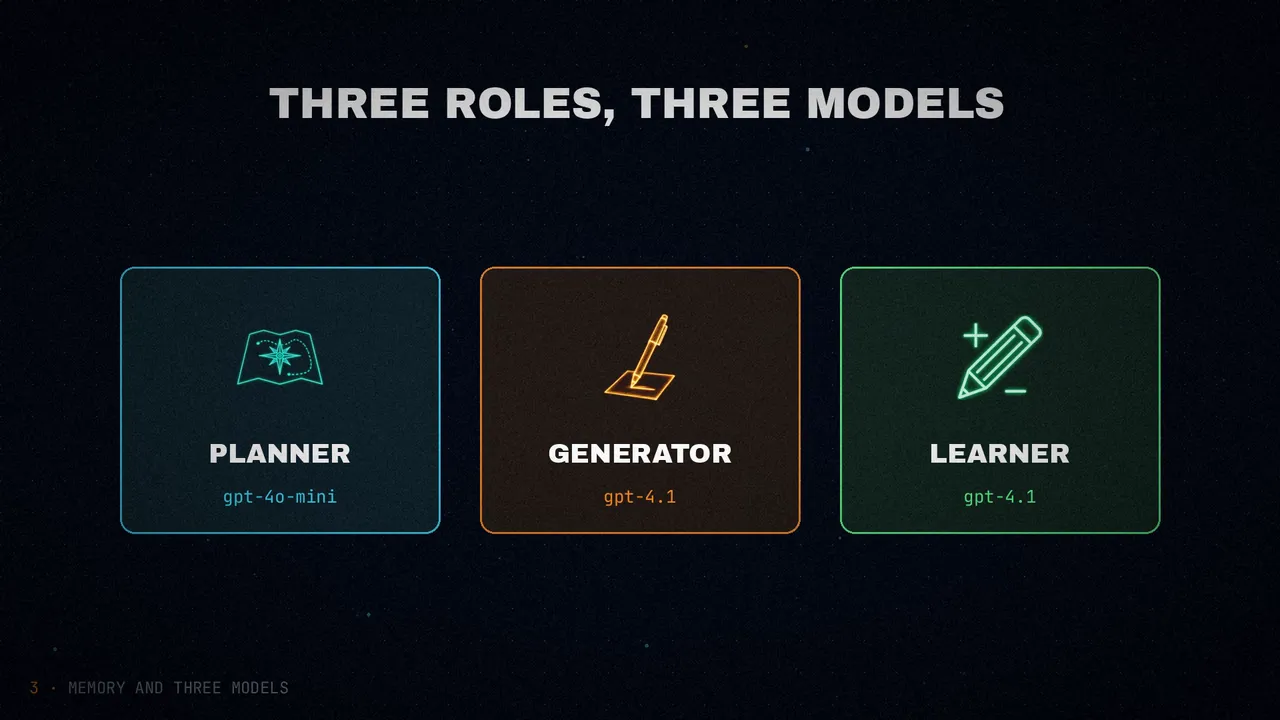
A maioria dos sistemas de memória usa um único modelo de linguagem para tudo: buscar, responder e gerenciar a memória. É como um homem-banda, que toca todos os instrumentos ao mesmo tempo e nenhum muito bem. A Quarq divide essas tarefas em três papéis, cada um com seu modelo:
Um modelo pequeno e barato. Antes de cada busca, prepara uma estratégia: reescreve a pergunta de várias formas parecidas, extrai as palavras-chave e escolhe um modo de busca de acordo com a complexidade da pergunta.
Recebe as lembranças encontradas, as regras procedurais e o histórico da conversa, e se dedica apenas a escrever a resposta.
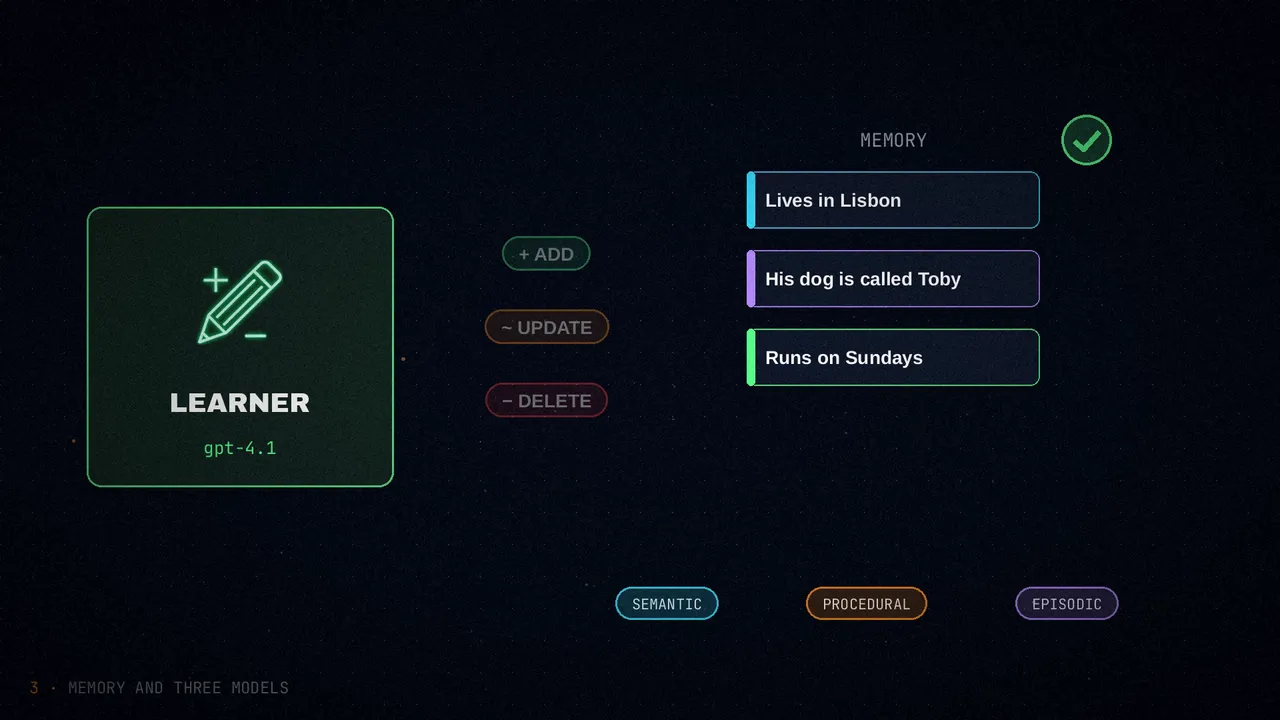
Não despeja texto bruto na memória: faz edições pontuais. Adiciona fatos novos, atualiza os que ficaram velhos e apaga as contradições, olhando o que há nas outras camadas para não duplicar nada.
Buscar bem: HyDE e a busca híbrida
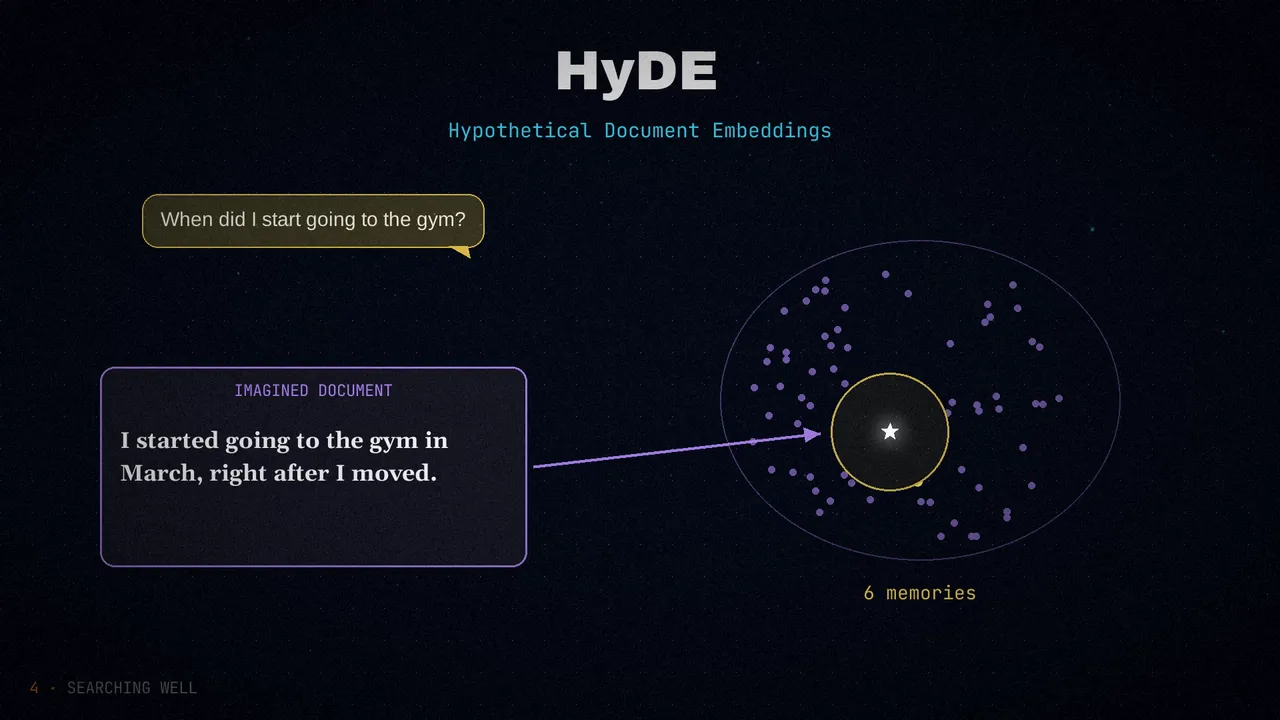
O planejador usa o HyDE (Hypothetical Document Embeddings): em vez de buscar com a pergunta do jeito que ela é, imagina como seria um documento que a respondesse e busca com isso. É como o retrato falado da polícia: você não tem a foto do suspeito, mas um desenho aproximado ajuda a encontrá-lo no meio da multidão.
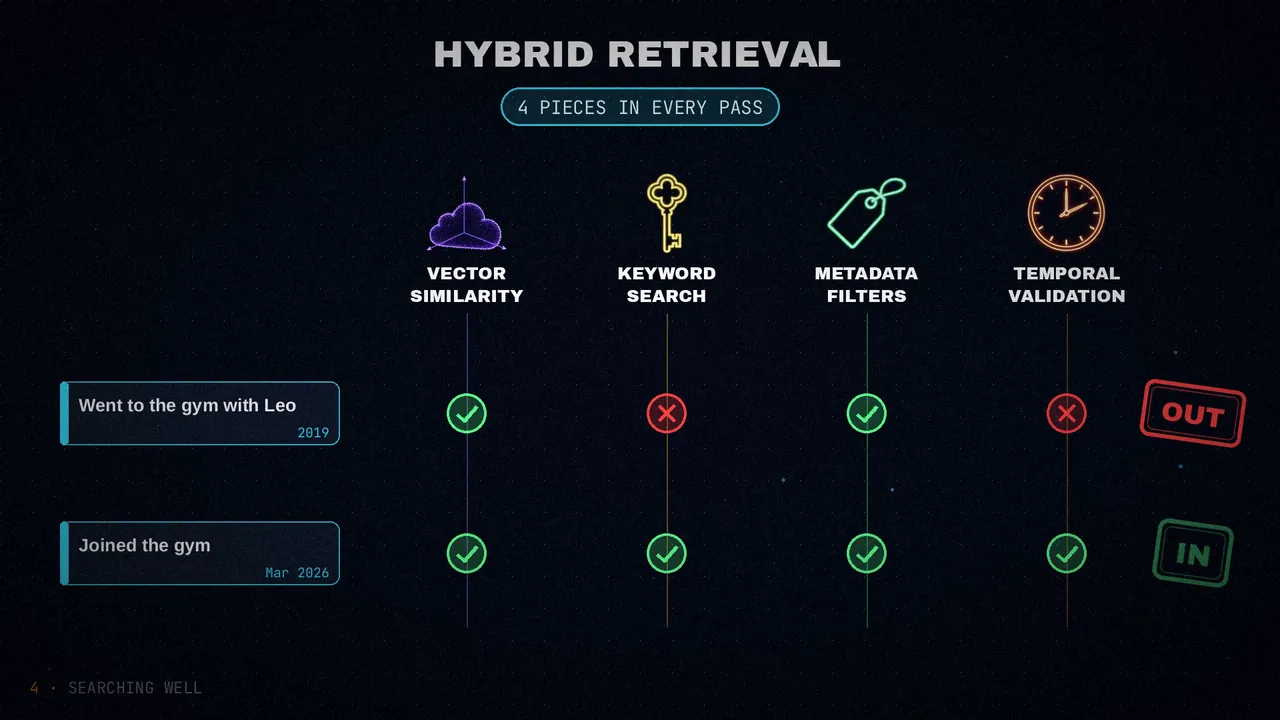
Cada passada de busca combina quatro peças: similaridade de vetores, palavras-chave, filtros por metadados e uma validação temporal. Parecer no significado não basta: a lembrança também precisa conter o que importa e se encaixar no tempo.
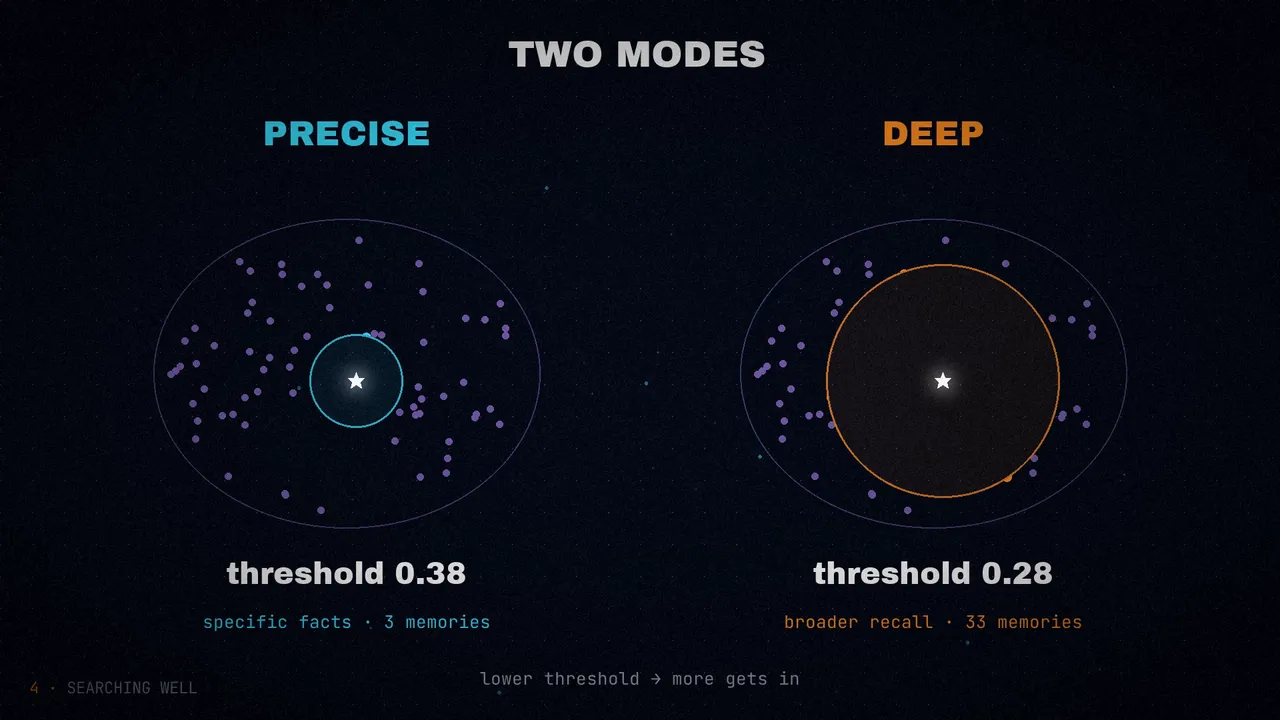
E há dois modos. O preciso usa um limiar de similaridade de 0,38, para dados pontuais. O profundo baixa para 0,28, para lembrar com mais contexto. É a diferença entre pescar com vara e jogar a rede.
Uma busca que se corrige sozinha
E se o que ele encontra não for suficiente? Quando a primeira busca não dá provas suficientes para responder com segurança, o gerador pode pedir outra. O sistema então faz novas buscas com o limiar profundo, junta o novo com o que já tinha e reescreve a resposta com regras mais rígidas contra alucinações.
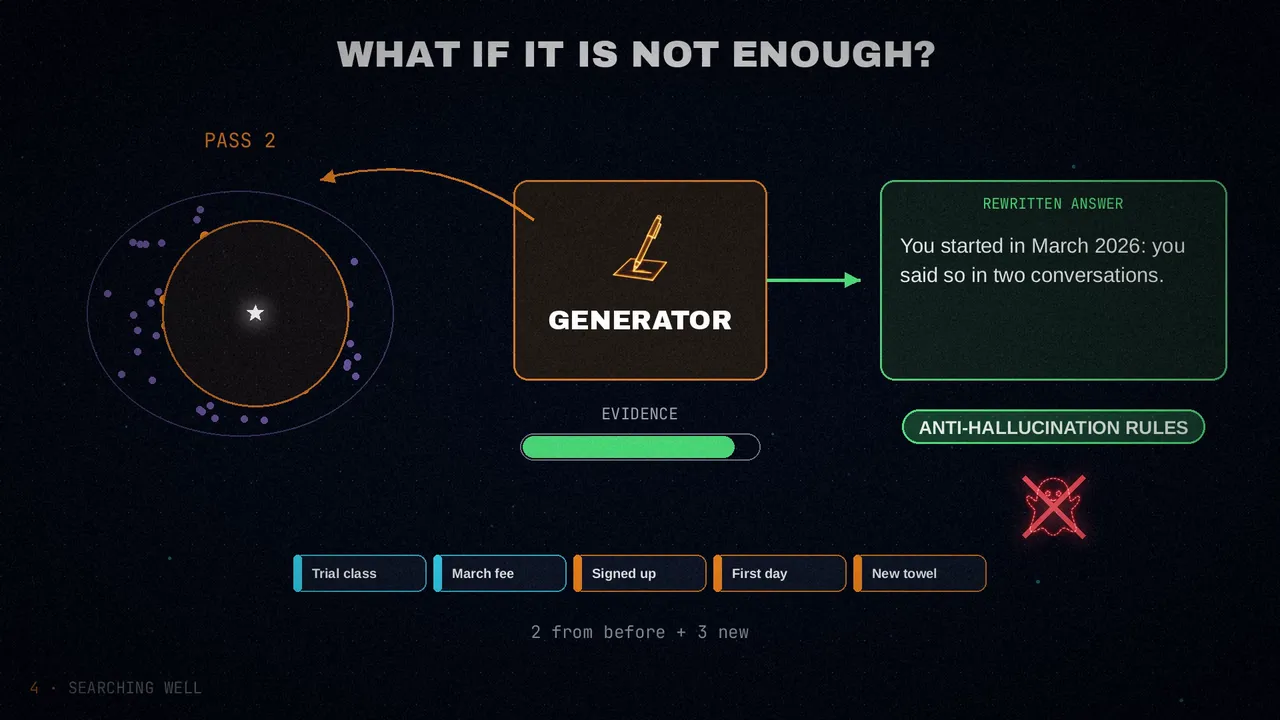
A ideia de fundo é simples: o modelo pode pedir provas melhores em vez de inventar o que falta.
O protocolo da verdade temporal
Raciocinar com o tempo é um dos problemas mais difíceis da memória de longo prazo. A Quarq separa quatro datas: a de armazenamento (quando a lembrança foi guardada), a do evento (quando aconteceu de verdade), a narrativa (a linha do tempo simulada do teste) e as relativas, como «semana passada», que são resolvidas na hora da busca.
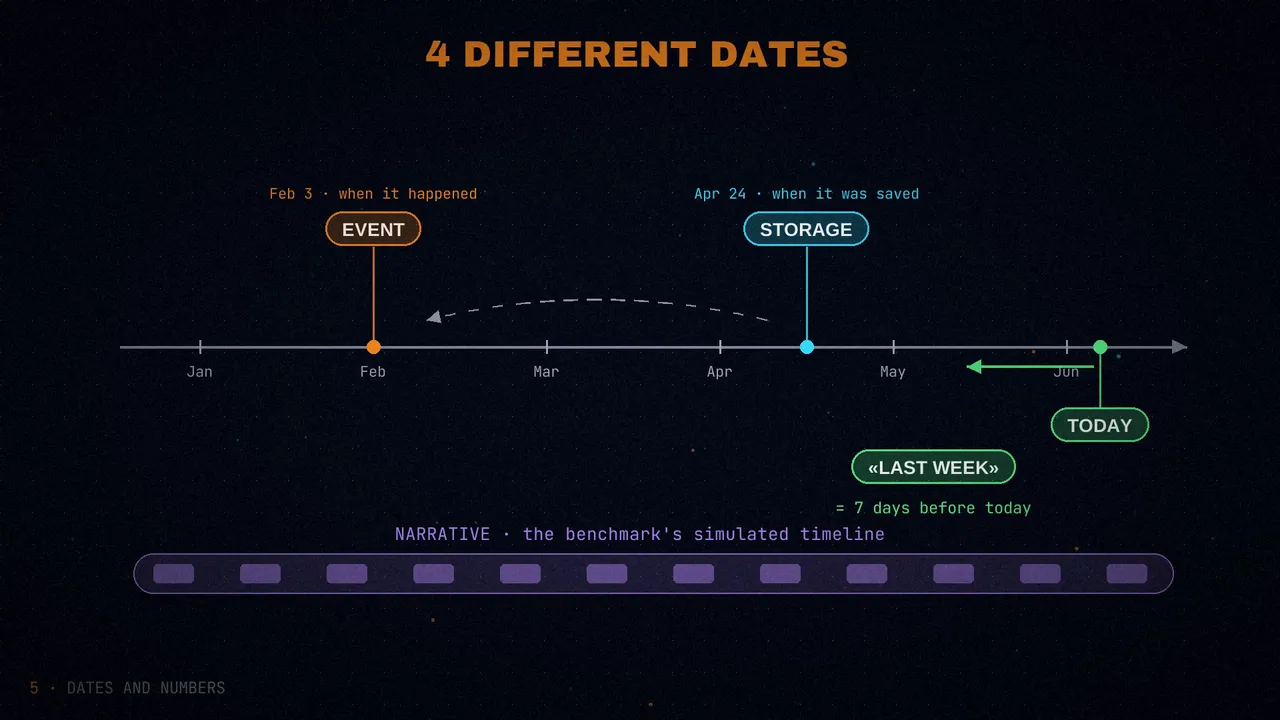
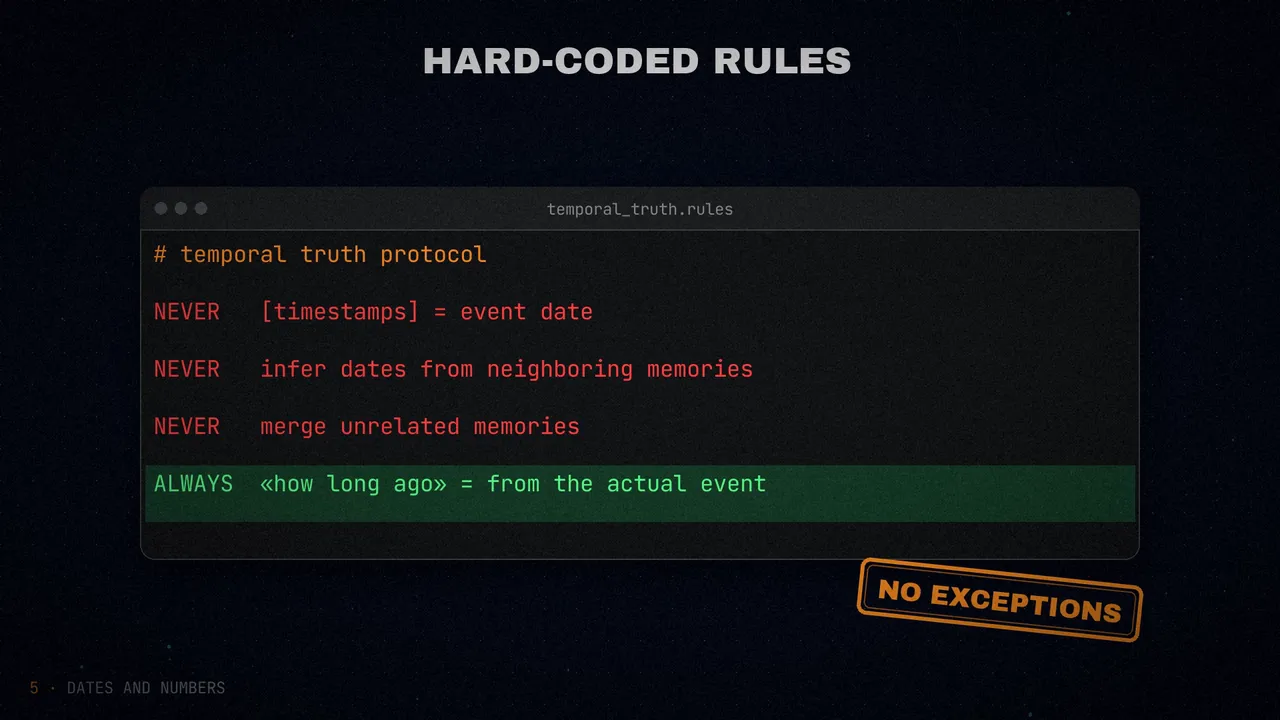
Pense numa foto antiga que você guarda hoje numa caixa nova: a caixa diz 2026, mas a foto é da sua infância. Se perguntarem quanto tempo faz daquele verão, a resposta não pode sair da etiqueta da caixa. Por isso as regras estão gravadas no código: as marcas de tempo entre colchetes não são a data do evento; nunca se deduz uma data das lembranças vizinhas; nunca se supõe que duas lembranças sem relação falam da mesma coisa; e o «quanto tempo faz» é sempre calculado a partir do evento real.
Fidelidade com os números
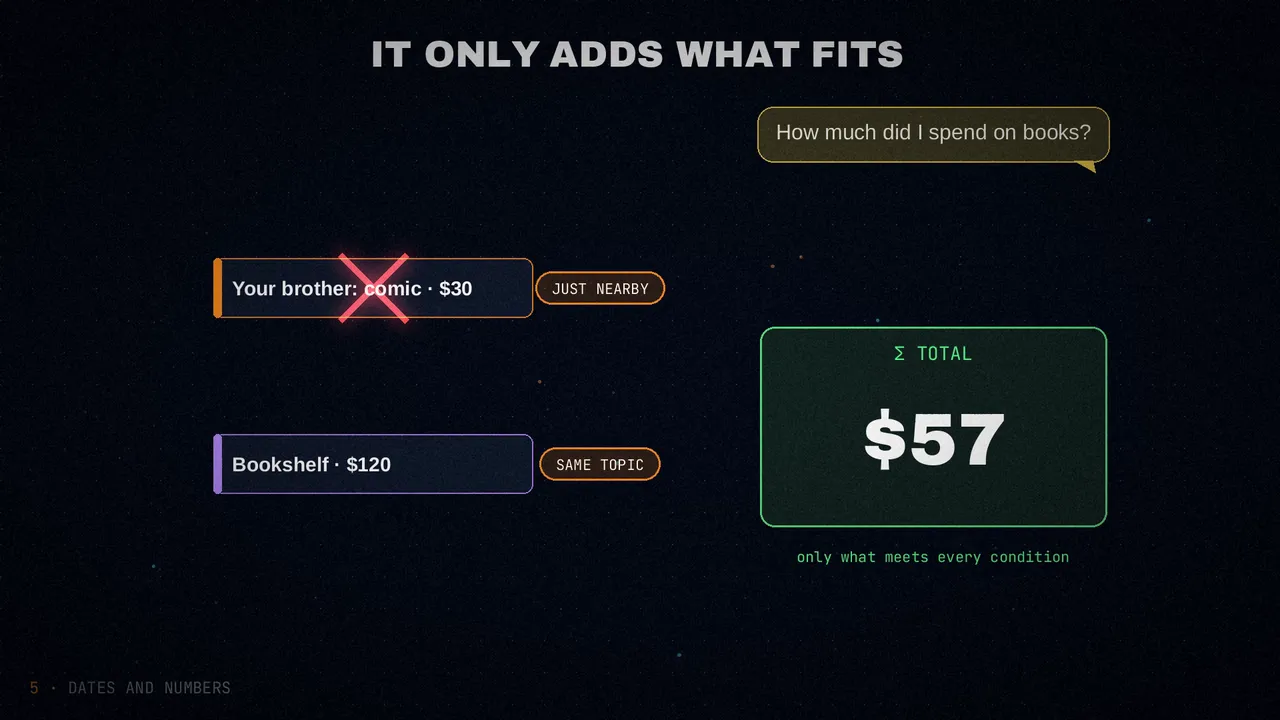
Com os números acontece algo parecido: os testes de memória castigam as contas descuidadas. Para totais, durações, preços, quantidades e contagens, a Quarq identifica quatro coisas: quem age, que ação é medida, sobre qual evento ou objeto e quanta exatidão é necessária. E descarta os números que só estão por perto ou falam do mesmo assunto: soma apenas os que cumprem todas as condições.
Um exemplo meu: se você pergunta quanto gastou em livros, não conta o que seu irmão gastou, nem o que você pagou pela estante.
Aprender sem fazer você esperar
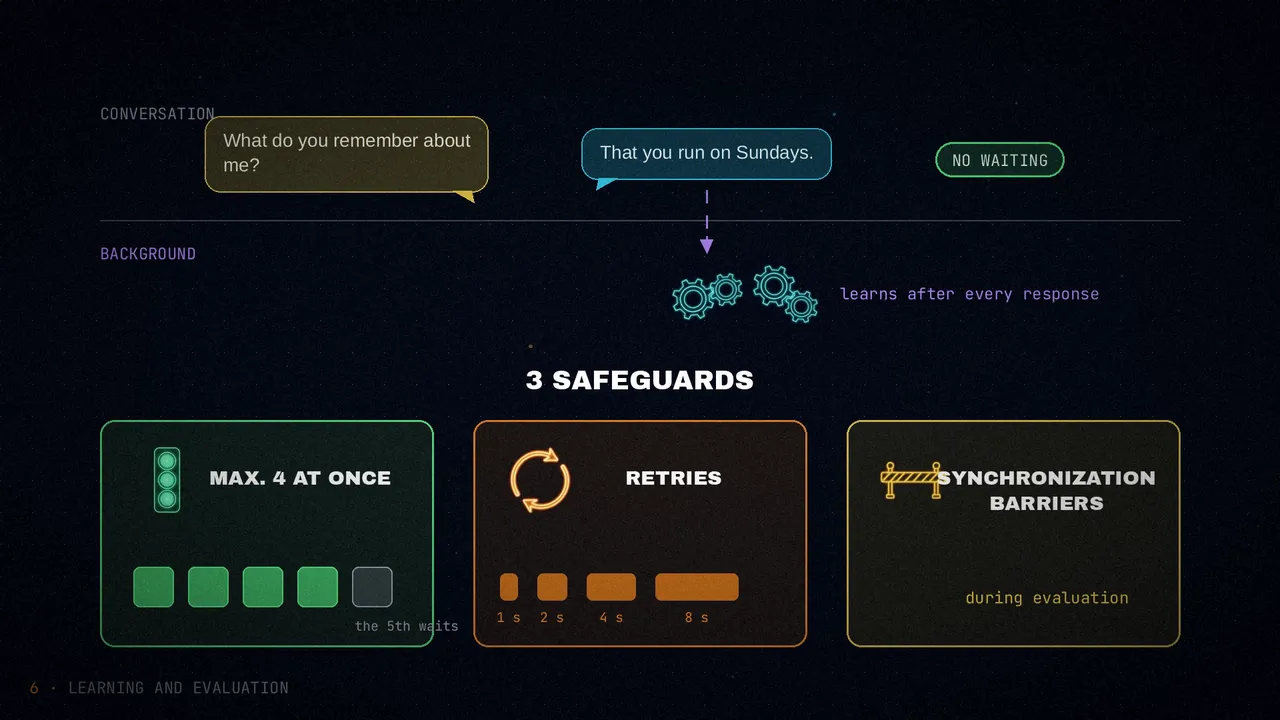
Para que você não perceba atrasos, o agente aprende em segundo plano, depois de cada resposta, com três salvaguardas: no máximo quatro tarefas de aprendizado ao mesmo tempo, novas tentativas persistentes que esperam cada vez mais entre uma e outra, e barreiras de sincronização durante a avaliação.
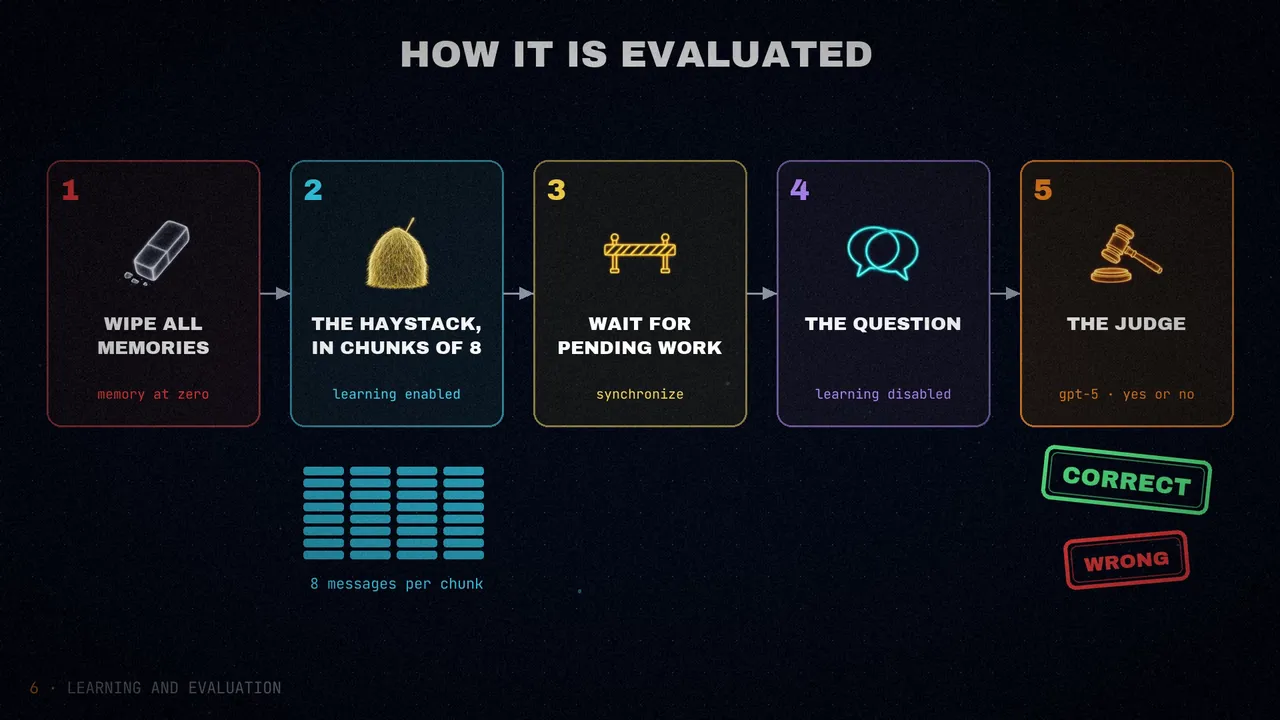
E é assim que se avalia: apaga-se toda a memória; as sessões do palheiro são passadas em blocos de oito mensagens, com o aprendizado ativado; espera-se o que estiver pendente terminar; faz-se a pergunta com o aprendizado desativado, e o GPT-5 decide se a resposta está certa ou errada.
Cada peça nasceu de uma falha
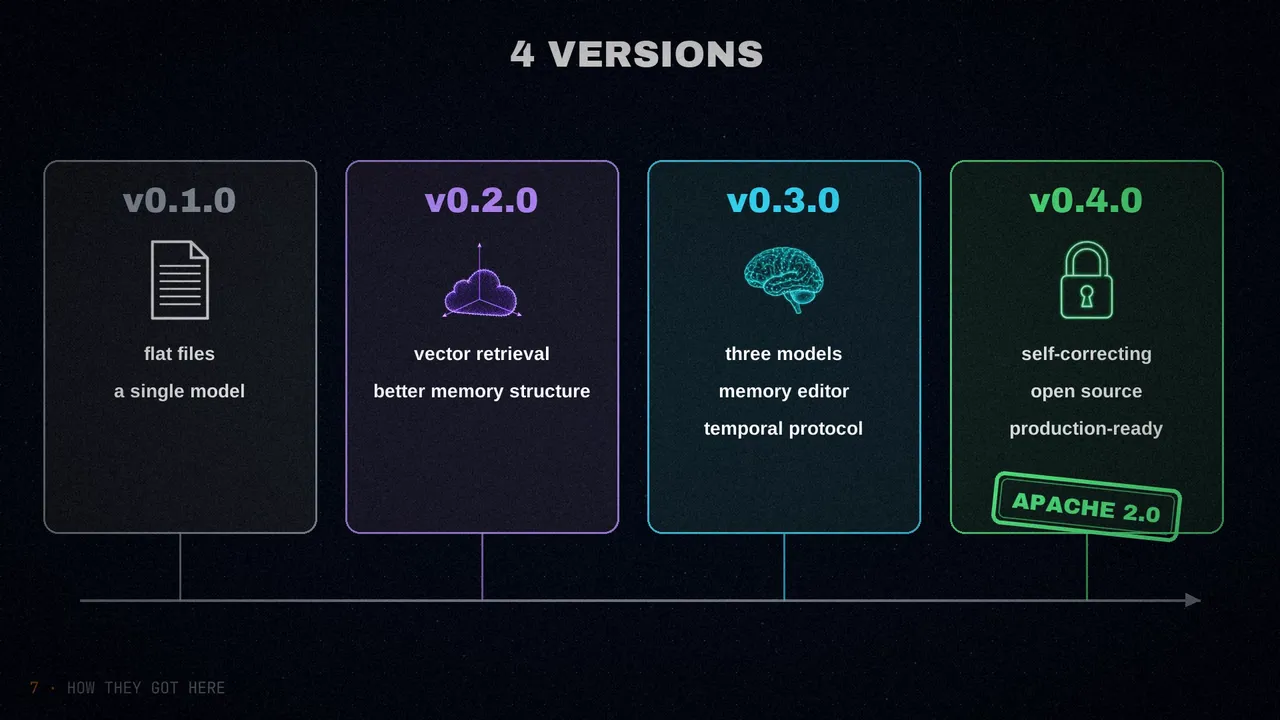
A primeira versão do Quarq usava arquivos de texto simples, carregados inteiros no contexto a cada requisição. Funcionava mal, mas ensinou uma coisa: um único modelo não consegue otimizar ao mesmo tempo a qualidade da busca, a da resposta e o custo. Daí saíram quatro versões: a 0.1, com arquivos simples e um único modelo; a 0.2, com busca por vetores e uma memória mais bem organizada; a 0.3, com os três modelos, o editor de memória e o protocolo temporal; e a 0.4, com a busca que se corrige sozinha, já em código aberto e pronta para produção.
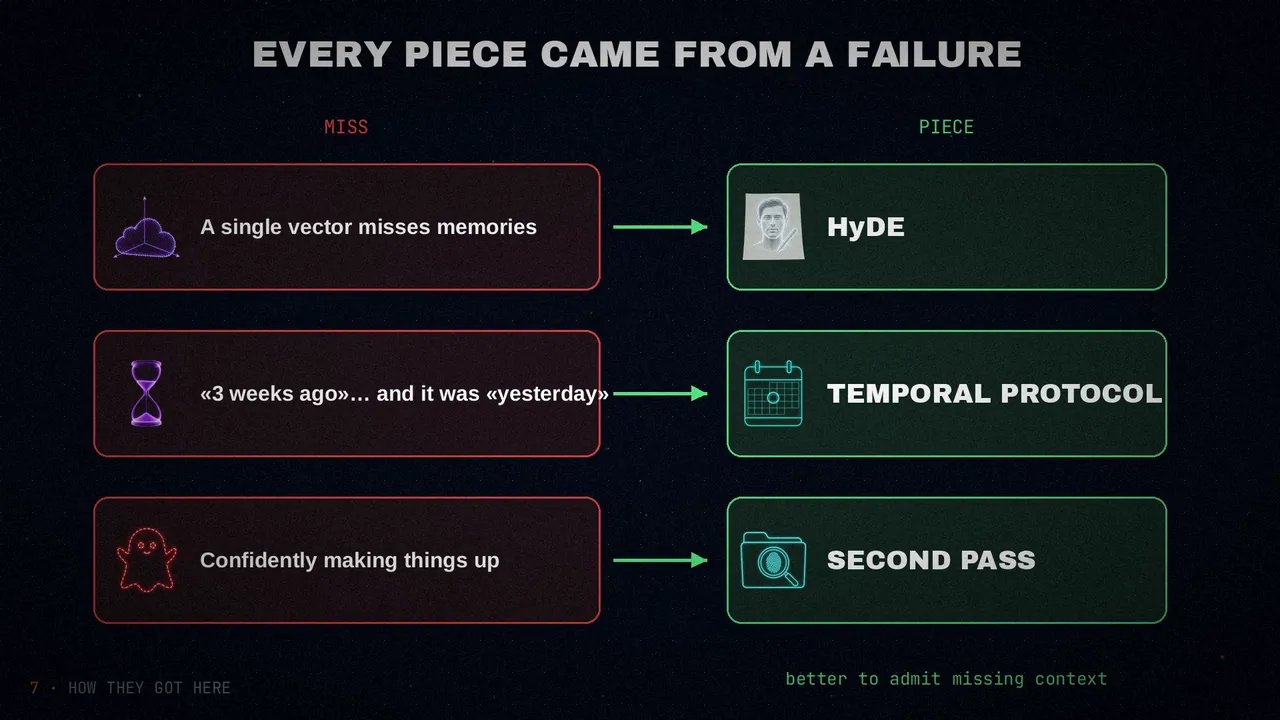
E cada peça nasceu de uma falha concreta. O HyDE, de ver que buscar com um único vetor deixava lembranças importantes de fora. O protocolo temporal, de alucinações como responder «três semanas atrás» quando a resposta era «ontem». E a segunda passada, de modelos que inventavam respostas com total segurança em vez de admitir que faltava contexto.
Teste você mesmo
Junto com o agente, eles liberaram o programa com que rodaram o teste, o quarqlabs/benchmarks. Ele fica separado: conversa com o agente por HTTP, como qualquer cliente, em vez de importar o código dele, o que torna a avaliação mais fácil de reproduzir e de revisar por conta própria. Inclui o conjunto de dados limpo, avaliações que retomam de onde pararam, um registro do contexto recuperado, memória isolada para cada pergunta, execução em paralelo e um guia de custos. A meta: resultados reproduzíveis, em vez de números opacos numa classificação.
Para testar, estes são os comandos do artigo:
git clone https://github.com/quarqlabs/agent-oss
cd agent-oss
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
# .env: OPENAI_API_KEY=sk-...  USER_ID=local_user  AGENT_ID=my_agent
python agent.py                      # o agente no terminal
uvicorn main:app --reload            # ou como servidor
curl -X POST http://127.0.0.1:8000/api/chat \
  -H "Content-Type: application/json" \
  -d '{"prompt": "What do you remember about me?"}'
python run_dataset_evals.py          # a avaliação completa
EVAL_WORKERS=4 python run_dataset_evals_parallel.py   # em paralelo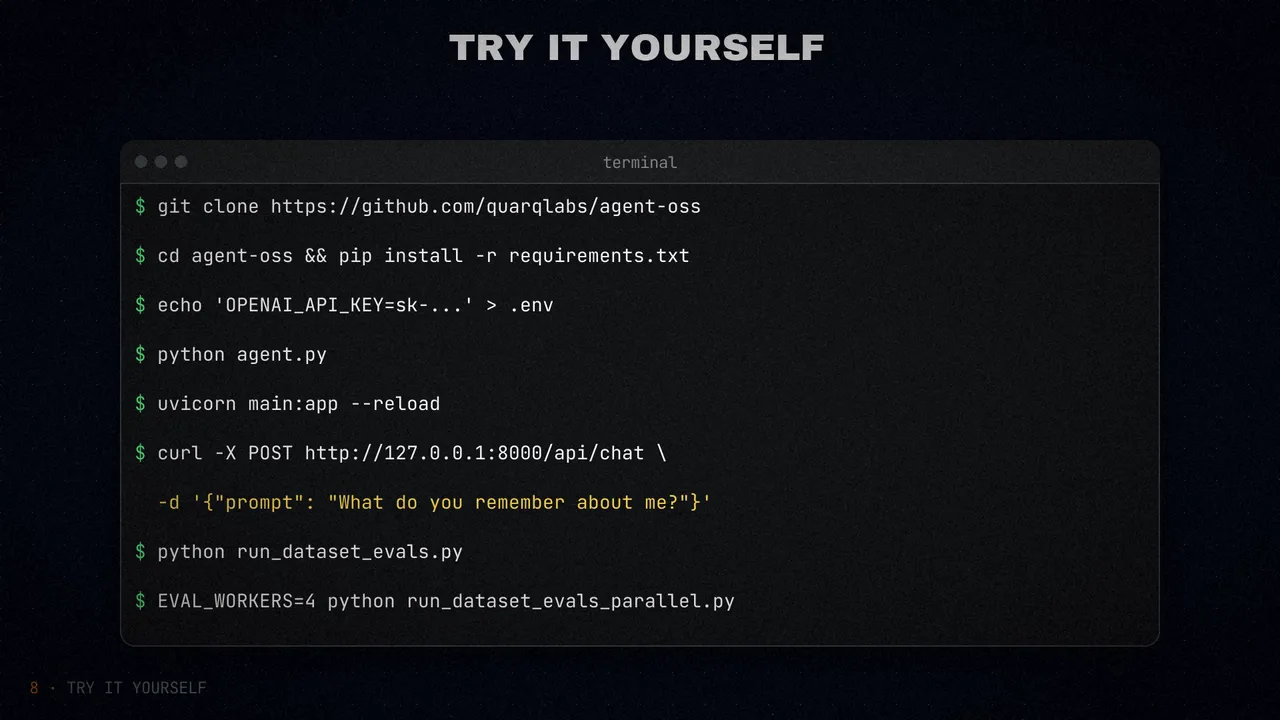
Um aviso se você for procurar: hoje o repositório se chama quarqlabs/argus («Argus Agent»). A documentação avisa que uma rodada completa do LongMemEval-S custou cerca de US$ 2.500, uns cinco por pergunta, então é melhor começar com poucas. Tudo está publicado com licença Apache 2.0.
Em resumo
O Quarq Agent chega a 98,2% no LongMemEval com uma arquitetura simples de propósito: três modelos especializados, busca híbrida local, regras rígidas para datas e números e uma segunda busca quando faltam provas.
Lembrar não é ler tudo: é encontrar o que importa, saber quando aconteceu e pedir mais provas antes de inventar.
O que você gostaria que o seu agente lembrasse?
Fontes
- «98.2% on LongMemEval: How We Built an Open-Source Agent That Actually Remembers», da Quarq (@quarqlabs), 1º de junho de 2026.
- O código: quarqlabs/argus (antes agent-oss) e o avaliador, quarqlabs/benchmarks.
- Sobre outro tipo de memória para agentes: meu post sobre a LLM Wiki do Karpathy.
- O vídeo, nos meus canais: inglês e espanhol.