Compilar en vez de buscar
La propuesta es sencilla. Un sistema RAG (generación aumentada por recuperación) busca trozos de texto en tus documentos en cuanto preguntas, los pega en el contexto y responde. La LLM Wiki hace otra cosa: el modelo lee tus fuentes una sola vez y las convierte en páginas de Markdown enlazadas entre sí. Esas páginas no se tiran: crecen y mejoran con cada fuente nueva.
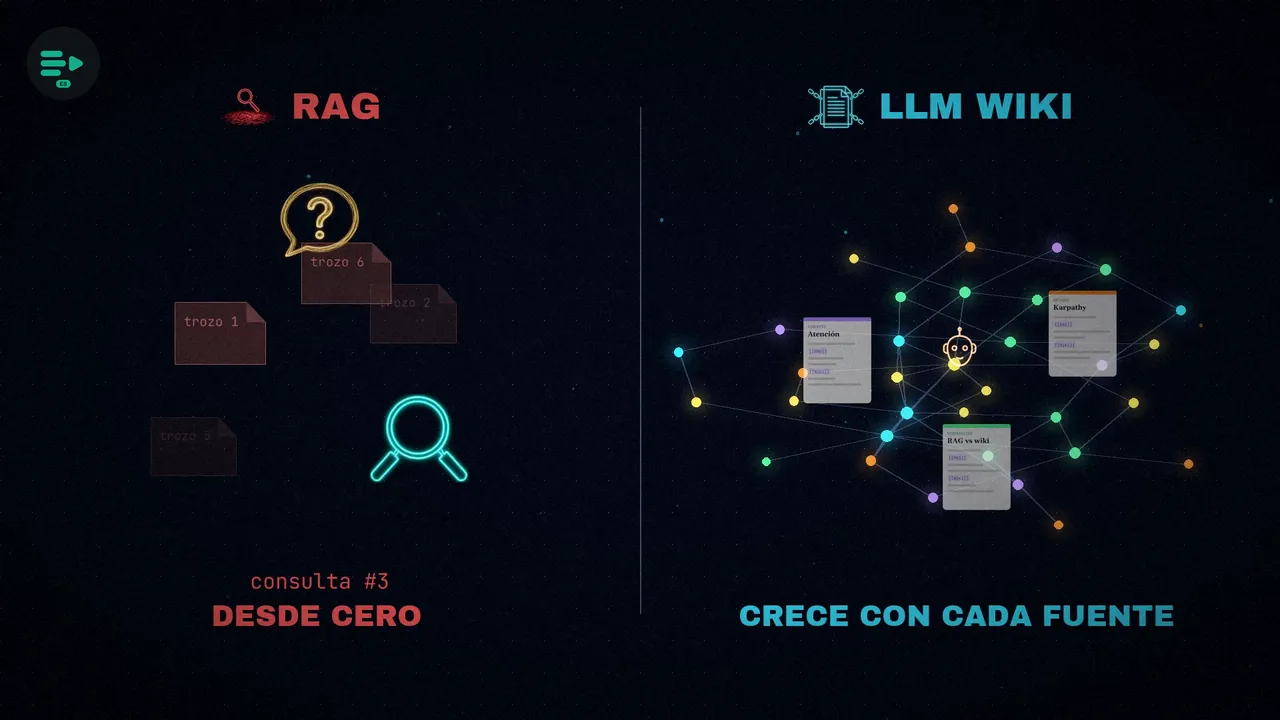
¿Por qué hace falta? Según el artículo, las tuberías RAG tradicionales fallan por un motivo: no tienen estado. Ante una pregunta recuperan fragmentos, los combinan, responden… y olvidan. La siguiente consulta empieza otra vez de cero. Así no se acumula nada: ni el conocimiento ni la síntesis que el modelo acaba de hacer.
Del código al conocimiento
A primeros de abril de 2026, Karpathy contó en X que su forma de trabajar con los modelos había cambiado. Ya no gasta la mayoría de sus tokens en escribir código, sino en organizar conocimiento: bases personales sobre los temas que investiga, guardadas como archivos de Markdown e imágenes dentro de Obsidian. El tuit pasó de 50.000 me gusta en pocos días.
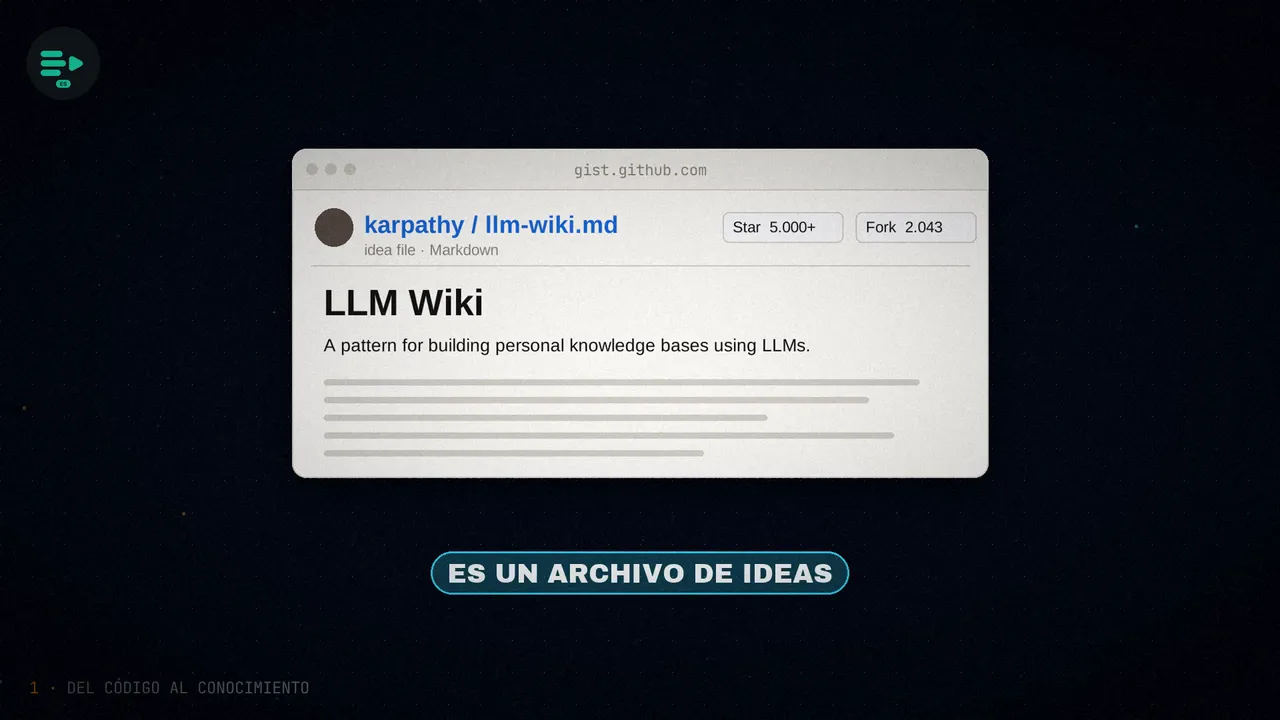
Después publicó en GitHub un documento titulado LLM Wiki. No es un programa: es un archivo de ideas, pensado para copiarlo y pegarlo tal cual en tu agente, ya sea Claude Code, Codex u OpenCode. El agente lo lee y construye contigo los detalles. En solo una semana ya había dos implementaciones funcionando.
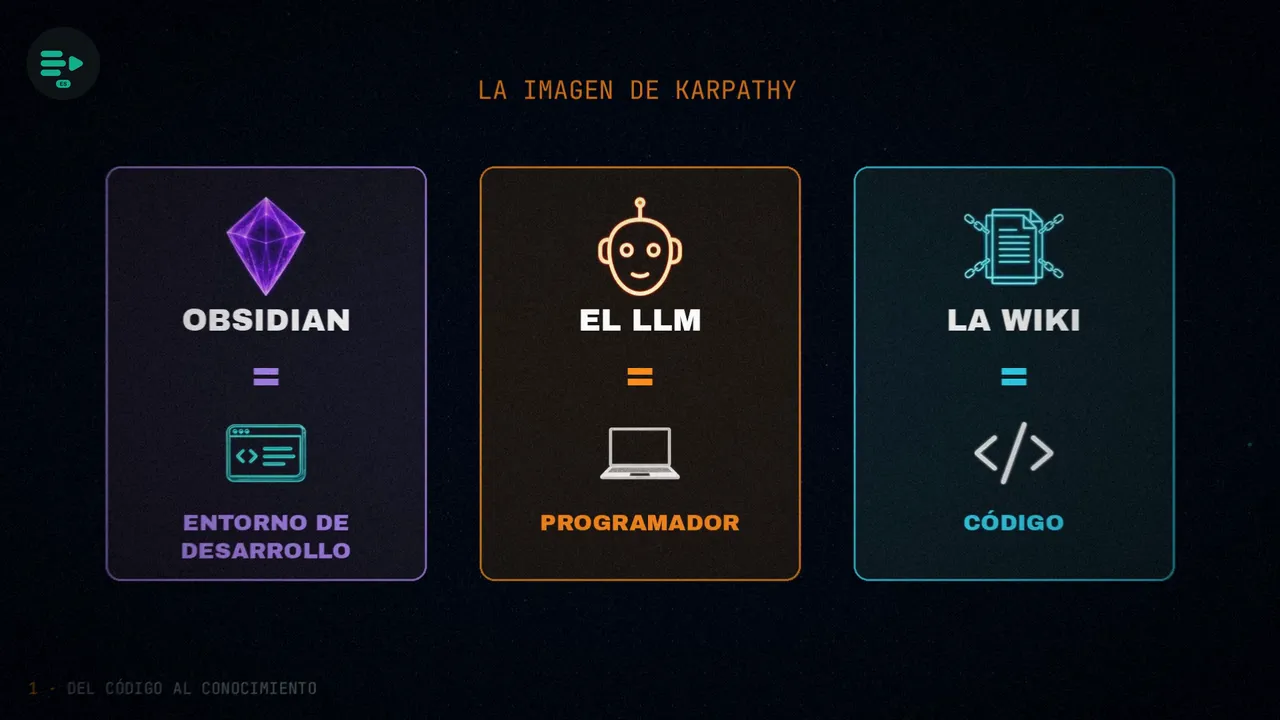
Para Karpathy, usar el modelo como un simple buscador desperdicia su capacidad. Su propuesta lo convierte en el encargado de una wiki: lee cada fuente una sola vez, la sintetiza en páginas estructuradas y las mantiene al día. En su documento lo resume con una imagen: Obsidian es el entorno de desarrollo, el LLM es el programador y la wiki es el código.
Las tres capas
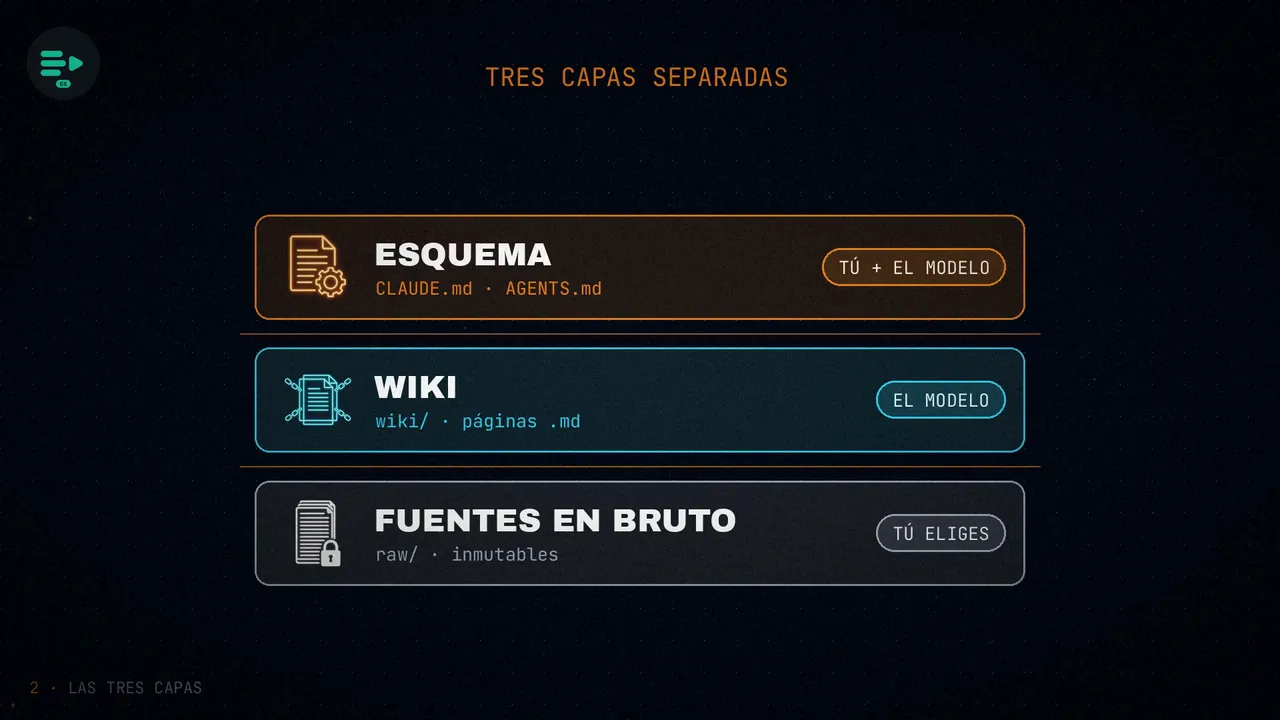
La arquitectura tiene tres capas separadas entre sí, y cada una tiene su dueño y sus reglas:
- Las fuentes en bruto. Artículos, papers, imágenes, datos y código, todo en una carpeta propia. Son inmutables: el modelo las lee, pero nunca las cambia. Karpathy reúne unos cien artículos por tema con el Web Clipper de Obsidian, y sus wikis compiladas suman unas 400.000 palabras.
- La wiki. Un directorio de archivos de Markdown que escribe el propio modelo: resúmenes, páginas de entidades y de conceptos, comparaciones y síntesis entre temas. Todo eso es suyo: la escribe, la reescribe y la reorganiza a medida que llegan fuentes y entiende mejor el tema. Las personas la leen y le preguntan, pero casi nunca la tocan.
- El esquema. Un documento de configuración, como
CLAUDE.mdoAGENTS.md, que fija la estructura de carpetas, cómo se nombran los archivos y qué pasos seguir en cada tarea. Es lo que convierte al modelo en un encargado disciplinado, y no en un chat genérico. Tú y el agente lo vais cambiando con el tiempo.
Las tres operaciones: ingesta, consulta y lint
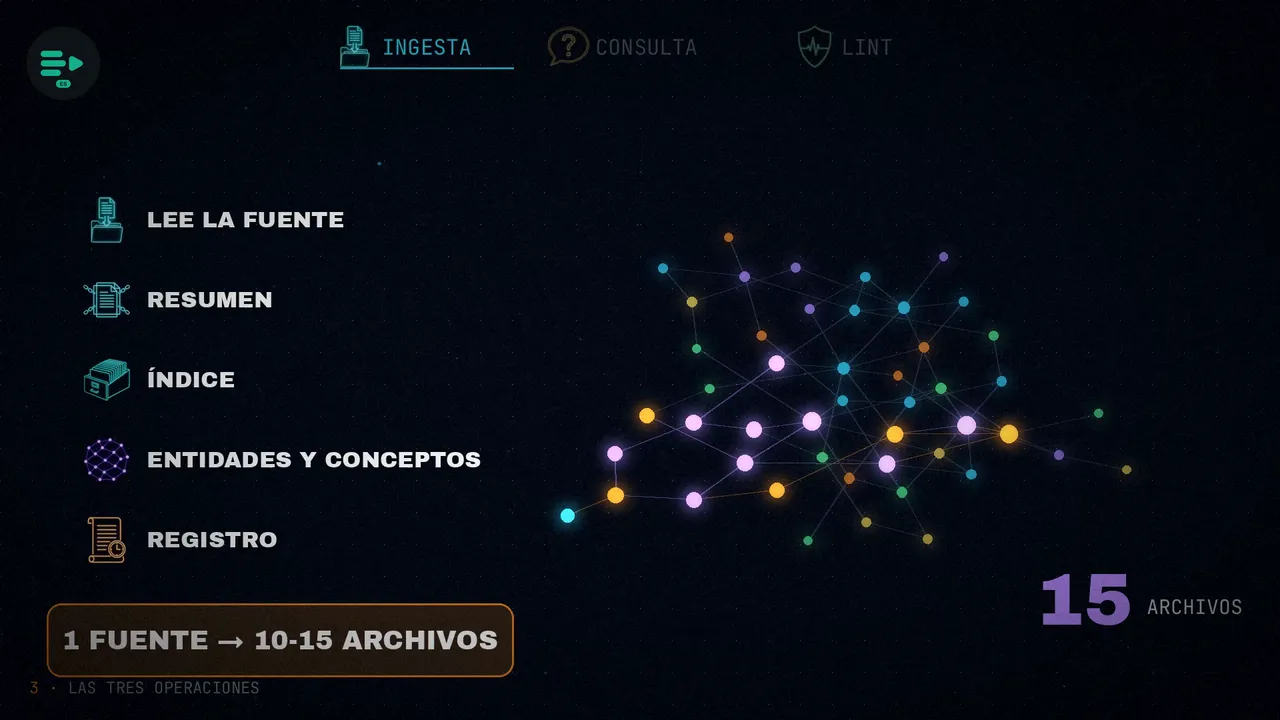
Sobre esas capas trabajan tres operaciones. La primera es la ingesta. Cuando entra una fuente nueva, el modelo la lee, escribe o actualiza su página de resumen, pone al día el índice, revisa las páginas de entidades y conceptos afectadas y anota la entrada en el registro. Una sola fuente suele tocar entre diez y quince archivos.
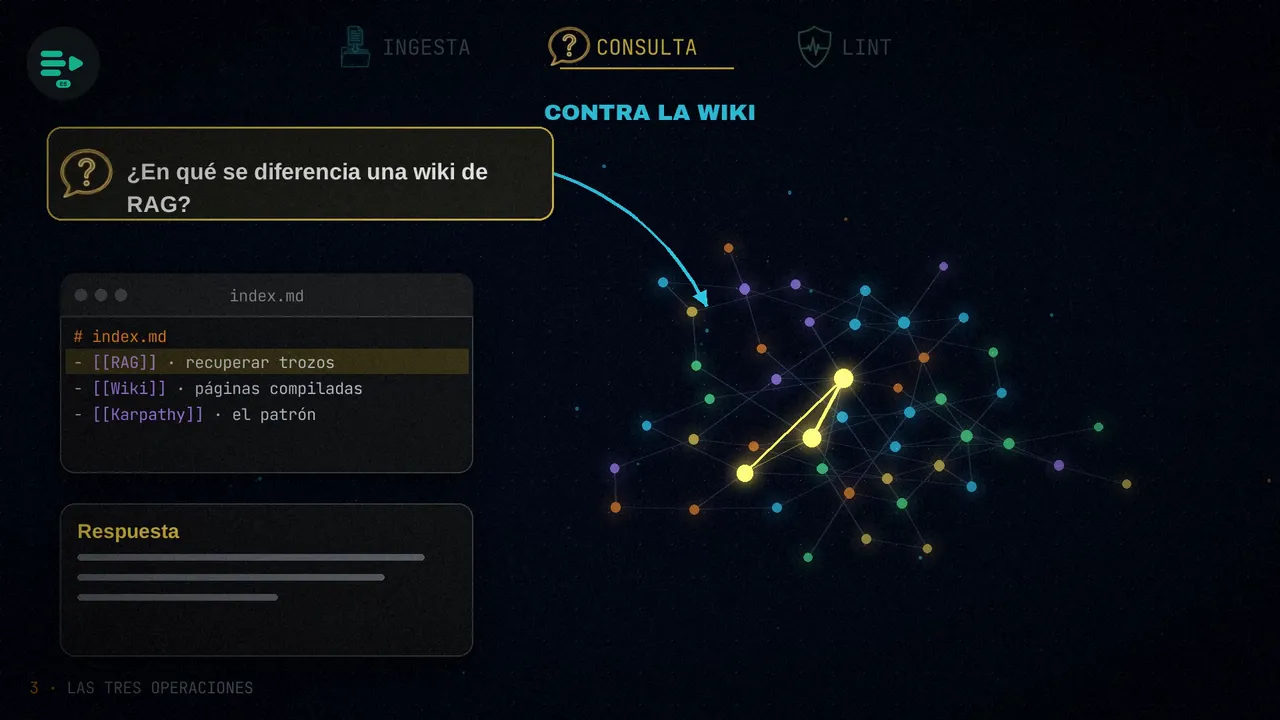
La segunda es la consulta. Las preguntas se responden contra la wiki, y no sobre los documentos originales. El modelo encuentra las páginas relevantes gracias al índice y responde con citas. Y si la respuesta vale la pena, la guarda en la wiki como una página nueva: así, tus propias dudas también suman.
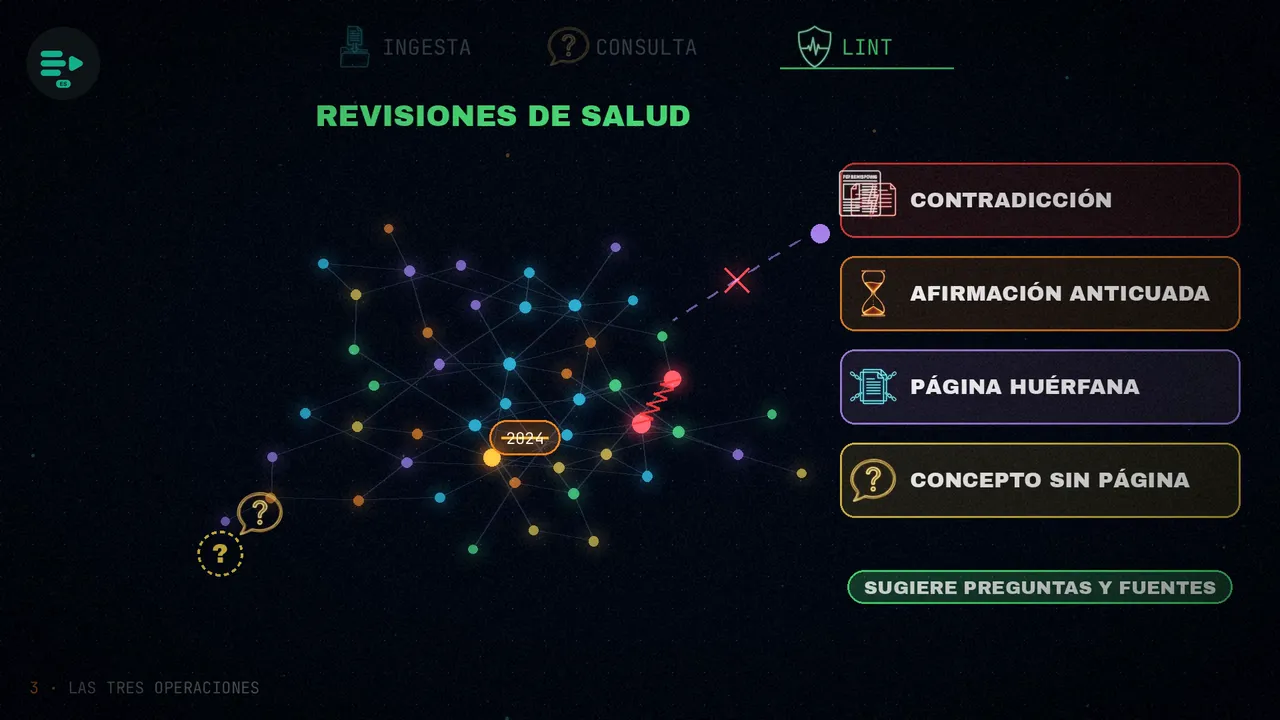
La tercera es el lint: revisiones de salud periódicas. El modelo busca contradicciones entre artículos de la wiki, afirmaciones que una fuente más reciente ha dejado anticuadas, páginas huérfanas a las que no llega ningún enlace y conceptos importantes que aún no tienen la suya. Después sugiere preguntas y fuentes nuevas para cubrir los huecos.
El índice, el log y qmd
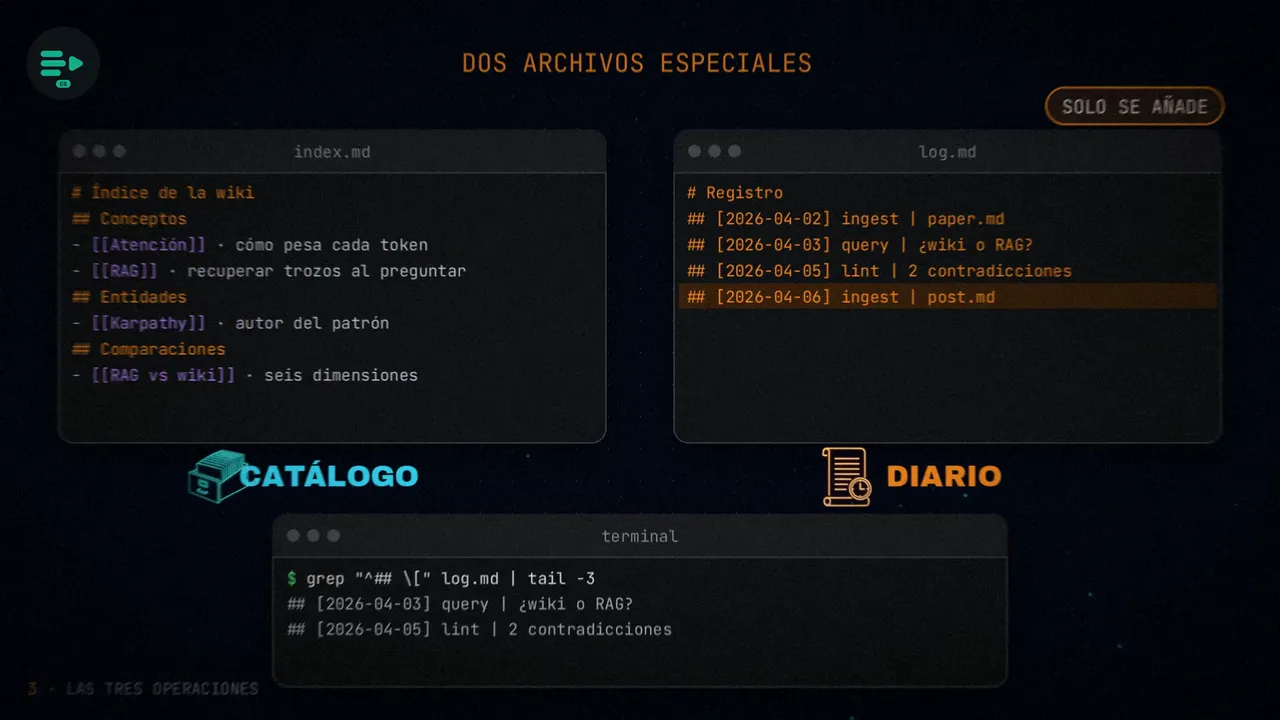
Dos archivos especiales mantienen todo unido. El índice (index.md) es un catálogo de todas las páginas de la wiki, por categorías y con un resumen de una línea. El log (log.md) es un registro cronológico al que solo se añaden entradas, una por ingesta, consulta o revisión. Como cada entrada empieza igual, se puede leer con herramientas básicas como grep y tail.
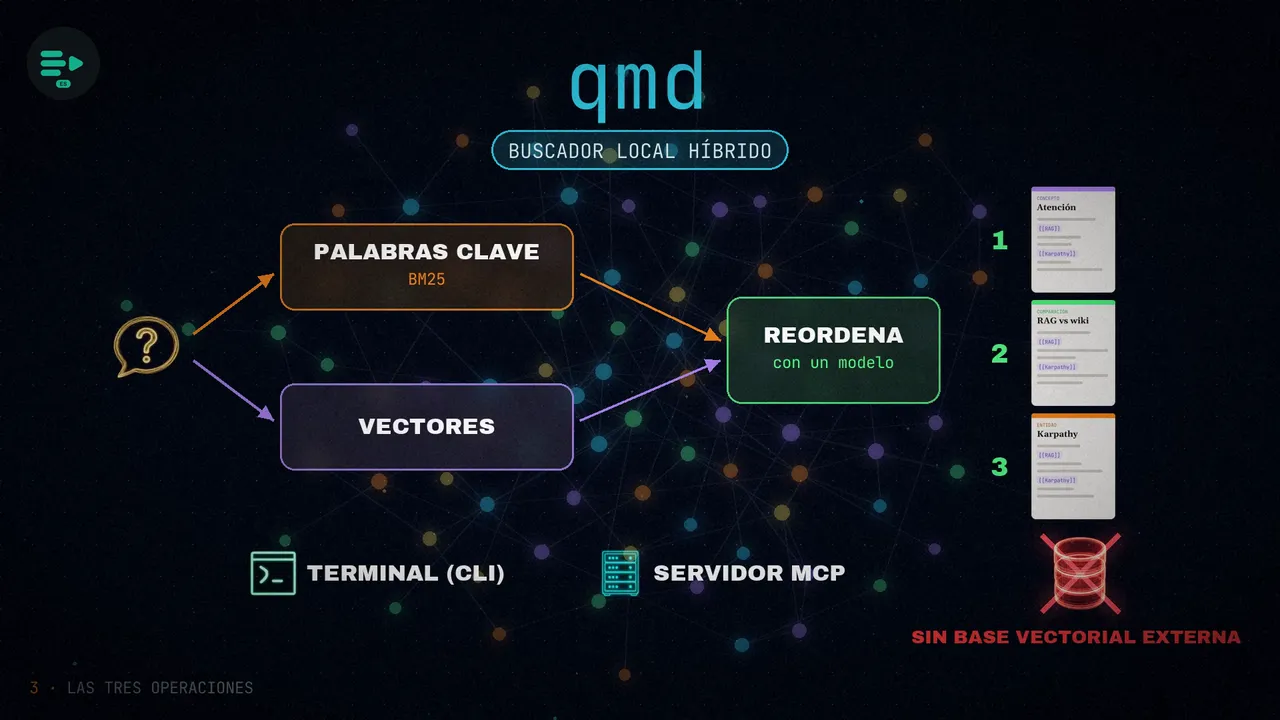
Para wikis más grandes, el documento recomienda qmd: un buscador local híbrido que combina palabras clave (con BM25) y vectores, y reordena los resultados con un modelo. Funciona desde la terminal o como servidor MCP, y busca rápido en los archivos de Markdown sin montar una base de datos vectorial externa.
El Memex: la pieza que faltaba
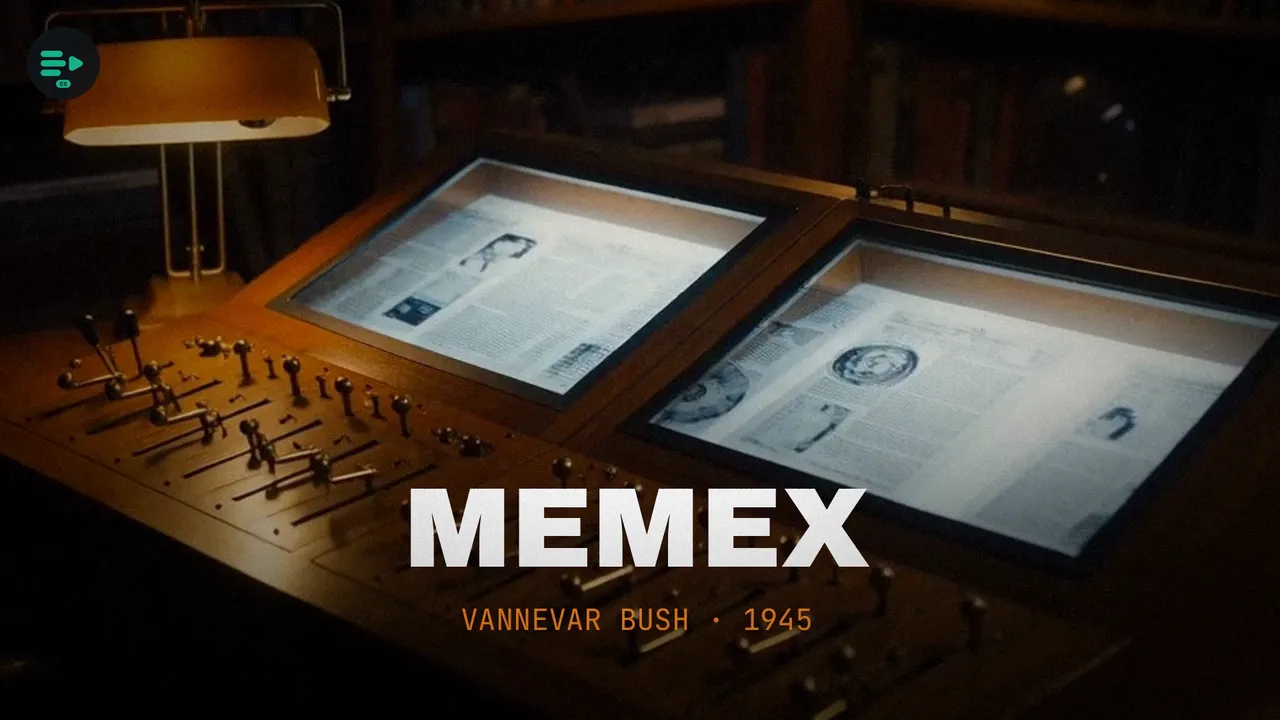
En el fondo, Karpathy conecta esta idea con el Memex, que Vannevar Bush imaginó en 1945: un almacén personal de conocimiento donde los rastros que unen unos documentos con otros importan tanto como los propios documentos.
El problema es que nadie quiere hacer el mantenimiento. Ese papeleo es justo lo que nos hace abandonar nuestras wikis. Los modelos pueden cerrar ese hueco: no se aburren, tocan de diez a quince archivos de una vez y propagan cada cambio por toda la wiki.
Las herramientas: Hermes Agent y Graphify
El documento de Karpathy es un archivo de ideas, no un programa. Pero a los pocos días de publicarlo, dos proyectos distintos ya tenían implementaciones que funcionaban.
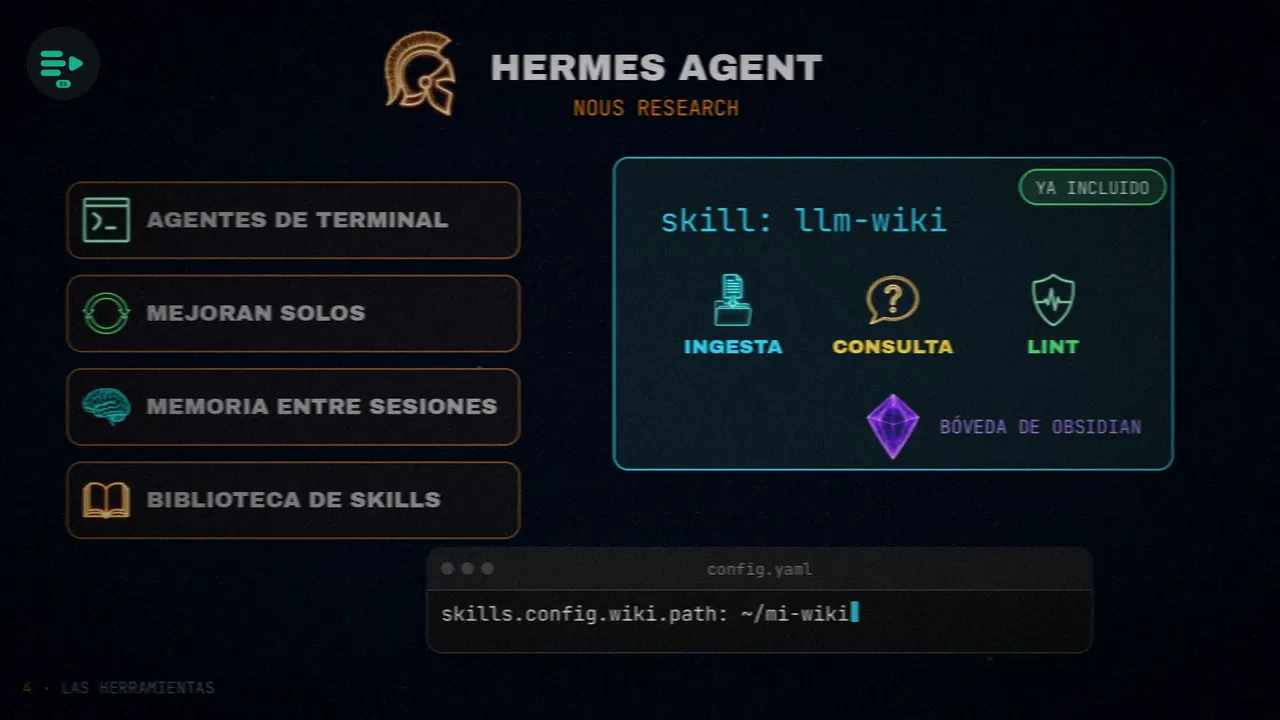
La primera es Hermes Agent, de Nous Research: un entorno para agentes de terminal que mejoran solos, con memoria entre sesiones y una biblioteca de habilidades. Trae el patrón ya incluido, como la skill llm-wiki, con sus tres operaciones sobre una bóveda de Obsidian. Para apuntarla a tu carpeta basta con un ajuste de configuración (skills.config.wiki.path).
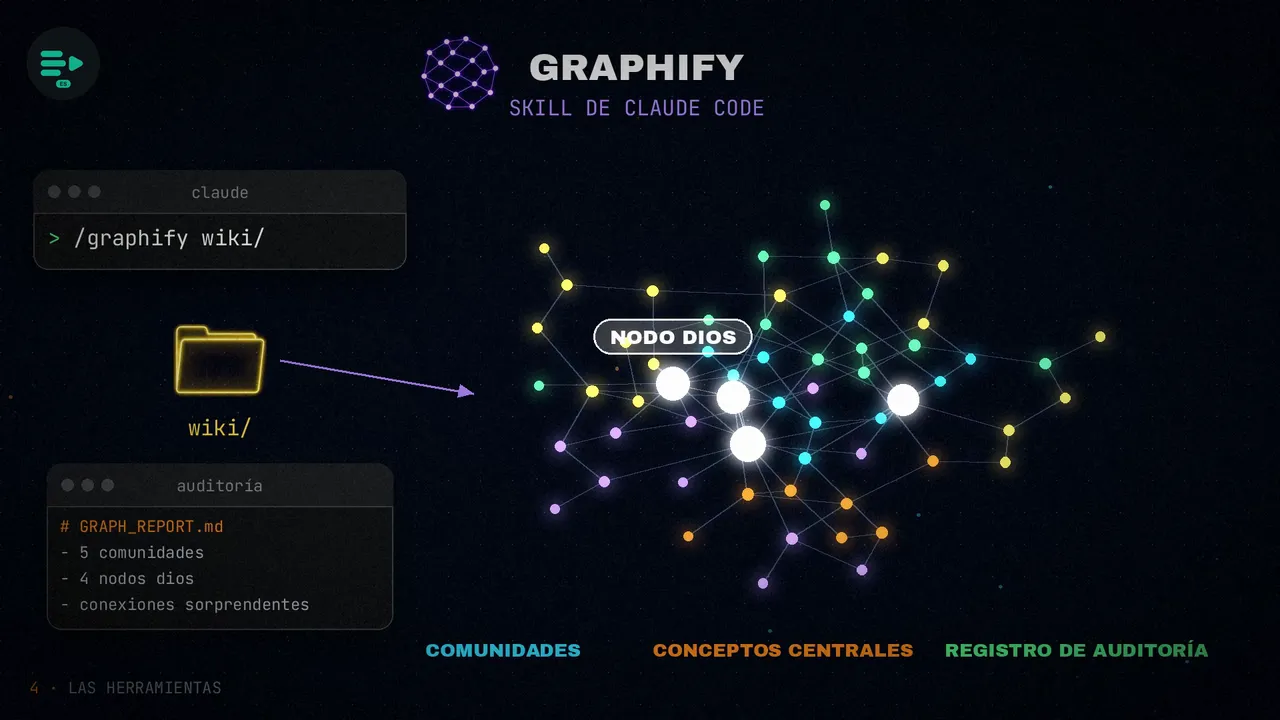
La segunda es Graphify, una skill de Claude Code que construye grafos de conocimiento a partir de cualquier carpeta. Si la apuntas a tu wiki, produce un grafo: detecta comunidades de ideas, analiza los conceptos centrales (que llama nodos dios) y deja un registro de auditoría.
Un apunte: el artículo da unos comandos de instalación para las dos que no coinciden con lo que dicen sus repositorios, así que aquí no los copio. Mira el README de cada una.
RAG, wiki o notas a mano
El artículo pone tres enfoques frente a frente: los sistemas RAG de siempre, el patrón de la wiki y la gestión manual del conocimiento, con aplicaciones de notas como Obsidian, Notion o Roam. Y los compara en seis dimensiones:
- Persistencia: ninguna, cada consulta empieza de cero.
- Síntesis: solo dentro de cada consulta.
- Mantenimiento: barato, basta con tener el índice al día.
- Infraestructura: base de datos vectorial, modelo de embeddings y tubería de recuperación.
- Consulta: una interfaz de recuperación programática.
- Modo de fallo: recupera trozos irrelevantes y no aprende nada.
- Persistencia: lo compilado se acumula y mejora.
- Síntesis: cruza documentos en cada ingesta.
- Mantenimiento: barato, porque los diez o quince cambios los hace el modelo.
- Infraestructura: archivos de Markdown en un repositorio de git y cualquier agente.
- Consulta: el modelo lee las páginas compiladas y sintetiza.
- Modo de fallo: puede incrustar en silencio errores de una mala fuente, y el lint solo atrapa algunos.
- Persistencia: depende del esfuerzo de la persona.
- Síntesis: solo si te molestas en hacerla.
- Mantenimiento: caro; la gente abandona sus wikis cuando el papeleo pesa más que lo que aportan.
- Infraestructura: una aplicación de notas y mucha disciplina.
- Consulta: buscas tú, con enlaces y vista de grafo.
- Modo de fallo: notas viejas, páginas huérfanas y, al final, dejas de mantenerlas.
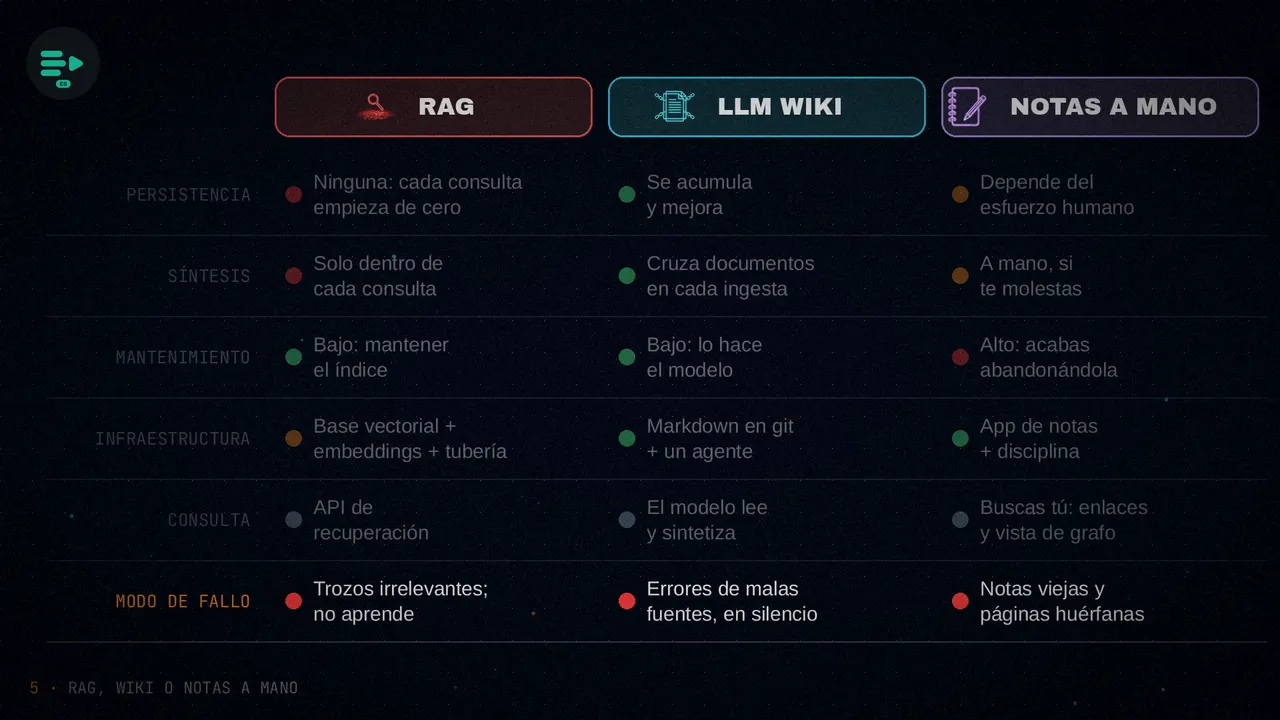
Ojo, porque esto no es una comparación con pruebas medidas. No hay datos publicados que enfrenten las respuestas de una wiki compilada con las de RAG, ni en precisión ni en completitud. Lo que se compara es la arquitectura: cómo está construido cada sistema, no cuál responde mejor.
Con todo, el patrón queda justo en medio. De RAG toma la automatización, pero cambia la recuperación sin memoria por una compilación que persiste. De las notas a mano se queda con una estructura que una persona puede leer, pero deja el mantenimiento al modelo. Y las herramientas de grafos, como Graphify o los servidores MCP de grafos de conocimiento, añaden algo que ni RAG ni Obsidian traen de serie: detectar comunidades de temas, encontrar los conceptos que hacen de centro y trazar caminos entre ideas muy lejanas.
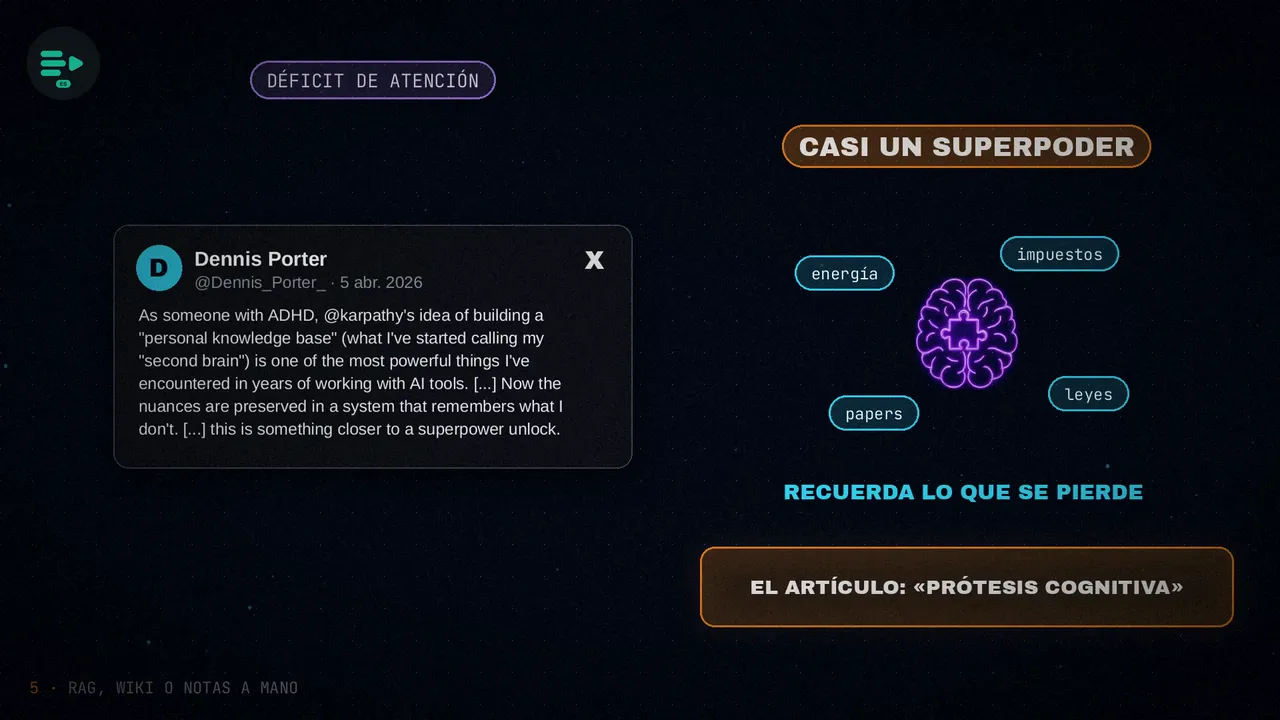
La comunidad ya le ha puesto nombre: el segundo cerebro. Hay tutoriales en YouTube para montar bases de conocimiento mantenidas por un modelo, revisar literatura científica o analizar a la competencia. Y Dennis Porter, que tiene TDAH, contó en X que para él es casi un superpoder: el sistema recuerda los matices que él perdía al cambiar de tema. El artículo lo llama una «prótesis cognitiva», aunque esa expresión no está en su tuit.
Los límites
Hay tres que ni el documento ni sus implementaciones resuelven:
- El techo de la ventana de contexto. Karpathy habló de wikis de unas 400.000 palabras, unos cien artículos, pero no se sabe dónde está el límite. Graphify lo esquiva, porque trabaja sobre la estructura de archivos.
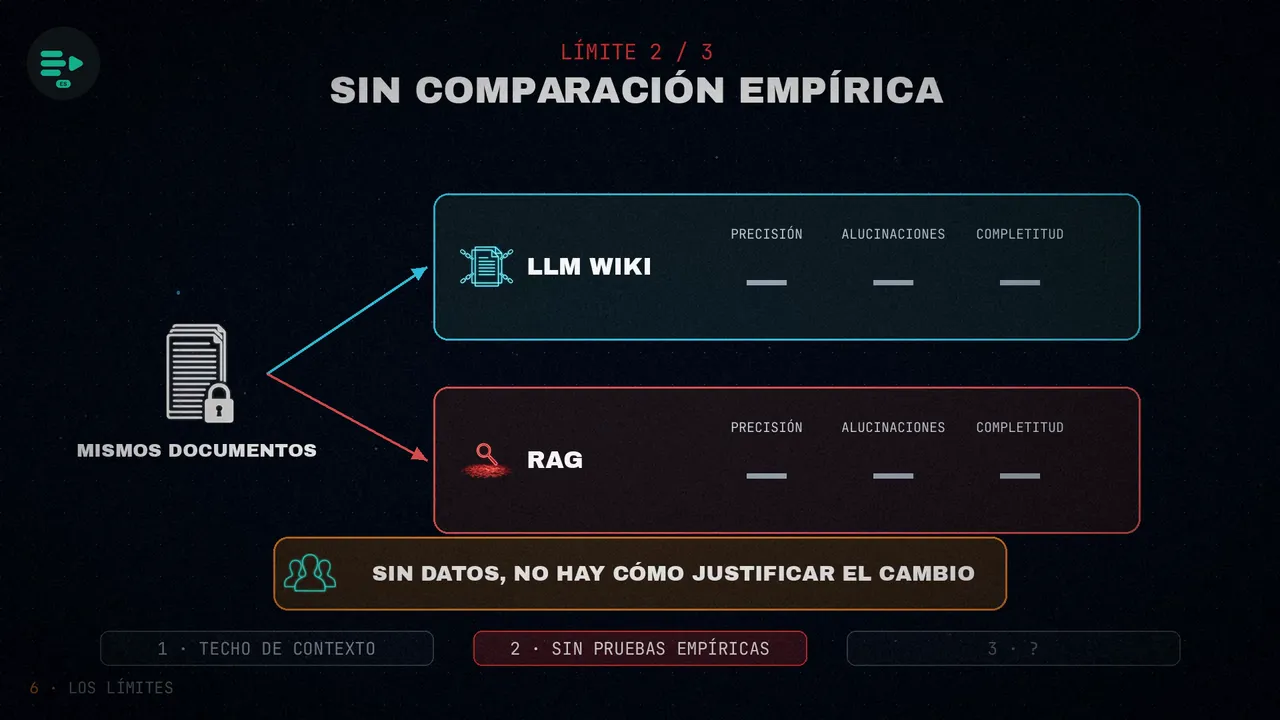
- No hay una comparación empírica de calidad. Que el conocimiento compilado sea mejor que la recuperación sin estado es un argumento de arquitectura, no un resultado medido. Nadie ha publicado pruebas que comparen las dos opciones con los mismos documentos, en precisión, alucinaciones o completitud. Y sin datos, los equipos no pueden justificar el cambio.
- Resolver contradicciones a gran escala. El lint las señala, pero no hay un protocolo para los desacuerdos legítimos, que abundan en campos que se mueven rápido, como la investigación en IA. La wiki funciona con la regla de que gana la última escritura, y eso pone en riesgo su fiabilidad como referencia cuando pasa de cien artículos.
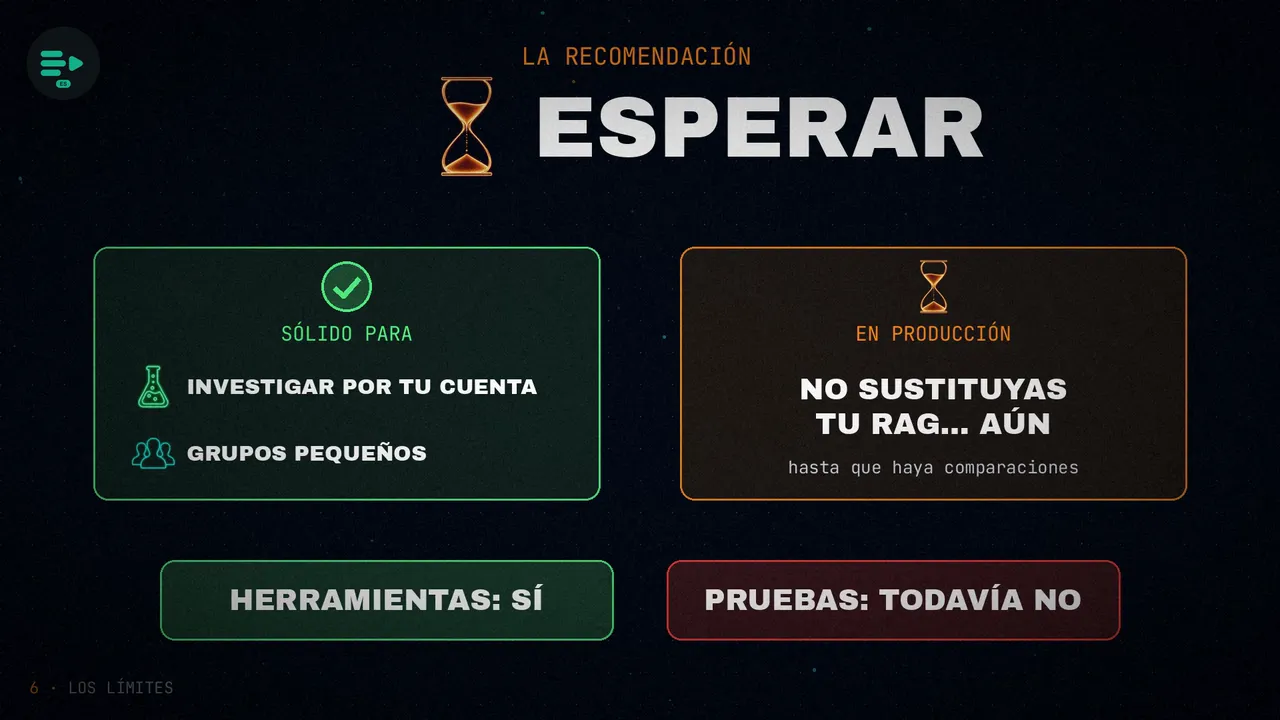
Por eso, la recomendación del artículo es esperar. El patrón es sólido para investigar por tu cuenta o para experimentos en grupos pequeños. Pero los equipos en producción deberían aguantar antes de sustituir su infraestructura de RAG, hasta que haya comparaciones que demuestren que responde mejor. Las herramientas existen; las pruebas, todavía no.
¿Para quién es?
- Ingenieros de aprendizaje automático, investigadores y desarrolladores que trabajan solos.
- Grandes revisiones de literatura, análisis de competencia o sistemas personales de conocimiento.
- Sobre todo, a quien ya usa Obsidian y quiere que un modelo lo mantenga sin montar infraestructura nueva.
- Equipos que necesitan recuperar al momento datos que cambian a menudo, porque compilar lleva su tiempo.
- Empresas con requisitos de cumplimiento para la documentación generada por IA, ya que no hay una revisión humana obligatoria.
- Quien necesite consultas estructuradas, con SQL o GraphQL, en vez de navegar por archivos de Markdown.
Móntala en 10 minutos
La propuesta práctica del artículo: monta tu propia wiki, en lugar de leer y olvidar en el chat. Empieza en un directorio vacío, que será también tu bóveda de Obsidian. Dentro van las fuentes en bruto, separadas en artículos, papers, repositorios e imágenes; la wiki, con entidades, temas, comparaciones, cronologías y preguntas; y tres archivos: el índice, el log y CLAUDE.md.
mkdir my-wiki && cd my-wiki
git init
mkdir -p raw/{articles,papers,repos,images}
mkdir -p wiki/{entities,topics,comparisons,timelines,qa}
touch index.md log.md CLAUDE.md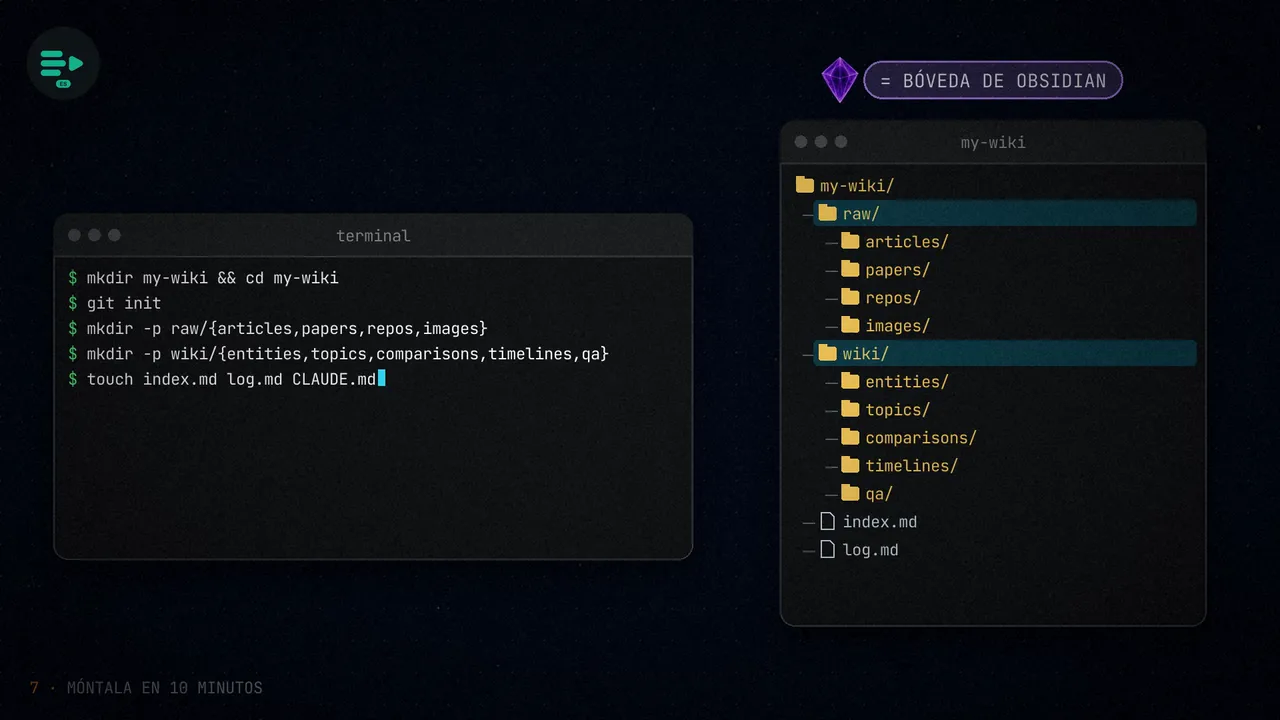
El archivo clave es CLAUDE.md. Pega dentro el documento de Karpathy, entero o recortado, y añade tu tema, las reglas de las carpetas, cómo se nombran los archivos y los tres protocolos: ingesta, consulta y lint. Claude Code lo lee solo al empezar cada sesión.
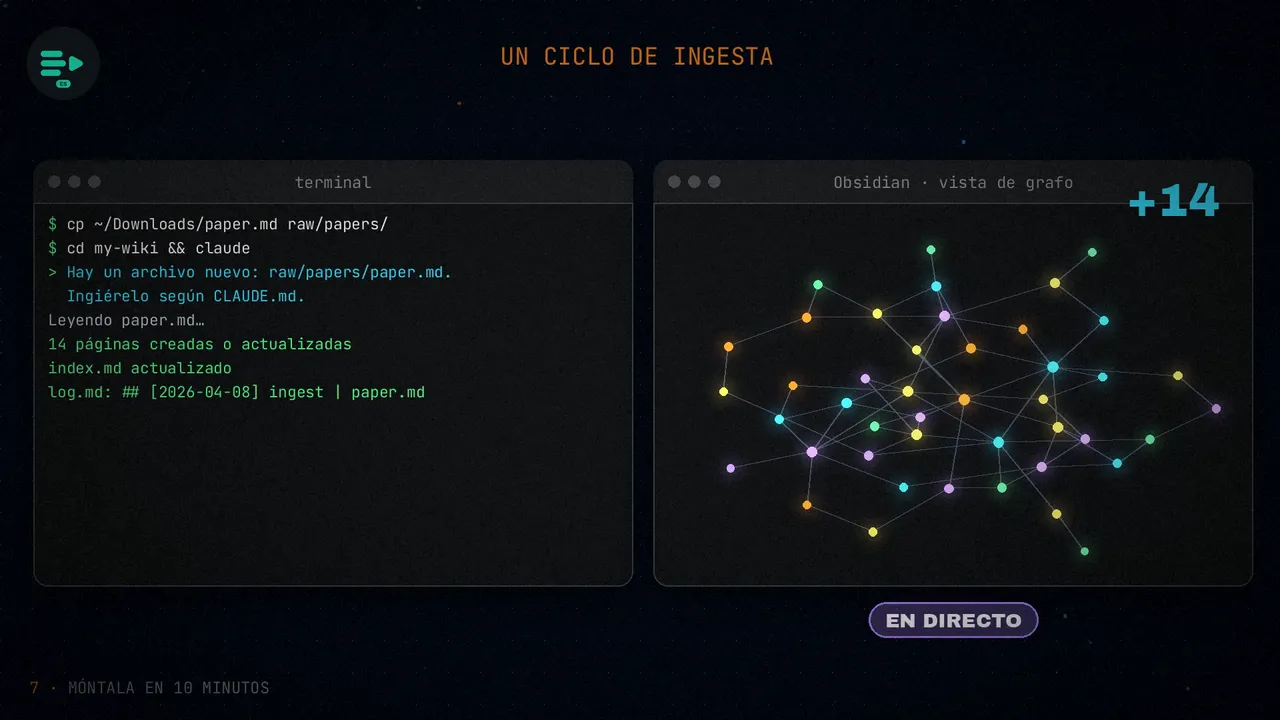
Para ingerir una fuente, cópiala a la carpeta de papers, abre Claude Code en la wiki y pídele algo como: «Hay un archivo nuevo: raw/papers/paper.md. Ingiérelo según CLAUDE.md». El agente lo lee, crea o actualiza entre diez y quince páginas, pone al día el índice y anota la operación en el log. Si abres la bóveda en Obsidian, verás crecer el grafo en directo.
Y hay atajos. Con Hermes Agent no hace falta escribir el archivo de instrucciones: apuntas su ajuste de la wiki a tu bóveda y lanzas la ingesta. Graphify se ejecuta sobre la wiki y te da un grafo con grupos de temas y nodos centrales encima de tus páginas. Y cuando pases de quinientas páginas, añade qmd, para que el agente acote qué leer antes de abrir nada.
En resumen
Karpathy propone que el modelo no rebusque en tus documentos cada vez, sino que los compile una sola vez en una wiki que crece. Capas separadas, tres operaciones y un aviso: aún faltan pruebas de que responda mejor que la recuperación clásica.
No le pidas al modelo que rebusque cada vez: pídele que compile una vez y mantenga lo que sabe.
¿Te montarías tu propia wiki, o te quedas con RAG?
Fuentes
- «How Karpathy’s LLM Wiki Works, And How to Actually Set it Up», de AlphaSignal (@AlphaSignalAI), 8 de abril de 2026.
- El documento «LLM Wiki» de Andrej Karpathy, y su tuit del 2 de abril de 2026.
- El tuit de Dennis Porter sobre su segundo cerebro.
- Sobre cómo recuperar información sin RAG: mi post sobre el sistema de archivos virtual de Mintlify.
- El vídeo, en mis canales: español e inglés.