Dos tarjetas de 24 GiB no son una sola de 48
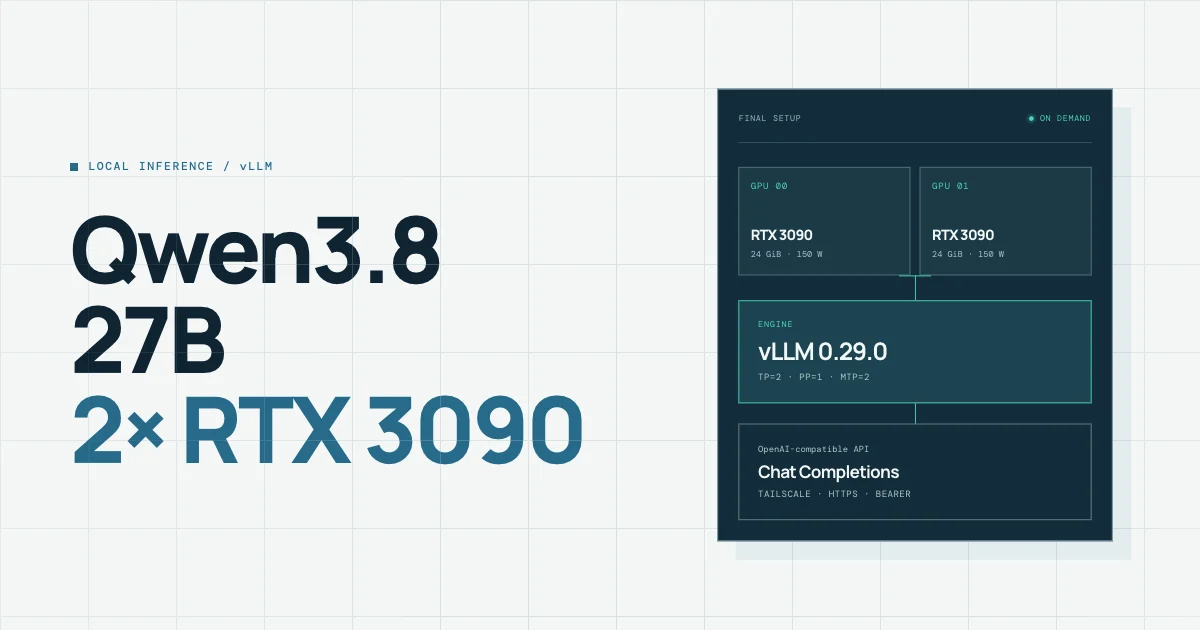
Partimos de un ordenador de sobremesa convertido en servidor personal. Tiene dos tarjetas gráficas NVIDIA RTX 3090, cada una con 24 GiB de memoria de vídeo o VRAM: el espacio donde deben caber los pesos del modelo y la memoria temporal de la conversación. Queríamos servir Qwen3.8-27B a nuestros dispositivos sin dedicarle permanentemente ambas tarjetas ni exponerlo a Internet.
Los archivos de Qwen permanecen guardados en el disco, pero eso no significa que el modelo esté siempre funcionando. Cuando está dormido, sus pesos no están cargados en la memoria de las GPU: no hay un proceso de inferencia ocupando las dos tarjetas. Al pulsar «despertar» en Home Assistant se inicia el servicio, se cargan los pesos desde el disco a las GPU y esperamos a que indique «listo». Entonces podemos enviarle peticiones desde el móvil o el Mac. Si transcurren 15 minutos sin solicitudes, se apaga, descarga el modelo y deja libres las GPU para otros modelos.
Qwen3.8-27B tiene unos 27.000 millones de parámetros: números aprendidos durante el entrenamiento que se cargan como pesos para producir texto. Cada GPU dispone de su propia VRAM; sus 24 + 24 GiB no se fusionan automáticamente. Para alojar el modelo en ambas hay que repartir trabajo y datos, y lo que se intercambia entre ellas puede volverse un cuello de botella.
Las tarjetas están conectadas a la placa mediante PCI Express (PCIe), el bus de comunicación del ordenador. Una trabaja con un enlace x16, dieciséis «carriles» de datos, y la otra con x4, cuatro carriles. Es una diferencia de capacidad del enlace, no una promesa de que toda la inferencia vaya cuatro veces más lenta: importa cuánto tengan que comunicarse. La herramienta nvidia-smi topo -m etiquetó su ruta como PHB, abreviatura de PCIe Host Bridge: para comunicarse atraviesan PCIe y un puente del sistema, en vez de disponer de un enlace directo entre tarjetas. La alternativa sería instalar un puente NVLink: los datos que intercambian las dos GPU viajarían por ese enlace directo, sin recorrer esa ruta por la placa base. No lo instalamos porque el puente compatible es caro y aún habría que comprobar que encaja físicamente entre estas dos tarjetas; dejamos la compra para más adelante.
Comprobamos además que en este montaje no había comunicación P2P utilizable ni un enlace NVLink activo. P2P (peer-to-peer) permite que una GPU acceda directamente a memoria de otra cuando la plataforma lo admite; NVLink es un enlace físico de alta velocidad que puede facilitar ese intercambio. PHB describe la topología, pero por sí solo no prueba si P2P funciona: lo verificamos aparte. Sin un camino rápido garantizado, no era obvio cuál era la mejor forma de repartir Qwen.
Las dos hacen la misma etapa
Paralelismo tensorial (TP): dividimos los cálculos de una misma capa del modelo entre GPU 0 y GPU 1. Trabajan a la vez en partes de la misma operación y después reúnen los resultados. Es como dos personas resolviendo mitades de un mismo problema y comparando notas en cada paso: puede acelerar, pero exige comunicarse con frecuencia.
Cada una hace etapas distintas
Paralelismo de pipeline (PP): ponemos las primeras capas en una GPU y las siguientes en la otra. Una procesa su tramo y pasa el resultado intermedio a la siguiente, como dos puestos de una cadena de montaje. Se intercambian datos en menos puntos, pero para una sola solicitud puede haber una GPU esperando a la otra.
Ésa fue una pregunta central del experimento: en este PC, con PCIe x16/x4 y sin P2P/NVLink operativo, ¿compensa la simultaneidad de TP pese a sus intercambios frecuentes, o la menor comunicación de PP? Más adelante veremos cómo lo medimos manteniendo lo demás constante.
El ordenador se alimenta a través de un SAI (sistema de alimentación ininterrumpida, o UPS): una batería con electrónica que mantiene el equipo encendido durante un corte y mide la carga eléctrica. El nuestro admite 900 W reales. Un tope de 150 o 200 W por GPU no limita el consumo de la CPU, ventiladores, discos y pérdidas de alimentación; por eso vigilamos la carga total que registra el SAI.
Fijamos un aborto preventivo al 85 % de su capacidad, unos 765 W según su valor nominal: deja alrededor de 135 W de margen nominal frente a los 900 W. Es un umbral elegido para estas pruebas, no una regla universal ni una garantía contra picos más breves que el muestreo. Si se rebasaba, parábamos la prueba y limpiábamos el entorno.
Primero, una base que pueda verificarse
Antes de comparar motores preparamos el sistema: Ubuntu 24.04, Docker para aislar procesos, el controlador de las GPU y un modelo descargado y verificado. No basta con tener dos tarjetas instaladas: el programa de inferencia debe poder verlas, usar la versión correcta de sus bibliotecas y encontrar todos los archivos del modelo.
El controlador NVIDIA es el software del sistema operativo que habla con las GPU. «Validado» aquí no significa simplemente «la versión más reciente»: comprobamos que el módulo cargado y las bibliotecas NVIDIA de usuario coinciden, que nvidia-smi funciona, que ambas tarjetas ejecutan cómputo CUDA y que el servicio real arranca y se detiene limpiamente. Tras una actualización de septiembre, la versión actual fijada es 595.91.07; antes de reiniciar hubo una mezcla entre el módulo anterior y las bibliotecas nuevas que impedía usar las GPU. El reinicio y las pruebas posteriores corrigieron y verificaron esa situación.
NVIDIA Container Toolkit es la capa que permite a un contenedor Docker solicitar las GPU y recibir los dispositivos y componentes del controlador necesarios. Docker aísla el proceso, pero por sí solo no le da acceso correcto al hardware NVIDIA. En este equipo quedó instalado el Toolkit 1.20.1; se configuró con nvidia-ctk y se comprobó desde un contenedor. El controlador permanece en el host, el ordenador físico; no se instala uno independiente dentro de cada contenedor.
El modelo principal es el checkpoint oficial Qwen3.8-27B-FP8. Un checkpoint es el conjunto de archivos con los pesos y la configuración del modelo. La alternativa para llama.cpp utilizó el formato GGUF UD-Q8_K_XL de Unsloth; GGUF empaqueta el modelo en un formato que llama.cpp puede cargar.
- 01
Validar host y energía
Comprobar ambas GPU con
nvidia-smi, su recorrido PCIe connvidia-smi topo -m, refrigeración, memoria y almacenamiento. Confirmar que el SAI está en línea y que podemos medir su carga; establecer la parada preventiva del 85 % antes de cargar los pesos. - 02
Dar GPU a Docker
Instalar Docker y NVIDIA Container Toolkit, que presenta las GPU del host a los contenedores. Configurar el runtime con
nvidia-ctky verificar ambas GPU desde un contenedor de prueba. La guía oficial de NVIDIA explica los pasos y requisitos actuales. - 03
Fijar archivos concretos
No descargar «lo último» en cada arranque. Elegimos una revisión exacta del checkpoint, verificamos el inventario y los hashes de sus fragmentos y montamos esa copia solo lectura. También fijamos y auditamos la imagen del motor vLLM para saber qué código ejecutábamos.
- 04
Probar sin dejar residuos
Ejecutamos un ensayo cada vez. Un bloqueo de GPU impide que dos modelos administrados compitan por las tarjetas; aplicamos topes de potencia, red Docker interna sin puertos abiertos en el host y límites del contenedor. Tras cada ensayo, incluso fallido, retiramos contenedor y red y restauramos la potencia.
Para que la instalación sea repetible, el cliente de Hugging Face permite fijar una revisión exacta. Usamos además un descargador que comprobó con SHA-256 cada fragmento, una huella digital del archivo. El comando siguiente ilustra la selección de revisión, no reemplaza todas esas comprobaciones.
hf download Qwen/Qwen3.8-27B-FP8 \
  --revision 017b9c7af6b5689d5dd426a76e0bc077eb5ca20a \
  --local-dir /ruta/protegida/qwen-fp8
Después: valida inventario y hashes, restringe permisos, y monta el snapshot en el contenedor como solo lectura. No es aconsejable descargar desde el proceso de inferencia.
nvidia-smi --query-gpu=index,name,memory.total,power.limit --format=csv
nvidia-smi topo -m
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Comandos orientativos, no un instalador transaccional. En un host existente, revisa antes daemon.json y el efecto de reiniciar Docker sobre otros servicios.
Había otra decisión de memoria. BF16 guarda cada peso en 16 bits; los pesos oficiales en ese formato superaban la VRAM disponible incluso antes de reservar memoria para procesar las solicitudes. Elegimos la variante FP8, de 8 bits por peso. Las RTX 3090 no hacen cálculo FP8 nativo: vLLM utilizó Marlin, una implementación que aprovecha los pesos comprimidos y calcula con activaciones FP16. Así cupo el modelo, pero «usar pesos FP8» no significa que todo el cálculo fuese FP8.
Estos son los parámetros esenciales del motor finalmente elegido. TP=2 significa que las dos GPU participan en cada etapa; PP=1, que no se encadenan dos tramos distintos del modelo. MTP=2 adelanta dos candidatos de texto, como explicaremos después. El comando va dentro del contenedor aislado, con el checkpoint ya montado; por sí solo no crea el límite de 150 W, el control del SAI, el bloqueo GPU, la autenticación ni la política de red.
vllm serve /models/qwen3.8-27b \
  --served-model-name qwen3.8-27b \
  --tensor-parallel-size 2 --pipeline-parallel-size 1 \
  --distributed-executor-backend mp \
  --dtype float16 --linear-backend marlin \
  --max-model-len 32768 --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --gpu-memory-utilization 0.90 --kv-cache-dtype fp8 \
  --enable-prefix-caching --enforce-eager \
  --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Flags dependientes de vLLM 0.29.0. El servidor escucha solo en la red privada del contenedor; no publiques su puerto en el host. El gestor externo vigila salud, potencia, SAI y limpieza.
Medimos el sistema, no solo tokens por segundo
No queríamos elegir una configuración solo porque una cifra de velocidad pareciera alta. Repetimos una batería de 22 casos sintéticos: aritmética, separación del razonamiento, formato de llamadas a herramientas sin ejecutarlas, textos de entrada de varios tamaños, doce solicitudes de estabilidad, respuesta en streaming y prueba de caché.
Un token es una unidad de texto que el modelo lee o escribe: puede ser una palabra, parte de una palabra o un signo. Cuantos más tokens caben en la entrada, más código o conversación podemos enviar en una sola petición. Configuramos una ventana máxima de 32.768, pero lo que realmente comprobamos en la batería fue hasta 27.064 tokens de entrada; no confundimos ajuste con prueba.
¿Responde correctamente?
Los 22 casos, incluidas llamadas a herramientas con el formato esperado. Una llamada a herramienta es una propuesta estructurada del modelo; en el ensayo no dejamos que ejecutara código ni acciones reales.
¿Cuánto tarda?
TTFT (time to first token) mide la espera hasta el primer fragmento de respuesta. Los tokens por segundo miden la velocidad posterior de escritura. Medimos ambos: un motor puede escribir deprisa y, aun así, tardar en empezar.
¿A qué coste?
VRAM por GPU, temperatura, carga del SAI, la batería de respaldo, y energía GPU aproximada por token de salida. La expresamos en mWh por token, milivatios-hora consumidos por las GPU para producir un token. Procede de muestras de potencia y no equivale al consumo total medido en el enchufe.
También separamos las pruebas de caché fría y caché caliente. Si una entrada repite un prefijo ya procesado, el motor puede reutilizar cálculos y responder antes. Eso es útil, pero no sería honesto presentar el tiempo de una repetición como si fuera el de una solicitud nueva.
Dos motores, dos formatos de pesos
Un motor de inferencia es el programa que carga el checkpoint y sirve respuestas. Probamos dos: vLLM, pensado para atender solicitudes de modelos grandes, y llama.cpp, una alternativa que trabaja con archivos GGUF. En la primera comparación, con cada GPU limitada a 250 W, llama.cpp consumió menos energía GPU por token; vLLM con MTP=2 inició antes la respuesta y escribió algo más rápido.
No se trata de instalar dos «sabores» idénticos del mismo archivo. vLLM leyó el checkpoint FP8 oficial mediante Marlin; llama.cpp leyó la conversión GGUF Q8. Ambos representan Qwen3.8-27B, pero sus formatos y métodos de cálculo difieren. Por eso la tabla compara pilas prácticas completas, no aísla científicamente el efecto de cambiar solo de motor.
| Motor / perfil | TTFT | Salida | Energía GPU | Máx. |
|---|---|---|---|---|
| vLLM · FP8/Marlin · MTP=0 | 189 ms | 13,526 tok/s | 21,43 mWh/tok | 57 °C |
| vLLM · FP8/Marlin · MTP=2 | 206 ms | 27,391 tok/s | 17,60 mWh/tok | 58 °C |
| llama.cpp · GGUF Q8 · sin especulación | 476 ms | 25,195 tok/s | 14,05 mWh/tok | 52 °C |
Frente a vLLM MTP=2, llama.cpp dio cerca de un 8 % menos tokens por segundo, tardó más del doble en empezar a responder, según TTFT, la espera hasta el primer token, y empleó cerca de un 20 % menos energía de las GPU por token. Nos quedamos con vLLM para la API interactiva, sin afirmar que sea siempre mejor: llama.cpp sigue siendo una alternativa interesante cuando cambia la prioridad.
La ruta GGUF también nos enseñó qué significa «arranca» en la práctica. Una primera imagen no podía ejecutar el binario como usuario sin privilegios por permisos de archivos; después apareció una biblioteca compartida ausente. Reparadas ambas cosas, aún hubo que verificar carga de pesos e inferencia. Que llama-server --version responda solo prueba que el ejecutable puede mostrar su versión, no que sea capaz de servir el modelo completo.
Aquí quedó una pregunta sin responder. llama.cpp alcanzó 25,195 tok/s sin MTP, mientras que vLLM, también sin MTP, alcanzó 13,526 tok/s a la misma potencia. ¿Podría llama.cpp superar también al vLLM acelerado si activásemos MTP? Quizá, pero todavía no lo hemos probado. MTP no es un multiplicador de velocidad que se pueda trasladar de un programa a otro: cada motor prepara y comprueba sus borradores de forma diferente. La prueba ngram-mod de llama.cpp que veremos después tampoco responde a esa pregunta, porque utiliza otra técnica.
Más borradores no siempre dan más velocidad
Al escribir, el modelo suele generar un token tras otro. MTP (Multi-Token Prediction) intenta adelantar varios tokens candidatos y después comprueba cuáles sirven. Es una forma de decodificación especulativa: como escribir un borrador de las próximas palabras y revisarlo en bloque. Si se aceptan suficientes candidatos, el modelo avanza más por cada comprobación.
Probamos MTP=0, sin adelantar tokens, MTP=2 y MTP=4 con el mismo checkpoint FP8 de vLLM, el mismo reparto tensorial entre las dos GPU (TP=2) y 250 W por tarjeta. La tasa de aceptación indica qué fracción de los tokens propuestos se conservó, no qué porcentaje de respuestas fue «correcto».
tokens de salida / segundo · mismo modelo y 250 W por GPU
MTP=2 conservó el 82,04 % de los candidatos y duplicó aproximadamente la velocidad de salida frente a MTP=0 (+102,51 %), con un 17,84 % menos energía GPU por token. Con cuatro candidatos la aceptación bajó al 56,57 %: hubo más trabajo de borrador desperdiciado, la salida fue un 8,61 % más lenta que con dos y aumentaron tanto la espera inicial como la energía. En esta batería, especular más no significó ir más rápido.
¿Y si los borradores salen de texto ya visto?
llama.cpp ofrecía ngram-mod: busca secuencias de tokens repetidas para proponer las siguientes, sin el mecanismo MTP de vLLM. Con los parámetros fijados 24/48/64, los 22 casos de entrada nueva no generaron trabajo especulativo; la velocidad fue casi igual a la base, 25,232 frente a 25,195 tok/s, con algo más de energía. En un microensayo que repetía exactamente una entrada, sí aceptó el 67,19 % de propuestas y aceleró esa repetición un 146,12 %. No extrapolamos ese caso especial al uso diario.
No aplazamos la prueba de llama.cpp con MTP por falta de interés, sino por el riesgo de perder el control del ordenador. Un fallo comunicado a llama.cpp describe un bloqueo completo al usar MTP con dos RTX 3090 sin comunicación P2P y entradas largas; fue necesario apagar el equipo a la fuerza. Allí el modelo se repartía entre las GPU de otra manera, así que no sabemos si nuestro montaje sufriría exactamente lo mismo, pero tampoco podemos asegurar que esté libre del problema. La corrección propuesta no está en nuestra imagen auditada. Antes de hacer una prueba larga necesitamos una versión corregida que podamos verificar o una prueba inicial cuidadosamente limitada que descarte el camino peligroso. Hasta entonces, la ventaja potencial de llama.cpp con MTP sigue siendo una hipótesis, no un resultado.
Sin MTP, TP ganó a PP a 150 W
Volvamos al reparto del modelo. Con TP=2, las dos GPU calculan a la vez partes de cada capa y se intercambian resultados; con PP=2, una guarda las primeras capas y pasa su resultado a la segunda, que guarda las posteriores. Al no disponer de NVLink/P2P operativo, pensamos que la menor comunicación de PP podría compensar la espera entre etapas. Era una hipótesis, no una regla.
Primero intentamos compararlas con más potencia. A 250 W por GPU, la prueba PP se detuvo al pasar el límite de seguridad del SAI. A 200 W, PP terminó, pero su pareja TP se abortó por una lectura puntual del 102 % de carga del SAI. Aunque el límite configurado por GPU fuese de 200 W, el SAI mide el ordenador completo; esa lectura mostró por qué no podíamos ignorarlo. Como una prueba acabó y la otra no, esos intentos no decidían el ganador.
Bajamos a 150 W por GPU y repetimos las dos configuraciones con el mismo checkpoint, los mismos 22 casos y MTP desactivado. Esta vez la variable principal era TP frente a PP. TP=2 · PP=1 reparte cada capa entre dos tarjetas; TP=1 · PP=2 reparte las capas en dos tramos sucesivos.
| Métrica | TP=2 · PP=1 | TP=1 · PP=2 |
|---|---|---|
| Casos / contexto | 22/22 · 27.064 | 22/22 · 27.064 |
| Salida | 13,445 tok/s | 12,434 tok/s |
| TTFT | 185 ms | 229 ms |
| Energía GPU / token | 25,33 mWh | 26,50 mWh |
| Temperatura máxima | 49 °C | 60 °C |
| Pico SAI | 52 % | 61 % |
| VRAM GPU0 / GPU1 | 21.302 / 21.412 MiB | 20.066 / 22.702 MiB |
En este PC, TP=2 fue un 8,13 % más rápido, empezó a responder un 19,21 % antes (menor TTFT), consumió un 4,42 % menos de energía GPU por token y registró un pico 11 °C inferior. PP dejó además la memoria menos equilibrada entre tarjetas. Esto no demuestra que TP gane siempre: demuestra que la recomendación «sin NVLink, usa PP» no sustituye medir la topología, potencia y carga concretas.
Pero esta victoria de TP responde solo a la pregunta «¿qué reparto funciona mejor sin MTP?». Después activamos MTP=2 en TP y su velocidad pasó de 13,445 a 25,137 tok/s a 150 W. No hicimos la prueba equivalente con PP. Podría ocurrir que PP también mejorase mucho al añadir MTP, o que no mereciese la pena: con las mediciones actuales no podemos saberlo.
Para salir de dudas habría que probar seis combinaciones a la misma potencia: TP con MTP=0, 2 y 4, y PP con MTP=0, 2 y 4. Solo tenemos tres de esas seis a 150 W. También medimos TP con MTP=4, pero fue a 250 W; mezclar ese resultado con los de 150 W atribuiría al reparto o a MTP un efecto que podría deberse a la potencia. Por eso el perfil que elegimos es el mejor de los probados, no un ganador universal.
Falta además preparar el software para completar la tabla. Nuestra imagen auditada usa vLLM 0.29.0, anterior a la incorporación inicial de PP con MTP, y existe un informe abierto sobre fallos de esa combinación. Primero tendríamos que elegir y auditar otra versión, demostrar que PP con MTP responde correctamente y luego repetir las seis pruebas con la misma versión, el mismo controlador y 150 W por GPU. El controlador NVIDIA cambió después de las mediciones anteriores, de modo que tampoco sería una comparación rigurosa enfrentar ensayos nuevos con aquellas cifras sin repetir las referencias.
Rápido cuando despierta, invisible cuando duerme
Con las combinaciones que sí pudimos medir y validar, elegimos vLLM como motor de la API, pesos FP8/Marlin para que el modelo cupiera, TP=2 · PP=1 para repartir cada capa entre ambas GPU y MTP=2 para adelantar dos tokens candidatos. Es una elección práctica con evidencia a favor, no la afirmación de que ninguna combinación pendiente pueda mejorarla. Limitamos cada tarjeta a 150 W, donde la comparación de reparto fue segura para nuestro SAI.
Quedaba confirmar que MTP también ayudaba a 150 W, no solo en la prueba anterior a 250 W. Frente al mismo TP=2 sin MTP y a idéntica potencia, pasamos de 13,445 a 25,137 tokens de salida por segundo: +86,96 %, con un 10,23 % menos de energía GPU aproximada por token. La espera hasta el primer token subió de 185 a 219 ms: una pequeña penalización inicial a cambio de escribir bastante más deprisa una vez arrancada la respuesta.
Después hicimos un smoke test: una prueba corta para comprobar que el servicio completo arranca, acepta peticiones reales y se limpia, antes de considerarlo utilizable. Un segundo contenedor, sin GPU, actuó como cliente dentro de la red Docker privada. Verificó salud, nombre de modelo, sentido de la respuesta, razonamiento separado, llamadas a herramientas sin ejecutarlas y seis observaciones de salud. Solo entonces instalamos el gestor bajo demanda.
Los archivos del modelo siguen en el disco, pero sus pesos no ocupan la VRAM. No hay contenedor de inferencia activo.
Al pulsarlo se reserva el uso de ambas GPU, se limitan a 150 W y se carga Qwen en su memoria.
Cuando termina la carga, móvil y Mac pueden hacer peticiones. Cada uso reinicia el contador de inactividad.
Tras 15 minutos sin peticiones se detiene Qwen, se retiran contenedor y red y se restaura la potencia.
El bloqueo global de GPU de la fase de despertar es un candado de software: si otro modelo administrado tiene las tarjetas, Qwen no puede apropiárselas a la vez. El modelo y la imagen permanecen en el ordenador. El contenedor de inferencia no publica puertos al host, usa archivos de solo lectura, usuario sin privilegios y restricciones adicionales de Linux. Un gestor limitado arranca y detiene este perfil; la pasarela web no recibe control general de Docker ni permisos de administración.
HTTPS dentro de la tailnet, cero exposición pública
Para usarlo desde otro dispositivo necesitábamos una entrada, pero no queríamos publicar el puerto de vLLM en Internet. Tailscale crea una red privada entre nuestros dispositivos autorizados, llamada tailnet. El móvil y el Mac se conectan a esa red; no basta con conocer la dirección del servidor desde fuera.
El recorrido de una petición tiene varias puertas. Tailscale Serve recibe HTTPS en el puerto 443 dentro de la tailnet; no es Tailscale Funnel, que serviría para publicar hacia Internet. Serve entrega el tráfico a Caddy, el servidor web ya instalado, y este lo envía a una pasarela local. La pasarela verifica la ruta y la credencial antes de hablar con vLLM por una red Docker interna. El contenedor del modelo no tiene puerto publicado en el ordenador, y no abrimos puertos del router.
- Permiso de red. Las grants de Tailscale son reglas que dicen qué dispositivo puede contactar con qué destino y puerto. El Mac, el Android y la Raspberry con Home Assistant recibieron solo el acceso necesario a este HTTPS privado.
- Identidad de aplicación. Una clave Bearer es un secreto que el cliente envía en la cabecera de autorización, como una llave individual. Mac y móvil usan claves distintas; Home Assistant tiene otra identidad, pero solo puede despertar Qwen y consultar su estado, no chatear ni detenerlo.
- Rutas cerradas. La pasarela acepta solo las rutas previstas. Sin clave devuelve
401; para una ruta desconocida,404. No guarda prompts, respuestas ni cabeceras con claves en los registros. - Protocolo concreto. La API habla el formato OpenAI Chat Completions, que muchas aplicaciones de chat y agentes pueden configurar con URL, ID de modelo y clave. No implementamos la Responses API. El ID servido es
qwen3.8-27b.
Lo probamos desde un cliente Android y desde OpenCode en Mac. En Home Assistant, instalado en una Raspberry Pi, añadimos el botón que inicia la carga de Qwen y una vista que muestra comprobaciones, potencia GPU, creación de la red y del contenedor, carga del modelo y estado listo. No es un porcentaje inventado de carga ni ofrece chat por ahora. La API de chat no despierta el modelo por sí sola: primero pulsamos el botón y esperamos a que esté listo. Si pasan 15 minutos sin peticiones, el proceso termina y sus pesos salen de la VRAM, de modo que las dos GPU vuelven a estar disponibles para otros modelos.
Si quieres repetir el camino, conserva estas invariantes
Lo reproducible no es copiar a ciegas nuestra configuración privada, sino seguir el orden de decisiones. Primero comprueba hardware y consumo; después fija archivos y versiones; mide perfiles comparables; solo al final abre una entrada privada a clientes concretos.
- Fija versiones. Anota la revisión exacta del modelo, la imagen del motor, la versión del controlador NVIDIA y los parámetros. Una revisión identifica los mismos archivos en cada descarga; un digest identifica la misma imagen Docker. La revisión FP8 que probamos fue
017b9c7…ca20a. - Descarga fuera de la inferencia. Verifica pesos y configuración antes de arrancar, y monta los archivos solo lectura. Así un fallo de red o una actualización silenciosa no cambian el modelo durante una prueba.
- Haz un smoke descartable. Es la comprobación breve de arranque: límite de potencia GPU, vigilancia del SAI, contenedor sin puerto host, una petición sintética y retirada verificable incluso si falla.
- Compara una variable cada vez. Prueba MTP, el número de tokens candidatos que se adelantan, con el mismo motor. Después prueba TP frente a PP, las dos maneras de repartir trabajo entre GPU, primero sin MTP y luego con cada profundidad que el motor soporte de forma segura. Mantén iguales versión, modelo, potencia y batería para toda la matriz. Una ejecución abortada por seguridad no puede decidir una comparativa.
- Separa inferencia de acceso. Un gestor despierta y duerme el modelo; una pasarela valida las peticiones; Tailscale limita qué dispositivos llegan a ella. Usa claves independientes y guárdalas en el cliente o un almacén de secretos, nunca en el JavaScript público de una web.
Base URL: https://<tu-servidor>.<tu-tailnet>.ts.net/api/ai/v1
Modelo:   qwen3.8-27b
API:      Chat Completions
Clave:    <credencial Bearer individual; nunca en la web>
Estado:   despierta Qwen antes de enviar chat
La URL es ficticia. Primero verifica que el dispositivo resuelve el nombre privado de Tailscale, alcanza HTTPS y tiene grant; después configura su clave. Un 401 sin token indica que la ruta respondió y exige autenticación, no que ya puedas inferir. Según el cliente, introduce esta Base URL completa o comprueba si añade /v1 por su cuenta.
El trabajo no acabó cuando Qwen produjo texto. Acabó cuando pudimos explicar por qué ese perfil, limitar su riesgo y devolver las GPU al resto de modelos al terminar.
Fuentes y límites
Las cifras proceden de los registros de este ordenador del 14 al 24 de septiembre de 2026. Se muestran redondeadas; la versión pública omite el nombre interno del host, direcciones, rutas privadas y credenciales. Tras actualizar el controlador NVIDIA a 595.91.07 el 23 de septiembre repetimos pruebas de GPU, salud y arranques reales, pero no toda la batería de 22 casos: los números de rendimiento son anteriores a esa actualización.
- Qwen3.8-27B-FP8 · ficha oficial
- Hugging Face · descarga por revisión
- vLLM · TP y PP
- vLLM · decodificación especulativa
- llama.cpp · n-gram y especulación
- NVIDIA · topología PHB y prueba P2P
- NVIDIA CUDA · P2P y NVLink
- NVIDIA · qué hace Container Toolkit
- NVIDIA · instalación de Container Toolkit
- Tailscale · Serve privado