Duas placas de 24 GiB não são uma de 48
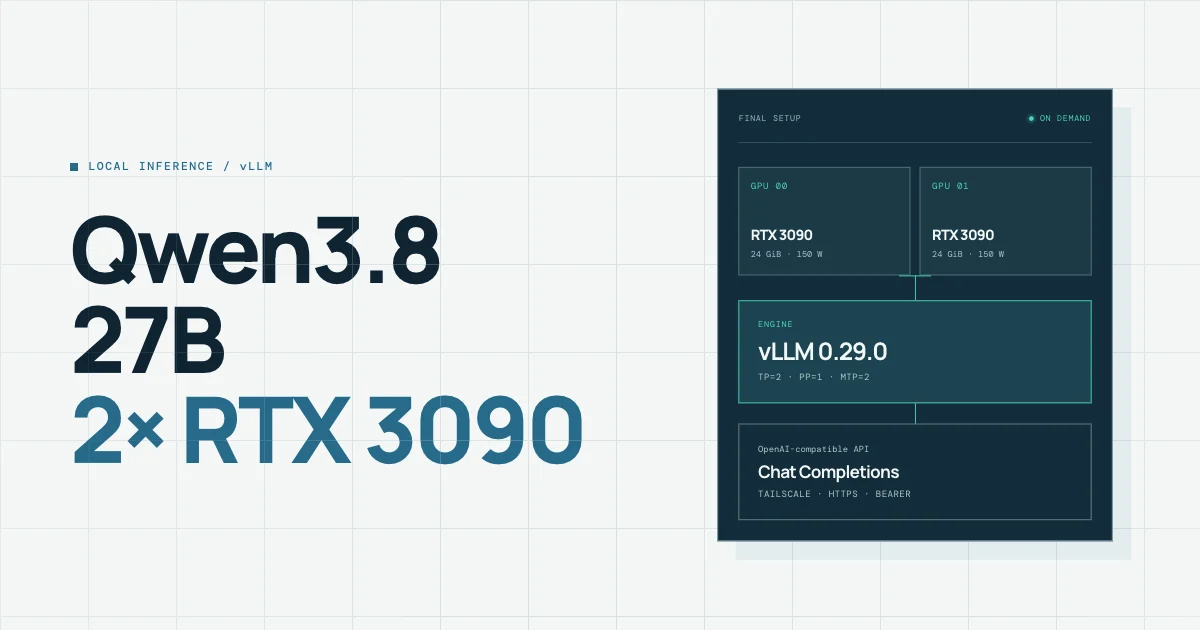
Partimos de um computador de mesa transformado em servidor pessoal. Ele tem duas placas de vídeo NVIDIA RTX 3090, cada uma com 24 GiB de memória de vídeo, ou VRAM: o espaço onde precisam caber os pesos do modelo e a memória temporária da conversa. Queríamos servir o Qwen3.8-27B aos nossos dispositivos sem dedicar as duas placas a ele permanentemente e sem expô-lo à Internet.
Os arquivos do Qwen continuam guardados no disco, mas isso não significa que o modelo esteja sempre em execução. Quando está dormindo, seus pesos não estão carregados na memória das GPUs: não há um processo de inferência ocupando as duas placas. Ao apertar «acordar» no Home Assistant, o serviço é iniciado, os pesos são carregados do disco para as GPUs e esperamos até que ele indique «pronto». Então podemos enviar requisições pelo celular ou pelo Mac. Se passarem 15 minutos sem solicitações, ele desliga, descarrega o modelo e deixa as GPUs livres para outros modelos.
O Qwen3.8-27B tem cerca de 27 bilhões de parâmetros: números aprendidos durante o treinamento que são carregados como pesos para produzir texto. Cada GPU tem sua própria VRAM; os 24 + 24 GiB não se fundem automaticamente. Para hospedar o modelo nas duas, é preciso dividir trabalho e dados, e o que é trocado entre elas pode virar um gargalo.
As placas estão conectadas à placa-mãe por PCI Express (PCIe), o barramento de comunicação do computador. Uma trabalha com um link x16, dezesseis «faixas» de dados, e a outra com x4, quatro faixas. É uma diferença de capacidade do link, não uma promessa de que toda a inferência será quatro vezes mais lenta: o que importa é quanto elas precisam se comunicar. A ferramenta nvidia-smi topo -m rotulou o caminho como PHB, abreviação de PCIe Host Bridge: para se comunicar, elas atravessam o PCIe e uma ponte do sistema, em vez de ter um link direto entre placas. A alternativa seria instalar uma ponte NVLink: os dados trocados pelas duas GPUs viajariam por esse link direto, sem percorrer a placa-mãe. Não instalamos porque a ponte compatível é cara e ainda seria preciso verificar se ela cabe fisicamente entre essas duas placas; deixamos a compra para depois.
Verificamos também que nessa montagem não havia comunicação P2P utilizável nem link NVLink ativo. P2P (peer-to-peer) permite que uma GPU acesse diretamente a memória de outra quando a plataforma suporta; NVLink é um link físico de alta velocidade que pode facilitar essa troca. PHB descreve a topologia, mas por si só não prova se o P2P funciona: verificamos isso à parte. Sem um caminho rápido garantido, não era óbvio qual seria a melhor forma de dividir o Qwen.
As duas fazem a mesma etapa
Paralelismo tensorial (TP): dividimos os cálculos de uma mesma camada do modelo entre a GPU 0 e a GPU 1. Elas trabalham ao mesmo tempo em partes da mesma operação e depois juntam os resultados. É como duas pessoas resolvendo metades do mesmo problema e comparando anotações a cada passo: pode acelerar, mas exige comunicação frequente.
Cada uma faz etapas diferentes
Paralelismo de pipeline (PP): colocamos as primeiras camadas em uma GPU e as seguintes na outra. Uma processa seu trecho e passa o resultado intermediário para a próxima, como dois postos de uma linha de montagem. Os dados são trocados em menos pontos, mas para uma única solicitação uma GPU pode ficar esperando a outra.
Essa foi uma pergunta central do experimento: neste PC, com PCIe x16/x4 e sem P2P/NVLink operacional, a simultaneidade do TP compensa apesar das trocas frequentes, ou vence a menor comunicação do PP? Mais adiante veremos como medimos isso mantendo o resto constante.
O computador é alimentado por um nobreak (UPS, fonte de alimentação ininterrupta): uma bateria com eletrônica que mantém o equipamento ligado durante uma queda de energia e mede a carga elétrica. O nosso suporta 900 W reais. Um teto de 150 ou 200 W por GPU não limita o consumo da CPU, ventoinhas, discos e perdas da fonte; por isso monitoramos a carga total registrada pelo nobreak.
Definimos um aborto preventivo a 85 % da capacidade, cerca de 765 W segundo o valor nominal: isso deixa uns 135 W de margem nominal em relação aos 900 W. É um limite escolhido para estes testes, não uma regra universal nem uma garantia contra picos mais curtos que a amostragem. Se fosse ultrapassado, parávamos o teste e limpávamos o ambiente.
Primeiro, uma base que possa ser verificada
Antes de comparar motores preparamos o sistema: Ubuntu 24.04, Docker para isolar processos, o driver das GPUs e um modelo baixado e verificado. Não basta ter duas placas instaladas: o programa de inferência precisa conseguir vê-las, usar a versão correta de suas bibliotecas e encontrar todos os arquivos do modelo.
O driver NVIDIA é o software do sistema operacional que conversa com as GPUs. «Validado» aqui não significa simplesmente «a versão mais recente»: verificamos que o módulo carregado e as bibliotecas NVIDIA de usuário coincidem, que o nvidia-smi funciona, que as duas placas executam computação CUDA e que o serviço real inicia e para de forma limpa. Depois de uma atualização em setembro, a versão fixada atual é a 595.91.07; antes de reiniciar houve uma mistura entre o módulo anterior e as bibliotecas novas que impedia o uso das GPUs. A reinicialização e os testes seguintes corrigiram e verificaram essa situação.
O NVIDIA Container Toolkit é a camada que permite a um contêiner Docker solicitar as GPUs e receber os dispositivos e componentes do driver necessários. O Docker isola o processo, mas sozinho não lhe dá acesso correto ao hardware NVIDIA. Nesta máquina ficou instalado o Toolkit 1.20.1; ele foi configurado com nvidia-ctk e verificado a partir de um contêiner. O driver fica no host, o computador físico; não se instala um driver separado dentro de cada contêiner.
O modelo principal é o checkpoint oficial Qwen3.8-27B-FP8. Um checkpoint é o conjunto de arquivos com os pesos e a configuração do modelo. A alternativa para o llama.cpp usou o formato GGUF UD-Q8_K_XL da Unsloth; o GGUF empacota o modelo em um formato que o llama.cpp consegue carregar.
- 01
Validar host e energia
Verificar as duas GPUs com
nvidia-smi, seu caminho PCIe comnvidia-smi topo -m, refrigeração, memória e armazenamento. Confirmar que o nobreak está online e que conseguimos medir sua carga; definir a parada preventiva de 85 % antes de carregar os pesos. - 02
Dar GPUs ao Docker
Instalar o Docker e o NVIDIA Container Toolkit, que apresenta as GPUs do host aos contêineres. Configurar o runtime com
nvidia-ctke verificar as duas GPUs a partir de um contêiner de teste. O guia oficial da NVIDIA explica os passos e requisitos atuais. - 03
Fixar arquivos concretos
Não baixar «o mais recente» a cada inicialização. Escolhemos uma revisão exata do checkpoint, verificamos o inventário e os hashes de seus fragmentos e montamos essa cópia somente leitura. Também fixamos e auditamos a imagem do motor vLLM para saber qual código estávamos executando.
- 04
Testar sem deixar resíduos
Executamos um ensaio por vez. Um bloqueio de GPU impede que dois modelos gerenciados disputem as placas; aplicamos tetos de potência, rede Docker interna sem portas abertas no host e limites do contêiner. Depois de cada ensaio, mesmo com falha, removemos contêiner e rede e restauramos a potência.
Para que a instalação seja repetível, o cliente do Hugging Face permite fixar uma revisão exata. Usamos ainda um downloader que verificou cada fragmento com SHA-256, uma impressão digital do arquivo. O comando a seguir ilustra a seleção da revisão; não substitui todas essas verificações.
hf download Qwen/Qwen3.8-27B-FP8 \
  --revision 017b9c7af6b5689d5dd426a76e0bc077eb5ca20a \
  --local-dir /caminho/protegido/qwen-fp8
Depois: valide inventário e hashes, restrinja permissões e monte o snapshot no contêiner como somente leitura. Não é aconselhável baixar a partir do processo de inferência.
nvidia-smi --query-gpu=index,name,memory.total,power.limit --format=csv
nvidia-smi topo -m
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Comandos orientativos, não um instalador transacional. Em um host existente, revise antes o daemon.json e o efeito de reiniciar o Docker sobre outros serviços.
Havia outra decisão de memória. O BF16 guarda cada peso em 16 bits; os pesos oficiais nesse formato superavam a VRAM disponível mesmo antes de reservar memória para processar as solicitações. Escolhemos a variante FP8, de 8 bits por peso. As RTX 3090 não fazem cálculo FP8 nativo: o vLLM usou o Marlin, uma implementação que aproveita os pesos comprimidos e calcula com ativações FP16. Assim o modelo coube, mas «usar pesos FP8» não significa que todo o cálculo foi FP8.
Estes são os parâmetros essenciais do motor finalmente escolhido. TP=2 significa que as duas GPUs participam de cada etapa; PP=1, que não se encadeiam dois trechos diferentes do modelo. MTP=2 antecipa dois candidatos de texto, como explicaremos depois. O comando roda dentro do contêiner isolado, com o checkpoint já montado; sozinho ele não cria o limite de 150 W, o controle do nobreak, o bloqueio de GPU, a autenticação nem a política de rede.
vllm serve /models/qwen3.8-27b \
  --served-model-name qwen3.8-27b \
  --tensor-parallel-size 2 --pipeline-parallel-size 1 \
  --distributed-executor-backend mp \
  --dtype float16 --linear-backend marlin \
  --max-model-len 32768 --max-num-seqs 1 \
  --max-num-batched-tokens 2048 \
  --gpu-memory-utilization 0.90 --kv-cache-dtype fp8 \
  --enable-prefix-caching --enforce-eager \
  --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Flags dependentes do vLLM 0.29.0. O servidor escuta apenas na rede privada do contêiner; não publique sua porta no host. O gerenciador externo monitora saúde, potência, nobreak e limpeza.
Medimos o sistema, não só tokens por segundo
Não queríamos escolher uma configuração só porque um número de velocidade parecia alto. Repetimos uma bateria de 22 casos sintéticos: aritmética, separação do raciocínio, formato de chamadas de ferramentas sem executá-las, textos de entrada de vários tamanhos, doze solicitações de estabilidade, resposta em streaming e teste de cache.
Um token é uma unidade de texto que o modelo lê ou escreve: pode ser uma palavra, parte de uma palavra ou um sinal. Quanto mais tokens cabem na entrada, mais código ou conversa podemos enviar em uma única requisição. Configuramos uma janela máxima de 32.768, mas o que realmente testamos na bateria foi até 27.064 tokens de entrada; não confundimos configuração com teste.
Responde corretamente?
Os 22 casos, incluindo chamadas de ferramentas no formato esperado. Uma chamada de ferramenta é uma proposta estruturada do modelo; no ensaio não deixamos que ela executasse código nem ações reais.
Quanto demora?
TTFT (time to first token) mede a espera até o primeiro fragmento da resposta. Os tokens por segundo medem a velocidade de escrita depois disso. Medimos os dois: um motor pode escrever rápido e, mesmo assim, demorar para começar.
A que custo?
VRAM por GPU, temperatura, carga do nobreak, a bateria de reserva e a energia aproximada das GPUs por token de saída. Nós a expressamos em mWh por token, miliwatts-hora consumidos pelas GPUs para produzir um token. Ela vem de amostras de potência e não equivale ao consumo total medido na tomada.
Também separamos os testes de cache frio e cache quente. Se uma entrada repete um prefixo já processado, o motor pode reutilizar cálculos e responder antes. Isso é útil, mas não seria honesto apresentar o tempo de uma repetição como se fosse o de uma requisição nova.
Dois motores, dois formatos de pesos
Um motor de inferência é o programa que carrega o checkpoint e serve respostas. Testamos dois: o vLLM, pensado para atender solicitações de modelos grandes, e o llama.cpp, uma alternativa que trabalha com arquivos GGUF. Na primeira comparação, com cada GPU limitada a 250 W, o llama.cpp consumiu menos energia de GPU por token; o vLLM com MTP=2 começou a responder antes e escreveu um pouco mais rápido.
Não se trata de instalar dois «sabores» idênticos do mesmo arquivo. O vLLM leu o checkpoint FP8 oficial por meio do Marlin; o llama.cpp leu a conversão GGUF Q8. Os dois representam o Qwen3.8-27B, mas seus formatos e métodos de cálculo diferem. Por isso a tabela compara pilhas práticas completas; não isola cientificamente o efeito de trocar apenas o motor.
| Motor / perfil | TTFT | Saída | Energia GPU | Máx. |
|---|---|---|---|---|
| vLLM · FP8/Marlin · MTP=0 | 189 ms | 13,526 tok/s | 21,43 mWh/tok | 57 °C |
| vLLM · FP8/Marlin · MTP=2 | 206 ms | 27,391 tok/s | 17,60 mWh/tok | 58 °C |
| llama.cpp · GGUF Q8 · sem especulação | 476 ms | 25,195 tok/s | 14,05 mWh/tok | 52 °C |
Em comparação com o vLLM MTP=2, o llama.cpp entregou cerca de 8 % menos tokens por segundo, demorou mais que o dobro para começar a responder (TTFT, a espera até o primeiro token) e usou cerca de 20 % menos energia das GPUs por token. Ficamos com o vLLM para a API interativa, sem afirmar que ele seja sempre melhor: o llama.cpp continua sendo uma alternativa interessante quando a prioridade muda.
O caminho GGUF também nos ensinou o que significa «inicia» na prática. Uma primeira imagem não conseguia executar o binário como usuário sem privilégios por causa de permissões de arquivos; depois apareceu uma biblioteca compartilhada ausente. Corrigidas as duas coisas, ainda foi preciso verificar o carregamento dos pesos e a inferência. O fato de llama-server --version responder só prova que o executável consegue mostrar sua versão, não que é capaz de servir o modelo completo.
Aqui ficou uma pergunta sem resposta. O llama.cpp chegou a 25,195 tok/s sem MTP, enquanto o vLLM, também sem MTP, chegou a 13,526 tok/s na mesma potência. O llama.cpp poderia superar também o vLLM acelerado se ativássemos o MTP? Talvez, mas ainda não testamos. O MTP não é um multiplicador de velocidade que se possa levar de um programa para outro: cada motor prepara e verifica seus rascunhos de forma diferente. O teste ngram-mod do llama.cpp que veremos a seguir também não responde a essa pergunta, porque usa outra técnica.
Mais rascunhos nem sempre dão mais velocidade
Ao escrever, o modelo costuma gerar um token depois do outro. O MTP (Multi-Token Prediction) tenta antecipar vários tokens candidatos e depois verifica quais servem. É uma forma de decodificação especulativa: como escrever um rascunho das próximas palavras e revisá-lo em bloco. Se candidatos suficientes forem aceitos, o modelo avança mais a cada verificação.
Testamos MTP=0, sem antecipar tokens, MTP=2 e MTP=4 com o mesmo checkpoint FP8 do vLLM, a mesma divisão tensorial entre as duas GPUs (TP=2) e 250 W por placa. A taxa de aceitação indica que fração dos tokens propostos foi mantida, não que porcentagem das respostas foi «correta».
tokens de saída / segundo · mesmo modelo e 250 W por GPU
O MTP=2 manteve 82,04 % dos candidatos e praticamente dobrou a velocidade de saída em relação ao MTP=0 (+102,51 %), com 17,84 % menos energia de GPU por token. Com quatro candidatos a aceitação caiu para 56,57 %: houve mais trabalho de rascunho desperdiçado, a saída foi 8,61 % mais lenta que com dois e aumentaram tanto a espera inicial quanto a energia. Nesta bateria, especular mais não significou ir mais rápido.
E se os rascunhos saírem de texto já visto?
O llama.cpp oferecia o ngram-mod: ele procura sequências de tokens repetidas para propor as seguintes, sem o mecanismo MTP do vLLM. Com os parâmetros fixados em 24/48/64, os 22 casos de entrada nova não geraram trabalho especulativo; a velocidade foi quase igual à base, 25,232 contra 25,195 tok/s, com um pouco mais de energia. Em um microteste que repetia exatamente uma entrada, ele aceitou 67,19 % das propostas e acelerou essa repetição em 146,12 %. Não extrapolamos esse caso especial para o uso diário.
Não adiamos o teste do llama.cpp com MTP por falta de interesse, mas pelo risco de perder o controle do computador. Um bug reportado ao llama.cpp descreve um travamento completo ao usar MTP com duas RTX 3090 sem comunicação P2P e entradas longas; foi preciso desligar a máquina à força. Lá o modelo era dividido entre as GPUs de outra forma, então não sabemos se a nossa montagem sofreria exatamente o mesmo, mas também não podemos garantir que esteja livre do problema. A correção proposta não está na nossa imagem auditada. Antes de fazer um teste longo precisamos de uma versão corrigida que possamos verificar ou de um teste inicial cuidadosamente limitado que descarte o caminho perigoso. Até lá, a vantagem potencial do llama.cpp com MTP continua sendo uma hipótese, não um resultado.
Sem MTP, o TP venceu o PP a 150 W
Voltemos à divisão do modelo. Com TP=2, as duas GPUs calculam ao mesmo tempo partes de cada camada e trocam resultados; com PP=2, uma guarda as primeiras camadas e passa seu resultado para a segunda, que guarda as posteriores. Sem NVLink/P2P operacional, pensamos que a menor comunicação do PP poderia compensar a espera entre etapas. Era uma hipótese, não uma regra.
Primeiro tentamos compará-los com mais potência. A 250 W por GPU, o teste PP parou ao ultrapassar o limite de segurança do nobreak. A 200 W, o PP terminou, mas seu par TP foi abortado por uma leitura pontual de 102 % de carga do nobreak. Embora o limite configurado por GPU fosse de 200 W, o nobreak mede o computador inteiro; essa leitura mostrou por que não podíamos ignorá-lo. Como um teste terminou e o outro não, essas tentativas não decidiam o vencedor.
Descemos para 150 W por GPU e repetimos as duas configurações com o mesmo checkpoint, os mesmos 22 casos e o MTP desativado. Desta vez a variável principal era TP contra PP. TP=2 · PP=1 divide cada camada entre duas placas; TP=1 · PP=2 divide as camadas em dois trechos sucessivos.
| Métrica | TP=2 · PP=1 | TP=1 · PP=2 |
|---|---|---|
| Casos / contexto | 22/22 · 27.064 | 22/22 · 27.064 |
| Saída | 13,445 tok/s | 12,434 tok/s |
| TTFT | 185 ms | 229 ms |
| Energia GPU / token | 25,33 mWh | 26,50 mWh |
| Temperatura máxima | 49 °C | 60 °C |
| Pico do nobreak | 52 % | 61 % |
| VRAM GPU0 / GPU1 | 21.302 / 21.412 MiB | 20.066 / 22.702 MiB |
Neste PC, o TP=2 foi 8,13 % mais rápido, começou a responder 19,21 % antes (TTFT menor), consumiu 4,42 % menos energia de GPU por token e registrou um pico 11 °C mais baixo. O PP também deixou a memória menos equilibrada entre as placas. Isso não demonstra que o TP vence sempre: demonstra que a recomendação «sem NVLink, use PP» não substitui medir a topologia, a potência e a carga concretas.
Mas essa vitória do TP responde apenas à pergunta «qual divisão funciona melhor sem MTP?». Depois ativamos o MTP=2 no TP e sua velocidade passou de 13,445 para 25,137 tok/s a 150 W. Não fizemos o teste equivalente com PP. Pode ser que o PP também melhorasse muito com MTP, ou que não valesse a pena: com as medições atuais não temos como saber.
Para tirar a dúvida seria preciso testar seis combinações na mesma potência: TP com MTP=0, 2 e 4, e PP com MTP=0, 2 e 4. Temos só três dessas seis a 150 W. Também medimos TP com MTP=4, mas a 250 W; misturar esse resultado com os de 150 W atribuiria à divisão ou ao MTP um efeito que poderia ser da potência. Por isso o perfil que escolhemos é o melhor dos testados, não um vencedor universal.
Falta também preparar o software para completar a tabela. Nossa imagem auditada usa o vLLM 0.29.0, anterior à incorporação inicial de PP com MTP, e existe um relatório aberto sobre falhas dessa combinação. Primeiro precisaríamos escolher e auditar outra versão, demonstrar que PP com MTP responde corretamente e depois repetir os seis testes com a mesma versão, o mesmo driver e 150 W por GPU. O driver NVIDIA mudou depois das medições anteriores, então também não seria uma comparação rigorosa confrontar ensaios novos com aqueles números sem repetir as referências.
Rápido quando acorda, invisível quando dorme
Com as combinações que conseguimos medir e validar, escolhemos o vLLM como motor da API, pesos FP8/Marlin para que o modelo coubesse, TP=2 · PP=1 para dividir cada camada entre as duas GPUs e MTP=2 para antecipar dois tokens candidatos. É uma escolha prática com evidências a favor, não a afirmação de que nenhuma combinação pendente possa melhorá-la. Limitamos cada placa a 150 W, onde a comparação de divisão foi segura para o nosso nobreak.
Faltava confirmar que o MTP também ajudava a 150 W, e não só no teste anterior a 250 W. Em relação ao mesmo TP=2 sem MTP e na mesma potência, passamos de 13,445 para 25,137 tokens de saída por segundo: +86,96 %, com 10,23 % menos energia aproximada de GPU por token. A espera até o primeiro token subiu de 185 para 219 ms: uma pequena penalidade inicial em troca de escrever bem mais rápido depois que a resposta começa.
Depois fizemos um smoke test: um teste curto para verificar que o serviço completo inicia, aceita requisições reais e se limpa, antes de considerá-lo utilizável. Um segundo contêiner, sem GPU, atuou como cliente dentro da rede Docker privada. Ele verificou saúde, nome do modelo, sentido da resposta, raciocínio separado, chamadas de ferramentas sem executá-las e seis observações de saúde. Só então instalamos o gerenciador sob demanda.
Os arquivos do modelo continuam no disco, mas seus pesos não ocupam a VRAM. Não há contêiner de inferência ativo.
Ao apertá-lo, o uso das duas GPUs é reservado, elas são limitadas a 150 W e o Qwen é carregado em sua memória.
Quando o carregamento termina, celular e Mac podem fazer requisições. Cada uso reinicia o contador de inatividade.
Após 15 minutos sem requisições o Qwen é parado, contêiner e rede são removidos e a potência é restaurada.
O bloqueio global de GPU da fase de acordar é uma trava de software: se outro modelo gerenciado estiver com as placas, o Qwen não pode tomá-las ao mesmo tempo. O modelo e a imagem ficam no computador. O contêiner de inferência não publica portas no host, usa arquivos somente leitura, usuário sem privilégios e restrições adicionais do Linux. Um gerenciador limitado inicia e para este perfil; o gateway web não recebe controle geral do Docker nem permissões de administração.
HTTPS dentro da tailnet, zero exposição pública
Para usá-lo a partir de outro dispositivo precisávamos de uma entrada, mas não queríamos publicar a porta do vLLM na Internet. O Tailscale cria uma rede privada entre nossos dispositivos autorizados, chamada tailnet. O celular e o Mac se conectam a essa rede; não basta conhecer o endereço do servidor de fora.
O caminho de uma requisição tem várias portas. O Tailscale Serve recebe HTTPS na porta 443 dentro da tailnet; não é o Tailscale Funnel, que serviria para publicar na Internet. O Serve entrega o tráfego ao Caddy, o servidor web já instalado, que o envia a um gateway local. O gateway verifica a rota e a credencial antes de falar com o vLLM por uma rede Docker interna. O contêiner do modelo não tem porta publicada no computador, e não abrimos portas no roteador.
- Permissão de rede. As grants do Tailscale são regras que dizem qual dispositivo pode contatar qual destino e porta. O Mac, o Android e o Raspberry com Home Assistant receberam apenas o acesso necessário a este HTTPS privado.
- Identidade de aplicação. Uma chave Bearer é um segredo que o cliente envia no cabeçalho de autorização, como uma chave individual. Mac e celular usam chaves diferentes; o Home Assistant tem outra identidade, mas só pode acordar o Qwen e consultar seu estado, não conversar nem pará-lo.
- Rotas fechadas. O gateway aceita apenas as rotas previstas. Sem chave, devolve
401; para uma rota desconhecida,404. Ele não guarda prompts, respostas nem cabeçalhos com chaves nos logs. - Protocolo concreto. A API fala o formato OpenAI Chat Completions, que muitos aplicativos de chat e agentes podem configurar com URL, ID do modelo e chave. Não implementamos a Responses API. O ID servido é
qwen3.8-27b.
Testamos a partir de um cliente Android e do OpenCode no Mac. No Home Assistant, instalado em um Raspberry Pi, adicionamos o botão que inicia o carregamento do Qwen e uma visualização que mostra verificações, potência das GPUs, criação da rede e do contêiner, carregamento do modelo e estado pronto. Não é uma porcentagem de carregamento inventada e, por enquanto, não oferece chat. A API de chat não acorda o modelo sozinha: primeiro apertamos o botão e esperamos que esteja pronto. Se passarem 15 minutos sem requisições, o processo termina e seus pesos saem da VRAM, de modo que as duas GPUs voltam a ficar disponíveis para outros modelos.
Se quiser repetir o caminho, mantenha estas invariantes
O que é reproduzível não é copiar às cegas a nossa configuração privada, mas seguir a ordem das decisões. Primeiro verifique hardware e consumo; depois fixe arquivos e versões; meça perfis comparáveis; só no final abra uma entrada privada para clientes concretos.
- Fixe versões. Anote a revisão exata do modelo, a imagem do motor, a versão do driver NVIDIA e os parâmetros. Uma revisão identifica os mesmos arquivos a cada download; um digest identifica a mesma imagem Docker. A revisão FP8 que testamos foi
017b9c7…ca20a. - Baixe fora da inferência. Verifique pesos e configuração antes de iniciar e monte os arquivos como somente leitura. Assim uma falha de rede ou uma atualização silenciosa não mudam o modelo durante um teste.
- Faça um smoke descartável. É a verificação curta de inicialização: limite de potência da GPU, monitoramento do nobreak, contêiner sem porta no host, uma requisição sintética e remoção verificável mesmo em caso de falha.
- Compare uma variável por vez. Teste o MTP, o número de tokens candidatos antecipados, com o mesmo motor. Depois teste TP contra PP, as duas formas de dividir o trabalho entre GPUs, primeiro sem MTP e depois com cada profundidade que o motor suporte com segurança. Mantenha iguais versão, modelo, potência e bateria de testes para toda a matriz. Uma execução abortada por segurança não pode decidir uma comparação.
- Separe inferência de acesso. Um gerenciador acorda e adormece o modelo; um gateway valida as requisições; o Tailscale limita quais dispositivos chegam até ele. Use chaves independentes e guarde-as no cliente ou em um cofre de segredos, nunca no JavaScript público de um site.
Base URL: https://<seu-servidor>.<sua-tailnet>.ts.net/api/ai/v1
Modelo:   qwen3.8-27b
API:      Chat Completions
Chave:    <credencial Bearer individual; nunca na web>
Estado:   acorde o Qwen antes de enviar chat
A URL é fictícia. Primeiro verifique se o dispositivo resolve o nome privado do Tailscale, alcança o HTTPS e tem grant; depois configure a chave. Um 401 sem token indica que a rota respondeu e exige autenticação, não que você já possa fazer inferência. Dependendo do cliente, informe esta Base URL completa ou verifique se ele adiciona /v1 por conta própria.
O trabalho não terminou quando o Qwen produziu texto. Terminou quando conseguimos explicar por que esse perfil, limitar seu risco e devolver as GPUs aos outros modelos ao terminar.
Fontes e limites
Os números vêm dos registros deste computador de 14 a 24 de setembro de 2026. Eles aparecem arredondados; a versão pública omite o nome interno do host, endereços, caminhos privados e credenciais. Depois de atualizar o driver NVIDIA para 595.91.07 em 23 de setembro, repetimos testes de GPU, saúde e inicializações reais, mas não toda a bateria de 22 casos: os números de desempenho são anteriores a essa atualização.
- Qwen3.8-27B-FP8 · ficha oficial
- Hugging Face · download por revisão
- vLLM · TP e PP
- vLLM · decodificação especulativa
- llama.cpp · n-gram e especulação
- NVIDIA · topologia PHB e teste P2P
- NVIDIA CUDA · P2P e NVLink
- NVIDIA · o que o Container Toolkit faz
- NVIDIA · instalação do Container Toolkit
- Tailscale · Serve privado