Por qué importan los entornos
El aprendizaje por refuerzo (RL) se ha convertido en el gran motor de los modelos que razonan y de los agentes: es el punto en el que el ajuste fino supervisado se estanca y el refuerzo sigue subiendo el rendimiento. Y su pieza central es el entorno: el sitio donde el modelo practica, recibe una nota y aprende de la interacción durante muchos pasos.
Para conseguir más capacidades, el número de entornos se ha disparado:
- Qwen3 entrenó con unas 20 tareas de dominio general.
- Qwen3-Coder pasó a 20.000 entornos en paralelo en Alibaba Cloud.
- Forge, de MiniMax, entrena M2.5 con cientos de miles de entornos sacados del mundo real.
- Qwen3.5 habla ya de entornos con millones de agentes y distribuciones de tareas cada vez más complejas.
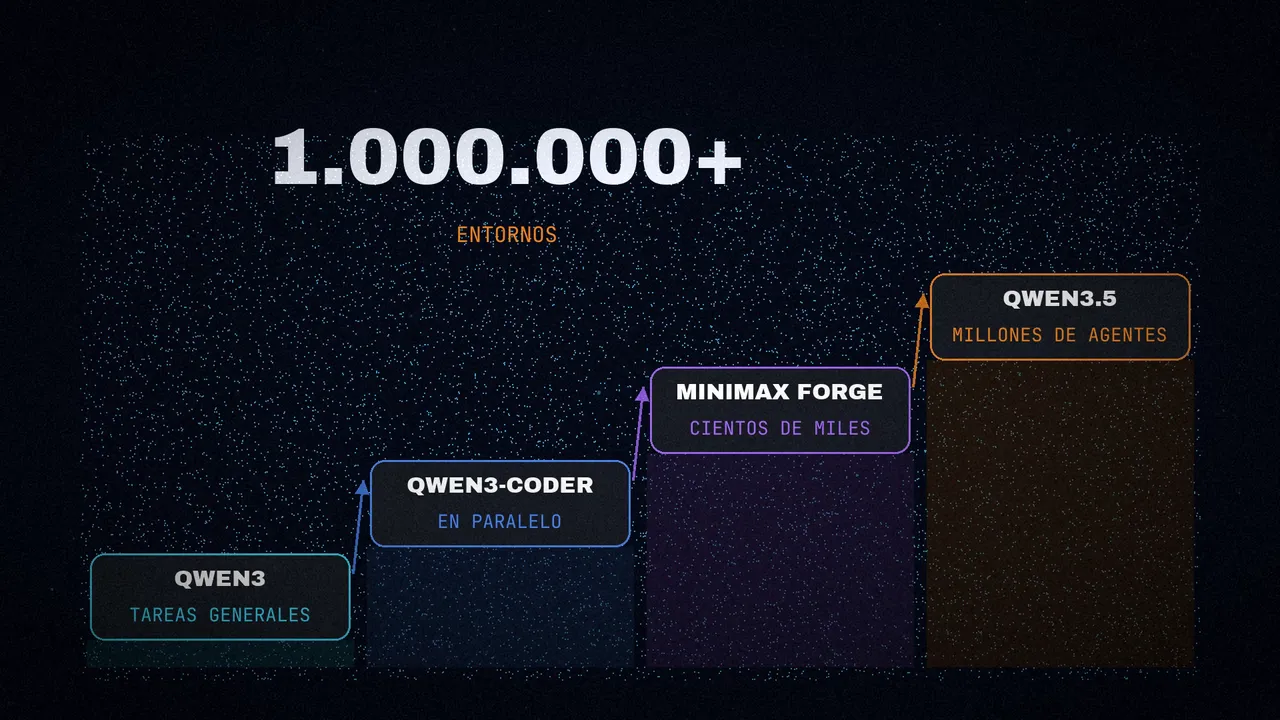
El equipo de Qwen lo dice sin rodeos en las notas de Qwen3.5: casi toda la mejora sobre Qwen3 viene de «escalar prácticamente todas las tareas y entornos de RL que se nos ocurrieron», subiendo a propósito su dificultad y su generalidad en vez de optimizar para benchmarks concretos.
Así que el cuello de botella ya no es «¿sé montar un entorno?», sino «¿cómo ejecuto 100.000 a la vez, los mantengo honestos y los meto en el bucle de entrenamiento?». Para eso están saliendo frameworks que lo estandarizan y catálogos de entornos hechos: el mayor está en Hugging Face Spaces, con más de 4.000 entornos compatibles con MCP, y el Environments Hub de Prime Intellect y openreward.ai suman varios miles más.
La conclusión de los autores, por adelantado: cada framework hace lo mismo a su manera. Las diferencias están en cómo se conecta el entorno con el resto del entrenamiento, no en lo que puede hacer. El mismo entorno se puede replicar en los seis, así que no te pierdes nada fundamental eligiendo uno u otro: lo que cambia es la comodidad, y eso depende de lo que ya uses. Todo el código está en su repositorio RL_Envs_101.
Qué es un entorno de RL en la era de los LLM
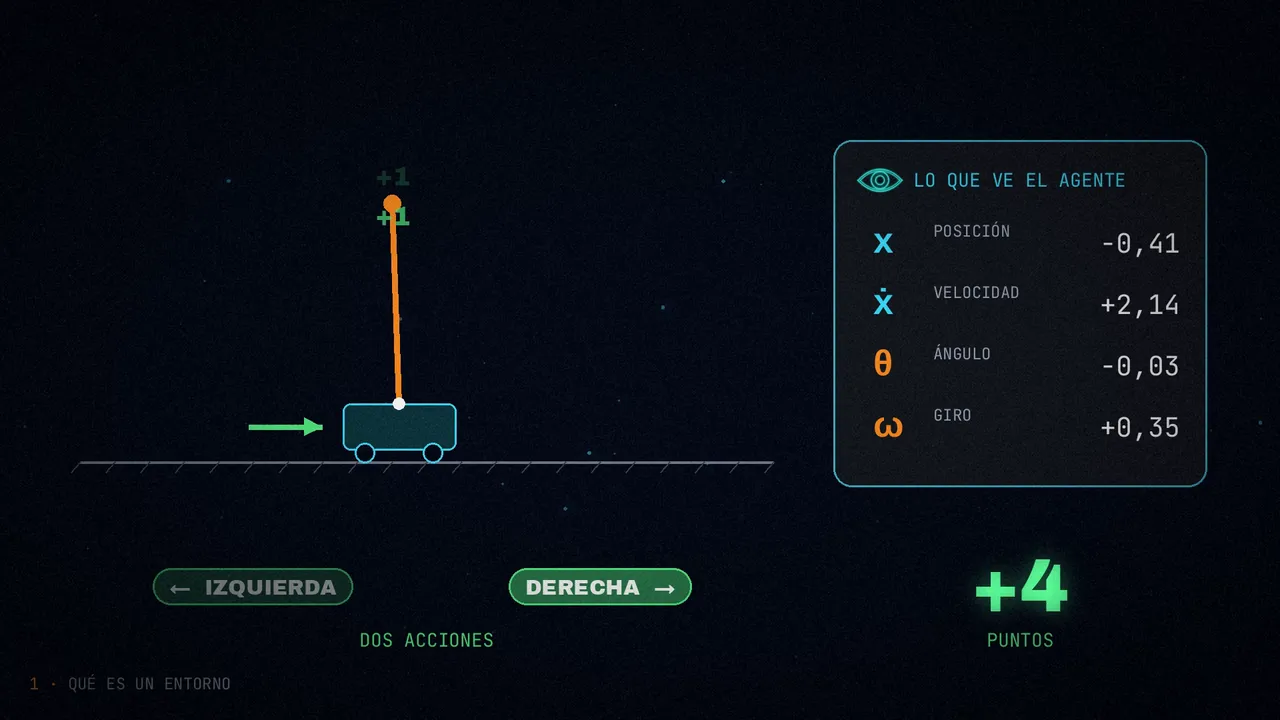
En el RL clásico (Atari, robótica), un entorno es pequeño y autocontenido. El ejemplo de manual es CartPole: un carrito sobre un raíl con un palo en equilibrio encima. El agente observa cuatro números (posición y velocidad del carro, ángulo y velocidad angular del palo), elige una de dos acciones (empujar a la izquierda o a la derecha) y el entorno avanza un paso de física. La recompensa es +1 por cada paso en que el palo sigue de pie. El entorno es el simulador de física más la regla de la recompensa.
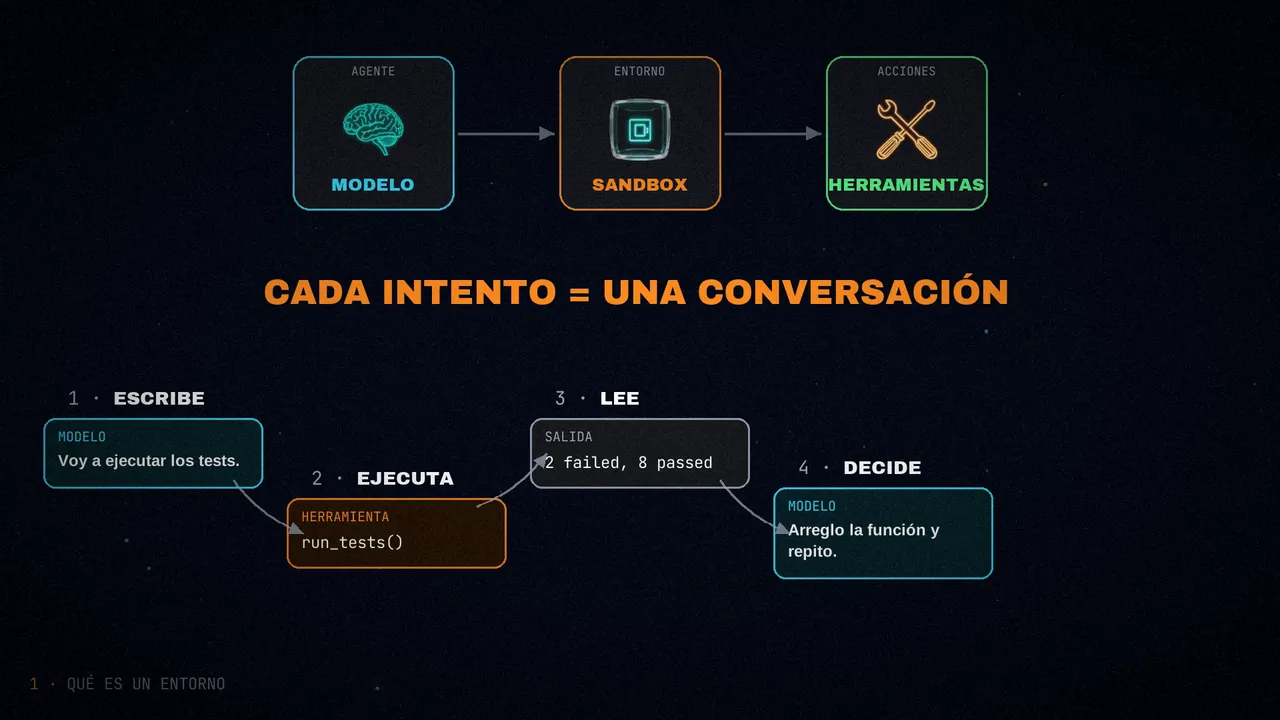
Con los modelos de lenguaje la imagen se complica y no hay una implementación canónica. Una forma habitual: el agente es el modelo; el entorno, un sandbox que ejecuta comandos o código; y el espacio de acciones, las herramientas que exponga el framework. Cada intento (rollout) es una conversación de varios turnos: el modelo escribe, ejecuta una herramienta, lee la salida, decide qué probar y al final entrega una respuesta. El entorno puntúa el intento completo y devuelve una recompensa, y cada paso de entrenamiento junta un grupo de intentos por tarea para aprender de ellos.
Hay muchas otras formas (razonamiento en un solo turno, tareas web, agentes sobre repositorios, varios agentes), pero todas son variaciones del mismo esqueleto. Cambian las herramientas, las observaciones y la regla de la recompensa.
Las cinco etapas y quién cubre qué
Todo sistema de entrenamiento por refuerzo para LLM se apoya en la misma columna de cinco etapas: tareas que resolver, un arnés que deja al modelo interactuar, una recompensa que puntúa su comportamiento, un recolector que junta episodios completos y un entrenador que convierte esos episodios en una actualización de la política. Lo que cambia de un framework a otro es qué trozo de esa columna te dan hecho:
| Framework | Tareas | Arnés | Recompensa | Recolección | Entrenador |
|---|---|---|---|---|---|
| OpenEnv | – | ✓ | ✓ | – | – |
| ORS | ✓ | ✓ | ✓ | – | – |
| NeMo Gym | ✓ | ✓ | ✓ | ✓ | – |
| Verifiers + Prime RL | ✓ | ✓ | ✓ | ✓ | ✓ |
| SkyRL Gym | – | ✓ | ✓ | ✓ | ✓ |
| GEM | ✓ | ✓ | ✓ | – | – |
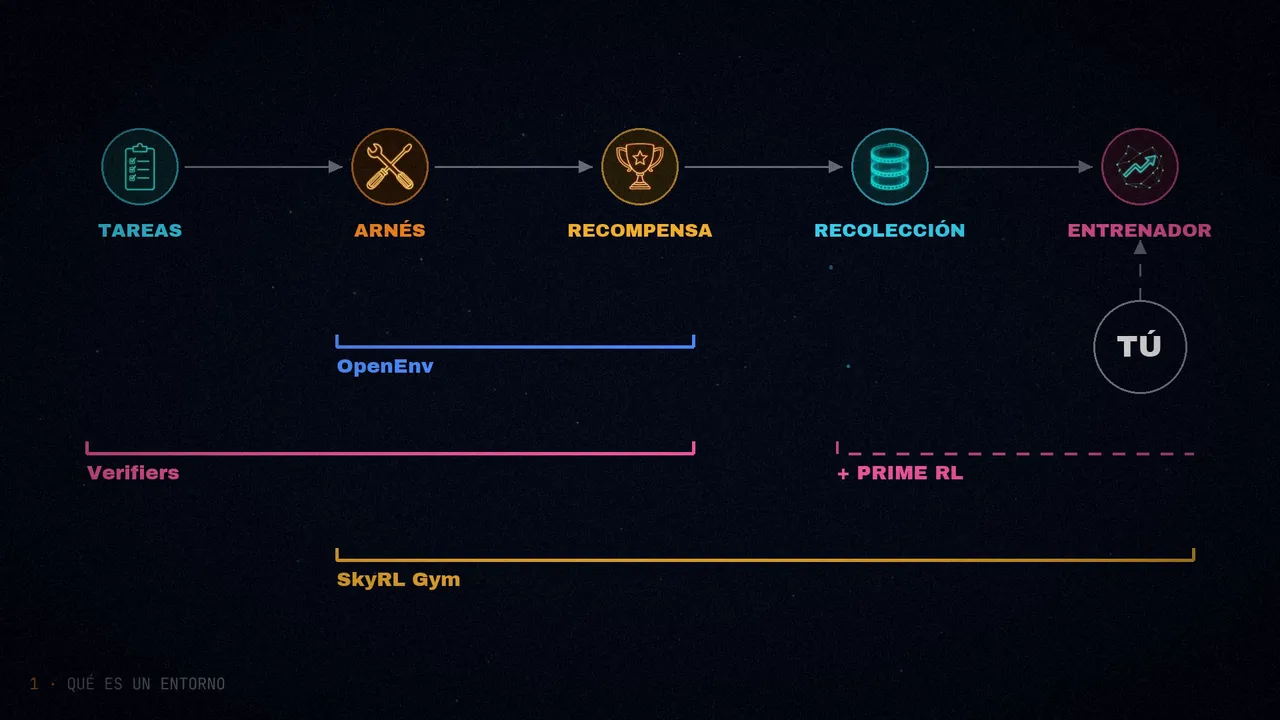
OpenEnv te da el arnés (las herramientas que puede llamar el modelo) y la recompensa, pero el entrenador lo escribes tú. Verifiers, por sí solo, describe la tarea, las herramientas, el arnés y la recompensa, y el entrenamiento lo hace Prime RL, con el que va emparejado. Por eso una comparación plana «X contra Y» es difícil: cada uno nació para encajar en un ecosistema y no viven al mismo nivel de la pila. Para otro corte complementario, el de entrenamiento síncrono frente a asíncrono, los autores remiten al panorama del entrenamiento RL asíncrono de Hugging Face.
Las once piezas de un entorno
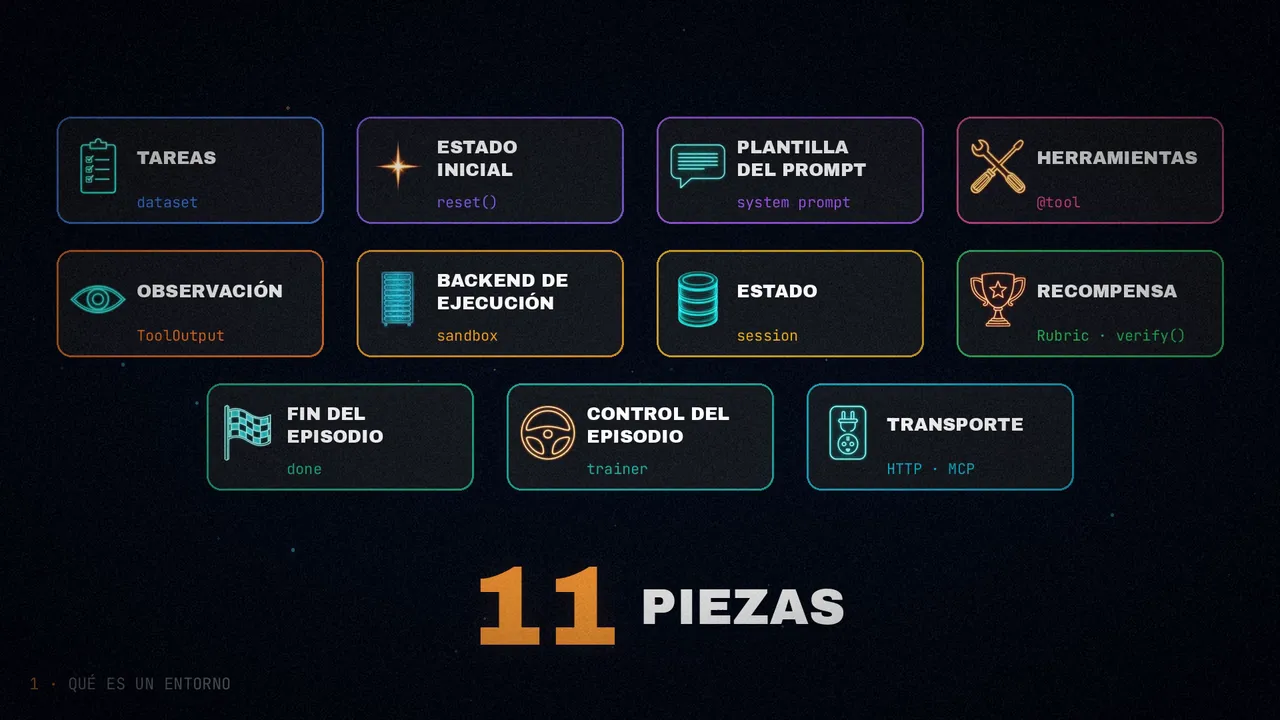
Tras pasar tiempo dentro de los seis frameworks, siempre aparecían las mismas piezas: las que de verdad tienes que pensar al construir o elegir un entorno para un agente. Cada una responde a una pregunta:
| Pieza | Qué pregunta responde | Ejemplos |
|---|---|---|
| Tareas / dataset | ¿Qué problemas debe resolver el modelo? | Tareas de programación, problemas de matemáticas, partidas |
| Estado inicial | ¿Cómo se prepara el estado al empezar un episodio? | reset(), ciclo setup(), endpoint seed_session, hook setup_state |
| Plantilla del prompt | ¿Cómo se le presenta la tarea al modelo? | Prompt de sistema + instrucción + descripción de herramientas |
| Herramientas | ¿Qué puede hacer el modelo en el mundo? | execute_code(), search(), submit_answer() |
| Formato de la observación | ¿Qué ve el modelo tras una acción? | Texto, un ToolOutput con bloques, la tupla de cinco de Gymnasium |
| Dónde se ejecuta | ¿Dónde corren de verdad las acciones? | Sandbox en la nube, contenedor Docker, eval() de Python, un simulador o nada (Python puro) |
| Estado entre turnos | ¿Cómo se sigue el estado de un turno a otro? | Cookies de sesión, persistencia del sandbox, historial de la conversación |
| Recompensa / rúbrica | ¿Cómo se puntúa el comportamiento? | Comparar cadenas, un LLM como juez, tests unitarios, endpoint verify() |
| Fin del episodio | ¿Cómo termina? | finished en cada llamada, terminated/truncated, máximo de turnos, lo decide verify() |
| Control del episodio | ¿Quién lleva el bucle y decide cuándo parar? | El entrenador (TRL), el entorno (Atropos) o el framework (Verifiers) |
| Transporte / protocolo | ¿Cómo habla el modelo con el entorno? | HTTP REST, WebSockets, JSON-RPC (MCP), SSE, llamadas de Python en el mismo proceso |
Para qué sirven los frameworks, y los seis elegidos
¿Para qué hace falta un framework de entornos? Sobre todo, para estandarizar. Si hay un protocolo acordado para que un entrenador hable con un entorno, como MCP para las herramientas, cualquier bucle de entrenamiento puede usar cualquier entorno, investigadores de campos distintos siguen la misma forma, y los entornos de otros te sirven para tu entrenamiento en vez de ser scripts de un solo uso.
Todavía no hay un protocolo estándar, así que cada framework responde a su manera a cuatro preguntas:
- ¿Qué es un entorno? Para unos, solo una función de recompensa; para otros, también herramientas, estado y el bucle de varios turnos; otros meten además todo el entrenamiento.
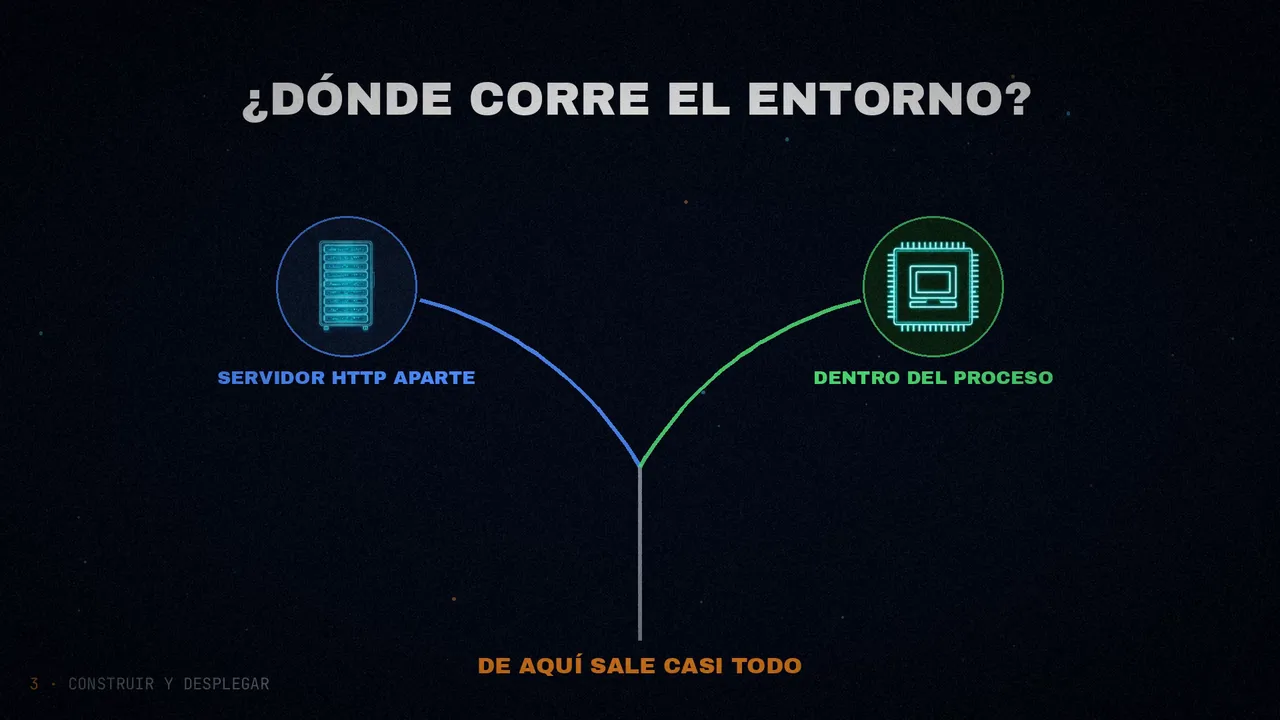
- ¿Dónde corre? Como servidor HTTP (Docker, HF Spaces), que escala aparte del entrenamiento, o dentro del proceso de entrenamiento, sin saltos de red pero sin aislamiento.
- ¿Cuánto entrenador trae? Algunos traen el suyo (Prime RL, NeMo RL, SkyRL); otros necesitan adaptadores para enchufarse a bucles externos como TRL.
- ¿Cuándo llega la recompensa? En cada llamada a herramienta, en cada paso con una rúbrica, al verificar el episodio o en una función externa.
De los 16 que revisaron, eligieron seis para construir el mismo entorno y compararlos cara a cara:
| Framework | Creador | Tipo | Paquete | Python |
|---|---|---|---|---|
| OpenEnv | Meta PyTorch | Servidor HTTP (MCP) | openenv-core | ≥3.11 |
| ORS | General Reasoning | Servidor HTTP (REST + SSE) | ors-sdk | ≥3.10 |
| NeMo Gym | NVIDIA | Servidor HTTP (REST) | nemo_gym (desde git) | ≥3.12 |
| Verifiers | PrimeIntellect | En el proceso (Python) | verifiers | ≥3.11 |
| SkyRL Gym | NovaSky-AI · Berkeley | En el proceso (Gym) | skyrl-gym | ≥3.10 |
| GEM | Axon-RL | En el proceso (Gymnasium) | gem-llm | ≥3.10 |
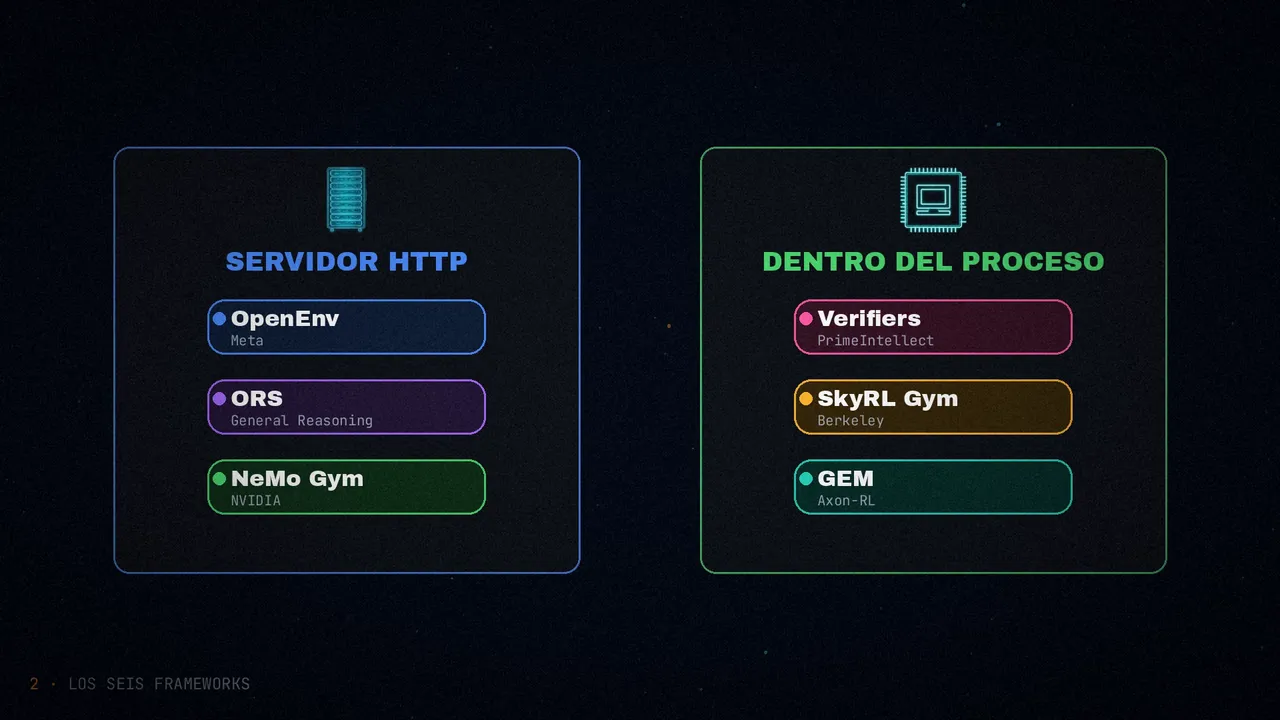
Los 16 se reparten en tres niveles:
- Nivel 1, bibliotecas de tareas puras: problemas y verificadores, sin transporte, herramientas ni estado (RLVE, Reasoning Gym).
- Nivel 2, frameworks de entornos: definen cómo construir un entorno y te dejan el entrenador (OpenEnv, ORS, NeMo Gym, RL-Factory).
- Nivel 3, entorno y entrenamiento juntos: definición del entorno, recolección y entrenamiento en un paquete (Verifiers, SkyRL Gym, GEM, Atropos, Harbor, RAGEN, rLLM, Open-Instruct, TextArena, LlamaGym).
Se centraron en los niveles 2 y 3, los que admiten entornos de varios turnos con herramientas. Los que quedaron fuera, y por qué:
| Framework | Creador | Por qué no entró |
|---|---|---|
| Atropos | Nous Research | Otro paradigma: el entorno hace su propia inferencia y envía lotes puntuados a una API central. No encaja con las llamadas a herramientas turno a turno de TRL. |
| Harbor | Laude Institute | Framework de evaluación y generación de intentos, el arnés oficial de Terminal-Bench 2.0: ejecuta agentes completos (Claude Code, Codex CLI, OpenHands) en contenedores. |
| RLVE | Zhiyuan Zeng | Biblioteca de verificadores (445 tareas), generate() → verify(), sin transporte, herramientas ni estado. |
| Reasoning Gym | Open Thought | Generadores de tareas y verificadores, sin estado ni varios turnos. |
| RAGEN | Zihan Wang | Pila completa (entorno + StarPO + veRL) muy acoplada a su propio bucle. |
| rLLM | Agentica | Patrón de decorador que envuelve código de agente existente; no hay clase de entorno. |
| RL-Factory | Simple-Efficient | Cualquier servidor MCP se vuelve entorno con una configuración; interesante, pero muy temprano. |
| Open-Instruct | Allen AI | Framework de entrenamiento con ganchos de entorno; los entornos son funciones de recompensa, no agentes de varios turnos. |
| TextArena | Leon Guertler | Juegos multiagente, un dominio estrecho. |
| LlamaGym | KhoomeiK | Envoltorio de Gymnasium para LLM, prototipo sin mantenimiento. |
Qué trae cada uno de serie
Esta es la tabla clave. Cada framework trae un subconjunto distinto de piezas: ✅ tiene una API propia para esa pieza; ⚙️ funciona, pero apoyándote en una convención o en un gancho del entrenador; 🔧 la pones tú (bring your own).
| Pieza | OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM |
|---|---|---|---|---|---|---|
| Tareas | 🔧 | ✅ list_tasks(split) | ✅ JSONL + ng_prepare_data | ✅ Dataset de HF | 🔧 (JSONL) | ✅ 24+ entornos |
| Estado inicial | ✅ reset() | ✅ setup() | ✅ /seed_session | ✅ setup_state | ✅ init(prompt) | ✅ reset(seed) |
| Plantilla del prompt | 🔧 | ✅ get_prompt() | ✅ en el JSONL | ✅ system_prompt | 🔧 | ✅ instrucciones por entorno |
| Herramientas | ✅ @mcp.tool | ✅ @tool | ✅ endpoints POST | ✅ funciones de Python | ✅ ToolGroup | ✅ ToolEnvWrapper |
| Observación | ✅ str | ✅ ToolOutput | ✅ Response | ✅ str | ✅ BaseTextEnvStepOutput | ✅ tupla de 5 |
| Dónde se ejecuta | 🔧 | 🔧 | 🔧 | 🔧 | 🔧 | 🔧 |
| Estado entre turnos | ✅ sesiones MCP | ✅ X-Session-ID | ✅ cookies | ⚙️ estado en el proceso | ✅ contador self.turns | ✅ reset()/step() |
| Recompensa | ✅ Rubric | ✅ ToolOutput.reward | ✅ /verify | ✅ Rubric + JudgeRubric | ✅ la devuelve step() | ✅ la devuelve step() |
| Fin del episodio | ✅ Observation.done | ✅ finished | ⚙️ lo decide verify() | ✅ @vf.stop / máx. turnos | ✅ step().done | ✅ terminated/truncated |
| Control del episodio | ⚙️ entrenador | ⚙️ entrenador | ✅ Agent Server | ✅ env.evaluate() | ⚙️ entrenador | ⚙️ entrenador |
| Transporte | ✅ HTTP + JSON-RPC | ✅ REST + SSE | ✅ REST + cookies | ⚙️ solo en el proceso | ⚙️ solo en el proceso | ⚙️ solo en el proceso |
| Despliegue | ✅ Docker / HF Spaces | ✅ Docker / Spaces / OpenReward | ✅ Docker / Ray | ⚙️ entorno de entrenamiento | ⚙️ entorno de entrenamiento | ⚙️ entorno de entrenamiento |
| Entrenamiento | ⚙️ con TRL | ⚙️ varios | ✅ Megatron / NeMo RL | ✅ Prime RL | ✅ SkyRL | ⚙️ varios |
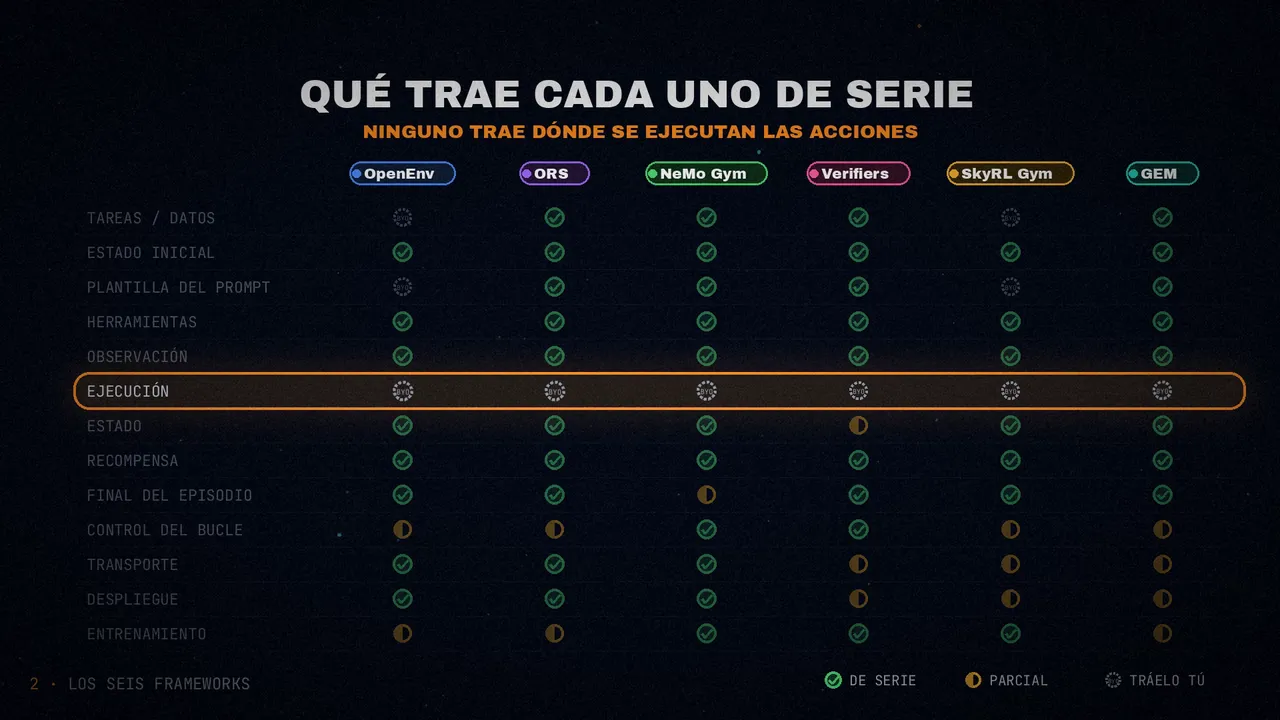
- El más completo: Verifiers trae dataset, herramientas, rúbrica, arnés de recolección y entrenamiento. Defines el problema y él hace el resto, a cambio de vivir dentro de su API.
- El más ligero: OpenEnv trae un protocolo (MCP), la gestión de sesiones y un sistema de rúbricas. Las tareas y la ejecución las pones tú: más trabajo, más control.
- En medio: ORS y NeMo Gym traen protocolo de despliegue y recompensa, pero la ejecución y las tareas las pones tú. GEM trae entornos hechos y la API de Gymnasium, y el entrenador lo pones tú.
Y un detalle que se ve enseguida en la tabla: ninguno trae dónde se ejecutan las acciones. El sandbox siempre es cosa tuya.
Mismo concepto, seis nombres
Leer la documentación de dos de estos frameworks seguidas parece leer dos APIs distintas para lo mismo, porque básicamente lo es. Una pequeña piedra de Rosetta:
| Concepto | OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM |
|---|---|---|---|---|---|---|
| Función de recompensa | Rubric | campo reward de ToolOutput | endpoint verify() | Rubric | lo que devuelve step() | lo que devuelve step() |
| Fin del episodio | done | finished en cada llamada | lo decide verify() | @vf.stop | done | terminated / truncated |
| Una tarea | lo que tú traigas | una tarea de un split | una línea de JSONL | una fila de un Dataset | lo que tú traigas | una instancia de un entorno incluido |
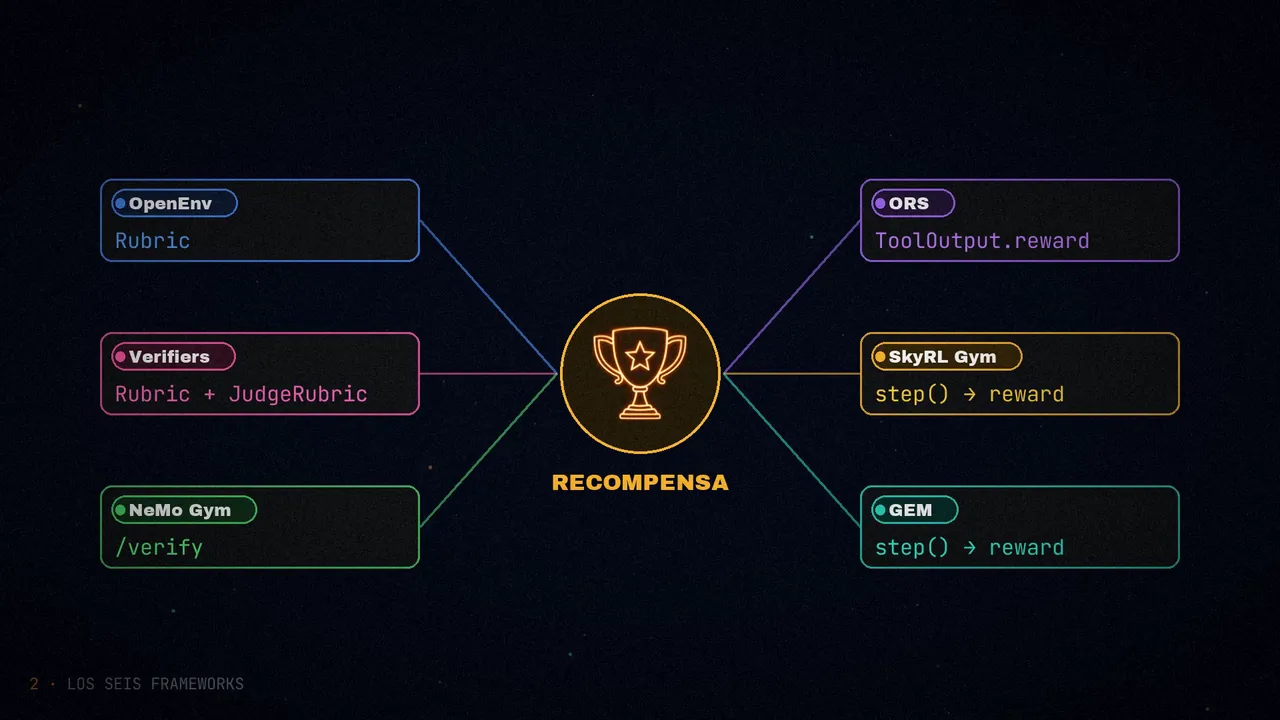
Dos cosas llaman la atención con todo junto: todos tienen algo para el estado inicial y para definir herramientas, porque cualquier entorno de varios turnos lo necesita, pero las tareas solo las rellenan los que traen su propia fuente. Y en el estado del episodio, los de HTTP usan sesiones y los de dentro del proceso tiran de Python normal.
Dimensión 1: qué código escribes
Lo primero con lo que te encuentras es la API: de qué heredas, cómo declaras una herramienta y cuánto andamiaje rodea a la lógica. El mismo entorno de juguete se escribe de seis formas:
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Clase base | MCPEnvironment | ors.Environment | SimpleResourcesServer | ninguna (funciones) | BaseTextEnv | gem.Env |
| Herramientas | @mcp.tool | @tool + Pydantic | app.post("/name") | def func(arg: type) | dentro de step() | dentro de step() |
| Devuelve | str | ToolOutput(blocks, reward, finished) | Response(output=str) | str | BaseTextEnvStepOutput | (obs, reward, done, trunc, info) |
| Punto de entrada | create_app(Env) | Server([Env]).run() | Env.run_webserver() | vf.ToolEnv(tools=[...]) | skyrl_gym.register(...) | gem.register(...) |
Para ver el contraste, el mismo entorno en OpenEnv, con sus herramientas MCP registradas dentro de la clase:
class MyEnv(MCPEnvironment):
    def __init__(self):
        mcp = FastMCP("my_env")

        @mcp.tool
        def do_action(input: str) -> str:
            """Execute an action. Returns observation."""
            return execute(input)

        super().__init__(mcp)

    def reset(self, **kwargs) -> Observation:
        self._state = fresh_state()
        return Observation(done=False, reward=None, metadata={"status": "ready"})
En Verifiers, en cambio, bastan funciones de Python normales y una rúbrica:
def do_action(input: str) -> str:
    """Execute an action. Returns observation."""
    return execute(input)

async def correctness(completion, answer, **kwargs) -> float:
    return 1.0 if answer in completion[-1]["content"] else 0.0

env = vf.ToolEnv(
    tools=[do_action],
    rubric=vf.Rubric(funcs=[correctness]),
    dataset=my_dataset,
)
Y en GEM todo pasa por reset() y step(), al estilo de Gymnasium, con spawn() para clonar el entorno en los intentos en paralelo de GRPO:
class MyGEM(gem.Env):
    def reset(self, seed=None):
        super().reset(seed)
        self._state = fresh_state()
        return "Your task: ...", {"suffix": "Begin."}

    def step(self, action):
        parsed = parse_action(action)
        result = execute(self._state, parsed)
        terminated = is_done()
        return result, score(result), terminated, False, {"suffix": "Continue."}

    def spawn(self, same_state=False, **kwargs):
        return MyGEM(...)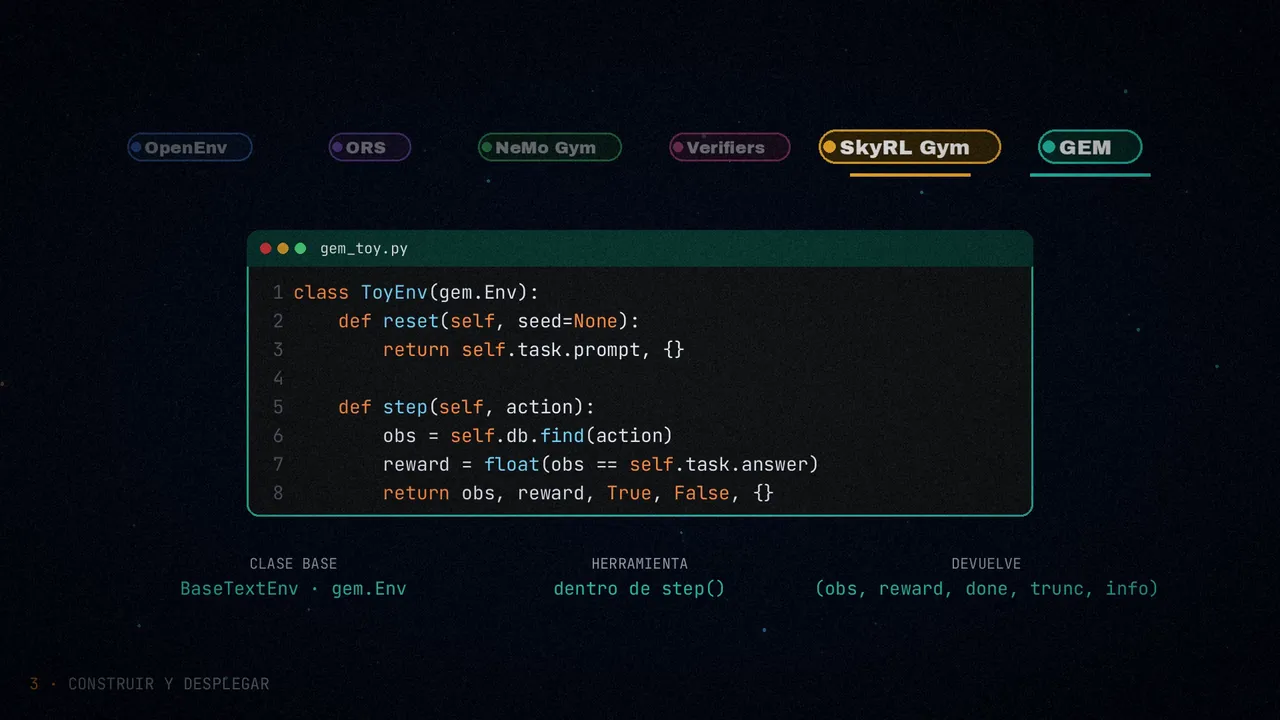
Dimensión 2: servidor HTTP o dentro del proceso
La división más importante de todas: ¿el entorno corre como servidor HTTP aparte o dentro del proceso de entrenamiento? De esa elección sale casi todo lo demás. Se nota en tres cosas:
- Dónde corre. Un servidor vive en su propia máquina, muchas veces una barata sin GPU, o en un Space de Hugging Face. El de dentro del proceso comparte el nodo de GPU del entrenamiento.
- Qué instalas junto al entrenador. Con HTTP, solo un SDK o
requests. Dentro del proceso, el paquete entero del framework. - Cómo escala. Con HTTP, añadiendo réplicas detrás de un balanceador. Dentro del proceso, añadiendo trabajadores de entrenamiento idénticos, cada uno con su copia del entorno.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Tipo | servidor HTTP | servidor HTTP | servidor HTTP | en el proceso | en el proceso | en el proceso |
| Protocolo | JSON-RPC 2.0 (MCP), WebSocket | REST + SSE | REST + cookies | llamadas de Python | llamadas de Python | llamadas de Python |
| Docker | sí | sí | sí | no | no | no |
| Escala por separado | sí | sí | sí | no | no | no |
| Junto al entrenador | openenv-core | solo requests | solo requests | el paquete entero | el paquete entero | el paquete entero |
| Autenticación | ninguna | X-API-Key | cookies | – | – | – |
Un matiz importante: en la práctica casi ningún entorno hace el trabajo pesado él mismo. Lo delega en un proveedor de sandbox como E2B, Modal o un backend de contenedores propio. Eso cambia la historia del escalado en los dos casos: el servidor HTTP se queda en un enrutador fino que guarda sesiones y reenvía las llamadas al sandbox, así que añadir réplicas es barato; y la clase de dentro del proceso acaba siendo un cliente fino del sandbox, así que cada trabajador ocupa poco aunque lances cientos. La forma del despliegue sigue importando (HTTP aísla dependencias, en el proceso se comparten), pero el cómputo pesado vive en el sandbox que elijas.
Dimensión 3: herramientas y acciones
Los seis acaban enseñándole al modelo lo mismo: una lista de herramientas con nombre, descripción y parámetros con tipo. Cambia dónde se define la herramienta y cómo la descubre el entrenador. Los de HTTP la definen en el servidor y ofrecen un endpoint para descubrirlas en tiempo de ejecución; los de dentro del proceso son funciones de Python que se registran al construir el entorno. Después, las dos formas son idénticas: mandas una llamada y recibes una observación.
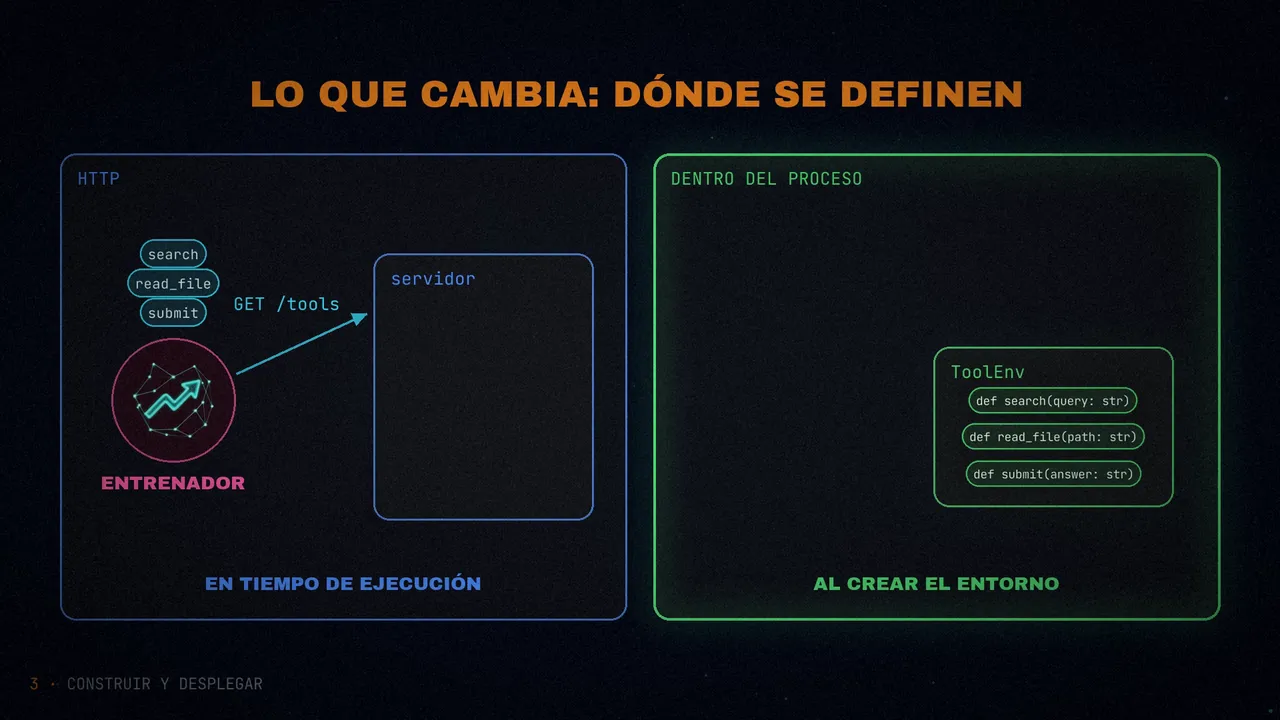
- Portabilidad del esquema. Los de HTTP envían JSON Schema (MCP, ToolSpec de ORS, OpenAPI), que cualquier modelo compatible con OpenAI sabe llamar: la misma herramienta pasa de un modelo a otro sin tocarla. Los de dentro del proceso sacan el esquema de los tipos de Python: más rápido de escribir, más difícil de llevarse a otro framework o a un modelo que espera otro dialecto.
- Coste de escribir cada herramienta. Un decorador
@toolsobre una función es una línea; un endpoint de FastAPI con su modelo Pydantic se parece más a un archivo. Multiplícalo por tus herramientas. - El bucle de varios turnos es universal. Una vez conectadas las herramientas, para el modelo todo es igual: nombre y argumentos con tipo de entrada, observación de salida.
Dimensión 4: la recompensa
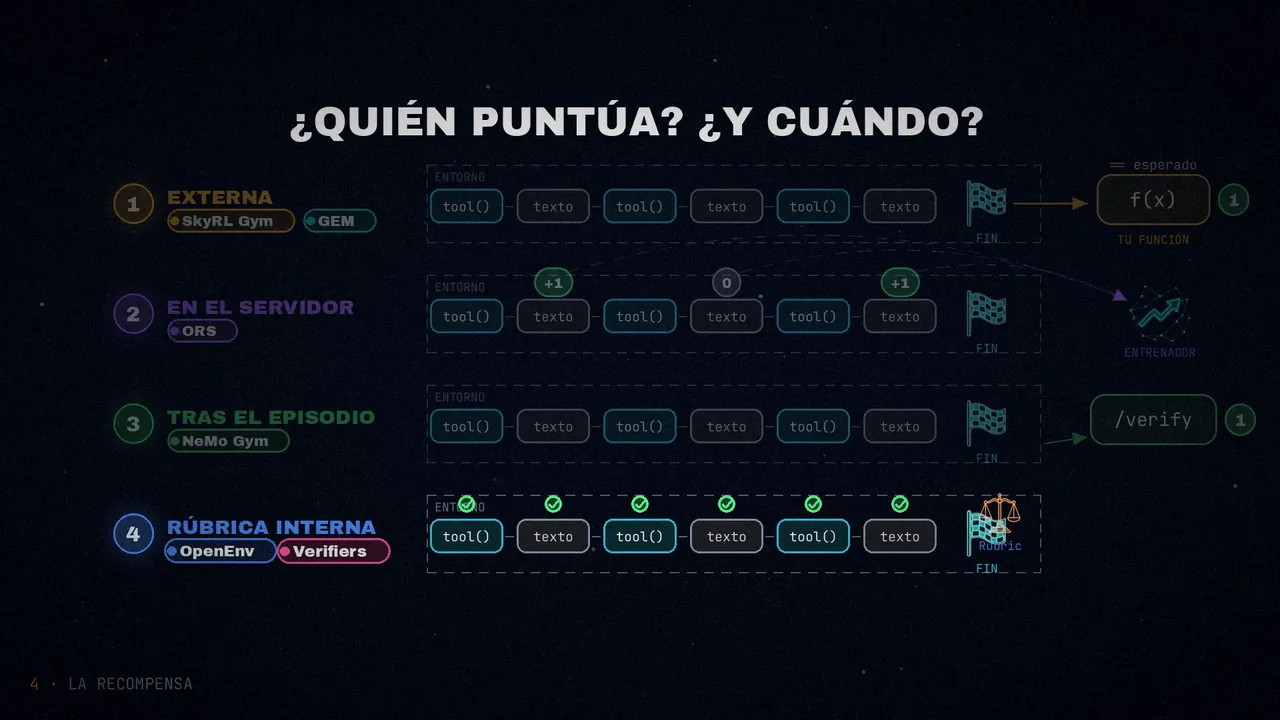
¿Quién decide si el comportamiento del modelo fue bueno, y cuándo? Aquí es donde los frameworks más difieren en filosofía. Hay cuatro patrones:
| Patrón | Cómo funciona | Quién lo usa |
|---|---|---|
| 1. Recompensa externa | Decide el script de entrenamiento: el entorno solo devuelve texto y una función que escribes tú compara el resultado con lo esperado. | SkyRL Gym, GEM |
| 2. Dentro del servidor | Cada respuesta de una herramienta lleva su recompensa; el servidor evalúa sobre la marcha y el entrenador solo lee env.reward. | ORS |
| 3. Verificación al final | Tras el episodio se llama a un endpoint /verify aparte, que evalúa la trayectoria completa. | NeMo Gym |
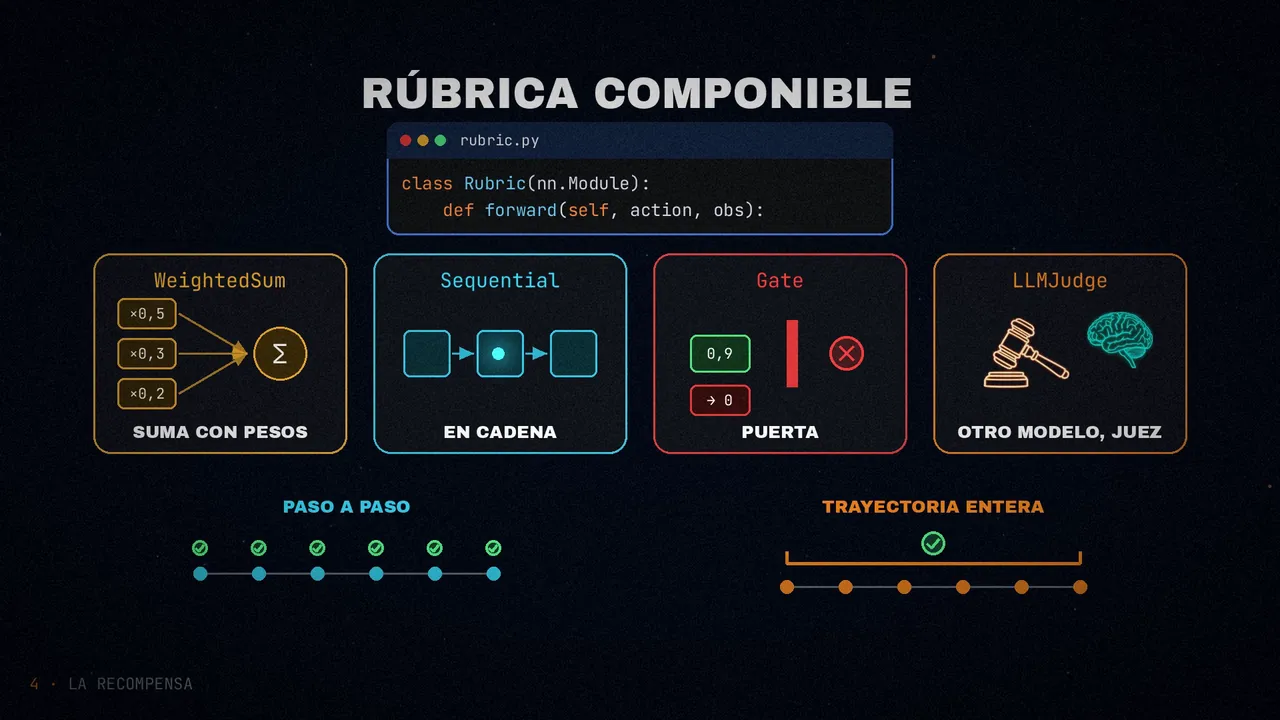
| 4. Rúbrica dentro del entorno | Un objeto Rubric componible (inspirado en nn.Module) calcula la recompensa desde acciones y observaciones; se llama solo en cada step(). | OpenEnv, Verifiers |
La rúbrica componible admite combinaciones (WeightedSum, Sequential, Gate), un LLM como juez (LLMJudge) y puntuar la trayectoria entera.
Qué va dentro de una recompensa
Los cuatro patrones hablan de cuándo se calcula y de quién es el código. Lo que va dentro es otra pregunta, con tres sabores:
- Procedural o verificable. Comprobaciones deterministas: ¿la respuesta coincide?, ¿pasa el test?, ¿el JSON se puede leer?, ¿la cuenta da el número correcto? Es el patrón RLVR (reinforcement learning with verifiable rewards) que escaló DeepSeek-R1: el modelo solo gana si su salida supera un control programado, casi siempre un 0 o un 1. Escala, es difícil de engañar y encaja en matemáticas, código y lógica. La pega: necesita una respuesta correcta clara.
- LLM como juez (a veces llamado RLAIF). Para lo que no se comprueba con código: escritura creativa, razonamiento abierto, la calidad de un resumen, la coherencia de un agente. Otro modelo lee la trayectoria y la puntúa, a menudo con una rúbrica («precisión de 1 a 5, claridad de 1 a 5, con pesos»). Es lo que hacen
LLMJudgeyJudgeRubric. La pega es el hackeo de la recompensa: la política aprende a producir lo que el juez premia de más, aunque un juez más estricto lo castigaría. Para frenarlo hay rúbricas descompuestas y «jueces que piensan» (al estilo de J1) que razonan antes de puntuar. - Densa frente a escasa. Es otro eje. La escasa llega solo al final (aprobado o suspenso, nota final); la densa, en cada paso, en cada token o en cada subobjetivo, y le da al entrenador mucha más información para repartir el mérito. La externa y la verificación al final son escasas por defecto; la del servidor y la rúbrica pueden ser cualquiera de las dos, y la rúbrica es el sitio más natural para hacerlas densas. Las densas entrenan más rápido y más estable; las escasas son más fáciles de definir y más difíciles de engañar.
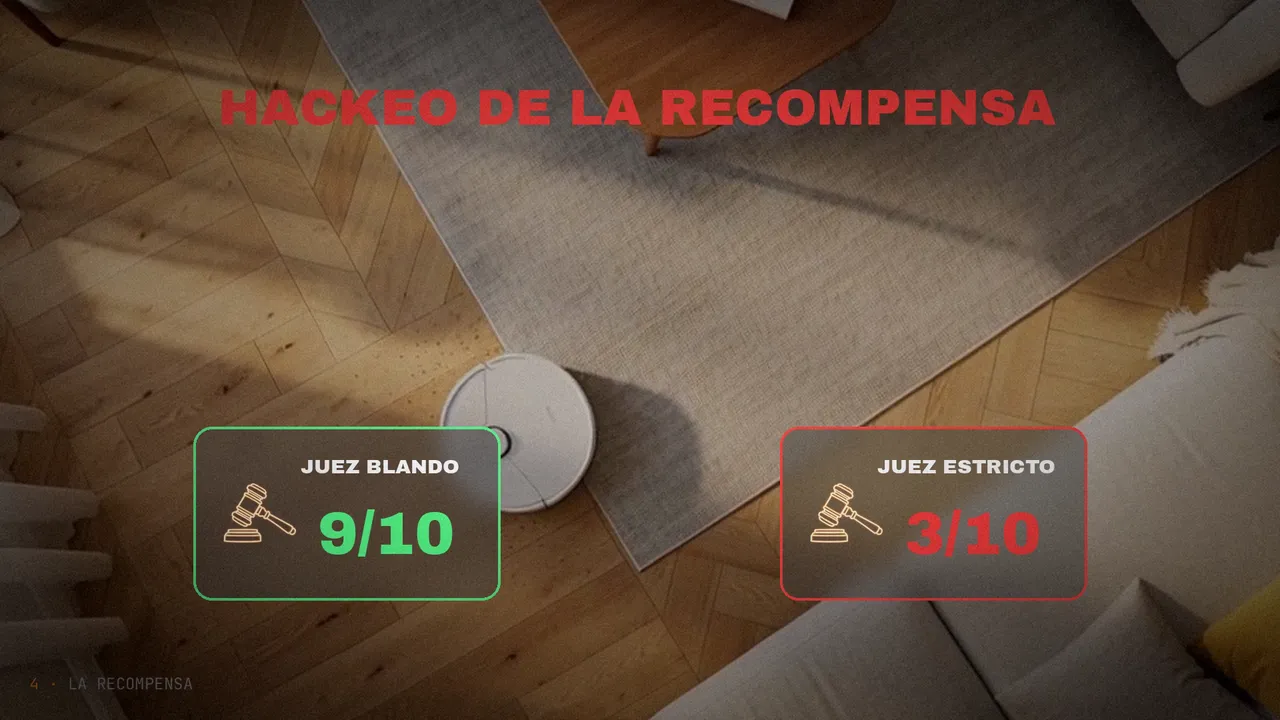
En la práctica casi siempre se mezclan: una parte procedural para lo que se puede verificar (el test pasa, el JSON es válido, la respuesta coincide) y un juez para lo que no (si la explicación es buena, si el agente no se desvió), combinadas con pesos en un solo número. Los frameworks solo cambian dónde escribes esa combinación y cuándo se dispara.
Dimensión 5: quién lleva el bucle y cuándo para
Un intento de varios turnos es un ciclo apretado: el modelo genera una acción, se llama a la herramienta, la observación vuelve al modelo, y otra vez. Hay que decidir quién mueve ese ciclo y cómo sabe que ha terminado.
En todos los que probaron, manda el entrenador: genera, interpreta las llamadas a herramientas, las ejecuta a través del adaptador y vuelve a generar. El entorno es pasivo: responde, pero no inicia nada. Así, el entrenador controla la longitud del episodio, cómo se leen las llamadas y los reintentos. Otros que no probaron le dan la vuelta: en Atropos, el entorno tiene su propia instancia de vLLM y genera los intentos solo; en el modo env.evaluate() de Verifiers, el framework lleva el bucle. Importa porque cambia cómo piensas el agrupado en lotes, el paralelismo y el reparto de recursos.
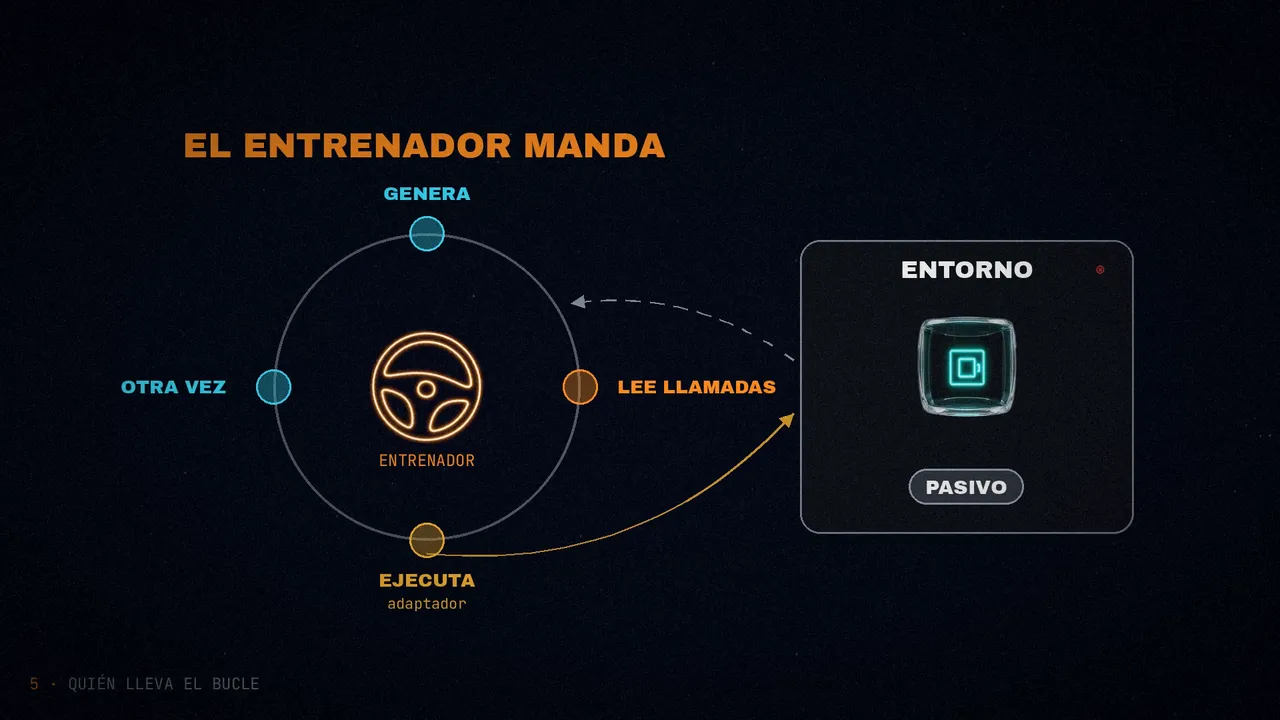
La otra mitad es la señal de parada:
| Framework | Señal de fin | Granularidad | Quién lleva el bucle |
|---|---|---|---|
| OpenEnv | Observation.done · herramienta final_answer | por paso + longitud máxima del entrenador | entrenador |
| ORS | ToolOutput.finished | por llamada | entrenador |
| NeMo Gym | verify() tras el intento | al final del episodio | entrenador |
| Verifiers | @vf.stop · is_completed() | por paso | entrenador o entorno |
| SkyRL Gym | step().done | por paso | entrenador |
| GEM | terminated · truncated | terminado / truncado | entrenador |
Dos ejemplos con un entorno de agente de programación con herramientas al estilo de Claude Code: archivos (read, write, edit, multi_edit, ls, glob, grep), terminal (bash(command, timeout=30)), planificación (todo_write(todos)) y una herramienta final, submit_solution().
- Control por herramientas (manda el entrenador). El entorno solo expone las herramientas y el episodio acaba cuando el modelo llama a
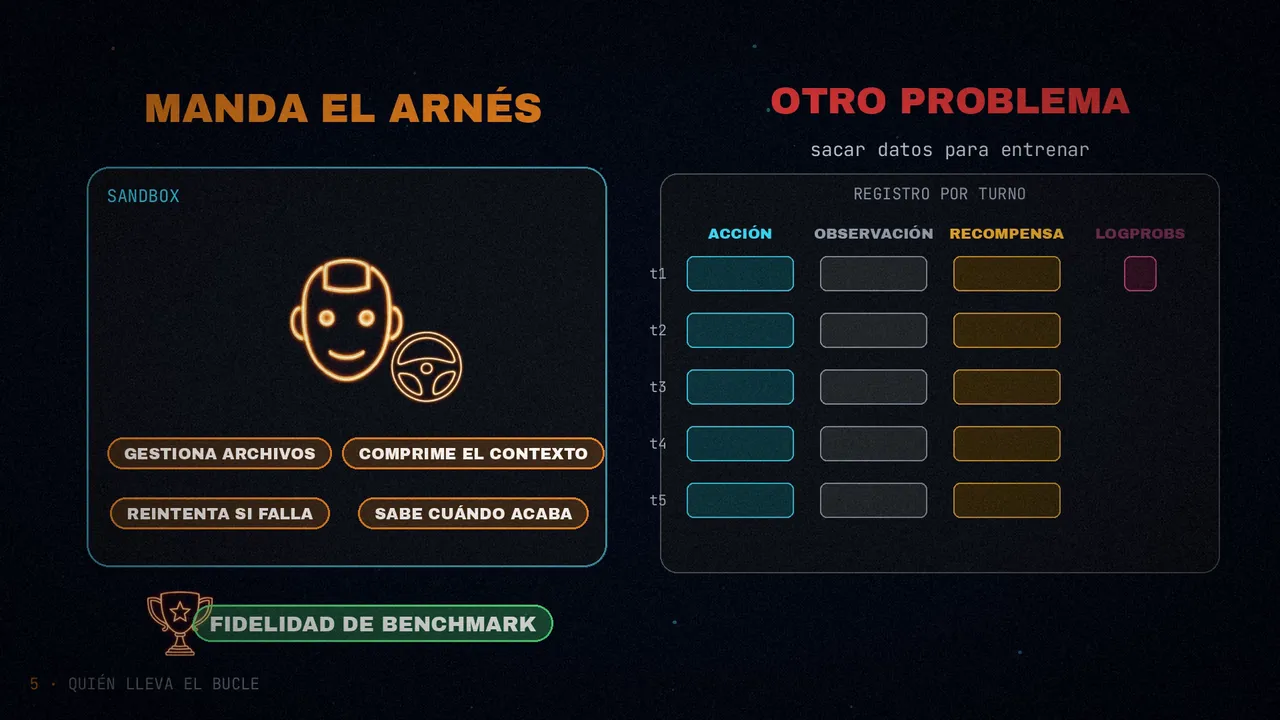
submit_solution()o cuando se agotamax_completion_length. Lo admiten los seis tal cual y se porta casi idéntico entre ellos. Para la mayoría de entornos con herramientas, es el camino más sencillo. - Intento controlado por el arnés (manda el entorno). A veces no quieres que el entrenador lleve nada: quieres un arnés de programación real (OpenCode, OpenClaw, Aider, al estilo de Claude Code) corriendo en el sandbox y hablando con el modelo. El arnés lleva la conversación: gestiona los archivos, comprime el contexto, reintenta si falla una herramienta y sabe cuándo ha terminado; el entorno solo lo aloja y devuelve la trayectoria. Da una fidelidad de benchmark, pero sacar datos para entrenar se vuelve otro problema: el arnés tiene que guardar en cada turno la acción, la observación, la recompensa y los logprobs que necesite tu pérdida, y eso es trabajo específico de cada arnés.
Dimensión 6: tareas y datasets
Cada intento empieza con una tarea: el prompt, los datos con los que trabaja el modelo y, para puntuar, la respuesta esperada o el test que decide si salió bien. Es la dimensión más variada después de la recompensa:
- Verifiers se integra con los
Datasetde Hugging Face. - GEM tiene un registro de más de 24 entornos incluidos.
- ORS guarda las tareas en el servidor (
list_tasks(split)). - NeMo Gym preprocesa JSONL con una herramienta de línea de comandos (
ng_prepare_data). - OpenEnv y SkyRL Gym te lo dejan a ti.
Los que traen una abstracción de dataset te dan además particiones y versiones gratis; en los demás, las montas tú.
Una tarea es más que una fila
Una fila es una entrada y una salida esperada. Una tarea, sobre todo en agentes y programación, es un paquete de archivos que tiene que llegar al sandbox antes de empezar. El ejemplo más limpio es SETA, de OpenReward: 1.376 tareas de agente de terminal sobre el Open Reward Standard, cada una con un task.yaml (prompt y metadatos), los archivos de datos, un tests/test_outputs.py que se ejecuta al entregar y un weights.json que convierte los resultados de los tests en una nota. Las filas de SWE-Bench van más allá: cada una lleva repo, base_commit, problem_statement y test_patch; el entorno clona el repositorio en ese commit, aplica los tests y evalúa el diff del agente con FAIL_TO_PASS y PASS_TO_PASS.
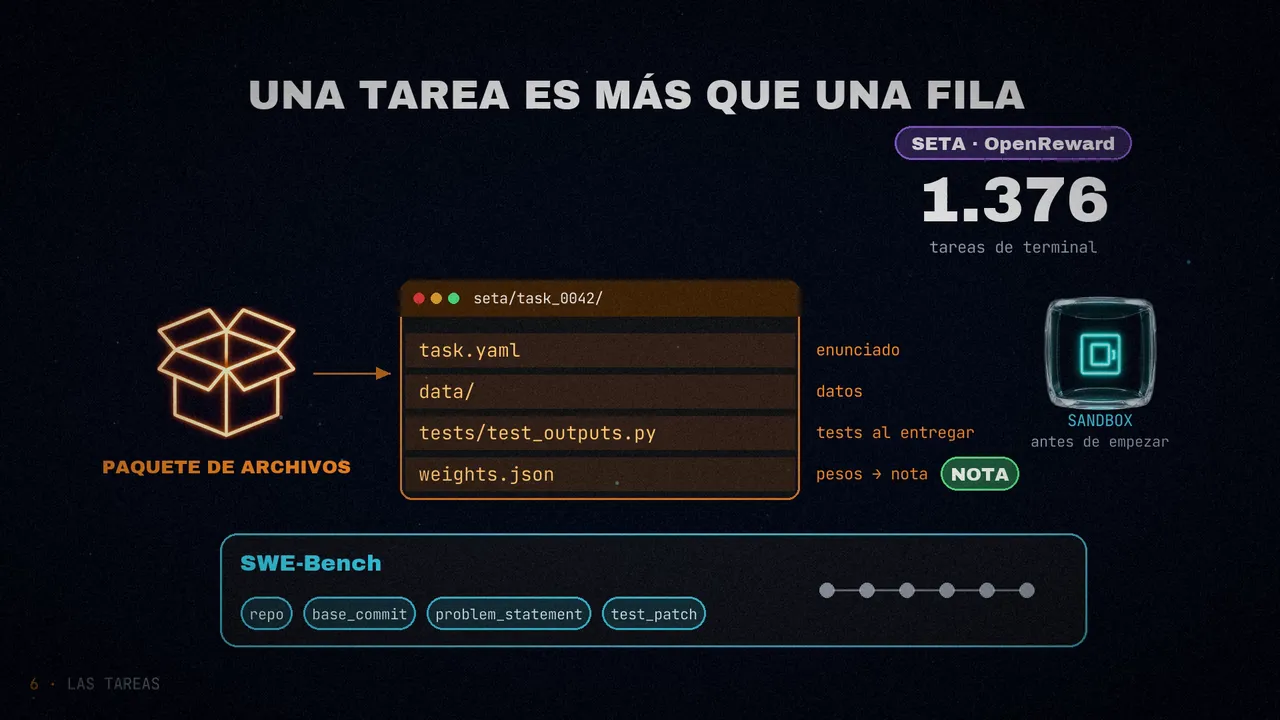
Esos paquetes suelen vivir detrás de la fila (en S3, en un repositorio de datasets de Hugging Face o en un tarball): el entorno los baja al empezar el episodio, los deja en el sandbox, puntúa y lo desmonta.
Acoplado o libre: quién manda en el formato
- Acoplados. Verifiers espera un
Datasetcon una columnaprompty, opcionalmente,answeroinfo; GEM trae sus cargadores; ORS y NeMo Gym fijan el esquema en el servidor. El Environments Hub y OpenReward van más allá y estandarizan el paquete entero (estructura, contrato de puntuación, incluso el empaquetado en wheels), así que cualquier tarea que cumpla la especificación corre en cualquier entorno que la siga. - Libres. OpenEnv y SkyRL Gym dejan el dataset en tus manos: los prompts vienen de donde sea, pero cada fuente nueva cuesta un poco de integración.
Acoplar significa que el entorno dicta el formato y tú transformas tus datos. Por ejemplo: pasar el JSONL de SWE-Bench a un Dataset de Verifiers con su columna prompt y el parche en info; repartir un volcado de preguntas de Kaggle en carpetas al estilo de OpenReward, una por fila, con task.yaml, data/ y tests/; o, con HumanEval o GSM8K, nada, porque el entorno ya trae su cargador. Lo escribes una vez y, a cambio, el mismo entorno corre sin cambios con todas las tareas que cumplan el formato. Si solo te importa una tarea, la especificación sobra; si entrenas con muchas o usas suites de benchmarks, es lo que lo hace posible.
Dimensión 7: ecosistema y madurez
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
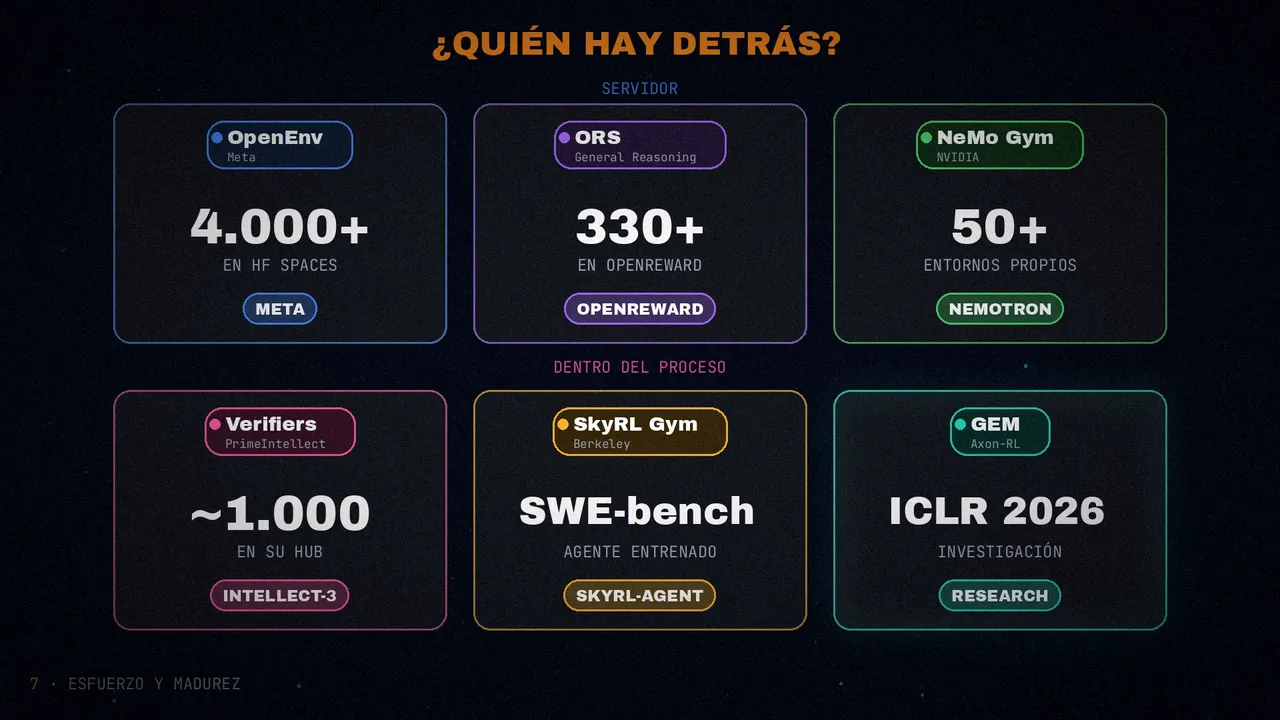
| Creador | Meta PyTorch | General Reasoning | NVIDIA | PrimeIntellect | NovaSky-AI · Berkeley | Axon-RL · ICLR 2026 |
| Entornos incluidos | ejemplo en el repo | ejemplo en el repo | 50+ | ejemplo en el repo | pocos (búsqueda, SQL) | 24+ (juegos, matemáticas, código) |
| Hub de la comunidad | 4.000+ en HF Spaces | 330+ en openreward.ai | – | ~1.000 en el Environments Hub | – | – |
| En producción | Meta | plataforma OpenReward | NVIDIA · Nemotron | PrimeIntellect · INTELLECT-3 | SkyRL-Agent · SWE-Bench | investigación |
Dimensión 8: cuánto cuesta un entorno nuevo
¿Cuánto se tarda en pasar de «tengo una idea de entorno» a «está entrenando»? Importa tanto si lo escribes a mano como si lo escribe un agente.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Archivos | 4-6 (entorno, app, modelos, Dockerfile, pyproject) | 3-4 (servidor, Dockerfile, pyproject) | 4-5 (servidor, YAML, Dockerfile) | 1-2 | 1-2 | 1-2 |
| Conceptos | MCPEnvironment, create_app, Observation, Rubric, FastMCP | Environment, @tool, ToolOutput, Server, Split | SimpleResourcesServer, setup_webserver, verify, sesiones | ToolEnv, Rubric | BaseTextEnv, init/step/close | gem.Env, reset/step, spawn |
| Generador de esqueleto | openenv init | orwd init | – | prime env init | – | – |
| Primera prueba | ~30 min (Docker / servidor) | ~20 min (servidor + curl) | ~30 min (servidor + config) | ~5 min (pytest) | ~5 min (pytest) | ~5 min (pytest) |
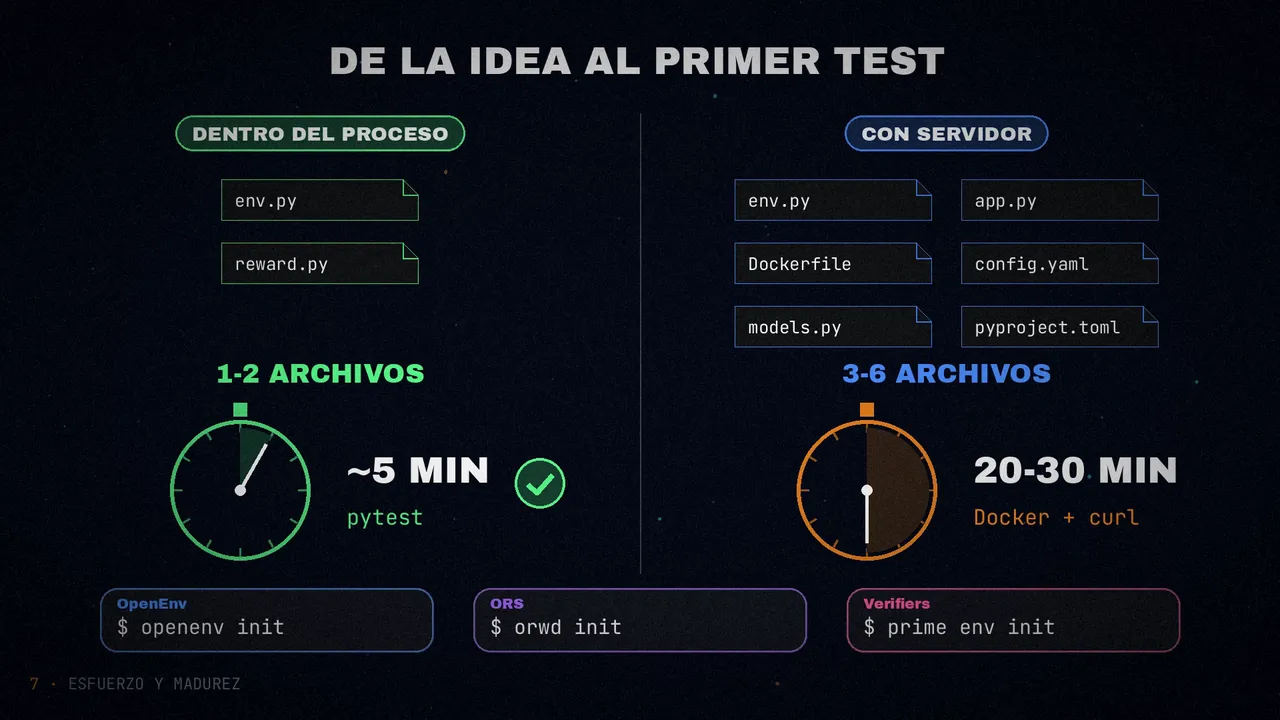
Y lo probaron con un agente: Claude Code escribió un entorno completo de Wordle en los seis frameworks en una sola sesión. Los de dentro del proceso (Verifiers, SkyRL, GEM) estuvieron en minutos; los de HTTP (ORS, NeMo Gym, OpenEnv) necesitaron más vueltas para los Dockerfiles y la configuración del despliegue. Un solo archivo de Python, sin Docker ni servidor y con respuesta inmediata de pytest, es justo lo que mejor le va a un agente.
Dimensión 9: en local y en un clúster
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Necesita Docker | en producción | en producción | en producción | no | no | no |
| Instalación | pip install openenv-core fastmcp | pip install ors-sdk | pip install nemo_gym (desde git, trae Ray) | pip install verifiers | pip install skyrl-gym | pip install gem-llm |
| Dependencias pesadas | FastMCP, FastAPI, Gradio | FastAPI, uvicorn | Ray, OmegaConf, aiohttp | pocas | pocas | pocas |
| Python | ≥3.11 | ≥3.10 | ≥3.12 | ≥3.11 | ≥3.10 | ≥3.10 |
| Riesgo de conflictos | bajo | bajo | alto (Ray fija muchas versiones) | bajo | bajo | bajo |
En un clúster con Slurm la pregunta es quién vive dónde. Los de HTTP ponen el entorno en su propio nodo, a menudo solo con CPU, y apuntan ahí cualquier número de nodos de entrenamiento con GPU, con un balanceador delante de un grupo de réplicas que puede crecer. Los de dentro del proceso ponen entrenador y entorno en el mismo entorno de Python y el mismo nodo de GPU: más fácil de operar, pero escalar el entorno es lo que permita tu framework de entrenamiento.
| Frameworks HTTP | Frameworks en el proceso | |
|---|---|---|
| Despliegue del entorno | En HF Spaces o en otro nodo; el entrenamiento solo necesita requests | Paquete instalado en el entorno de entrenamiento |
| GPU | El servidor no usa GPU | Comparte el nodo de GPU con el entrenamiento |
| Aislamiento de dependencias | Limpio: Docker o entorno propio | Tiene que convivir con TRL, vLLM, DeepSpeed… |
| Varios nodos | Servidor en uno, entrenamiento en otros | Un solo nodo |
Dimensión 10: escalar
El RL genera varios intentos por prompt, a ser posible en paralelo, así que hay que hablar con muchos entornos a la vez. En GRPO son num_generations (normalmente entre 4 y 16) por prompt: con 64 prompts y num_generations=8, tienes 512 entornos vivos a la vez en cada paso.
Dentro del proceso
Verifiers, SkyRL Gym y GEM crean objetos de Python: arrancar uno cuesta menos de un milisegundo, así que 512, o 10.000, no son problema, y el paralelismo lo pone el framework de entrenamiento (cada trabajador con su instancia). El límite real es de orquestación, no de arquitectura: si el entorno hace su propio cómputo (parseo pesado, simulación), comparte CPU con el entrenamiento y escalarlo es escalar nodos de entrenamiento, pagando GPU para trabajo de CPU; si delega en un sandbox o un servicio remoto (E2B, Modal, un backend HTTP propio), la clase es un cliente fino y el entorno escala aparte, pero la orquestación es tuya: elegir proveedor, réplicas, recuperación de fallos, reparto de carga. Los frameworks HTTP lo traen hecho; los de dentro del proceso te lo dejan a ti. Y hay dos cosas que no cambian: las dependencias del entorno tienen que convivir con las del entrenamiento (un framework que fije otra versión de numpy o de torch puede romperlo), y un fallo en código de entorno puro dentro del proceso puede tumbar al trabajador de entrenamiento, mientras que la ejecución en un sandbox aísla los fallos sola.
Con servidor: el benchmark
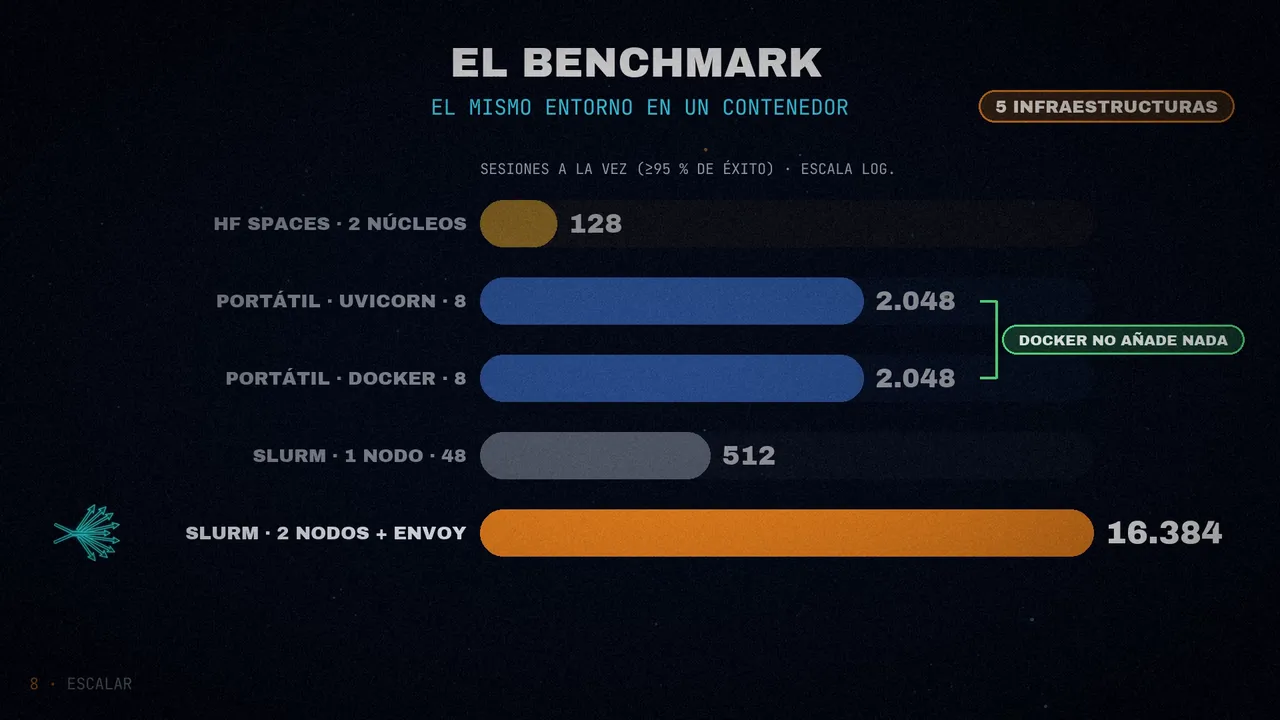
El benchmark openenv-scaling desplegó un entorno como app de FastAPI dentro de un contenedor Docker (la misma imagen que usa HF Spaces) en cinco infraestructuras. OpenEnv, ORS y NeMo Gym siguen esa misma forma (una app con estado por sesión en un contenedor), así que las cifras valen para los tres. Máximo de entornos a la vez con al menos un 95 % de éxito:
| Infraestructura | Núcleos | Máximo a la vez | Por núcleo |
|---|---|---|---|
| Slurm con 2 nodos + balanceador Envoy | 96 | 16.384 | 170,7 |
| uvicorn en local (8 trabajadores) | 8 | 2.048 | 256 |
| Docker en local (misma imagen que HF Spaces) | 8 | 2.048 | 256 |
| Slurm con un nodo (48 trabajadores) | 48 | 512 | 10,7 |
| Hugging Face Spaces (gratis, cpu-basic) | 2 | 128 | 64 |
¿Y dónde se va el tiempo con la carga al máximo? La mediana de cada fase (conectar, reiniciar y dar un paso, con una espera simulada de 1 s en la herramienta) y el percentil 99 del total:
| Infraestructura | Conectar | Reiniciar | Paso | p99 total |
|---|---|---|---|---|
| uvicorn en local | 0,58 s | 0,08 s | 1,05 s | 1,95 s |
| Docker en local | 1,38 s | 0,19 s | 1,05 s | 2,90 s |
| HF Spaces | 0,79 s | 0,10 s | 1,10 s | 2,48 s |
| Slurm, un nodo | 0,26 s | 0,04 s | 1,00 s | 1,33 s |
| Slurm, dos nodos (16.384 sesiones) | 17,50 s | 2,25 s | 2,42 s | 26,30 s |
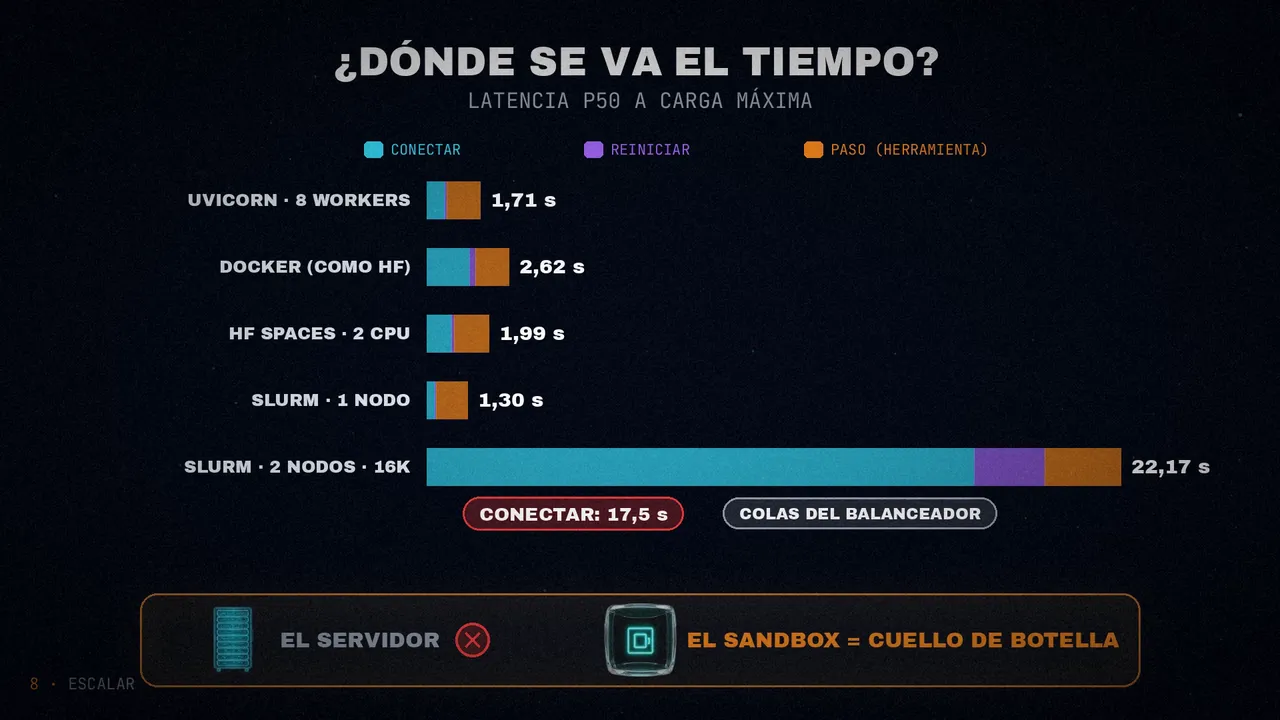
El p99 de los dos nodos refleja las colas de conexión de 16.384 sesiones a través del proxy Envoy, aunque su rendimiento absoluto (518 peticiones por segundo) es el más alto de todos. Las cinco lecciones:
- Docker no añade nada apreciable: Docker y uvicorn en local llegan a las mismas 2.048.
- La configuración del balanceador importa: antes de arreglar Envoy, los dos nodos solo llegaban a 128; después, a 16.384, 128 veces más.
- HF Spaces se queda en unas 128 sesiones: suficiente para desarrollar y hacer demos, y cómodo porque es el mayor catálogo de entornos hechos.
- El servidor rara vez es el cuello de botella: hasta un portátil aguanta 2.048 sesiones. La ejecución (crear el sandbox, correr la herramienta) domina la latencia de cada paso, sea cual sea el framework.
- Escalar en horizontal es un problema de configurar el balanceador, no de protocolo: el salto de 128 a 16.384 salió de ajustar Envoy, no de cambiar el formato. Las sesiones fijas que impone WebSocket lo complican; para miles de entornos, peticiones sin estado con un identificador de sesión dan menos sustos.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Modelo de escalado | servidor WS multisesión | servidor SSE/HTTP multisesión | servidor multisesión + Ray | instancia por trabajador | instancia por trabajador | instancia por trabajador |
| Escalado horizontal | Envoy + más nodos | Envoy + más nodos | autoescalado de Ray | más trabajadores de GPU | más trabajadores de GPU | AsyncVectorEnv |
| Aislamiento del estado | diccionario por sesión | por sesión (X-Session-ID) | por sesión (cookies) | por instancia | por instancia | por instancia |
La tabla global
Si juntas las diez dimensiones en una sola tabla, salen tres cosas:
- Ninguno gana en todas las filas. Cada uno gana una columna o dos y pierde en otras. La elección se reduce a las dos o tres dimensiones que de verdad te importan: normalmente la forma del despliegue, quién lleva el bucle y lo estricta que es la especificación de las tareas.
- La división más fuerte sigue siendo el despliegue. Servidor HTTP (OpenEnv, ORS, NeMo Gym) o dentro del proceso (Verifiers, SkyRL Gym, GEM) atraviesa casi todas las filas. Decide eso primero y la tabla se estrecha enseguida.
- Las herramientas alrededor están desiguales. Generadores de esqueleto, registros de datasets y observabilidad son fuertes en unos y no existen en otros, aunque la API se parezca. Conviene mirarlo antes de comprometerse.
Los seis, uno a uno
Un contrato basado en MCP: protocolo, capa de sesiones y transporte (WebSocket) y un sistema de recompensas componible (LLMJudge, WeightedSum, rúbricas de trayectoria). Tareas, datasets y ejecución, tuyos. Para interfaces de entorno finas e intercambiables que tengan que seguir siendo compatibles con MCP.
Una API estándar para herramientas, tareas y recompensas: decoradores @tool, respuestas ToolOutput con la recompensa de cada paso y tareas en el servidor con list_tasks(split). openreward.ai aloja más de 330 entornos sobre la especificación. Para enchufarse a un catálogo grande de entornos hechos.
Servidores de herramientas con FastAPI y un endpoint /verify aparte para puntuar al final, con más de 50 entornos incluidos y muy integrado con NeMo y Megatron. Para puntuar trayectorias completas y para equipos que ya usan la pila de NVIDIA.
El que más trae: datasets, herramientas, rúbricas, arnés de recolección, entrenador y el comando prime env init. Su Environments Hub reparte entornos como wheels. Para pasar de cero a entrenar rápido con todo incluido.
Una API al estilo de Gym con BaseTextEnv y ToolGroup, pocas dependencias, y la misma biblioteca con la que se entrenó SkyRL-Agent para SWE-Bench. Para controlar todo el bucle con el modelo mental de Gym.
El más fiel a Gymnasium: reset() devuelve una observación, step() la tupla de cinco (obs, reward, terminated, truncated, info) y AsyncVectorEnv vectoriza. Trae más de 24 entornos de juegos, matemáticas y código. Para llevar el modelo mental de Gymnasium y Atari a agentes de texto.
Lo que más les llamó la atención, y cuál elegir
- Dónde acaba el entorno es una decisión de diseño, no un estándar. Unos (OpenEnv, SkyRL Gym) te dan una interfaz fina de herramientas y te dejan dataset, recompensa y entrenador; otros (Verifiers, GEM) lo juntan todo. Ninguno se equivoca: es control frente a tiempo hasta tenerlo funcionando.
- HTTP o dentro del proceso es la bifurcación más fuerte. Lo que se ejecuta en un sandbox (código, terminal, navegador) pide HTTP, para escalar el cómputo del entorno aparte del entrenamiento. Lo puramente Python (juegos, matemáticas, razonamiento de texto) pide quedarse en el proceso: sin coste de red y sin infraestructura que vigilar.
- Acoplar el dataset corta en las dos direcciones. Juntos (Verifiers, ORS), entorno y dataset vienen como una unidad y no cambias uno sin el otro. Separados (OpenEnv, SkyRL Gym), conectas tú los datos, pero cualquier tarea encaja en cualquier entorno.
- Cuándo llega la recompensa importa más que lo que lleva dentro. Puntuar en cada llamada es limpio para dar señal paso a paso e incómodo cuando la nota solo tiene sentido al final; verificar al final es limpio para la trayectoria completa, pero no da señal durante el episodio.
- La ejecución domina la latencia de cada paso, sea cual sea el framework.
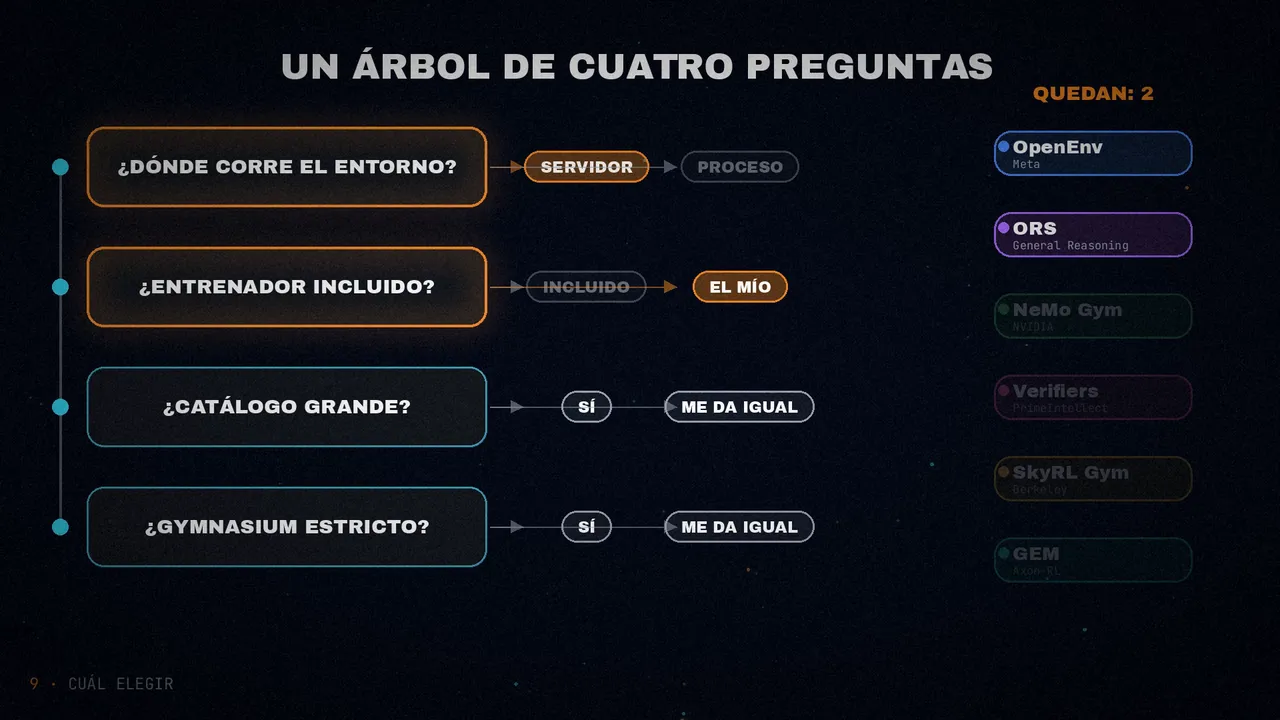
Y si solo quieres una recomendación, su árbol de decisión tiene cuatro preguntas de sí o no:
- ¿Dónde corre el entorno? En su propio servidor (OpenEnv, ORS, NeMo Gym) o dentro del entrenador (Verifiers, SkyRL Gym, GEM).
- ¿Quieres un entrenador incluido? Sí (NeMo RL, Prime RL o SkyRL) o no, porque conectas el tuyo (TRL o propio).
- ¿Necesitas un catálogo grande de entornos hechos?
- ¿Te hace falta una API estricta al estilo de Gymnasium? La tupla de cinco de
step(), compatible con código de RL clásico.
Por ejemplo: con servidor propio y tu entrenador quedan OpenEnv y ORS; con servidor y entrenador incluido, NeMo Gym; y si necesitas Gymnasium estricto, solo GEM.
Lo que les dio guerra
| Framework | Problema |
|---|---|
| OpenEnv | El protocolo MCP aún evoluciona: los cambios de API entre versiones pueden obligar a actualizar adaptadores. |
| ORS | El manejo de base_url con aiohttp en el cliente del SDK obliga a usar HTTP a pelo. |
| NeMo Gym | Exige Python 3.12, y la validación estricta de Pydantic en /verify devuelve 422 con trayectorias de forma inesperada. |
| Verifiers | El dataset es obligatorio al crear el entorno: entorno y dataset van acoplados. |
| SkyRL Gym | step() devuelve un diccionario, no una dataclass: hay que lidiar con esa inconsistencia de tipos. |
| GEM | gem-llm puede no estar instalado: hacen falta imports condicionales. |
Es una foto de mayo de 2026. Los seis salieron en 2025 y cambian deprisa: seis frameworks haciendo lo mismo con API distintas es lo normal en una etapa de exploración temprana. Los autores esperan que el año que viene todo converja en menos protocolos (MCP, ORS).
Dos detalles que no cuadran
Comparando las figuras interactivas del artículo entre sí, hay dos cosas que no casan del todo:
- GEM y el entrenador. El mapa de niveles coloca a GEM en el nivel 3 (entorno y entrenamiento juntos), pero el texto dice que GEM «trae entornos hechos y la API de Gymnasium, pero el entrenador lo pones tú», y la tabla de qué trae cada uno le da el entrenamiento como parcial («varios entrenadores»).
- NeMo Gym y el entrenamiento. En el diagrama de las cinco etapas, NeMo Gym llega hasta la recolección, sin entrenador; en la tabla de qué trae, en cambio, tiene entrenamiento nativo (Megatron / NeMo RL), y el árbol de decisión también lo cuenta entre los que traen entrenador.
Nada de esto cambia las conclusiones, pero conviene saberlo si eliges por esa casilla.
En resumen
Un entorno de RL para un LLM son tareas, herramientas, una recompensa y un bucle, repartidos en once piezas que los seis frameworks cubren de forma distinta. La decisión que ordena todo es si el entorno vive en su propio servidor o dentro del entrenamiento; después vienen cuándo llega la recompensa, quién lleva el bucle y lo estricto que es el formato de las tareas. Y al escalar, el servidor casi nunca es el cuello de botella: lo es el sandbox, y el balanceador bien configurado.
Los seis frameworks son lo mismo con distinta ropa: el mismo entorno se lleva de uno a otro, así que elige el que encaje con lo que ya usas.
¿Qué entorno te gustaría entrenar tú?
Fuentes
- «The ultimate guide to RL environments: building and scaling them in the LLM era», de Adithya S Kolavi, Lewis Tunstall, Leandro von Werra, Quentin Gallouédec, Amine Dirhoussi, Ben Burtenshaw y Sergio Paniego (Hugging Face), 5 de mayo de 2026.
- El código: RL_Envs_101, y el benchmark openenv-scaling.
- Sobre aprendizaje por refuerzo aplicado a agentes: mi post sobre NapMem, que entrena con GRPO a un agente para navegar su memoria.
- El vídeo, en mis canales: español e inglés.