Por que os ambientes importam
O aprendizado por reforço (RL) virou o grande motor dos modelos que raciocinam e dos agentes: é onde o ajuste fino supervisionado empaca e o reforço continua subindo o desempenho. E a peça central é o ambiente: o lugar onde o modelo pratica, recebe uma nota e aprende com a interação ao longo de muitos passos.
Para ganhar capacidades, o número de ambientes disparou:
- O Qwen3 treinou com cerca de 20 tarefas de domínio geral.
- O Qwen3-Coder passou para 20.000 ambientes em paralelo na Alibaba Cloud.
- O Forge, da MiniMax, treina o M2.5 com centenas de milhares de ambientes tirados do mundo real.
- O Qwen3.5 já fala de ambientes com milhões de agentes e distribuições de tarefas cada vez mais complexas.
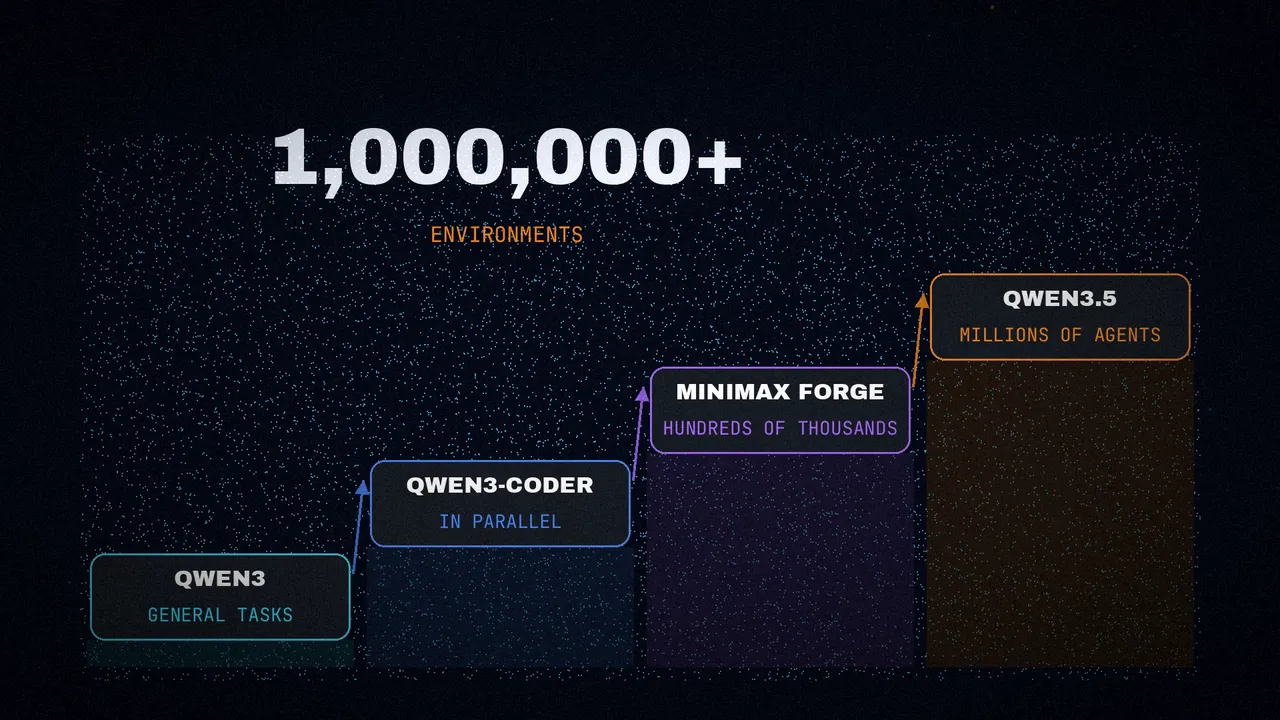
A equipe do Qwen diz sem rodeios nas notas do Qwen3.5: quase todo o ganho sobre o Qwen3 vem de «escalar praticamente todas as tarefas e ambientes de RL que conseguimos imaginar», aumentando de propósito a dificuldade e a generalidade em vez de otimizar para benchmarks específicos.
Então o gargalo já não é «eu sei montar um ambiente?», e sim «como rodo 100.000 ao mesmo tempo, mantenho todos honestos e coloco no loop de treinamento?». Para isso estão surgindo frameworks que padronizam o processo e catálogos de ambientes prontos: o maior está nos Hugging Face Spaces, com mais de 4.000 ambientes compatíveis com MCP, e o Environments Hub da Prime Intellect e o openreward.ai somam vários milhares a mais.
A conclusão dos autores, logo de cara: cada framework faz a mesma coisa do seu jeito. As diferenças estão em como o ambiente se conecta ao resto do treinamento, não no que ele consegue fazer. O mesmo ambiente pode ser replicado nos seis, então você não perde nada fundamental escolhendo um ou outro: o que muda é a conveniência, e isso depende do que você já usa. Todo o código está no repositório RL_Envs_101.
O que é um ambiente de RL na era dos LLMs
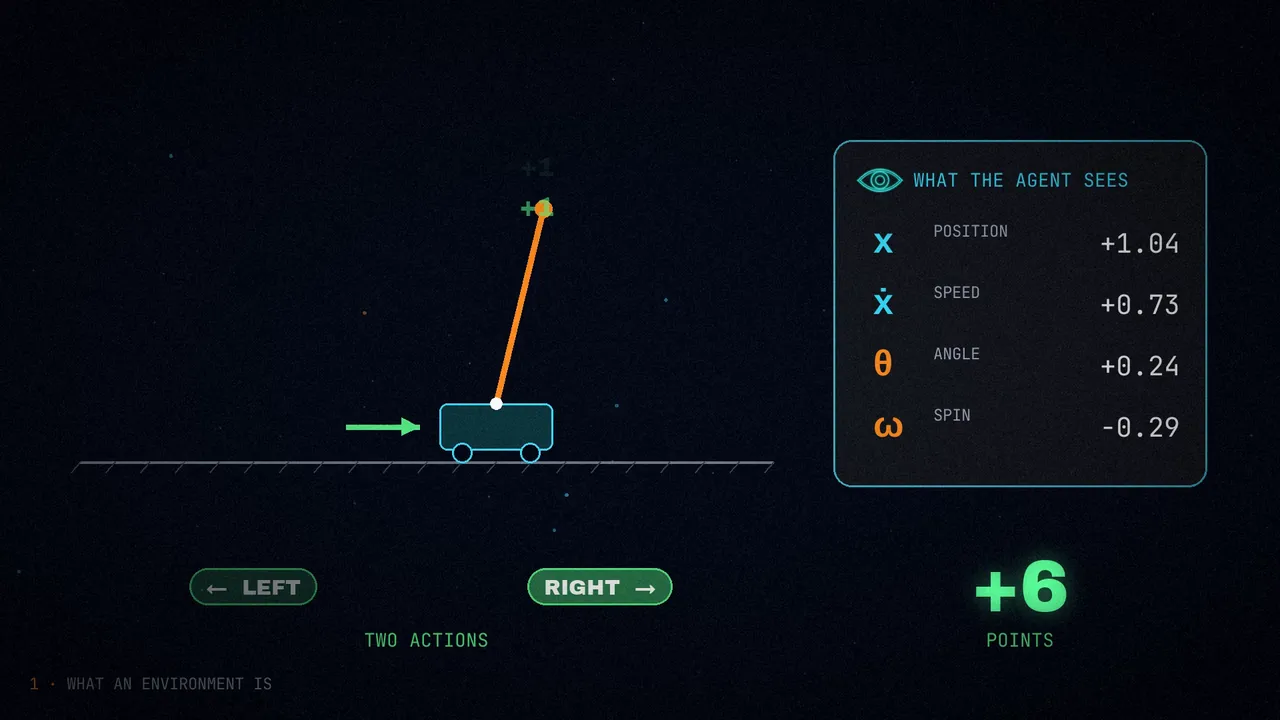
No RL clássico (Atari, robótica), um ambiente é pequeno e autocontido. O exemplo de manual é o CartPole: um carrinho sobre um trilho com uma haste equilibrada em cima. O agente observa quatro números (posição e velocidade do carrinho, ângulo e velocidade angular da haste), escolhe uma de duas ações (empurrar para a esquerda ou para a direita) e o ambiente avança um passo de física. A recompensa é +1 por cada passo em que a haste continua em pé. O ambiente é o simulador de física mais a regra da recompensa.
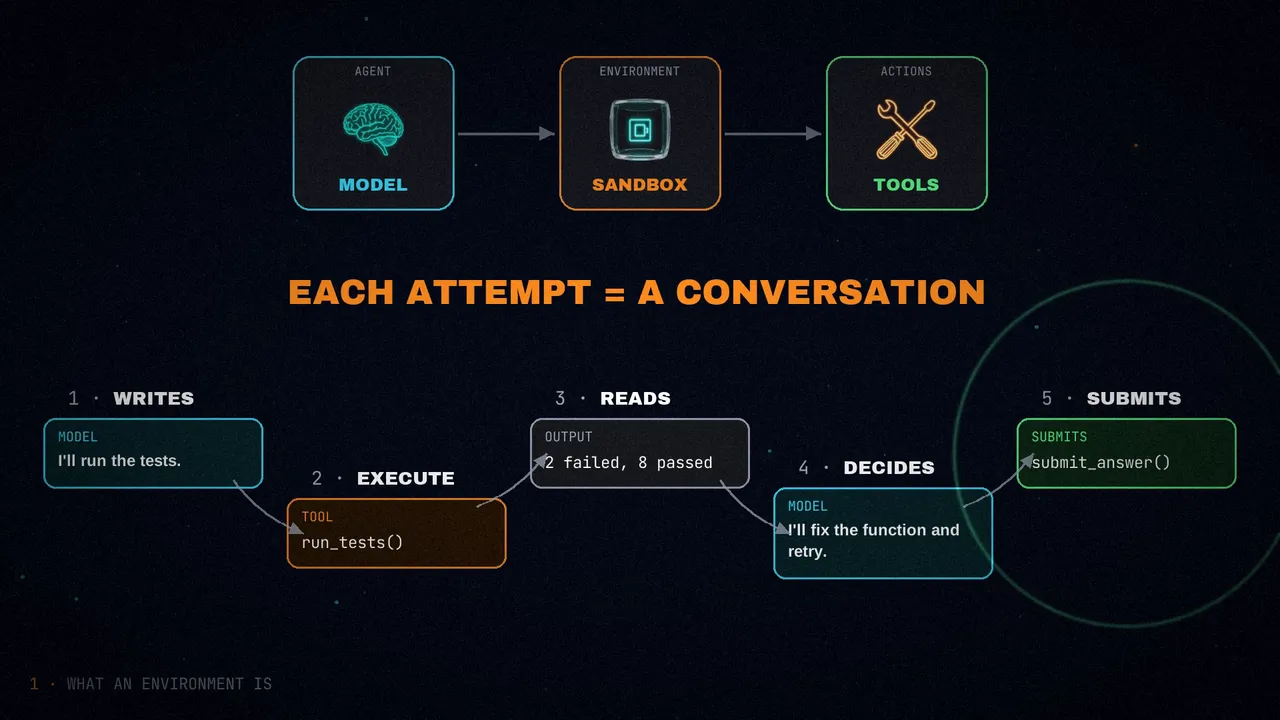
Com modelos de linguagem o quadro fica mais complexo, e não existe uma implementação canônica. Uma forma comum: o agente é o modelo; o ambiente, um sandbox que executa comandos ou código; e o espaço de ações, as ferramentas que o framework expõe. Cada tentativa (rollout) é uma conversa de vários turnos: o modelo escreve, executa uma ferramenta, lê a saída, decide o que tentar e no fim entrega uma resposta. O ambiente avalia a tentativa completa e devolve uma recompensa, e cada passo de treinamento junta um grupo de tentativas por tarefa para aprender com elas.
Existem muitas outras formas (raciocínio em um só turno, tarefas web, agentes sobre repositórios, vários agentes), mas todas são variações do mesmo esqueleto. Mudam as ferramentas, as observações e a regra da recompensa.
As cinco etapas e quem cobre o quê
Todo sistema de treinamento por reforço para LLMs se apoia na mesma espinha de cinco etapas: tarefas para resolver, um harness que deixa o modelo interagir, uma recompensa que avalia o comportamento, um coletor que junta episódios completos e um treinador que transforma esses episódios em uma atualização da política. O que muda de um framework para outro é qual pedaço dessa espinha já vem pronto:
| Framework | Tarefas | Harness | Recompensa | Coleta | Treinador |
|---|---|---|---|---|---|
| OpenEnv | – | ✓ | ✓ | – | – |
| ORS | ✓ | ✓ | ✓ | – | – |
| NeMo Gym | ✓ | ✓ | ✓ | ✓ | – |
| Verifiers + Prime RL | ✓ | ✓ | ✓ | ✓ | ✓ |
| SkyRL Gym | – | ✓ | ✓ | ✓ | ✓ |
| GEM | ✓ | ✓ | ✓ | – | – |
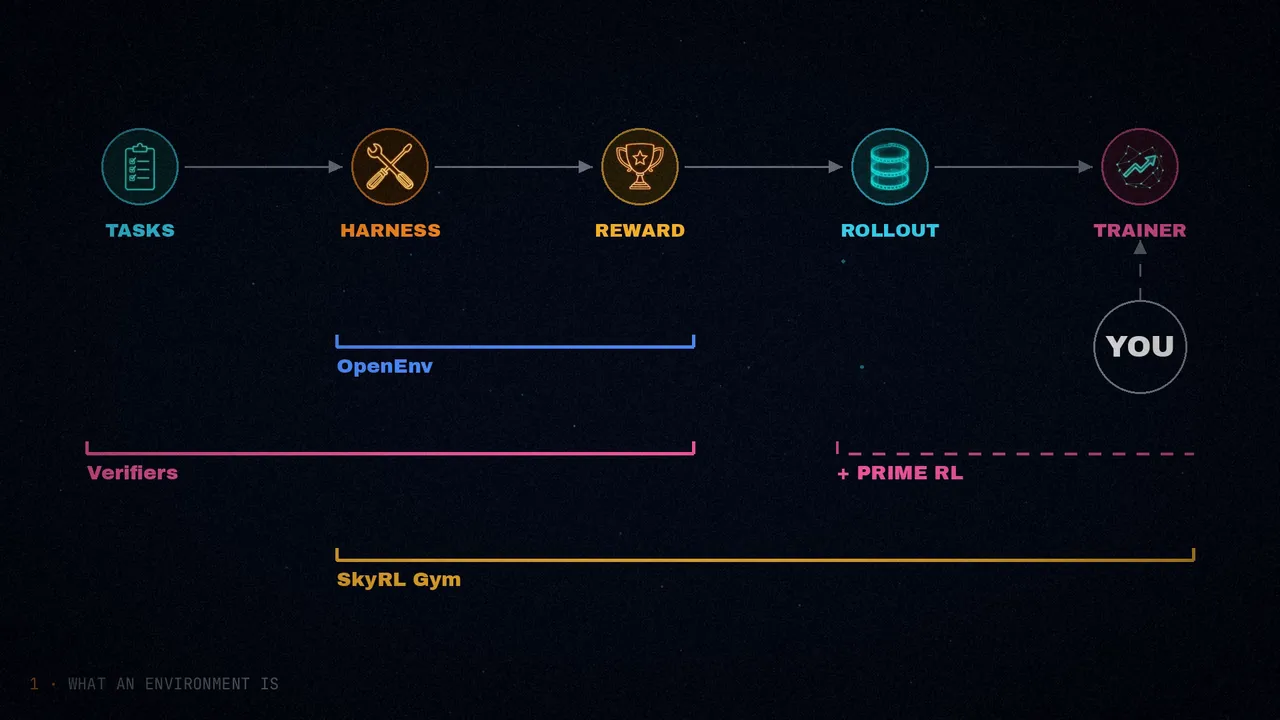
O OpenEnv te dá o harness (as ferramentas que o modelo pode chamar) e a recompensa, mas o treinador você escreve. O Verifiers, sozinho, descreve a tarefa, as ferramentas, o harness e a recompensa, e o treinamento fica com o Prime RL, com quem ele faz par. Por isso uma comparação plana «X contra Y» é difícil: cada um nasceu para se encaixar em um ecossistema, e eles não vivem no mesmo nível da pilha. Para um recorte complementar, treinamento síncrono contra assíncrono, os autores indicam o panorama do treinamento de RL assíncrono da Hugging Face.
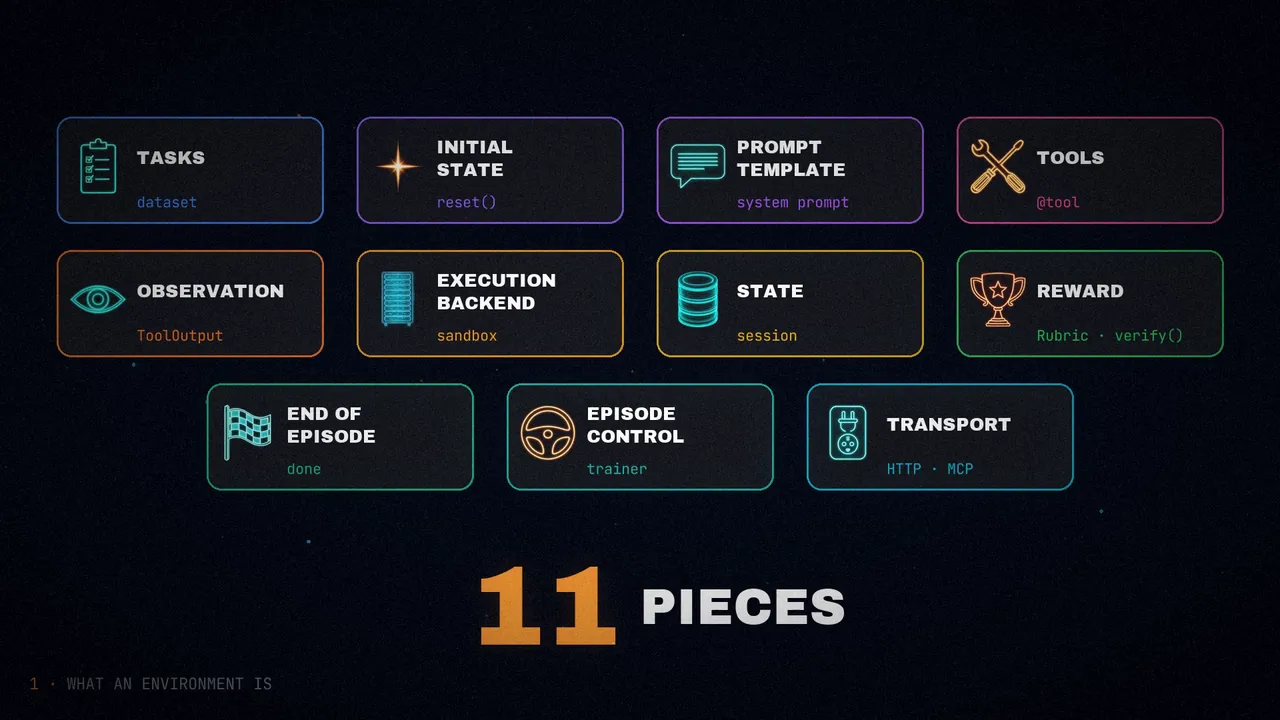
As onze peças de um ambiente
Depois de passar tempo dentro dos seis frameworks, sempre apareciam as mesmas peças: as que você realmente precisa pensar ao construir ou escolher um ambiente para um agente. Cada uma responde a uma pergunta:
| Peça | Que pergunta responde | Exemplos |
|---|---|---|
| Tarefas / dataset | Que problemas o modelo deve resolver? | Tarefas de programação, problemas de matemática, partidas |
| Estado inicial | Como o estado é preparado no início de um episódio? | reset(), ciclo setup(), endpoint seed_session, hook setup_state |
| Template do prompt | Como a tarefa é apresentada ao modelo? | Prompt de sistema + instrução + descrição das ferramentas |
| Ferramentas | O que o modelo pode fazer no mundo? | execute_code(), search(), submit_answer() |
| Formato da observação | O que o modelo vê depois de uma ação? | Texto, um ToolOutput com blocos, a tupla de cinco do Gymnasium |
| Onde executa | Onde as ações rodam de verdade? | Sandbox na nuvem, contêiner Docker, eval() do Python, um simulador ou nada (Python puro) |
| Estado entre turnos | Como o estado é acompanhado de um turno para o outro? | Cookies de sessão, persistência do sandbox, histórico da conversa |
| Recompensa / rubrica | Como o comportamento é avaliado? | Comparar strings, um LLM como juiz, testes unitários, endpoint verify() |
| Fim do episódio | Como termina? | finished em cada chamada, terminated/truncated, máximo de turnos, quem decide é o verify() |
| Controle do episódio | Quem conduz o loop e decide quando parar? | O treinador (TRL), o ambiente (Atropos) ou o framework (Verifiers) |
| Transporte / protocolo | Como o modelo fala com o ambiente? | HTTP REST, WebSockets, JSON-RPC (MCP), SSE, chamadas de Python no mesmo processo |
Para que servem os frameworks, e os seis escolhidos
Para que serve um framework de ambientes? Principalmente, para padronizar. Se existe um protocolo combinado para um treinador falar com um ambiente, como o MCP para as ferramentas, qualquer loop de treinamento pode usar qualquer ambiente, pesquisadores de áreas diferentes seguem a mesma forma, e os ambientes dos outros servem para o seu treinamento em vez de serem scripts de uso único.
Ainda não existe um protocolo padrão, então cada framework responde do seu jeito a quatro perguntas:
- O que é um ambiente? Para uns, só uma função de recompensa; para outros, também ferramentas, estado e o loop de vários turnos; outros ainda incluem todo o treinamento.
- Onde ele roda? Como servidor HTTP (Docker, HF Spaces), que escala separado do treinamento, ou dentro do processo de treinamento, sem saltos de rede mas também sem isolamento.
- Quanto treinador vem junto? Alguns trazem o seu (Prime RL, NeMo RL, SkyRL); outros precisam de adaptadores para se conectar a loops externos como o TRL.
- Quando chega a recompensa? A cada chamada de ferramenta, a cada passo com uma rubrica, ao verificar o episódio ou em uma função externa.
Dos 16 que analisaram, escolheram seis para construir o mesmo ambiente e comparar frente a frente:
| Framework | Criador | Tipo | Pacote | Python |
|---|---|---|---|---|
| OpenEnv | Meta PyTorch | Servidor HTTP (MCP) | openenv-core | ≥3.11 |
| ORS | General Reasoning | Servidor HTTP (REST + SSE) | ors-sdk | ≥3.10 |
| NeMo Gym | NVIDIA | Servidor HTTP (REST) | nemo_gym (via git) | ≥3.12 |
| Verifiers | PrimeIntellect | No processo (Python) | verifiers | ≥3.11 |
| SkyRL Gym | NovaSky-AI · Berkeley | No processo (Gym) | skyrl-gym | ≥3.10 |
| GEM | Axon-RL | No processo (Gymnasium) | gem-llm | ≥3.10 |
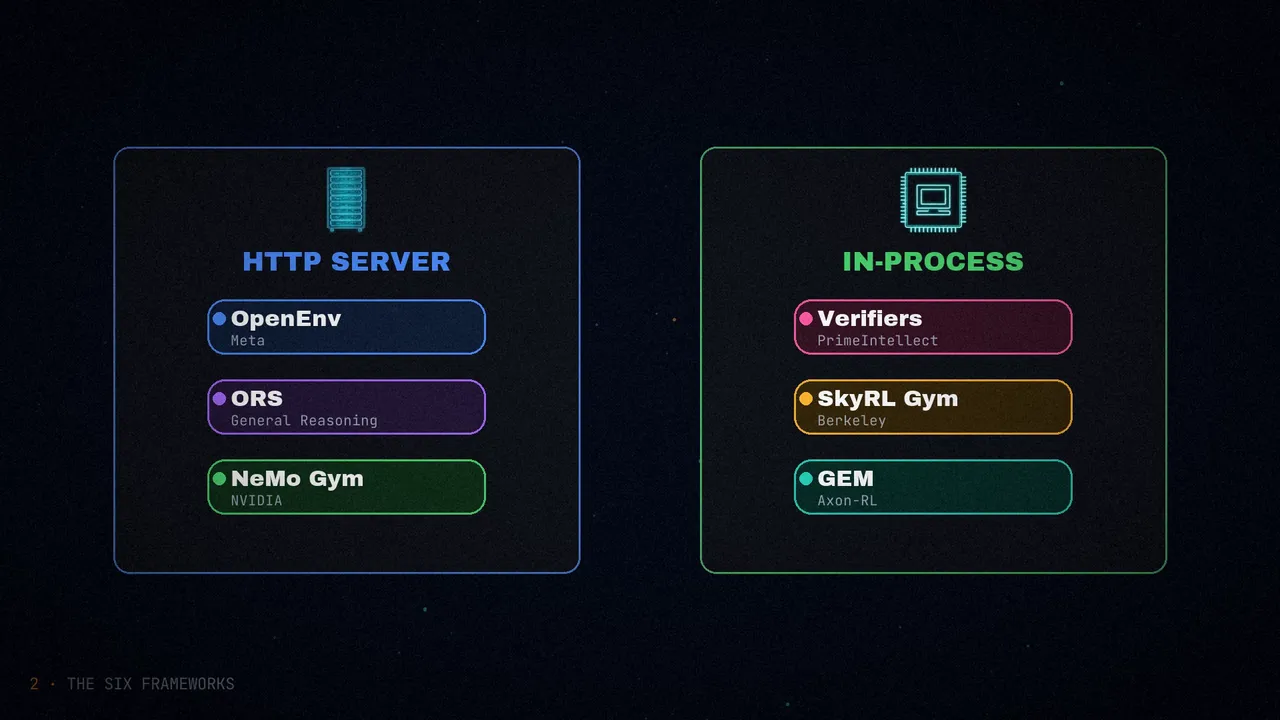
Os 16 se dividem em três níveis:
- Nível 1, bibliotecas de tarefas puras: problemas e verificadores, sem transporte, ferramentas nem estado (RLVE, Reasoning Gym).
- Nível 2, frameworks de ambientes: definem como construir um ambiente e deixam o treinador com você (OpenEnv, ORS, NeMo Gym, RL-Factory).
- Nível 3, ambiente e treinamento juntos: definição do ambiente, coleta e treinamento em um pacote (Verifiers, SkyRL Gym, GEM, Atropos, Harbor, RAGEN, rLLM, Open-Instruct, TextArena, LlamaGym).
Eles focaram nos níveis 2 e 3, os que suportam ambientes de vários turnos com ferramentas. Os que ficaram de fora, e por quê:
| Framework | Criador | Por que ficou de fora |
|---|---|---|
| Atropos | Nous Research | Outro paradigma: o ambiente faz sua própria inferência e envia lotes avaliados para uma API central. Não combina com as chamadas de ferramenta turno a turno do TRL. |
| Harbor | Laude Institute | Framework de avaliação e geração de tentativas, o harness oficial do Terminal-Bench 2.0: roda agentes completos (Claude Code, Codex CLI, OpenHands) em contêineres. |
| RLVE | Zhiyuan Zeng | Biblioteca de verificadores (445 tarefas), generate() → verify(), sem transporte, ferramentas nem estado. |
| Reasoning Gym | Open Thought | Geradores de tarefas e verificadores, sem estado nem vários turnos. |
| RAGEN | Zihan Wang | Pilha completa (ambiente + StarPO + veRL) muito acoplada ao próprio loop. |
| rLLM | Agentica | Padrão de decorador que envolve código de agente existente; não há classe de ambiente. |
| RL-Factory | Simple-Efficient | Qualquer servidor MCP vira ambiente com uma configuração; interessante, mas muito no começo. |
| Open-Instruct | Allen AI | Framework de treinamento com ganchos de ambiente; os ambientes são funções de recompensa, não agentes de vários turnos. |
| TextArena | Leon Guertler | Jogos multiagente, um domínio estreito. |
| LlamaGym | KhoomeiK | Wrapper de Gymnasium para LLMs, protótipo sem manutenção. |
O que cada um traz de fábrica
Esta é a tabela-chave. Cada framework traz um subconjunto diferente de peças: ✅ tem uma API própria para essa peça; ⚙️ funciona, mas apoiado em uma convenção ou em um gancho do treinador; 🔧 quem traz é você (bring your own).
| Peça | OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM |
|---|---|---|---|---|---|---|
| Tarefas | 🔧 | ✅ list_tasks(split) | ✅ JSONL + ng_prepare_data | ✅ Dataset do HF | 🔧 (JSONL) | ✅ 24+ ambientes |
| Estado inicial | ✅ reset() | ✅ setup() | ✅ /seed_session | ✅ setup_state | ✅ init(prompt) | ✅ reset(seed) |
| Template do prompt | 🔧 | ✅ get_prompt() | ✅ no JSONL | ✅ system_prompt | 🔧 | ✅ instruções por ambiente |
| Ferramentas | ✅ @mcp.tool | ✅ @tool | ✅ endpoints POST | ✅ funções de Python | ✅ ToolGroup | ✅ ToolEnvWrapper |
| Observação | ✅ str | ✅ ToolOutput | ✅ Response | ✅ str | ✅ BaseTextEnvStepOutput | ✅ tupla de 5 |
| Onde executa | 🔧 | 🔧 | 🔧 | 🔧 | 🔧 | 🔧 |
| Estado entre turnos | ✅ sessões MCP | ✅ X-Session-ID | ✅ cookies | ⚙️ estado no processo | ✅ contador self.turns | ✅ reset()/step() |
| Recompensa | ✅ Rubric | ✅ ToolOutput.reward | ✅ /verify | ✅ Rubric + JudgeRubric | ✅ devolvida por step() | ✅ devolvida por step() |
| Fim do episódio | ✅ Observation.done | ✅ finished | ⚙️ quem decide é o verify() | ✅ @vf.stop / máx. de turnos | ✅ step().done | ✅ terminated/truncated |
| Controle do episódio | ⚙️ treinador | ⚙️ treinador | ✅ Agent Server | ✅ env.evaluate() | ⚙️ treinador | ⚙️ treinador |
| Transporte | ✅ HTTP + JSON-RPC | ✅ REST + SSE | ✅ REST + cookies | ⚙️ só no processo | ⚙️ só no processo | ⚙️ só no processo |
| Implantação | ✅ Docker / HF Spaces | ✅ Docker / Spaces / OpenReward | ✅ Docker / Ray | ⚙️ ambiente de treinamento | ⚙️ ambiente de treinamento | ⚙️ ambiente de treinamento |
| Treinamento | ⚙️ com TRL | ⚙️ vários | ✅ Megatron / NeMo RL | ✅ Prime RL | ✅ SkyRL | ⚙️ vários |
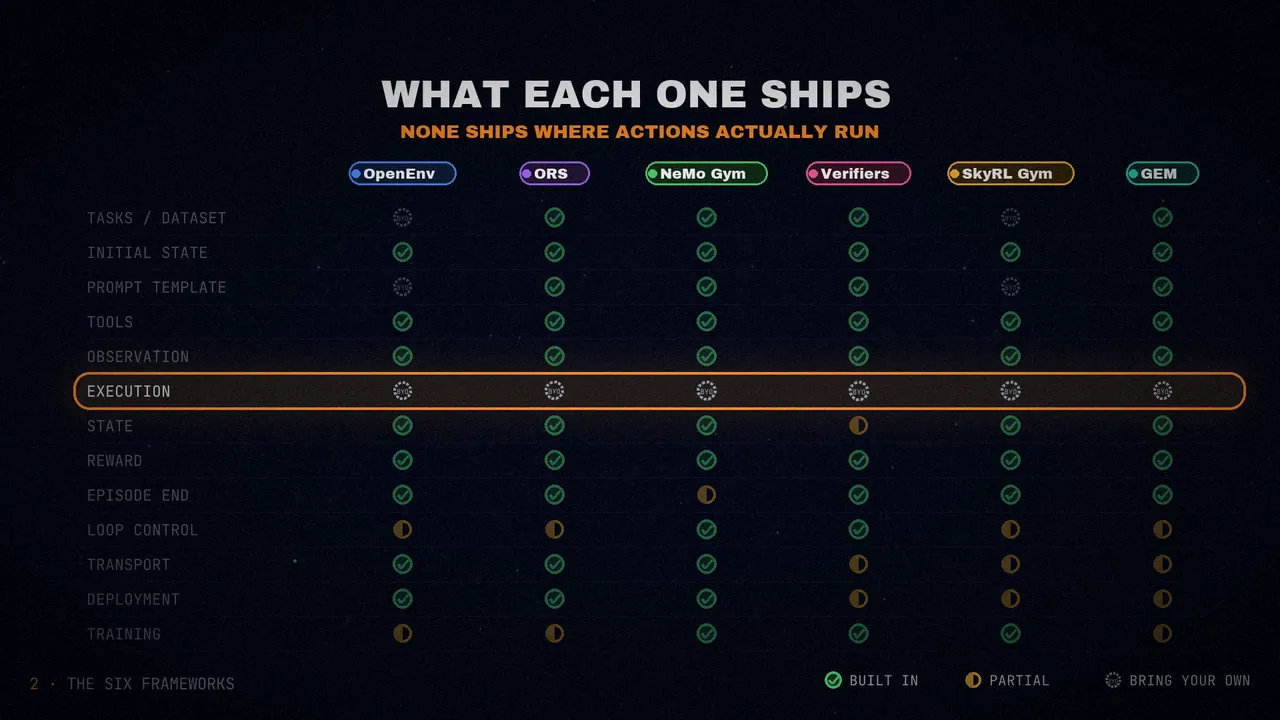
- O mais completo: o Verifiers traz dataset, ferramentas, rubrica, harness de coleta e treinamento. Você define o problema e ele faz o resto, em troca de viver dentro da API dele.
- O mais enxuto: o OpenEnv traz um protocolo (MCP), a gestão de sessões e um sistema de rubricas. As tarefas e a execução são por sua conta: mais trabalho, mais controle.
- No meio: ORS e NeMo Gym trazem protocolo de implantação e recompensa, mas a execução e as tarefas são suas. O GEM traz ambientes prontos e a API do Gymnasium, e o treinador fica com você.
E um detalhe salta aos olhos na tabela: nenhum traz onde as ações são executadas. O sandbox é sempre por sua conta.
Mesmo conceito, seis nomes
Ler a documentação de dois desses frameworks em sequência parece ler duas APIs diferentes para a mesma coisa, porque basicamente é isso. Uma pequena pedra de Roseta:
| Conceito | OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM |
|---|---|---|---|---|---|---|
| Função de recompensa | Rubric | campo reward do ToolOutput | endpoint verify() | Rubric | o que step() devolve | o que step() devolve |
| Fim do episódio | done | finished em cada chamada | quem decide é o verify() | @vf.stop | done | terminated / truncated |
| Uma tarefa | o que você trouxer | uma tarefa de um split | uma linha de JSONL | uma linha de um Dataset | o que você trouxer | uma instância de um ambiente incluído |
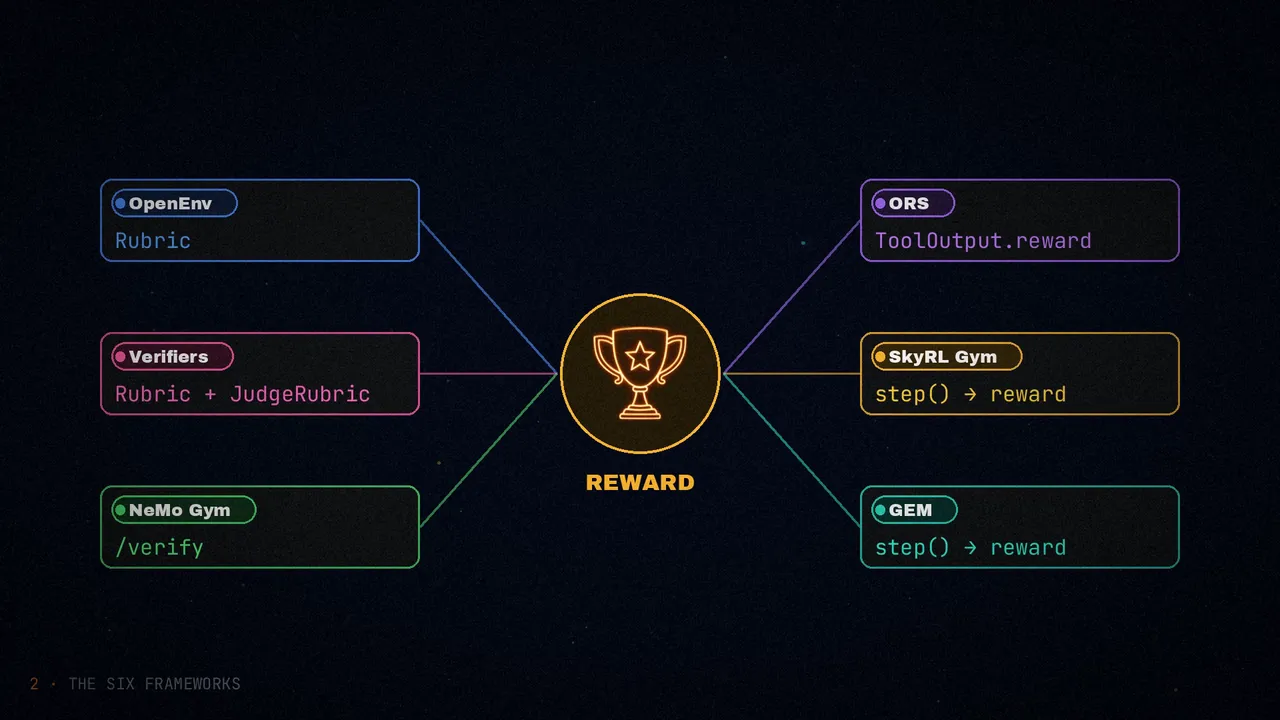
Duas coisas chamam a atenção com tudo junto: todos têm algo para o estado inicial e para definir ferramentas, porque qualquer ambiente de vários turnos precisa disso, mas as tarefas só são preenchidas por quem traz a própria fonte. E no estado do episódio, os de HTTP usam sessões e os de dentro do processo recorrem a Python comum.
Dimensão 1: que código você escreve
A primeira coisa que você encontra é a API: de que classe herdar, como declarar uma ferramenta e quanto código de estrutura envolve a lógica. O mesmo ambiente de brinquedo sai de seis formas:
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Classe base | MCPEnvironment | ors.Environment | SimpleResourcesServer | nenhuma (funções) | BaseTextEnv | gem.Env |
| Ferramentas | @mcp.tool | @tool + Pydantic | app.post("/name") | def func(arg: type) | dentro de step() | dentro de step() |
| Retorna | str | ToolOutput(blocks, reward, finished) | Response(output=str) | str | BaseTextEnvStepOutput | (obs, reward, done, trunc, info) |
| Ponto de entrada | create_app(Env) | Server([Env]).run() | Env.run_webserver() | vf.ToolEnv(tools=[...]) | skyrl_gym.register(...) | gem.register(...) |
Para ver o contraste, o mesmo ambiente no OpenEnv, com as ferramentas MCP registradas dentro da classe:
class MyEnv(MCPEnvironment):
    def __init__(self):
        mcp = FastMCP("my_env")

        @mcp.tool
        def do_action(input: str) -> str:
            """Execute an action. Returns observation."""
            return execute(input)

        super().__init__(mcp)

    def reset(self, **kwargs) -> Observation:
        self._state = fresh_state()
        return Observation(done=False, reward=None, metadata={"status": "ready"})
No Verifiers, por outro lado, bastam funções de Python comuns e uma rubrica:
def do_action(input: str) -> str:
    """Execute an action. Returns observation."""
    return execute(input)

async def correctness(completion, answer, **kwargs) -> float:
    return 1.0 if answer in completion[-1]["content"] else 0.0

env = vf.ToolEnv(
    tools=[do_action],
    rubric=vf.Rubric(funcs=[correctness]),
    dataset=my_dataset,
)
E no GEM tudo passa por reset() e step(), no estilo do Gymnasium, com spawn() para clonar o ambiente nas tentativas em paralelo do GRPO:
class MyGEM(gem.Env):
    def reset(self, seed=None):
        super().reset(seed)
        self._state = fresh_state()
        return "Your task: ...", {"suffix": "Begin."}

    def step(self, action):
        parsed = parse_action(action)
        result = execute(self._state, parsed)
        terminated = is_done()
        return result, score(result), terminated, False, {"suffix": "Continue."}

    def spawn(self, same_state=False, **kwargs):
        return MyGEM(...)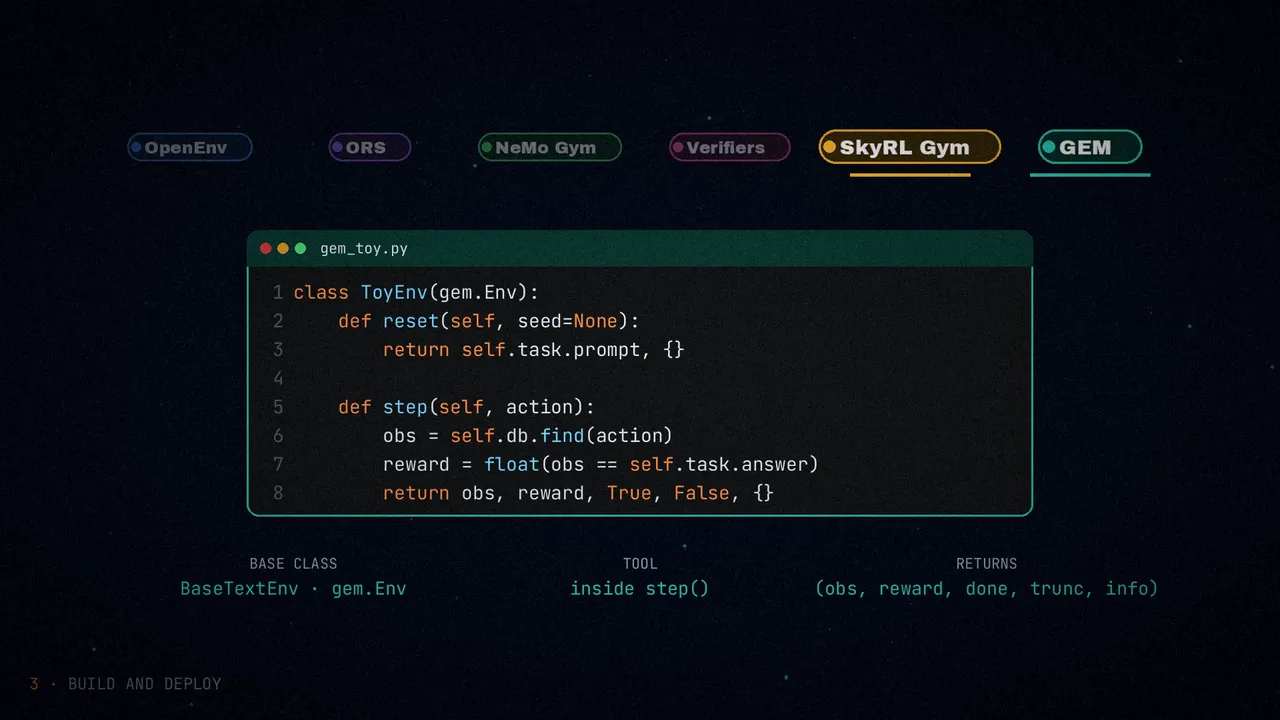
Dimensão 2: servidor HTTP ou dentro do processo
A divisão mais importante de todas: o ambiente roda como servidor HTTP separado ou dentro do processo de treinamento? Dessa escolha sai quase todo o resto. Dá para notar em três coisas:
- Onde roda. Um servidor vive na própria máquina, muitas vezes uma barata sem GPU, ou em um Space da Hugging Face. O de dentro do processo divide o nó de GPU com o treinamento.
- O que você instala junto do treinador. Com HTTP, só um SDK ou
requests. Dentro do processo, o pacote inteiro do framework. - Como escala. Com HTTP, adicionando réplicas atrás de um balanceador. Dentro do processo, adicionando workers de treinamento idênticos, cada um com sua cópia do ambiente.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Tipo | servidor HTTP | servidor HTTP | servidor HTTP | no processo | no processo | no processo |
| Protocolo | JSON-RPC 2.0 (MCP), WebSocket | REST + SSE | REST + cookies | chamadas de Python | chamadas de Python | chamadas de Python |
| Docker | sim | sim | sim | não | não | não |
| Escala separado | sim | sim | sim | não | não | não |
| Junto do treinador | openenv-core | só requests | só requests | o pacote inteiro | o pacote inteiro | o pacote inteiro |
| Autenticação | nenhuma | X-API-Key | cookies | – | – | – |
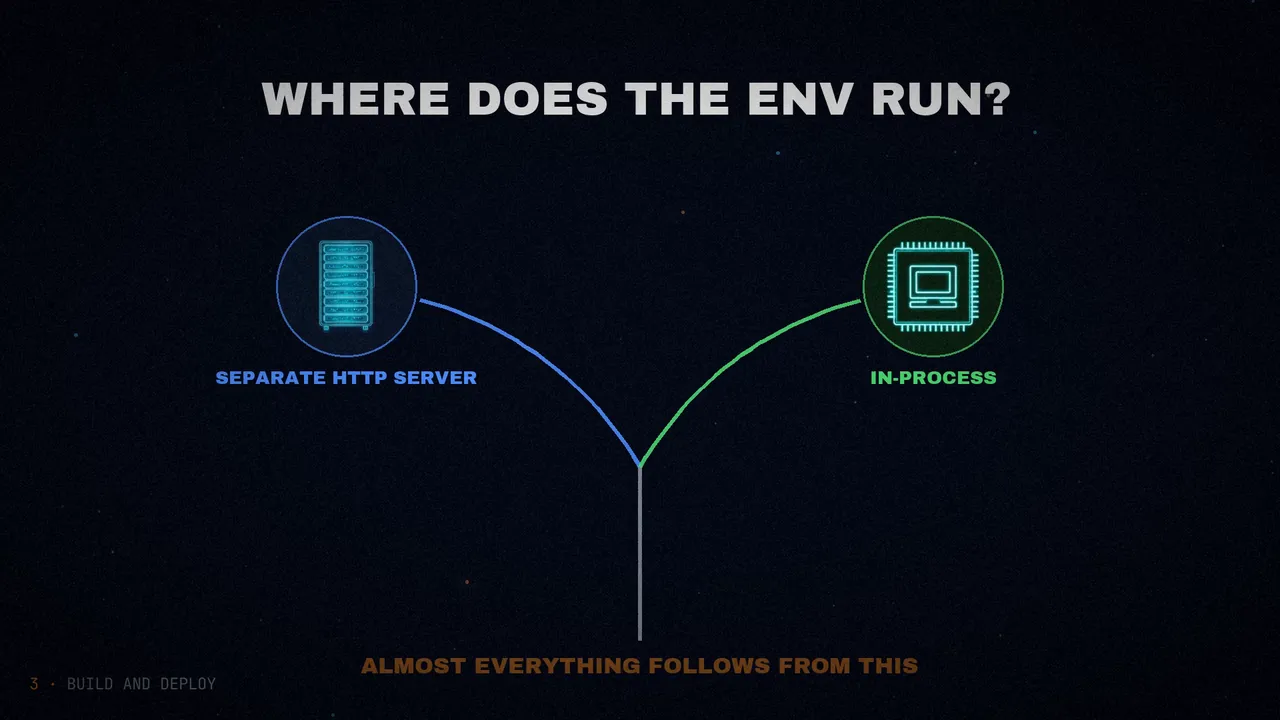
Um detalhe importante: na prática, quase nenhum ambiente faz o trabalho pesado sozinho. Ele delega para um provedor de sandbox como E2B, Modal ou um backend de contêineres próprio. Isso muda a história do escalonamento nos dois casos: o servidor HTTP vira um roteador fino que guarda sessões e repassa as chamadas para o sandbox, então adicionar réplicas é barato; e a classe de dentro do processo vira um cliente fino do sandbox, então cada worker ocupa pouco mesmo com centenas deles. A forma da implantação continua importando (HTTP isola dependências, no processo elas são compartilhadas), mas o processamento pesado vive no sandbox que você escolher.
Dimensão 3: ferramentas e ações
Os seis acabam mostrando ao modelo a mesma coisa: uma lista de ferramentas com nome, descrição e parâmetros tipados. O que muda é onde a ferramenta é definida e como o treinador a descobre. Os de HTTP a definem no servidor e oferecem um endpoint para descobri-las em tempo de execução; os de dentro do processo são funções de Python registradas ao construir o ambiente. Depois disso, as duas formas são idênticas: você manda uma chamada e recebe uma observação.
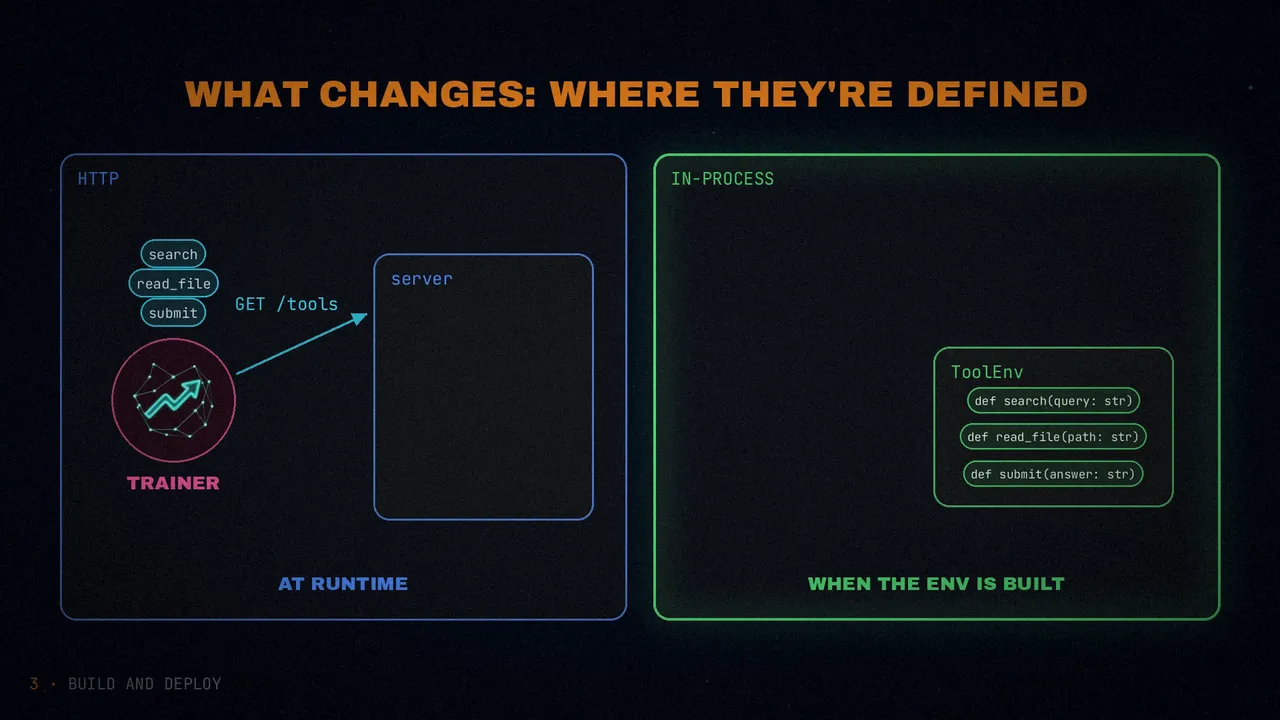
- Portabilidade do schema. Os de HTTP enviam JSON Schema (MCP, ToolSpec do ORS, OpenAPI), que qualquer modelo compatível com a OpenAI sabe chamar: a mesma ferramenta passa de um modelo para outro sem mexer em nada. Os de dentro do processo tiram o schema dos tipos do Python: mais rápido de escrever, mais difícil de levar para outro framework ou para um modelo que espera outro dialeto.
- Custo de escrever cada ferramenta. Um decorador
@toolsobre uma função é uma linha; um endpoint de FastAPI com seu modelo Pydantic parece mais um arquivo. Multiplique pelo número de ferramentas. - O loop de vários turnos é universal. Com as ferramentas conectadas, para o modelo tudo é igual: nome e argumentos tipados na entrada, observação na saída.
Dimensão 4: a recompensa
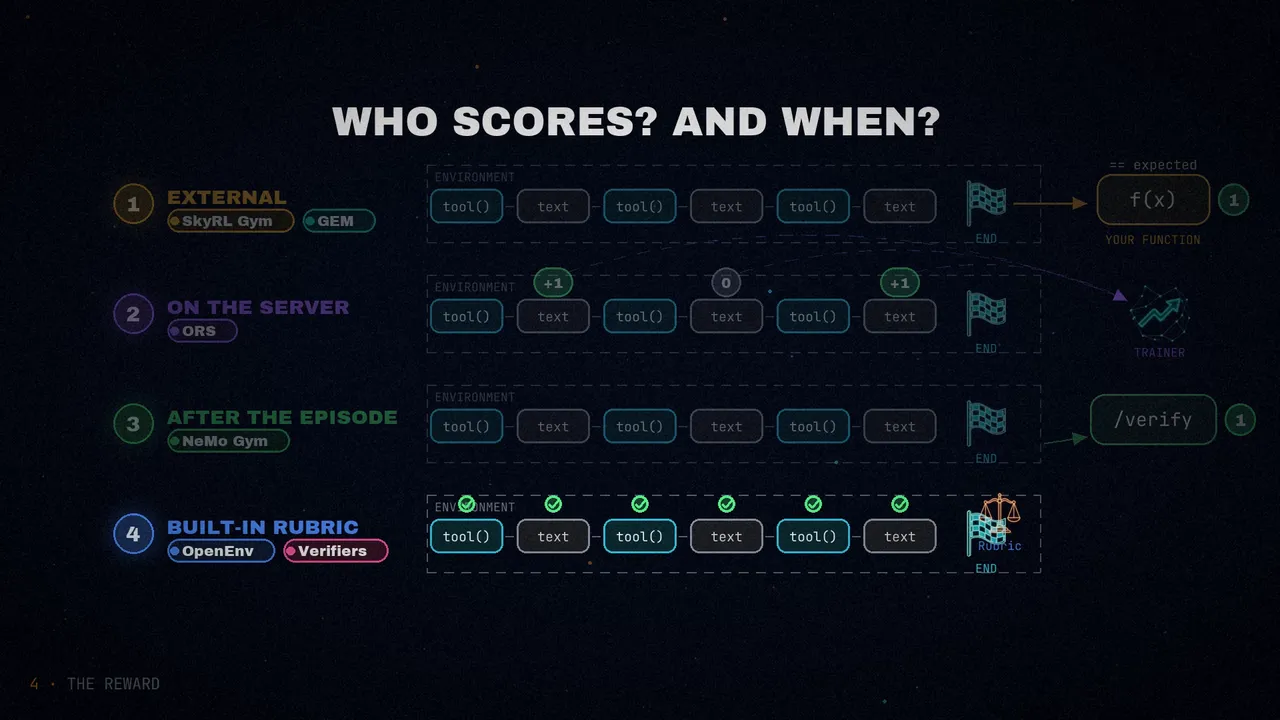
Quem decide se o comportamento do modelo foi bom, e quando? É aqui que os frameworks mais diferem em filosofia. Há quatro padrões:
| Padrão | Como funciona | Quem usa |
|---|---|---|
| 1. Recompensa externa | Quem decide é o script de treinamento: o ambiente só devolve texto e uma função que você escreve compara o resultado com o esperado. | SkyRL Gym, GEM |
| 2. Dentro do servidor | Cada resposta de ferramenta traz sua recompensa; o servidor avalia no caminho e o treinador só lê env.reward. | ORS |
| 3. Verificação no fim | Depois do episódio, um endpoint /verify separado avalia a trajetória completa. | NeMo Gym |
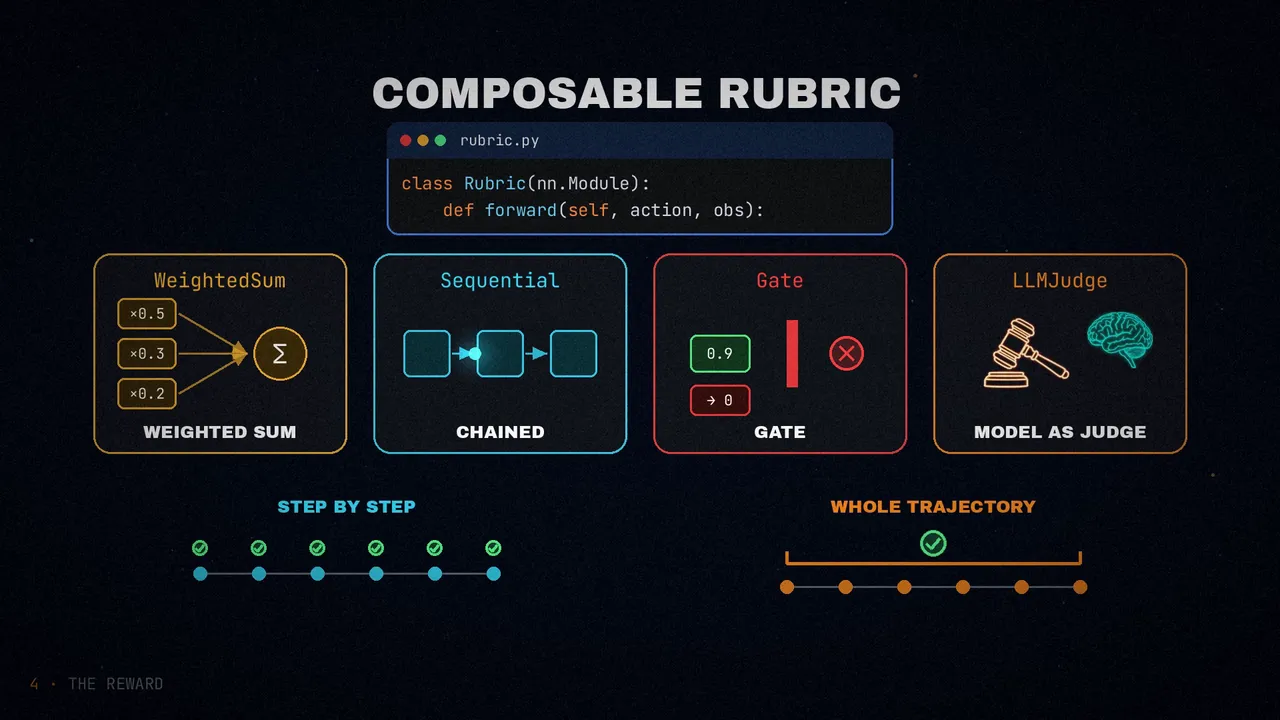
| 4. Rubrica dentro do ambiente | Um objeto Rubric combinável (inspirado no nn.Module) calcula a recompensa a partir de ações e observações; é chamado sozinho a cada step(). | OpenEnv, Verifiers |
A rubrica combinável aceita composições (WeightedSum, Sequential, Gate), um LLM como juiz (LLMJudge) e avaliar a trajetória inteira.
O que vai dentro de uma recompensa
Os quatro padrões falam de quando ela é calculada e de quem é o código. O que vai dentro é outra pergunta, com três sabores:
- Procedural ou verificável. Checagens determinísticas: a resposta bate? O teste passa? O JSON é válido? A conta dá o número certo? É o padrão RLVR (reinforcement learning with verifiable rewards) que o DeepSeek-R1 escalou: o modelo só ganha se a saída passar em um controle programado, quase sempre um 0 ou um 1. Escala, é difícil de enganar e funciona bem em matemática, código e lógica. O porém: precisa de uma resposta certa clara.
- LLM como juiz (às vezes chamado de RLAIF). Para o que não se checa com código: escrita criativa, raciocínio aberto, a qualidade de um resumo, a coerência de um agente. Outro modelo lê a trajetória e dá a nota, muitas vezes guiado por uma rubrica («precisão de 1 a 5, clareza de 1 a 5, com pesos»). É o que fazem
LLMJudgeeJudgeRubric. O porém é o reward hacking: a política aprende a produzir o que o juiz premia demais, mesmo que um juiz mais rigoroso castigasse. Para conter isso existem rubricas decompostas e «juízes que pensam» (no estilo do J1), que raciocinam antes de dar a nota. - Densa contra esparsa. É outro eixo. A esparsa chega só no fim (aprovado ou reprovado, nota final); a densa, a cada passo, a cada token ou a cada subobjetivo, e dá ao treinador muito mais informação para distribuir o mérito. A externa e a verificação no fim são esparsas por padrão; a do servidor e a rubrica podem ser qualquer uma das duas, e a rubrica é o lugar mais natural para torná-las densas. As densas treinam mais rápido e de forma mais estável; as esparsas são mais fáceis de definir e mais difíceis de enganar.
Na prática, quase sempre se misturam: uma parte procedural para o que dá para verificar (o teste passa, o JSON é válido, a resposta bate) e um juiz para o que não dá (se a explicação é boa, se o agente não se desviou), combinadas com pesos em um único número. Os frameworks só mudam onde você escreve essa combinação e quando ela dispara.
Dimensão 5: quem conduz o loop e quando ele para
Uma tentativa de vários turnos é um ciclo apertado: o modelo gera uma ação, a ferramenta é chamada, a observação volta para o modelo, e de novo. É preciso decidir quem move esse ciclo e como ele sabe que terminou.
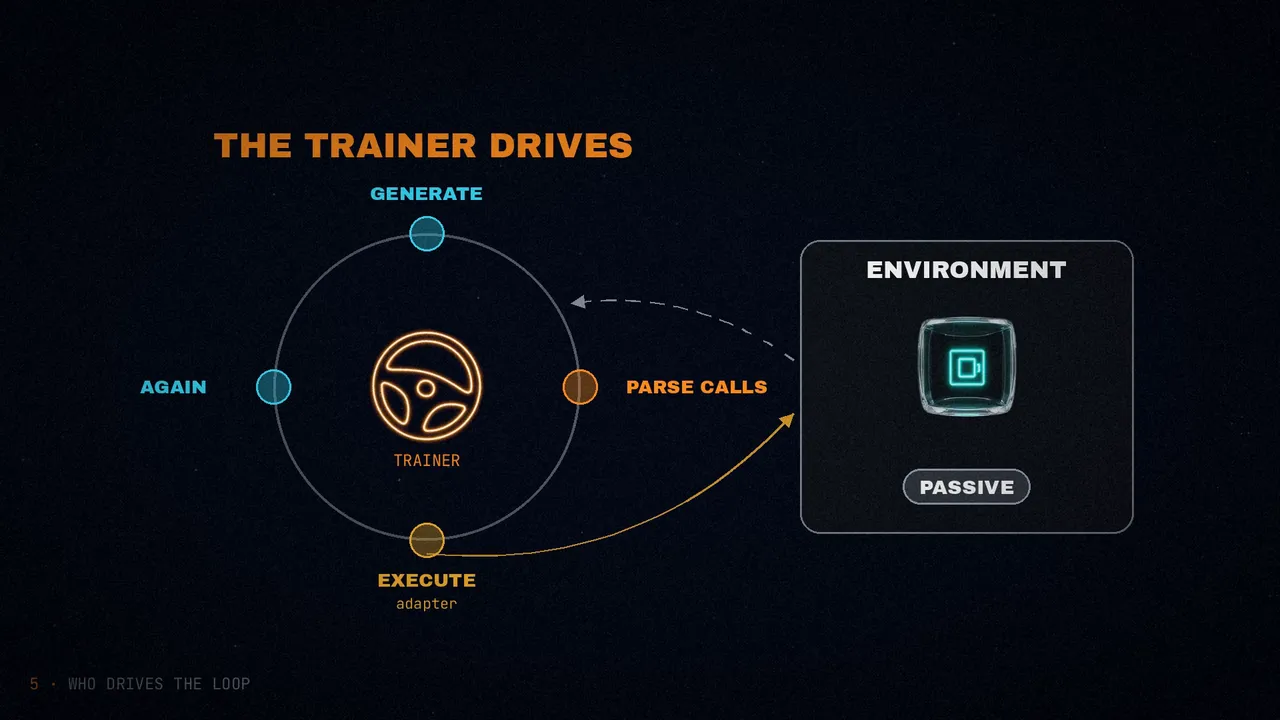
Em todos os que testaram, quem manda é o treinador: gera, interpreta as chamadas de ferramenta, executa-as pelo adaptador e gera de novo. O ambiente é passivo: responde, mas não inicia nada. Assim, o treinador controla a duração do episódio, como as chamadas são lidas e as novas tentativas. Outros que não testaram invertem isso: no Atropos, o ambiente tem sua própria instância de vLLM e gera as tentativas sozinho; no modo env.evaluate() do Verifiers, o framework conduz o loop. Importa porque muda como você pensa em lotes, paralelismo e alocação de recursos.
A outra metade é o sinal de parada:
| Framework | Sinal de fim | Granularidade | Quem conduz |
|---|---|---|---|
| OpenEnv | Observation.done · ferramenta final_answer | por passo + duração máxima do treinador | treinador |
| ORS | ToolOutput.finished | por chamada | treinador |
| NeMo Gym | verify() depois da tentativa | no fim do episódio | treinador |
| Verifiers | @vf.stop · is_completed() | por passo | treinador ou ambiente |
| SkyRL Gym | step().done | por passo | treinador |
| GEM | terminated · truncated | terminado / truncado | treinador |
Dois exemplos com um ambiente de agente de programação com ferramentas no estilo do Claude Code: arquivos (read, write, edit, multi_edit, ls, glob, grep), terminal (bash(command, timeout=30)), planejamento (todo_write(todos)) e uma ferramenta final, submit_solution().
- Controle por ferramentas (o treinador manda). O ambiente só expõe as ferramentas e o episódio termina quando o modelo chama
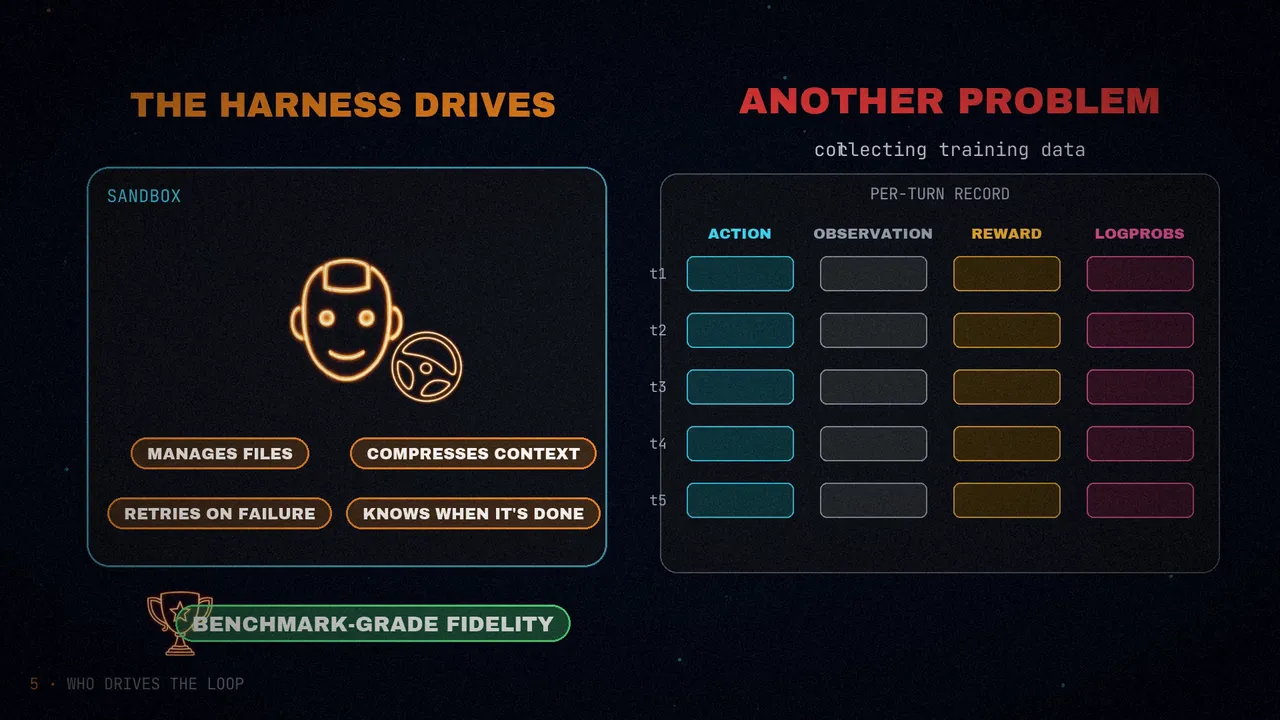
submit_solution()ou quandomax_completion_lengthse esgota. Os seis suportam isso de fábrica e ele se porta quase idêntico entre eles. Para a maioria dos ambientes com ferramentas, é o caminho mais simples. - Tentativa controlada pelo harness (o ambiente manda). Às vezes você não quer que o treinador conduza nada: quer um harness de programação real (OpenCode, OpenClaw, Aider, no estilo do Claude Code) rodando no sandbox e falando com o modelo. O harness conduz a conversa: gerencia os arquivos, comprime o contexto, tenta de novo se uma ferramenta falha e sabe quando terminou; o ambiente só o hospeda e devolve a trajetória. Isso dá uma fidelidade de benchmark, mas tirar dados para treinar vira outro problema: o harness precisa registrar a cada turno a ação, a observação, a recompensa e os logprobs que sua função de perda exige, e isso é trabalho específico de cada harness.
Dimensão 6: tarefas e datasets
Cada tentativa começa com uma tarefa: o prompt, os dados com que o modelo trabalha e, para dar a nota, a resposta esperada ou o teste que decide se deu certo. É a dimensão mais variada depois da recompensa:
- O Verifiers se integra com os
Datasets da Hugging Face. - O GEM tem um registro de mais de 24 ambientes incluídos.
- O ORS guarda as tarefas no servidor (
list_tasks(split)). - O NeMo Gym pré-processa JSONL com uma ferramenta de linha de comando (
ng_prepare_data). - O OpenEnv e o SkyRL Gym deixam isso com você.
Os que trazem uma abstração de dataset também dão partições e versões de graça; nos outros, você monta.
Uma tarefa é mais que uma linha
Uma linha é uma entrada e uma saída esperada. Uma tarefa, sobretudo em agentes e programação, é um pacote de arquivos que precisa chegar ao sandbox antes de começar. O exemplo mais limpo é o SETA, do OpenReward: 1.376 tarefas de agente de terminal sobre o Open Reward Standard, cada uma com um task.yaml (prompt e metadados), os arquivos de dados, um tests/test_outputs.py executado na entrega e um weights.json que transforma os resultados dos testes em uma nota. As linhas do SWE-Bench vão além: cada uma traz repo, base_commit, problem_statement e test_patch; o ambiente clona o repositório nesse commit, aplica os testes e avalia o diff do agente com FAIL_TO_PASS e PASS_TO_PASS.
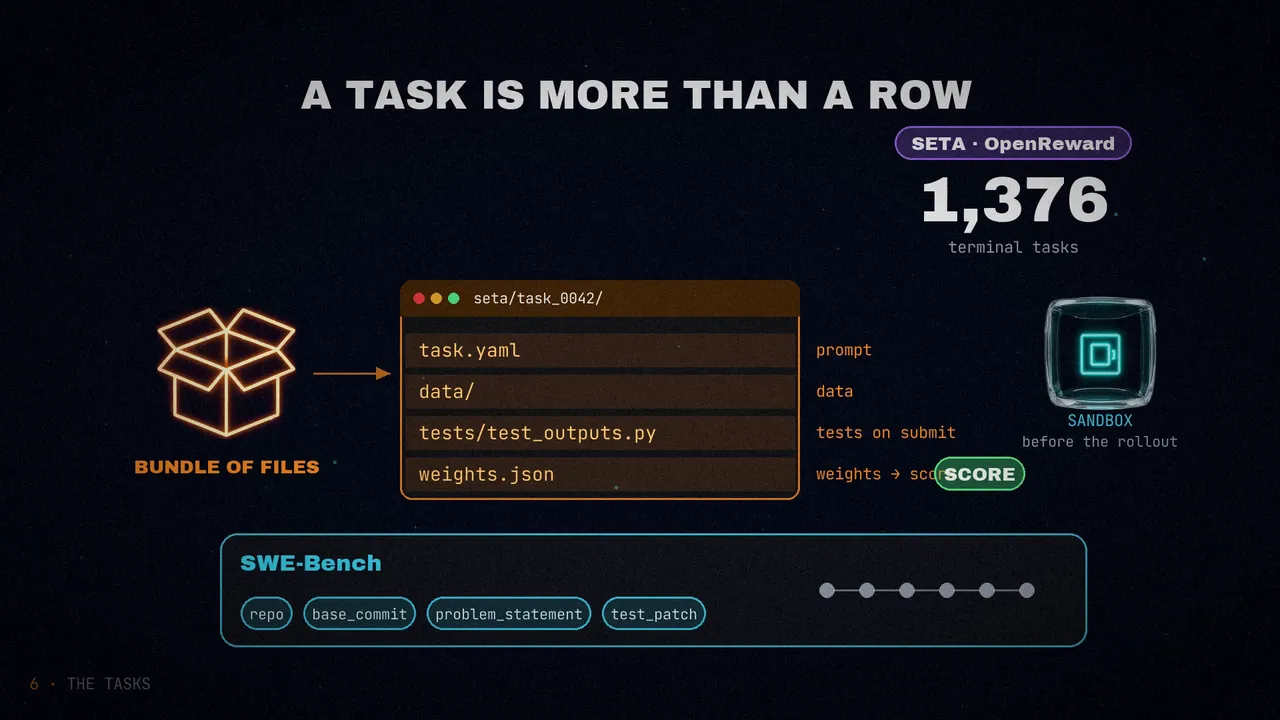
Esses pacotes costumam viver atrás da linha (no S3, em um repositório de datasets da Hugging Face ou em um tarball): o ambiente os baixa no início do episódio, coloca no sandbox, avalia e desmonta tudo.
Acoplado ou livre: quem manda no formato
- Acoplados. O Verifiers espera um
Datasetcom uma colunaprompte, opcionalmente,answerouinfo; o GEM traz seus carregadores; ORS e NeMo Gym fixam o schema no servidor. O Environments Hub e o OpenReward vão além e padronizam o pacote inteiro (estrutura, contrato de avaliação, até o empacotamento em wheels), então qualquer tarefa que siga a especificação roda em qualquer ambiente que a siga. - Livres. OpenEnv e SkyRL Gym deixam o dataset nas suas mãos: os prompts vêm de onde for, mas cada fonte nova custa um pouco de integração.
Acoplar significa que o ambiente dita o formato e você transforma seus dados. Por exemplo: passar o JSONL do SWE-Bench para um Dataset do Verifiers com a coluna prompt e o patch em info; espalhar um dump de perguntas do Kaggle em pastas no estilo do OpenReward, uma por linha, com task.yaml, data/ e tests/; ou, com HumanEval ou GSM8K, nada, porque o ambiente já traz o carregador. Você escreve isso uma vez e, em troca, o mesmo ambiente roda sem mudanças com todas as tarefas que seguem o formato. Se você só se importa com uma tarefa, a especificação sobra; se treina com muitas ou usa suítes de benchmarks, é o que torna isso possível.
Dimensão 7: ecossistema e maturidade
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
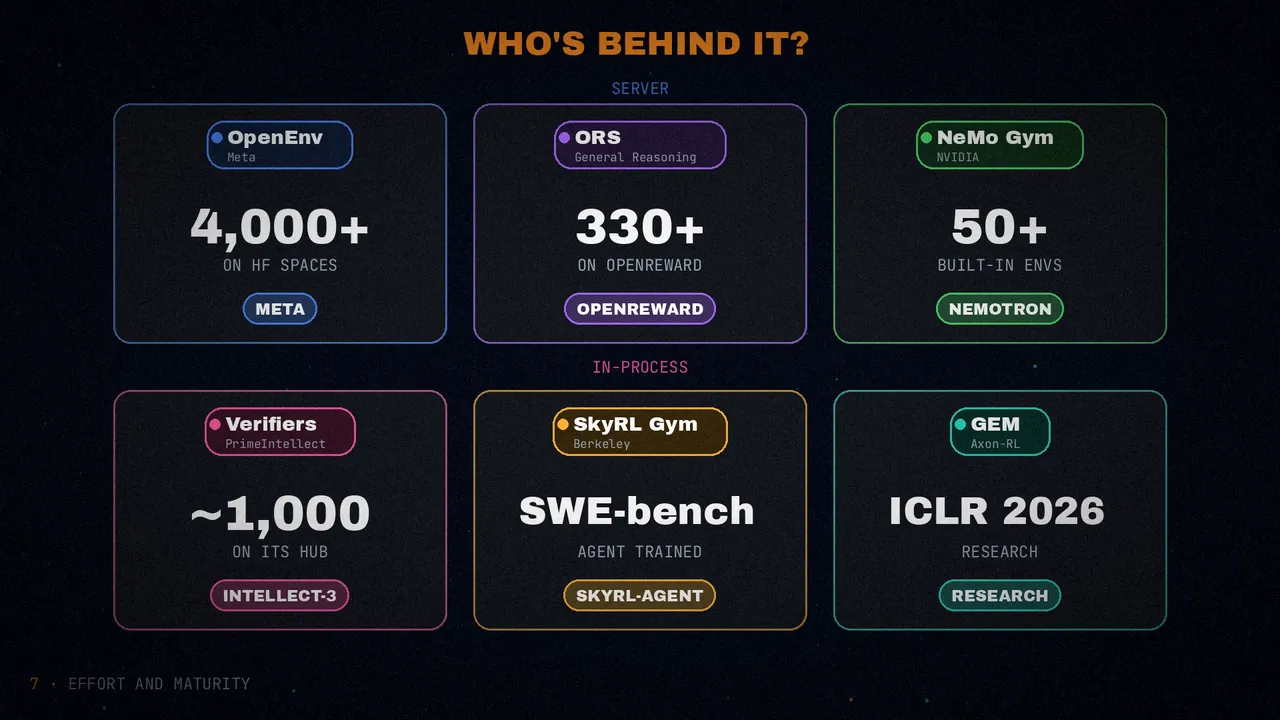
| Criador | Meta PyTorch | General Reasoning | NVIDIA | PrimeIntellect | NovaSky-AI · Berkeley | Axon-RL · ICLR 2026 |
| Ambientes incluídos | exemplo no repositório | exemplo no repositório | 50+ | exemplo no repositório | poucos (busca, SQL) | 24+ (jogos, matemática, código) |
| Hub da comunidade | 4.000+ nos HF Spaces | 330+ no openreward.ai | – | ~1.000 no Environments Hub | – | – |
| Em produção | Meta | plataforma OpenReward | NVIDIA · Nemotron | PrimeIntellect · INTELLECT-3 | SkyRL-Agent · SWE-Bench | pesquisa |
Dimensão 8: quanto custa um ambiente novo
Quanto tempo leva para ir de «tenho uma ideia de ambiente» a «está treinando»? Importa tanto se você escreve à mão quanto se um agente escreve.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Arquivos | 4-6 (ambiente, app, modelos, Dockerfile, pyproject) | 3-4 (servidor, Dockerfile, pyproject) | 4-5 (servidor, YAML, Dockerfile) | 1-2 | 1-2 | 1-2 |
| Conceitos | MCPEnvironment, create_app, Observation, Rubric, FastMCP | Environment, @tool, ToolOutput, Server, Split | SimpleResourcesServer, setup_webserver, verify, sessões | ToolEnv, Rubric | BaseTextEnv, init/step/close | gem.Env, reset/step, spawn |
| Gerador de esqueleto | openenv init | orwd init | – | prime env init | – | – |
| Primeiro teste | ~30 min (Docker / servidor) | ~20 min (servidor + curl) | ~30 min (servidor + config) | ~5 min (pytest) | ~5 min (pytest) | ~5 min (pytest) |
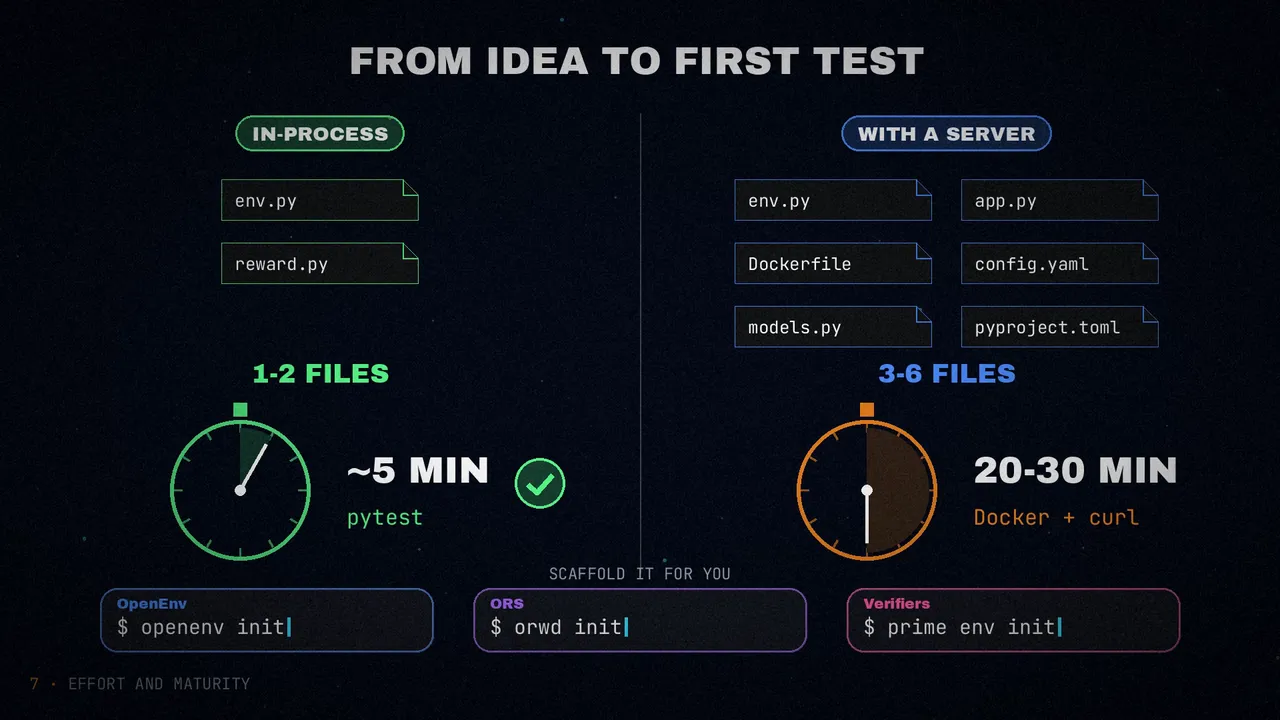
E eles testaram com um agente: o Claude Code escreveu um ambiente completo de Wordle nos seis frameworks em uma única sessão. Os de dentro do processo (Verifiers, SkyRL, GEM) ficaram prontos em minutos; os de HTTP (ORS, NeMo Gym, OpenEnv) precisaram de mais rodadas para os Dockerfiles e a configuração da implantação. Um único arquivo de Python, sem Docker nem servidor e com resposta imediata do pytest, é exatamente o que funciona melhor para um agente.
Dimensão 9: local e em cluster
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Precisa de Docker | em produção | em produção | em produção | não | não | não |
| Instalação | pip install openenv-core fastmcp | pip install ors-sdk | pip install nemo_gym (via git, traz o Ray) | pip install verifiers | pip install skyrl-gym | pip install gem-llm |
| Dependências pesadas | FastMCP, FastAPI, Gradio | FastAPI, uvicorn | Ray, OmegaConf, aiohttp | poucas | poucas | poucas |
| Python | ≥3.11 | ≥3.10 | ≥3.12 | ≥3.11 | ≥3.10 | ≥3.10 |
| Risco de conflitos | baixo | baixo | alto (o Ray fixa muitas versões) | baixo | baixo | baixo |
Em um cluster com Slurm, a pergunta é quem vive onde. Os de HTTP colocam o ambiente no próprio nó, muitas vezes só com CPU, e apontam para lá qualquer número de nós de treinamento com GPU, com um balanceador na frente de um grupo de réplicas que pode crescer. Os de dentro do processo colocam treinador e ambiente no mesmo ambiente de Python e no mesmo nó de GPU: mais fácil de operar, mas escalar o ambiente depende do que o seu framework de treinamento permitir.
| Frameworks HTTP | Frameworks no processo | |
|---|---|---|
| Implantação do ambiente | Nos HF Spaces ou em outro nó; o treinamento só precisa de requests | Pacote instalado no ambiente de treinamento |
| GPU | O servidor não usa GPU | Divide o nó de GPU com o treinamento |
| Isolamento de dependências | Limpo: Docker ou ambiente próprio | Precisa conviver com TRL, vLLM, DeepSpeed… |
| Vários nós | Servidor em um, treinamento em outros | Um único nó |
Dimensão 10: escalar
O RL gera várias tentativas por prompt, de preferência em paralelo, então é preciso falar com muitos ambientes ao mesmo tempo. No GRPO são num_generations (normalmente entre 4 e 16) por prompt: com 64 prompts e num_generations=8, você tem 512 ambientes ativos ao mesmo tempo em cada passo.
Dentro do processo
Verifiers, SkyRL Gym e GEM criam objetos de Python: iniciar um custa menos de um milissegundo, então 512, ou 10.000, não são problema, e o paralelismo fica a cargo do framework de treinamento (cada worker com sua instância). O limite real é de orquestração, não de arquitetura: se o ambiente faz seu próprio processamento (parsing pesado, simulação), divide a CPU com o treinamento e escalá-lo é escalar nós de treinamento, pagando GPU para trabalho de CPU; se delega para um sandbox ou um serviço remoto (E2B, Modal, um backend HTTP próprio), a classe é um cliente fino e o ambiente escala separado, mas a orquestração é sua: escolher o provedor, réplicas, recuperação de falhas, distribuição de carga. Os frameworks HTTP já trazem isso pronto; os de dentro do processo deixam com você. E há duas coisas que não mudam: as dependências do ambiente precisam conviver com as do treinamento (um framework que fixe outra versão de numpy ou de torch pode quebrá-lo), e uma falha em código de ambiente puro dentro do processo pode derrubar o worker de treinamento, enquanto a execução em sandbox isola as falhas sozinha.
Com servidor: o benchmark
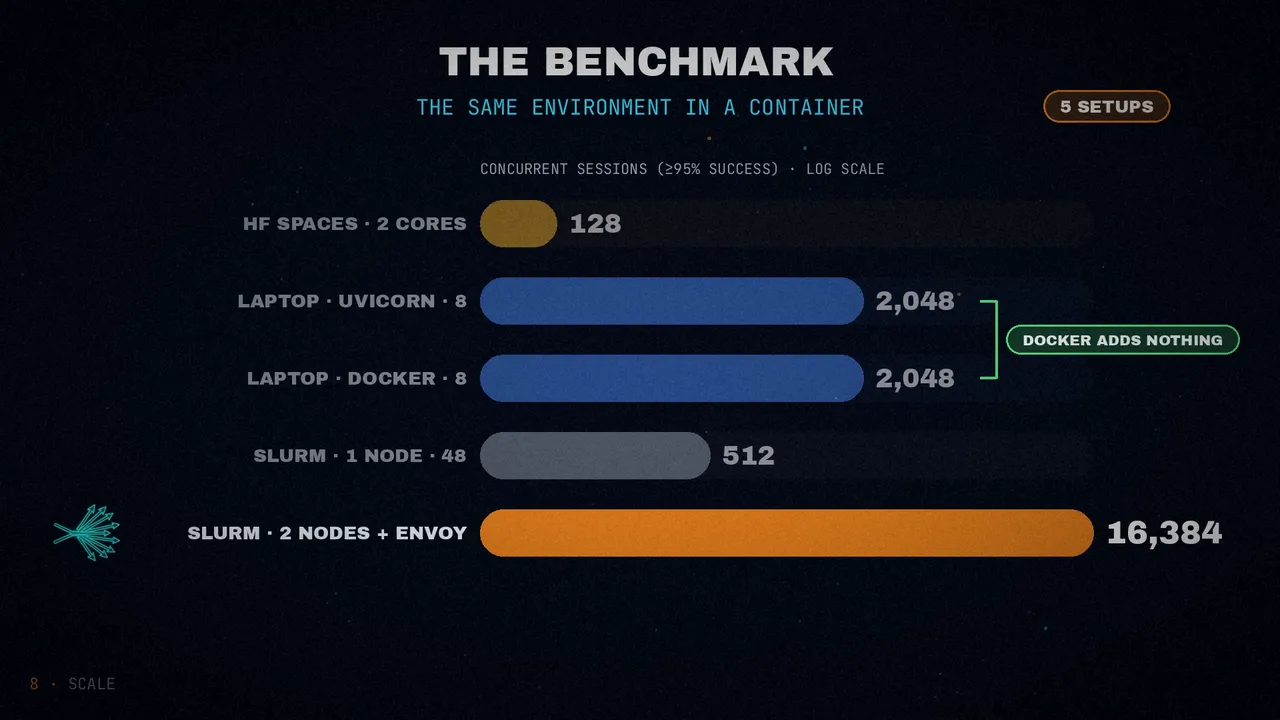
O benchmark openenv-scaling implantou um ambiente como app FastAPI dentro de um contêiner Docker (a mesma imagem que os HF Spaces usam) em cinco infraestruturas. OpenEnv, ORS e NeMo Gym seguem essa mesma forma (um app com estado por sessão em um contêiner), então os números valem para os três. Máximo de ambientes simultâneos com pelo menos 95 % de sucesso:
| Infraestrutura | Núcleos | Máximo simultâneo | Por núcleo |
|---|---|---|---|
| Slurm com 2 nós + balanceador Envoy | 96 | 16.384 | 170,7 |
| uvicorn local (8 workers) | 8 | 2.048 | 256 |
| Docker local (mesma imagem dos HF Spaces) | 8 | 2.048 | 256 |
| Slurm com um nó (48 workers) | 48 | 512 | 10,7 |
| Hugging Face Spaces (grátis, cpu-basic) | 2 | 128 | 64 |
E para onde vai o tempo com a carga no máximo? A mediana de cada fase (conectar, reiniciar e dar um passo, com uma espera simulada de 1 s na ferramenta) e o percentil 99 do total:
| Infraestrutura | Conectar | Reiniciar | Passo | p99 total |
|---|---|---|---|---|
| uvicorn local | 0,58 s | 0,08 s | 1,05 s | 1,95 s |
| Docker local | 1,38 s | 0,19 s | 1,05 s | 2,90 s |
| HF Spaces | 0,79 s | 0,10 s | 1,10 s | 2,48 s |
| Slurm, um nó | 0,26 s | 0,04 s | 1,00 s | 1,33 s |
| Slurm, dois nós (16.384 sessões) | 17,50 s | 2,25 s | 2,42 s | 26,30 s |
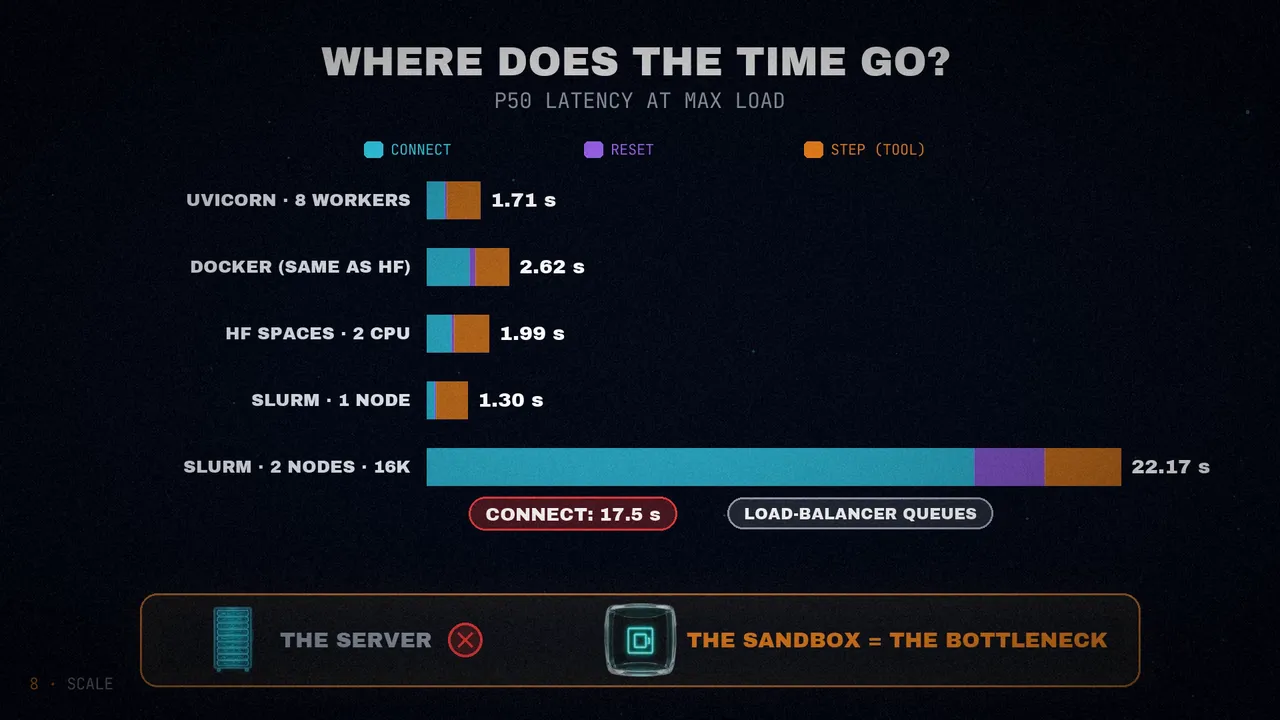
O p99 dos dois nós reflete as filas de conexão de 16.384 sessões através do proxy Envoy, embora seu rendimento absoluto (518 requisições por segundo) seja o mais alto de todos. As cinco lições:
- O Docker não acrescenta nada perceptível: Docker e uvicorn locais chegam às mesmas 2.048.
- A configuração do balanceador importa: antes de ajustar o Envoy, os dois nós só chegavam a 128; depois, a 16.384, 128 vezes mais.
- Os HF Spaces ficam em cerca de 128 sessões: suficiente para desenvolver e fazer demos, e prático porque é o maior catálogo de ambientes prontos.
- O servidor raramente é o gargalo: até um notebook aguenta 2.048 sessões. A execução (criar o sandbox, rodar a ferramenta) domina a latência de cada passo, seja qual for o framework.
- Escalar horizontalmente é um problema de configurar o balanceador, não de protocolo: o salto de 128 para 16.384 veio de ajustar o Envoy, não de mudar o formato. As sessões fixas que o WebSocket impõe complicam; para milhares de ambientes, requisições sem estado com um identificador de sessão dão menos sustos.
| OpenEnv | ORS | NeMo Gym | Verifiers | SkyRL Gym | GEM | |
|---|---|---|---|---|---|---|
| Modelo de escala | servidor WS multissessão | servidor SSE/HTTP multissessão | servidor multissessão + Ray | instância por worker | instância por worker | instância por worker |
| Escala horizontal | Envoy + mais nós | Envoy + mais nós | autoescala do Ray | mais workers de GPU | mais workers de GPU | AsyncVectorEnv |
| Isolamento do estado | dicionário por sessão | por sessão (X-Session-ID) | por sessão (cookies) | por instância | por instância | por instância |
A tabela geral
Se você junta as dez dimensões em uma única tabela, saem três coisas:
- Nenhum ganha em todas as linhas. Cada um ganha uma coluna ou duas e perde em outras. A escolha se resume às duas ou três dimensões que realmente importam para você: normalmente a forma da implantação, quem conduz o loop e o quão rígida é a especificação das tarefas.
- A divisão mais forte continua sendo a implantação. Servidor HTTP (OpenEnv, ORS, NeMo Gym) ou dentro do processo (Verifiers, SkyRL Gym, GEM) atravessa quase todas as linhas. Decida isso primeiro e a tabela se estreita rapidinho.
- As ferramentas em volta são desiguais. Geradores de esqueleto, registros de datasets e observabilidade são fortes em uns e não existem em outros, mesmo quando a API se parece. Vale olhar antes de se comprometer.
Os seis, um a um
Um contrato baseado em MCP: protocolo, camada de sessões e transporte (WebSocket) e um sistema de recompensas combinável (LLMJudge, WeightedSum, rubricas de trajetória). Tarefas, datasets e execução, por sua conta. Para interfaces de ambiente finas e intercambiáveis que precisem continuar compatíveis com MCP.
Uma API padrão para ferramentas, tarefas e recompensas: decoradores @tool, respostas ToolOutput com a recompensa de cada passo e tarefas no servidor com list_tasks(split). O openreward.ai hospeda mais de 330 ambientes sobre a especificação. Para se conectar a um catálogo grande de ambientes prontos.
Servidores de ferramentas com FastAPI e um endpoint /verify separado para avaliar no fim, com mais de 50 ambientes incluídos e bem integrado ao NeMo e ao Megatron. Para avaliar trajetórias completas e para equipes que já usam a pilha da NVIDIA.
O que mais traz: datasets, ferramentas, rubricas, harness de coleta, treinador e o comando prime env init. O Environments Hub distribui ambientes como wheels. Para ir do zero ao treinamento rápido, com tudo incluído.
Uma API no estilo do Gym com BaseTextEnv e ToolGroup, poucas dependências, e a mesma biblioteca com que o SkyRL-Agent foi treinado para o SWE-Bench. Para controlar todo o loop com o modelo mental do Gym.
O mais fiel ao Gymnasium: reset() devolve uma observação, step() a tupla de cinco (obs, reward, terminated, truncated, info) e AsyncVectorEnv vetoriza. Traz mais de 24 ambientes de jogos, matemática e código. Para levar o modelo mental do Gymnasium e do Atari para agentes de texto.
O que mais chamou a atenção, e qual escolher
- Onde o ambiente termina é uma decisão de design, não um padrão. Uns (OpenEnv, SkyRL Gym) dão uma interface fina de ferramentas e deixam dataset, recompensa e treinador com você; outros (Verifiers, GEM) juntam tudo. Nenhum está errado: é controle contra tempo até ter algo funcionando.
- HTTP ou dentro do processo é a bifurcação mais forte. O que roda em um sandbox (código, terminal, navegador) pede HTTP, para escalar o processamento do ambiente separado do treinamento. O que é puramente Python (jogos, matemática, raciocínio em texto) pede ficar no processo: sem custo de rede e sem infraestrutura para vigiar.
- Acoplar o dataset corta para os dois lados. Juntos (Verifiers, ORS), ambiente e dataset vêm como uma unidade e você não troca um sem o outro. Separados (OpenEnv, SkyRL Gym), você conecta os dados, mas qualquer tarefa encaixa em qualquer ambiente.
- Quando a recompensa chega importa mais do que o que ela tem dentro. Avaliar a cada chamada é limpo para dar sinal passo a passo e incômodo quando a nota só faz sentido no fim; verificar no fim é limpo para a trajetória completa, mas não dá sinal durante o episódio.
- A execução domina a latência de cada passo, seja qual for o framework.
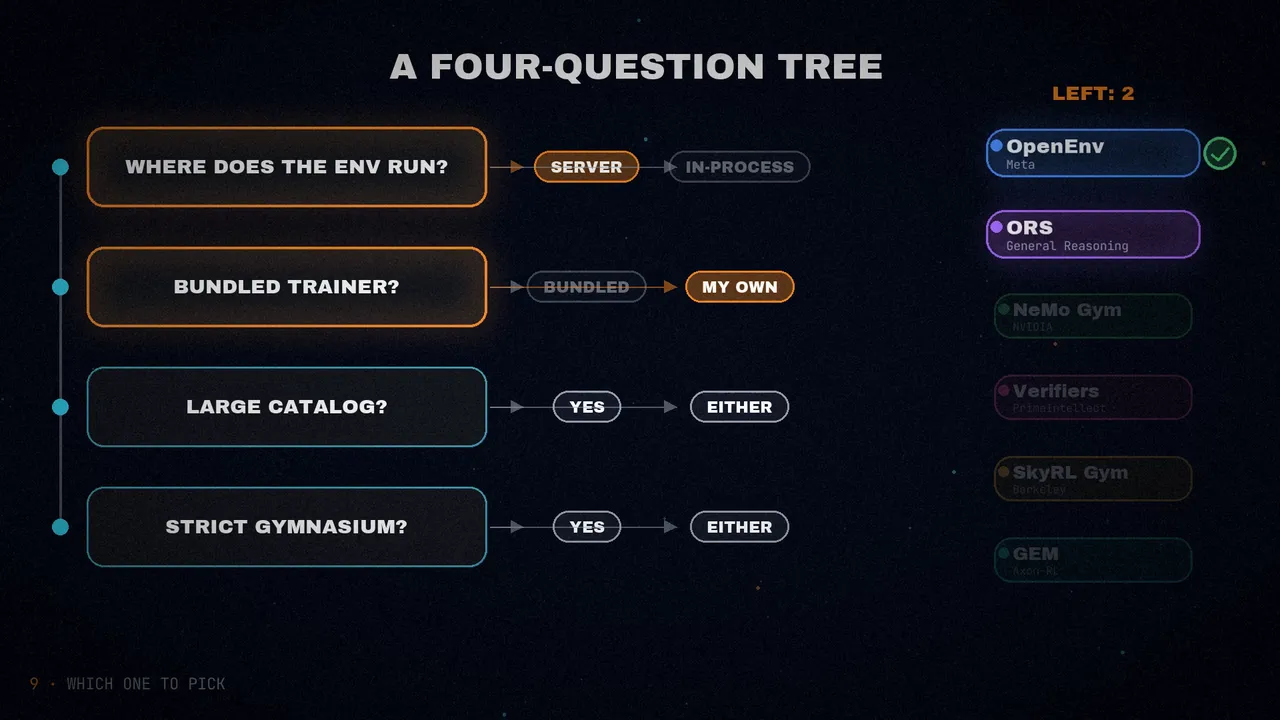
E se você só quer uma recomendação, a árvore de decisão deles tem quatro perguntas de sim ou não:
- Onde o ambiente roda? No próprio servidor (OpenEnv, ORS, NeMo Gym) ou dentro do treinador (Verifiers, SkyRL Gym, GEM).
- Você quer um treinador incluído? Sim (NeMo RL, Prime RL ou SkyRL) ou não, porque vai conectar o seu (TRL ou próprio).
- Você precisa de um catálogo grande de ambientes prontos?
- Você precisa de uma API rígida no estilo do Gymnasium? A tupla de cinco de
step(), compatível com código de RL clássico.
Por exemplo: com servidor próprio e seu treinador, sobram OpenEnv e ORS; com servidor e treinador incluído, NeMo Gym; e se você precisa de Gymnasium rígido, só o GEM.
O que deu trabalho
| Framework | Problema |
|---|---|
| OpenEnv | O protocolo MCP ainda está evoluindo: mudanças de API entre versões podem exigir atualizar adaptadores. |
| ORS | O tratamento de base_url com aiohttp no cliente do SDK obriga a usar HTTP direto. |
| NeMo Gym | Exige Python 3.12, e a validação rígida do Pydantic em /verify devolve 422 com trajetórias de formato inesperado. |
| Verifiers | O dataset é obrigatório ao criar o ambiente: ambiente e dataset vêm acoplados. |
| SkyRL Gym | step() devolve um dicionário, não uma dataclass: é preciso lidar com essa inconsistência de tipos. |
| GEM | gem-llm pode não estar instalado: são necessários imports condicionais. |
É uma foto de maio de 2026. Os seis saíram em 2025 e mudam rápido: seis frameworks fazendo a mesma coisa com APIs diferentes é o normal em uma fase de exploração inicial. Os autores esperam que, no próximo ano, tudo convirja para menos protocolos (MCP, ORS).
Dois detalhes que não batem
Comparando as figuras interativas do artigo entre si, duas coisas não batem totalmente:
- O GEM e o treinador. O mapa de níveis coloca o GEM no nível 3 (ambiente e treinamento juntos), mas o texto diz que o GEM «traz ambientes prontos e a API do Gymnasium, mas o treinador é por sua conta», e a tabela do que cada um traz marca o treinamento dele como parcial («vários treinadores»).
- O NeMo Gym e o treinamento. No diagrama das cinco etapas, o NeMo Gym vai até a coleta, sem treinador; já na tabela do que cada um traz, ele tem treinamento nativo (Megatron / NeMo RL), e a árvore de decisão também o conta entre os que trazem treinador.
Nada disso muda as conclusões, mas é bom saber se você escolher por essa célula.
Resumindo
Um ambiente de RL para um LLM é tarefas, ferramentas, uma recompensa e um loop, distribuídos em onze peças que os seis frameworks cobrem de formas diferentes. A decisão que organiza tudo é se o ambiente vive no próprio servidor ou dentro do treinamento; depois vêm quando a recompensa chega, quem conduz o loop e o quão rígido é o formato das tarefas. E ao escalar, o servidor quase nunca é o gargalo: o gargalo é o sandbox, e um balanceador bem configurado faz toda a diferença.
Os seis frameworks são a mesma coisa com roupas diferentes: o mesmo ambiente passa de um para o outro, então escolha o que combina com o que você já usa.
Que ambiente você gostaria de treinar?
Fontes
- «The ultimate guide to RL environments: building and scaling them in the LLM era», de Adithya S Kolavi, Lewis Tunstall, Leandro von Werra, Quentin Gallouédec, Amine Dirhoussi, Ben Burtenshaw e Sergio Paniego (Hugging Face), 5 de maio de 2026.
- O código: RL_Envs_101, e o benchmark openenv-scaling.
- Sobre aprendizado por reforço aplicado a agentes: meu post sobre o NapMem, que treina com GRPO um agente para navegar pela própria memória.
- O vídeo, nos meus canais: inglês e espanhol.