Un ejemplo: ¿qué tuve antes?
El paper abre con un ejemplo muy claro. Un usuario pregunta: «¿Qué tuve antes, el Samsung Galaxy S22 o el Dell XPS 13?». Un sistema de memoria clásico busca y le pasa al agente dos notas: que el usuario tiene los dos aparatos y que compró el Galaxy S22 el 20 de febrero. Del portátil no hay fecha. Con eso, lo único que puede responder el agente es «no lo sé».
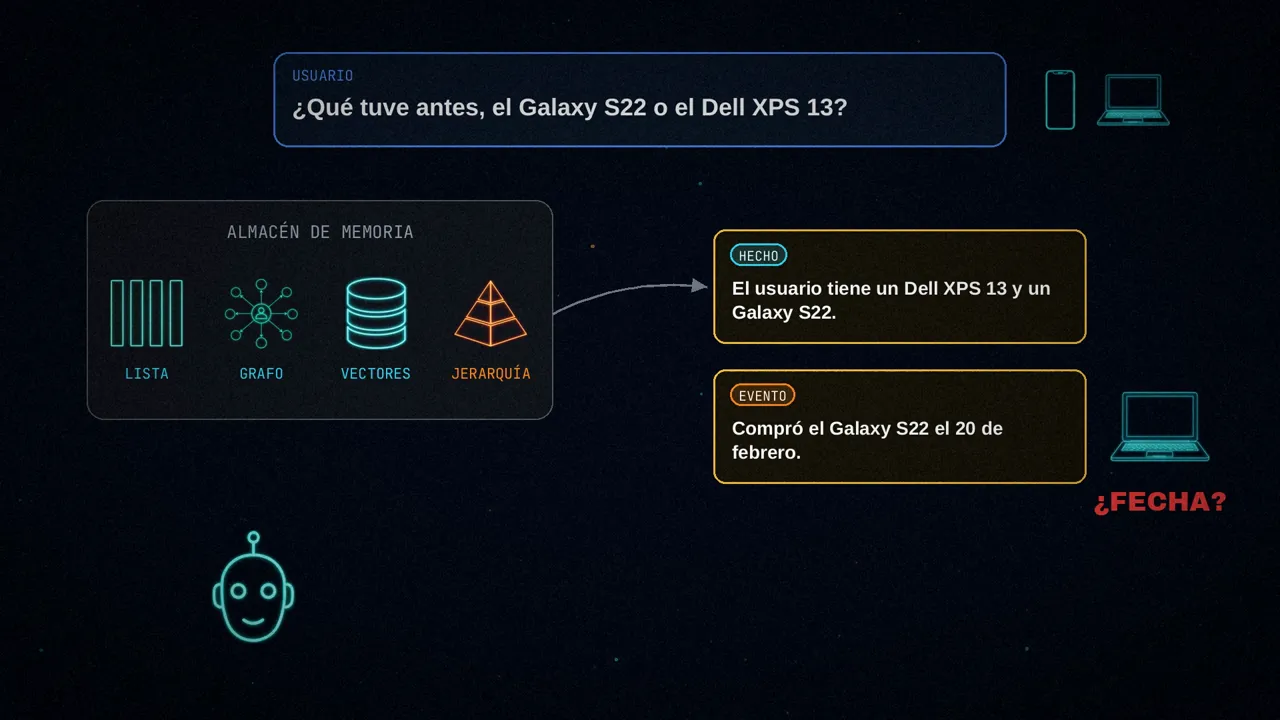
Ahora, el mismo agente con herramientas de memoria. Ya no espera a que le traigan nada: busca él en las conversaciones y encuentra dos mensajes. El Dell lo reservó el 28 de enero, pero le llegó el 25 de febrero; el Galaxy lo tuvo el 20. La respuesta correcta es el Galaxy S22, y la trampa estaba en la fecha de la reserva.
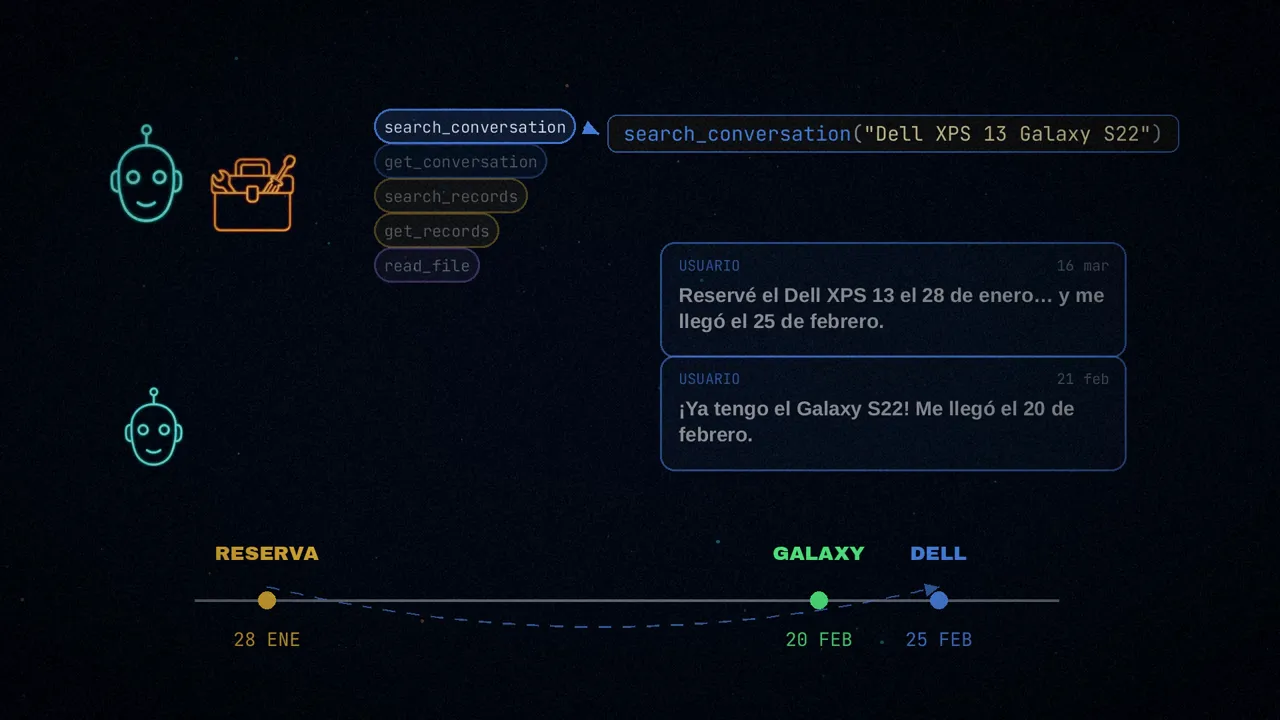
Esa diferencia, recibir frente a buscar, es todo el paper.
El problema de la recuperación pasiva
Los agentes ya no viven en una sola conversación: nos acompañan durante semanas en el trabajo, estudiando o en el día a día, y para eso tienen que acordarse de nosotros. Lo difícil es que lo que saben de un usuario es de muchos tipos y cada pregunta futura necesita un recuerdo distinto, así que una forma fija de guardar y de consultar la memoria se queda corta.
Hasta ahora la memoria se ha mejorado por dos lados:
Categorías más finas y almacenes de vectores, grafos, híbridos o jerárquicos: Mem0 guarda registros compactos, Zep monta un grafo de conocimiento temporal, MemOS trata la memoria como un recurso del sistema y MemoryOS la divide en corto, medio y largo plazo.
Búsquedas que reflexionan sobre lo encontrado, consultas personalizadas para cada usuario y una mejor reordenación de los resultados, a veces entrenadas con aprendizaje por refuerzo (Search-R1, DeepRetrieval, RMM).
Pero en casi todos, acceder a la memoria es una función del sistema, un proceso diseñado de antemano. Da igual cómo guardes la memoria, en lista, en grafo, en vectores o en jerarquía: al final se reduce a un trozo de contexto que alguien elige y se entrega al agente. Si ese trozo está incompleto, el agente no puede ir a buscar más. Es, como dicen los autores, un consumidor de pruebas seleccionadas por otro.
La memoria como espacio de acciones
La propuesta es darle la vuelta: que la memoria sea un espacio de acciones estructurado. El agente tiene herramientas de memoria y decide tres cosas:
- Si necesita la memoria para esta pregunta.
- A qué nivel de detalle consultarla.
- Si lo que ha encontrado ya basta para responder.
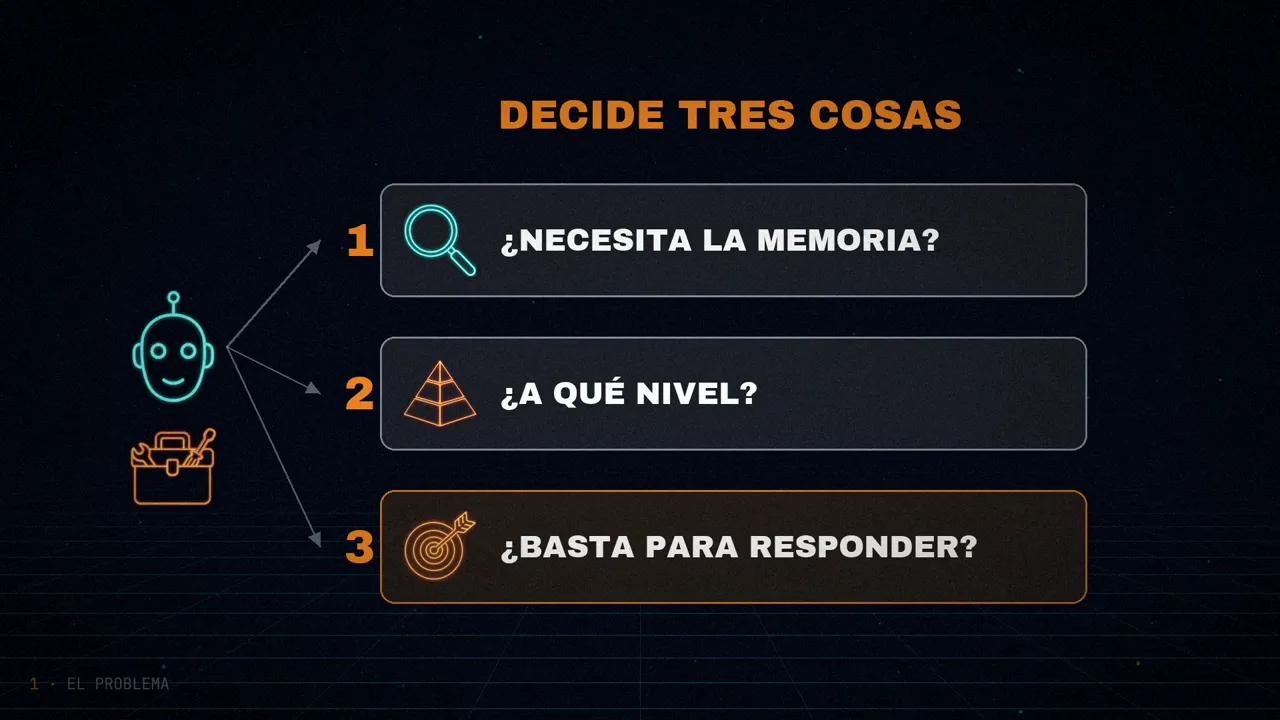
Lo llaman navegación activa de la memoria, y la diferencia con los trabajos que también entrenan políticas de memoria es dónde ponen el foco: no en qué guardar o cuándo borrar, sino en cómo usar la memoria en el momento de responder, eligiendo el nivel y afinando según lo que va encontrando.
La pirámide de memoria
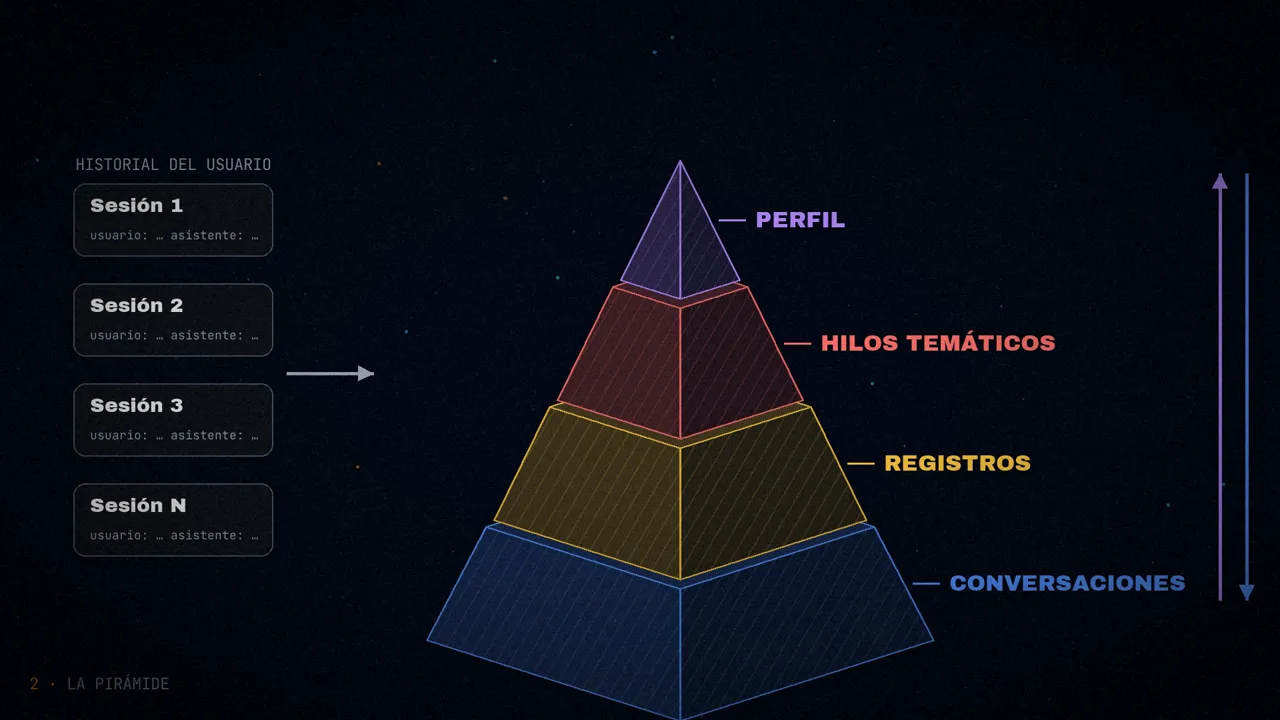
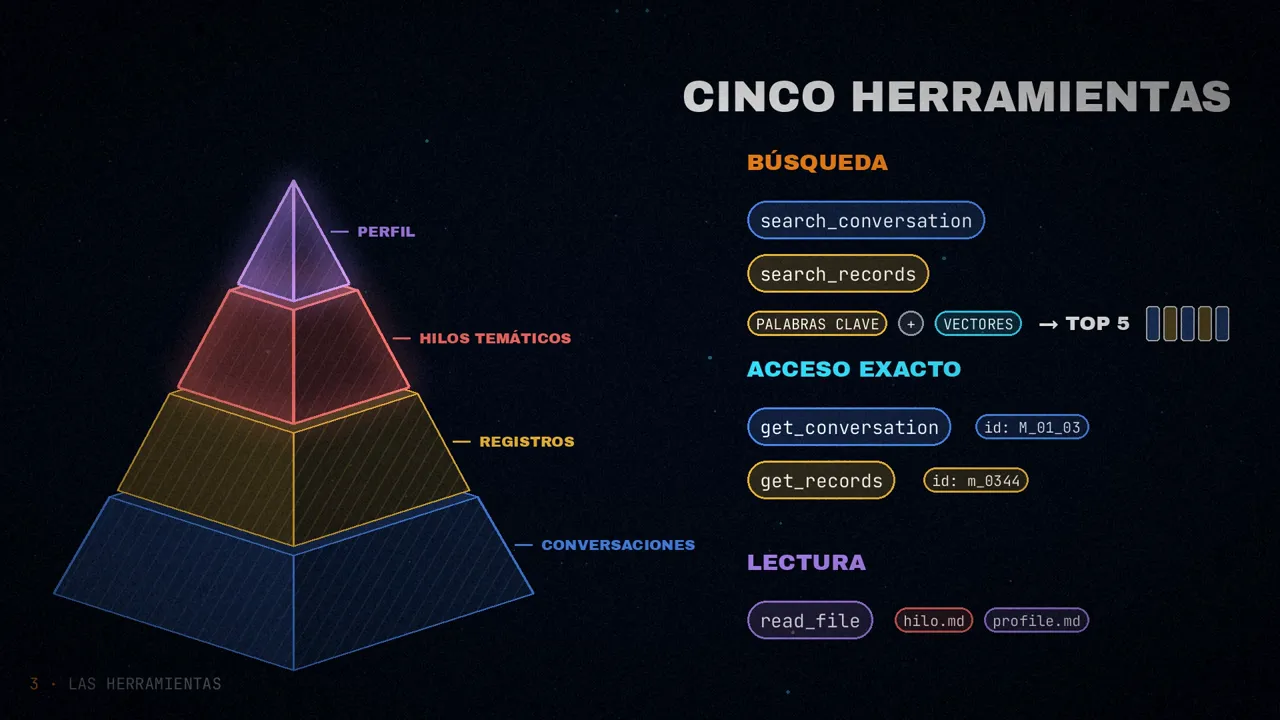
NapMem construye una pirámide para cada usuario con cuatro niveles. Todos cuentan la misma historia, cada uno con otro grado de abstracción, como un mapa que puedes ver entero o acercarte hasta una calle.
1. Conversaciones en bruto
La base guarda cada mensaje tal cual, con su contenido, quién lo dijo, cuándo, la sesión y un identificador único para encontrarlo exacto. Esta capa solo crece: nunca se reescribe. Es la prueba de mayor fidelidad, la que el agente consulta cuando necesita el detalle fino.
2. Registros de memoria
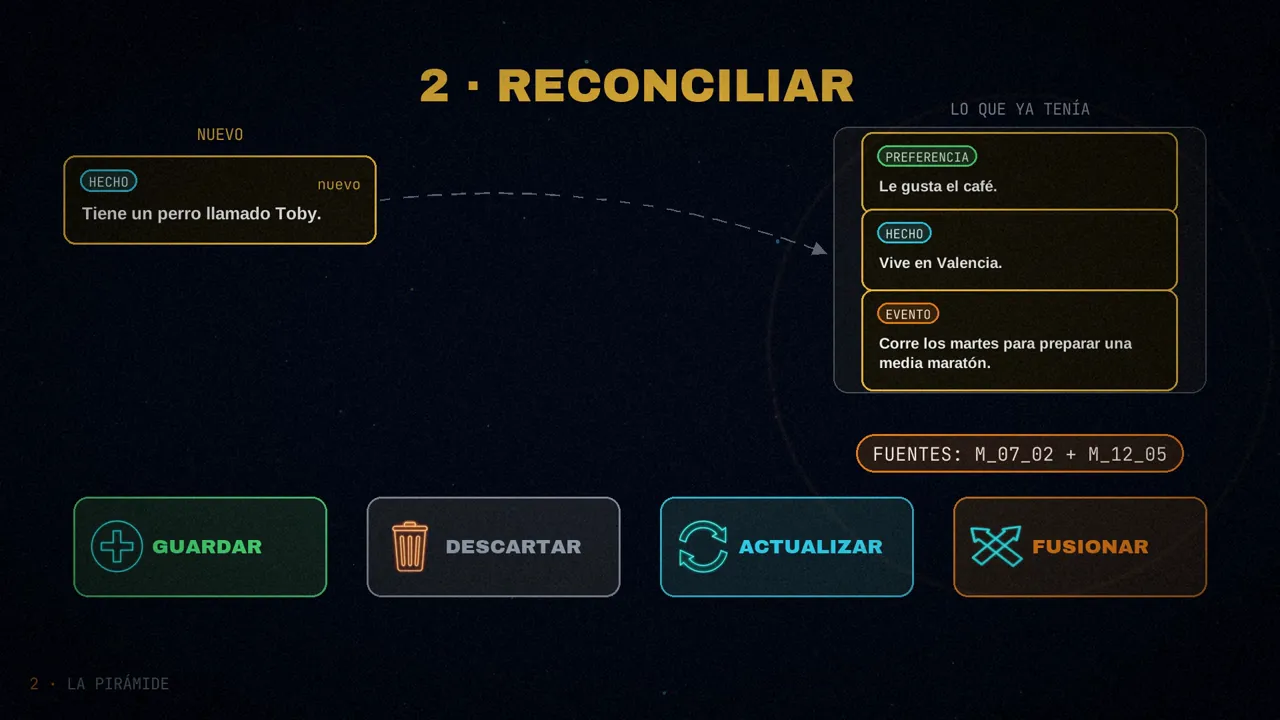
El segundo nivel son frases compactas que quitan la paja de la charla y se quedan con lo útil. Hay cuatro tipos: hechos, eventos, instrucciones y preferencias. Cada registro lleva su identificador, su tipo, su texto, su fecha y los identificadores de los mensajes de los que salió; ese enlace permite volver de un recuerdo resumido a la conversación original.
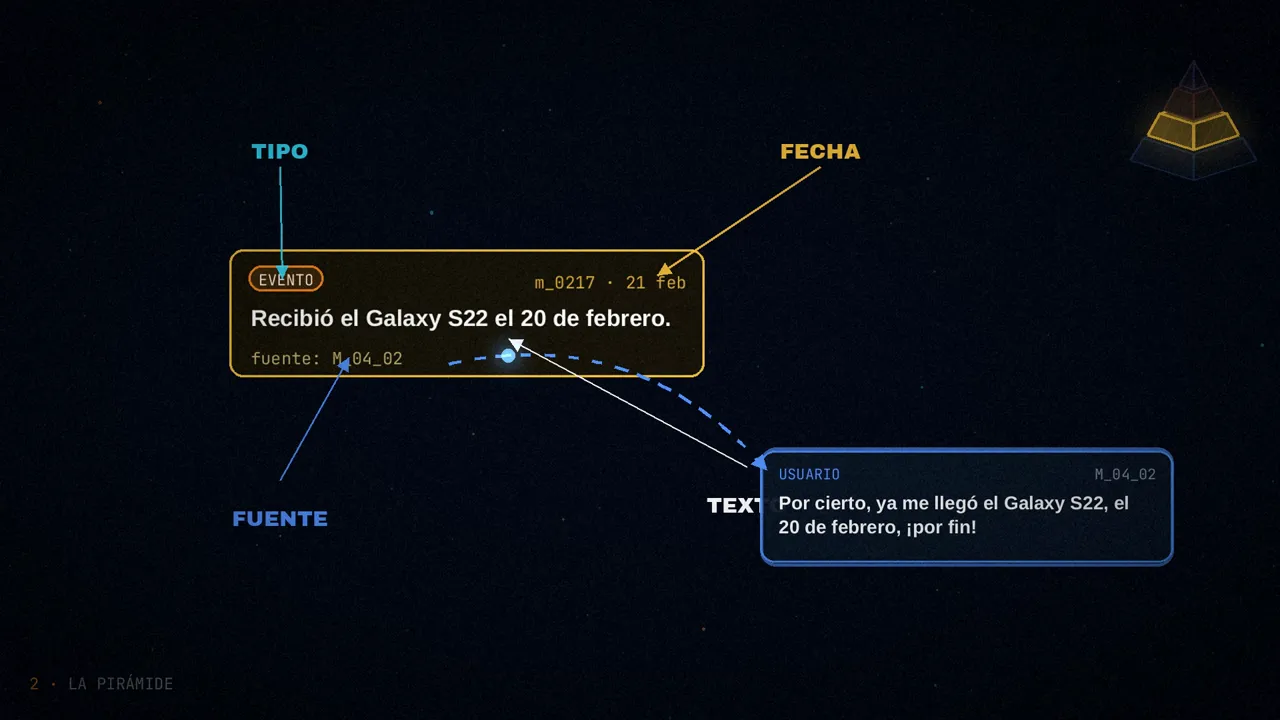
Se crean en dos pasos. Primero, tras unos turnos de charla (el lote crece de 1 a 2, a 4 y después se queda en 5 turnos), el modelo extrae registros nuevos de los mensajes recientes. Después los compara con los que ya tenía, mediante búsqueda híbrida, y elige qué hacer con cada uno: guardarlo, descartarlo si es redundante, actualizar uno antiguo si algo ha cambiado o fusionarlos si hablan de lo mismo. Al actualizar o fusionar se conserva la unión de las fuentes y de las fechas.
3. Hilos temáticos
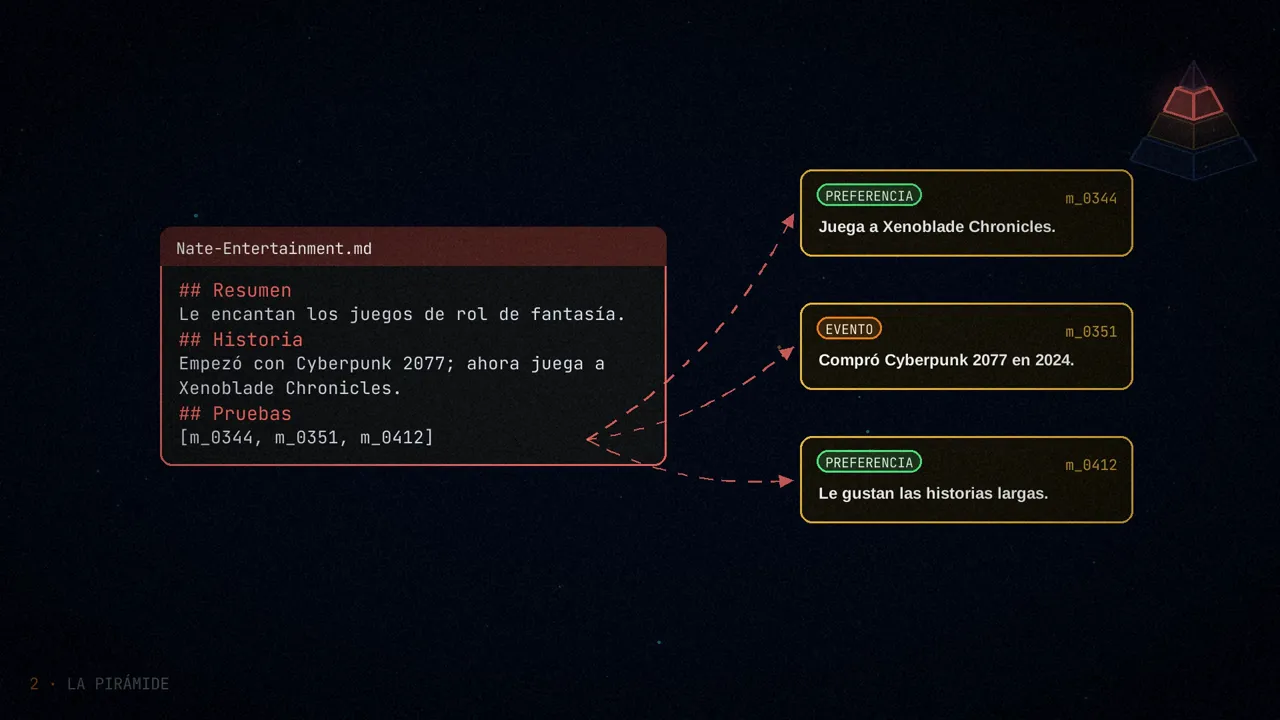
Un registro es un dato suelto, pero muchas cosas de una persona evolucionan durante semanas: un proyecto, una afición, una relación. Cada hilo temático es un archivo Markdown con metadatos, un resumen, la historia de ese tema y una sección de pruebas que enlaza los registros que la respaldan. Como mucho hay 20 hilos, y el agente decide si actualizar uno, fusionar dos o abrir otro nuevo. Las escrituras se validan antes de confirmarse; si el formato falla, se deshacen.
4. El perfil del usuario
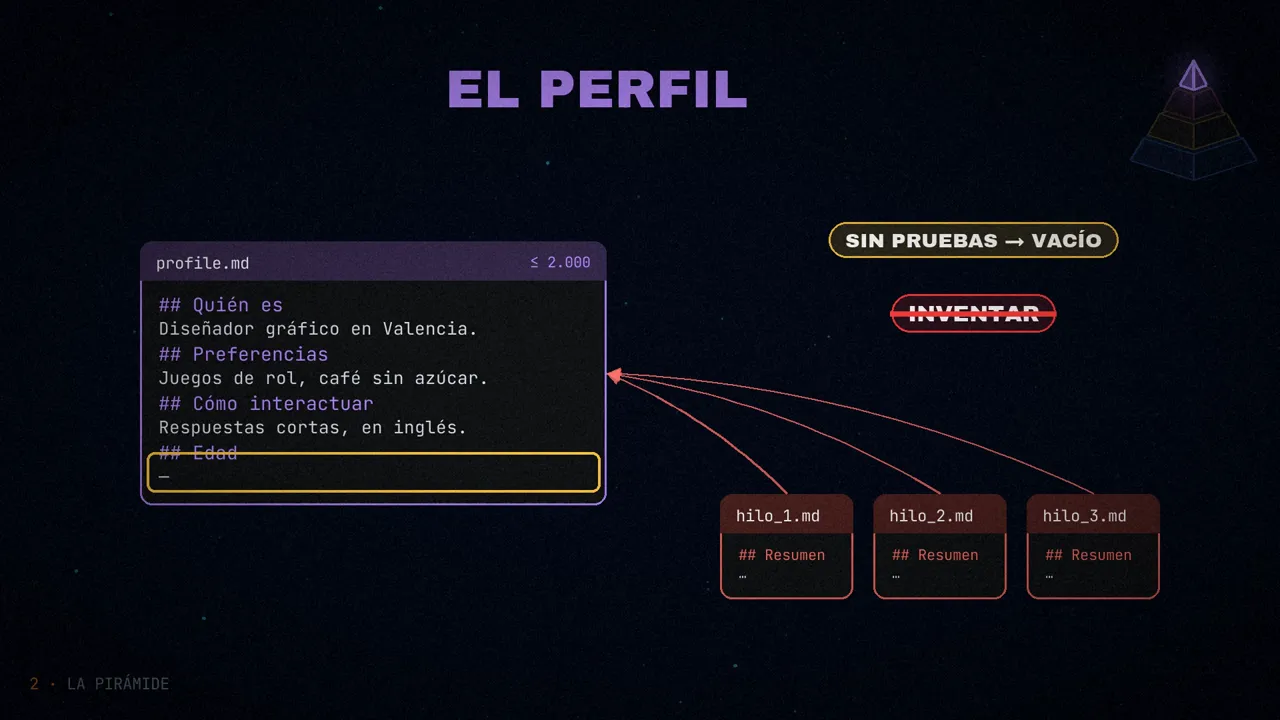
En la cima está el perfil: un resumen global de quién es el usuario, sus preferencias de largo plazo y su forma de interactuar. Tiene un límite de 2.000 caracteres, así que se revisa en vez de crecer. Y solo puede usar lo que dicen los hilos: si no hay pruebas, el campo se queda vacío antes que inventar.
Cómo se construye
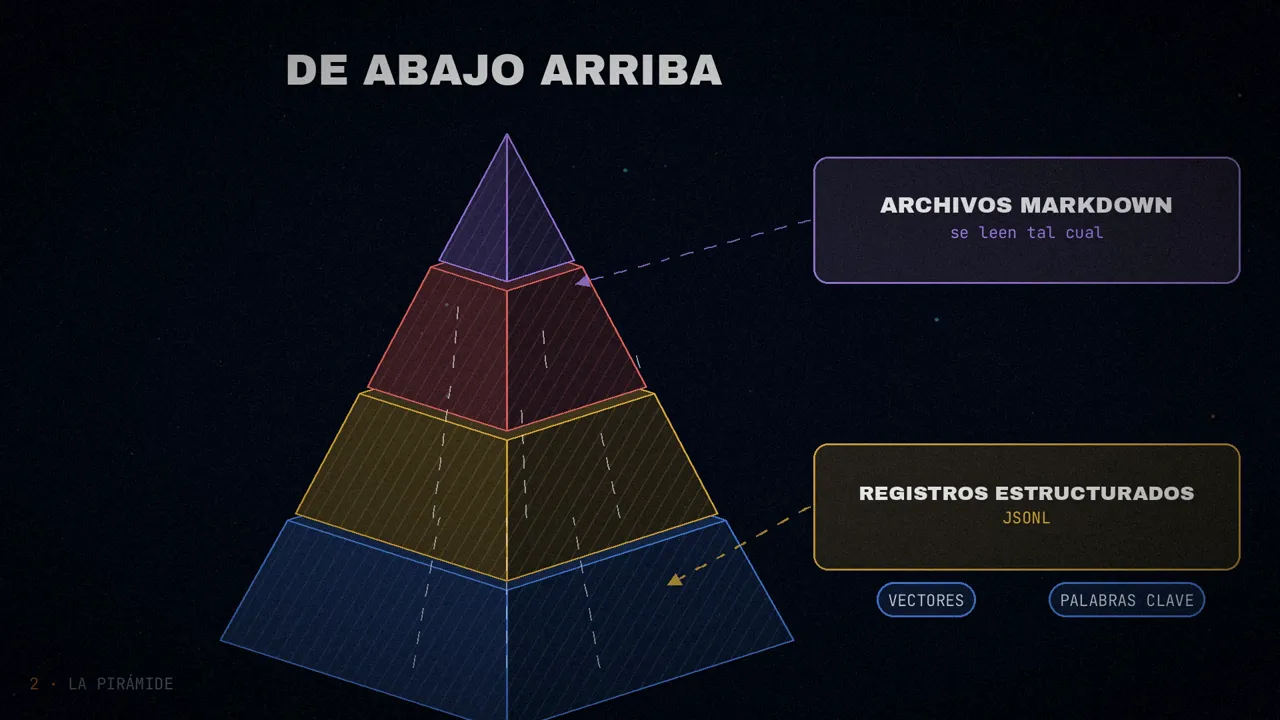
La pirámide se levanta de abajo arriba y poco a poco, recorriendo las sesiones del usuario en orden cronológico. Cada sesión nueva se añade a las conversaciones, de ahí salen registros, y los cambios suben: los hilos se revisan antes de una sesión nueva si hay registros pendientes, en los cambios de fecha o cuando se acumulan más de 20 registros nuevos; el perfil, tras actualizar los hilos o cuando hay más de 50.
Los dos niveles inferiores son registros estructurados en JSONL con índices de vectores y de palabras clave, para buscar por significado y encontrar algo exacto por su identificador. Los dos superiores son archivos Markdown que se leen tal cual. Y todos quedan enlazados: del perfil a los hilos, de los hilos a los registros y de los registros a los mensajes.
Las cinco herramientas
Para moverse por la pirámide, el agente tiene cinco herramientas, cada una pensada para un nivel:
| Herramienta | Entrada | Qué hace |
|---|---|---|
search_conversation | texto libre | Busca en los mensajes en bruto y devuelve los 5 mejores fragmentos |
search_records | texto libre | Busca en los registros y devuelve los 5 mejores |
get_conversation | lista de ids de mensaje | Trae mensajes exactos por su identificador |
get_records | lista de ids de registro | Trae registros exactos por su identificador |
read_file | nombre de archivo | Lee un hilo temático o profile.md |
Las dos de búsqueda son híbridas: mezclan palabras clave y vectores con reciprocal rank fusion (RRF, con k = 60), sobre embeddings de Qwen3-Embedding-0.6B. Las de acceso exacto usan los identificadores que devolvieron llamadas anteriores, y la de lectura da acceso a los niveles más abstractos.
Navegar en las dos direcciones
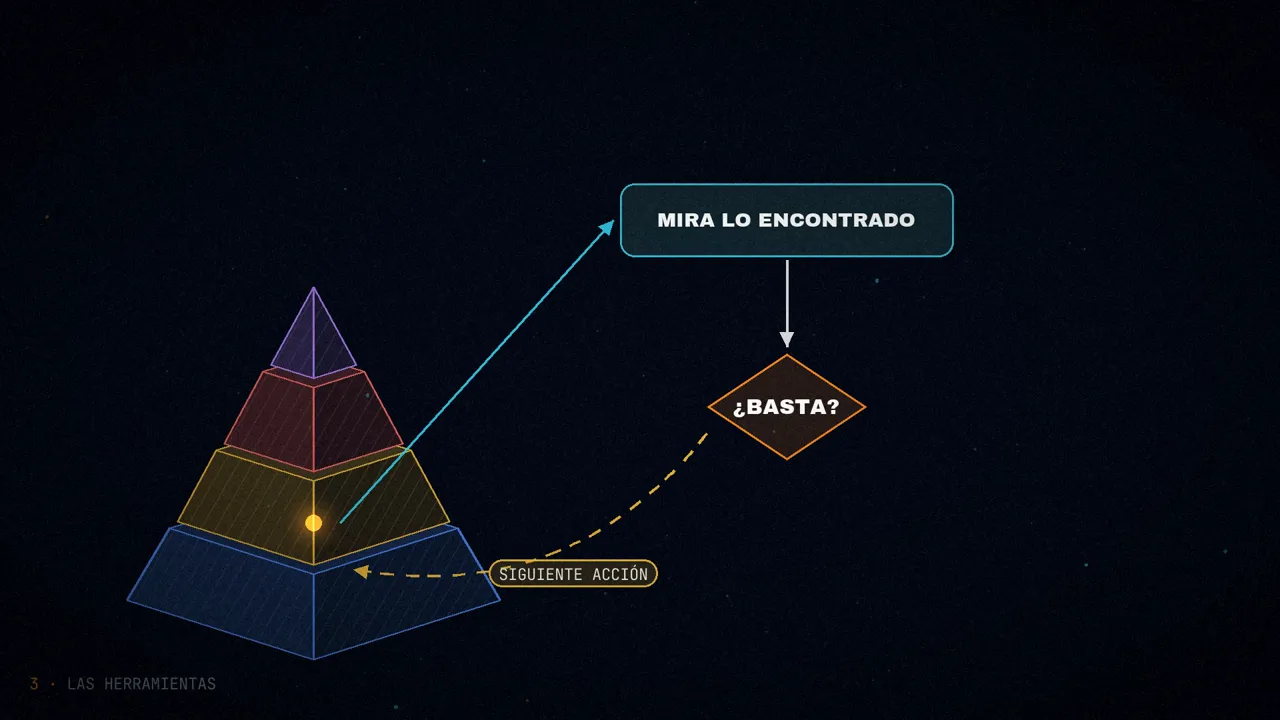
Con eso, la navegación puede ir de arriba abajo (empezar por el perfil o un hilo, afinar con los registros y bajar a la conversación para comprobar la prueba) o de abajo arriba (buscar un detalle y, si no aparece, subir a un resumen). En cada paso el agente mira lo que ha encontrado y decide su siguiente acción, o si para y responde. Formalmente, en el paso t elige una acción a partir de la pregunta, la pirámide y lo que ha visto hasta entonces, y la trayectoria termina con la respuesta.
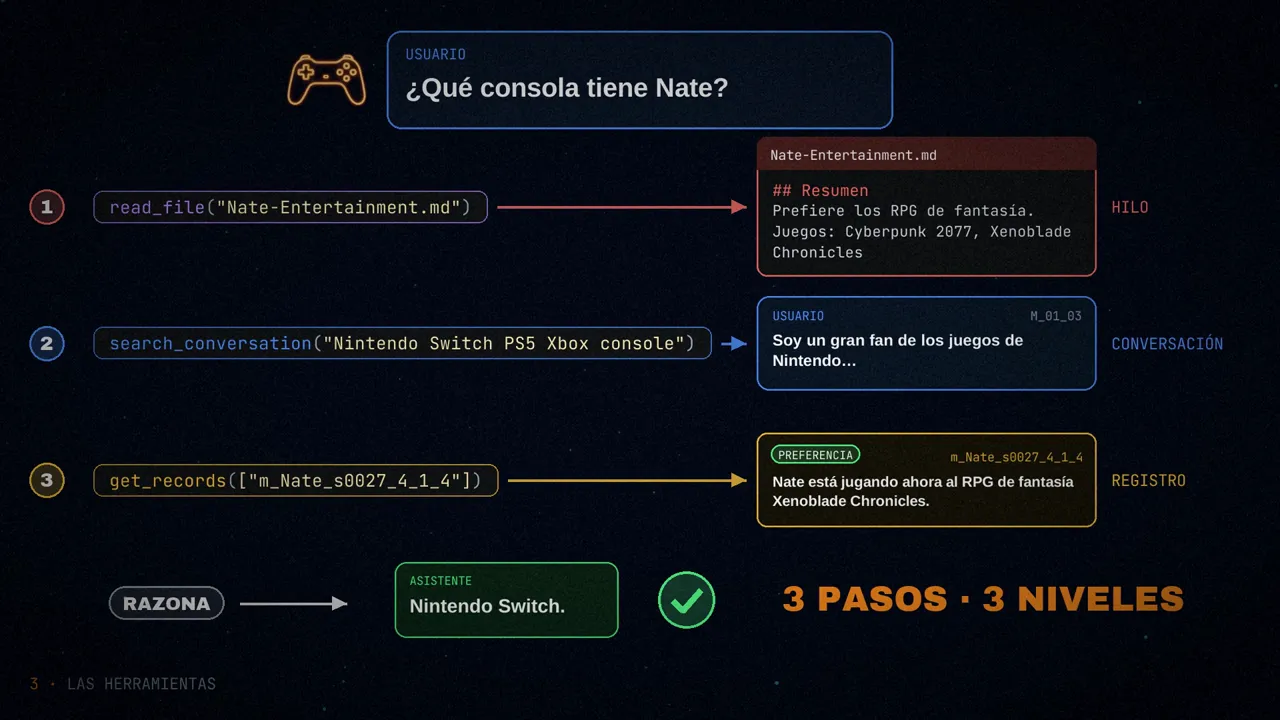
El ejemplo de la figura 2 del paper: «¿Qué consola tiene Nate?». El agente lee primero Nate-Entertainment.md, que menciona Cyberpunk 2077 y Xenoblade Chronicles. Busca en las conversaciones con search_conversation("Nintendo Switch PS5 Xbox console") y encuentra que Nate es un gran fan de los juegos de Nintendo. Después trae con get_records el registro exacto: está jugando a Xenoblade Chronicles, un RPG de fantasía. Razona y responde: una Nintendo Switch. Tres pasos por tres niveles distintos.
Hay un límite: como mucho cuatro pasos con herramientas por pregunta; si se pasa, la respuesta cuenta como fallo. Y el prompt es claro: no adivines nada sobre el usuario; si dos recuerdos se contradicen, mandan las instrucciones; usa las conversaciones cuando necesites la prueba exacta, y deja de buscar en cuanto tengas pruebas suficientes, sin perseguir detalles marginales. La respuesta final va en JSON con la respuesta y el motivo.
Aprender a navegar: la rúbrica y GRPO
Tener herramientas no basta: hay que saber usarlas. Por eso entrenan al agente con aprendizaje por refuerzo. Cada ejemplo es una pregunta que necesita memoria junto a la pirámide de ese usuario; el agente responde con su cadena de llamadas y solo recibe una nota al final, por el resultado. Esa nota entrena a la vez la respuesta y todas las decisiones de navegación que la llevaron hasta ahí.
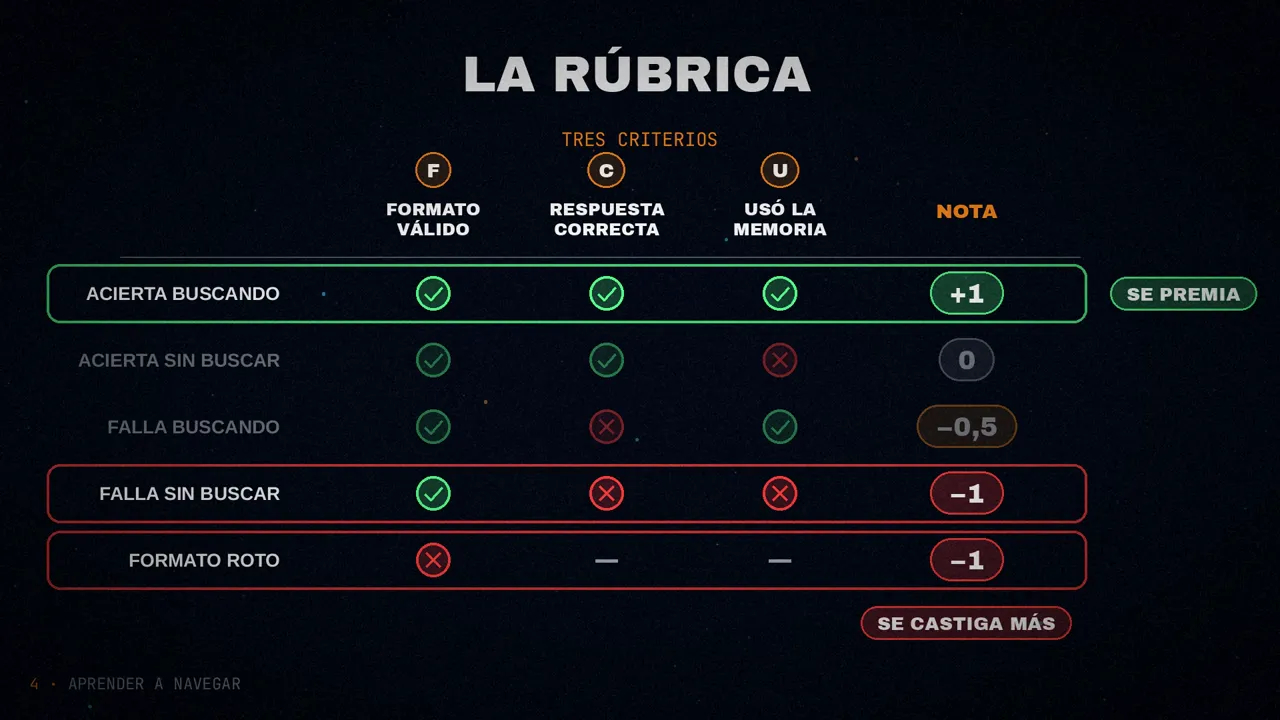
La nota sigue una rúbrica de tres criterios binarios: formato válido (F), respuesta correcta (C) y uso de la memoria (U):
| Caso | F | C | U | Nota |
|---|---|---|---|---|
| Acierta usando la memoria | 1 | 1 | 1 | +1 |
| Acierta sin usarla | 1 | 1 | 0 | 0 |
| Falla tras consultarla | 1 | 0 | 1 | −0,5 |
| Falla sin consultarla | 1 | 0 | 0 | −1 |
| Formato roto (o se pasa del presupuesto) | 0 | – | – | −1 |
Así se premia acertar buscando y se castiga más inventar. Como todas las preguntas del entrenamiento necesitan memoria, acertar sin consultarla no puntúa.
El algoritmo es GRPO (Group Relative Policy Optimization). Para cada pregunta se generan cuatro intentos, y la ventaja de cada uno es su nota menos la media del grupo: los intentos mejores que la media se refuerzan y los peores se penalizan. No hace falta un modelo aparte que juzgue cada paso: el propio grupo es la referencia. La ventaja se aplica a todos los tokens del intento, también a los de las llamadas a herramientas, con el objetivo recortado habitual y una penalización KL respecto al modelo de partida.
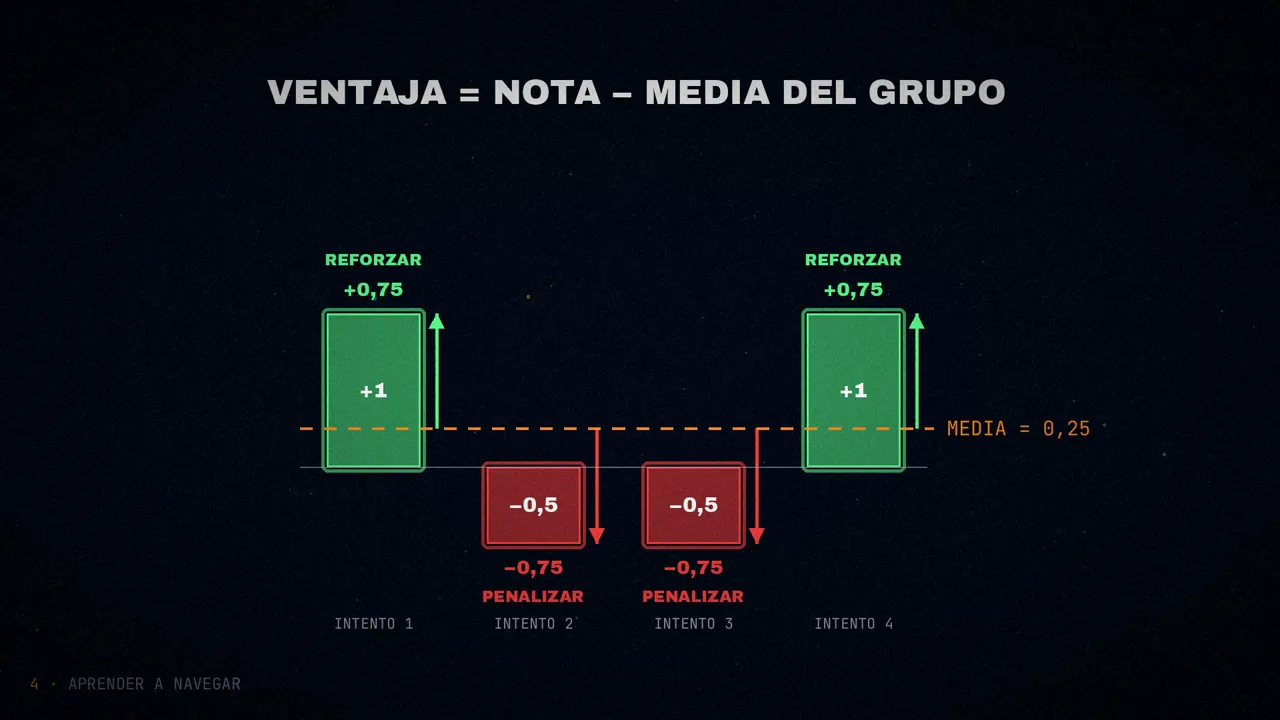
Para quien quiera reproducirlo, los hiperparámetros del apéndice: Qwen3.5-9B como modelo base, lote de 8, grupos de 4 intentos, tasa de aprendizaje 1×10⁻⁶, coeficiente KL de 0,001, sin término de entropía, bfloat16, 5 épocas y hasta 5 turnos del asistente, con el framework verl en GPU NVIDIA H20.
Entrenamiento y evaluación
Entrenan con preguntas de dos benchmarks, LoCoMo y PersonaMem-v2, separando a los usuarios (60 % para entrenar, 20 % para validar y 20 % para el test) para que nadie aparezca en dos lados. El tercero, LongMemEval, no se ve nunca durante el entrenamiento: sirve para comprobar si lo aprendido funciona fuera de lo conocido. LoCoMo y LongMemEval miden la memoria de hechos (recordar algo lejano, cambios en el tiempo, razonar entre sesiones); PersonaMem-v2, las preferencias implícitas. Los tests tienen 1.315 preguntas de LoCoMo, 100 de LongMemEval y 911 de PersonaMem-v2.
Lo comparan con cinco sistemas de memoria: Mem0 (memoria plana de vectores), Zep (grafo temporal), MemOS (un sistema operativo de memoria), MemoryOS (memoria jerárquica) y AgeMem (memoria agéntica entrenada con refuerzo), todos sobre el mismo Qwen3.5-9B. NapMem y AgeMem pueden hacer como mucho cuatro pasos con herramientas y cada búsqueda devuelve hasta 5 elementos; a los sistemas no agénticos se les dejan hasta 20 por búsqueda.
En las preguntas abiertas juzga Claude Opus 4.6. Comprobaron su fiabilidad con 100 respuestas anotadas por tres personas: coincide con la mayoría humana en el 99 % de los casos (precisión 1,0, exhaustividad 0,98, κ de Cohen 0,98). El único desacuerdo fue un «0 veces» que el juez dio por malo cuando la respuesta esperada era que nunca se mencionó. Todos los resultados son la media de tres semillas.
Los resultados
La tabla 1 del paper (L-J es la nota del juez; la media junta la nota del juez de LoCoMo y LongMemEval y la precisión de PersonaMem-v2):
| Sistema | LoCoMo F1 | LoCoMo L-J | LongMemEval F1 | LongMemEval L-J | PersonaMem-v2 | Media |
|---|---|---|---|---|---|---|
| Mem0 | 41,19 | 60,86 | 53,86 | 78,00 | 38,89 | 59,25 |
| Zep | 36,09 | 52,21 | 52,61 | 73,33 | 36,33 | 53,96 |
| MemOS | 35,22 | 55,82 | 39,16 | 54,33 | 37,58 | 49,24 |
| MemoryOS | 31,40 | 44,28 | 22,68 | 23,67 | 35,82 | 34,59 |
| AgeMem | 38,00 | 45,02 | 37,83 | 51,33 | 24,19 | 40,18 |
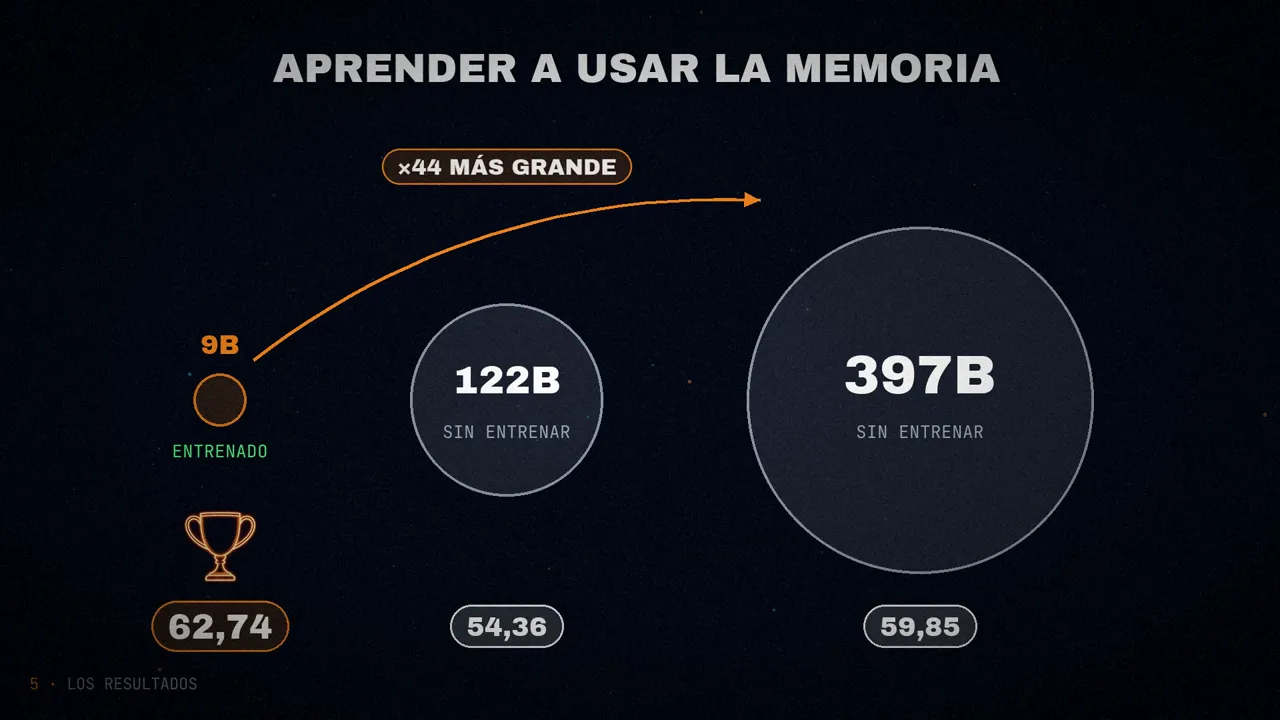
| NapMem-122B (sin entrenar) | 35,39 | 51,69 | 48,86 | 70,00 | 41,38 | 54,36 |
| NapMem-397B (sin entrenar) | 38,31 | 54,42 | 53,85 | 78,33 | 46,10 | 59,85 |
| NapMem-9B con RL | 41,28 | 59,92 | 57,41 | 80,33 | 47,97 | 62,74 |
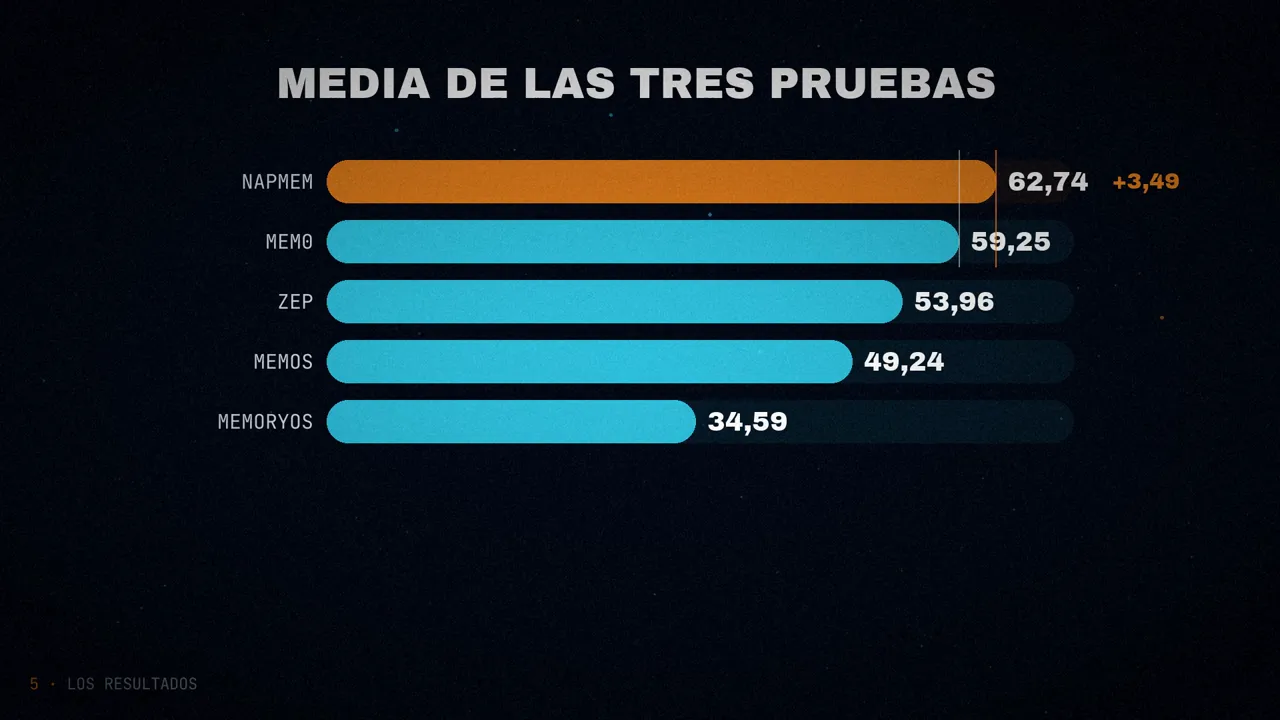
NapMem entrenado saca la mejor media, 62,74, frente a 59,25 del mejor rival, Mem0. En LongMemEval, la prueba que no vio al entrenar, llega a 80,33, el mejor de todos; en PersonaMem-v2, a 47,97, también por delante.
En LoCoMo no gana en todo, y conviene decirlo: tiene el mejor F1 (41,28 frente a 41,19), pero en la nota del juez Mem0 le saca un punto (60,86 frente a 59,92). Es decir, en la memoria de hechos de conversaciones largas está a la par del mejor; donde se despega es en la personalización y en lo que no había visto al entrenar.
9B entrenado frente a 397B
Lo más llamativo de la tabla son las dos filas de en medio. Probaron la misma pirámide y las mismas herramientas con modelos mucho más grandes, sin entrenar: Qwen3.5-122B y Qwen3.5-397B. El más grande saca 59,85 de media; el pequeño de 9B, entrenado, 62,74. Aprender a usar la memoria vale más que multiplicar el tamaño por cuarenta.
Cuando no hace falta memoria
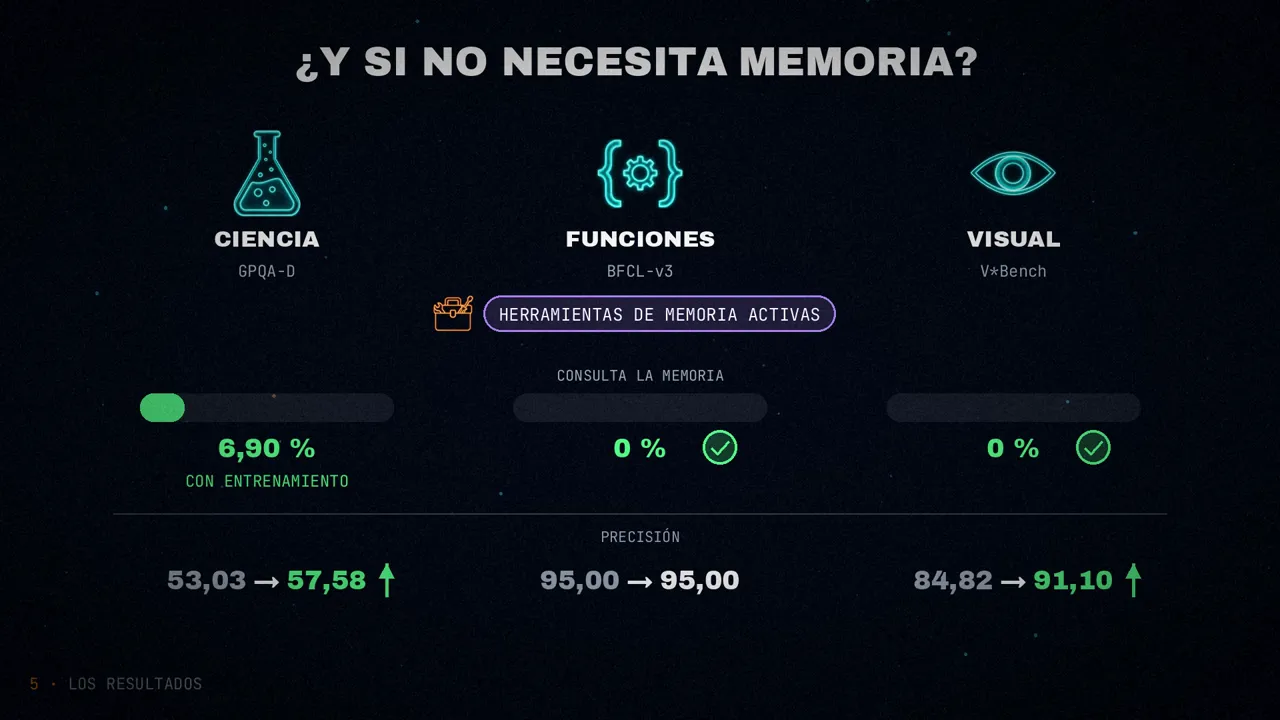
¿Y si la pregunta no necesita memoria? Para comprobar que el entrenamiento no lo convierte en un agente que consulta la memoria por todo, le pusieron tres tareas ajenas (ciencia con GPQA-Diamond, llamadas a funciones con BFCL-v3 y búsqueda visual con V*Bench) con una pirámide cualquiera y todas las herramientas de memoria activas:
| Prueba | Métrica | Modelo base | NapMem-9B sin RL | NapMem-9B con RL |
|---|---|---|---|---|
| GPQA-Diamond | Precisión | 53,03 | 55,74 | 57,58 |
| GPQA-Diamond | Llamadas a memoria | – | 34,51 % | 6,90 % |
| BFCL-v3 | Tarea / herramienta / ejecución | 95,00 / 97,50 / 93,50 | 93,50 / 97,50 / 94,00 | 95,00 / 97,50 / 94,50 |
| BFCL-v3 | Llamadas a memoria | – | 0 % | 0 % |
| V*Bench | Respuesta | 84,82 | 89,53 | 91,10 |
| V*Bench | Llamadas a memoria | – | 0 % | 0 % |
Sin entrenar, el modelo miraba la memoria en el 34,51 % de las preguntas de ciencia, sin motivo; entrenado, solo en el 6,90 %. En las otras dos tareas, nunca. Y no pierde nivel: incluso mejora algo en ciencia y en la prueba visual. El refuerzo calibra cuándo usar la memoria, no solo la usa más.
El coste: espacio y tiempo
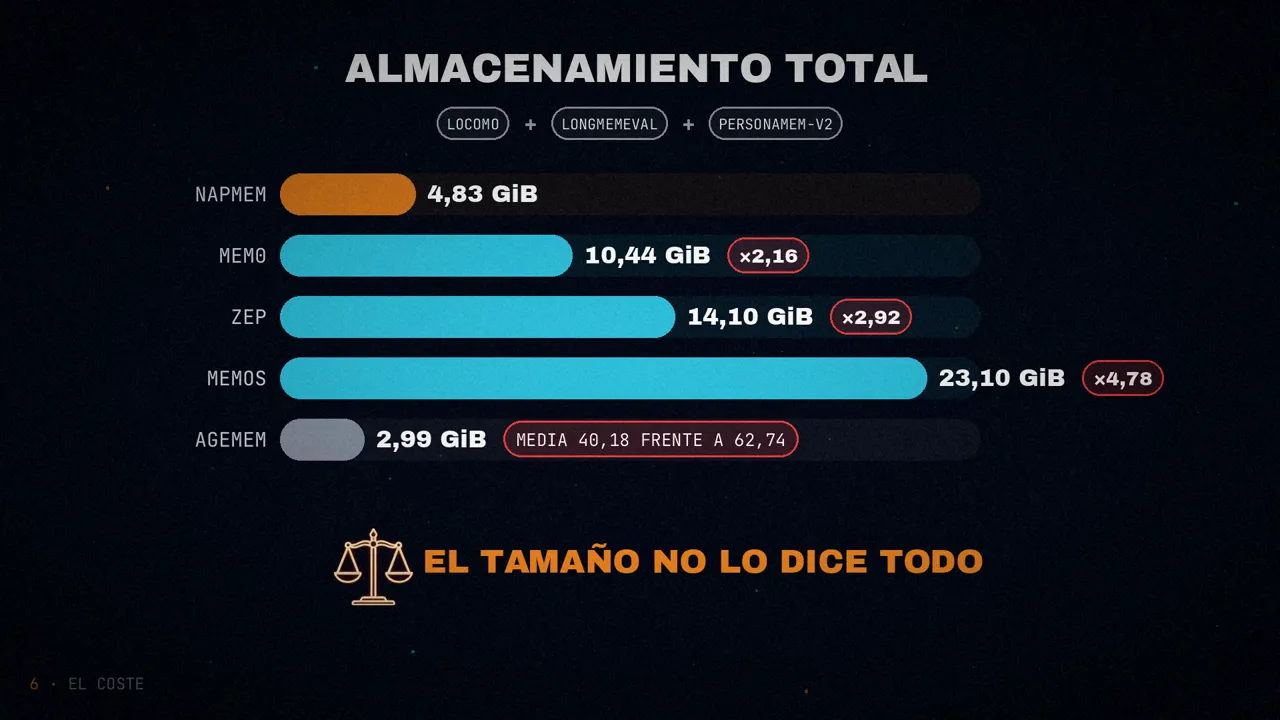
La memoria de un usuario no deja de crecer, así que ocupar poco importa. Sumando los tres benchmarks, NapMem ocupa 4,83 GiB, menos que casi todos pese a guardar cuatro niveles:
| Sistema | PersonaMem-v2 | LongMemEval | LoCoMo | Total |
|---|---|---|---|---|
| NapMem | 0,69 | 4,01 | 0,12 | 4,83 |
| Mem0 | 1,40 | 8,90 | 0,14 | 10,44 (×2,16) |
| MemOS | 3,61 | 18,85 | 0,64 | 23,10 (×4,78) |
| Zep | 3,50 | 10,00 | 0,60 | 14,10 (×2,92) |
| MemoryOS | 1,98 | 4,30 | 0,40 | 6,68 (×1,38) |
| AgeMem | 0,34 | 2,56 | 0,09 | 2,99 (×0,62) |
Solo AgeMem ocupa menos, con su memoria plana y ligera, pero rinde mucho peor (40,18 de media). El tamaño por sí solo no lo dice todo.
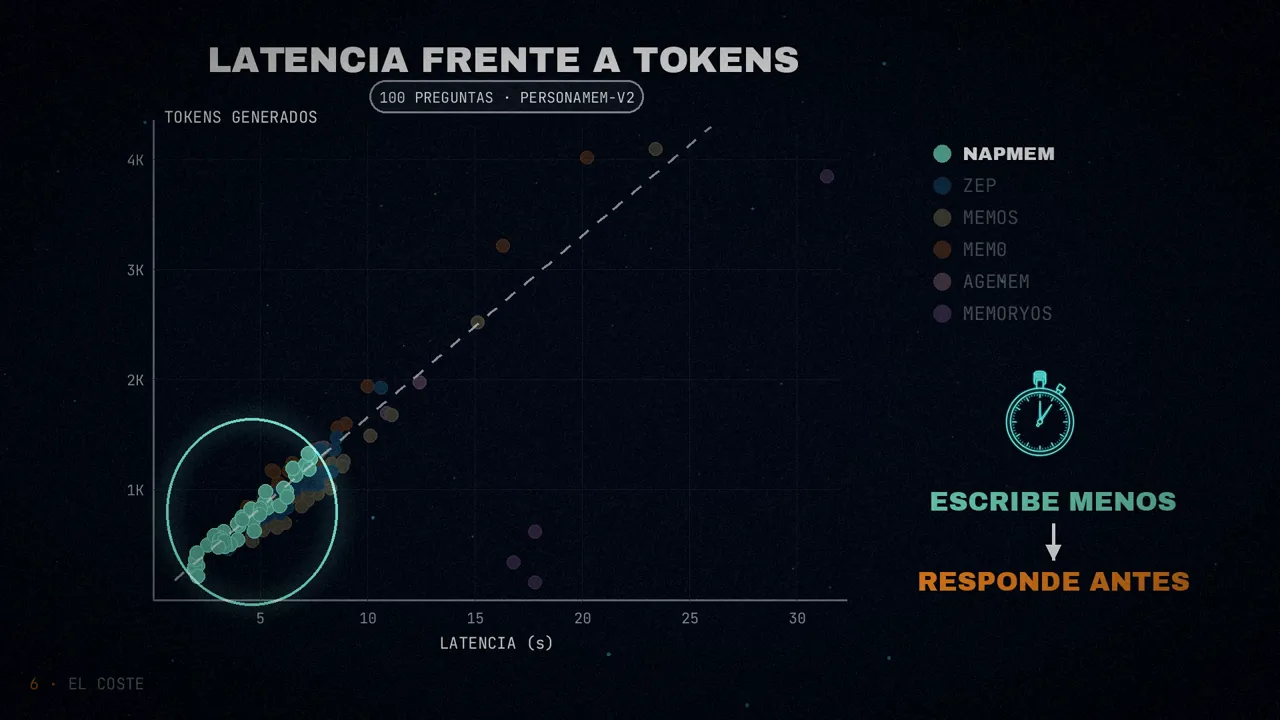
Y el tiempo de respuesta. En cien preguntas de PersonaMem-v2, la latencia crece casi en línea recta con los tokens que genera el modelo: cuanto más escribe, más tarda. Los sistemas pasivos reciben mucho texto y razonan sobre todo él; NapMem busca lo que necesita y para en cuanto tiene pruebas, así que escribe menos y contesta antes, aunque use herramientas.
Qué pieza importa
Para ver qué parte da la ventaja, quitaron piezas una a una (nota del juez en LoCoMo y LongMemEval, precisión en PersonaMem-v2):
| Variante | LoCoMo | LongMemEval | PersonaMem-v2 | Media |
|---|---|---|---|---|
| NapMem completo | 59,92 | 80,33 | 47,97 | 62,74 |
| Sin aprendizaje por refuerzo | 52,09 | 72,33 | 20,75 | 48,39 |
| Sin navegación (recuperación pasiva) | 48,37 | 68,00 | 45,88 | 54,08 |
| Solo herramientas de registros | 39,77 | 60,00 | 35,02 | 44,93 |
| Sin niveles superiores (sin hilos ni perfil) | 49,13 | 75,00 | 38,20 | 54,11 |
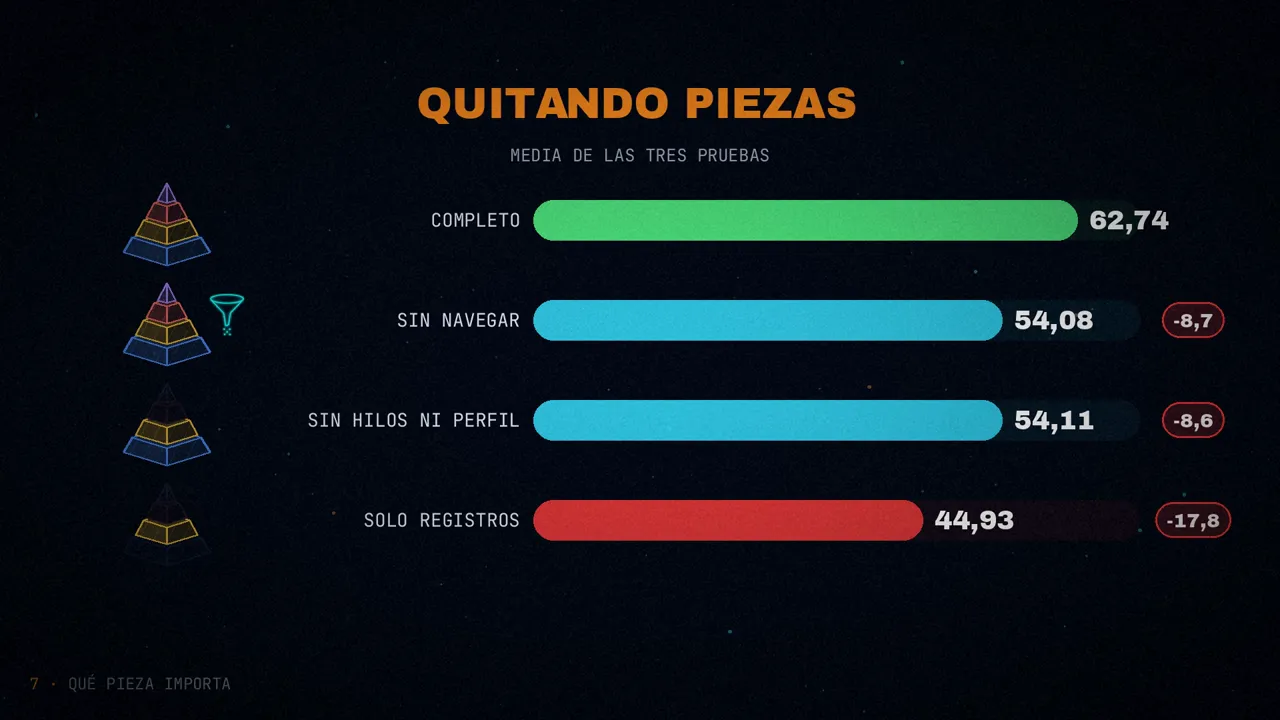
Las tres piezas suman. Navegar es mejor que recibir, aunque la memoria disponible sea la misma. Los resúmenes de arriba completan el detalle de abajo. Y usar bien la memoria se aprende: sin el refuerzo, con la misma pirámide y las mismas herramientas, la media cae a 48,39, y en PersonaMem-v2 se desploma de 47,97 a 20,75. No basta con explicarlo en el prompt.
Cómo navega
Miraron cuál es la primera herramienta que usa cada modelo. Los de 9B empiezan casi siempre por los registros (92,16 % sin entrenar, 88,84 % entrenado). Los grandes, en cambio, empiezan leyendo archivos en casi la mitad de los casos (44,38 % el de 122B y 46,60 % el de 397B). Una posible explicación de los autores: los modelos grandes digieren mejor un resumen largo, y los pequeños prefieren pruebas cortas y concretas.
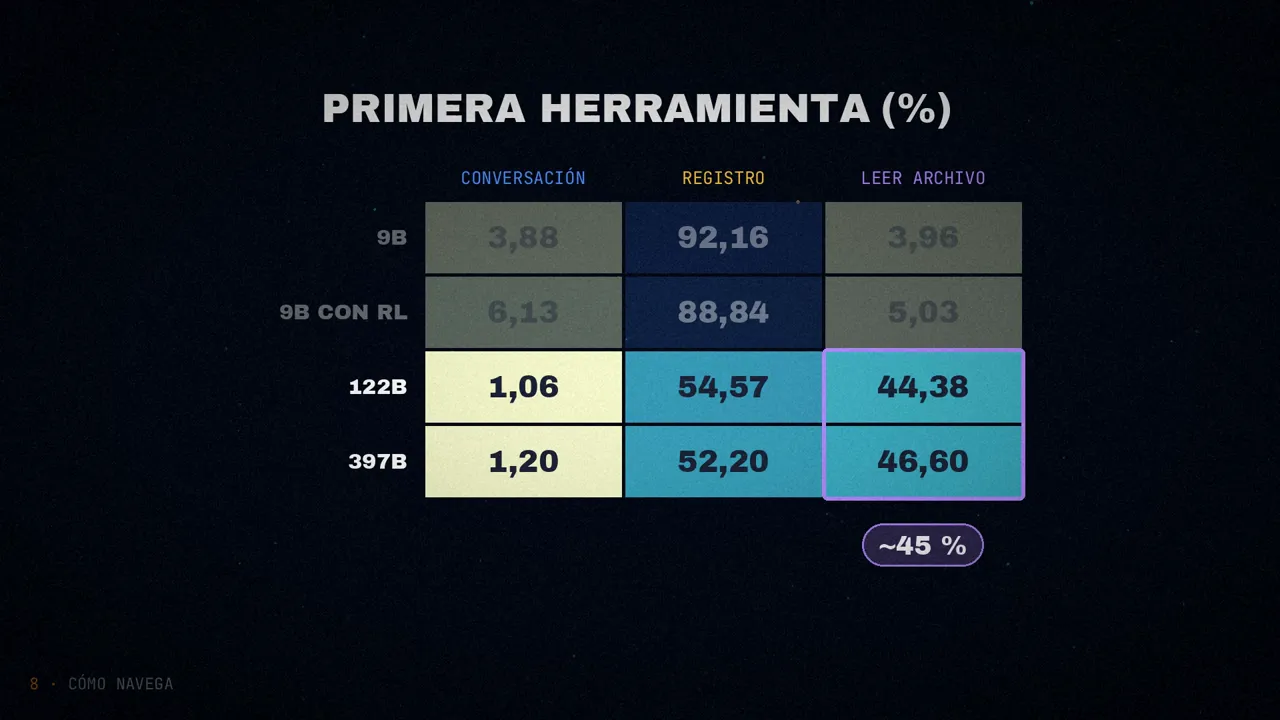
Y el refuerzo cambia la forma de buscar. Sin entrenar, el modelo de 9B hacía 3,97 llamadas por pregunta; entrenado, 2,15, y aun así acierta más: de cada cien resultados que le devuelven las herramientas, 34,92 son pruebas útiles, frente a 20,66 antes. No se queda en un solo nivel: el 79,63 % de las preguntas siguen usando varios (80,39 % antes de entrenar). Ha aprendido a parar.
Un acierto y un fallo
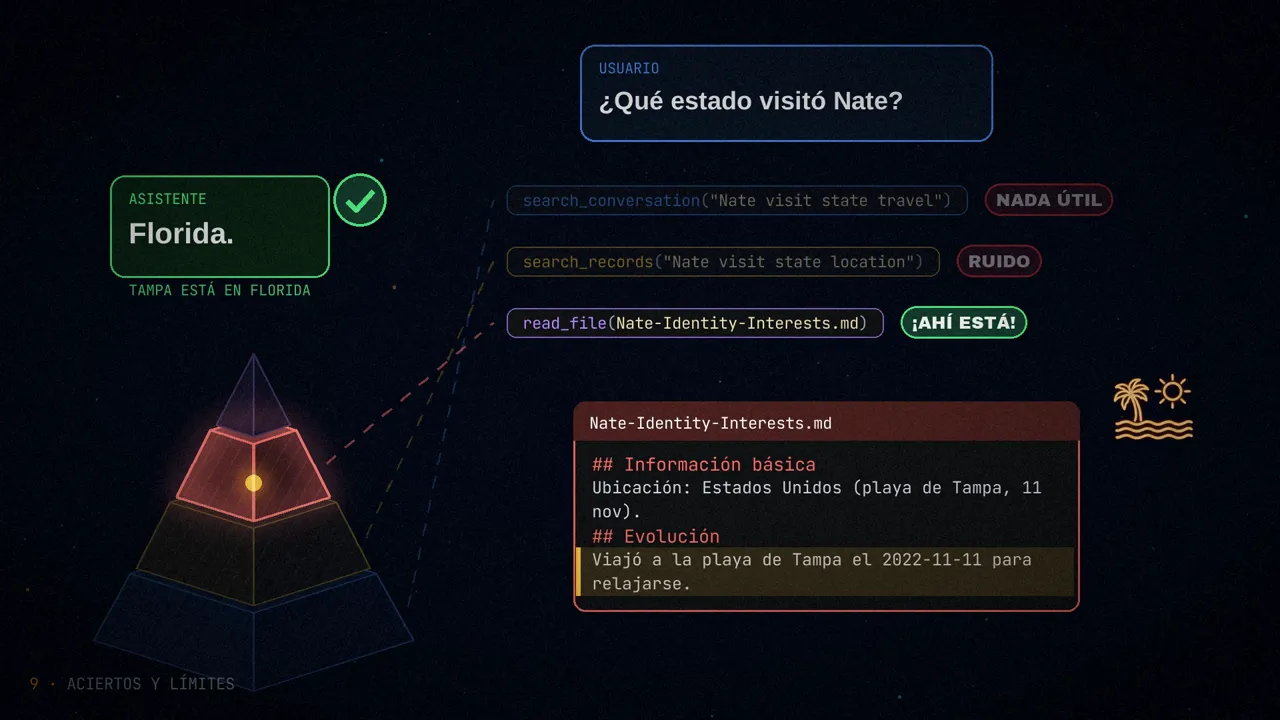
El acierto. Pregunta: «¿Qué estado visitó Nate?». search_conversation("Nate visit state travel") no da nada útil; search_records(...) devuelve registros irrelevantes o vagos. Entonces el agente lee el hilo Nate-Identity-Interests.md y ahí está: Nate viajó a la playa de Tampa el 11 de noviembre de 2022. Respuesta: Florida. Subir a un nivel más abstracto rescató lo que la búsqueda directa no encontraba.
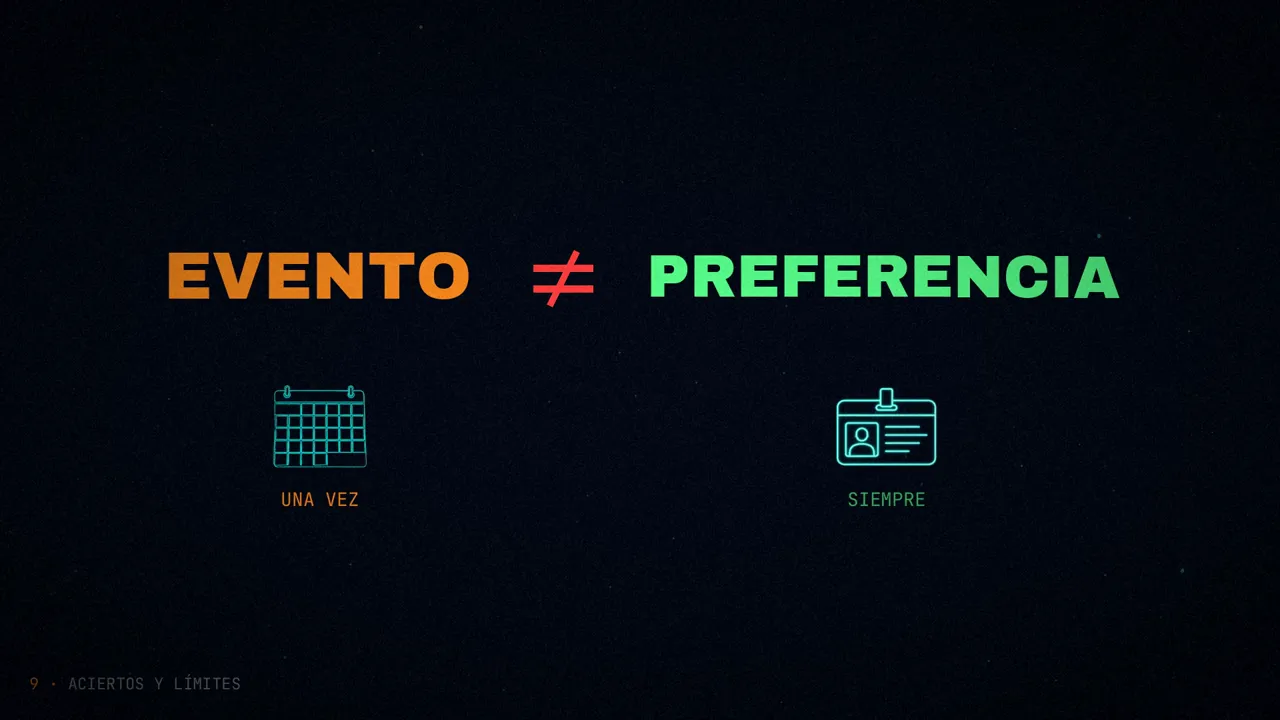
El fallo. Alguien pide ideas tranquilas para el fin de semana. El agente encuentra un registro: el usuario pensó en poner salsa en una gala benéfica porque el año anterior había funcionado. Encuentra otro: se carga de energía en eventos llenos de gente, pero luego necesita estar a solas. Y elige la opción que da por hecho que le encanta ir a bailar salsa los fines de semana. Ha convertido un evento suelto en una preferencia estable: los recuerdos eran relevantes, pero no bastaban para esa conclusión. Los autores lo señalan como trabajo futuro: calibrar cuánto prueba cada recuerdo.
Límites
Los propios autores señalan tres:
- Los benchmarks no recogen todas las formas reales de personalización ni de conversación abierta.
- La privacidad y el olvido, dos requisitos clave en cualquier sistema que recuerda cosas de personas, no están resueltos del todo.
- El tamaño del modelo: queda por estudiar a fondo cómo cambia la estrategia de acceso a la memoria al escalar.
Una curiosidad: en el apéndice de implementación se les escapa otro nombre, «PyraNav», seguramente el de una versión anterior del método.
En resumen
NapMem guarda la memoria del usuario en una pirámide de cuatro niveles (conversaciones, registros, hilos temáticos y perfil) y entrena al agente con aprendizaje por refuerzo para moverse por ella con cinco herramientas, en vez de recibir lo que otro elige. Así, un modelo de 9B supera a uno de 397B sin entrenar, busca menos, acierta más y casi nunca consulta la memoria cuando no hace falta.
La memoria de un agente funciona mejor como un sitio que recorre que como un trozo de contexto que le entregan.
¿Qué te gustaría que tu asistente recordara de ti?
Fuentes
- «From Passive Retrieval to Active Memory Navigation: Learning to Use Memory as a Structured Action Space», de Yue Xu, Yutao Sun, Yihao Liu, Mengyu Zhou, Jiayi Qiao, Lu Ma, Kai Tang, Wenjie Wang, Xiaoxi Jiang y Guanjun Jiang (Qwen, Alibaba; ShanghaiTech; Zhejiang; Peking; NUS), arXiv 2607.05794, 7 de julio de 2026.
- Sobre otros enfoques de memoria para agentes: mis posts sobre Quarq Agent y LongMemEval y sobre la LLM Wiki de Karpathy.
- El vídeo, en mis canales: español e inglés.