La capa que importa
Cobus parte de una lectura: el informe técnico de OpenDev, que se presenta como el primer trabajo completo sobre un agente de programación de código abierto que vive en la terminal. Lo que más le llamó la atención no fue el modelo ni las herramientas, sino la ingeniería de contexto: la capa que decide qué información tiene delante el agente en cada turno.
OpenDev trata la ventana de contexto como un recurso finito que se agota, igual que la memoria en un sistema operativo.
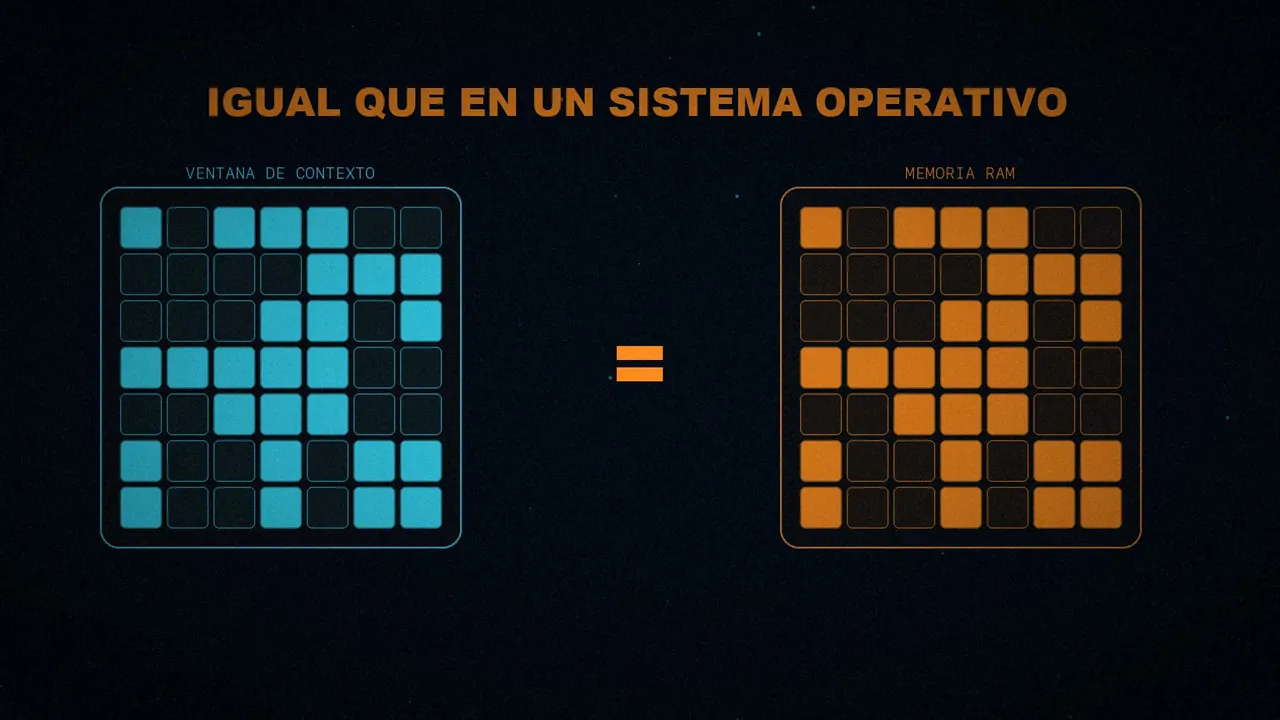
Y de ahí sale su idea central: cuando un agente falla, la mayoría de las veces no es porque razone mal, sino por su contexto. Seguro que te suenan estos tres síntomas: el modelo olvidó sus instrucciones, la ventana se llenó de salidas larguísimas de comandos o el agente dejó de seguir su prompt de sistema tras veinte llamadas a herramientas.
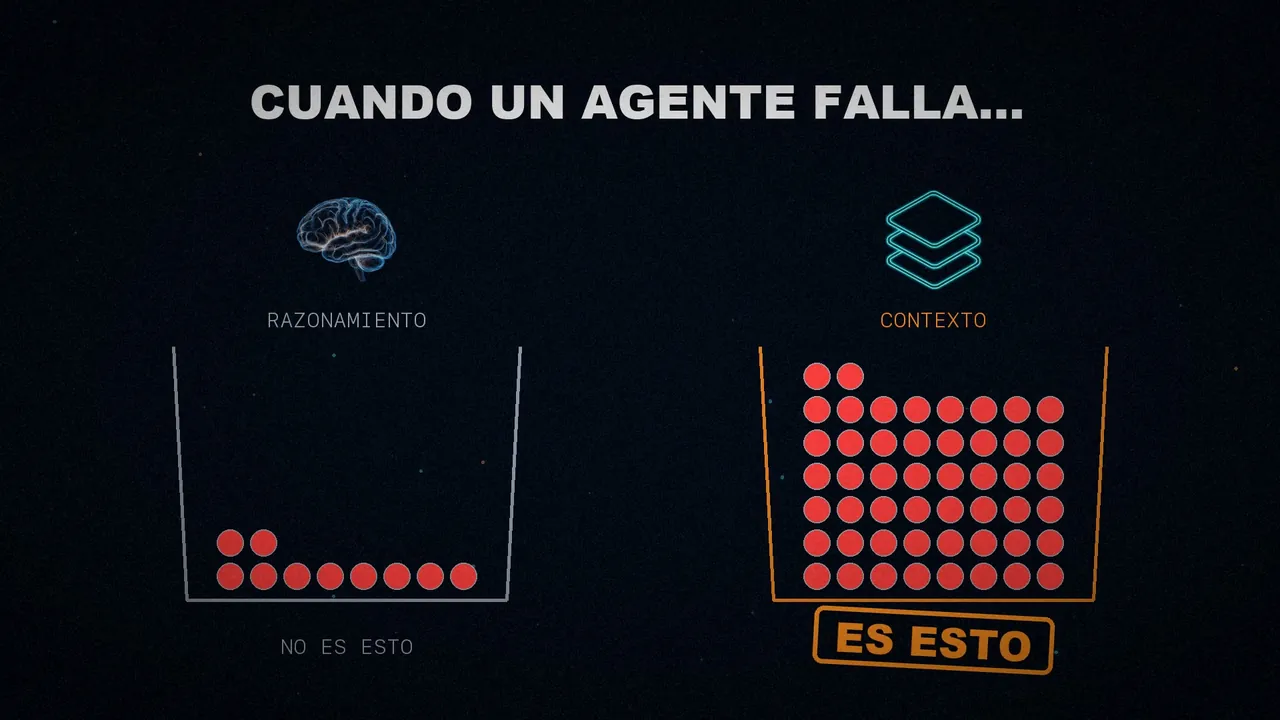
Para el autor, esta es la capa que separa una demo de algo que aguanta en producción.
Lo que ve un agente
La verdad incómoda es esta: un modelo de lenguaje ve exactamente lo que le pones delante, y nada más. Y un agente lee archivos, busca y ejecuta comandos. Todos esos resultados acaban en la misma ventana, de tamaño fijo.
Si le pones cifras, se llena enseguida. Una sola tanda de tests puede devolver una salida de 30.000 tokens. Suma unas cuantas lecturas de archivos grandes y el contexto ya está lleno.
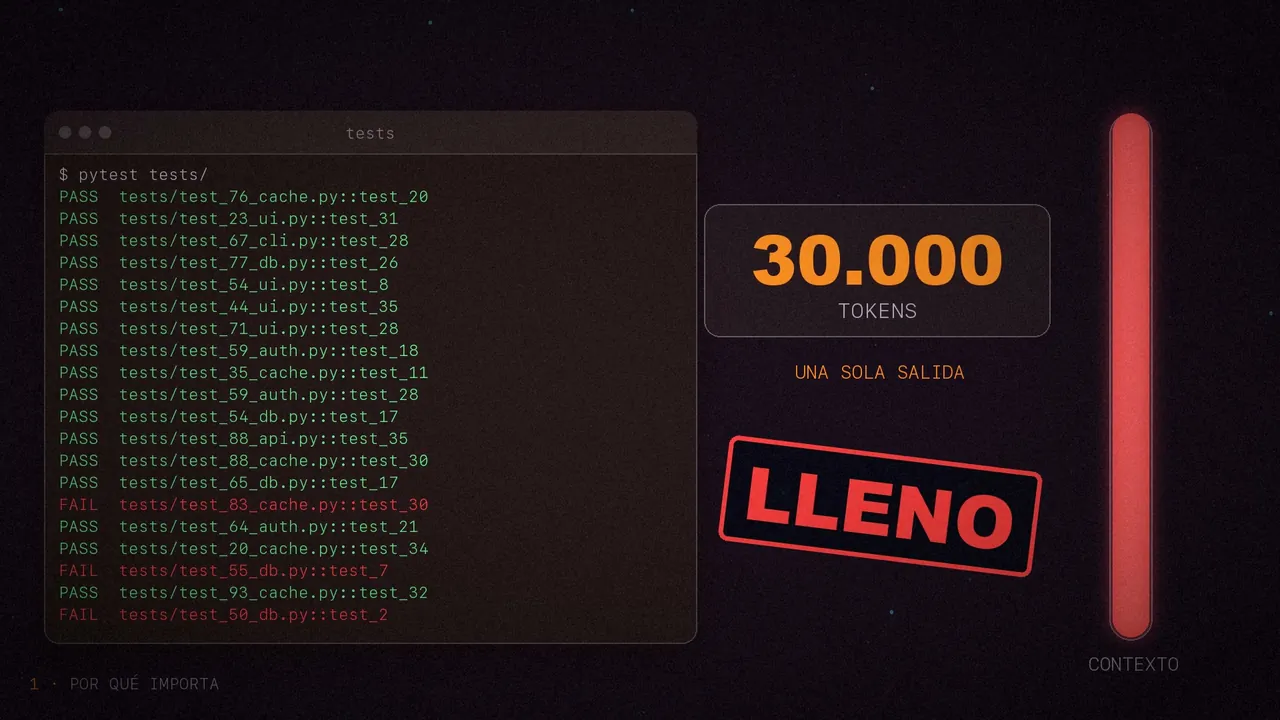
A partir de ahí, el agente deja de ser eficaz. No porque se haya vuelto más tonto: lo importante ha quedado enterrado bajo el ruido.
Un presupuesto, no un registro
Cobus lo resume en una frase: el contexto es un presupuesto, no un registro (a budget, not a log). Los tokens que se van en una salida vieja ya no están disponibles para la pregunta real del usuario.
Un apunte: el artículo se la atribuye al paper, pero lo que el paper dice es «Treat context as a budget, not a buffer». La idea es la misma; la frase con «registro» es de Cobus.
Cinco etapas en vez de todo o nada
Esta es la pieza central. Lo habitual es un sistema de todo o nada: cuando el contexto se llena, se hace un resumen de emergencia. OpenDev, en cambio, vigila la presión sin parar y aplica estrategias cada vez más agresivas: un flujo de compactación adaptativa con cinco escalones.
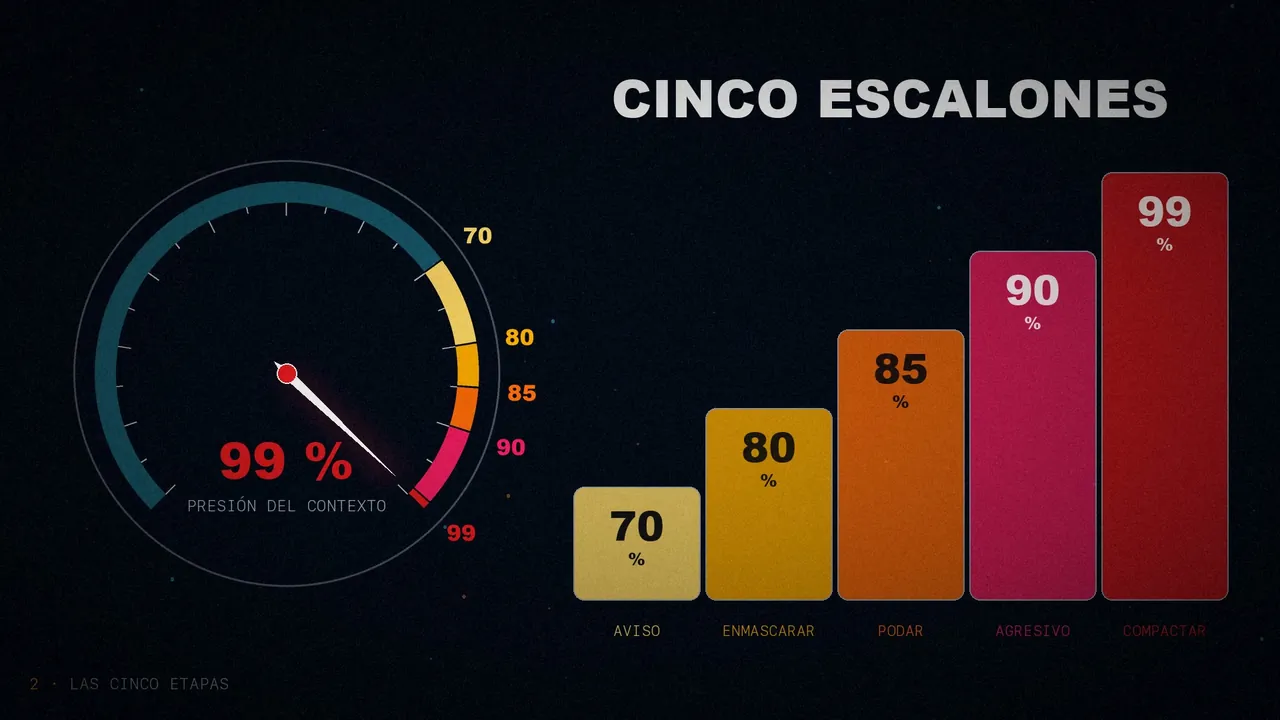
- 70 %, aviso. Todavía no se toca nada. El sistema apunta la presión y empieza a seguir la tendencia.
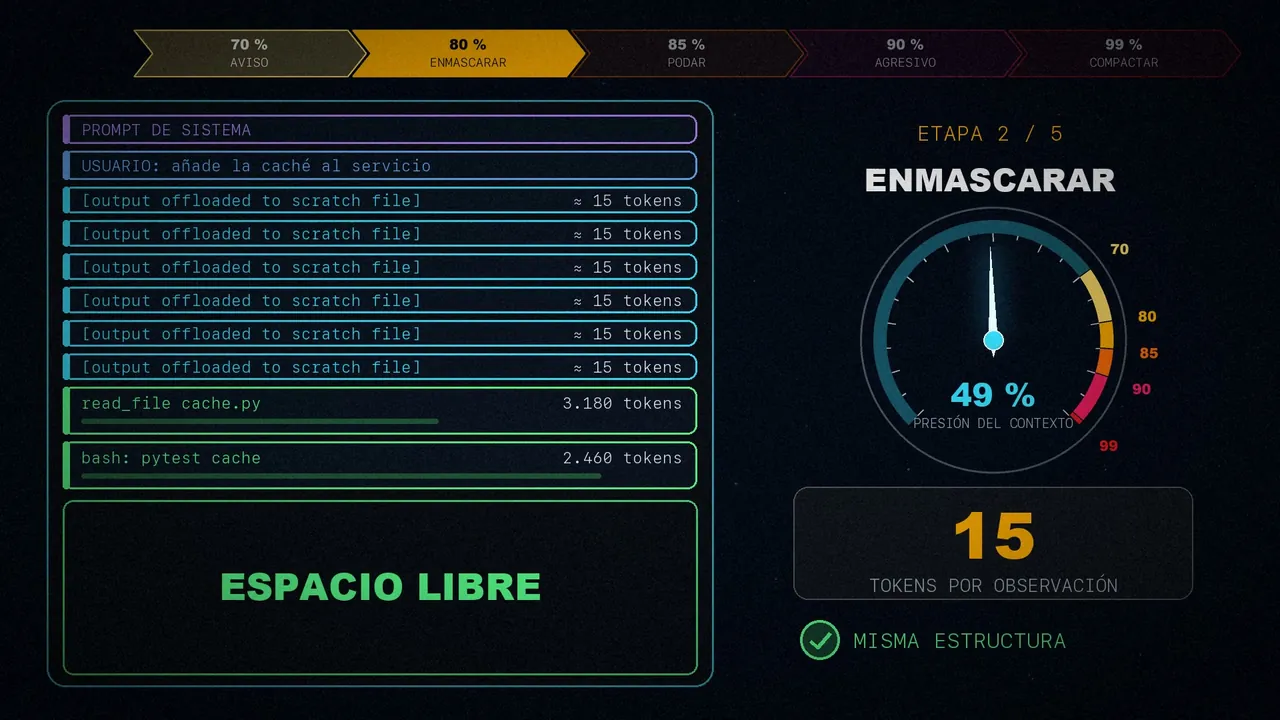
- 80 %, enmascarar observaciones. Los resultados antiguos de las herramientas se sustituyen por punteros de referencia muy compactos, de unos 15 tokens cada uno, como
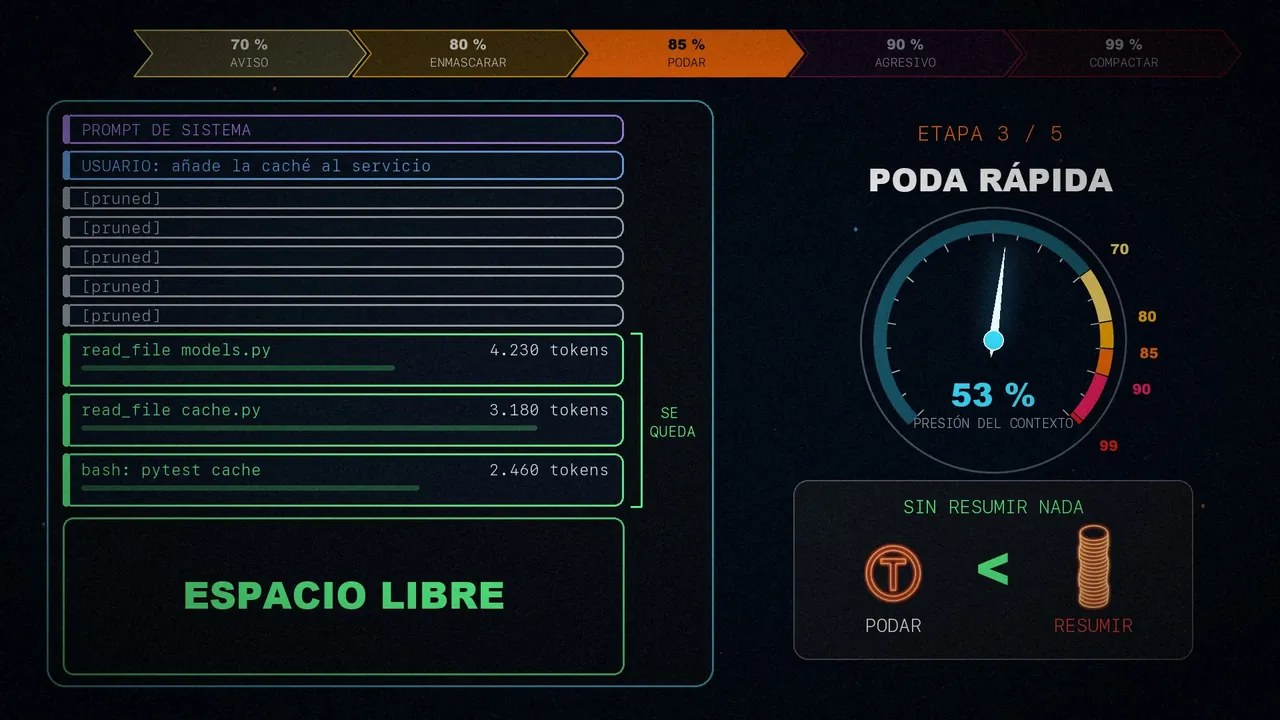
[output offloaded to scratch file]. La conversación mantiene su estructura, pero pesa muchísimo menos. - 85 %, poda rápida. Se borran las salidas viejas que quedan fuera de la ventana de lo reciente, sin resumir nada. Por eso sale más barato que pedirle un resumen al modelo.
- 90 %, enmascarado agresivo. La ventana de lo que se conserva se encoge, hasta quedarse solo con las salidas más recientes.
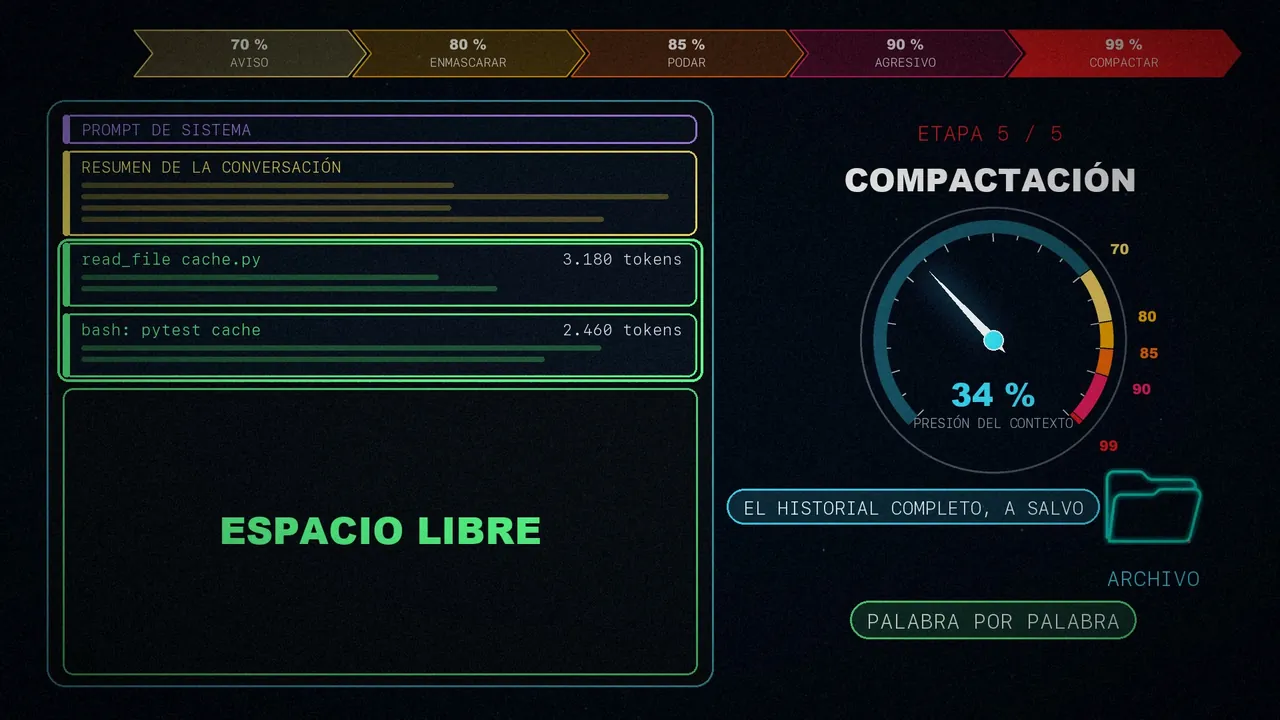
- 99 %, compactación completa. Según el paper, primero guarda todo el historial en un archivo. Ahora sí, el modelo resume la parte central de la conversación, y lo último se conserva palabra por palabra.
Una aclaración si vas al original: uso la numeración del artículo, del 1 al 5. El paper numera esas mismas etapas como 1, 2, 2.5, 3 y 4.
Lo barato, primero
La clave es esta: las estrategias baratas suelen recuperar espacio suficiente. Así te ahorras el coste de un resumen y la información que siempre se pierde con él.
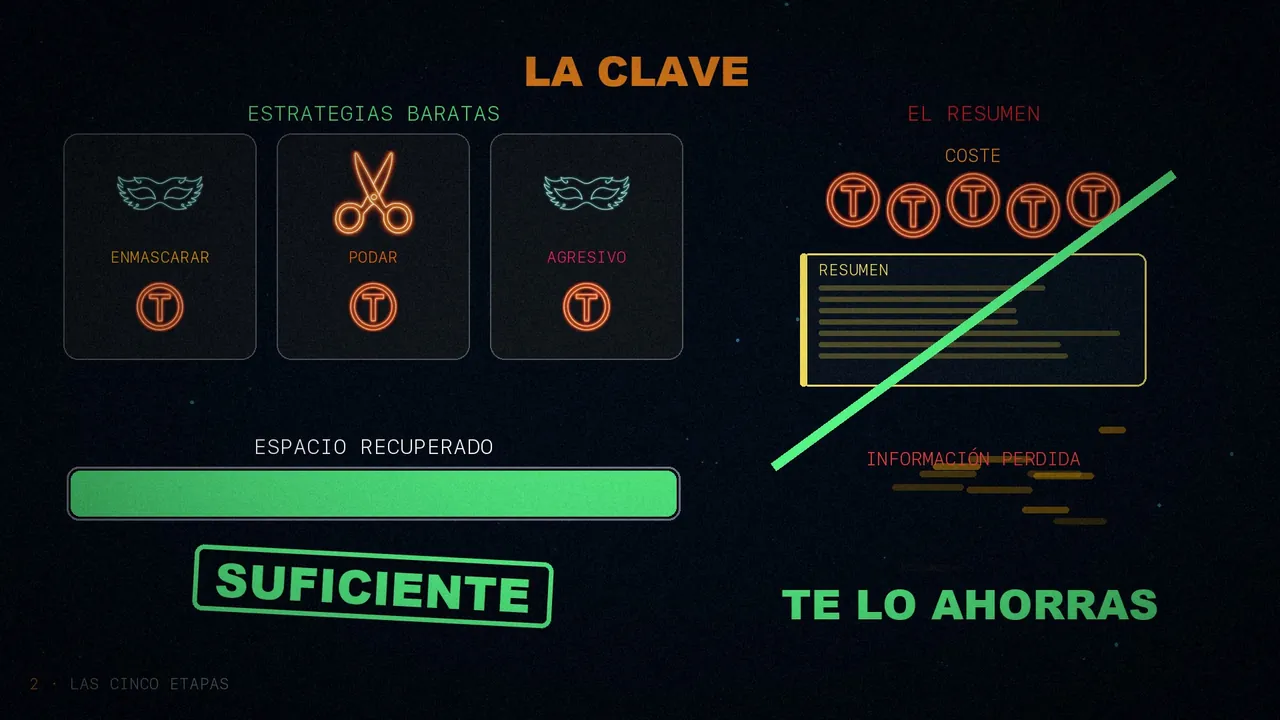
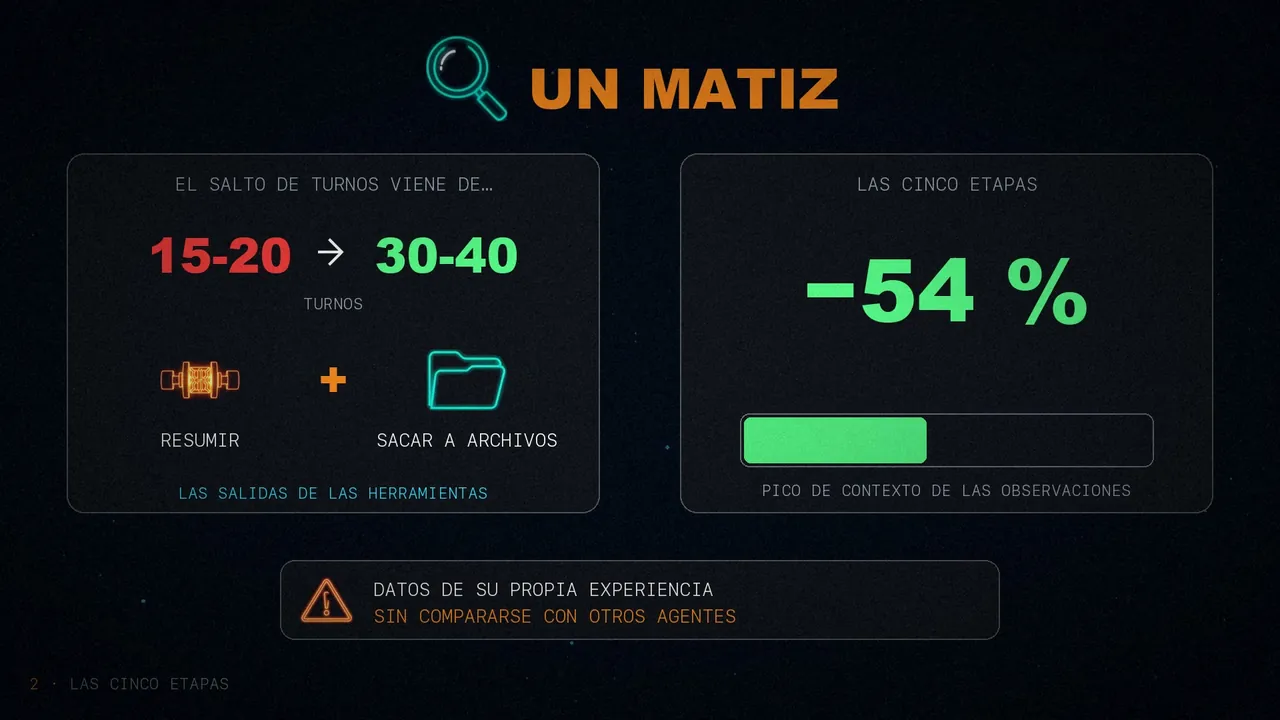
Solo con la segunda etapa, cada observación baja de miles de tokens a unos quince. Y el artículo da este resultado: antes, las sesiones se desbordaban a los 15 o 20 turnos; ahora aguantan de 30 a 40, sin que la compactación llegue ni a activarse.
Un matiz del paper
Aquí el artículo y su fuente no dicen exactamente lo mismo, así que lo fui a comprobar. El paper atribuye ese salto de turnos, sobre todo, a resumir las salidas de las herramientas y sacar a archivos las más grandes (las de más de 8.000 caracteres), no al flujo de cinco etapas.
De las cinco etapas da otra cifra: reducen un 54 % el pico de contexto que ocupan las observaciones. Y son datos de su propia experiencia, sin compararse con otros agentes, así que conviene leerlos con esa cautela.
También verás en el artículo «más de 40 turnos» en el resumen inicial. En su cuerpo y en el paper son de 30 a 40.
El prompt de sistema se apaga
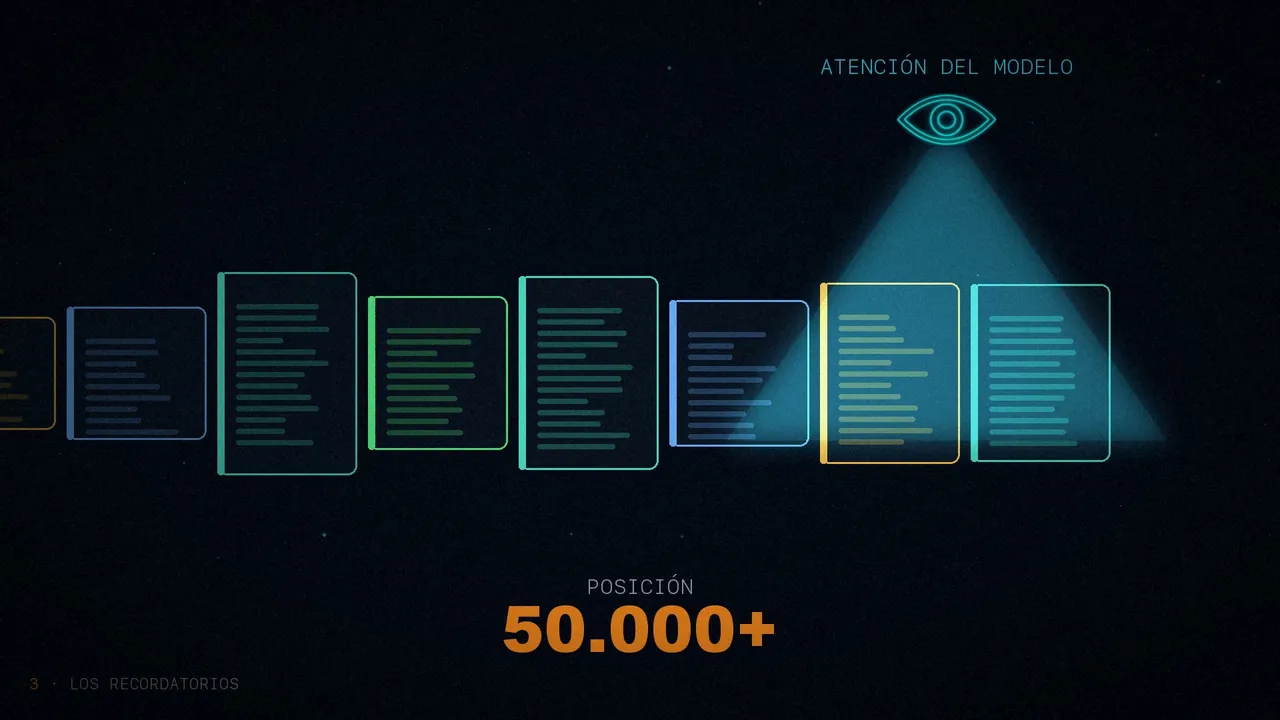
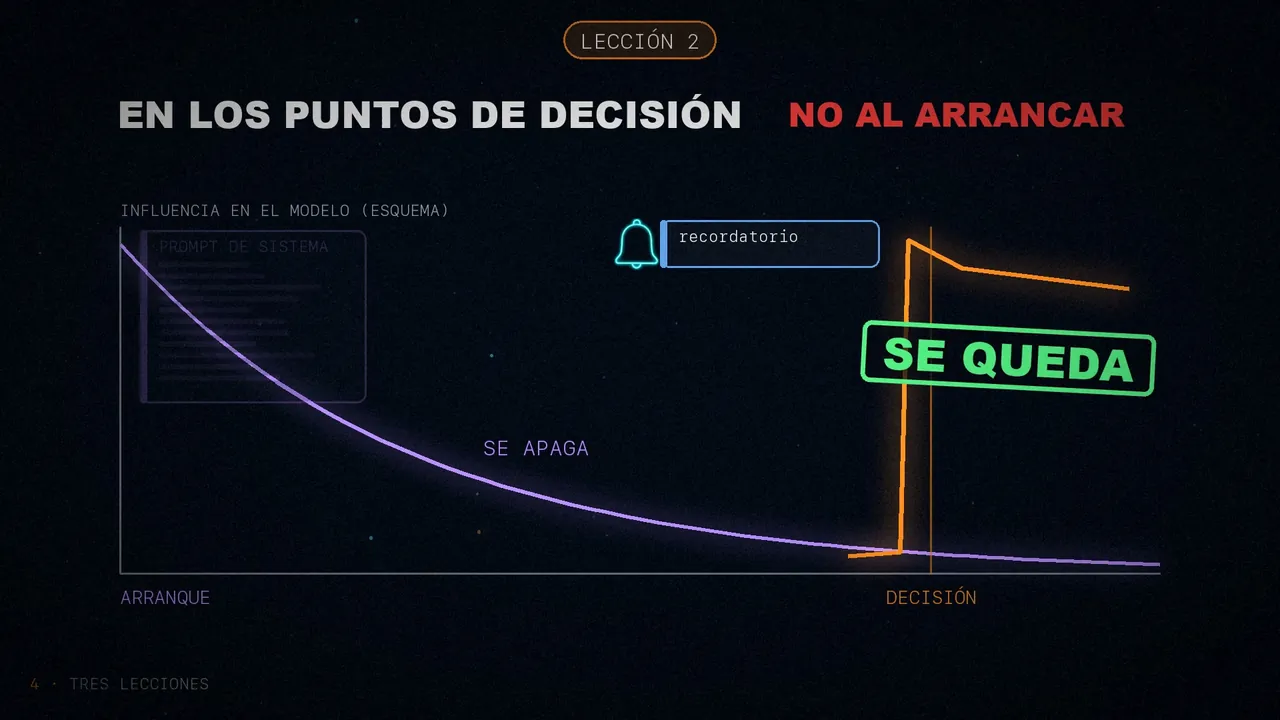
Esta es la parte que más sorprendió al autor. A partir de unas 15 llamadas a herramientas, el modelo deja de seguir su prompt de sistema, y ocurre una y otra vez. Las instrucciones siguen ahí, en la ventana. Simplemente, ya no les hace caso.
El ejemplo del paper: le dices que ejecute siempre los tests después de editar. Al principio lo hace. Pero pasadas unas veinte llamadas, lo deja de hacer sin avisar.
Cobus lo explica como un problema de distancia: el prompt de sistema está en la posición cero, y la atención del modelo se ha ido a los mensajes recientes, más allá de la 50.000. Esas dos posiciones son suyas, no salen en el paper.
Recordatorios con rol de usuario
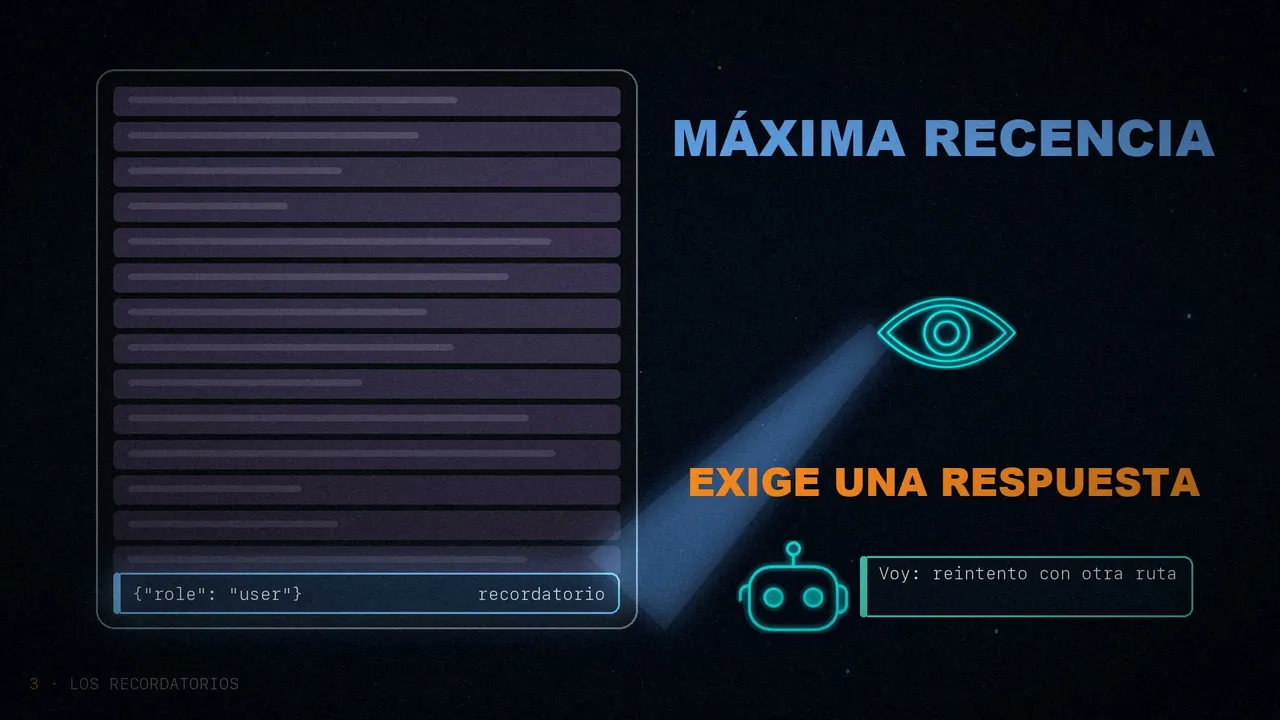
¿Cómo se arregla? Con recordatorios que se disparan por eventos: mensajes cortos que se inyectan justo en el punto de decisión, donde el agente se equivocaría. Según el paper, tiene ocho detectores de eventos; por ejemplo, cuando falla una herramienta y no reintenta, o tras cinco lecturas seguidas sin avanzar. Y unos contadores limitan cuántas veces salta cada recordatorio.
Y aquí está el truco: no van como mensajes de sistema, sino con role: user. Tras cuarenta turnos, otro aviso del sistema se confunde con ese fondo que el modelo ya ha olvidado a medias. En cambio, lo que escribe el usuario aparece como lo más reciente de todo, y el modelo lo trata como algo que exige una respuesta.
Tres lecciones
De todas las lecciones del paper, el autor se queda con tres:
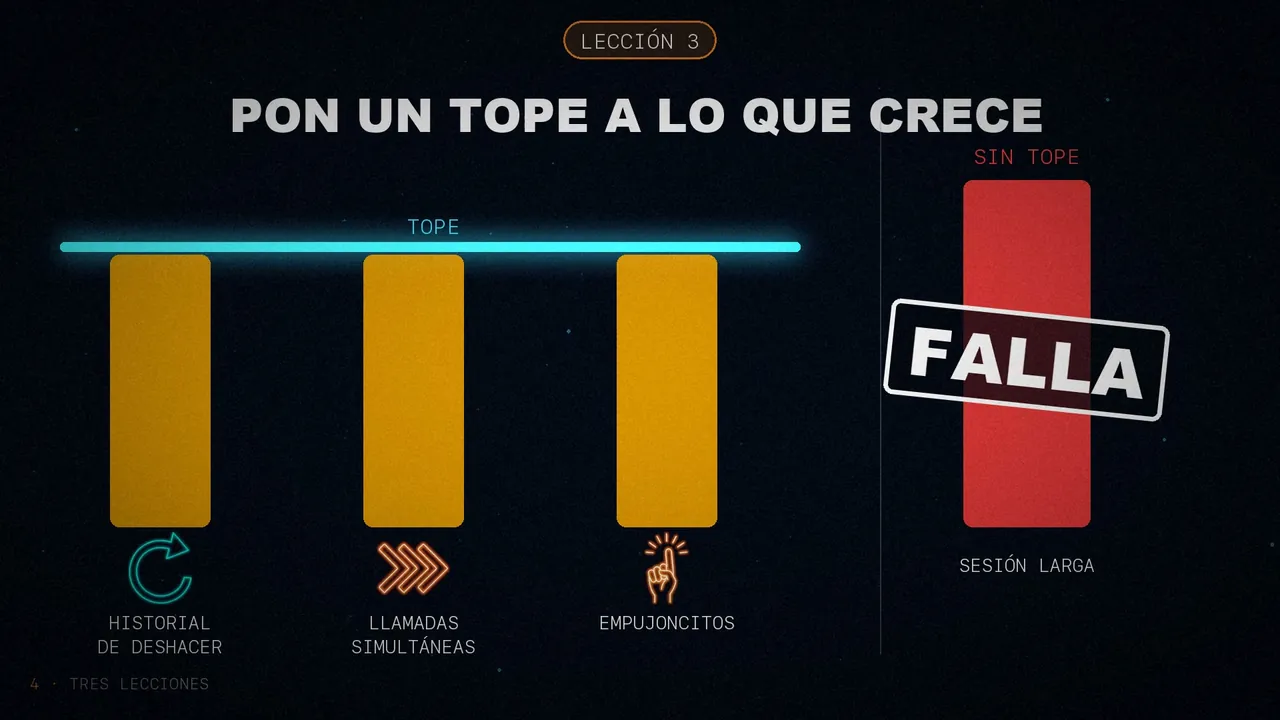
Cada mensaje compite por un espacio finito. Añadir es gastar, no apuntar. Vigila qué está consumiendo y si todavía compensa.
Un prompt de sistema largo se va apagando. Un recordatorio corto, justo antes de decidir, se queda.
El historial de deshacer, las llamadas simultáneas, los avisos de comportamiento. Sin un límite, las sesiones largas acaban fallando.
En resumen
Trata el contexto como un presupuesto, comprime primero lo barato, recuerda las reglas justo cuando hacen falta y ponle tope a lo que crece.
Tu agente es tan bueno como su contexto.
¿Qué es lo que más memoria le come a tu agente?
Fuentes
- «Context Engineering Is The Real Product», de Cobus Greyling, 14 de abril de 2026.
- El informe técnico de OpenDev, con el que he contrastado las cifras: arXiv 2603.05344. Lo explico entero en este otro post.
- El vídeo, en mis tres canales: español, inglés y portugués.