A camada que importa
Cobus parte de uma leitura: o relatório técnico do OpenDev, apresentado como o primeiro trabalho completo sobre um agente de programação de código aberto que vive no terminal. O que mais chamou a atenção não foi o modelo nem as ferramentas, e sim a engenharia de contexto: a camada que decide quais informações o agente tem diante de si a cada turno.
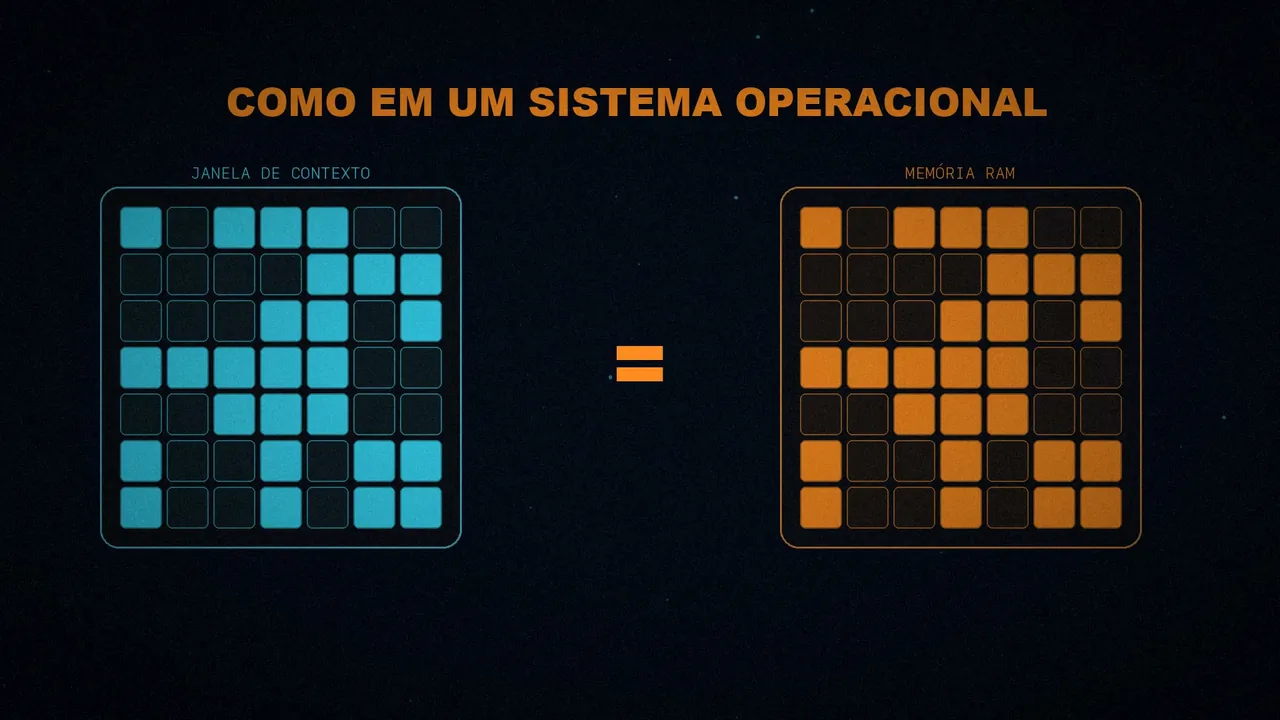
O OpenDev trata a janela de contexto como um recurso finito que se esgota, igual à memória em um sistema operacional.
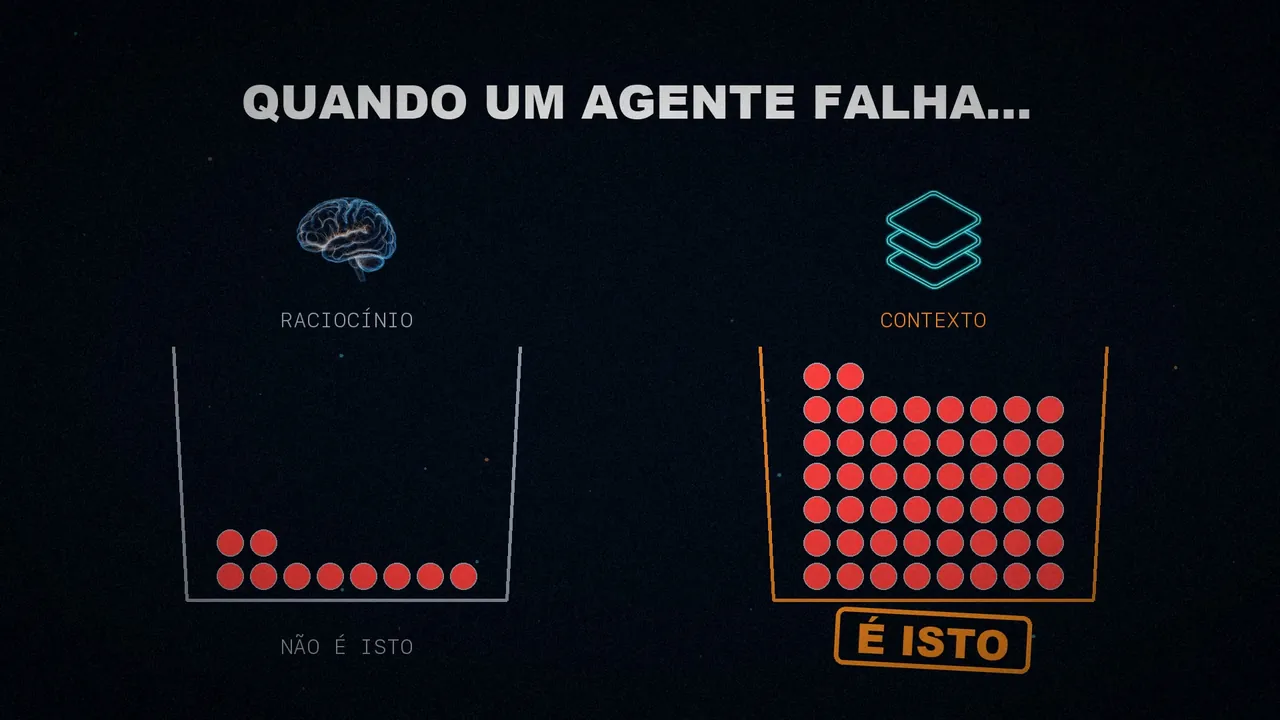
Daí vem a ideia central: quando um agente falha, na maioria das vezes não é por raciocinar mal, é por causa do contexto. Estes três sintomas devem soar familiares: o modelo esqueceu as instruções, a janela encheu de saídas enormes de comandos ou o agente deixou de seguir o prompt de sistema depois de vinte chamadas a ferramentas.
Para o autor, esta é a camada que separa uma demo de algo que aguenta em produção.
O que um agente vê
A verdade incômoda é esta: um modelo de linguagem vê exatamente o que você coloca na frente dele, e nada mais. E um agente lê arquivos, busca e executa comandos. Todos esses resultados acabam na mesma janela, de tamanho fixo.
Com números, ela enche rápido. Uma única rodada de testes pode devolver uma saída de 30.000 tokens. Some algumas leituras de arquivos grandes e o contexto já está cheio.
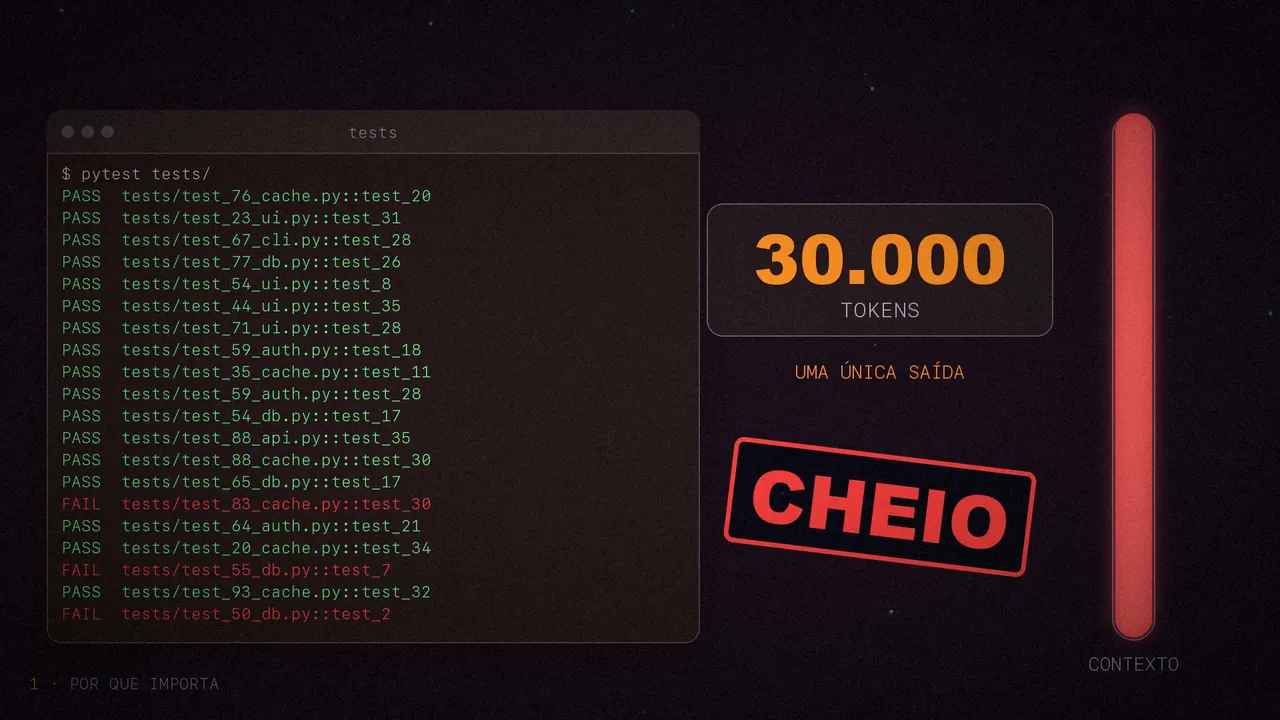
A partir daí, o agente deixa de ser eficaz. Não porque ficou mais burro: é que o importante ficou enterrado sob o ruído.
Um orçamento, não um registro
Cobus resume em uma frase: o contexto é um orçamento, não um registro (a budget, not a log). Os tokens gastos em uma saída velha já não estão disponíveis para a pergunta real do usuário.
Uma observação: o artigo atribui a frase ao paper, mas o que o paper diz é "Treat context as a budget, not a buffer". A ideia é a mesma; a frase com "registro" é de Cobus.
Cinco etapas em vez de tudo ou nada
Esta é a peça central. O habitual é um sistema de tudo ou nada: quando o contexto enche, faz-se um resumo de emergência. O OpenDev, em vez disso, vigia a pressão sem parar e aplica estratégias cada vez mais agressivas: um fluxo de compactação adaptativa com cinco degraus.
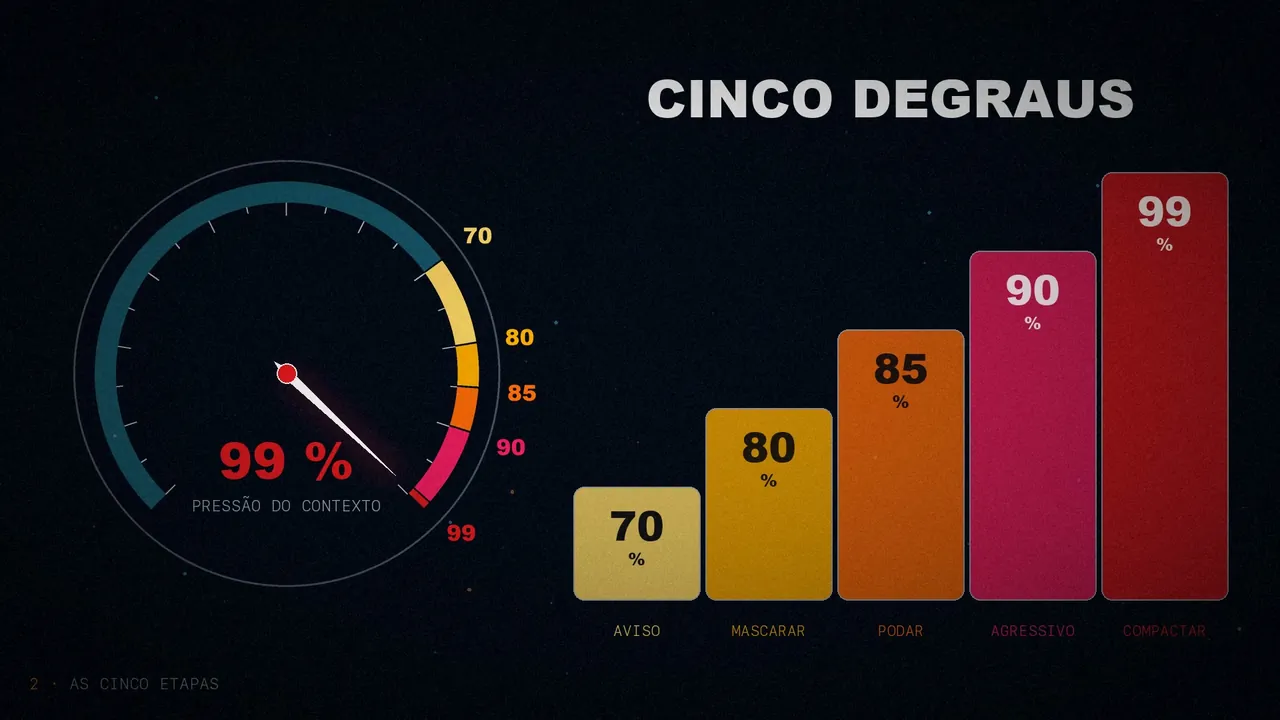
- 70%, aviso. Ainda não se mexe em nada. O sistema anota a pressão e começa a acompanhar a tendência.
- 80%, mascarar observações. Os resultados antigos das ferramentas são substituídos por ponteiros de referência muito compactos, de uns 15 tokens cada, como
[output offloaded to scratch file]. A conversa mantém a estrutura, mas pesa muito menos. - 85%, poda rápida. As saídas velhas que ficam fora da janela do recente são apagadas, sem resumir nada. Por isso sai mais barato que pedir um resumo ao modelo.
- 90%, mascaramento agressivo. A janela do que se conserva encolhe, até ficar só com as saídas mais recentes.
- 99%, compactação completa. Segundo o paper, primeiro ele salva todo o histórico em um arquivo. Agora sim, o modelo resume a parte central da conversa, e o final é conservado palavra por palavra.
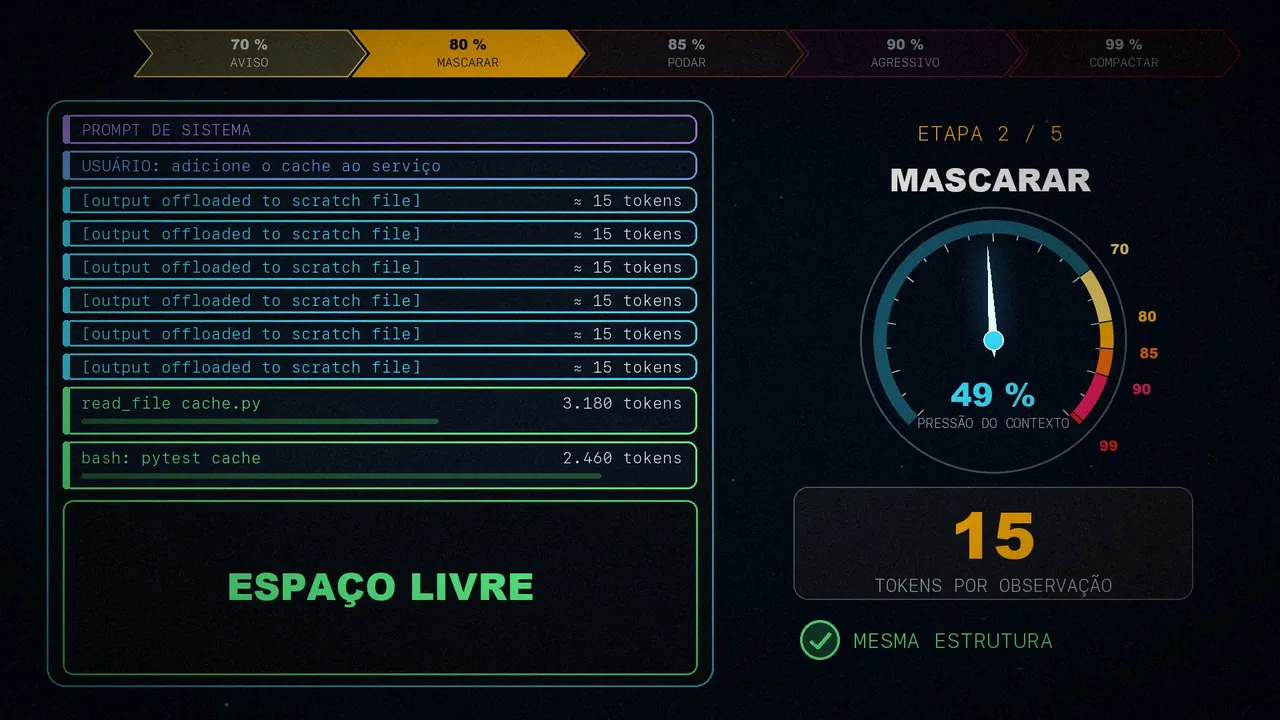
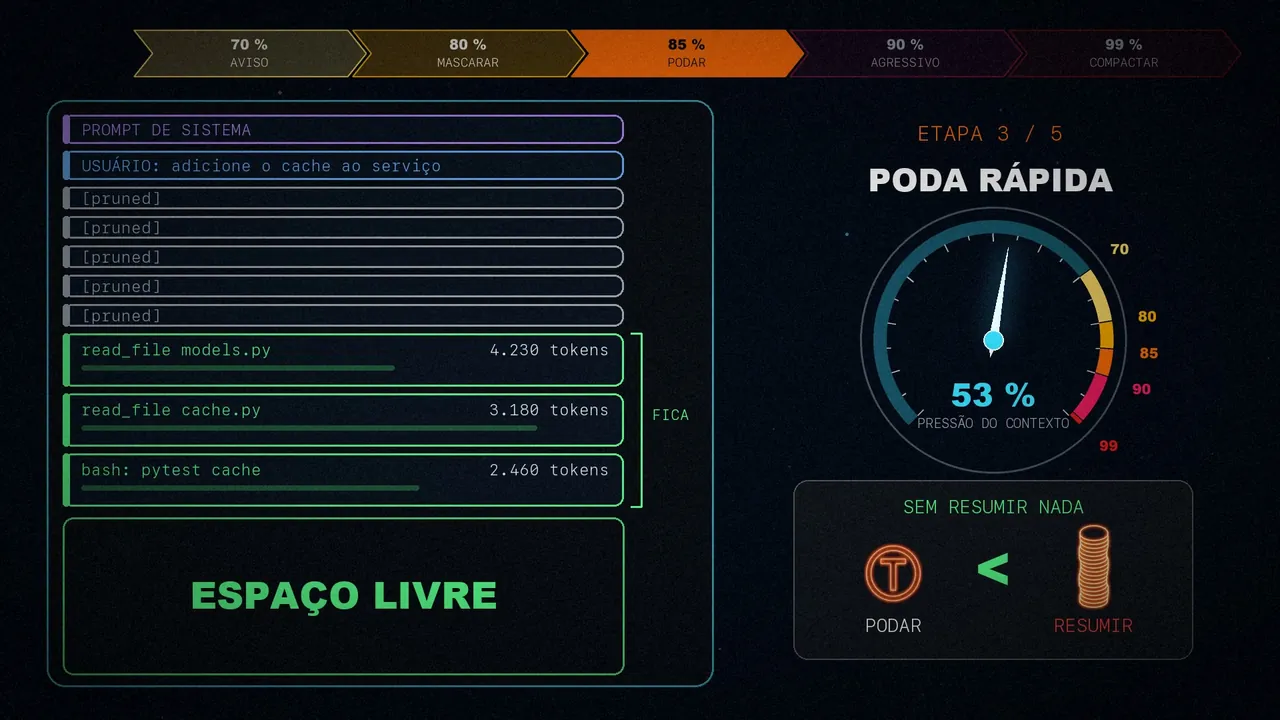
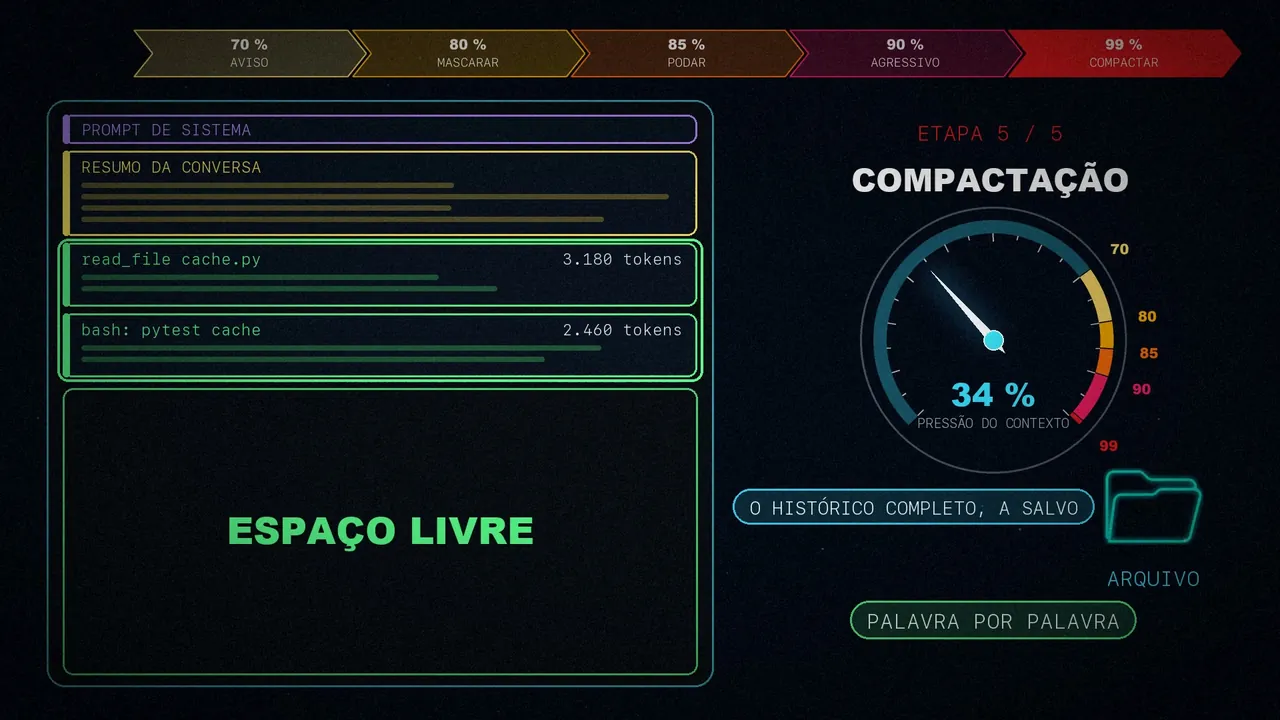
Um esclarecimento, se você for ao original: uso a numeração do artigo, de 1 a 5. O paper numera essas mesmas etapas como 1, 2, 2.5, 3 e 4.
O barato primeiro
A chave é esta: as estratégias baratas costumam recuperar espaço suficiente. Assim, você economiza o custo de um resumo e a informação que sempre se perde com ele.
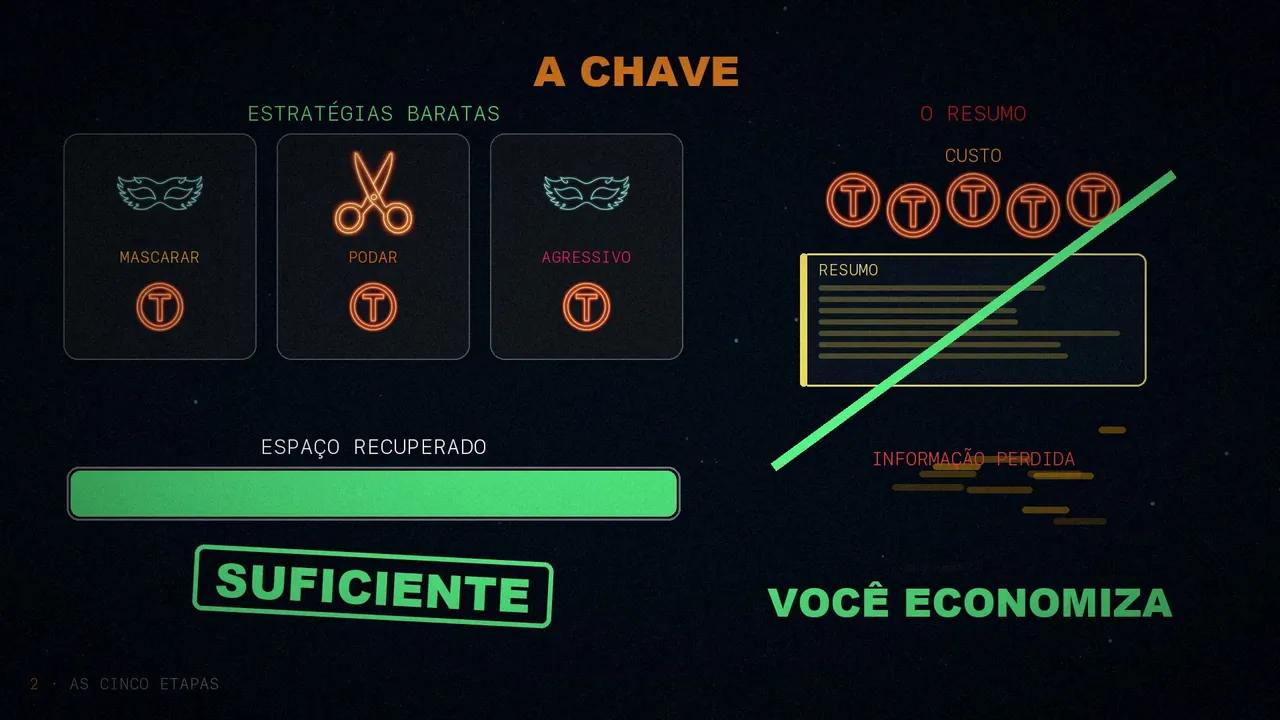
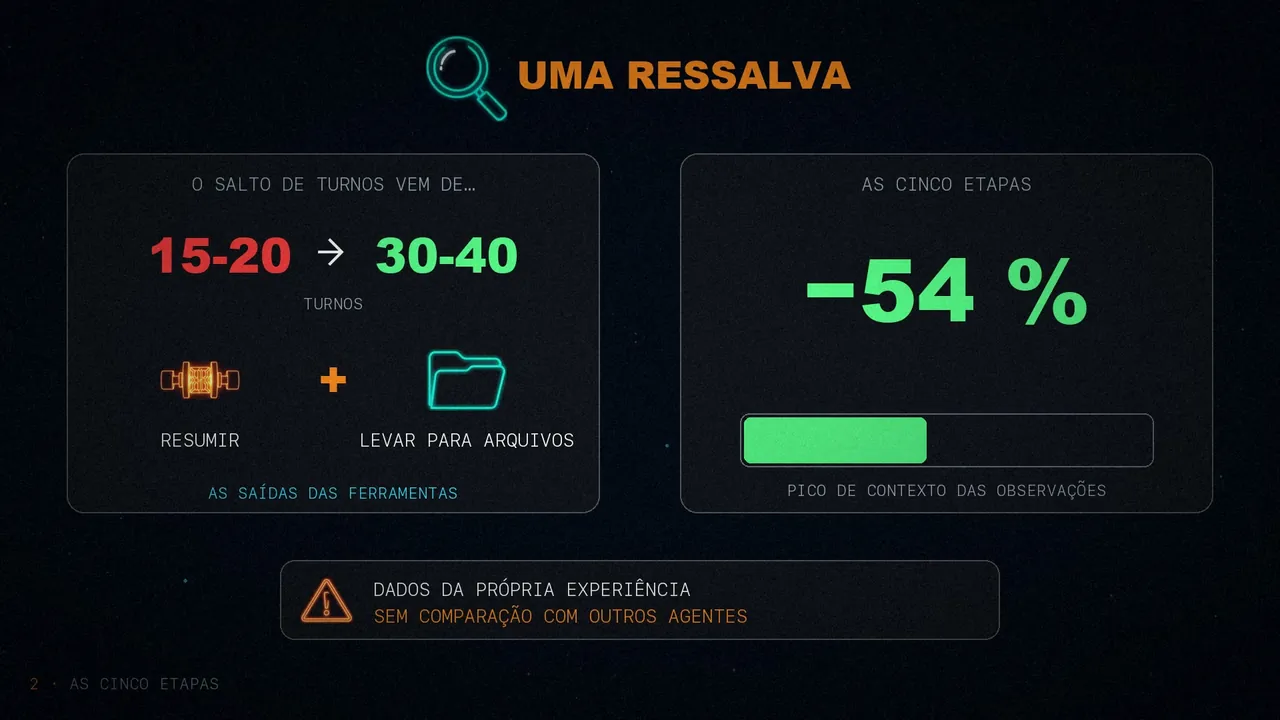
Só com a segunda etapa, cada observação cai de milhares de tokens para uns quinze. E o artigo dá este resultado: antes, as sessões transbordavam com 15 ou 20 turnos; agora aguentam de 30 a 40, sem a compactação ser ativada.
Uma ressalva do paper
Aqui o artigo e a fonte não dizem exatamente o mesmo, então fui conferir. O paper atribui esse salto de turnos, principalmente, a resumir as saídas das ferramentas e levar as maiores para arquivos (as de mais de 8.000 caracteres), não ao fluxo de cinco etapas.
Das cinco etapas ele dá outro número: reduzem em 54% o pico de contexto usado pelas observações. E são dados da própria experiência, sem comparação com outros agentes, então vale ler com essa cautela.
Você também vai ver "mais de 40 turnos" no resumo inicial do artigo. No corpo do texto e no paper, são de 30 a 40.
O prompt de sistema se apaga
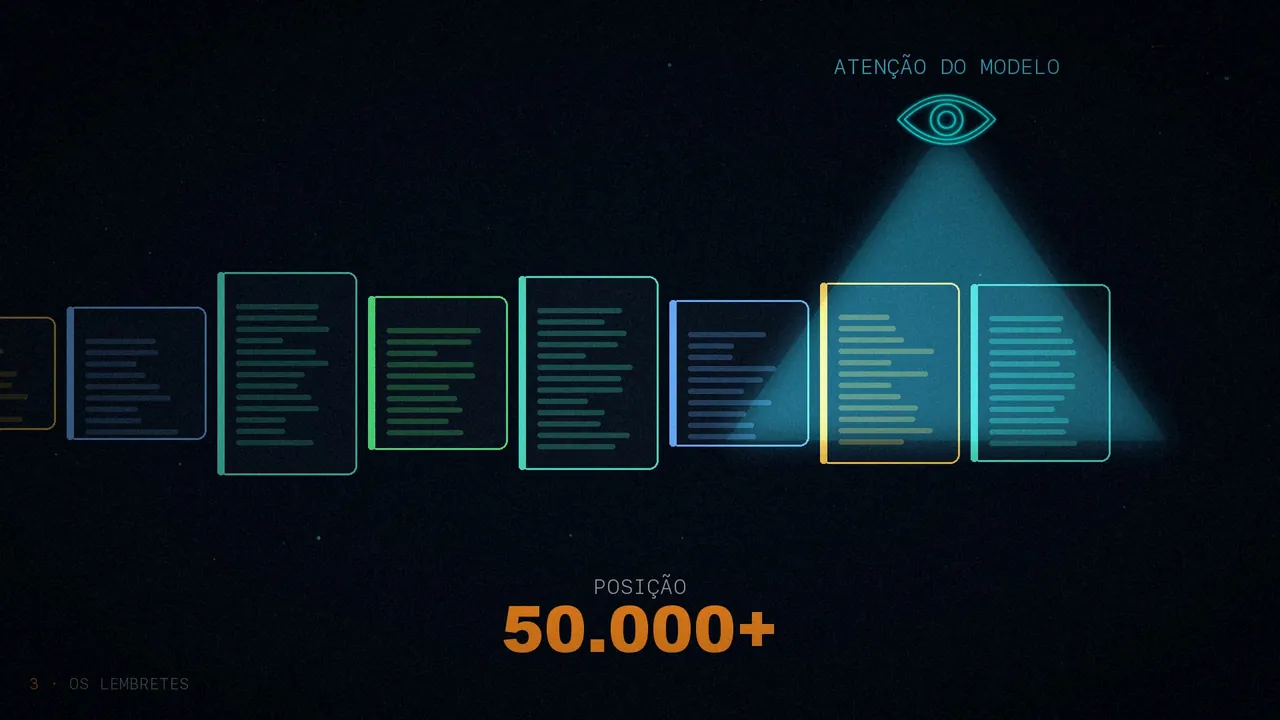
Esta é a parte que mais surpreendeu o autor. A partir de umas 15 chamadas a ferramentas, o modelo deixa de seguir o prompt de sistema, e isso acontece repetidamente. As instruções continuam lá, na janela. Ele simplesmente já não dá atenção a elas.
O exemplo do paper: você pede que ele sempre execute os testes depois de editar. No começo, ele faz. Mas passadas umas vinte chamadas, para de fazer sem avisar.
Cobus explica isso como um problema de distância: o prompt de sistema está na posição zero, e a atenção do modelo foi para as mensagens recentes, além da 50.000. Essas duas posições vêm do artigo, não saem do paper.
Lembretes com papel de usuário
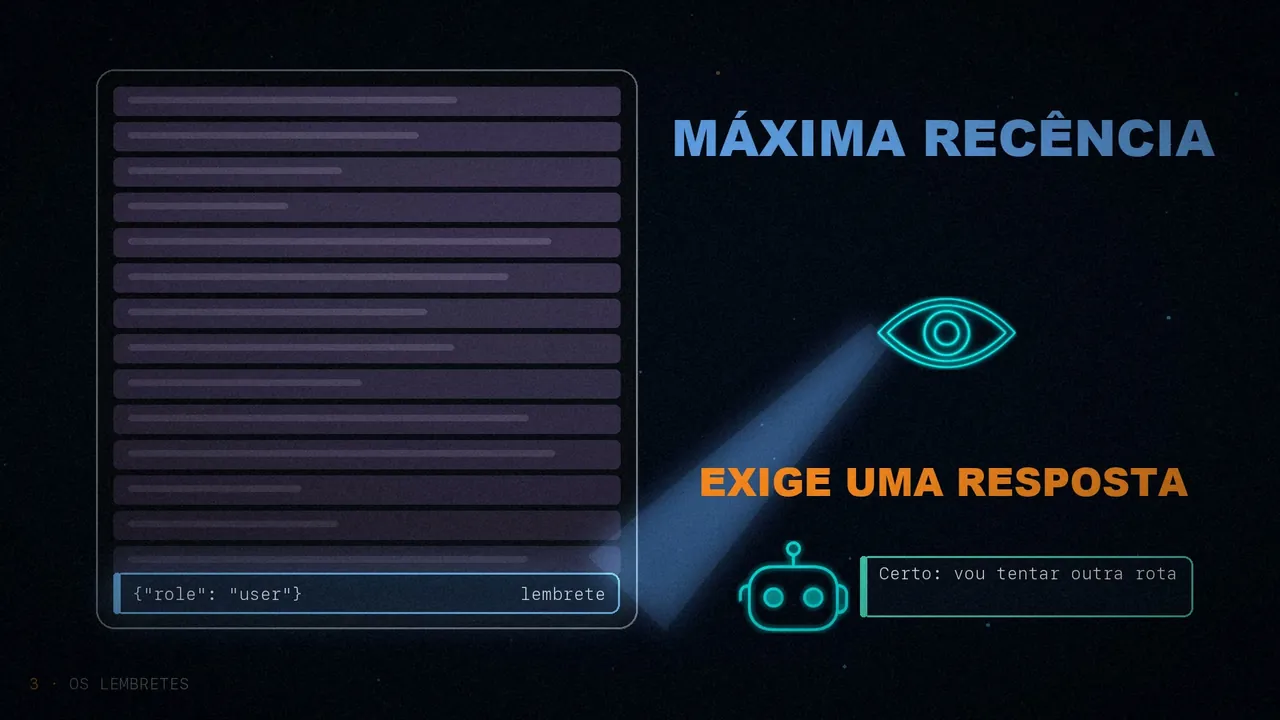
Como se resolve? Com lembretes disparados por eventos: mensagens curtas injetadas bem no ponto de decisão, onde o agente erraria. Segundo o paper, são oito detectores de eventos; por exemplo, quando uma ferramenta falha e ele não repete, ou depois de cinco leituras seguidas sem avançar. E contadores limitam quantas vezes cada lembrete dispara.
E aqui está o truque: eles não vão como mensagens de sistema, e sim com role: user. Depois de quarenta turnos, outro aviso do sistema se confunde com o fundo que o modelo já esqueceu pela metade. Já o que o usuário escreve aparece como a coisa mais recente de todas, e o modelo trata isso como algo que exige resposta.
Três lições
De todas as lições do paper, o autor destaca três:
Cada mensagem disputa um espaço finito. Adicionar é gastar, não anotar. Observe o que está consumindo e se ainda compensa.
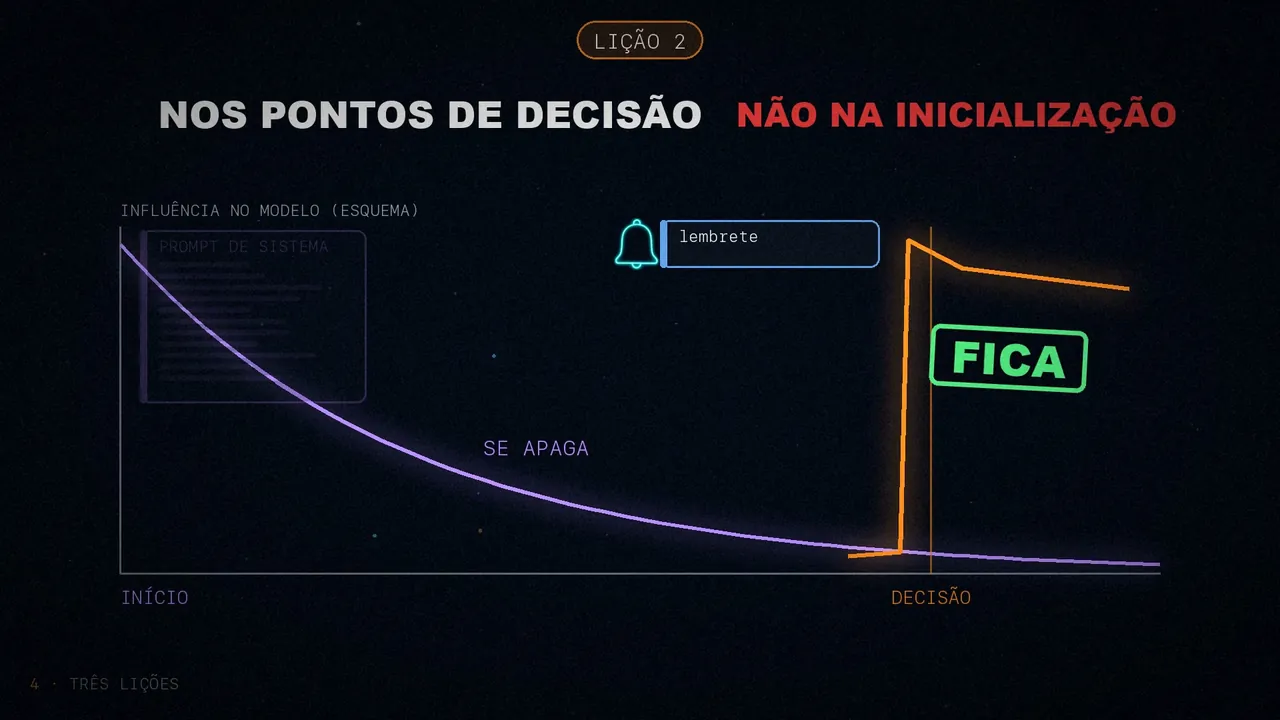
Um prompt de sistema longo vai se apagando. Um lembrete curto, logo antes de decidir, fica.
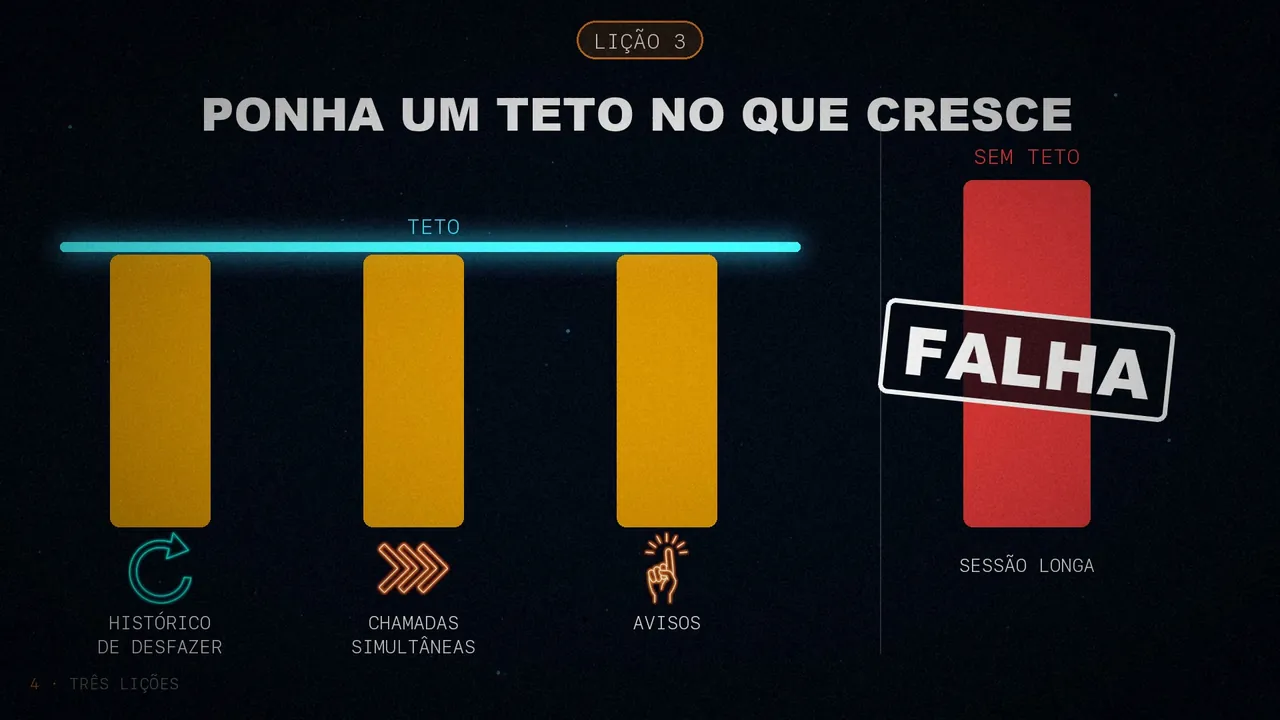
O histórico de desfazer, as chamadas simultâneas, os avisos de comportamento. Sem um limite, as sessões longas acabam falhando.
Em resumo
Trate o contexto como um orçamento, comprima primeiro o barato, lembre as regras bem quando são necessárias e coloque um teto no que cresce.
Seu agente é tão bom quanto o contexto dele.
O que mais consome memória no seu agente?
Fontes
- "Context Engineering Is The Real Product", de Cobus Greyling, 14 de abril de 2026.
- O relatório técnico do OpenDev, com o qual conferi os números: arXiv 2603.05344. Eu o explico por inteiro neste outro post.
- O vídeo, nos meus três canais: português, espanhol e inglês.