Por qué la terminal
Durante años, los asistentes de código vivieron dentro del editor, como copilotos que sugerían líneas y que había que vigilar de cerca. Ahora el cambio va hacia la terminal, y Claude Code abrió el camino. Tiene sentido: la terminal es el corazón del desarrollo. Ahí viven el control de versiones, la compilación, las sesiones remotas por SSH y los servidores sin pantalla.
El impacto ya es enorme. GitHub Copilot supera los quince millones de desarrolladores, y todos los grandes laboratorios tienen su propio agente de terminal. Pero hacerlo bien no es fácil: en Terminal-Bench, incluso los modelos punteros resuelven menos del 65 % de las tareas, y en LongCLI-Bench, con tareas largas, menos del 20 %.
El paper resume el problema en tres retos:
Las sesiones largas desbordan la ventana de contexto del modelo.
Un agente que puede ejecutar cualquier comando también puede destrozarlo todo.
Cada capacidad que le añades ocupa sitio en el prompt.
Andamiaje, arnés y un sistema compuesto
Para resolverlos, el paper separa dos fases. El andamiaje (scaffolding) monta el agente antes del primer mensaje: el prompt de sistema, los esquemas de las herramientas y el registro de subagentes. El arnés (harness) lo orquesta todo después, mientras trabaja: lanza las herramientas, gestiona el contexto y hace cumplir la seguridad.
¿Y por qué un paper así? Porque casi nadie cuenta cómo están hechos estos agentes. Hay frameworks pensados para benchmarks, como SWE-Agent; otros funcionan en el navegador, como OpenHands; y agentes de terminal como Aider, Goose u OpenCode no publican informes técnicos. Claude Code, tampoco, y además es cerrado.
La idea central es que OpenDev es un sistema de inteligencia artificial compuesto. No es un único modelo, sino un conjunto de agentes y flujos de trabajo, y cada uno se conecta al modelo que elija el usuario. Así, cambiar de proveedor o abaratar costes es cuestión de configuración, no de código, y el agente mejora en cuanto salen modelos mejores.
Tres principios guían el diseño:
- Separar responsabilidades: cada decisión (el modelo, el contexto, la seguridad, las herramientas) se configura y se cambia sin tocar las demás.
- Degradarse con elegancia: seguir funcionando cuando se acaban los tokens, las iteraciones o la red.
- Transparencia antes que magia: el desarrollador puede ver y corregir todo lo que hace el agente, desde cada llamada a una herramienta hasta cada compactación.
Cuatro capas y cinco de seguridad
OpenDev se organiza en cuatro capas: arriba, la de entrada, con una interfaz de terminal y otra web; debajo, el agente, que razona; luego, las herramientas y el contexto; y al fondo, la persistencia, que lo guarda todo. Cada petición las recorre en orden, de arriba abajo.
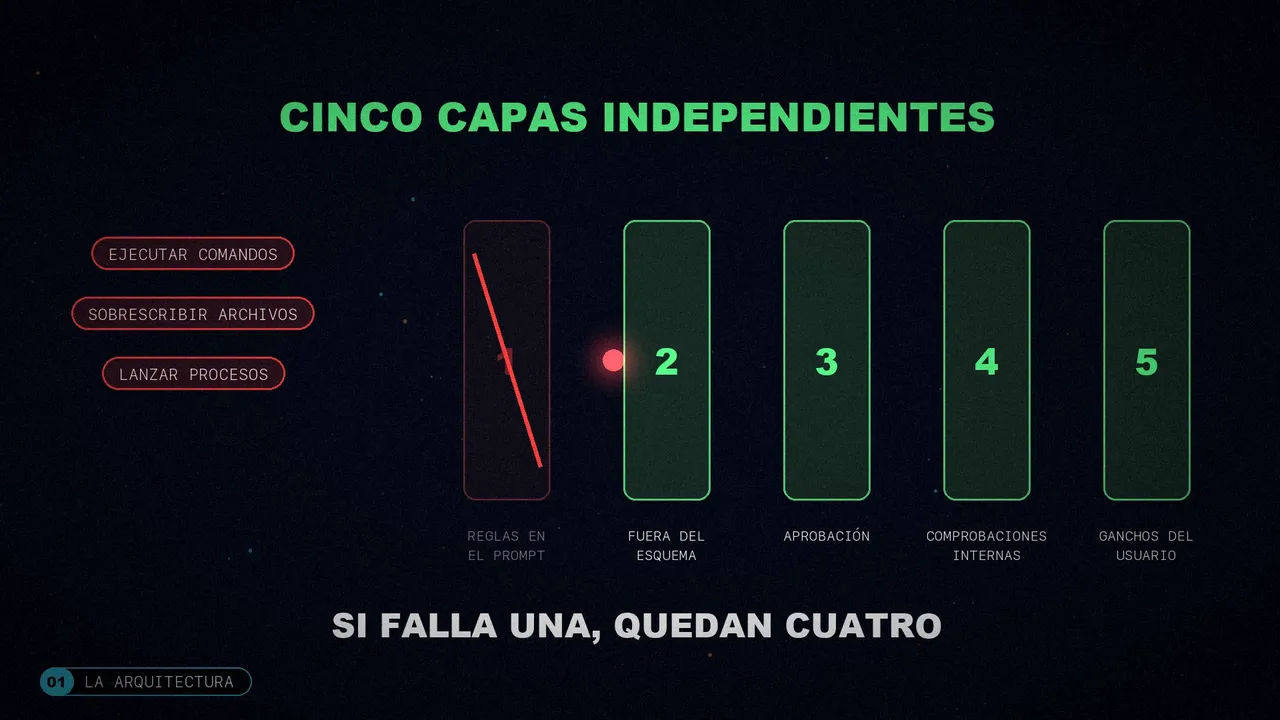
Como el agente puede ejecutar comandos, sobrescribir archivos y lanzar procesos, un solo mecanismo de seguridad no basta. Hay cinco capas independientes, y si falla una, quedan cuatro:
- Reglas en el prompt.
- Herramientas que ni aparecen en el esquema del agente.
- Aprobación en tiempo de ejecución, con permisos que se guardan.
- Comprobaciones dentro de cada herramienta: patrones peligrosos, lecturas obsoletas, tiempos límite.
- Ganchos que define el usuario.
El núcleo del agente
La primera sorpresa: no hay una jerarquía de tipos de agente, sino una sola clase. El agente principal, los subagentes y los que definas tú son instancias de ella, y solo cambian sus parámetros, sobre todo qué herramientas pueden usar. Al principio tenían clases separadas (un planificador, un explorador, un generador web…) y combinar capacidades, como una web que también planifica, se volvió un lío.
Una fábrica monta los agentes en tres pasos y en un orden fijo: primero las skills, después los subagentes y, al final, el agente principal. El orden importa, porque la herramienta que lanza subagentes describe los que hay, así que tienen que existir antes. Y cada agente se construye entero desde el principio: con la construcción perezosa, la primera llamada tardaba más y las herramientas que llegaban tarde, como las de MCP, no aparecían en el prompt.
Dos modos: planificar y ejecutar
Si pides planificar, o escribes /plan, entra en juego un subagente planificador que solo tiene herramientas de lectura. Explora el código, lo analiza y escribe un plan con siete apartados: objetivo, contexto, archivos que cambian, archivos nuevos, pasos, verificación y riesgos. Tú lo apruebas (con o sin revisar cada edición) o pides cambios, y entonces se ejecuta con todas las herramientas.
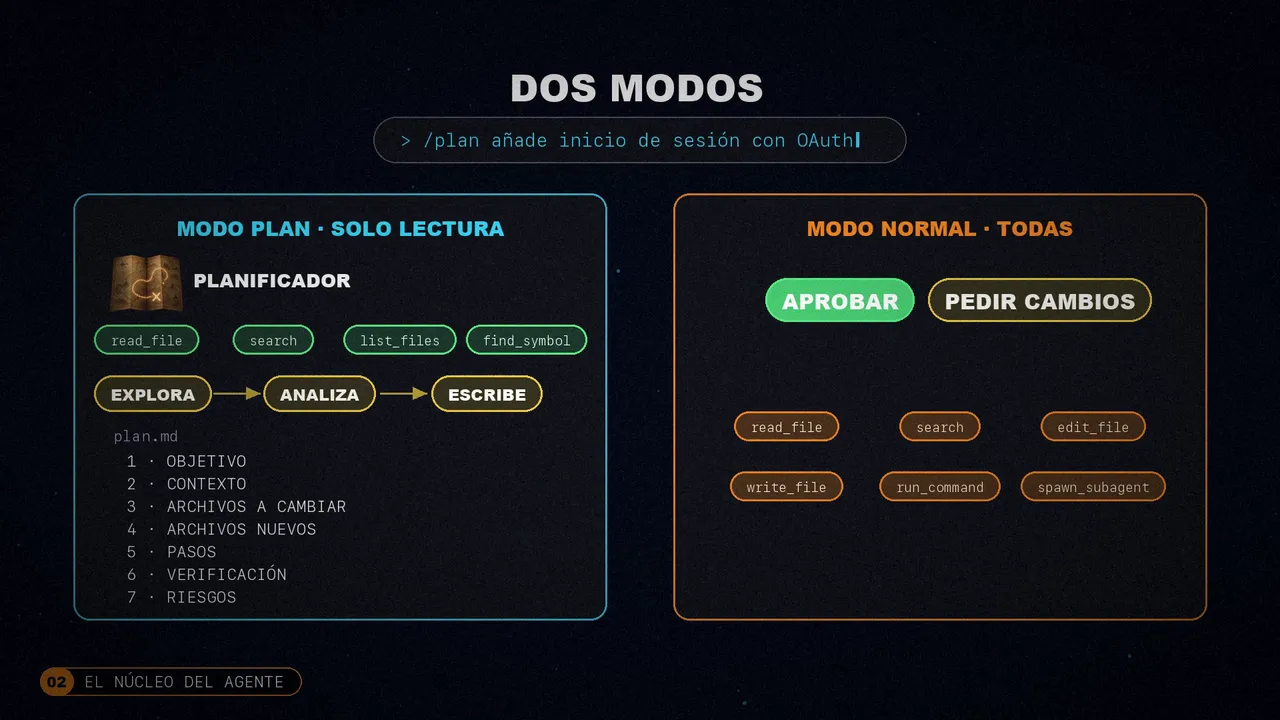
Antes, el modo plan era una máquina de estados con cuatro herramientas (entrar, salir, crear y editar el plan), y a veces el agente no salía nunca y se quedaba atascado en solo lectura. Ahora el planificador no puede escribir porque esas herramientas ni siquiera existen en su esquema. No hace falta bloquearlas.
El ciclo de cada mensaje
Cada mensaje sigue el mismo ciclo: el agente recoge lo que hayas escrito mientras trabajaba, comprime el contexto si hace falta, piensa si está activado y llama al modelo. Las lecturas se ejecutan en paralelo, hasta cinco a la vez, y las escrituras, una detrás de otra. Antes de terminar, comprueba que no quedan tareas pendientes.
El ciclo tiene diez eventos a los que puedes enganchar tus propios scripts: el inicio de la sesión, cada mensaje, antes y después de cada herramienta, los subagentes o la compactación. Un gancho previo puede bloquear la herramienta (con el código de salida 2) o reescribir sus argumentos, por ejemplo para añadir --dry-run o para pasar el linter tras editar un archivo.
Y no todo necesita al modelo: lo que empieza por una barra va directo a un comando (limpiar la sesión, compactar, cambiar de modo o de modelo, conectar un servidor MCP). Son operaciones deterministas: no piden aprobación y no gastan tokens.
Cinco modelos y el bucle ReAct
Cada fase del trabajo pide un modelo distinto, así que OpenDev reparte cinco papeles, y si falta alguno, otro ocupa su lugar:
El modelo principal, el que usa las herramientas.
Razona sin herramientas, para no precipitarse.
Revisa el razonamiento, solo en el nivel más alto.
Uno entiende capturas e imágenes; otro, pequeño y rápido, resume el contexto.
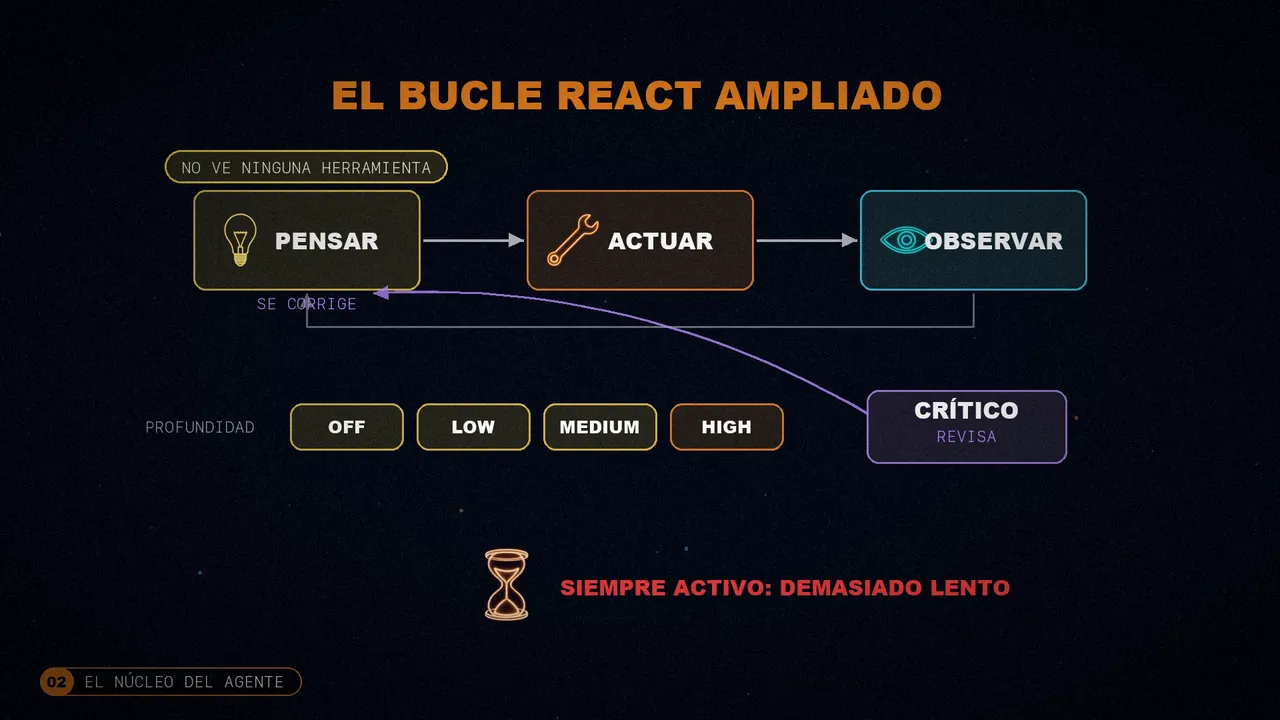
El corazón es un bucle ReAct ampliado. El ReAct clásico mezcla razonar y actuar en el mismo turno, y con las herramientas a la vista, el modelo tiende a actuar antes de pensar. Por eso hay una fase de pensamiento previa, con un modelo que no ve ninguna herramienta. Tiene cuatro niveles de profundidad; en el más alto, el crítico revisa el razonamiento y el modelo lo corrige. Aplicar la autocrítica siempre resultó demasiado lento.
Bucles atascados
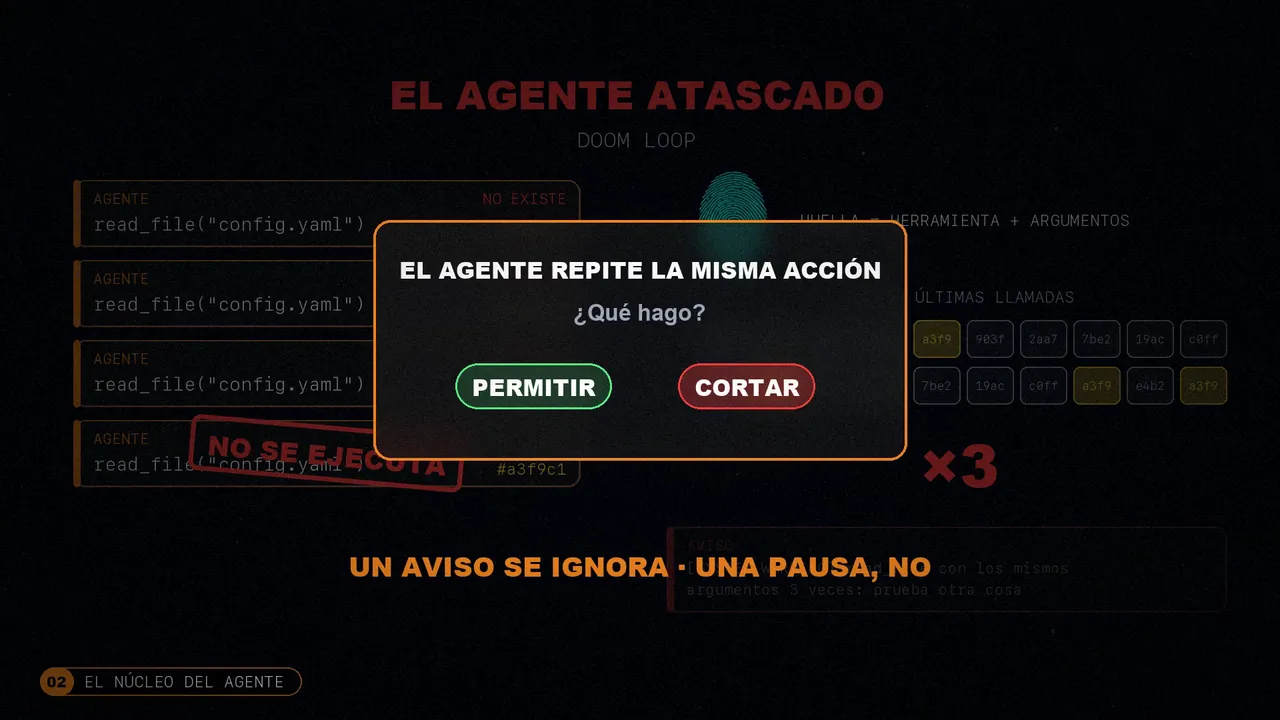
Otra trampa: el agente que repite lo mismo, como leer sin parar un archivo que no existe. OpenDev saca una huella de cada llamada, con la herramienta y sus argumentos, y vigila las veinte últimas. Si una se repite tres veces, avisa al modelo y no la ejecuta. Si insiste, se detiene y te pregunta si dejarla seguir o cortar. Como dice el paper, un aviso se puede ignorar; una pausa real, no.
Subagentes especializados
El agente principal delega en subagentes: un explorador del código, un planificador, revisores de código y de seguridad, generadores de webs… Cada uno tiene solo las herramientas de su papel. Así su contexto es más pequeño, no se pisan la lista de tareas (solo la lleva el principal) y, si se equivocan, el daño queda acotado. Si le pides varias cosas independientes, lanza varios a la vez, cada uno en su hilo y con su propio contexto, y luego une los resultados en una sola respuesta. Al principio no sabían cuándo parar y el explorador releía los mismos archivos; ahora tienen condiciones de parada explícitas.
La ingeniería de contexto
La calidad de cada respuesta depende, sobre todo, de lo que el modelo ve en su ventana: qué instrucciones recibe, cuánta conversación conserva, qué ha aprendido antes y qué información se le reúne en cada llamada. OpenDev lo trata como una prioridad de primer orden.
Un prompt por secciones, con caché
En vez de un prompt de sistema enorme, se compone de secciones independientes, cada una en su archivo y con una condición. Las reglas de git, por ejemplo, solo se cargan dentro de un repositorio. Se filtran, se ordenan por prioridad y se unen; lo que no aporta ni ocupa sitio ni distrae al modelo. Hay incluso secciones propias de cada proveedor de modelos.
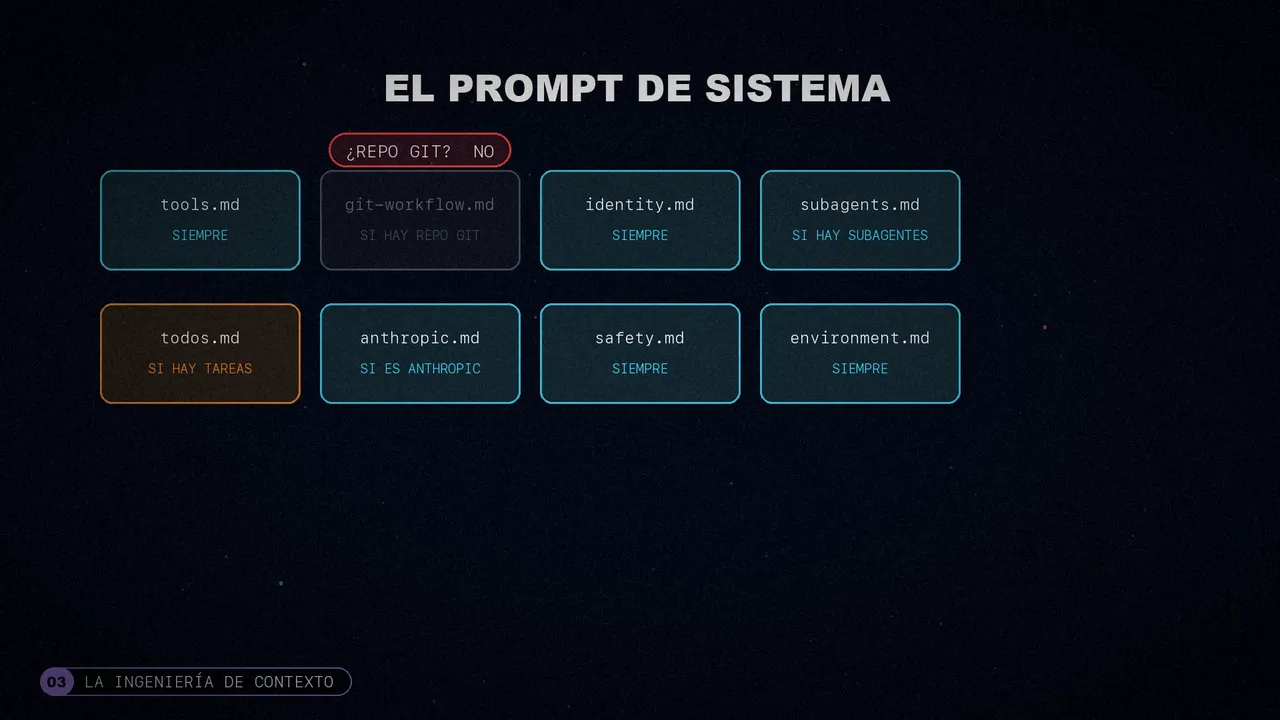
Además, el prompt se parte en dos: una parte estable, que supone entre el 80 y el 90 % del total, y otra que cambia con la sesión. La estable se guarda en la caché del proveedor, y como el prompt viaja en cada llamada, el coste de esa parte baja en torno a un 88 %.
Resultados resumidos y salidas a un archivo
Lo que más ocupa son los resultados de las herramientas: leer un archivo puede costar tres mil tokens. Así que cada resultado se resume según su tipo: una lectura queda en «leído, 142 líneas»; una búsqueda, en «23 coincidencias». Y si una salida pasa de ocho mil caracteres, se guarda en un archivo aparte y en la conversación solo queda un avance con la ruta. Antes, una batería de pruebas podía comerse treinta mil tokens; con estos dos cambios, las sesiones pasaron de aguantar 15-20 turnos a 30-40 antes de llenar el contexto.
Memoria doble para pensar
La fase de pensamiento usa una memoria doble, inspirada en la ciencia cognitiva. La episódica es un resumen de toda la conversación, con los objetivos y las decisiones. La de trabajo son los seis últimos intercambios, palabra por palabra. Juntas dan el panorama y el detalle, con un presupuesto fijo de tokens.
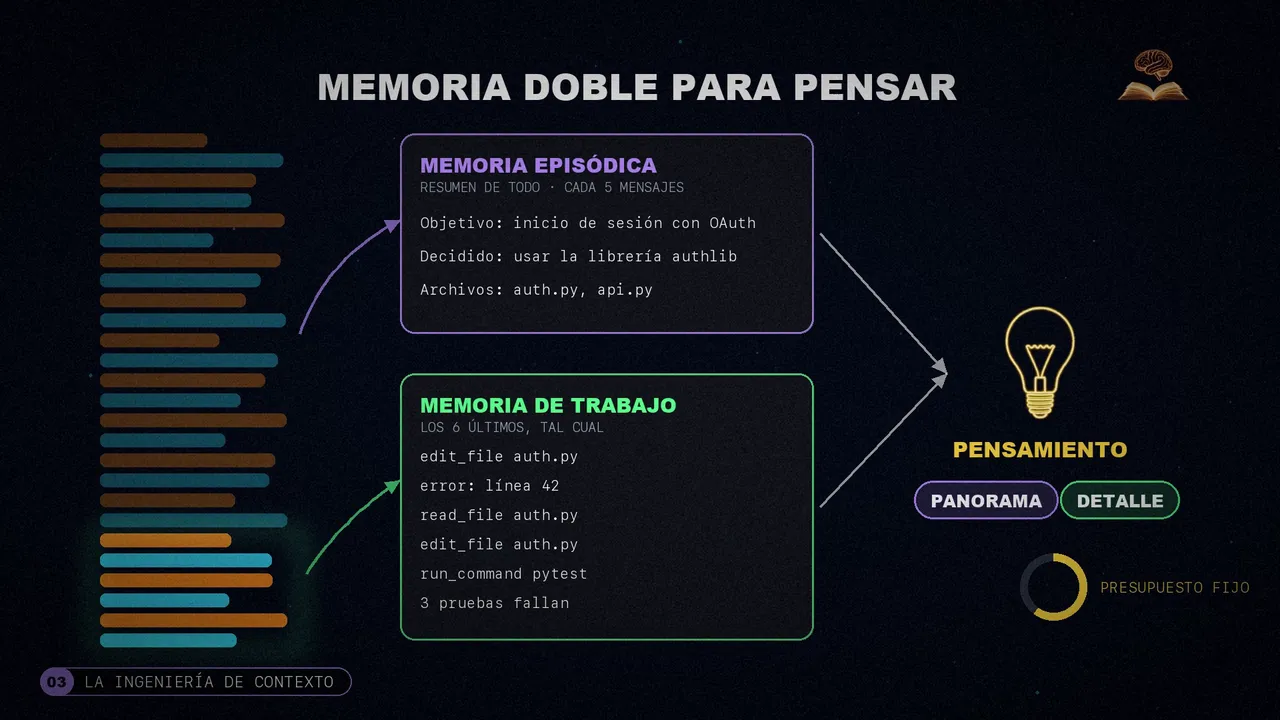
Probaron los dos extremos. Solo con resúmenes, se perdían rutas y nombres, y el agente citaba archivos que no existían. Solo con los mensajes recientes, olvidaba el objetivo a los diez turnos. Y un detalle fino: resumir un resumen acumula errores, así que el resumen se rehace cada cinco mensajes desde la conversación completa.
Instrucciones que se olvidan
Este es el problema que más me ha gustado del paper, porque lo reconocerá cualquiera que use agentes. Le dices que pase siempre las pruebas después de editar. Los primeros turnos lo hace. Pero tras unas veinte llamadas a herramientas, deja de hacerlo. La instrucción sigue en el prompt, pero queda tan lejos que el modelo ya no le hace caso. Lo vieron de forma sistemática en sesiones de más de quince llamadas.
La solución son los recordatorios de sistema: mensajes cortos que se inyectan justo antes de que el agente se equivoque. Ocho detectores vigilan la conversación: herramientas que fallan sin reintento, demasiadas lecturas seguidas, tareas sin terminar, planes aprobados que no se ejecutan… Y cada recordatorio tiene un tope, para que no se convierta en ruido.
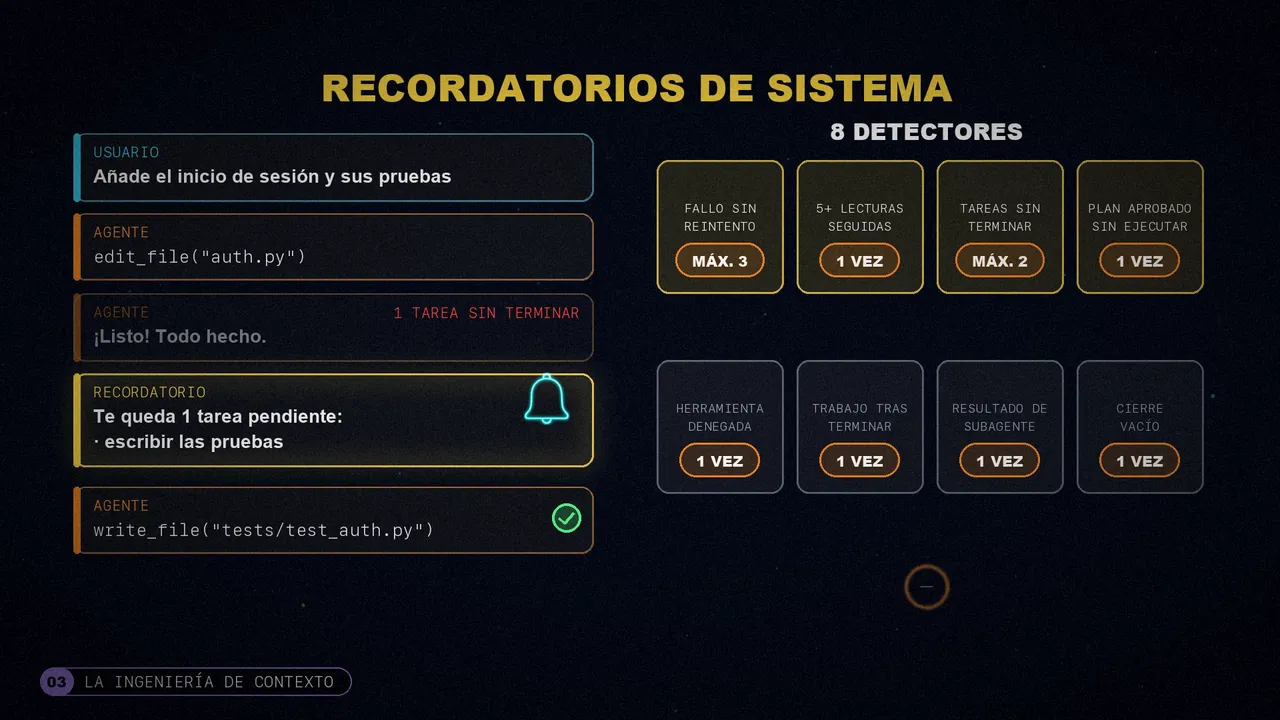
El detalle curioso: los recordatorios llegan como mensajes del usuario, no del sistema. Tras cuarenta turnos, otra instrucción de sistema se pierde en el fondo; lo que dice el usuario, en cambio, es lo más reciente, algo que acaba de pasar y pide respuesta. En sus pruebas, así el modelo obedecía bastante más.
Con los errores pasa algo parecido: ante un fallo, el agente suele pedir perdón en lugar de arreglarlo. OpenDev clasifica cada error en seis tipos (permiso denegado, archivo inexistente, edición que no encaja, sintaxis, límite de uso y tiempo agotado) y le da instrucciones concretas. «Vuelve a leer el archivo» funciona mucho mejor que «arréglalo». Y como mucho, lo intenta tres veces.
Compactar sin perder nada
Las salidas de las herramientas acaban ocupando del 70 al 80 % del contexto. Lo habitual es esperar a llenarlo casi del todo y resumir de golpe, perdiendo mucho. OpenDev comprime por etapas:
- 70 %: solo avisa.
- 80 %: cambia las salidas antiguas por referencias.
- 85 %: poda las que quedan muy atrás.
- 90 %: enmascara casi todo menos lo más reciente.
- 99 %: resume la conversación con un modelo.
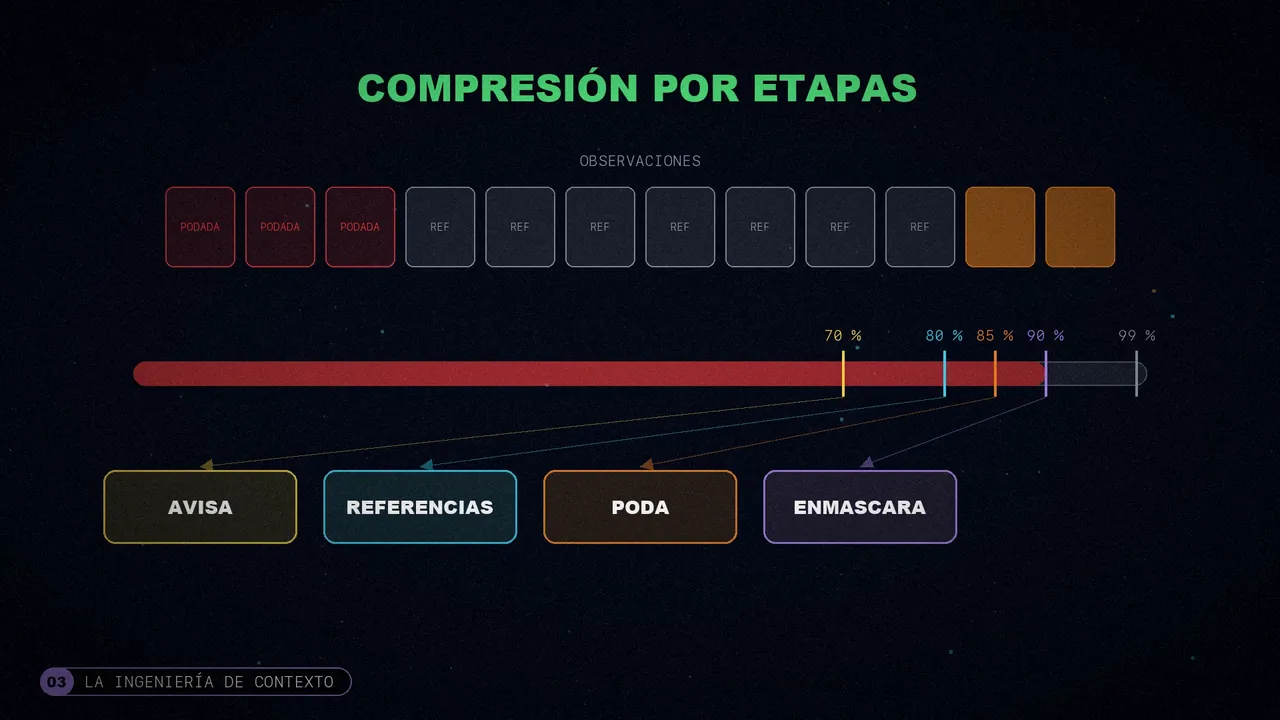
Y ni siquiera entonces se pierde nada: la conversación entera se guarda en un archivo, y el resumen incluye su ruta y un índice de todo lo que ha tocado el agente. Según el paper, así el pico de contexto que ocupan las observaciones baja un 54 %, y en sesiones típicas de treinta turnos muchas veces ya no hace falta el resumen de emergencia.
El agente también aprende de una sesión a otra con un cuaderno de estrategias (playbook): frases cortas marcadas como útiles, dañinas o neutras. Antes de cada consulta elige las mejores por eficacia (0,5), antigüedad (0,3) y parecido con la pregunta (0,2). Y cada cinco mensajes, un reflector analiza qué ha funcionado y un curador actualiza el cuaderno.
Encontrar el código adecuado
Encontrar el código adecuado es lo más decisivo para un agente de programación: todo lo demás depende de eso. Por defecto, los agentes buscan cualquier cosa con grep. OpenDev busca primero el ancla más fuerte de la petición: un nombre de función va al servidor de lenguaje; un mensaje de error, a la búsqueda de texto; y un patrón de código, al buscador estructural.
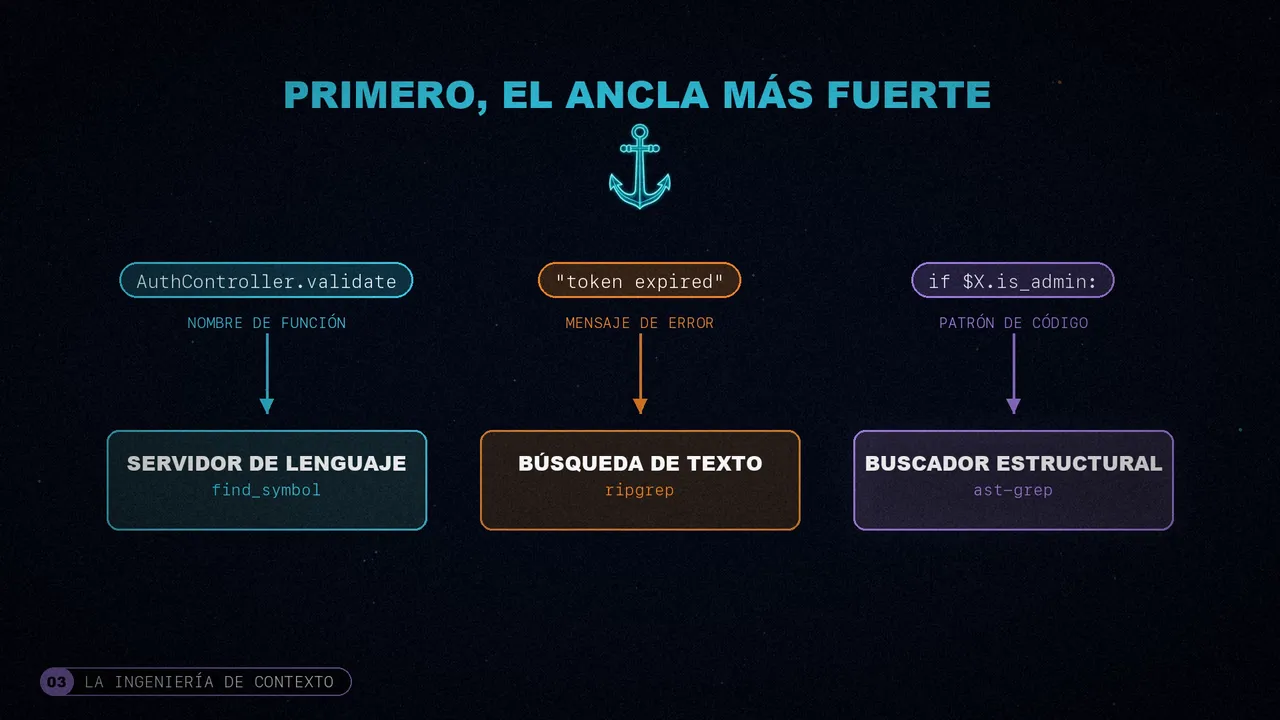
Si la tarea exige explorar a fondo, delega en el subagente explorador, que encadena búsquedas en su propio contexto: localiza una clase, lee sus dependencias y rastrea dónde se usan. Los miles de líneas intermedias se quedan en su ventana, y al agente principal solo le llega el resumen.
Las herramientas
OpenDev trae 35 herramientas propias, organizadas en un registro por categorías: archivos, procesos, web, símbolos, tareas… Antes estaban todas en un único espacio de nombres, con choques de nombres y una seguridad difícil de configurar; con categorías, las reglas se aplican por grupo.
Antes de ejecutar nada, tú decides cuánta autonomía le das: manual, con una aprobación para cada paso; semiautomática, que solo deja pasar las lecturas; o automática. Encima van reglas por patrón, por comando y por prefijo, y reglas de peligro, como borrar el disco entero, que siempre se deniegan. Lo que apruebas se guarda entre sesiones: si no, acabarías aprobándolo todo por cansancio.
Archivos y edición flexible
La lectura numera las líneas y, si el archivo es enorme, muestra el principio y el final. Antes de editar, se comprueba que nadie ha cambiado el archivo desde la última lectura, para no pisar tu trabajo. Y la escritura solo crea archivos nuevos: para modificar uno hay que editarlo, no reescribirlo de memoria.
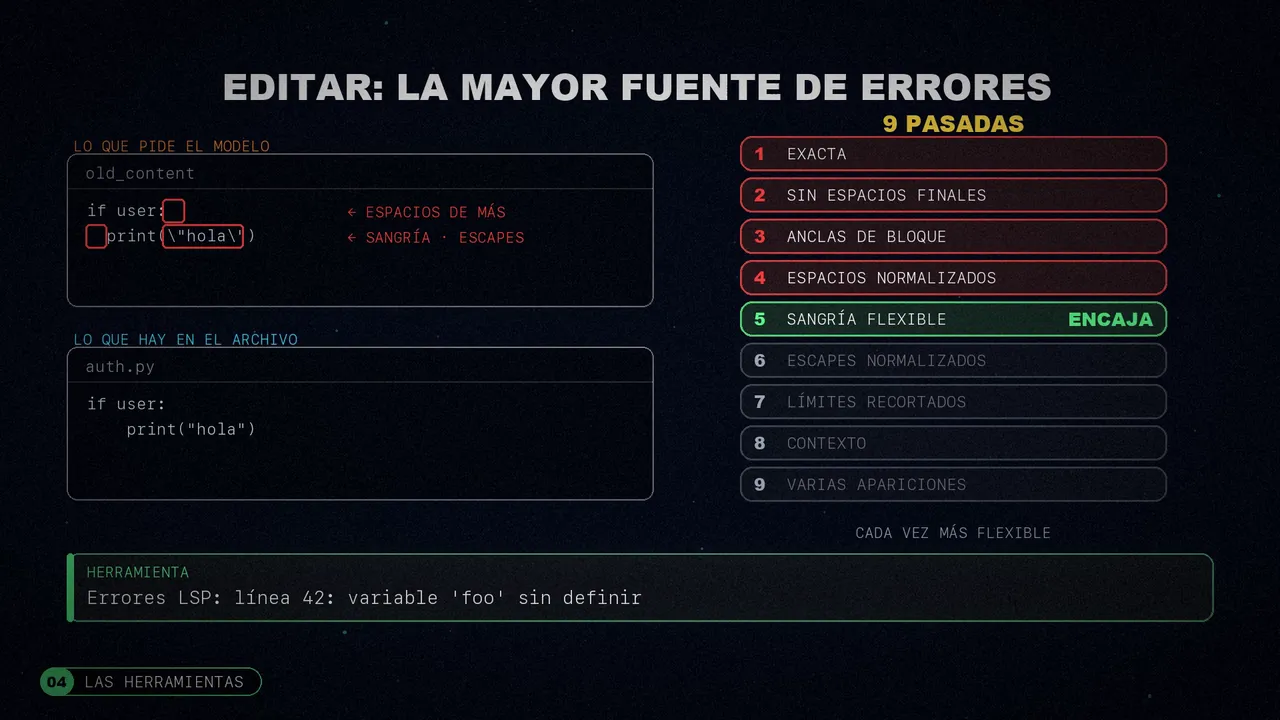
Editar era la mayor fuente de errores. El modelo pide sustituir un texto que casi coincide con el del archivo, con espacios de más, otra sangría o caracteres escapados. OpenDev lo intenta con nueve pasadas, de la coincidencia exacta a otras cada vez más flexibles, y se queda con la primera que encaja. Después, el servidor de lenguaje le avisa de los fallos que haya metido.
Shell, web y servidores de lenguaje
Cada comando de shell pasa por seis etapas: filtros de seguridad, preparación, detección de servidores, ejecución, gestión de la salida y límites de tiempo. Si reconoce un servidor de desarrollo, lo manda a segundo plano. Antes, con un tiempo límite fijo, esos procesos morían siempre; ahora depende de la actividad: un minuto sin salida o diez en total.
Para la web usa un navegador de verdad, porque mucha documentación necesita JavaScript, y también busca y hace capturas. Para entender el código se conecta a los servidores de lenguaje, los mismos que usan los editores: encuentra símbolos y referencias, renombra en todo el proyecto y reescribe el cuerpo de una función sin tocar su firma.
Para hablar contigo, hace preguntas con opciones en lugar de texto libre (y siempre puedes contestar otra cosa), lleva una lista de tareas con una sola en curso, te presenta el plan para que lo apruebes y tiene una herramienta explícita para decir que ha terminado.
MCP y skills, bajo demanda
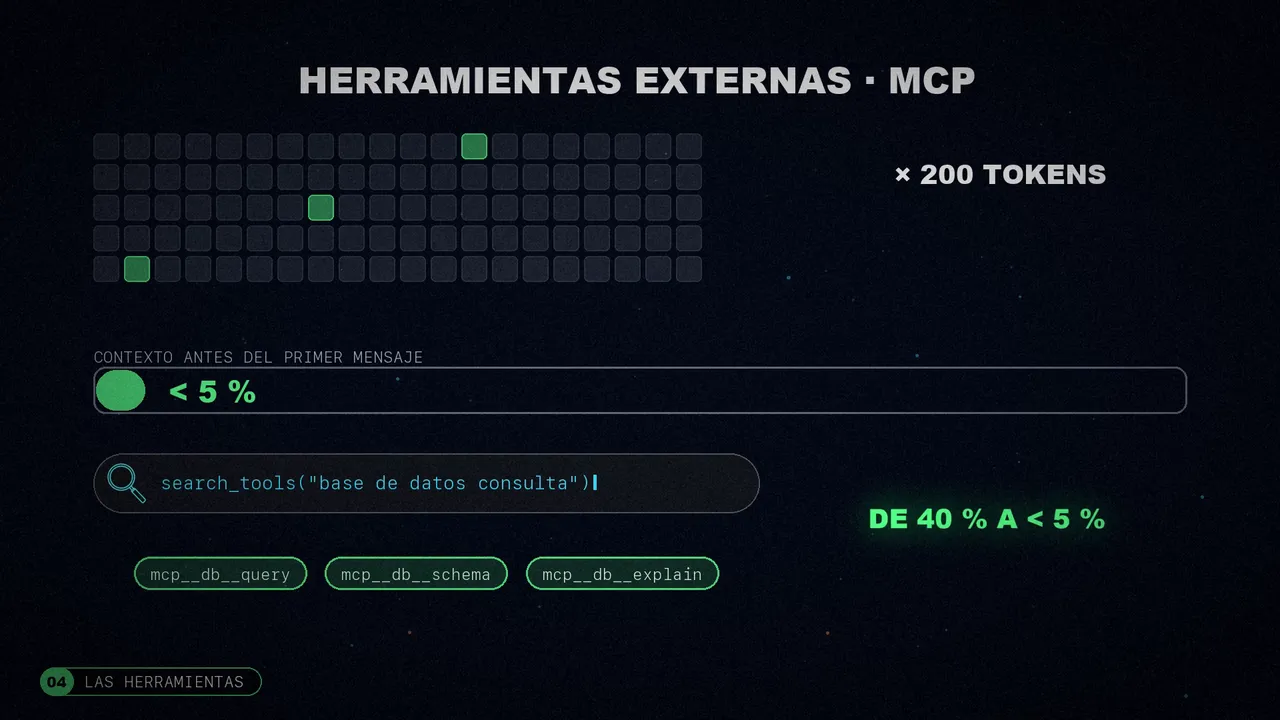
Cien herramientas MCP de unos doscientos tokens cada una suman veinte mil tokens solo en definiciones. Al principio las cargaban todas, y se comían hasta el 40 % del contexto antes del primer mensaje. Ahora el agente las busca por palabras clave cuando le hacen falta y solo carga esas: el coste inicial bajó a menos del 5 %. Con las skills hace lo mismo: al arrancar solo carga su nombre y su descripción.
La persistencia
Todo se guarda en archivos normales, sin base de datos. Cada sesión son dos archivos, los metadatos y la transcripción (un mensaje por línea), que se escriben en un temporal y luego se renombran, así que nunca quedan a medias. Y si el índice de sesiones se corrompe, se reconstruye solo.
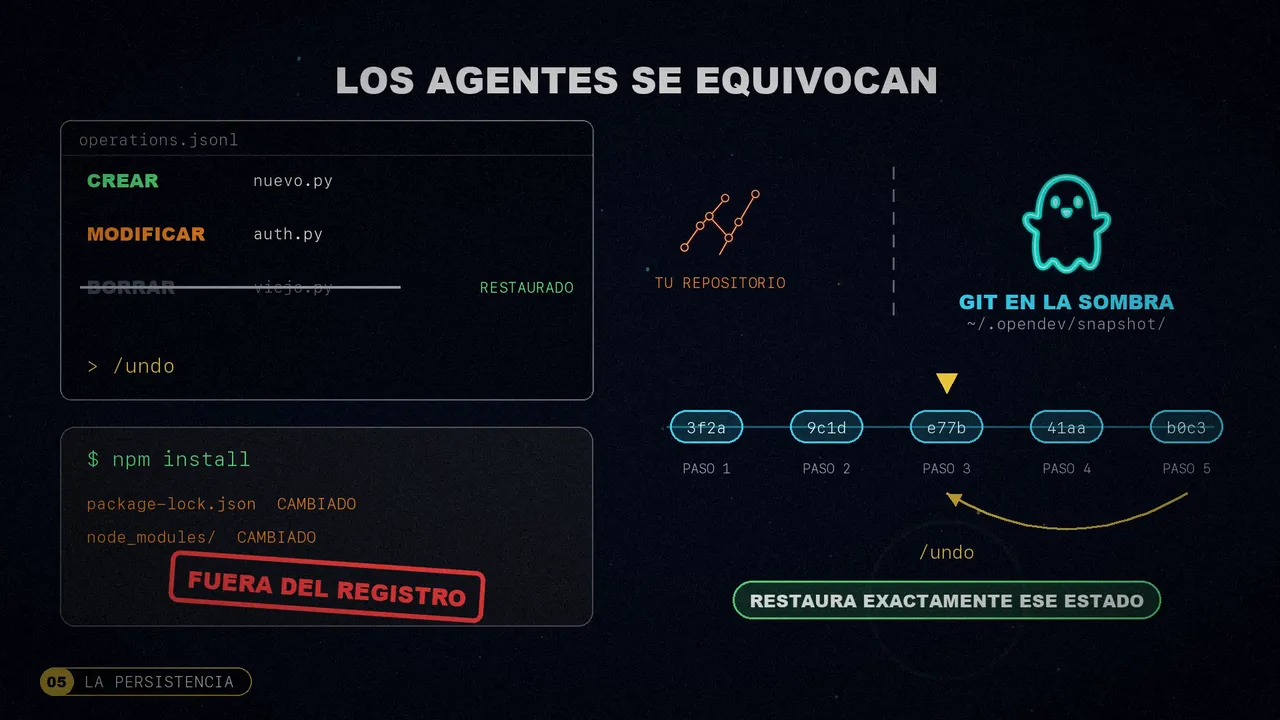
Los agentes se equivocan, así que cada operación con archivos queda registrada y se deshace con un solo comando. Pero un comando de shell también cambia archivos, por ejemplo al instalar dependencias. Para eso hay un repositorio de git en la sombra, aparte del tuyo, que guarda una instantánea en cada paso; deshacer restaura exactamente ese estado.
La configuración va por niveles (por defecto, entorno, usuario y proyecto, que manda sobre todo), las claves de la API solo se leen del entorno y los datos de los modelos se guardan en caché, así que el agente arranca incluso sin conexión.
Las cinco lecciones
- El contexto es la restricción central. Lo consumen el propio sistema y las acciones del agente, y las salidas de las herramientas se llevan del 70 al 80 %. Un resultado más completo mejora cada turno, pero acorta la vida útil de la sesión.
- Guiar al agente es un problema de señal y ruido. La influencia del prompt se desvanece con la conversación. Para que no lo busque todo con grep, le dieron un árbol de decisión con criterios concretos: «si buscas una función o una clase, usa la búsqueda de símbolos». Nada de «usa la herramienta más adecuada».
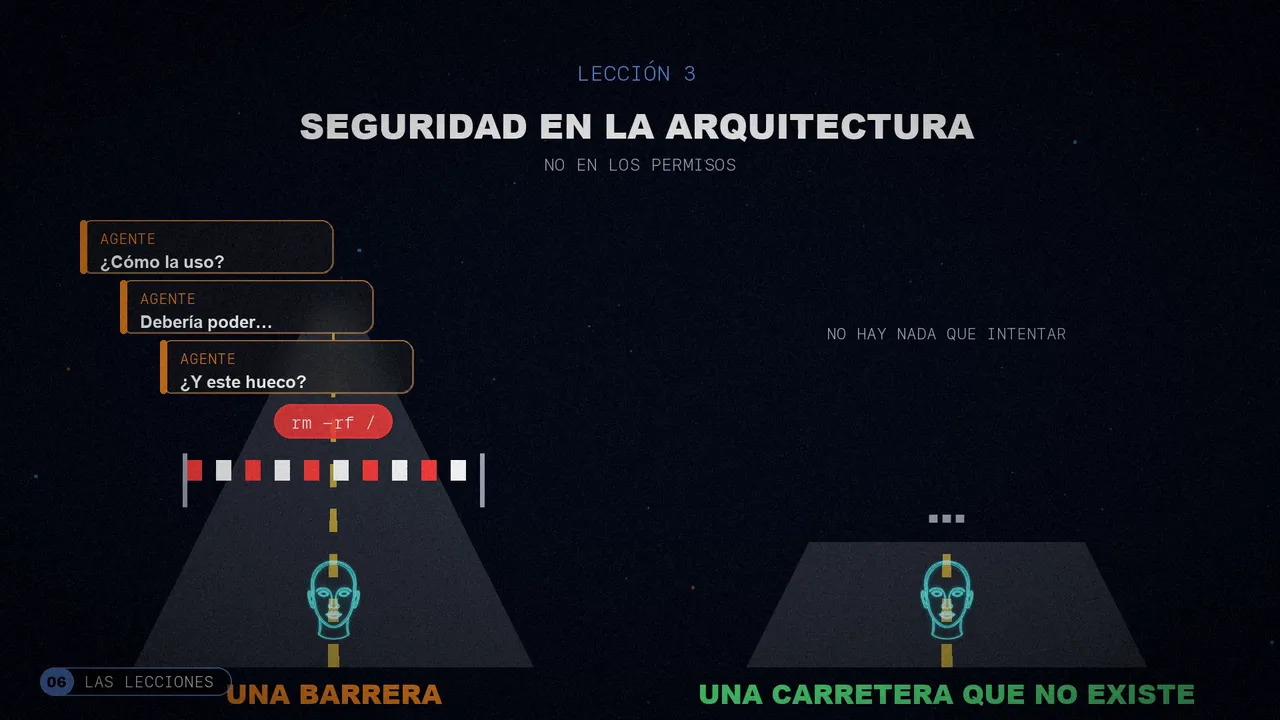
- La seguridad va en la arquitectura, no en los permisos. Un modelo que ve una herramienta peligrosa puede razonar cómo usarla, argumentar por qué debería poder y buscar huecos en las reglas. Si la herramienta no está en su esquema, ni siquiera lo intenta. Es la diferencia entre una barrera y una carretera que no existe.
- Los modelos casi aciertan. Un sistema que exige exactitud se pasa la vida recuperándose de errores; mejor herramientas que absorban la imprecisión: la edición flexible, pasar a segundo plano lo que parece un servidor o instalar una dependencia que falta.
- Cargarlo todo al principio no escala. Mejor un índice ligero al arrancar y el contenido completo cuando haga falta. Lo que se pueda reconstruir, que se regenere solo. Y lo determinista, fuera del bucle del agente.
Lo que falta
El propio autor lo reconoce: el paper documenta decisiones, pero no trae una evaluación cuantitativa sistemática. Sus cifras salen de su experiencia con OpenDev, sin compararlo con otros agentes en benchmarks como Terminal-Bench o LongCLI-Bench. Medirlo así es el primer paso pendiente.
Y propone hacia dónde seguir: umbrales que se adapten a cada tarea (un fallo sencillo no necesita la fase de pensamiento), una memoria que pase de un proyecto a otro y entienda el código como un grafo, subagentes que hablen entre sí, recordatorios que se aprendan solos en vez de diseñarse a mano y el mismo agente también dentro del editor.
Un buen agente de terminal no depende solo del modelo: es contexto bien administrado, seguridad por capas, herramientas que perdonan errores y una memoria que aprende.
¿Qué idea de OpenDev le pondrías a tu agente?
Fuentes
- «Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned», de Nghi D. Q. Bui (OpenDev), arXiv 2603.05344, marzo de 2026.
- El código del agente: opendev-to/opendev.
- El vídeo, en mis tres canales: español, inglés y portugués.