Por qué hay que gestionar el contexto
Los agentes abordan tareas cada vez más largas. Y cuanto más dura una tarea, más cosas acumula el agente en su ventana de contexto: mensajes, llamadas a herramientas, sus respuestas, archivos leídos…
Eso trae dos problemas. El primero es obvio: la ventana del modelo es finita. El segundo llega mucho antes de llenarla: con tanto texto, el modelo aprovecha peor lo importante. Es el deterioro del contexto, o context rot.
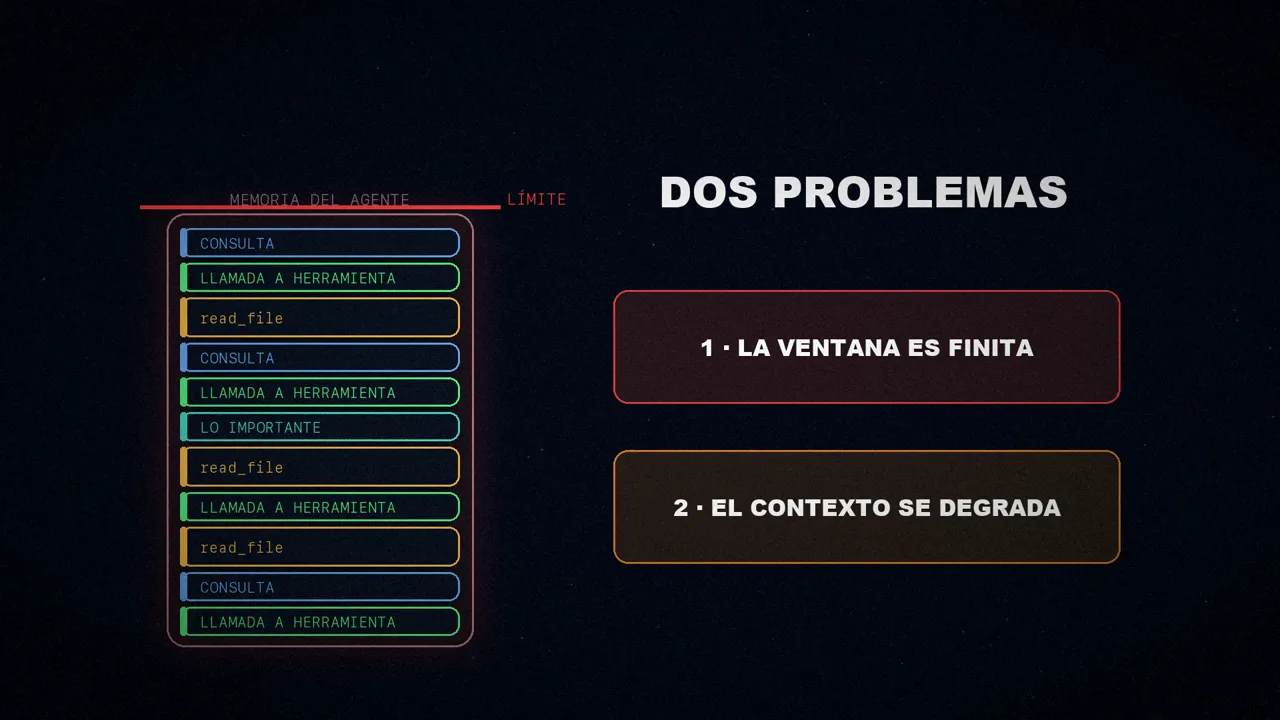
La solución es comprimir el contexto: reducir lo que el agente guarda en su memoria de trabajo sin perder los detalles que necesita para acabar la tarea. Puede ser resumir lo que ya pasó, quitar información caducada o decidir con cuidado qué se queda y qué se va.
Deep Agents y su sistema de archivos
Deep Agents es el arnés de agentes de LangChain: de código abierto y con todo lo necesario de serie (en inglés, batteries included). Con él, un agente puede planificar, lanzar subagentes y trabajar con un sistema de archivos para hacer tareas complejas y largas.
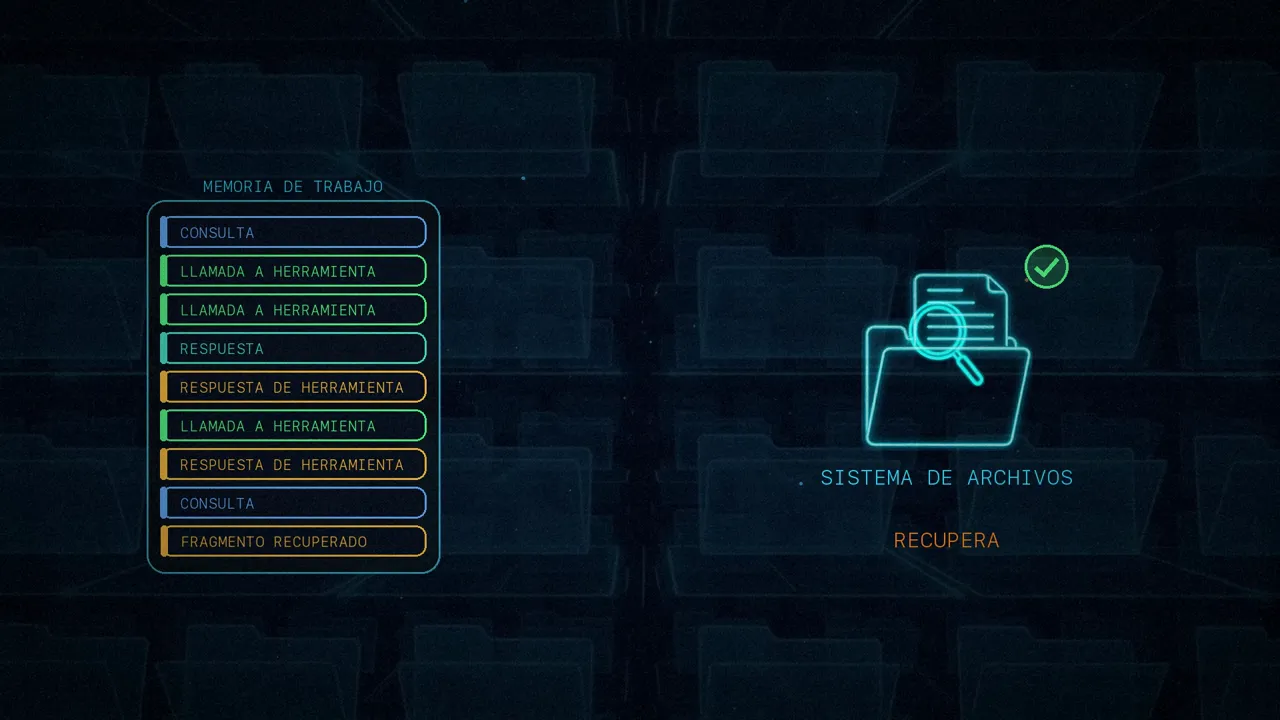
Ese sistema de archivos es la pieza clave de toda la gestión del contexto. El agente tiene herramientas para listar, leer, escribir y buscar archivos, e incluso ejecutarlos. Así, lo que sale de la memoria de trabajo no se pierde: va al disco, y el agente lo busca y lo recupera cuando le hace falta.
Tres técnicas, tres ritmos
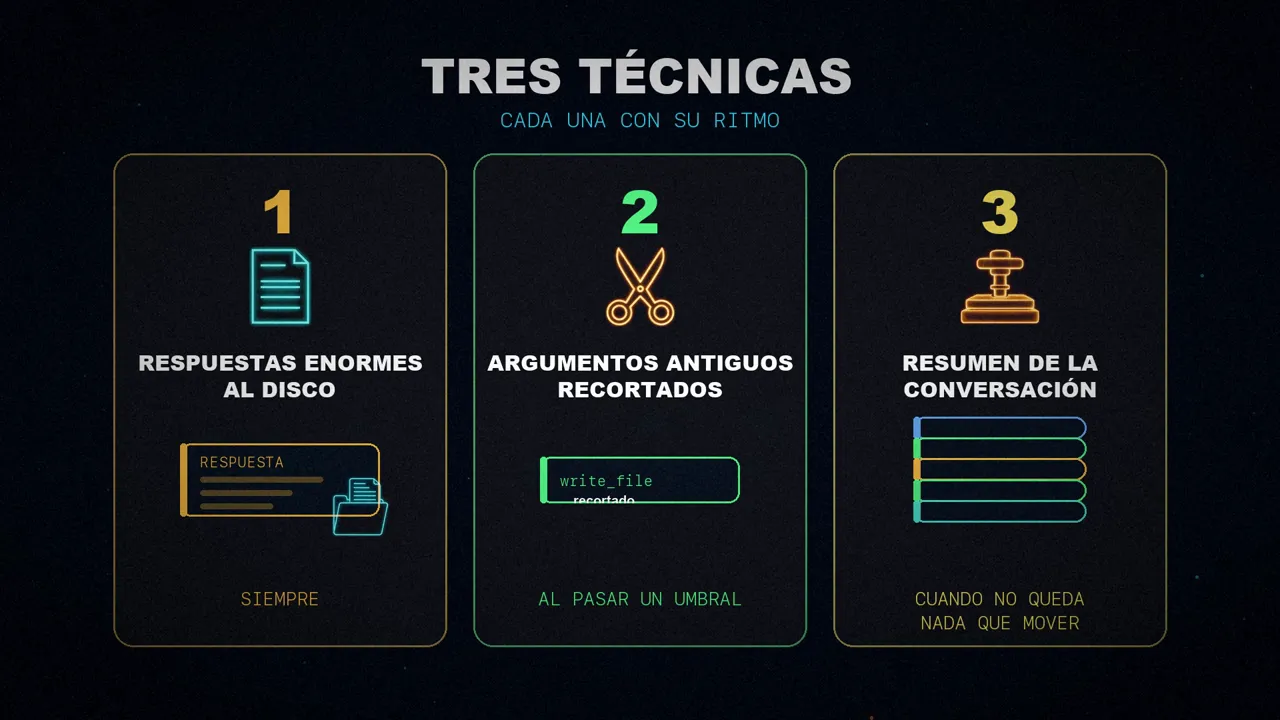
Sobre esa base, Deep Agents comprime el contexto con tres técnicas, cada una con su propio ritmo:
Mueve al disco las respuestas enormes de las herramientas, en cuanto aparecen.
Quita del historial los argumentos grandes de las llamadas antiguas, cuando el contexto pasa de un umbral.
Resume la conversación cuando ya no queda nada que mover al disco.
Los umbrales no son un número fijo de tokens, sino fracciones de la ventana de cada modelo. LangChain guarda en unos perfiles de modelo el máximo de tokens que admite cada uno, y Deep Agents comprime cuando el contexto llega a cierto porcentaje de esa cifra.
1. Las respuestas grandes, al disco
Cuando el agente lee un archivo enorme o consulta un servicio web, la respuesta de la herramienta puede ser tan grande que ni siquiera quepa en la ventana del modelo.
Por eso, cuando Deep Agents detecta una respuesta de más de 20.000 tokens, la guarda en un archivo del disco. En el contexto deja solo la ruta de ese archivo y una vista previa con sus diez primeras líneas. Si luego necesita más, el agente vuelve a leer el archivo o busca en él lo que le interesa: la respuesta completa sigue a su alcance, pero ya no ocupa la memoria de trabajo.
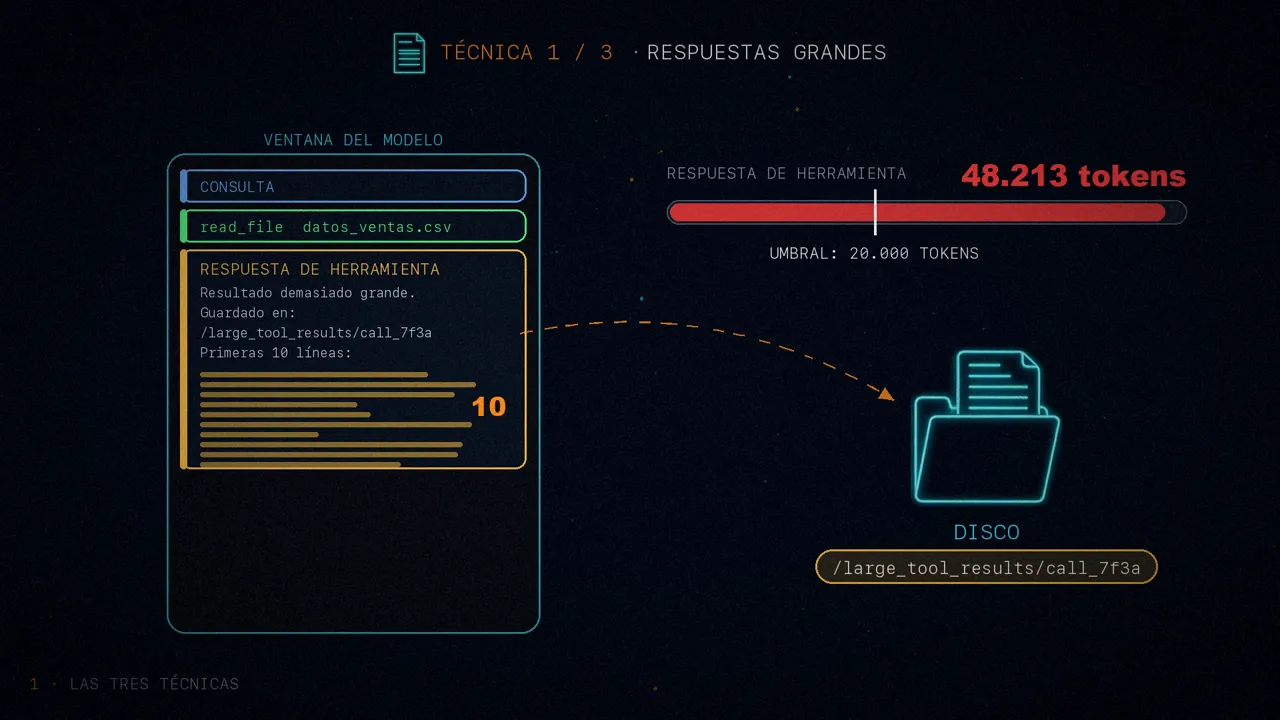
Un detalle que comprobé en el código de Deep Agents: el umbral de 20.000 tokens y la carpeta /large_tool_results/ coinciden con el artículo, pero la versión actual ya no enseña solo el principio, sino el principio y el final de la respuesta.
2. Recortar las entradas grandes
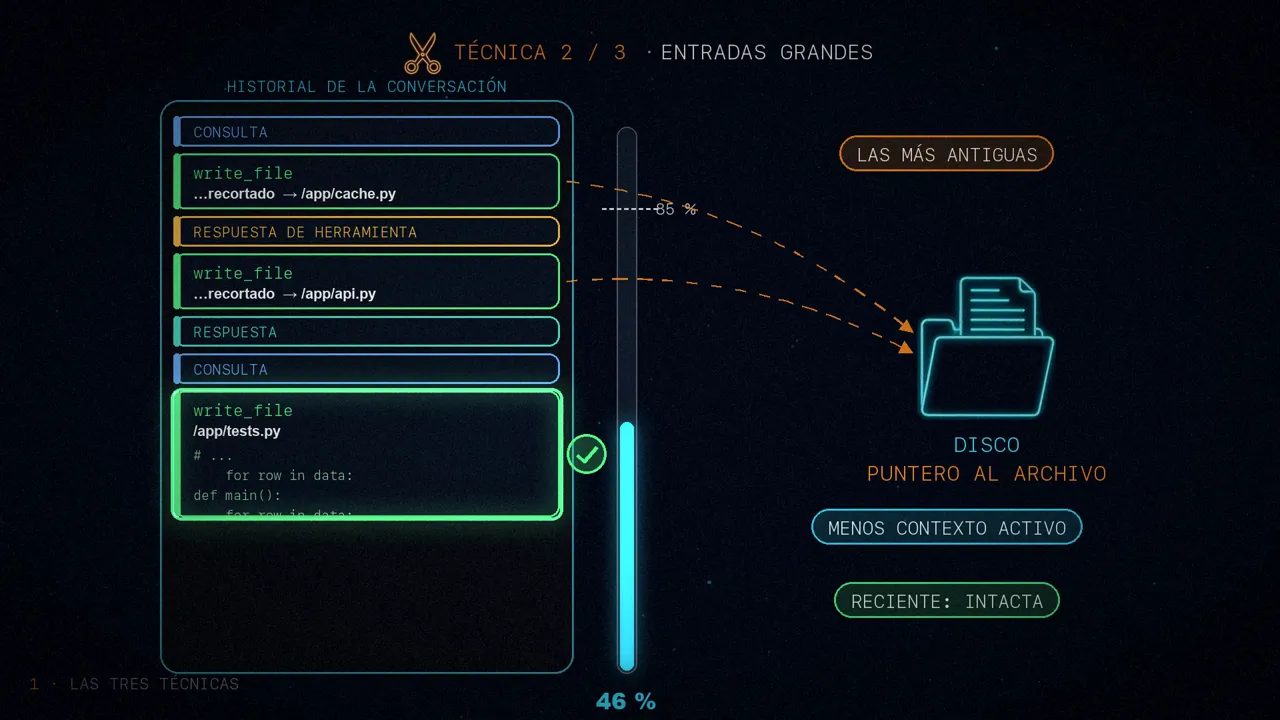
La segunda técnica mira al otro lado: no a lo que devuelven las herramientas, sino a lo que reciben. Cuando el agente escribe o edita un archivo, la llamada a la herramienta lleva dentro el contenido completo, y se queda en el historial de la conversación.
Pero ese contenido ya está guardado en el disco. Tenerlo también en el historial es redundante: pueden ser quinientas líneas de código ocupando espacio turno tras turno. Así que, cuando la conversación pasa del 85 % de la ventana, Deep Agents recorta las llamadas más antiguas: cambia su contenido por un puntero al archivo en disco, y el contexto activo adelgaza. Lo más reciente se queda como está.
3. Resumir sin borrar nada
Cuando sacar cosas al disco ya no libera suficiente espacio, Deep Agents recurre al resumen, en dos partes:
- Un resumen en la memoria: un modelo de lenguaje escribe un resumen estructurado de la conversación, con la intención de la sesión, los artefactos creados y los siguientes pasos. Ese resumen sustituye al historial completo en la memoria de trabajo del agente.
- El historial completo, al disco: los mensajes originales se escriben en un archivo, como registro canónico de todo lo que pasó. El resumen señala dónde está, por si hace falta volver a él.
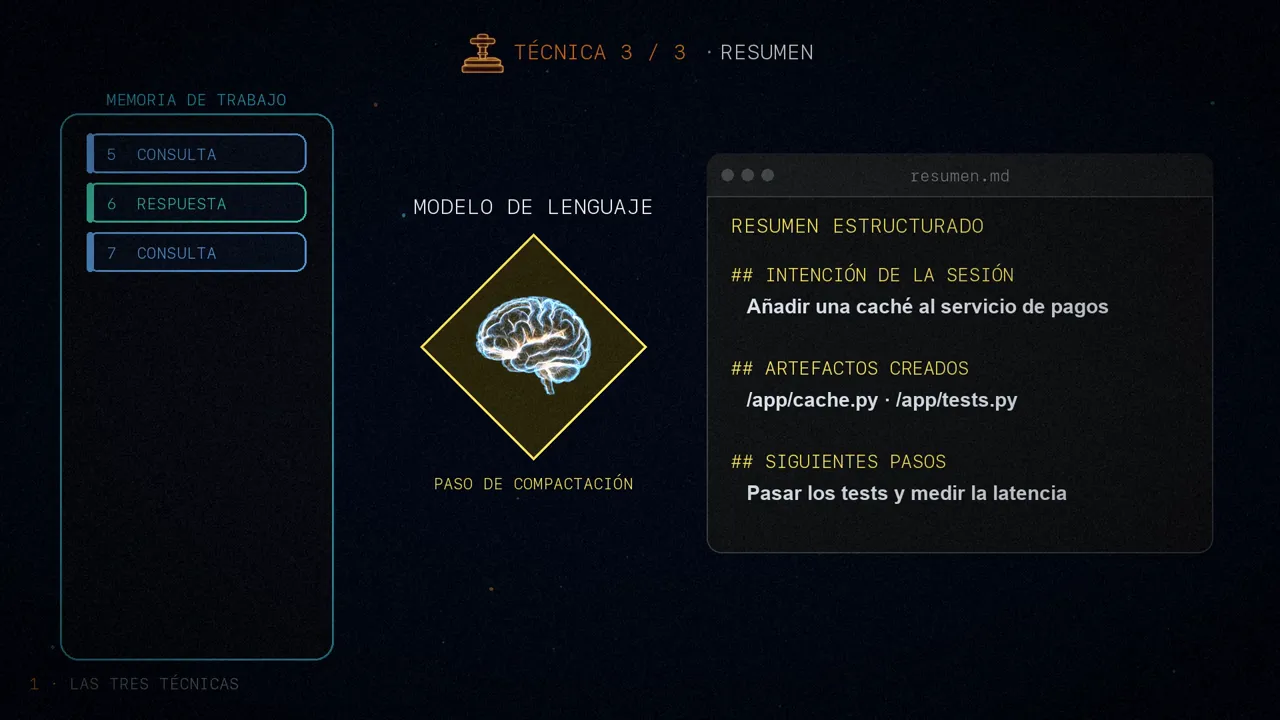
Con este doble enfoque, el agente sabe en qué punto está y hacia dónde va gracias al resumen, y si necesita un detalle concreto lo recupera buscando en el disco. El artículo lo enseña con una traza real, en la que el modelo usa su herramienta read_file para traer mensajes que ya se habían resumido.
¿Cómo saber si funciona?
Esa es la maquinaria. Pero, para mí, la parte más interesante del artículo es la segunda: ¿cómo sabes que de verdad funciona? En tareas reales, como las de Terminal Bench, la compresión se dispara solo de vez en cuando. Con tan pocos eventos, cuesta aislar qué aporta cada técnica.
El truco de LangChain es provocarla. Si resumes al llegar al 10 o al 20 % de la ventana, el agente rinde algo peor en general, pero resume muchísimas más veces. No es una configuración para producción, sino para probar: con tantos eventos ya puedes comparar configuraciones distintas, por ejemplo, dos versiones de tu prompt de resumen.
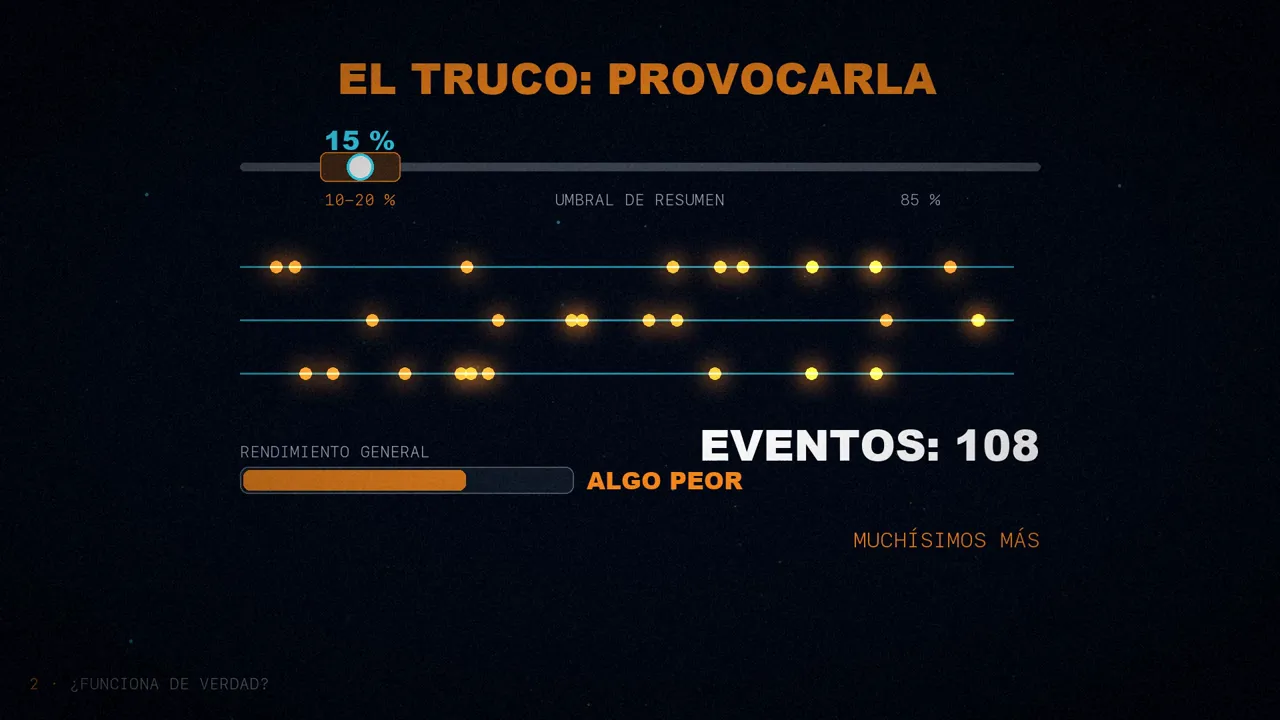
Así encontraron una mejora sencilla: el agente funcionaba mejor al añadir al prompt de resumen dos apartados propios, la intención de la sesión y los siguientes pasos. En la PR de LangChain que cambió ese prompt, el nuevo queda con cuatro secciones: intención de la sesión, resumen, artefactos y siguientes pasos.
La gráfica
El artículo lo ilustra con una gráfica: ejecuciones de Claude Sonnet 4.5 en Terminal Bench 2, comprimiendo al 25 % de la ventana en vez del 85 % por defecto. Cada línea sigue los tokens del contexto turno a turno.
- La línea verde: pasado el turno 20, un resumen hunde el contexto de golpe, de unos 50.000 tokens a unos 15.000.
- La línea naranja: cerca del turno 40, la caída es menor. No es un resumen: se expulsa del contexto una llamada que escribía un archivo grande.
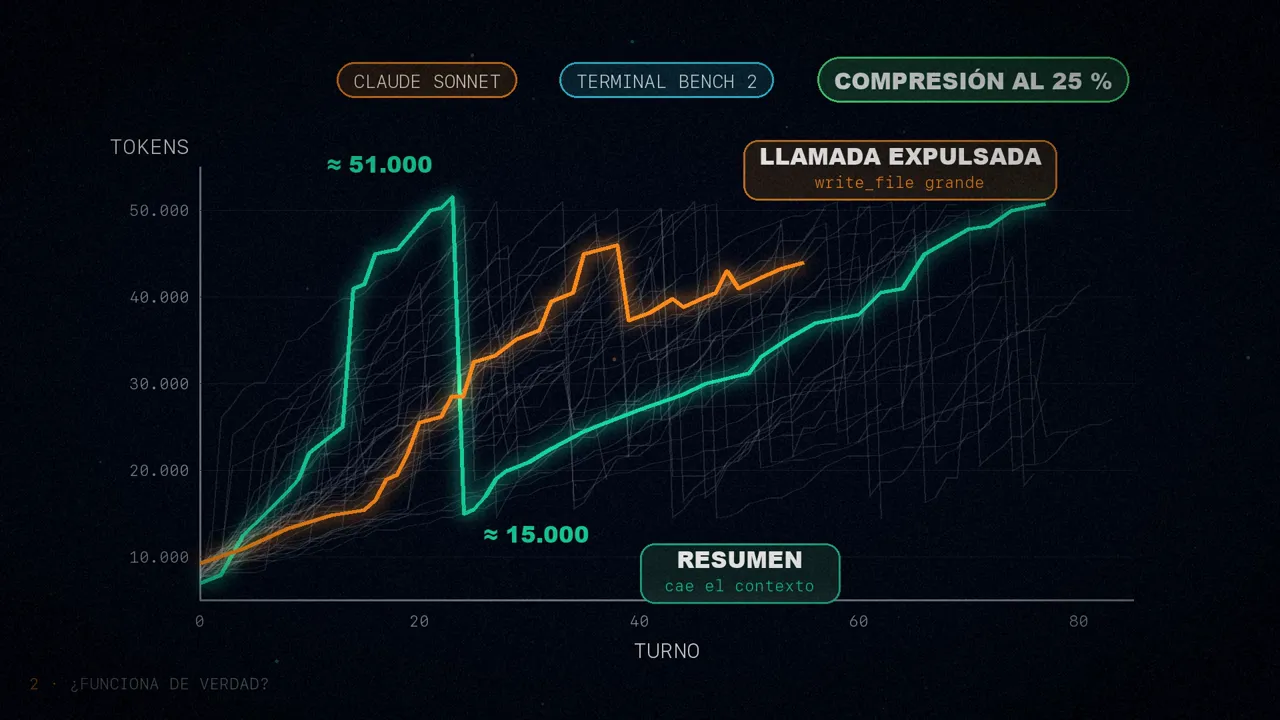
Más eventos, más datos para estudiarlos. Las cifras de las caídas las he leído de la figura, porque el artículo solo dice «hacia el turno 20» y «hacia el turno 40».
Evaluaciones dirigidas
Además, Deep Agents tiene un conjunto de evaluaciones dirigidas: pruebas pequeñas a propósito, en las que cada una aísla un mecanismo de la compresión. Así, cuando algo falla, el fallo salta a la vista y es fácil de depurar.
No buscan medir lo bien que el agente resuelve tareas en general, sino comprobar que el arnés no le estorba. Dos ejemplos:
Fuerzan un resumen a mitad de tarea y miran si el agente sigue adelante. No basta con guardar el estado: también tiene que mantener el rumbo.
Esconden un dato al principio de la conversación, como una aguja en un pajar, fuerzan un resumen y más tarde la tarea exige ese dato. Ya no está en el contexto: solo puede encontrarlo buscando en el disco.
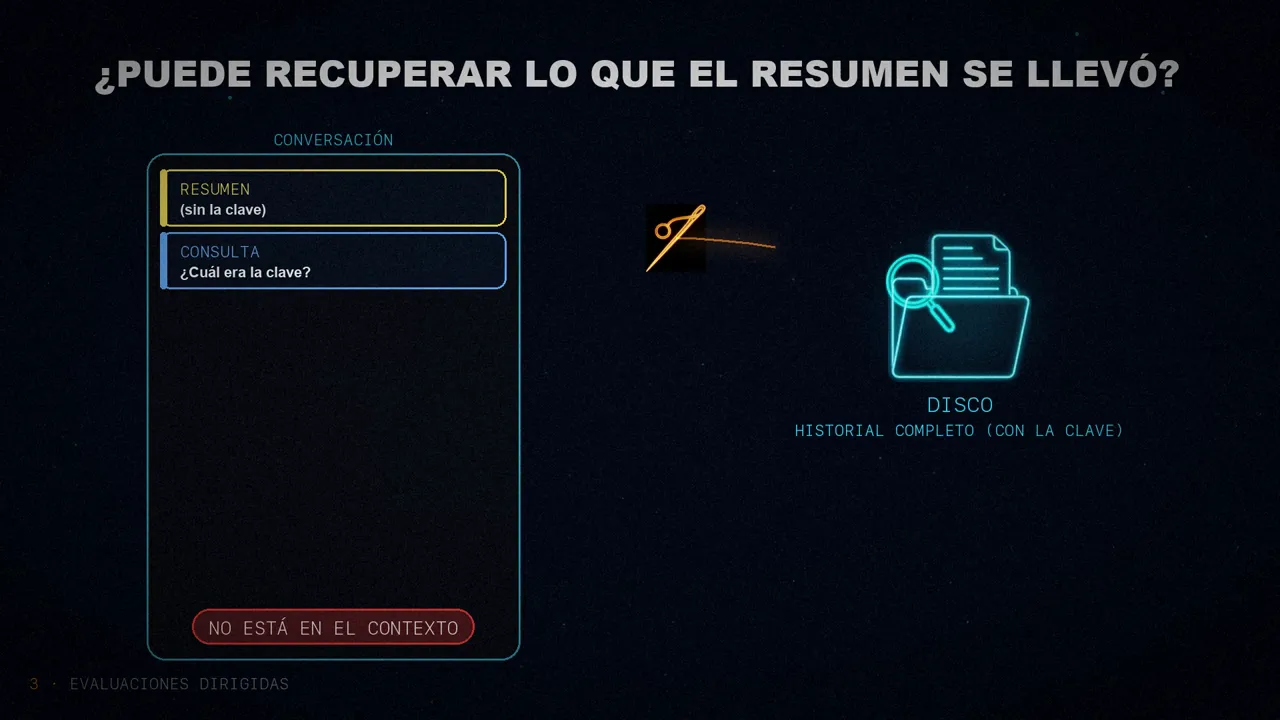
Son como tests de integración de la gestión del contexto. No sustituyen a los benchmarks completos, pero aceleran mucho cada iteración, y cuando algo falla sabes qué mecanismo ha sido, en vez de culpar al agente en general.
Tres consejos para evaluar tu compresión
El artículo termina con tres consejos para quien quiera evaluar sus propias estrategias de compresión:
Mide tu arnés con tareas representativas para tener una línea base. Después fuerza la compresión, al 10 o 20 % en vez del 85 %, y compara alternativas.
Comprimir solo sirve si lo crítico sigue a mano. Prueba que el agente sigue hacia su objetivo y que recupera detalles concretos, como la aguja.
El fallo más traicionero: tras un resumen, el agente pierde de vista lo que querías. Pide aclaraciones que no hacían falta o da la tarea por terminada sin acabarla.
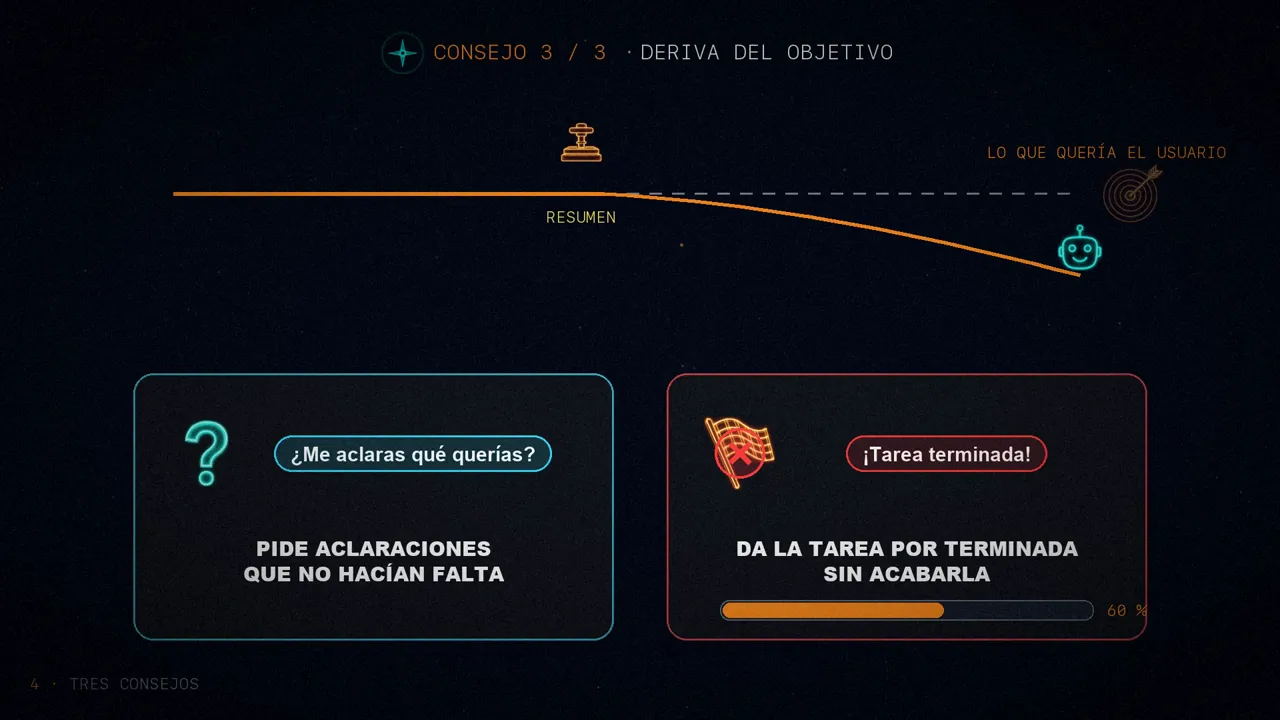
Hay desviaciones más sutiles, difíciles de achacar al resumen. Forzar resúmenes frecuentes en un conjunto de pruebas ayuda a sacarlas a la luz.
En resumen
Deep Agents gestiona el contexto en tres escalones: saca al disco las respuestas enormes, recorta las llamadas antiguas y, como último recurso, resume sin borrar nada. Todo su arnés es de código abierto, así que puedes probarlo.
Para saber si tu compresión funciona, no esperes a que salte sola: fuérzala y pruébala con tests pequeños.
¿Qué hacen tus agentes cuando se les llena la memoria?
Fuentes
- «Context Management for Deep Agents», de Chester Curme y Mason Daugherty (LangChain), 28 de enero de 2026.
- El código de Deep Agents, donde están el umbral de 20.000 tokens, el 85 % y las rutas de los archivos:
langchain-ai/deepagents. - La PR que añadió las secciones nuevas al prompt de resumen: langchain#34754.
- El vídeo, en mis tres canales: español, inglés y portugués.