Por que é preciso gerenciar o contexto
Os agentes encaram tarefas cada vez mais longas. E quanto mais dura uma tarefa, mais coisas o agente acumula na sua janela de contexto: mensagens, chamadas de ferramentas, as respostas delas, arquivos lidos…
Isso traz dois problemas. O primeiro é óbvio: a janela do modelo é finita. O segundo chega muito antes de enchê-la: com tanto texto, o modelo aproveita pior o que importa. É a deterioração do contexto, ou context rot.
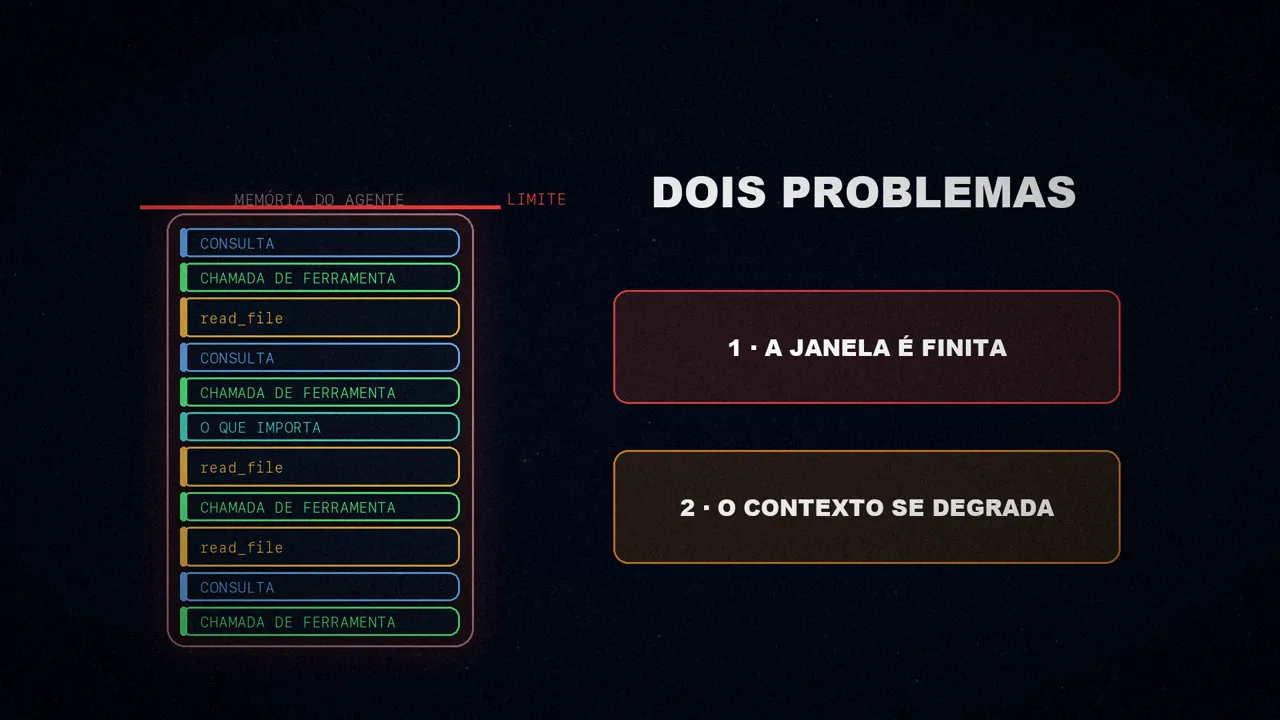
A solução é comprimir o contexto: reduzir o que o agente guarda na memória de trabalho sem perder os detalhes de que ele precisa para terminar a tarefa. Pode ser resumir o que já aconteceu, tirar informação desatualizada ou decidir com cuidado o que fica e o que sai.
O Deep Agents e seu sistema de arquivos
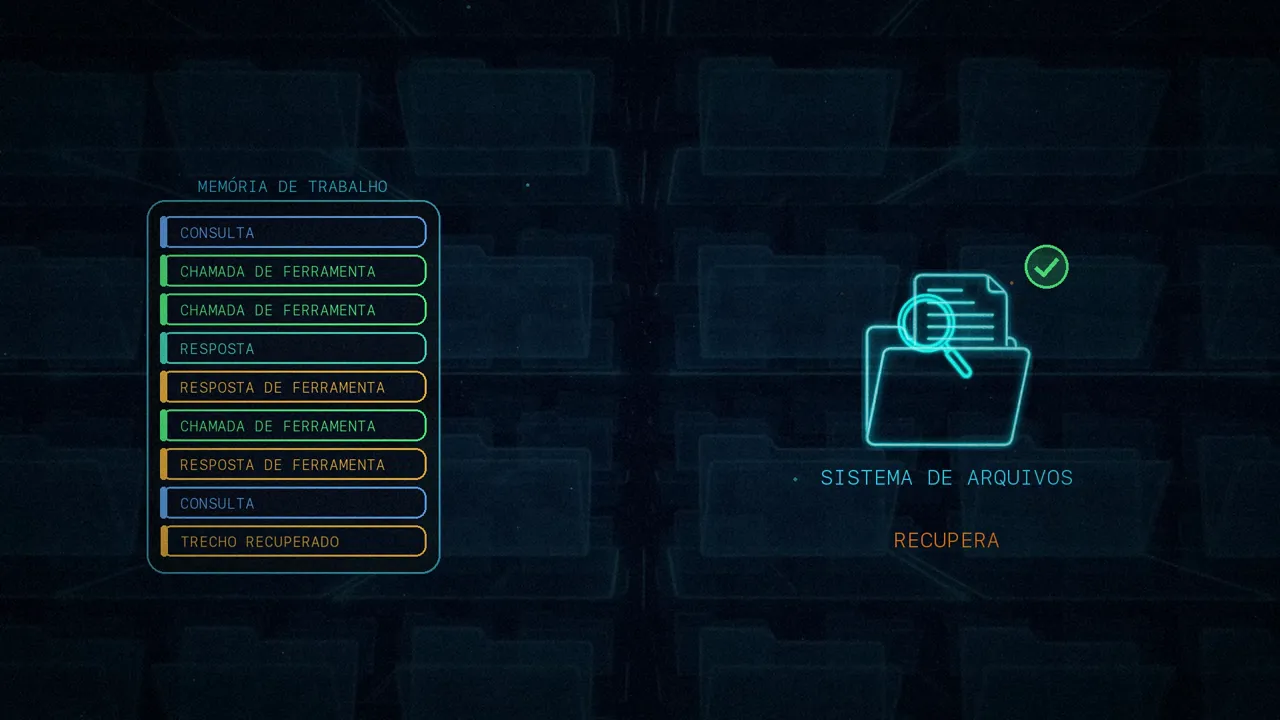
O Deep Agents é o arnês de agentes da LangChain: de código aberto e com tudo o que é preciso já incluído (em inglês, batteries included). Com ele, um agente pode planejar, criar subagentes e trabalhar com um sistema de arquivos para executar tarefas complexas e longas.
Esse sistema de arquivos é a peça-chave de toda a gestão do contexto. O agente tem ferramentas para listar, ler, escrever e buscar arquivos, e até executá-los. Assim, o que sai da memória de trabalho não se perde: vai para o disco, e o agente procura e recupera quando precisa.
Três técnicas, três ritmos
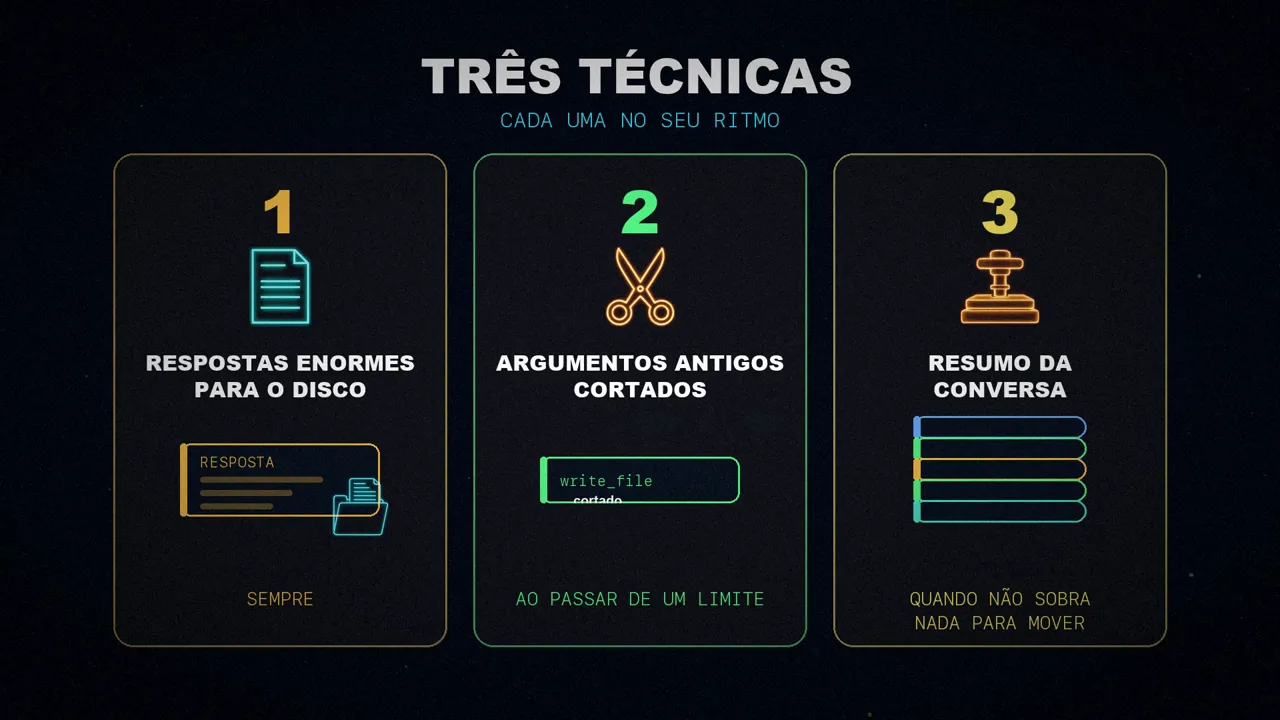
Sobre essa base, o Deep Agents comprime o contexto com três técnicas, cada uma no seu ritmo:
Move para o disco as respostas enormes das ferramentas assim que aparecem.
Tira do histórico os argumentos grandes das chamadas antigas quando o contexto passa de um limite.
Resume a conversa quando já não sobra nada para mover para o disco.
Os limites não são um número fixo de tokens, e sim frações da janela de cada modelo. A LangChain guarda perfis de modelo com o máximo de tokens que cada um aceita, e o Deep Agents comprime quando o contexto chega a uma certa porcentagem desse valor.
1. As respostas grandes vão para o disco
Quando o agente lê um arquivo enorme ou consulta um serviço web, a resposta da ferramenta pode ser tão grande que nem cabe na janela do modelo.
Por isso, quando o Deep Agents detecta uma resposta de mais de 20.000 tokens, ele a salva num arquivo no disco. No contexto, deixa só o caminho desse arquivo e uma prévia com as dez primeiras linhas. Se depois precisar de mais, o agente volta a ler o arquivo ou busca nele o que interessa: a resposta completa continua ao seu alcance, mas já não ocupa a memória de trabalho.
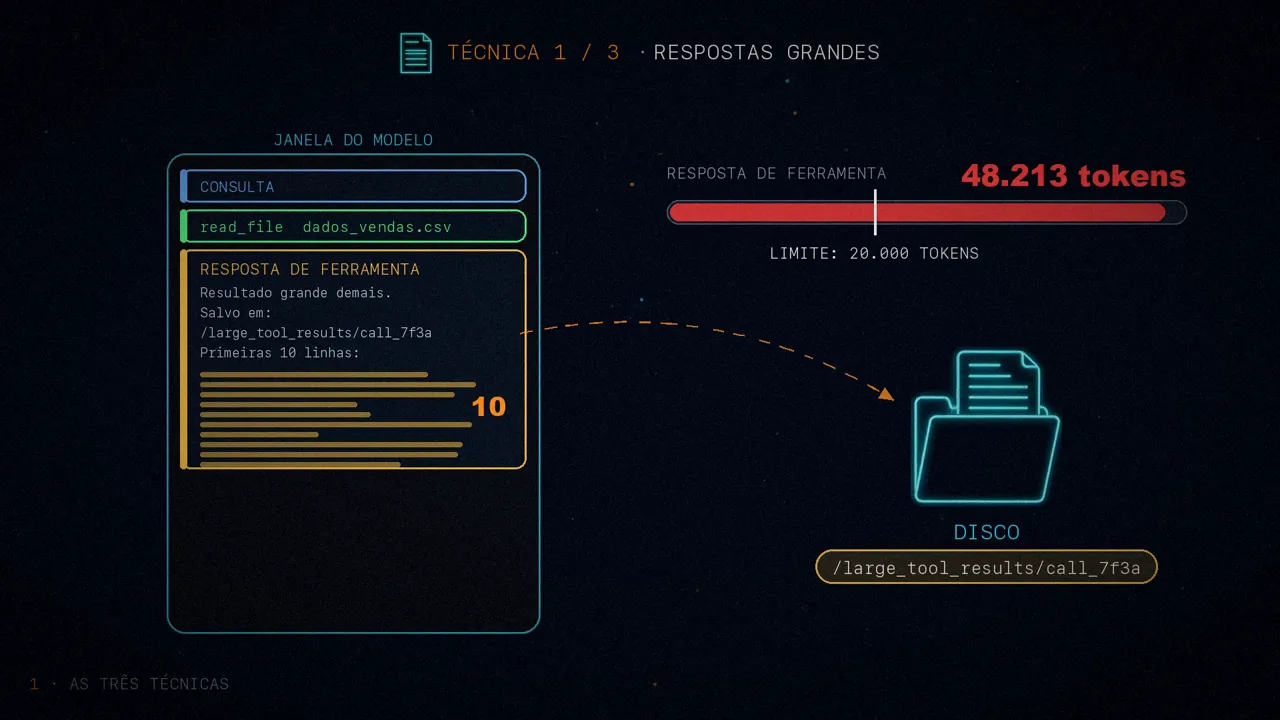
Um detalhe que conferi no código do Deep Agents: o limite de 20.000 tokens e a pasta /large_tool_results/ batem com o artigo, mas a versão atual já não mostra só o começo, e sim o começo e o final da resposta.
2. Cortar as entradas grandes
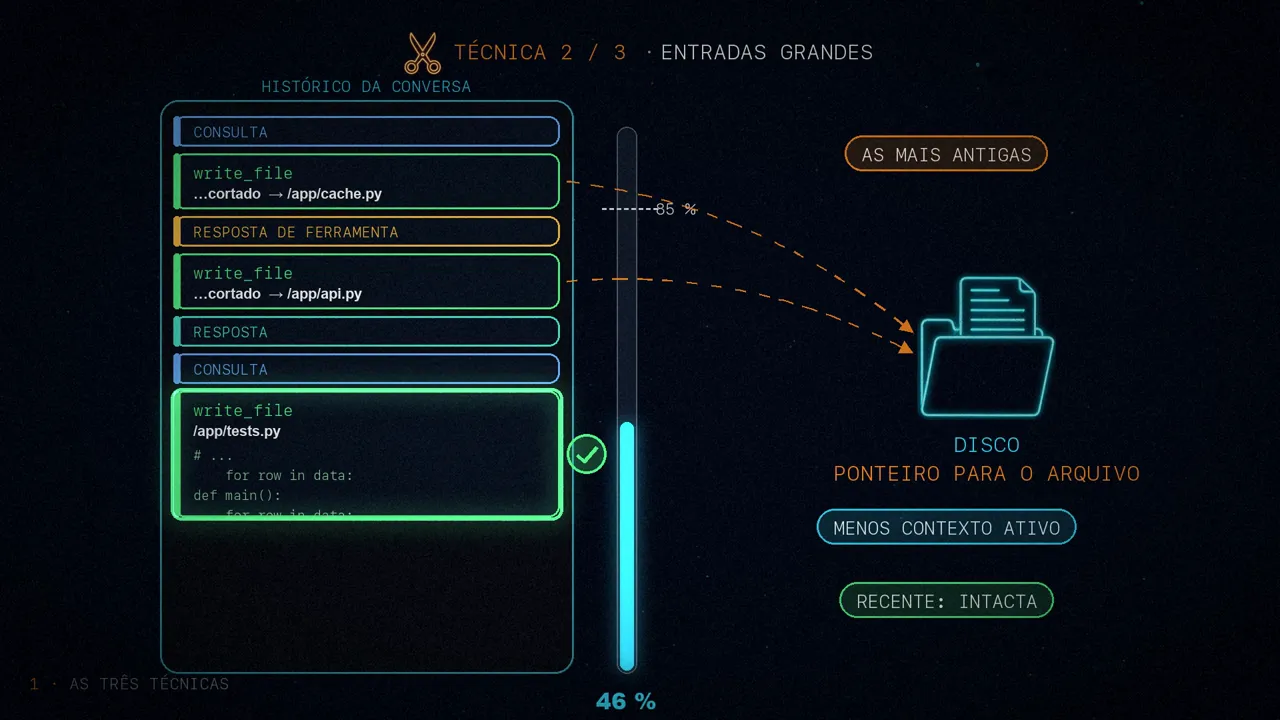
A segunda técnica olha para o outro lado: não para o que as ferramentas devolvem, mas para o que elas recebem. Quando o agente escreve ou edita um arquivo, a chamada da ferramenta leva dentro o conteúdo completo, e ele fica no histórico da conversa.
Mas esse conteúdo já está salvo no disco. Mantê-lo também no histórico é redundante: podem ser quinhentas linhas de código ocupando espaço turno após turno. Então, quando a conversa passa de 85% da janela, o Deep Agents corta as chamadas mais antigas: troca o conteúdo delas por um ponteiro para o arquivo no disco, e o contexto ativo emagrece. O mais recente fica como está.
3. Resumir sem apagar nada
Quando tirar coisas para o disco já não libera espaço suficiente, o Deep Agents recorre ao resumo, em duas partes:
- Um resumo na memória: um modelo de linguagem escreve um resumo estruturado da conversa, com a intenção da sessão, os artefatos criados e os próximos passos. Esse resumo substitui o histórico completo na memória de trabalho do agente.
- O histórico completo, no disco: as mensagens originais são gravadas num arquivo, como registro canônico de tudo o que aconteceu. O resumo indica onde ele está, caso seja preciso voltar a ele.
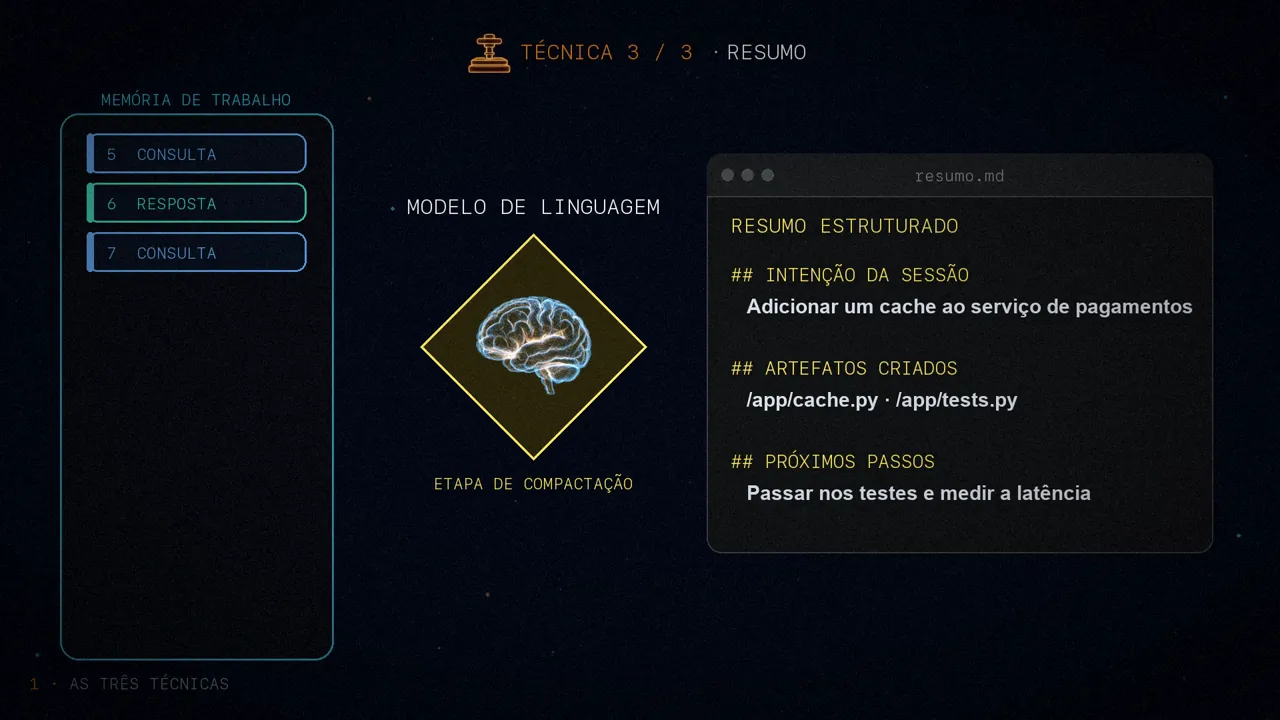
Com essa abordagem dupla, o agente sabe em que ponto está e para onde vai graças ao resumo, e se precisar de um detalhe específico ele recupera buscando no disco. O artigo mostra isso com um rastreamento real, em que o modelo usa a ferramenta read_file para trazer mensagens que já tinham sido resumidas.
Como saber se funciona?
Essa é a maquinaria. Mas, para mim, a parte mais interessante do artigo é a segunda: como saber se ela funciona de verdade? Em tarefas reais, como as do Terminal Bench, a compressão só dispara de vez em quando. Com tão poucos eventos, é difícil isolar o que cada técnica traz.
O truque da LangChain é provocá-la. Se você resume ao chegar a 10 ou 20% da janela, o agente rende um pouco pior no geral, mas resume muitíssimas vezes mais. Não é uma configuração para produção, e sim para testar: com tantos eventos, já dá para comparar configurações diferentes, por exemplo, duas versões do seu prompt de resumo.
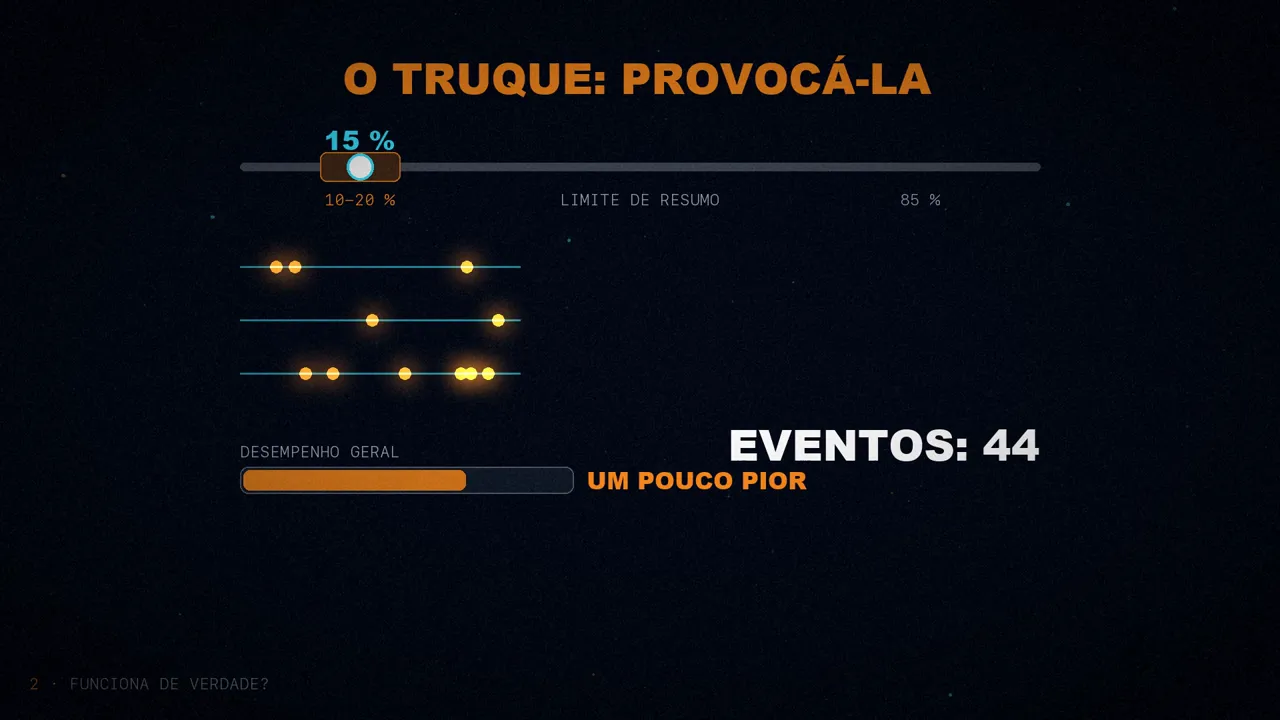
Foi assim que encontraram uma melhoria simples: o agente funcionava melhor ao acrescentar ao prompt de resumo duas seções próprias, a intenção da sessão e os próximos passos. Na PR da LangChain que mudou esse prompt, o novo fica com quatro seções: intenção da sessão, resumo, artefatos e próximos passos.
O gráfico
O artigo ilustra isso com um gráfico: execuções do Claude Sonnet 4.5 no Terminal Bench 2, comprimindo a 25% da janela em vez dos 85% padrão. Cada linha acompanha os tokens do contexto turno a turno.
- A linha verde: passado o turno 20, um resumo afunda o contexto de uma vez, de uns 50.000 tokens para uns 15.000.
- A linha laranja: perto do turno 40, a queda é menor. Não é um resumo: uma chamada que escrevia um arquivo grande é expulsa do contexto.
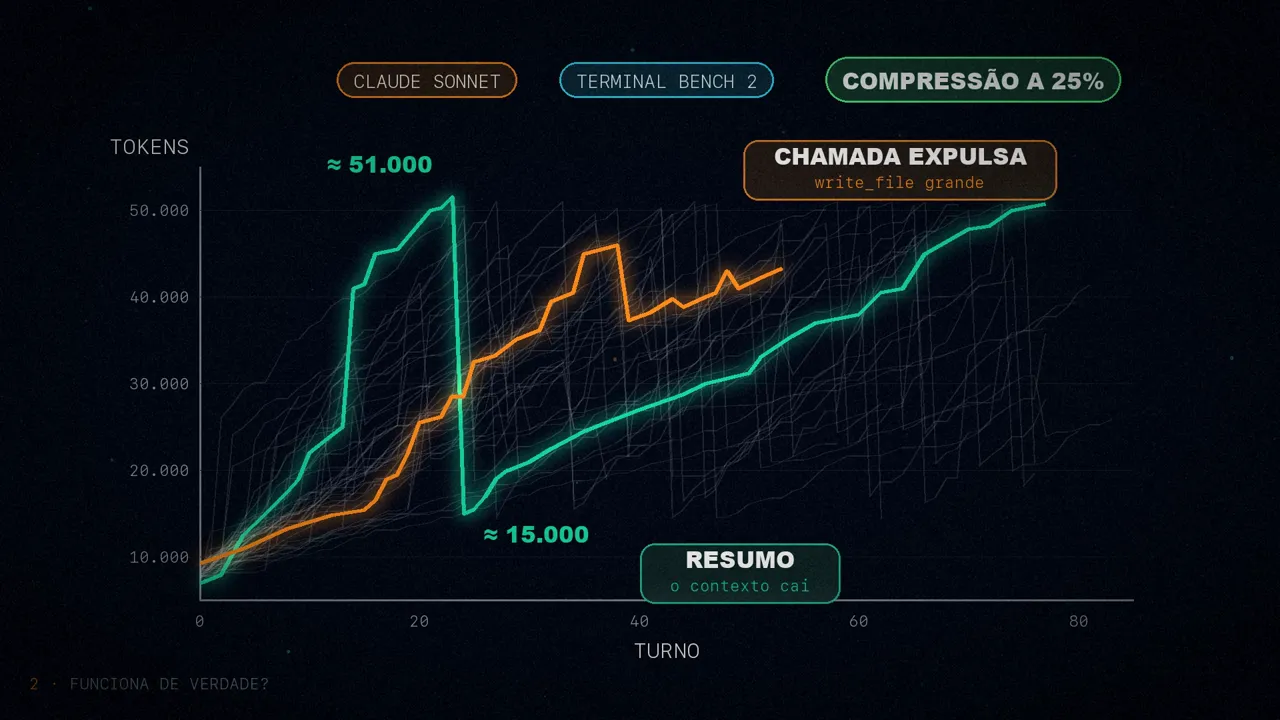
Mais eventos, mais dados para estudá-los. Os números das quedas eu li na figura, porque o artigo só diz "por volta do turno 20" e "por volta do turno 40".
Avaliações dirigidas
Além disso, o Deep Agents tem um conjunto de avaliações dirigidas: testes pequenos de propósito, em que cada um isola um mecanismo da compressão. Assim, quando algo falha, a falha salta aos olhos e fica fácil depurar.
Elas não buscam medir o quanto o agente resolve bem tarefas em geral, mas comprovar que o arnês não atrapalha. Dois exemplos:
Forçam um resumo no meio da tarefa e veem se o agente segue em frente. Não basta guardar o estado: ele também tem que manter o rumo.
Escondem um dado no começo da conversa, como uma agulha num palheiro, forçam um resumo e, mais tarde, a tarefa exige esse dado. Ele já não está no contexto: o agente só consegue encontrá-lo buscando no disco.
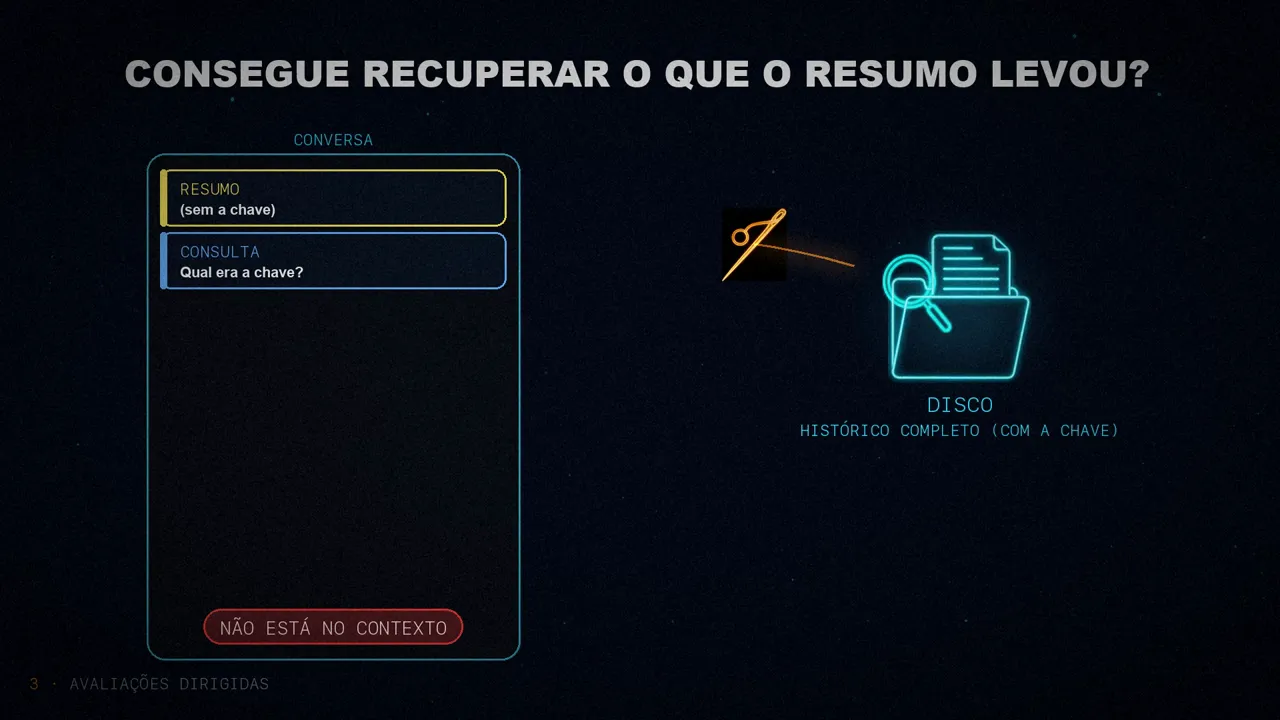
São como testes de integração da gestão do contexto. Não substituem os benchmarks completos, mas aceleram muito cada iteração, e quando algo falha você sabe qual mecanismo foi, em vez de culpar o agente em geral.
Três conselhos para avaliar sua compressão
O artigo termina com três conselhos para quem quer avaliar suas próprias estratégias de compressão:
Meça o seu arnês com tarefas representativas para ter uma linha de base. Em seguida, force a compressão, a 10 ou 20% em vez de 85%, e compare alternativas.
Comprimir só serve se o que é crítico estiver à mão. Teste se o agente segue rumo ao objetivo e se resgata detalhes específicos, como a agulha.
A falha mais traiçoeira: depois de um resumo, o agente perde de vista o que você queria. Pede esclarecimentos desnecessários ou dá a tarefa por concluída sem terminá-la.
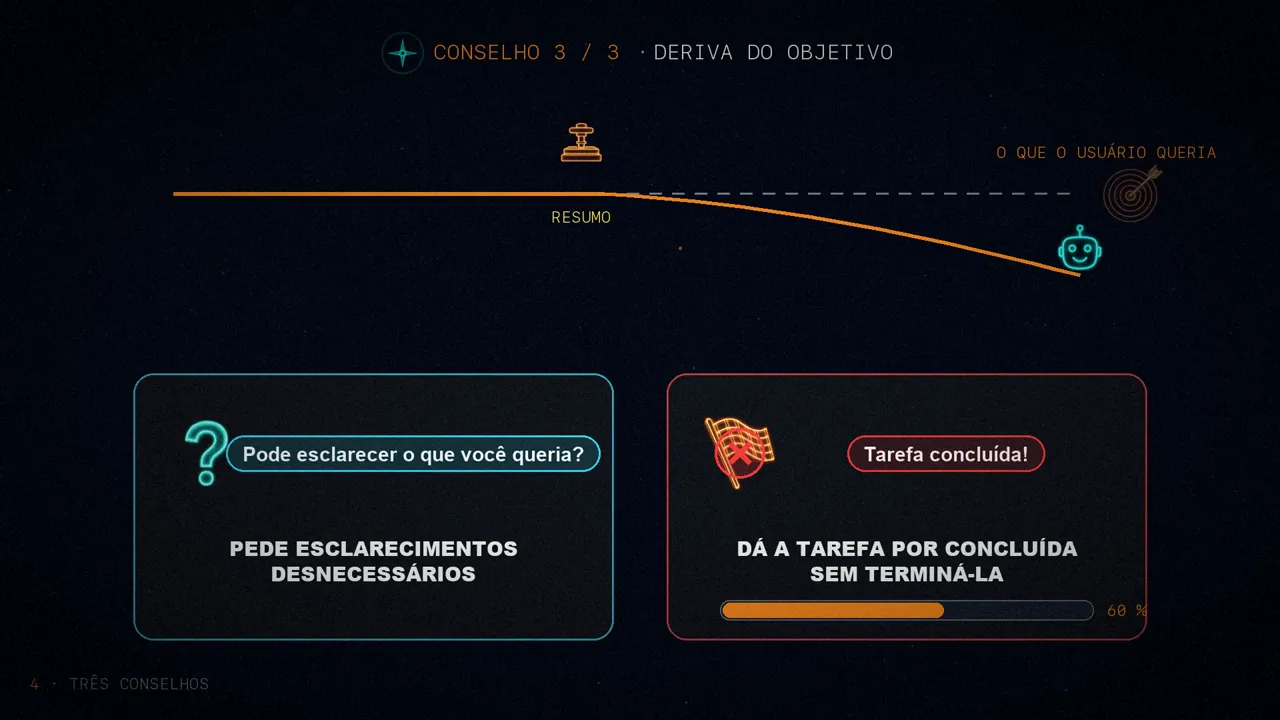
Há desvios mais sutis, difíceis de atribuir ao resumo. Forçar resumos frequentes num conjunto de testes ajuda a trazê-los à tona.
Resumindo
O Deep Agents gerencia o contexto em três degraus: tira para o disco as respostas enormes, corta as chamadas antigas e, como último recurso, resume sem apagar nada. Todo o arnês é de código aberto, então dá para testá-lo.
Para saber se a sua compressão funciona, não espere que ela dispare sozinha: force-a e teste com testes pequenos.
O que os seus agentes fazem quando a memória deles enche?
Fontes
- "Context Management for Deep Agents", de Chester Curme e Mason Daugherty (LangChain), 28 de janeiro de 2026.
- O código do Deep Agents, com o limite de 20.000 tokens, os 85% e os caminhos dos arquivos:
langchain-ai/deepagents. - A PR que acrescentou as seções novas ao prompt de resumo: langchain#34754.
- O vídeo, nos meus três canais: espanhol, inglês e português.