Cuando RAG se queda corto
El asistente de Mintlify funcionaba con RAG, la generación aumentada por recuperación: buscaba los trozos de texto más parecidos a la pregunta y respondía con ellos. El artículo arranca con una frase que lo resume todo: RAG funciona muy bien… hasta que deja de funcionar.
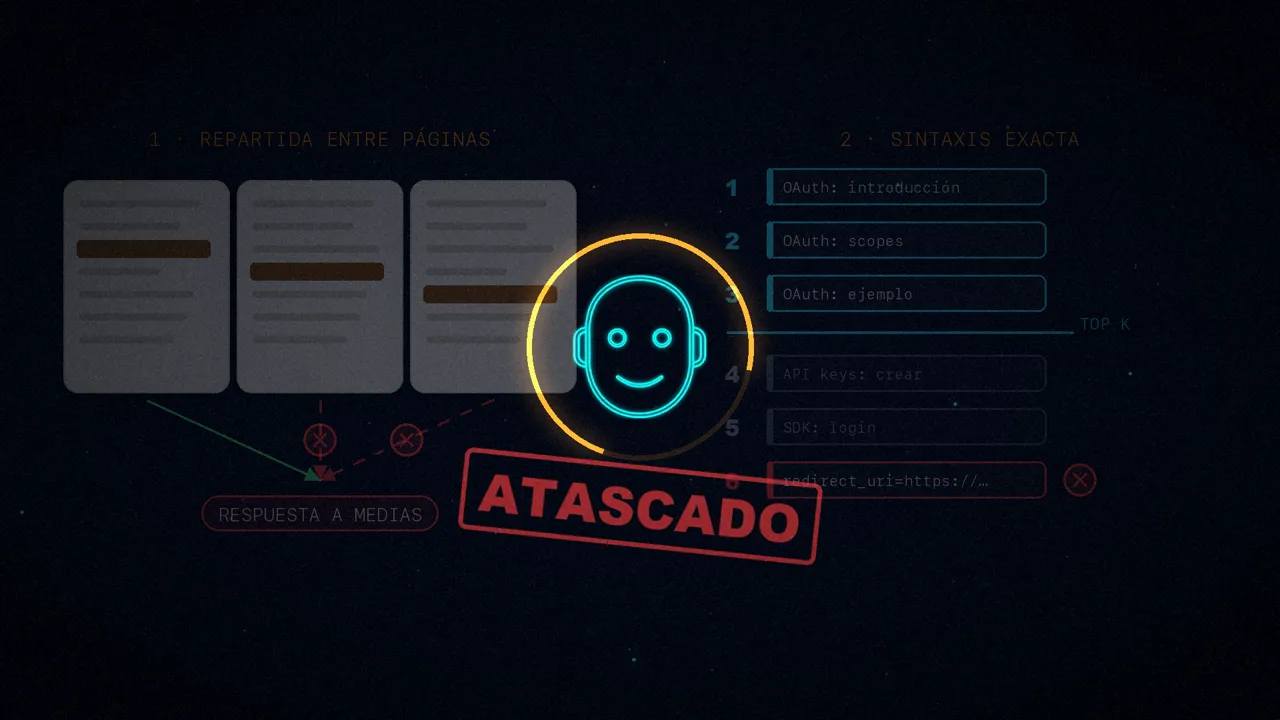
Falla en dos casos. Cuando la respuesta está repartida entre varias páginas. Y cuando el usuario necesita la sintaxis exacta de algo, y ese trozo no aparece entre los primeros resultados de la búsqueda (el famoso top-K). En los dos, el asistente se quedaba atascado.
La documentación, como un repositorio
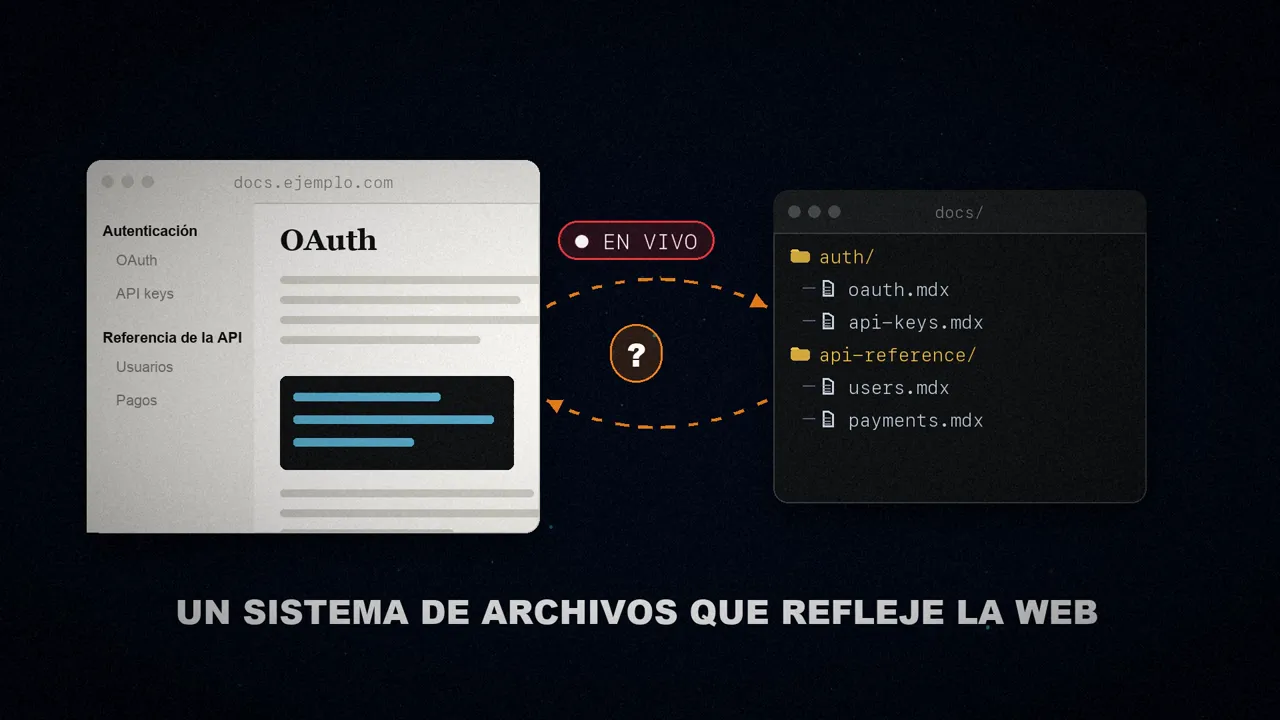
Querían que el asistente se moviera por la documentación como se mueve un agente por un repositorio de código. Y los agentes ya tienen una interfaz favorita para eso: el sistema de archivos. Según el artículo, están convergiendo en él porque grep, cat, ls y find es todo lo que necesitan.
La idea es sencilla: cada página de la documentación es un archivo y cada sección, una carpeta. Así el agente busca textos exactos, lee páginas enteras y recorre la estructura por su cuenta. Solo les faltaba un sistema de archivos que reflejara, en vivo, la web de documentación.
El cuello de botella del contenedor
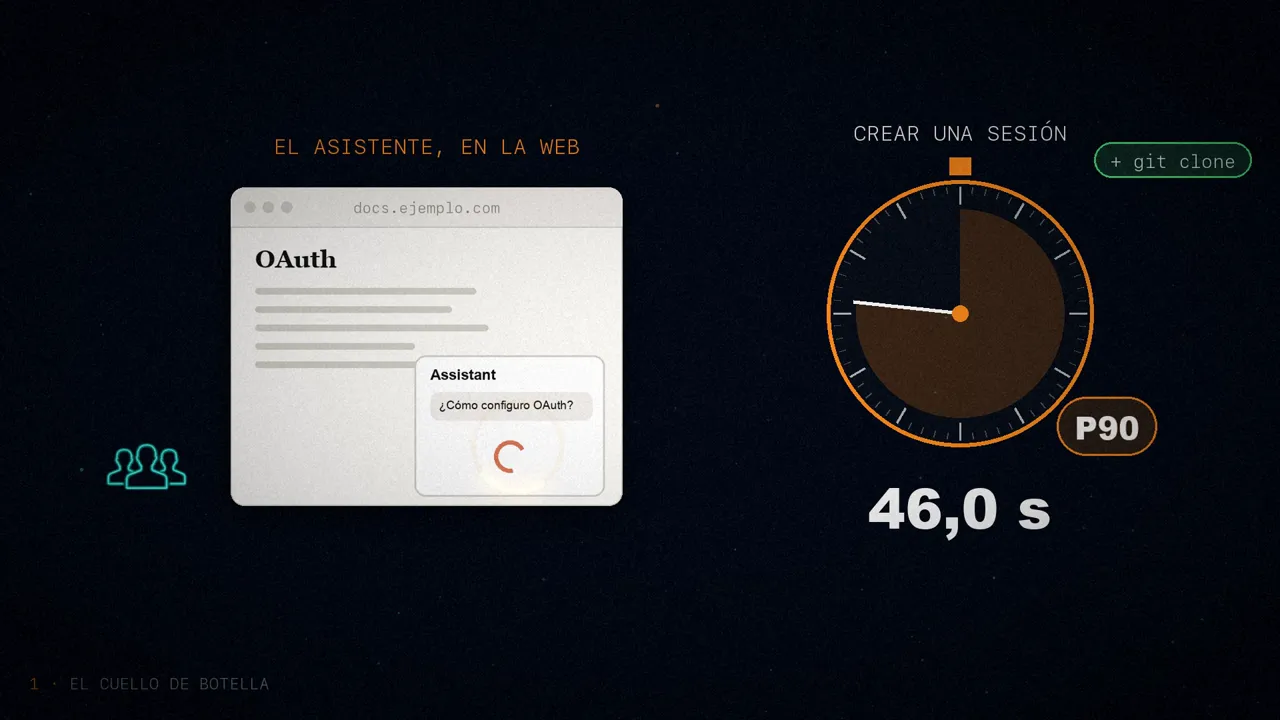
Lo obvio es darle al agente un sistema de archivos de verdad. Es lo que hacen casi todos los arneses: levantan un entorno aislado, un sandbox, y clonan dentro el repositorio. Mintlify ya lo hace con sus agentes en segundo plano, donde la latencia da igual. Pero este asistente vive en la web, con un usuario mirando cómo gira el icono de carga.
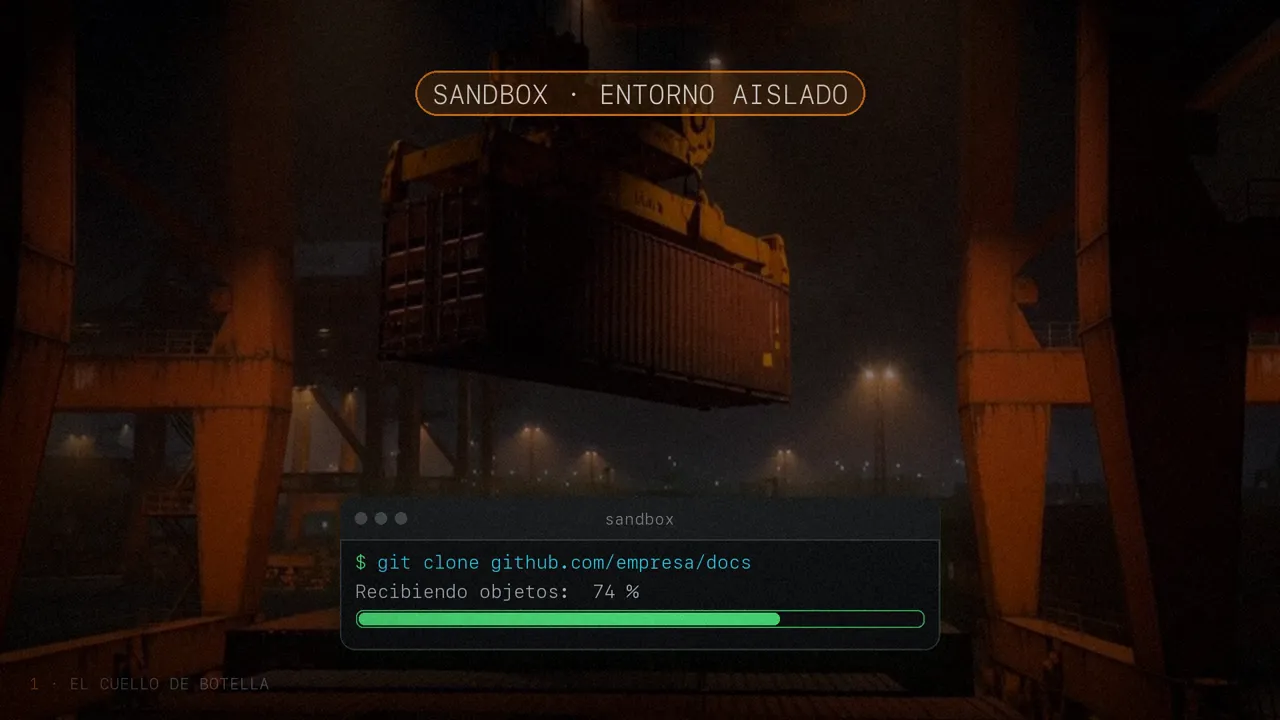
Crear cada sesión, con el clon de GitHub incluido, tardaba unos 46 segundos en el percentil 90. Es decir, nueve de cada diez sesiones tardaban menos, pero el resto, todavía más: casi un minuto mirando una ruedita, solo para empezar a leer documentación.
Además está la factura. El artículo hace la cuenta: 850.000 conversaciones al mes, cada una con su propia micro máquina virtual. Aunque sea mínima (1 vCPU, 2 GiB de memoria y 5 minutos de vida), con los precios por segundo de Daytona (0,0504 $/h por vCPU y 0,0162 $/h por GiB) sale a unos 0,0069 $ por conversación: más de 70.000 $ al año. Con sesiones más largas, el doble: unos 0,0137 $ por conversación, la cifra de su tabla comparativa.
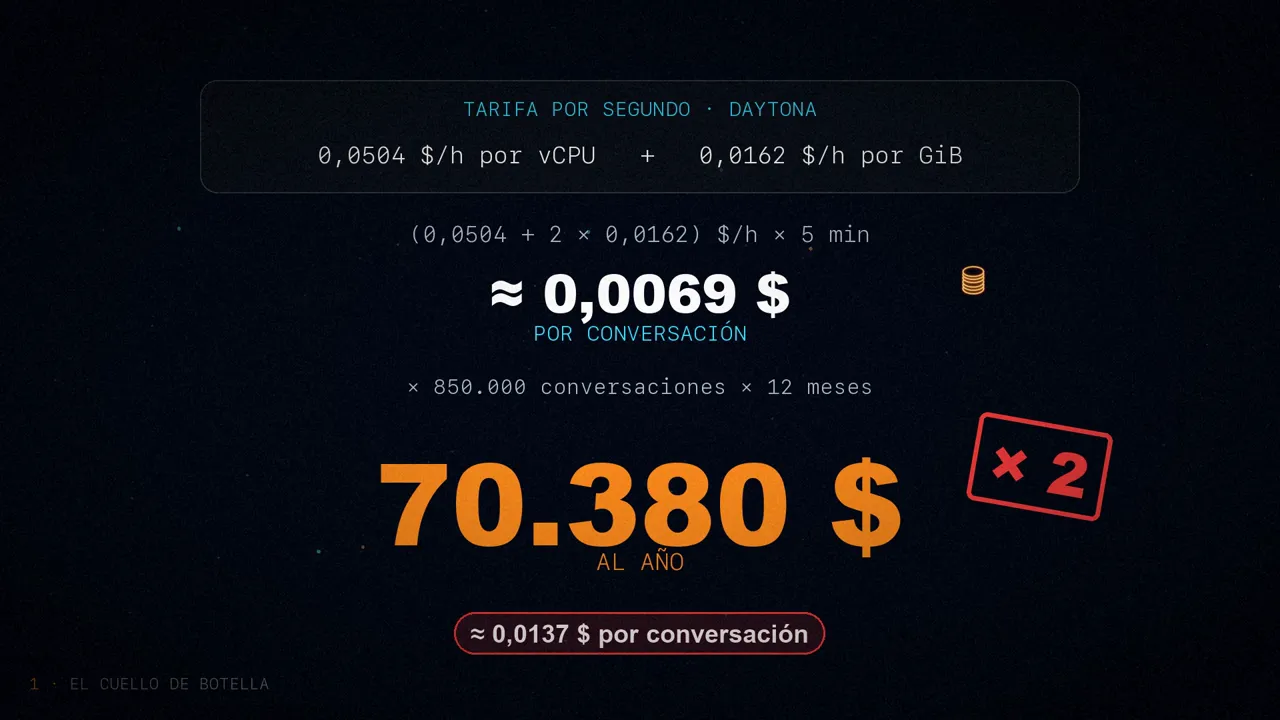
Ellos mismos reconocen que es una cuenta ingenua: en producción habría máquinas precalentadas y contenedores compartidos. Pero la idea se mantiene. Para leer documentación estática, una máquina por conversación es lento y caro. Necesitaban algo instantáneo y barato, y eso obligaba a repensar el propio sistema de archivos.
Fingir una shell: ChromaFs
La clave es esta: el agente no necesita un sistema de archivos de verdad, le basta con la ilusión de uno. Y Mintlify ya tenía toda su documentación troceada, indexada y guardada en Chroma, la base de datos que usa su buscador.
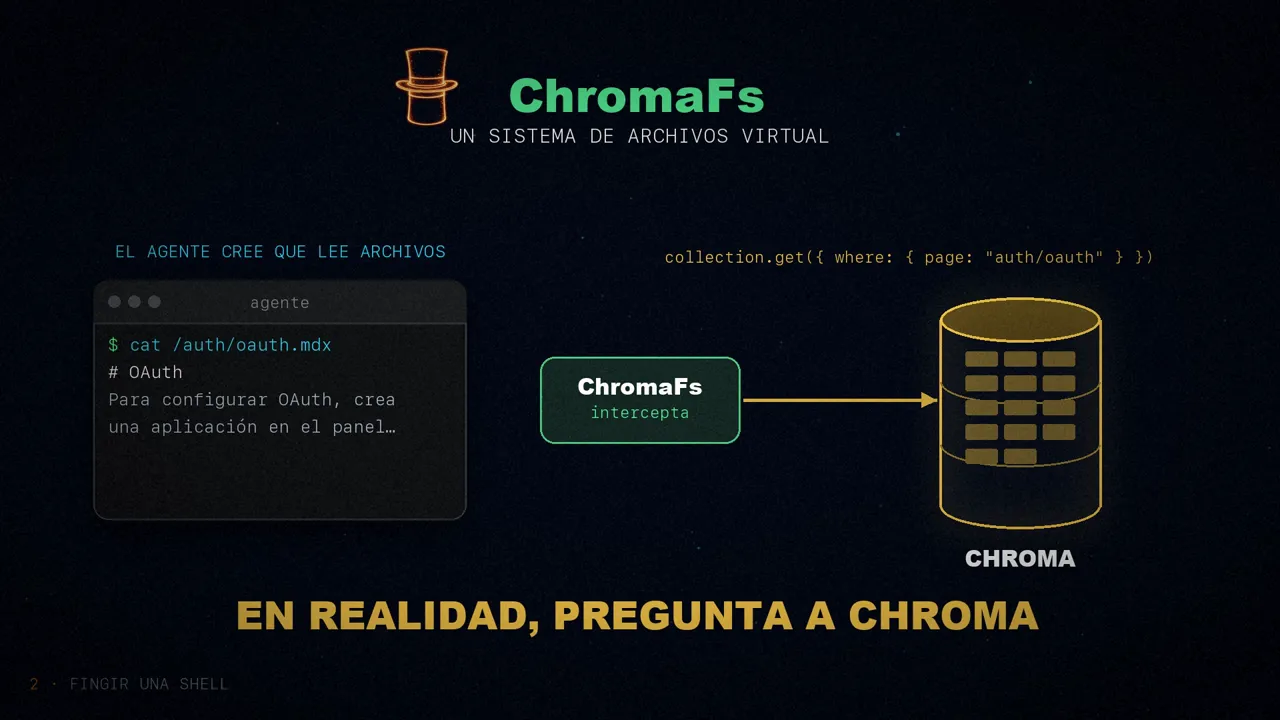
Así nació ChromaFs: un sistema de archivos virtual que intercepta los comandos de Unix que escribe el agente y los traduce a consultas sobre esa misma base de datos. El agente cree que está leyendo archivos; en realidad, le está preguntando a Chroma.
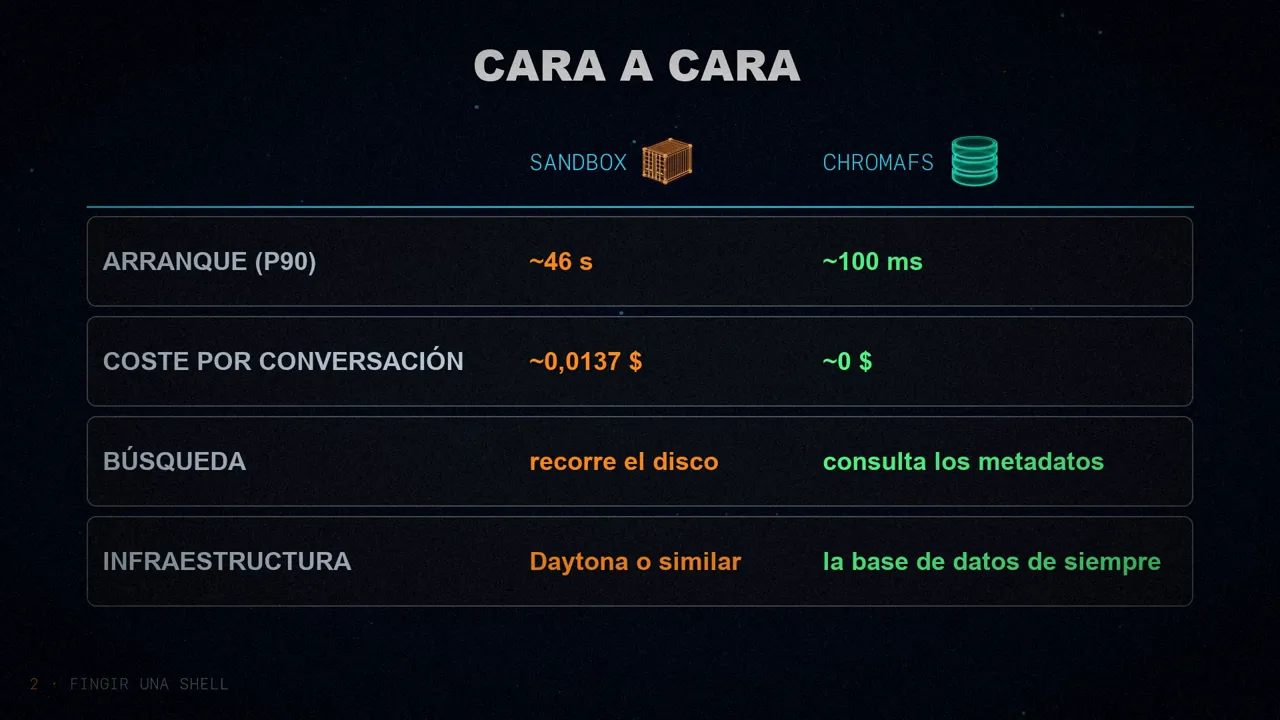
El resultado: crear una sesión pasó de unos 46 segundos a unos 100 milisegundos, unas 460 veces más rápido (esta cuenta es mía). Y como reutiliza una base de datos que ya pagaban, cada conversación nueva no añade coste de cómputo. Cara a cara:
- Arranque (p90): ~46 s
- Coste: ~0,0137 $ por conversación
- Búsqueda: recorre el disco archivo a archivo
- Infraestructura: Daytona o similar
- Arranque (p90): ~100 ms
- Coste: ~0 $, reutiliza la base de datos
- Búsqueda: una consulta a los metadatos
- Infraestructura: la base de datos que ya tenían
just-bash y las capas
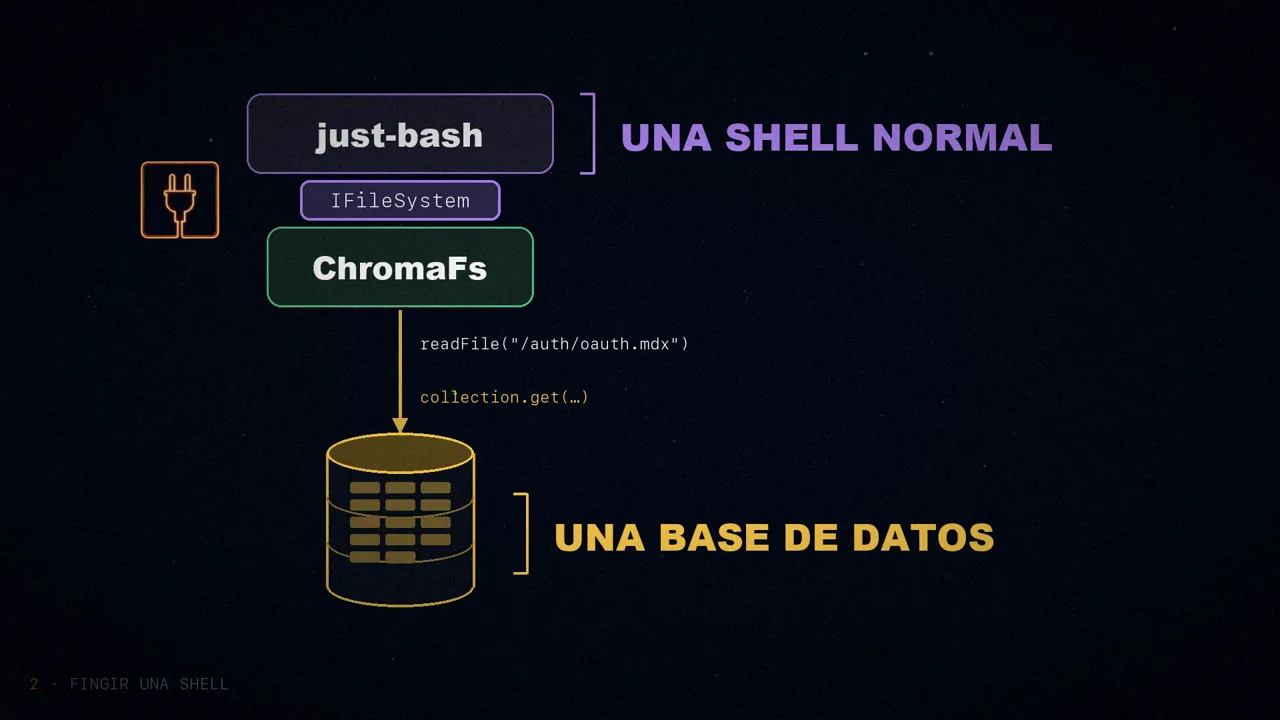
Por debajo, ChromaFs se apoya en just-bash, de Vercel Labs: una reimplementación de bash en TypeScript que entiende grep, cat, ls, find y cd. Se encarga de todo lo difícil: interpretar los comandos, las tuberías y las opciones.
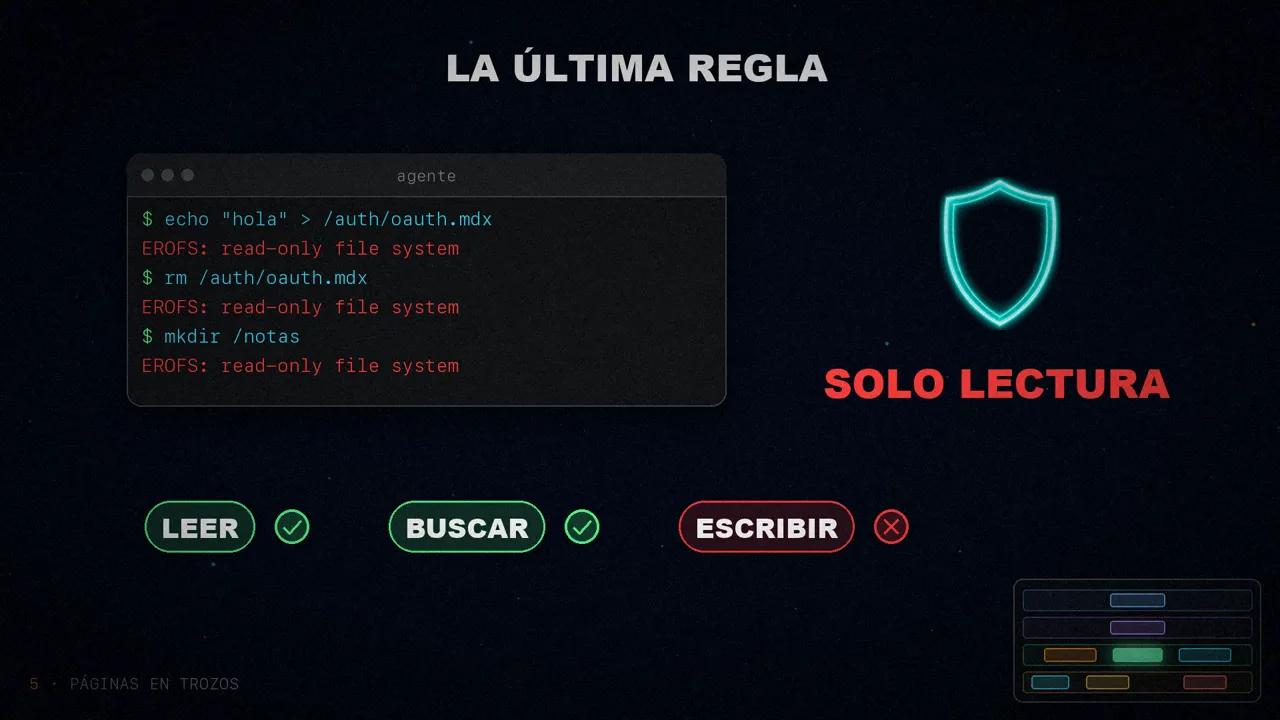
Y lo mejor: deja enchufar tu propio sistema de archivos a través de una interfaz, IFileSystem. ChromaFs la implementa, y cada llamada al disco se convierte en una consulta a Chroma. Por arriba, una shell normal; por abajo, una base de datos. En el código que enseña el artículo, readFile pide a Chroma todos los trozos de la página y los une, y writeFile, appendFile, mkdir y rm lanzan un error de solo lectura.
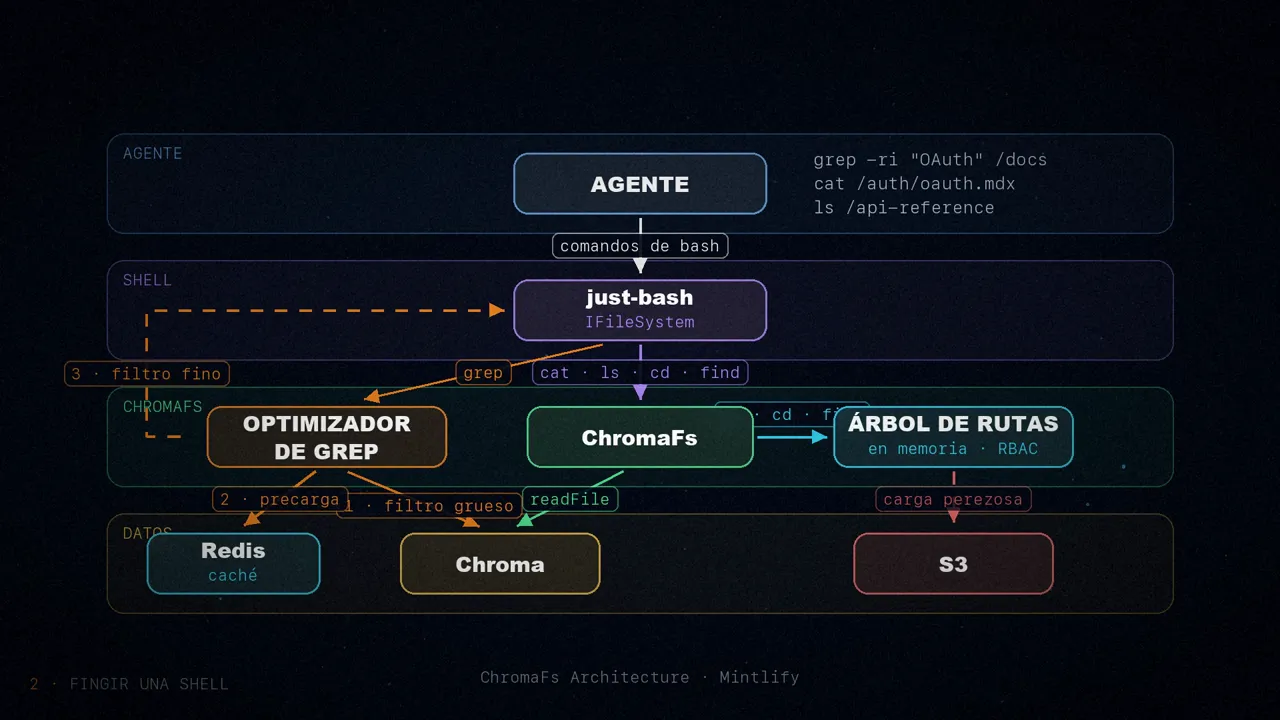
El diagrama del artículo lo resume en cuatro capas. Arriba, el agente escribe comandos de bash. Debajo, just-bash los interpreta. Después, ChromaFs los traduce. Y al fondo están los datos: Chroma, una caché en Redis y archivos en S3.
El árbol de carpetas
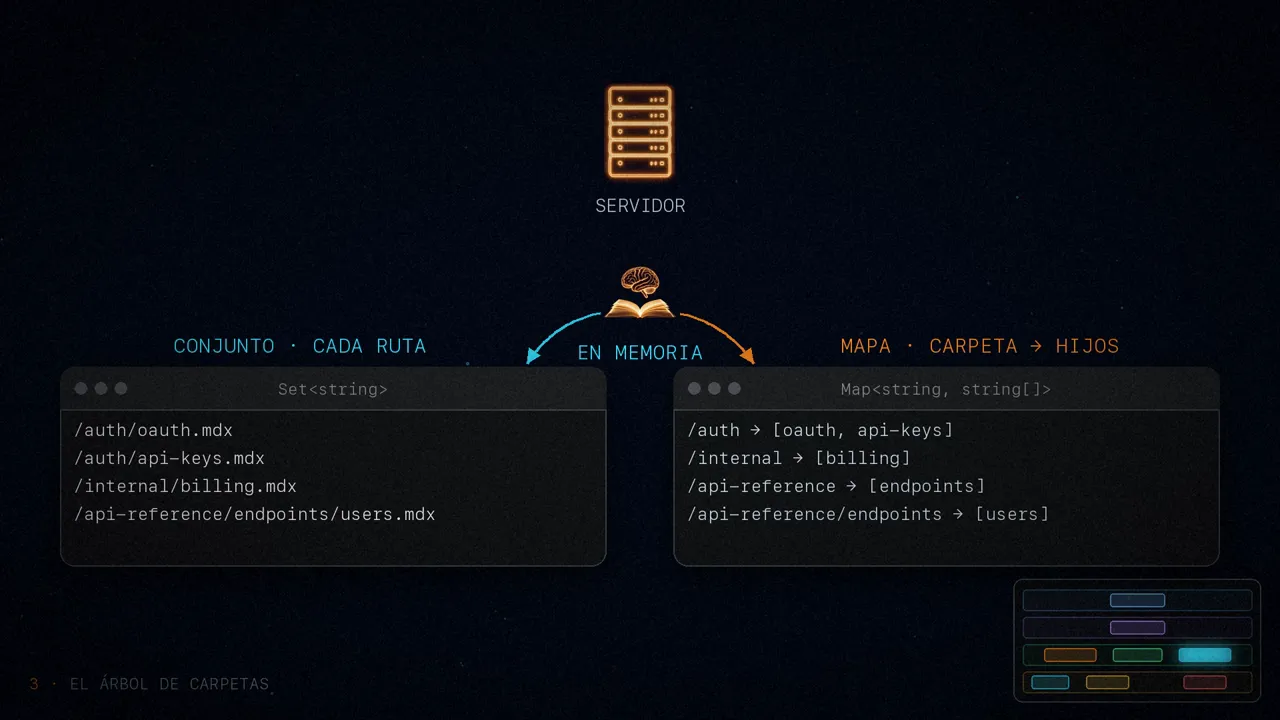
ChromaFs tiene que saber qué archivos existen antes de que el agente escriba un solo comando. Por eso guardan el árbol entero como un único documento JSON comprimido, __path_tree__, dentro de la propia colección de Chroma. Cada ruta lleva dos datos más: si es pública (isPublic) y a qué grupos pertenece (groups).
Al arrancar, el servidor lo descarga, lo descomprime y monta dos estructuras en memoria: un conjunto (Set<string>) con la ruta de cada archivo y un mapa (Map<string, string[]>) que dice qué hijos tiene cada carpeta. A partir de ahí, ls, cd y find se resuelven en la memoria local, sin tocar la red. Y como el árbol queda en caché, las siguientes sesiones del mismo sitio ni siquiera tienen que pedírselo a Chroma.
Control de acceso
Antes de construir el árbol, ChromaFs poda las rutas según el token de sesión del usuario, y aplica el mismo filtro a todas las consultas que vengan después. Si no tienes acceso a un archivo, ese archivo no existe: desaparece del árbol, y el agente no puede leerlo ni tampoco mencionarlo, porque para él esa ruta nunca ha estado ahí.
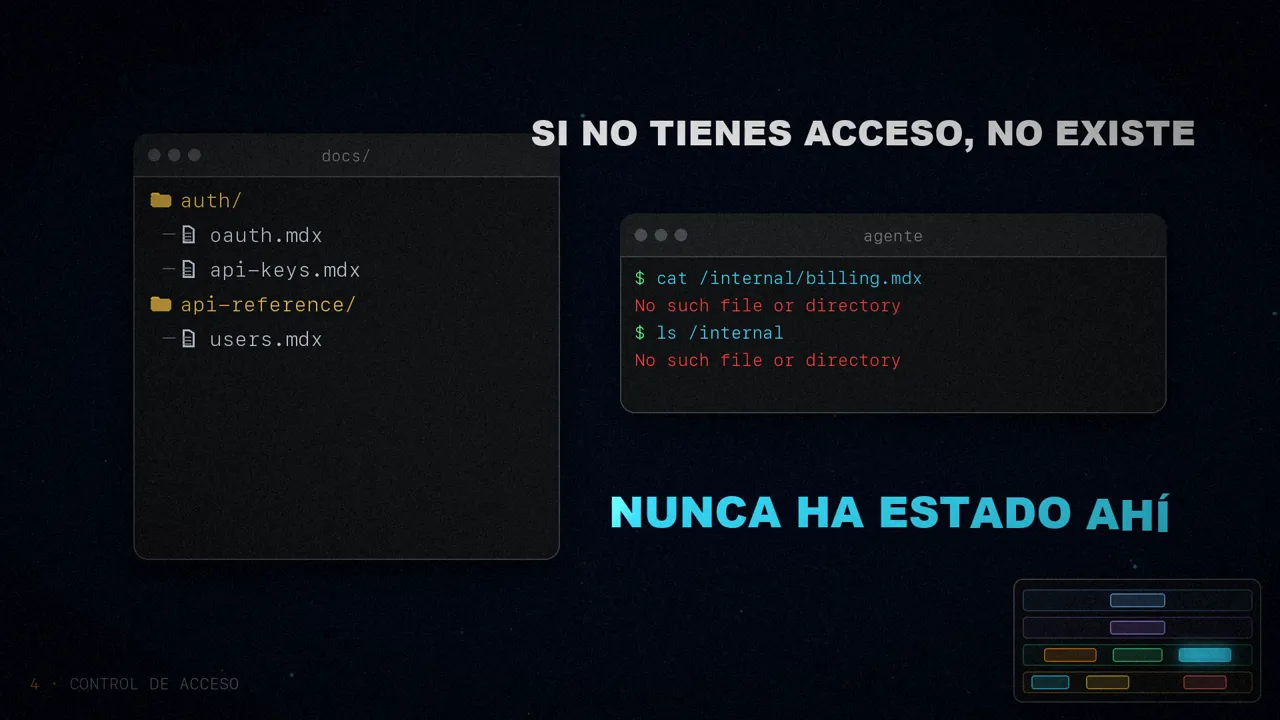
En un sandbox de verdad, esto obligaría a gestionar grupos de usuarios de Linux, permisos con chmod o una imagen de contenedor distinta para cada tipo de cliente. En ChromaFs son unas pocas líneas de filtro antes de construir el árbol.
Páginas en trozos, caché y solo lectura
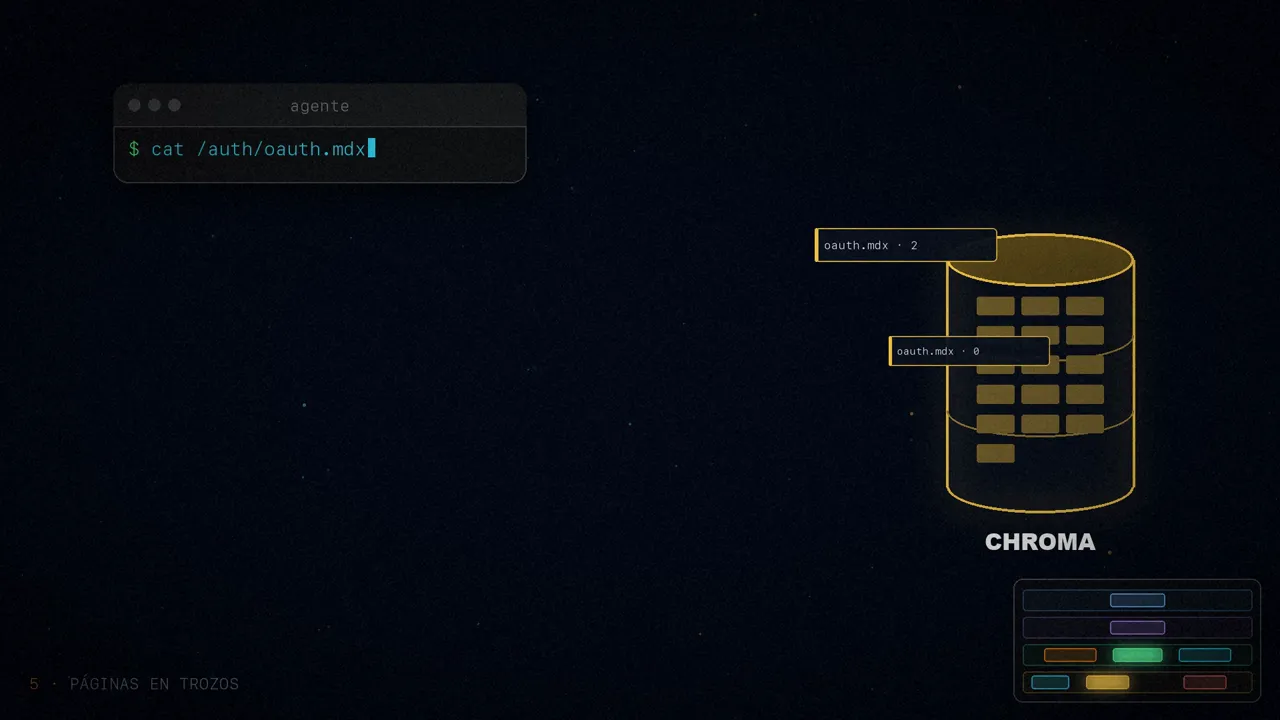
Las páginas están guardadas en Chroma en trozos, porque así se indexan para la búsqueda. Cuando el agente hace cat de una página, ChromaFs trae todos sus fragmentos, los ordena por su número (chunk_index) y los une. Además guarda el resultado en caché, así que varios grep seguidos sobre las mismas páginas nunca van dos veces a la base de datos.
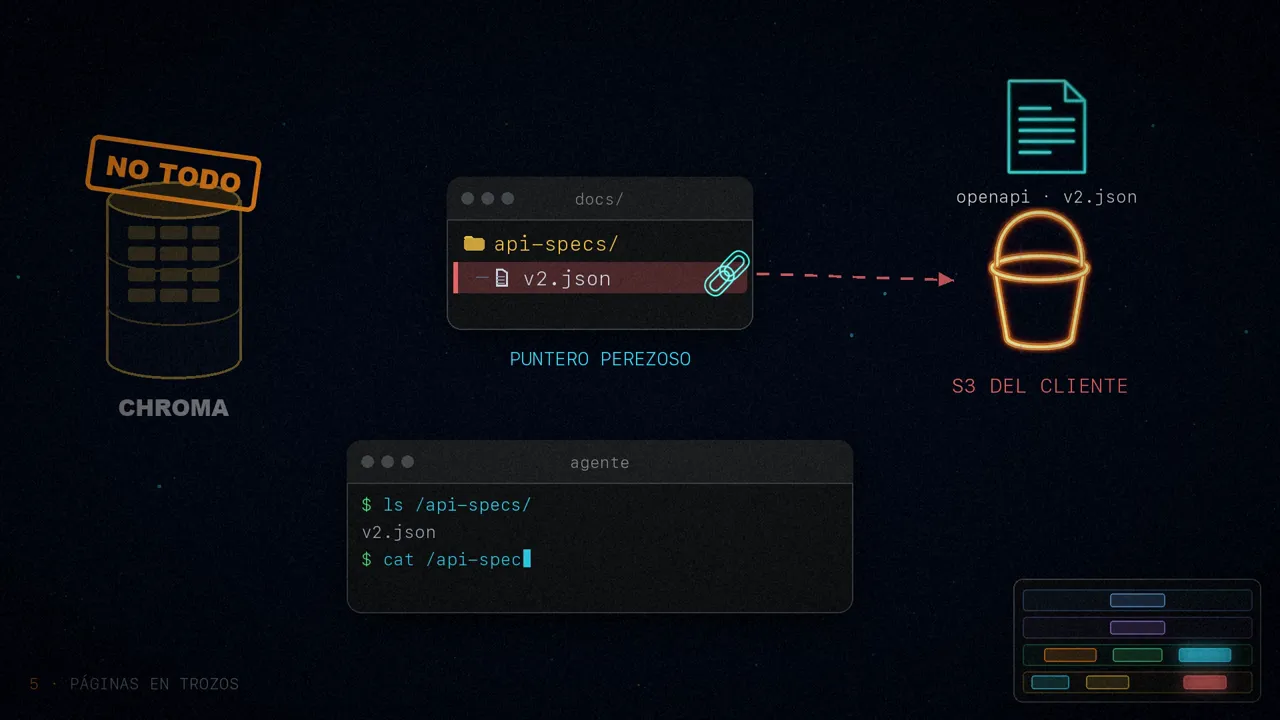
No todo tiene que estar en Chroma. Algunos clientes tienen especificaciones OpenAPI enormes guardadas en su propio S3. Para ellas hay punteros perezosos: el agente ve v2.json al listar /api-specs/, pero el contenido solo se descarga cuando hace cat.
Y una última regla: cualquier escritura devuelve EROFS, el error de sistema de archivos de solo lectura. El agente explora con total libertad, pero nunca puede cambiar la documentación. Así todo funciona sin estado: no hay que limpiar nada al cerrar la sesión, y ningún agente estropea lo que ve otro.
Optimizar grep
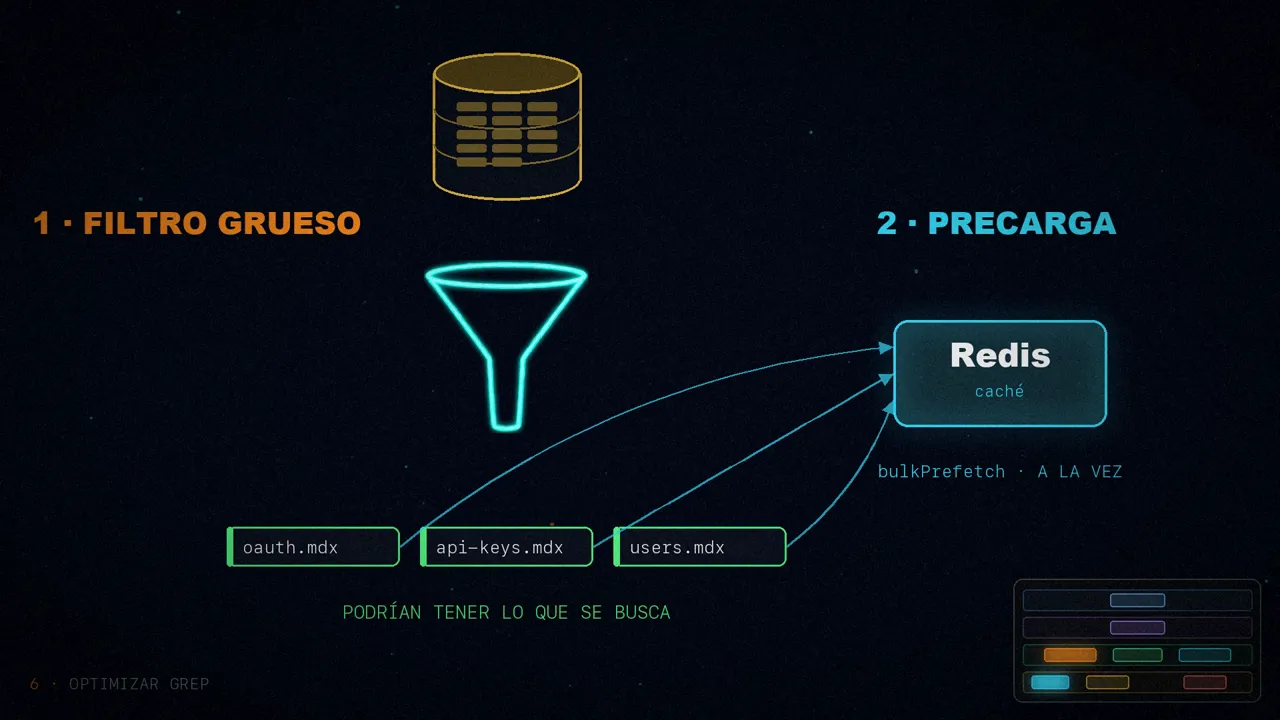
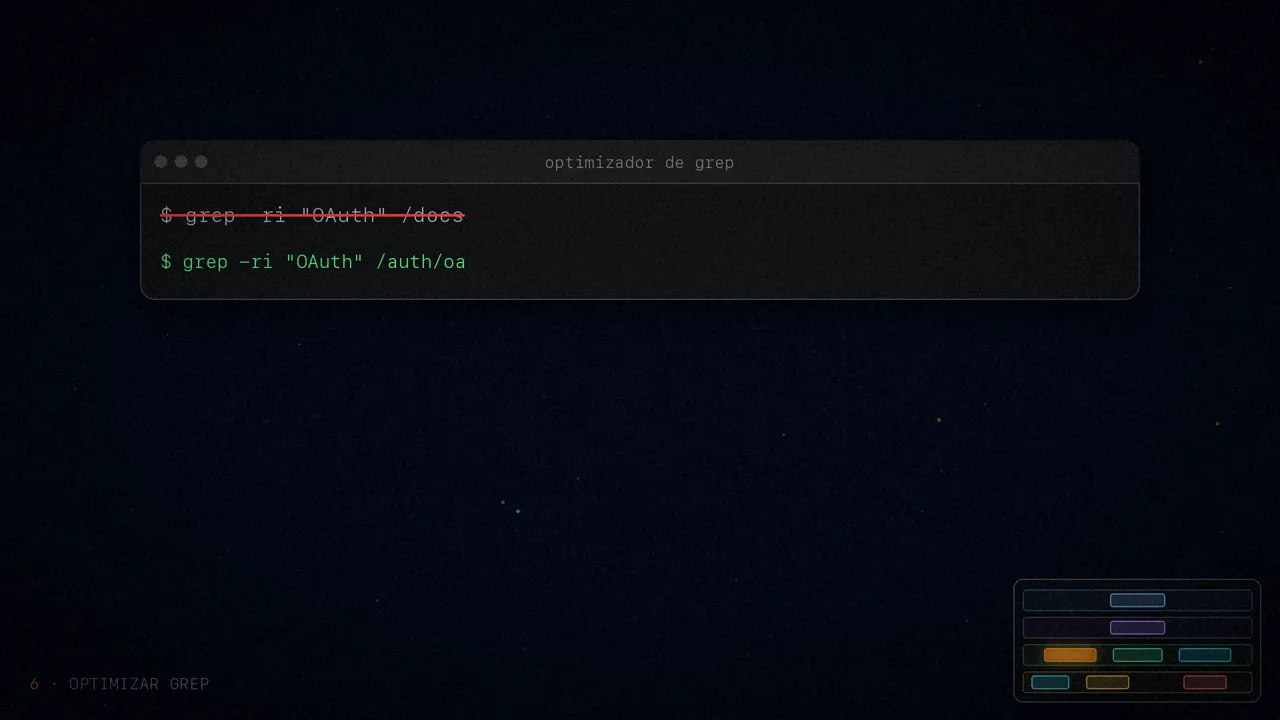
cat y ls son fáciles de virtualizar. El difícil es grep: un grep -r que leyera todos los archivos uno a uno, por la red, sería lentísimo. Así que lo interceptan: leen sus opciones con un analizador de argumentos (yargs-parser) y las convierten en una consulta de Chroma, $contains para un texto exacto o $regex para un patrón. Después trabaja en dos pasadas:
- Filtro grueso. Chroma señala qué archivos podrían contener lo que se busca.
- Precarga. Los fragmentos de esos archivos se descargan a la vez (
bulkPrefetch) a una caché de Redis. - Filtro fino. Reescriben el
greppara que mire solo esos archivos y se lo devuelven a just-bash, que lo ejecuta en memoria.
El resultado son búsquedas recursivas enormes que terminan en milisegundos.
En resumen
Hoy ChromaFs mueve el asistente de documentación de cientos de miles de usuarios, en más de 30.000 conversaciones al día. Al cambiar los sandbox por un sistema de archivos virtual sobre su base de datos de siempre, Mintlify consiguió tres cosas: sesiones instantáneas, coste marginal de cómputo cero y control de acceso por roles de serie, sin montar infraestructura nueva.
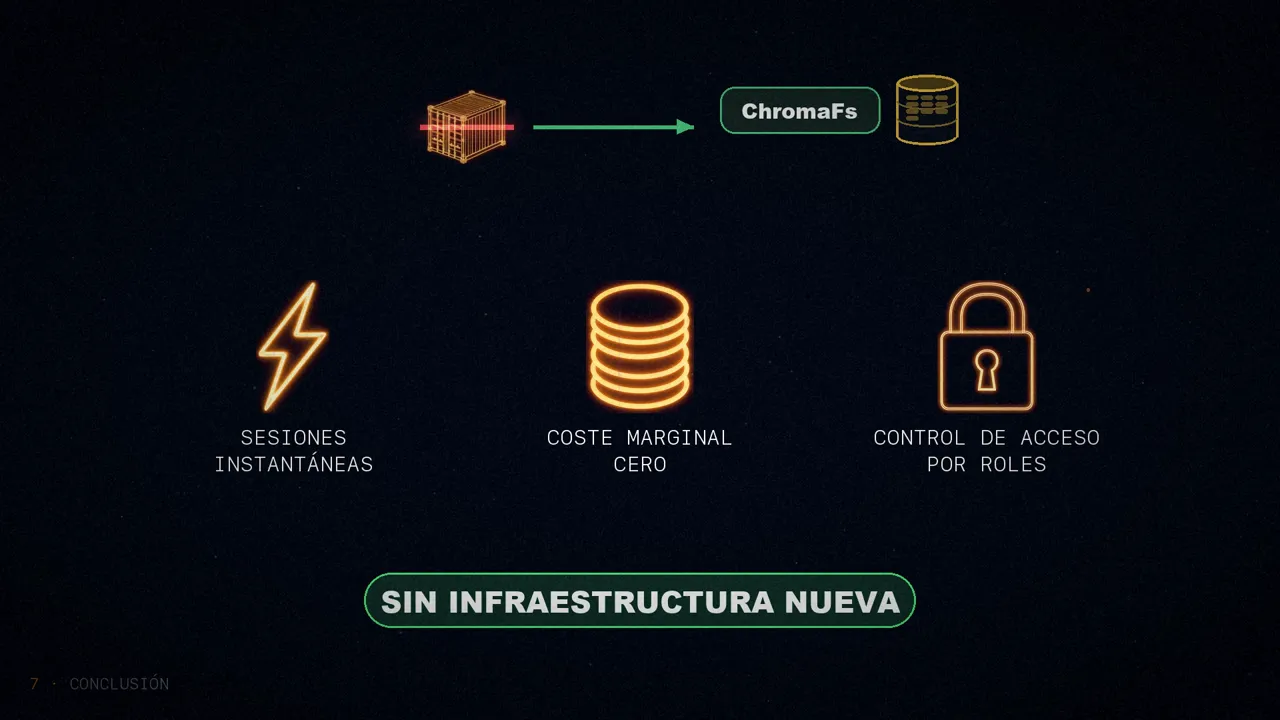
El agente no necesita un disco de verdad: le basta con la ilusión de uno.
¿Qué más convertirías en carpetas para que lo explore un agente?
Fuentes
- «How we built a virtual filesystem for our Assistant», de Dens Sumesh, Mintlify, 24 de marzo de 2026.
- Sobre por qué los agentes trabajan con archivos y bash: mi post sobre «The Anatomy of an Agent Harness».
- El vídeo, en mis tres canales: español, inglés y portugués.