Compilar em vez de buscar
A proposta é simples. Um sistema RAG (geração aumentada por recuperação) busca trechos de texto nos seus documentos assim que você pergunta, cola esses trechos no contexto e responde. A LLM Wiki faz outra coisa: o modelo lê suas fontes uma única vez e as transforma em páginas de Markdown ligadas entre si. Essas páginas não vão para o lixo: crescem e melhoram a cada fonte nova.
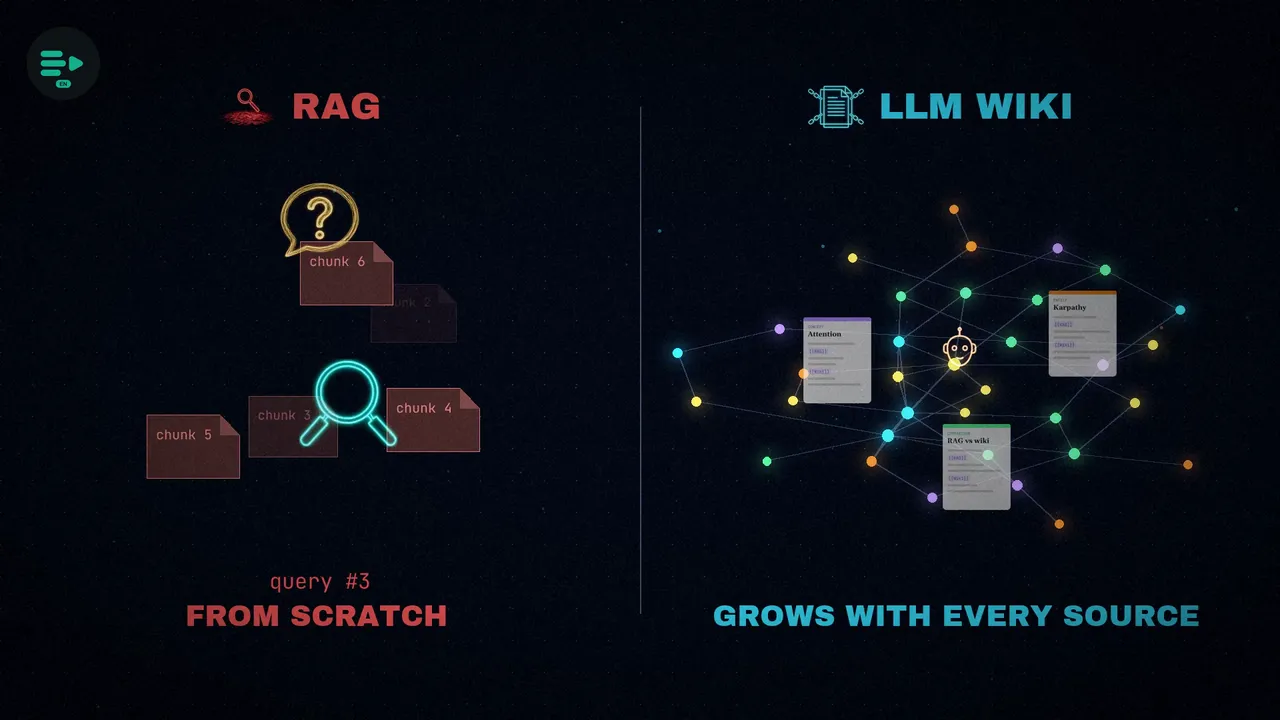
Por que isso é necessário? Segundo o artigo, os pipelines de RAG tradicionais falham por um motivo: não têm estado. Diante de uma pergunta, recuperam fragmentos, combinam, respondem… e esquecem. A consulta seguinte começa do zero de novo. Assim nada se acumula: nem o conhecimento, nem a síntese que o modelo acabou de fazer.
Do código ao conhecimento
No começo de abril de 2026, Karpathy contou no X que a forma como trabalha com os modelos tinha mudado. Ele não gasta mais a maior parte dos seus tokens escrevendo código, e sim organizando conhecimento: bases pessoais sobre os temas que pesquisa, guardadas como arquivos de Markdown e imagens dentro do Obsidian. O tuíte passou de 50.000 curtidas em poucos dias.
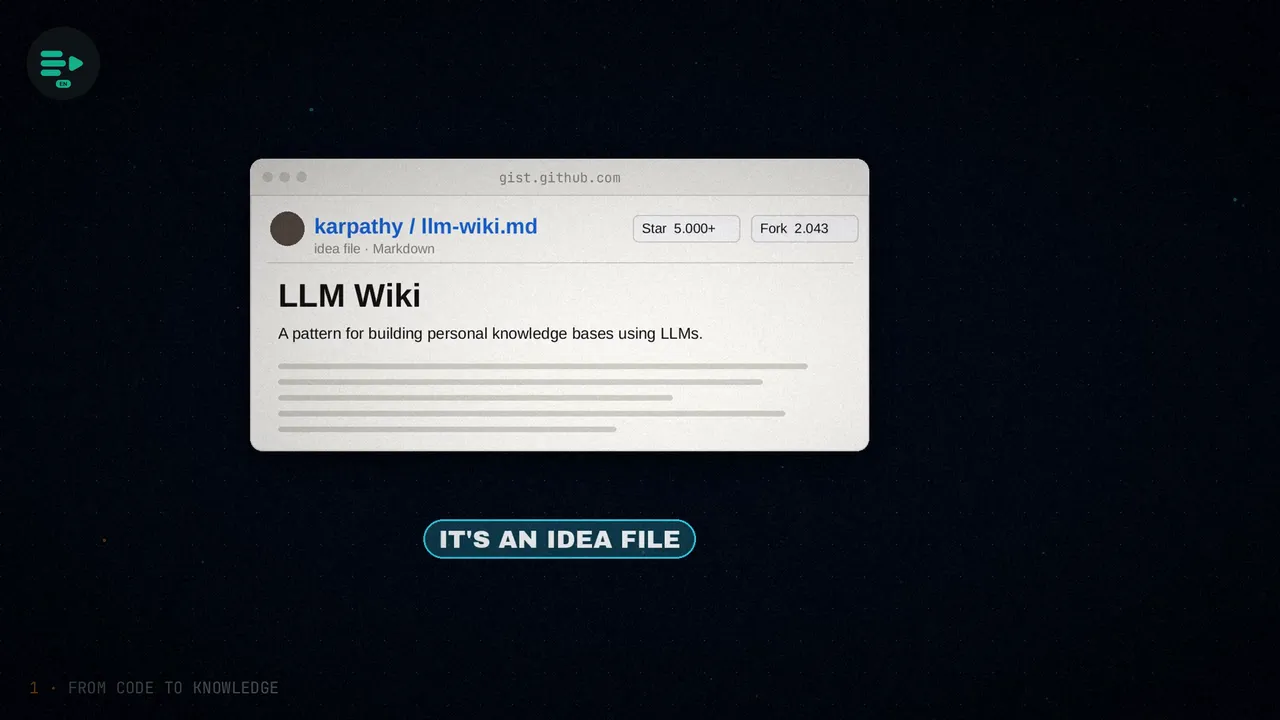
Depois ele publicou no GitHub um documento chamado LLM Wiki. Não é um programa: é um arquivo de ideias, feito para ser copiado e colado do jeito que está no seu agente, seja o Claude Code, o Codex ou o OpenCode. O agente lê e define os detalhes com você. Em apenas uma semana já havia duas implementações funcionando.
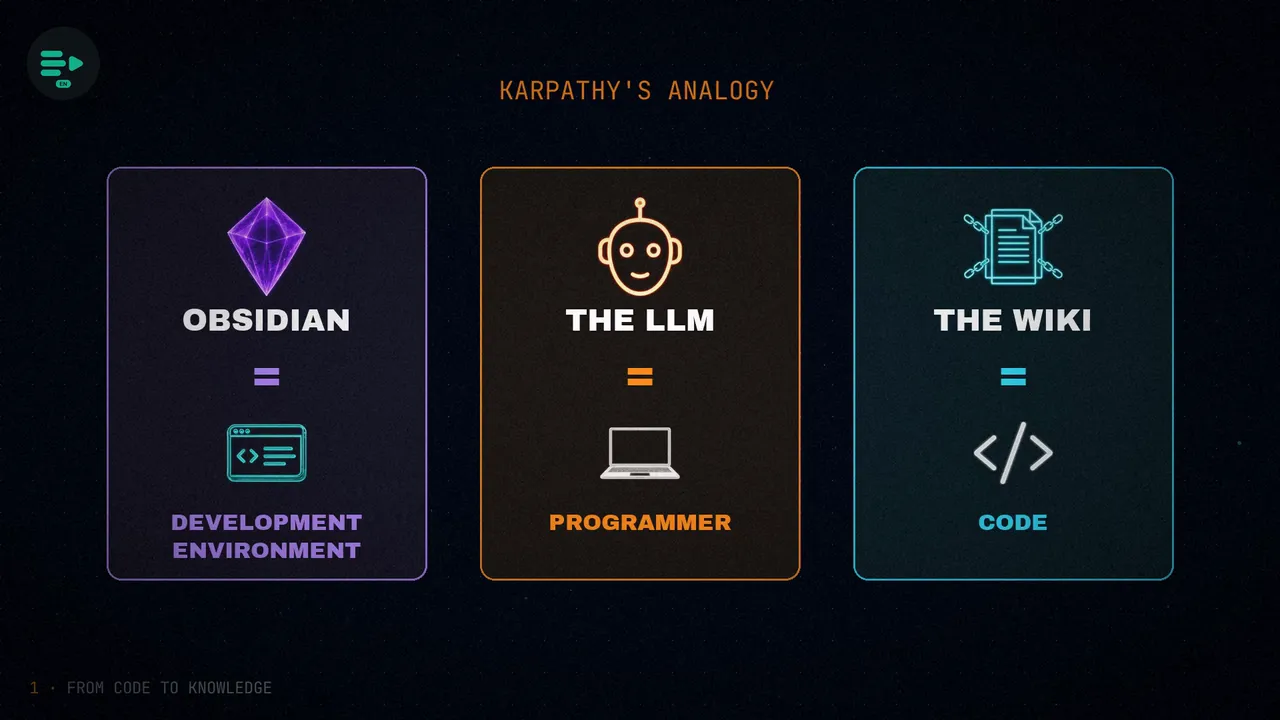
Para Karpathy, usar o modelo como um simples buscador desperdiça o que ele sabe fazer. A proposta o transforma no responsável por uma wiki: ele lê cada fonte uma única vez, sintetiza em páginas estruturadas e as mantém atualizadas. No documento, ele resume com uma imagem: o Obsidian é o ambiente de desenvolvimento, o LLM é o programador e a wiki é o código.
As três camadas
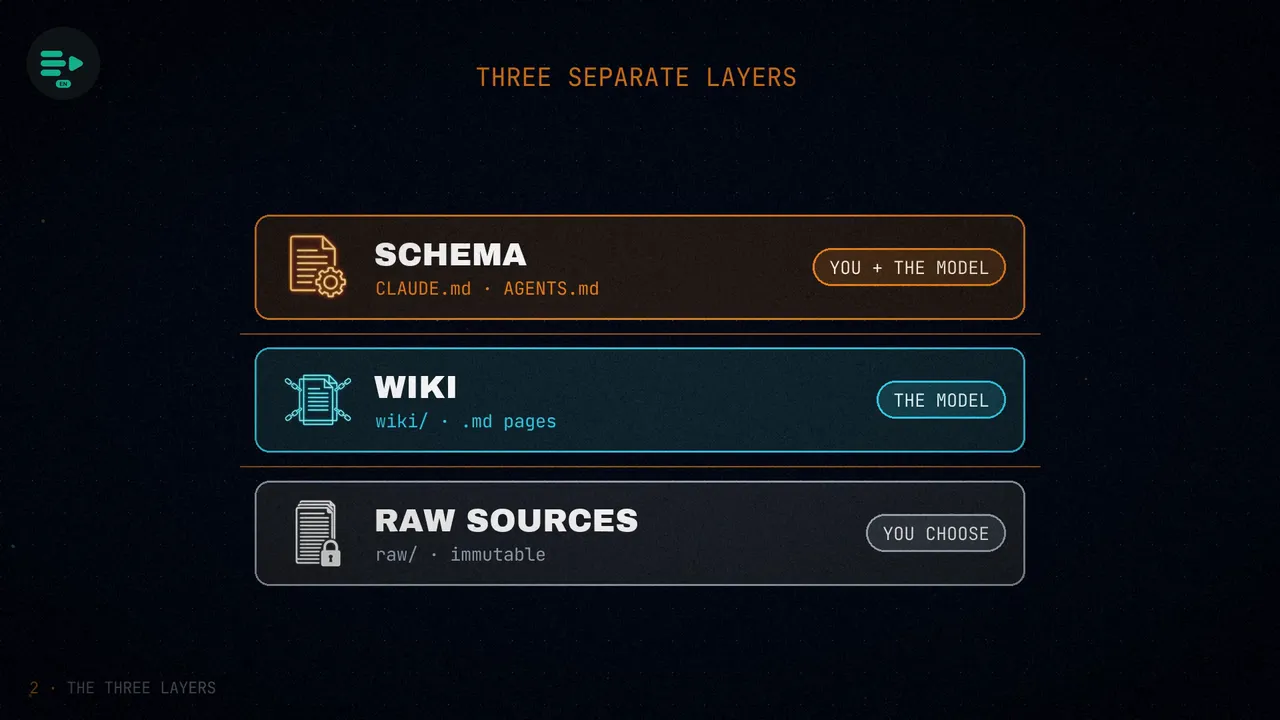
A arquitetura tem três camadas separadas, e cada uma tem seu dono e suas regras:
- As fontes brutas. Artigos, papers, imagens, dados e código, tudo numa pasta própria. São imutáveis: o modelo lê, mas nunca altera. Karpathy reúne uns cem artigos por tema com o Web Clipper do Obsidian, e suas wikis compiladas somam umas 400.000 palavras.
- A wiki. Um diretório de arquivos de Markdown escritos pelo próprio modelo: resumos, páginas de entidades e de conceitos, comparações e sínteses entre temas. Tudo isso é dele: ele escreve, reescreve e reorganiza à medida que chegam fontes e ele entende melhor o tema. As pessoas leem e fazem perguntas, mas quase nunca editam.
- O esquema. Um documento de configuração, como
CLAUDE.mdouAGENTS.md, que define a estrutura de pastas, como os arquivos são nomeados e quais passos seguir em cada tarefa. É o que transforma o modelo num responsável disciplinado, e não num chat genérico. Você e o agente vão ajustando com o tempo.
As três operações: ingestão, consulta e lint
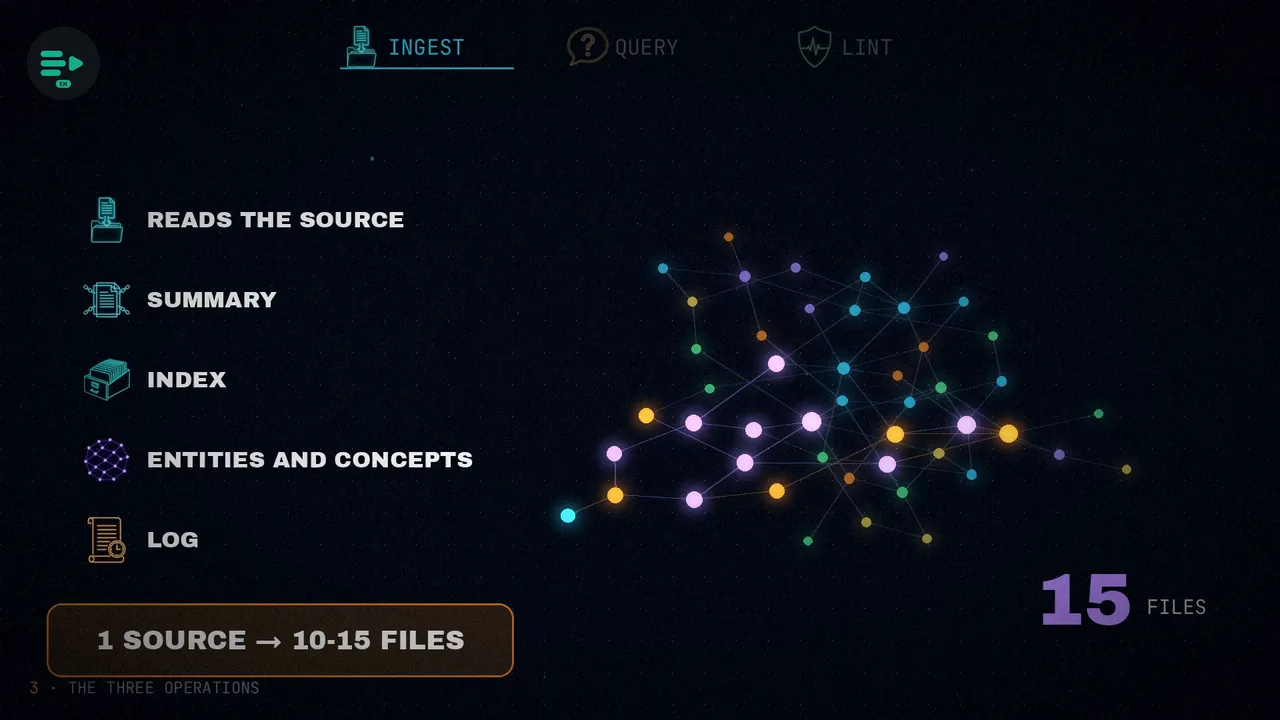
Três operações trabalham sobre essas camadas. A primeira é a ingestão. Quando entra uma fonte nova, o modelo a lê, escreve ou atualiza a página de resumo, atualiza o índice, revisa as páginas de entidades e conceitos afetadas e registra a entrada no log. Uma única fonte costuma alterar entre dez e quinze arquivos.
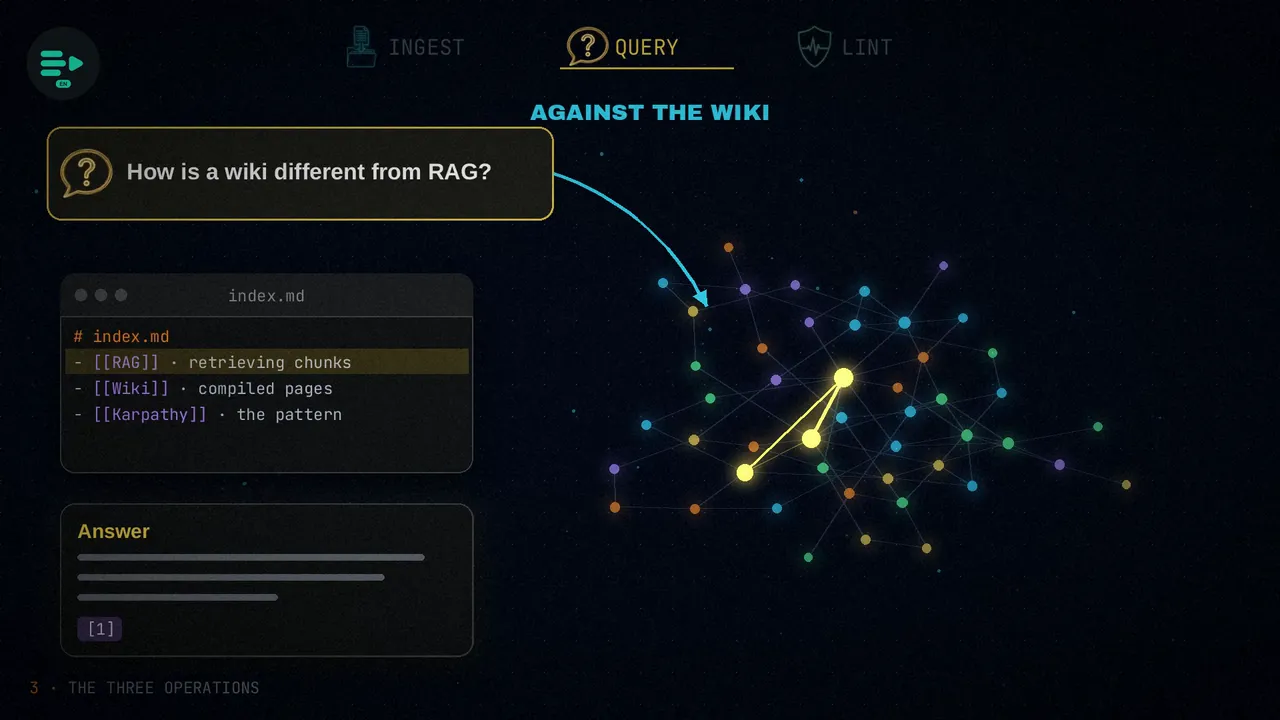
A segunda é a consulta. As perguntas são respondidas a partir da wiki, e não dos documentos originais. O modelo encontra as páginas relevantes pelo índice e responde com citações. E se a resposta valer a pena, ele a guarda na wiki como uma página nova: assim, suas próprias dúvidas também somam.
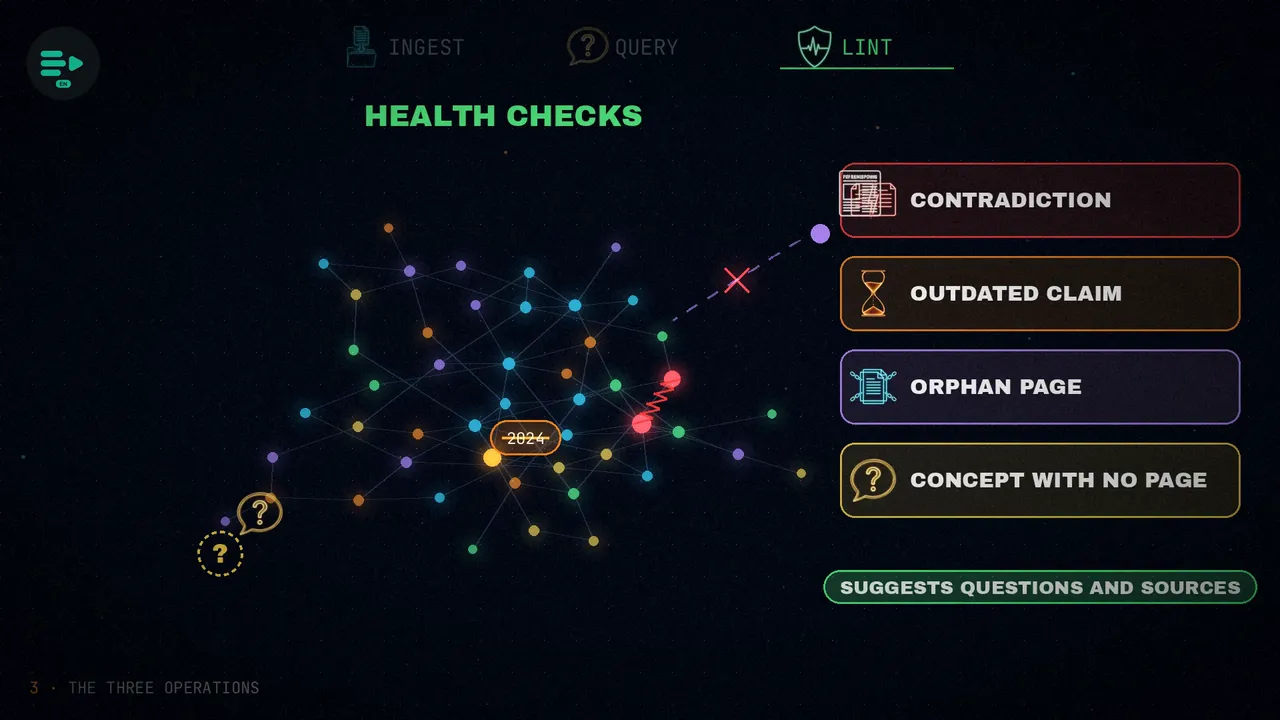
A terceira é o lint: revisões de saúde periódicas. O modelo procura contradições entre artigos da wiki, afirmações que uma fonte mais recente deixou desatualizadas, páginas órfãs que nenhum link alcança e conceitos importantes que ainda não têm página própria. Depois sugere perguntas e fontes novas para cobrir as lacunas.
O índice, o log e o qmd
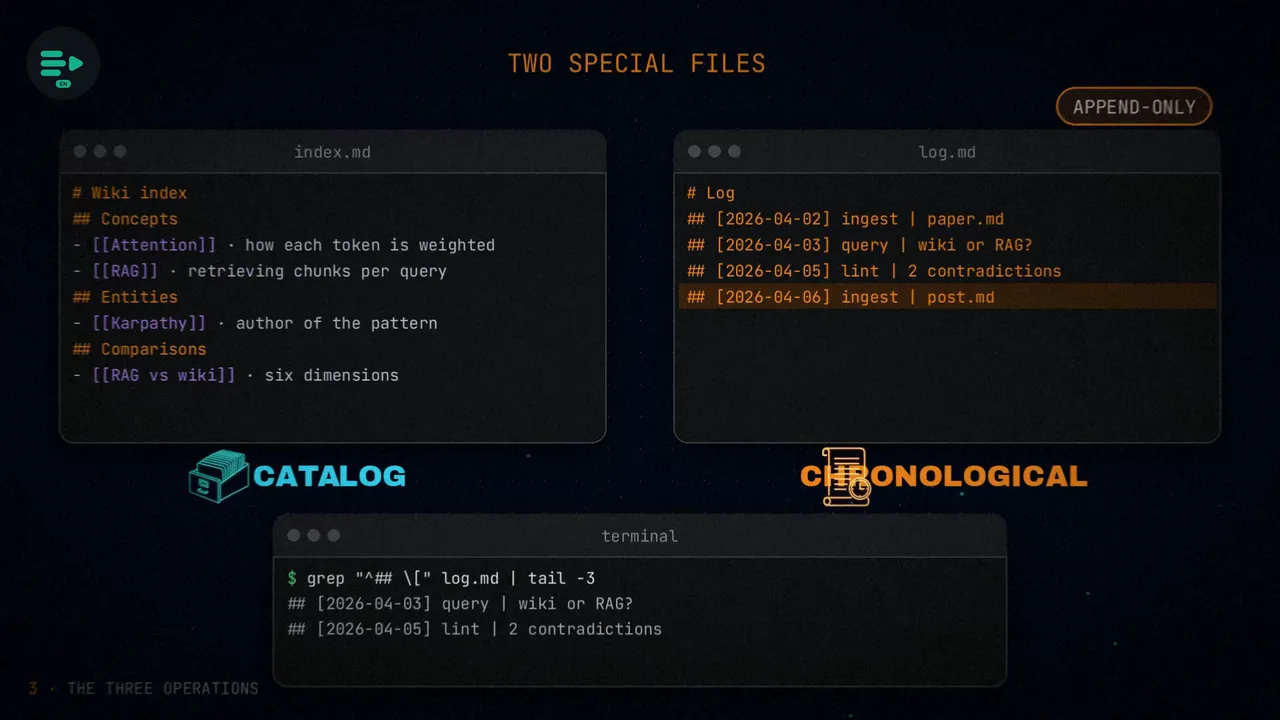
Dois arquivos especiais mantêm tudo unido. O índice (index.md) é um catálogo de todas as páginas da wiki, por categoria e com um resumo de uma linha. O log (log.md) é um registro cronológico em que só se acrescentam entradas, uma por ingestão, consulta ou revisão. Como toda entrada começa do mesmo jeito, dá para lê-lo com ferramentas básicas como grep e tail.
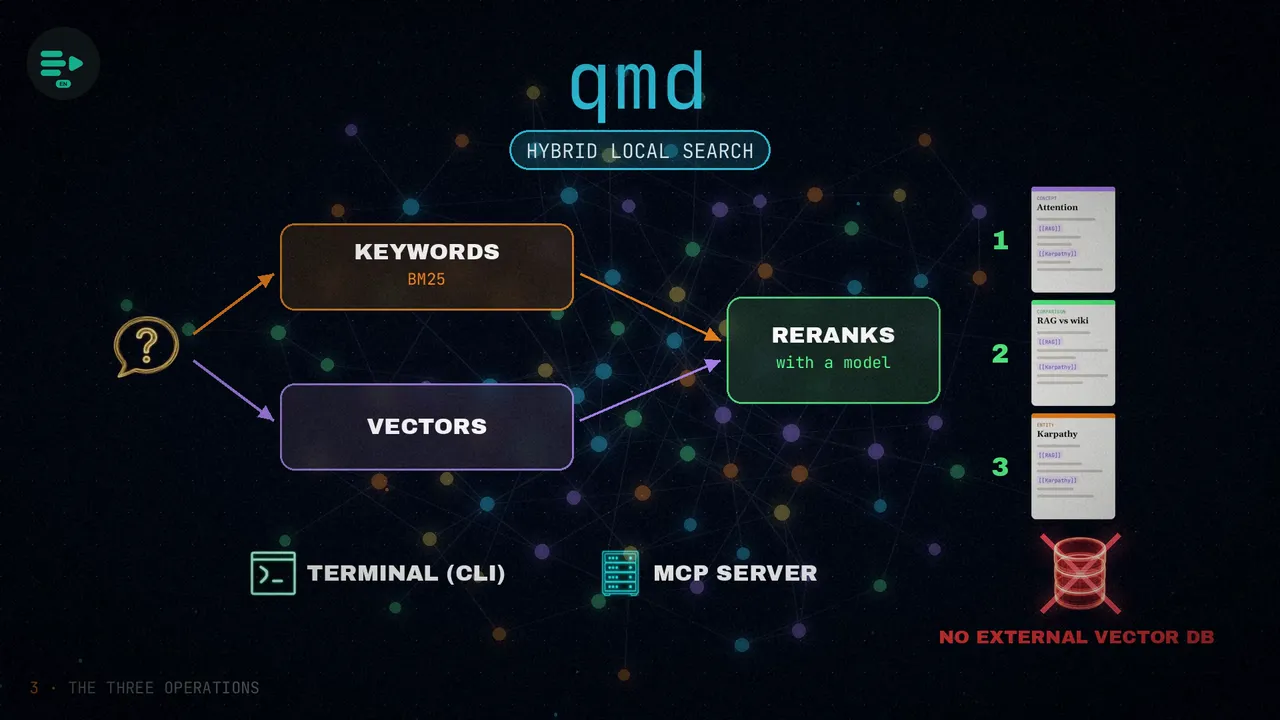
Para wikis maiores, o documento recomenda o qmd: um buscador local híbrido que combina palavras-chave (com BM25) e vetores, e reordena os resultados com um modelo. Funciona pelo terminal ou como servidor MCP, e busca rápido nos arquivos de Markdown sem montar um banco de dados vetorial externo.
O Memex: a peça que faltava
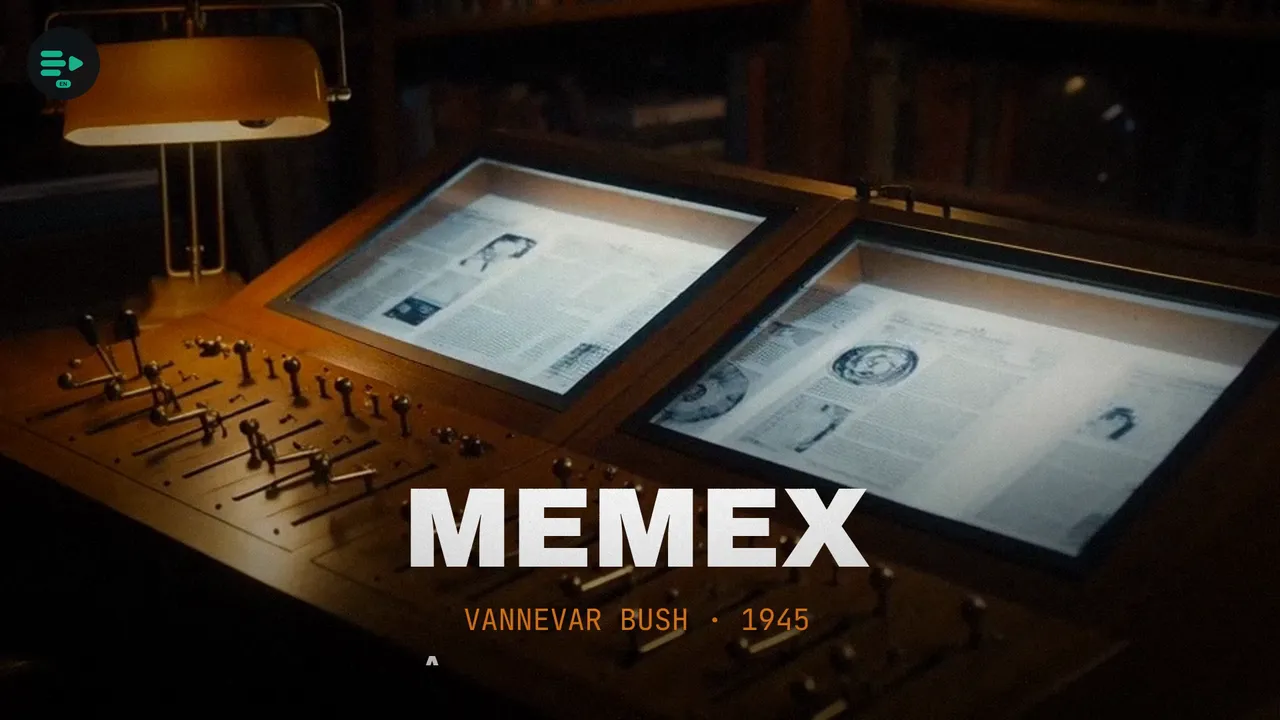
No fundo, Karpathy liga essa ideia ao Memex, que Vannevar Bush imaginou em 1945: um armazém pessoal de conhecimento em que as trilhas que ligam um documento a outro importam tanto quanto os próprios documentos.
O problema é que ninguém quer fazer a manutenção. Essa papelada é justamente o que nos faz abandonar nossas wikis. Os modelos podem fechar essa lacuna: não se entediam, alteram de dez a quinze arquivos de uma vez e propagam cada mudança pela wiki inteira.
As ferramentas: Hermes Agent e Graphify
O documento do Karpathy é um arquivo de ideias, não um programa. Mas poucos dias depois da publicação, dois projetos diferentes já tinham implementações funcionando.
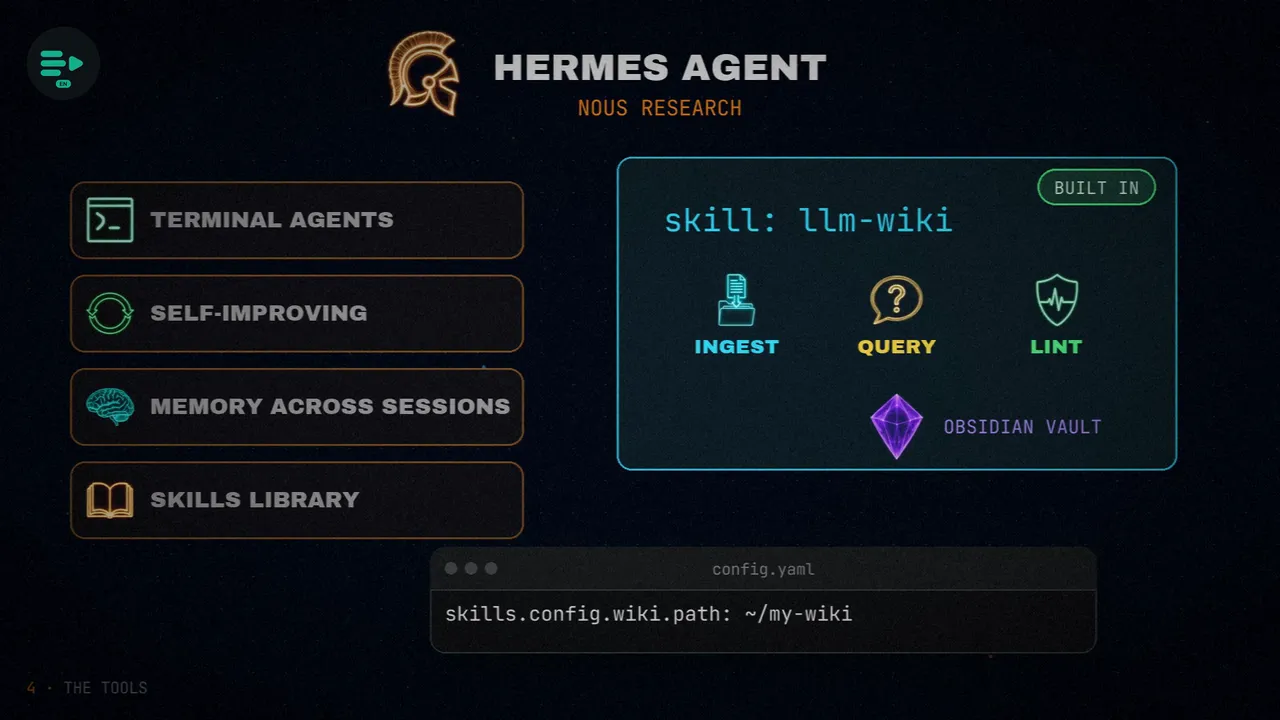
A primeira é o Hermes Agent, da Nous Research: um ambiente para agentes de terminal que se aprimoram sozinhos, com memória entre sessões e uma biblioteca de habilidades. Ele já traz o padrão incluído, como a skill llm-wiki, com as três operações sobre um cofre do Obsidian. Para apontá-la para a sua pasta, basta um ajuste de configuração (skills.config.wiki.path).
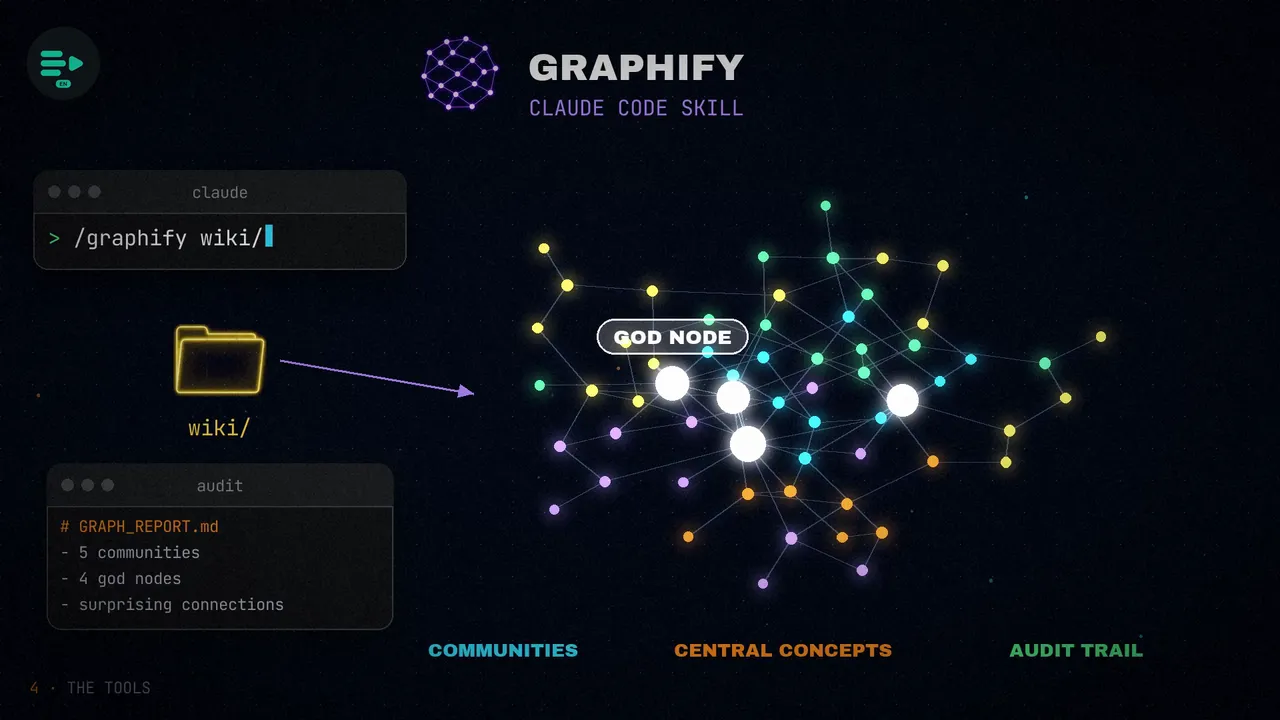
A segunda é o Graphify, uma skill do Claude Code que constrói grafos de conhecimento a partir de qualquer pasta. Se você a aponta para a sua wiki, ela produz um grafo: detecta comunidades de ideias, analisa os conceitos centrais (que chama de nós deus) e deixa um registro de auditoria.
Uma observação: o artigo dá comandos de instalação para as duas que não batem com o que dizem os repositórios, então não os copio aqui. Confira o README de cada uma.
RAG, wiki ou notas à mão
O artigo coloca três abordagens frente a frente: os sistemas RAG de sempre, o padrão da wiki e a gestão manual do conhecimento, com apps de notas como Obsidian, Notion ou Roam. E as compara em seis dimensões:
- Persistência: nenhuma, cada consulta começa do zero.
- Síntese: só dentro de cada consulta.
- Manutenção: barata, basta manter o índice em dia.
- Infraestrutura: banco de dados vetorial, modelo de embeddings e pipeline de recuperação.
- Consulta: uma interface de recuperação programática.
- Modo de falha: recupera trechos irrelevantes e não aprende nada.
- Persistência: o que é compilado se acumula e melhora.
- Síntese: cruza documentos a cada ingestão.
- Manutenção: barata, porque as dez ou quinze alterações são feitas pelo modelo.
- Infraestrutura: arquivos de Markdown num repositório git e qualquer agente.
- Consulta: o modelo lê as páginas compiladas e sintetiza.
- Modo de falha: pode incorporar em silêncio erros de uma fonte ruim, e o lint só pega alguns.
- Persistência: depende do esforço da pessoa.
- Síntese: só se você se der ao trabalho.
- Manutenção: cara; as pessoas abandonam suas wikis quando a papelada pesa mais do que o que elas trazem.
- Infraestrutura: um app de notas e muita disciplina.
- Consulta: você mesmo busca, com links e visualização de grafo.
- Modo de falha: notas velhas, páginas órfãs e, no fim, você para de mantê-las.
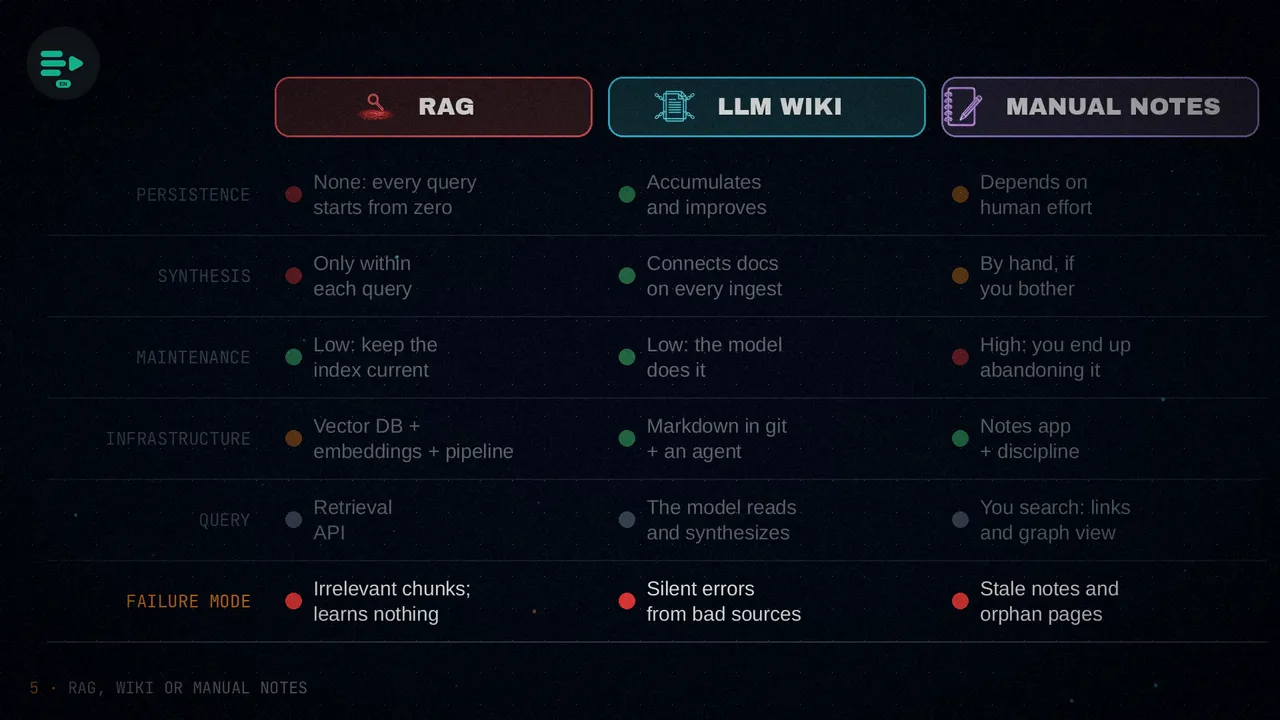
Atenção: isto não é uma comparação com testes medidos. Não há dados publicados que comparem as respostas de uma wiki compilada com as do RAG, nem em precisão nem em completude. O que se compara é a arquitetura: como cada sistema é construído, não qual responde melhor.
Mesmo assim, o padrão fica bem no meio. Do RAG ele pega a automação, mas troca a recuperação sem memória por uma compilação que persiste. Das notas à mão ele fica com uma estrutura que uma pessoa consegue ler, mas deixa a manutenção para o modelo. E as ferramentas de grafos, como o Graphify ou os servidores MCP de grafos de conhecimento, acrescentam algo que nem o RAG nem o Obsidian trazem de fábrica: detectar comunidades de temas, encontrar os conceitos que funcionam como centro e traçar caminhos entre ideias muito distantes.
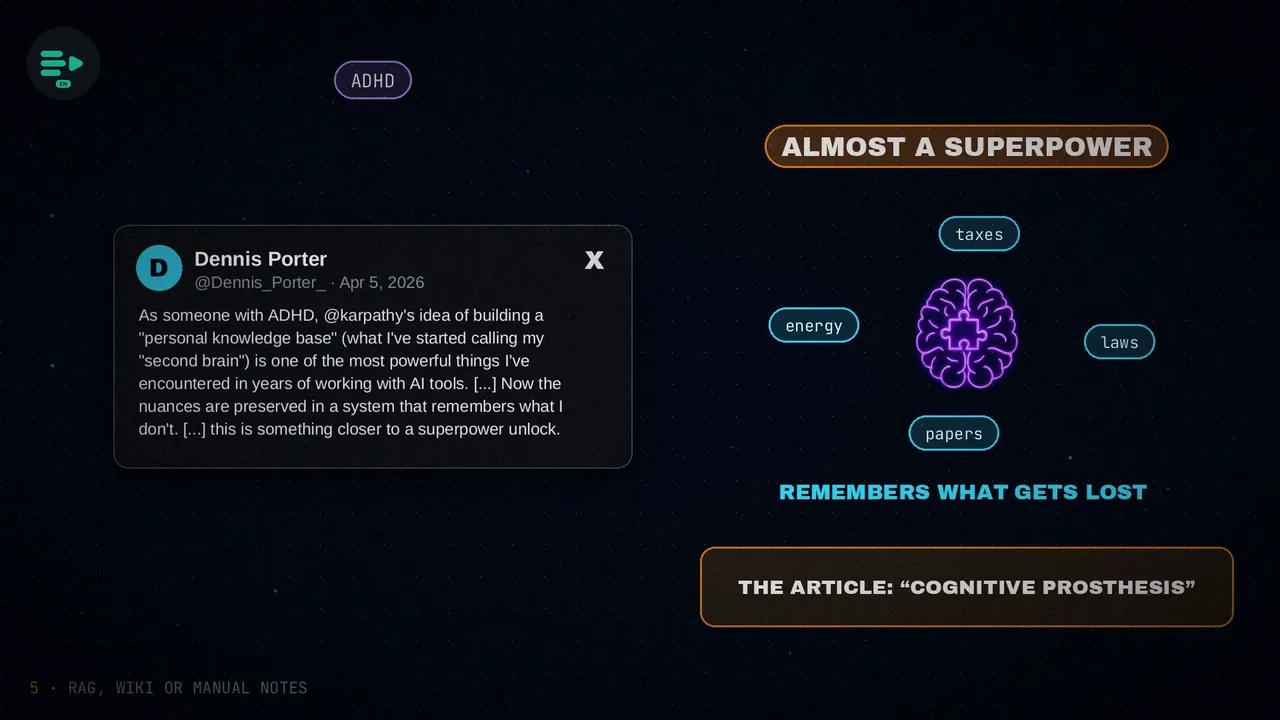
A comunidade já deu um nome a isso: o segundo cérebro. Há tutoriais no YouTube para montar bases de conhecimento mantidas por um modelo, revisar literatura científica ou analisar a concorrência. E Dennis Porter, que tem TDAH, contou no X que para ele é quase um superpoder: o sistema lembra as nuances que ele perdia ao mudar de assunto. O artigo chama isso de “prótese cognitiva”, embora essa expressão não esteja no tuíte dele.
Os limites
Há três que nem o documento nem suas implementações resolvem:
- O teto da janela de contexto. Karpathy falou de wikis de umas 400.000 palavras, uns cem artigos, mas ninguém sabe onde fica o limite. O Graphify contorna o problema, porque trabalha sobre a estrutura de arquivos.
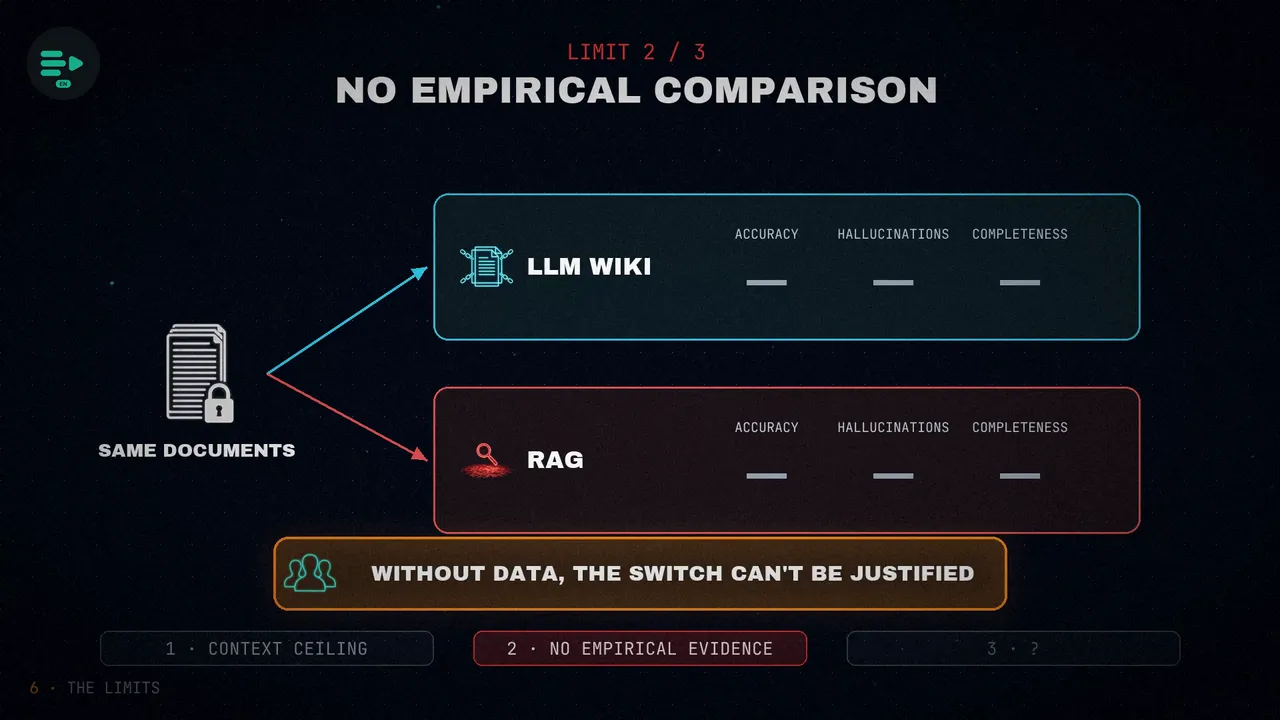
- Não há uma comparação empírica de qualidade. Que o conhecimento compilado seja melhor do que a recuperação sem estado é um argumento de arquitetura, não um resultado medido. Ninguém publicou testes que comparem as duas opções com os mesmos documentos, em precisão, alucinações ou completude. E sem dados, as equipes não conseguem justificar a troca.
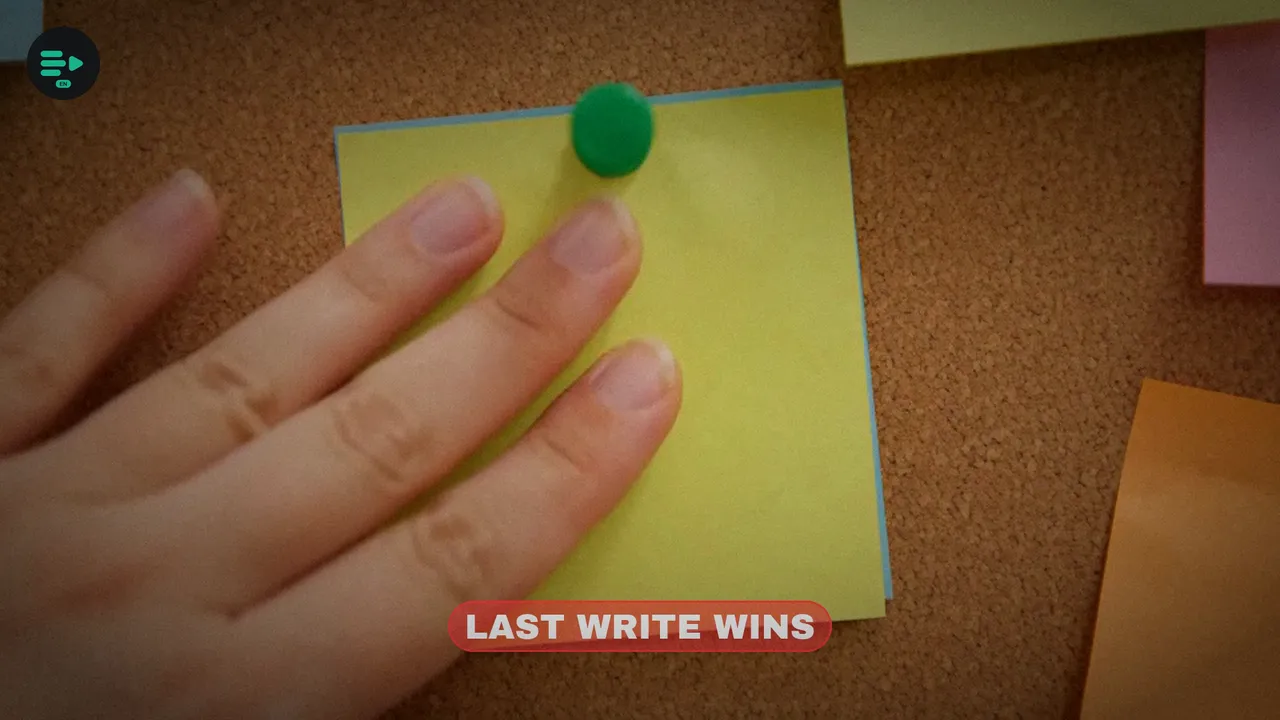
- Resolver contradições em grande escala. O lint aponta as contradições, mas não há um protocolo para as divergências legítimas, que são comuns em áreas que mudam rápido, como a pesquisa em IA. A wiki funciona com a regra de que a última escrita vence, e isso põe em risco sua confiabilidade como referência quando passa de cem artigos.
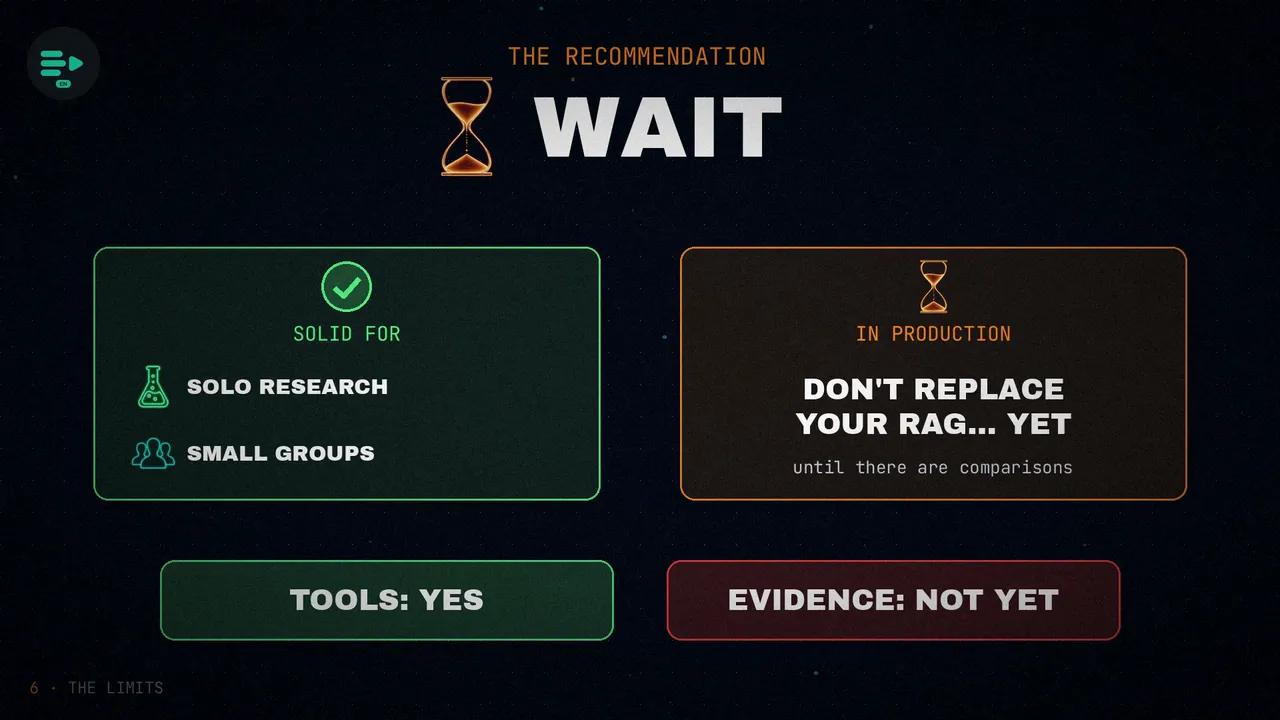
Por isso, a recomendação do artigo é esperar. O padrão é sólido para pesquisar por conta própria ou para experimentos em grupos pequenos. Mas as equipes em produção deveriam segurar antes de substituir sua infraestrutura de RAG, até que haja comparações que demonstrem que ele responde melhor. As ferramentas existem; as provas, ainda não.
Para quem é?
- Engenheiros de machine learning, pesquisadores e desenvolvedores que trabalham sozinhos.
- Grandes revisões de literatura, análise de concorrência ou sistemas pessoais de conhecimento.
- Principalmente quem já usa o Obsidian e quer que um modelo o mantenha sem montar infraestrutura nova.
- Equipes que precisam recuperar na hora dados que mudam com frequência, porque compilar leva tempo.
- Empresas com requisitos de conformidade para documentação gerada por IA, já que não há revisão humana obrigatória.
- Quem precisa de consultas estruturadas, com SQL ou GraphQL, em vez de navegar por arquivos de Markdown.
Monte em 10 minutos
A proposta prática do artigo: monte a sua própria wiki, em vez de ler e esquecer no chat. Comece num diretório vazio, que também será o seu cofre do Obsidian. Dentro vão as fontes brutas, separadas em artigos, papers, repositórios e imagens; a wiki, com entidades, temas, comparações, cronologias e perguntas; e três arquivos: o índice, o log e o CLAUDE.md.
mkdir my-wiki && cd my-wiki
git init
mkdir -p raw/{articles,papers,repos,images}
mkdir -p wiki/{entities,topics,comparisons,timelines,qa}
touch index.md log.md CLAUDE.md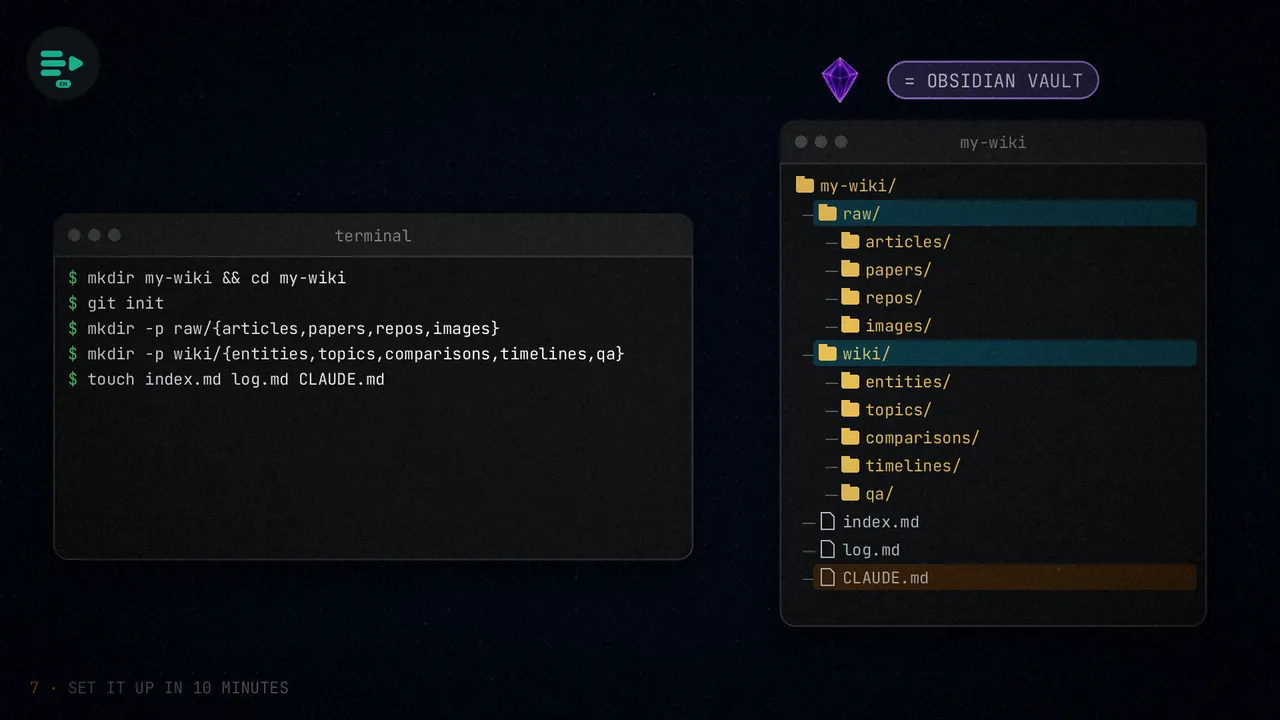
O arquivo-chave é o CLAUDE.md. Cole dentro o documento do Karpathy, inteiro ou cortado, e acrescente seu tema, as regras das pastas, como os arquivos são nomeados e os três protocolos: ingestão, consulta e lint. O Claude Code lê esse arquivo sozinho no começo de cada sessão.
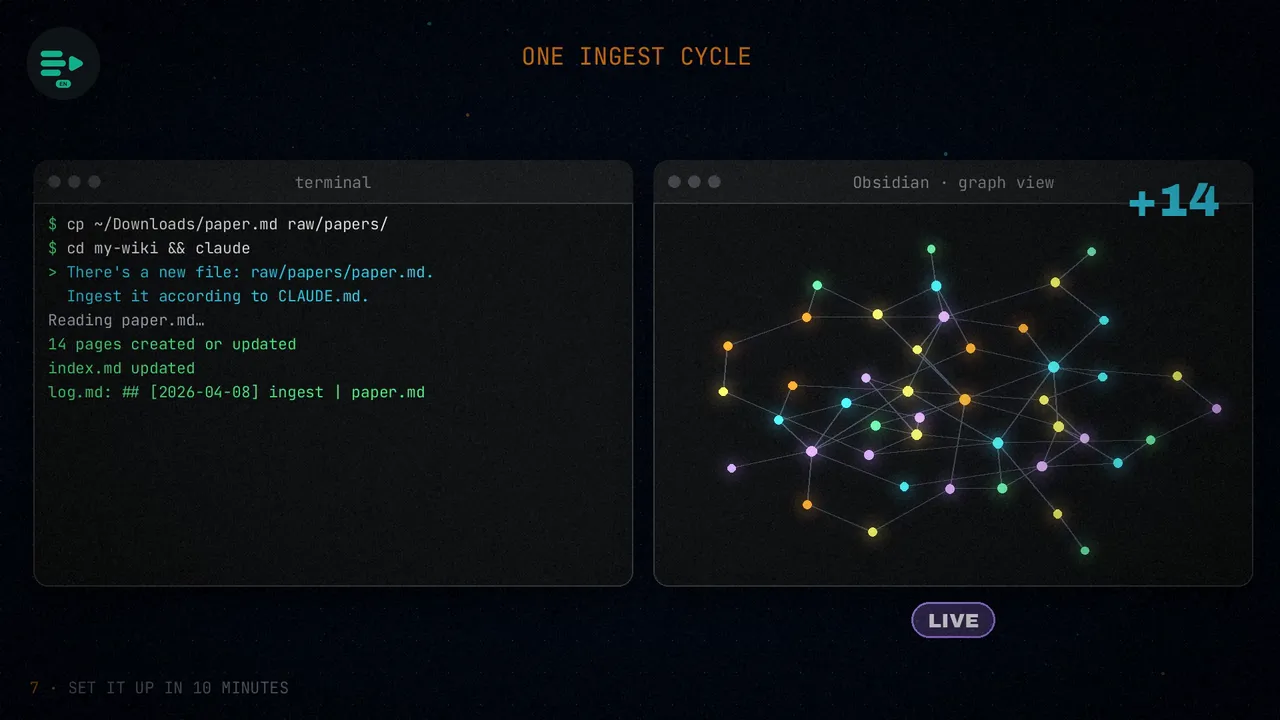
Para ingerir uma fonte, copie-a para a pasta de papers, abra o Claude Code na wiki e peça algo como: “Há um arquivo novo: raw/papers/paper.md. Faça a ingestão segundo o CLAUDE.md.” O agente o lê, cria ou atualiza entre dez e quinze páginas, atualiza o índice e registra a operação no log. Se você abrir o cofre no Obsidian, vai ver o grafo crescer ao vivo.
E há atalhos. Com o Hermes Agent não é preciso escrever o arquivo de instruções: você aponta o ajuste da wiki para o seu cofre e roda a ingestão. O Graphify roda sobre a wiki e te dá um grafo com grupos de temas e nós centrais em cima das suas páginas. E quando passar de quinhentas páginas, acrescente o qmd, para que o agente delimite o que ler antes de abrir qualquer coisa.
Resumindo
Karpathy propõe que o modelo não vasculhe seus documentos toda vez, e sim que os compile uma única vez numa wiki que cresce. Camadas separadas, três operações e um aviso: ainda faltam provas de que ela responda melhor do que a recuperação clássica.
Não peça ao modelo que vasculhe tudo toda vez: peça que compile uma vez e mantenha o que sabe.
Você montaria a sua própria wiki, ou fica com o RAG?
Fontes
- “How Karpathy’s LLM Wiki Works, And How to Actually Set it Up”, da AlphaSignal (@AlphaSignalAI), 8 de abril de 2026.
- O documento “LLM Wiki” de Andrej Karpathy, e o tuíte dele de 2 de abril de 2026.
- O tuíte de Dennis Porter sobre seu segundo cérebro.
- Sobre como recuperar informação sem RAG: meu post sobre o sistema de arquivos virtual da Mintlify.
- O vídeo, nos meus canais: inglês e espanhol.