Um exemplo: o que veio primeiro?
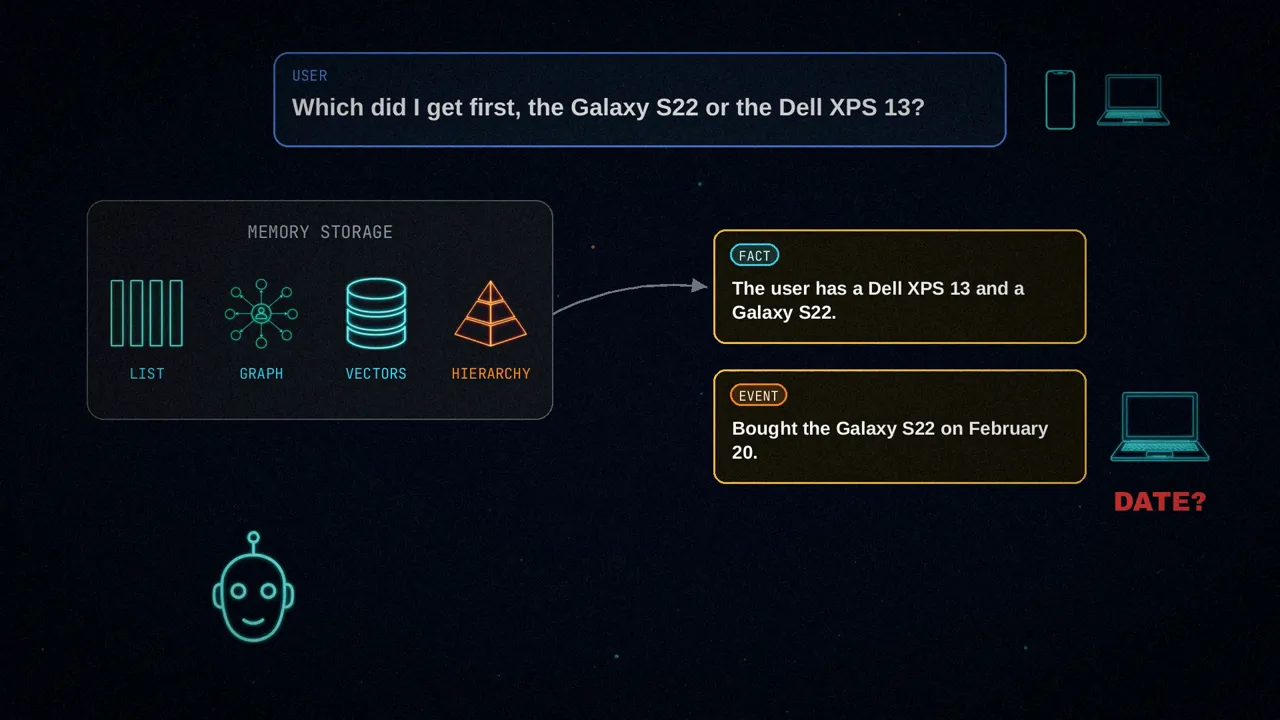
O paper começa com um exemplo bem claro. Um usuário pergunta: «O que eu tive primeiro, o Samsung Galaxy S22 ou o Dell XPS 13?». Um sistema de memória clássico faz a busca e entrega ao agente duas notas: o usuário tem os dois aparelhos e comprou o Galaxy S22 em 20 de fevereiro. Do notebook, não há data. Com isso, a única coisa que o agente pode responder é «não sei».
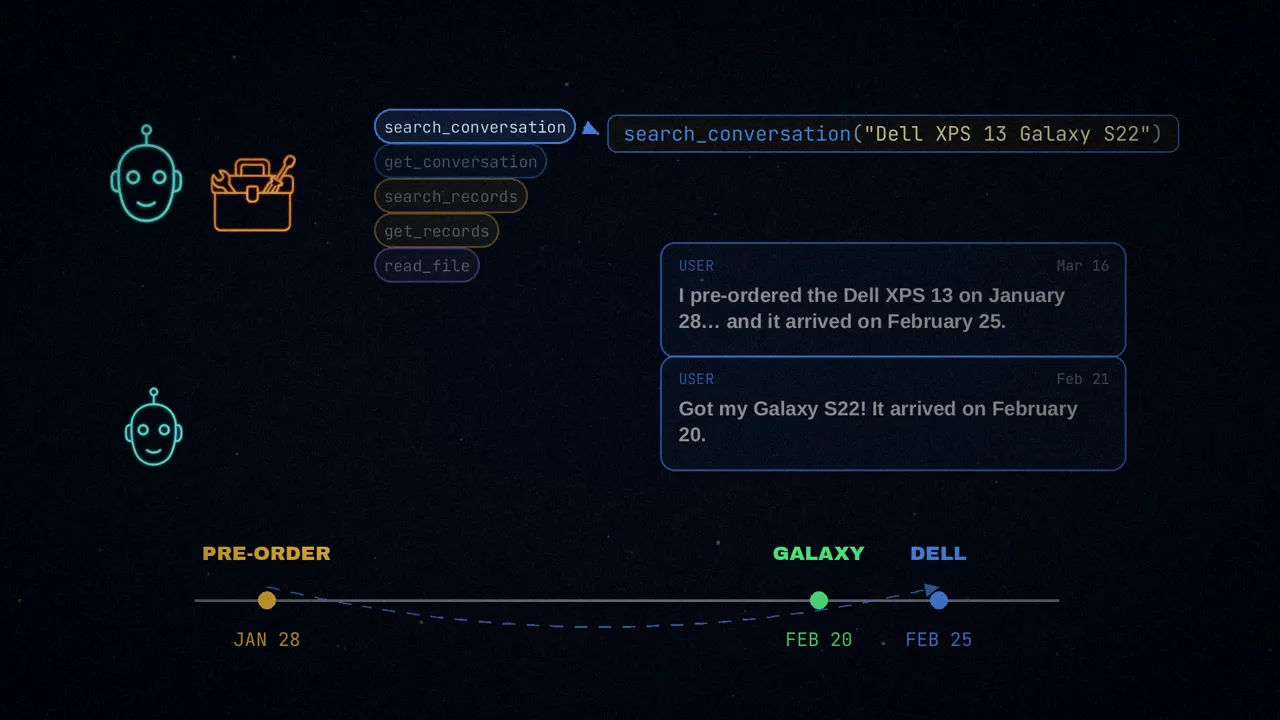
Agora, o mesmo agente com ferramentas de memória. Ele não espera mais que tragam nada: busca nas conversas por conta própria e encontra duas mensagens. O Dell foi reservado em 28 de janeiro, mas chegou em 25 de fevereiro; o Galaxy chegou no dia 20. A resposta certa é o Galaxy S22, e a pegadinha estava na data da reserva.
Essa diferença, receber contra buscar, é o paper inteiro.
O problema da recuperação passiva
Os agentes já não vivem em uma única conversa: eles nos acompanham por semanas, no trabalho, nos estudos ou no dia a dia, e para isso precisam se lembrar de nós. O difícil é que o que eles sabem de um usuário é de muitos tipos, e cada pergunta futura precisa de uma lembrança diferente; por isso uma forma fixa de guardar e consultar a memória não dá conta.
Até agora, a memória foi melhorada por dois lados:
Categorias mais finas e armazenamentos de vetores, grafos, híbridos ou hierárquicos: o Mem0 guarda registros compactos, o Zep monta um grafo de conhecimento temporal, o MemOS trata a memória como um recurso do sistema e o MemoryOS a divide em curto, médio e longo prazo.
Buscas que refletem sobre o que encontraram, consultas personalizadas para cada usuário e uma reordenação melhor dos resultados, às vezes treinadas com aprendizado por reforço (Search-R1, DeepRetrieval, RMM).
Mas em quase todos, acessar a memória é uma função do sistema, um processo desenhado de antemão. Não importa como você guarda a memória, em lista, em grafo, em vetores ou em hierarquia: no fim ela vira um pedaço de contexto que alguém escolhe e entrega ao agente. Se esse pedaço estiver incompleto, o agente não pode ir buscar mais. Ele é, como dizem os autores, um consumidor de provas selecionadas por outro.
A memória como espaço de ações
A proposta é virar isso do avesso: a memória passa a ser um espaço de ações estruturado. O agente ganha ferramentas de memória e decide três coisas:
- Se precisa da memória para esta pergunta.
- Em que nível de detalhe consultá-la.
- Se o que encontrou já basta para responder.
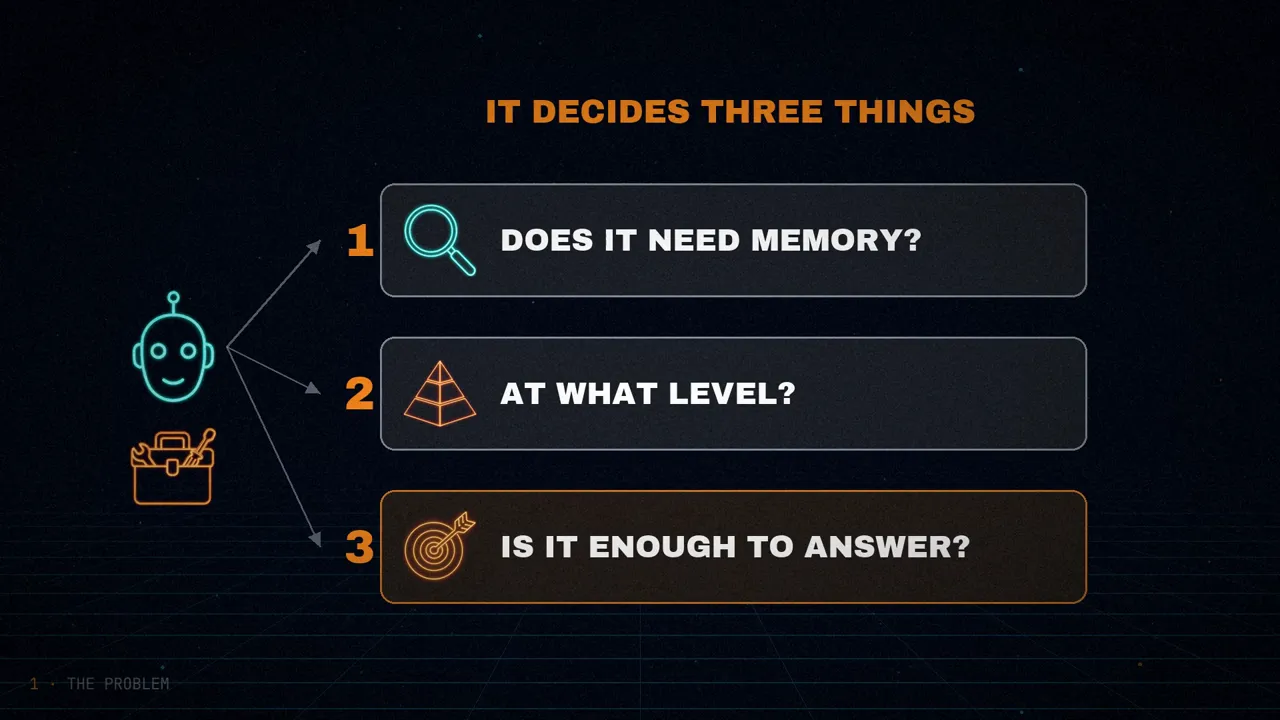
Eles chamam isso de navegação ativa da memória, e a diferença em relação a outros trabalhos que também treinam políticas de memória está no foco: não no que guardar ou quando apagar, e sim em como usar a memória na hora de responder, escolhendo o nível e ajustando conforme o que vai encontrando.
A pirâmide de memória
O NapMem constrói uma pirâmide para cada usuário, com quatro níveis. Todos contam a mesma história, cada um com outro grau de abstração, como um mapa que você pode ver inteiro ou aproximar até uma rua.
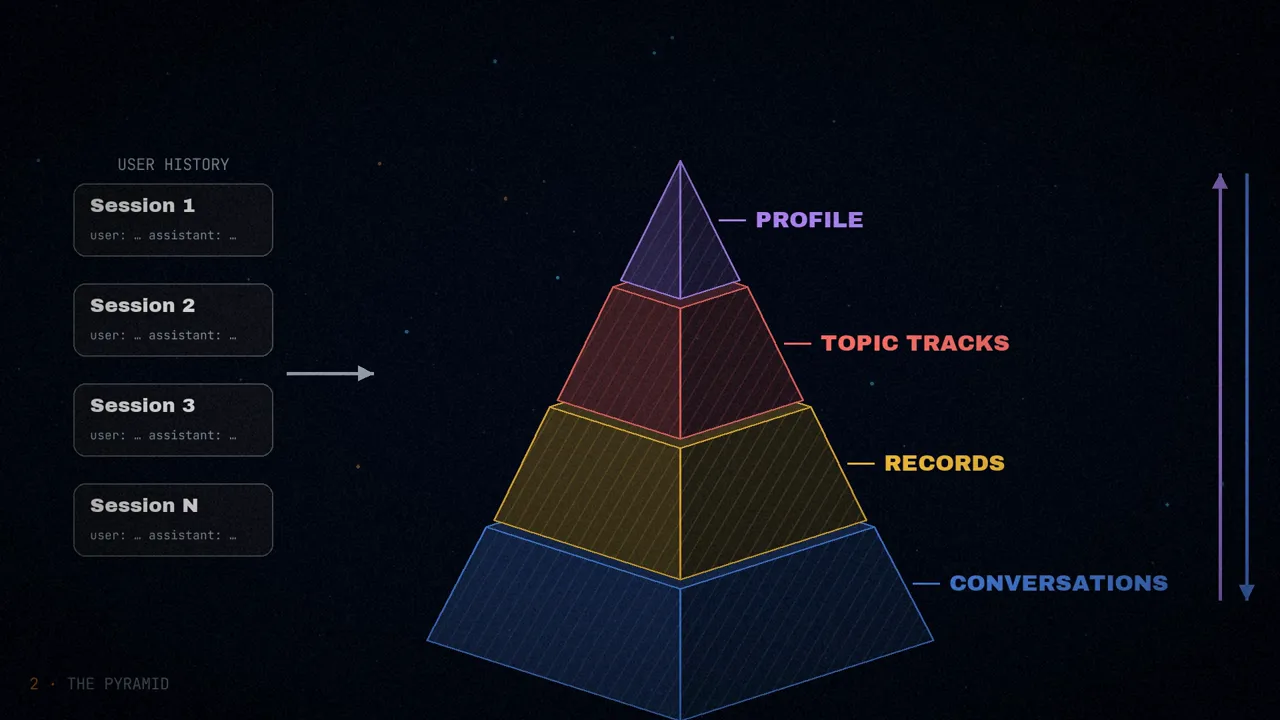
1. Conversas brutas
A base guarda cada mensagem como ela é, com o conteúdo, quem disse, quando, a sessão e um identificador único para encontrá-la com exatidão. Essa camada só cresce: nunca é reescrita. É a prova de maior fidelidade, a que o agente consulta quando precisa do detalhe fino.
2. Registros de memória
O segundo nível são frases compactas que tiram a enrolação da conversa e ficam só com o útil. Há quatro tipos: fatos, eventos, instruções e preferências. Cada registro leva seu identificador, seu tipo, seu texto, sua data e os identificadores das mensagens de onde saiu; esse vínculo permite voltar de uma lembrança resumida para a conversa original.
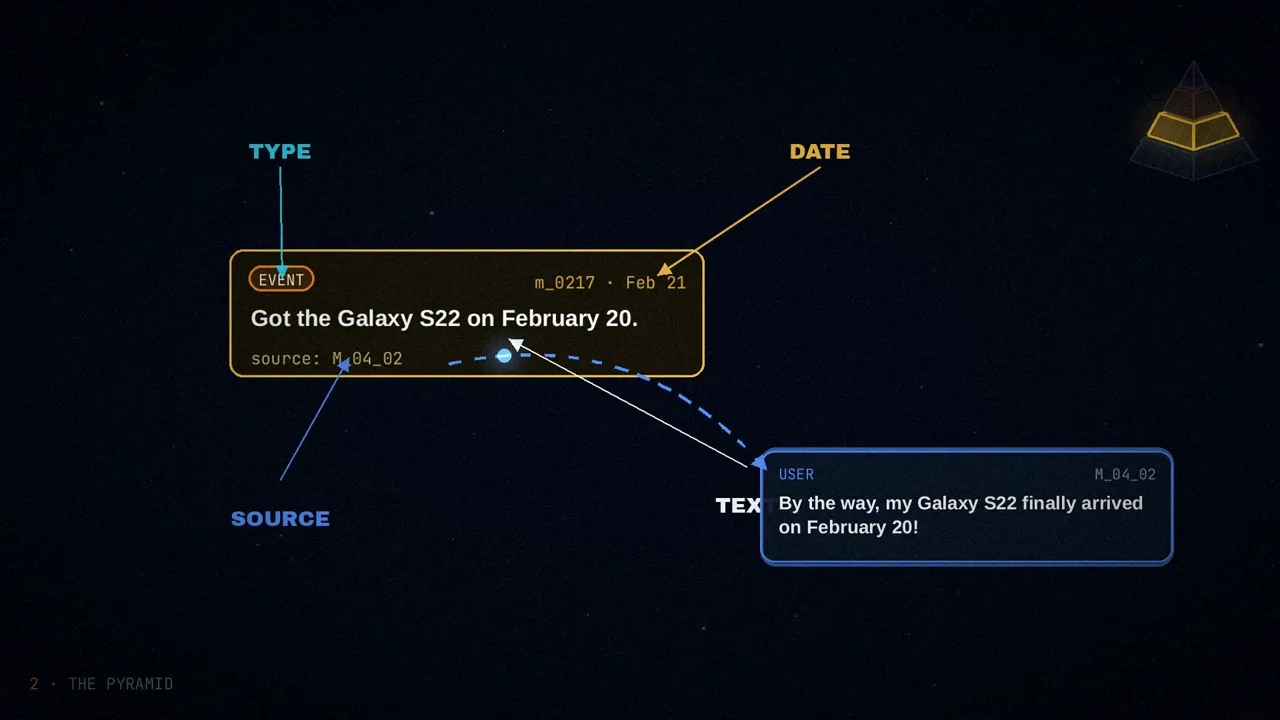
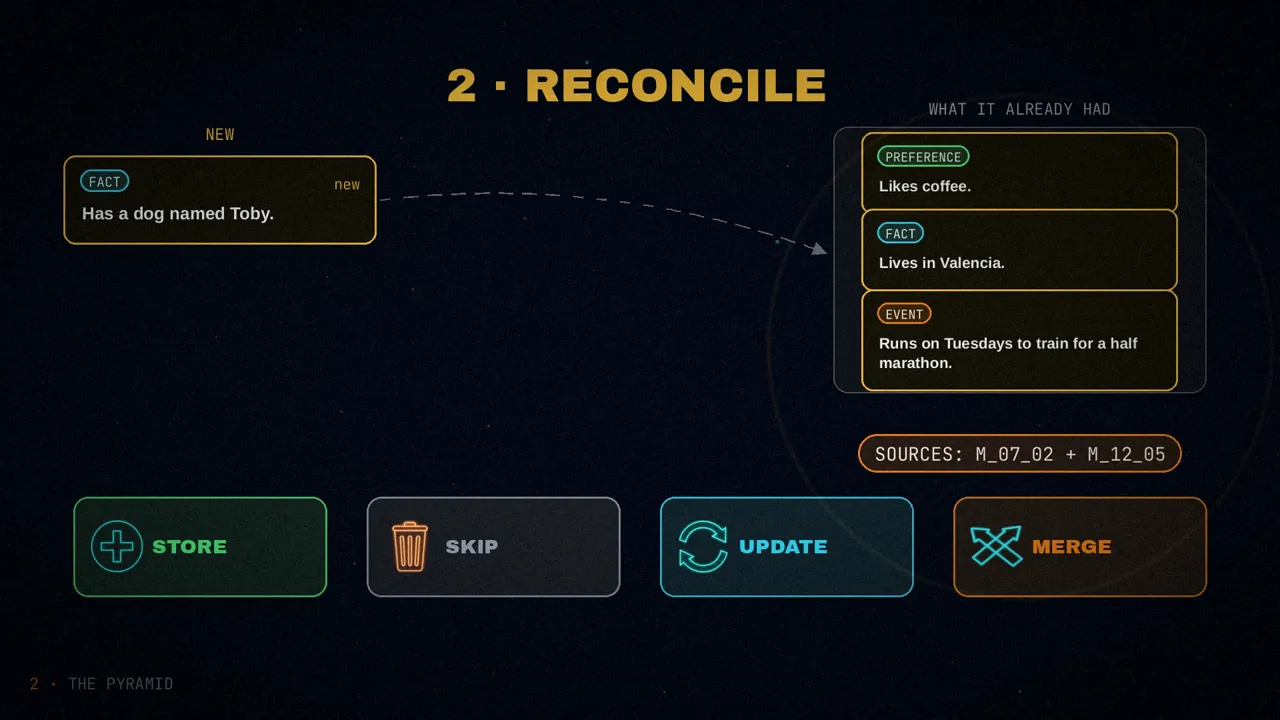
Eles são criados em duas etapas. Primeiro, depois de alguns turnos de conversa (o lote cresce de 1 para 2, para 4 e depois fica em 5 turnos), o modelo extrai registros novos das mensagens recentes. Depois os compara com os que já tinha, por busca híbrida, e escolhe o que fazer com cada um: guardar, descartar se for redundante, atualizar um antigo se algo mudou ou fundir os que falam da mesma coisa. Ao atualizar ou fundir, a união das fontes e das datas é preservada.
3. Trilhas temáticas
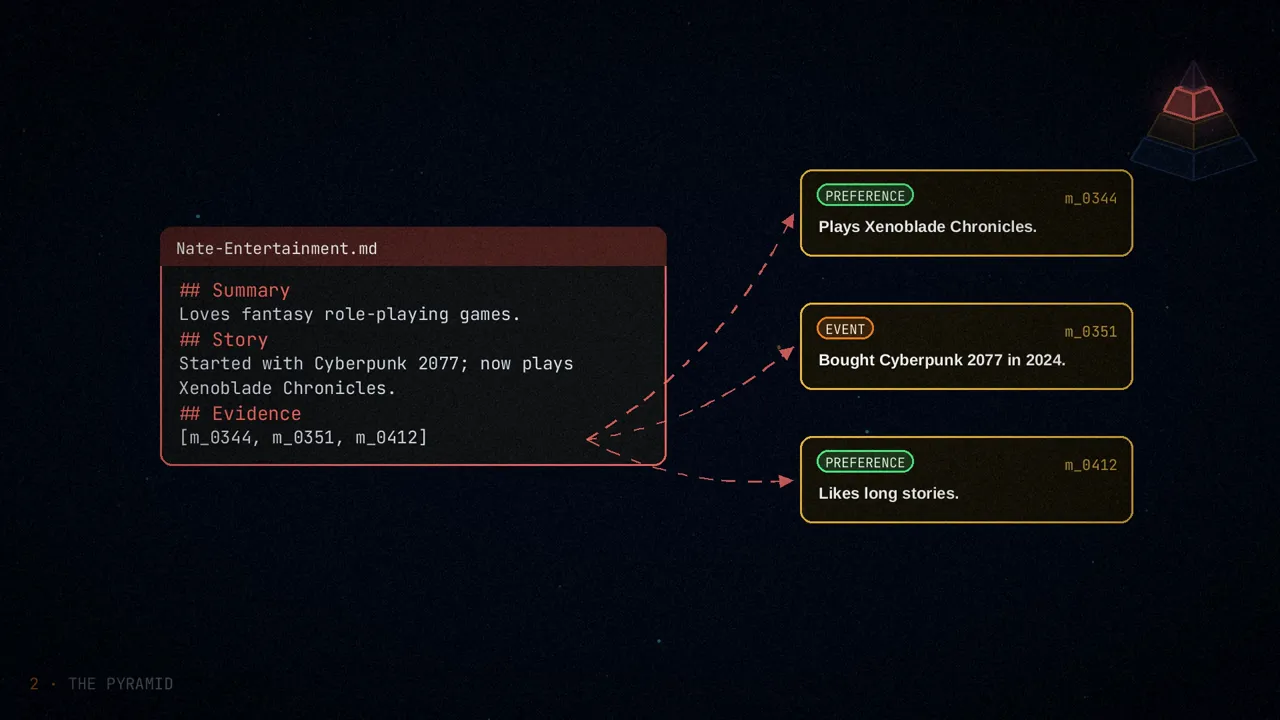
Um registro é um dado solto, mas muita coisa de uma pessoa evolui ao longo de semanas: um projeto, um hobby, um relacionamento. Cada trilha temática é um arquivo Markdown com metadados, um resumo, a história desse tema e uma seção de provas que liga os registros que a sustentam. Há no máximo 20 trilhas, e o agente decide se atualiza uma, funde duas ou abre outra nova. As escritas são validadas antes de serem confirmadas; se o formato falhar, elas são desfeitas.
4. O perfil do usuário
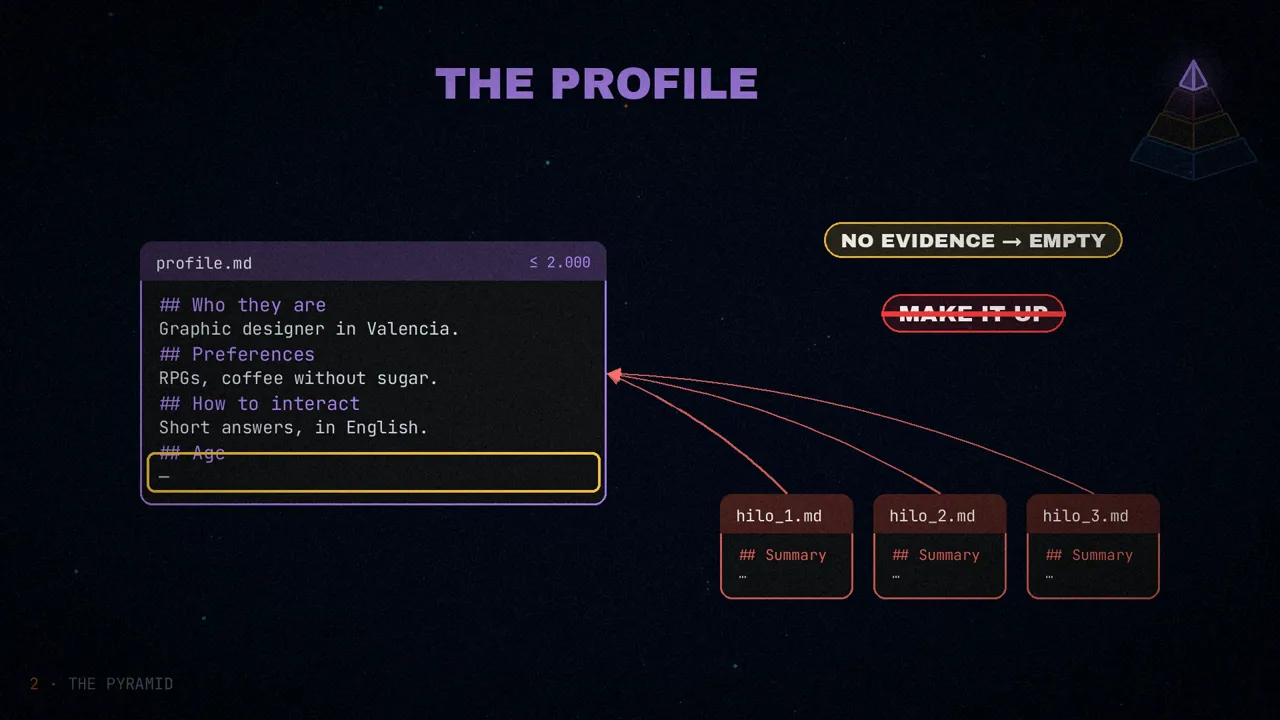
No topo fica o perfil: um resumo global de quem é o usuário, suas preferências de longo prazo e seu jeito de interagir. Ele tem um limite de 2.000 caracteres, então é revisado em vez de crescer. E só pode usar o que as trilhas dizem: se não houver provas, o campo fica vazio em vez de inventar.
Como ela é construída
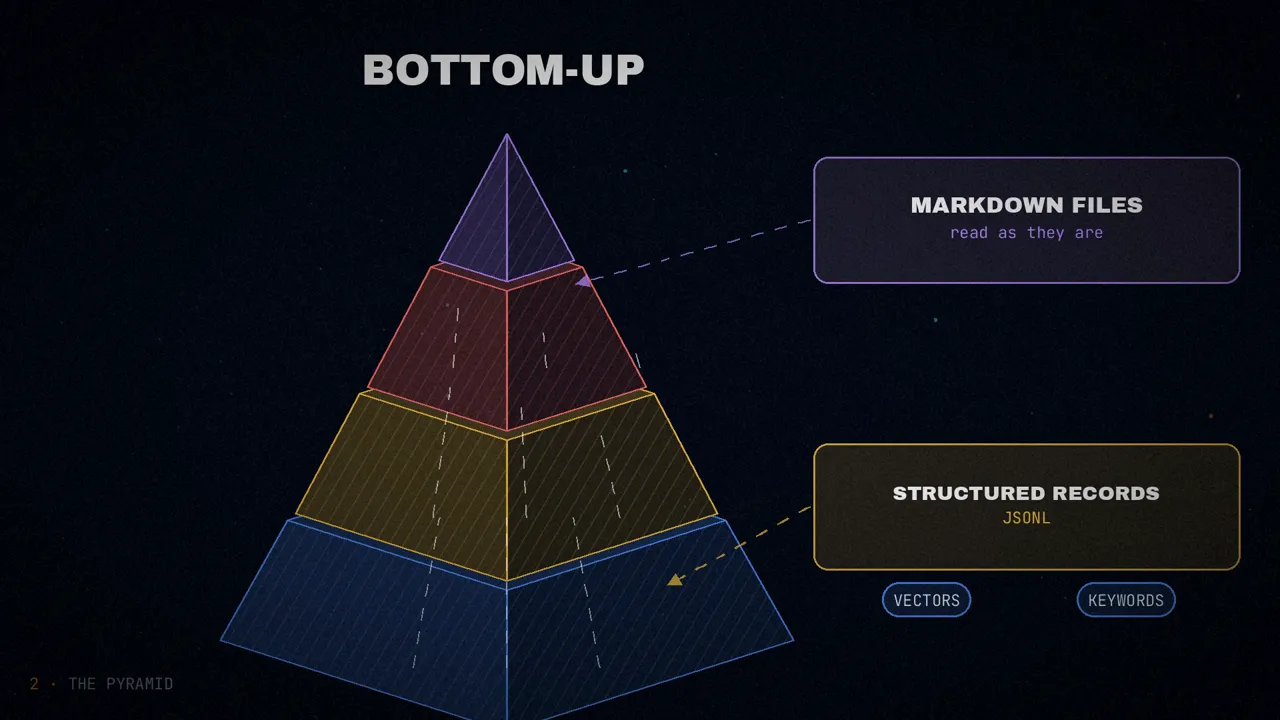
A pirâmide é construída de baixo para cima, aos poucos, percorrendo as sessões do usuário em ordem cronológica. Cada sessão nova entra nas conversas, dali saem registros, e as mudanças sobem: as trilhas são revisadas antes de uma sessão nova se há registros pendentes, nas mudanças de data ou quando se acumulam mais de 20 registros novos; o perfil, depois de atualizar as trilhas ou quando há mais de 50.
Os dois níveis de baixo são registros estruturados em JSONL com índices de vetores e de palavras-chave, para buscar pelo significado e achar algo exato pelo identificador. Os dois de cima são arquivos Markdown que são lidos como estão. E tudo fica ligado: do perfil às trilhas, das trilhas aos registros e dos registros às mensagens.
As cinco ferramentas
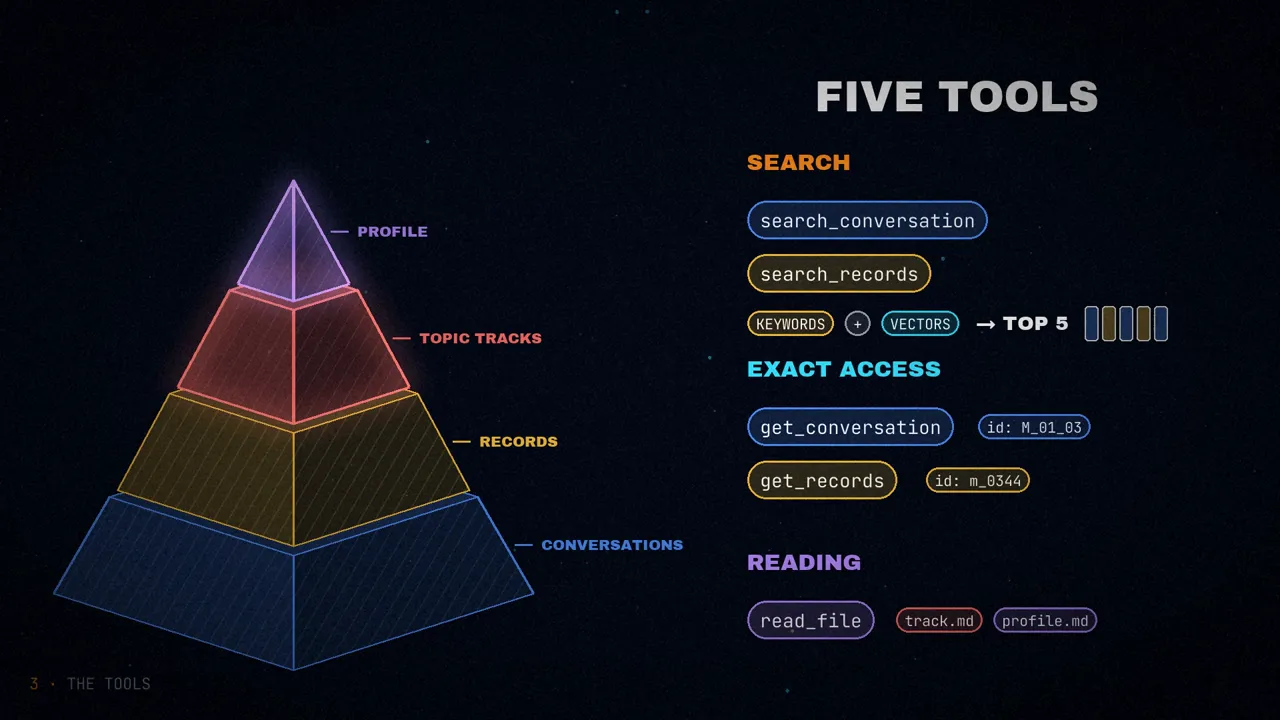
Para se mover pela pirâmide, o agente tem cinco ferramentas, cada uma pensada para um nível:
| Ferramenta | Entrada | O que faz |
|---|---|---|
search_conversation | texto livre | Busca nas mensagens brutas e devolve os 5 melhores trechos |
search_records | texto livre | Busca nos registros e devolve os 5 melhores |
get_conversation | lista de ids de mensagem | Traz mensagens exatas pelo identificador |
get_records | lista de ids de registro | Traz registros exatos pelo identificador |
read_file | nome do arquivo | Lê uma trilha temática ou o profile.md |
As duas de busca são híbridas: misturam palavras-chave e vetores com reciprocal rank fusion (RRF, com k = 60), sobre embeddings do Qwen3-Embedding-0.6B. As de acesso exato usam os identificadores devolvidos por chamadas anteriores, e a de leitura dá acesso aos níveis mais abstratos.
Navegar nas duas direções
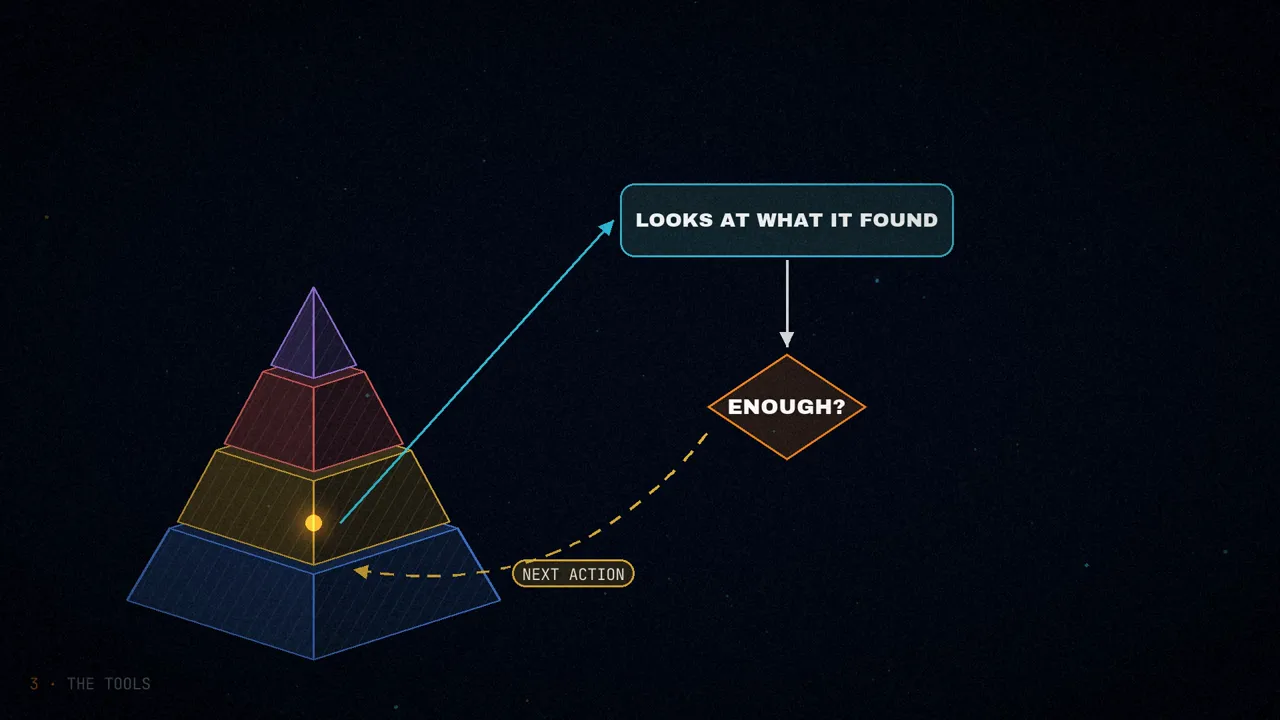
Com isso, a navegação pode ir de cima para baixo (começar pelo perfil ou por uma trilha, refinar com os registros e descer até a conversa para conferir a prova) ou de baixo para cima (buscar um detalhe e, se ele não aparecer, subir para um resumo). A cada passo o agente olha o que encontrou e decide a próxima ação, ou se para e responde. Formalmente, no passo t ele escolhe uma ação a partir da pergunta, da pirâmide e do que viu até ali, e a trajetória termina com a resposta.
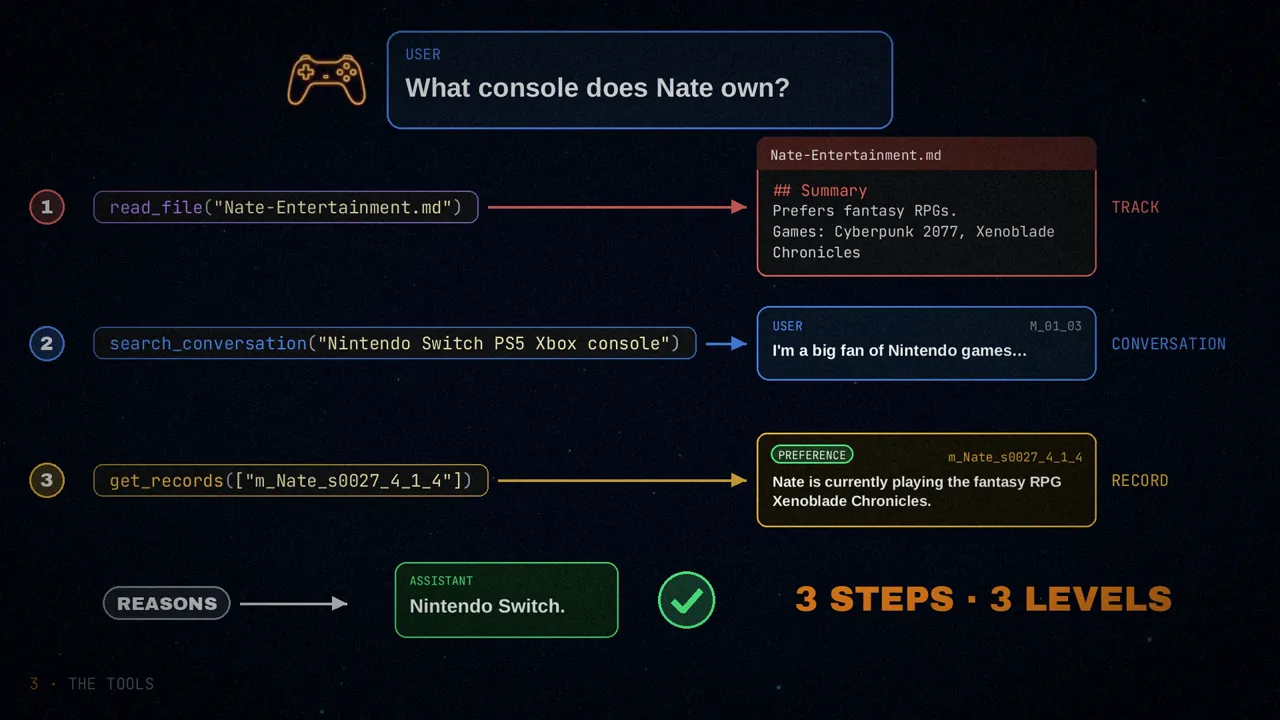
O exemplo da figura 2 do paper: «Que console o Nate tem?». O agente lê primeiro o Nate-Entertainment.md, que menciona Cyberpunk 2077 e Xenoblade Chronicles. Busca nas conversas com search_conversation("Nintendo Switch PS5 Xbox console") e descobre que o Nate é muito fã dos jogos da Nintendo. Depois traz com get_records o registro exato: ele está jogando Xenoblade Chronicles, um RPG de fantasia. Raciocina e responde: um Nintendo Switch. Três passos por três níveis diferentes.
Há um limite: no máximo quatro passos com ferramentas por pergunta; se passar disso, a resposta conta como erro. E o prompt é claro: não adivinhe nada sobre o usuário; se duas lembranças se contradizem, valem as instruções; use as conversas brutas quando precisar da prova exata; e pare de buscar assim que tiver provas suficientes, sem ir atrás de detalhes marginais. A resposta final vai em JSON, com a resposta e o motivo.
Aprender a navegar: a rubrica e o GRPO
Ter ferramentas não basta: é preciso saber usá-las. Por isso eles treinam o agente com aprendizado por reforço. Cada exemplo é uma pergunta que precisa de memória junto com a pirâmide daquele usuário; o agente responde com sua cadeia de chamadas e só recebe uma nota no final, pelo resultado. Essa nota treina ao mesmo tempo a resposta e todas as decisões de navegação que levaram até ela.
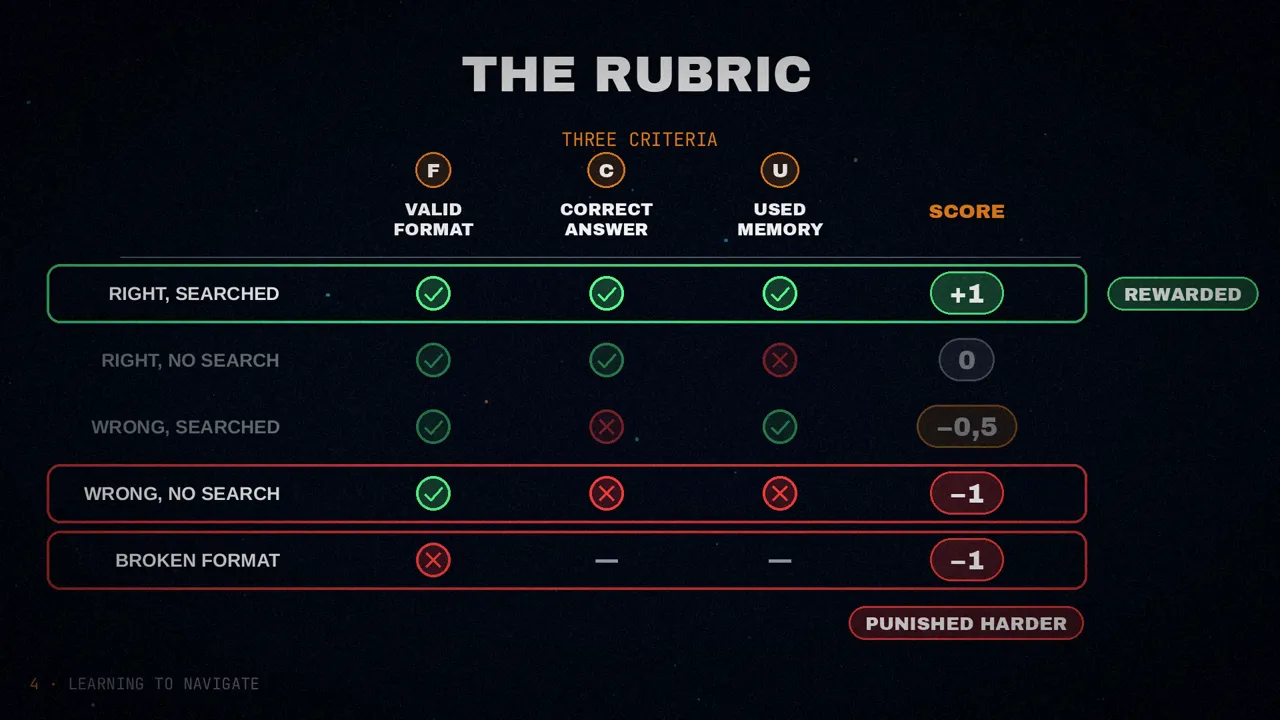
A nota segue uma rubrica com três critérios binários: formato válido (F), resposta correta (C) e uso da memória (U):
| Caso | F | C | U | Nota |
|---|---|---|---|---|
| Acerta usando a memória | 1 | 1 | 1 | +1 |
| Acerta sem usá-la | 1 | 1 | 0 | 0 |
| Erra depois de consultá-la | 1 | 0 | 1 | −0,5 |
| Erra sem consultá-la | 1 | 0 | 0 | −1 |
| Formato quebrado (ou estoura o orçamento) | 0 | – | – | −1 |
Assim, acertar buscando é premiado e inventar é punido com mais força. Como todas as perguntas do treino precisam de memória, acertar sem consultá-la não pontua.
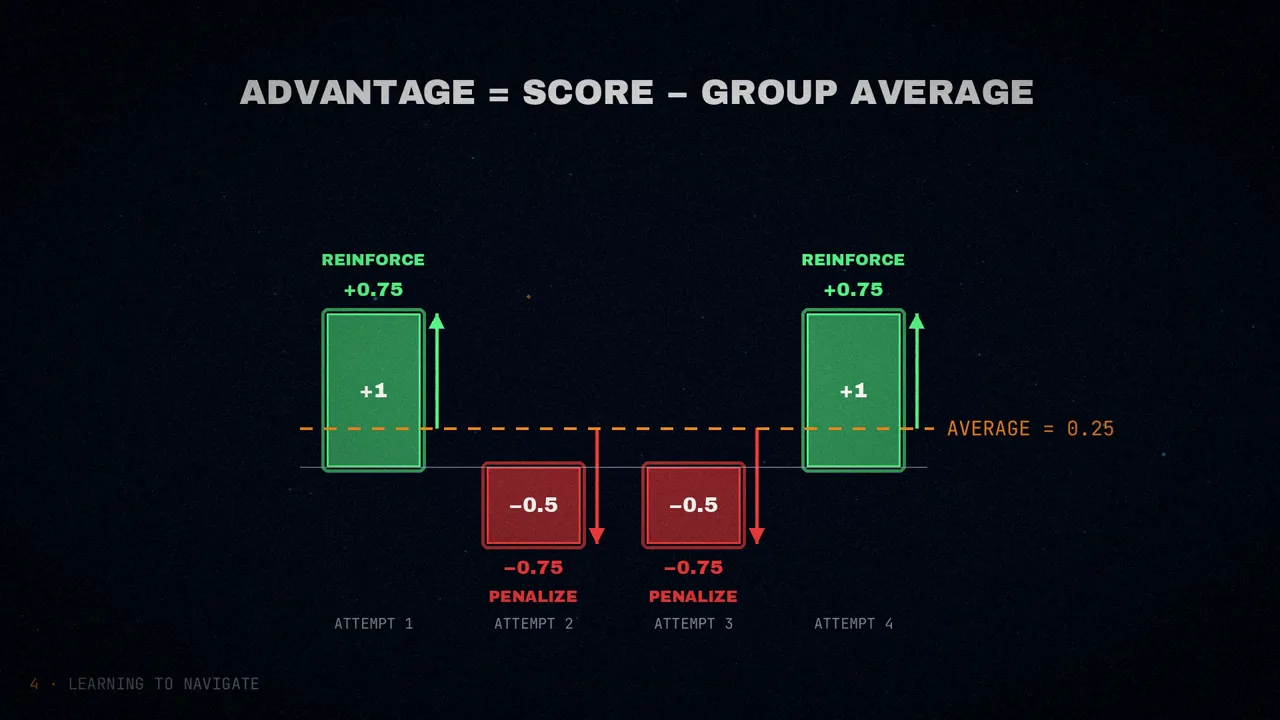
O algoritmo é o GRPO (Group Relative Policy Optimization). Para cada pergunta são gerados quatro tentativas, e a vantagem de cada uma é sua nota menos a média do grupo: as tentativas acima da média são reforçadas e as de baixo, penalizadas. Não é preciso um modelo à parte para julgar cada passo: o próprio grupo é a referência. A vantagem se aplica a todos os tokens da tentativa, inclusive os das chamadas a ferramentas, com o objetivo recortado de sempre e uma penalidade KL em relação ao modelo de partida.
Para quem quiser reproduzir, os hiperparâmetros do apêndice: Qwen3.5-9B como modelo base, lote de 8, grupos de 4 tentativas, taxa de aprendizado de 1×10⁻⁶, coeficiente KL de 0,001, sem termo de entropia, bfloat16, 5 épocas e até 5 turnos do assistente, com o framework verl em GPUs NVIDIA H20.
Treinamento e avaliação
Eles treinam com perguntas de dois benchmarks, LoCoMo e PersonaMem-v2, separando os usuários (60% para treino, 20% para validação e 20% para teste) para que ninguém apareça dos dois lados. O terceiro, LongMemEval, nunca é visto durante o treino: serve para conferir se o aprendido funciona fora do terreno conhecido. LoCoMo e LongMemEval medem a memória de fatos (lembrar algo distante, mudanças ao longo do tempo, raciocinar entre sessões); o PersonaMem-v2, as preferências implícitas. Os testes têm 1.315 perguntas do LoCoMo, 100 do LongMemEval e 911 do PersonaMem-v2.
Eles comparam com cinco sistemas de memória: Mem0 (memória plana de vetores), Zep (grafo temporal), MemOS (um sistema operacional de memória), MemoryOS (memória hierárquica) e AgeMem (memória agêntica treinada com reforço), todos sobre o mesmo Qwen3.5-9B. NapMem e AgeMem podem dar no máximo quatro passos com ferramentas e cada busca devolve até 5 itens; os sistemas não agênticos podem trazer até 20 por busca.
Nas perguntas abertas, o juiz é o Claude Opus 4.6. Eles conferiram a confiabilidade com 100 respostas anotadas por três pessoas: ele concorda com a maioria humana em 99% dos casos (precisão 1,0, revocação 0,98, κ de Cohen 0,98). A única divergência foi um «0 vezes» que o juiz deu como errado quando a resposta esperada era que aquilo nunca foi mencionado. Todos os resultados são a média de três sementes.
Os resultados
A tabela 1 do paper (L-J é a nota do juiz; a média junta a nota do juiz no LoCoMo e no LongMemEval com a precisão no PersonaMem-v2):
| Sistema | LoCoMo F1 | LoCoMo L-J | LongMemEval F1 | LongMemEval L-J | PersonaMem-v2 | Média |
|---|---|---|---|---|---|---|
| Mem0 | 41,19 | 60,86 | 53,86 | 78,00 | 38,89 | 59,25 |
| Zep | 36,09 | 52,21 | 52,61 | 73,33 | 36,33 | 53,96 |
| MemOS | 35,22 | 55,82 | 39,16 | 54,33 | 37,58 | 49,24 |
| MemoryOS | 31,40 | 44,28 | 22,68 | 23,67 | 35,82 | 34,59 |
| AgeMem | 38,00 | 45,02 | 37,83 | 51,33 | 24,19 | 40,18 |
| NapMem-122B (sem treino) | 35,39 | 51,69 | 48,86 | 70,00 | 41,38 | 54,36 |
| NapMem-397B (sem treino) | 38,31 | 54,42 | 53,85 | 78,33 | 46,10 | 59,85 |
| NapMem-9B com RL | 41,28 | 59,92 | 57,41 | 80,33 | 47,97 | 62,74 |
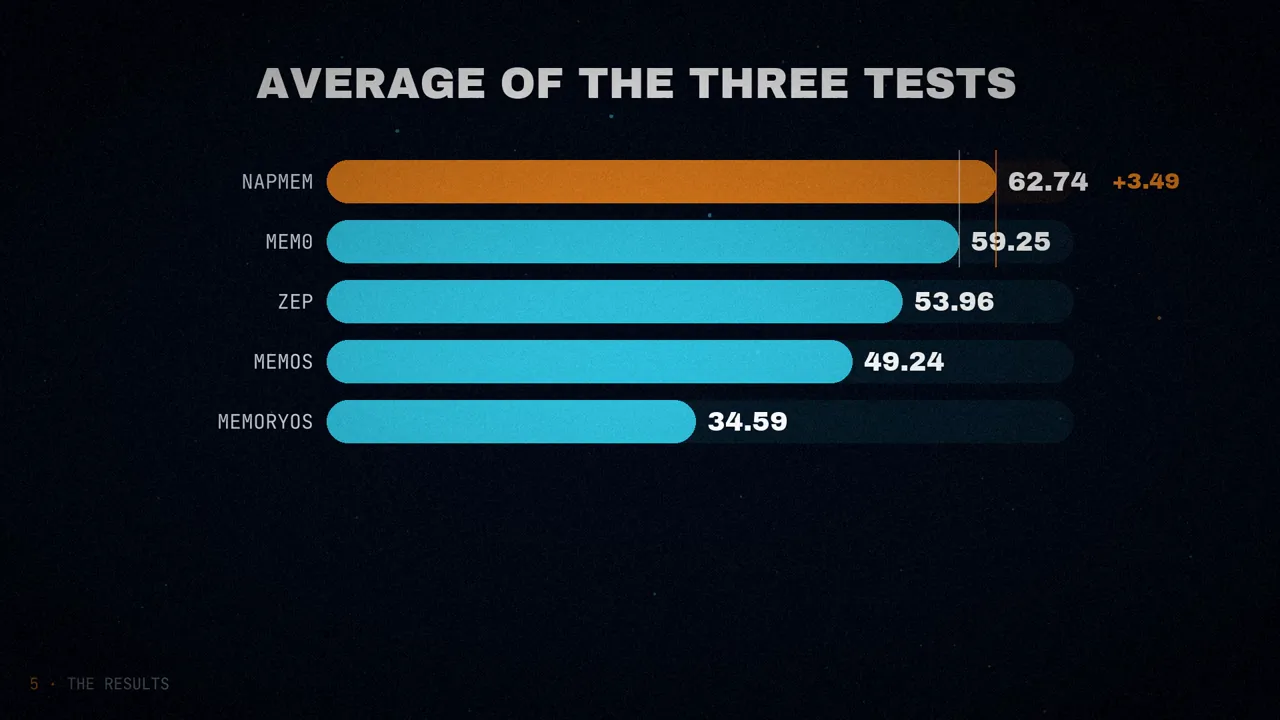
O NapMem treinado tem a melhor média, 62,74, contra 59,25 do melhor rival, o Mem0. No LongMemEval, o teste que ele não viu no treino, chega a 80,33, o melhor de todos; no PersonaMem-v2, a 47,97, também na frente.
No LoCoMo ele não vence em tudo, e vale dizer: tem o melhor F1 (41,28 contra 41,19), mas na nota do juiz o Mem0 fica um ponto à frente (60,86 contra 59,92). Ou seja, na memória de fatos de conversas longas ele está no mesmo nível do melhor; onde ele se destaca é na personalização e no que não tinha visto no treino.
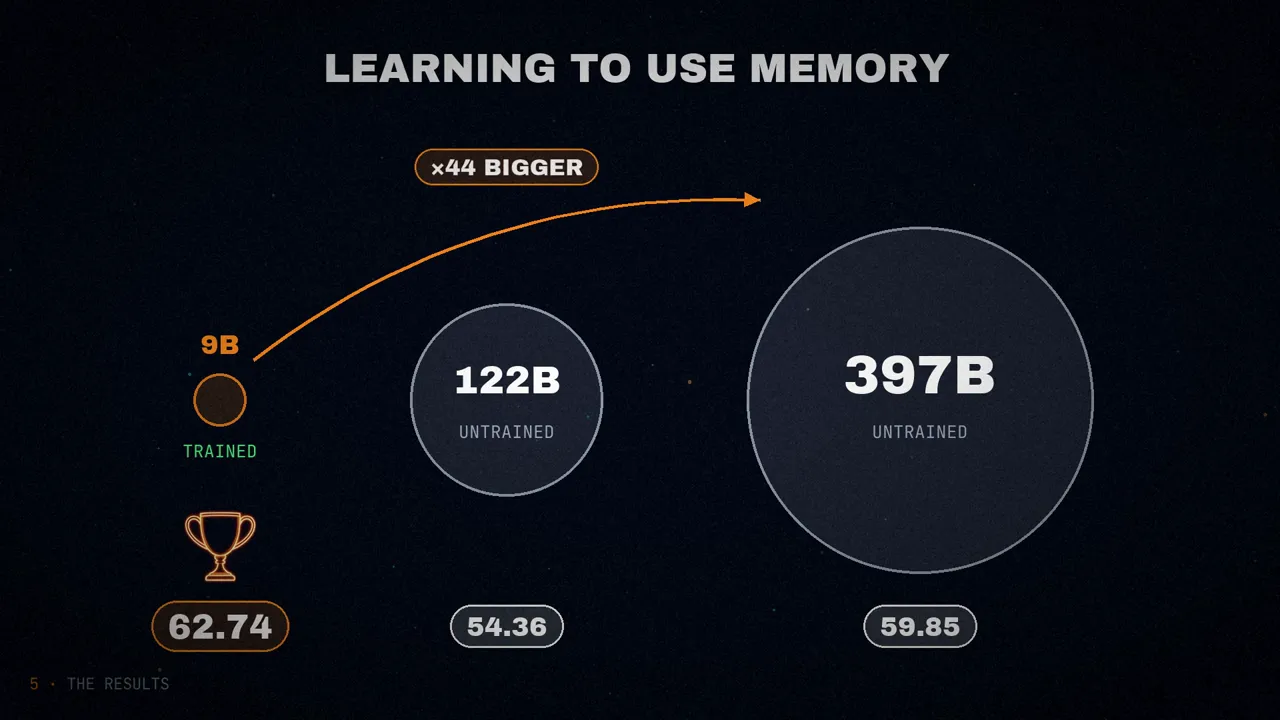
9B treinado contra 397B
O mais chamativo da tabela são as duas linhas do meio. Eles testaram a mesma pirâmide e as mesmas ferramentas com modelos muito maiores, sem treino: Qwen3.5-122B e Qwen3.5-397B. O maior tira 59,85 de média; o pequeno de 9B, treinado, 62,74. Aprender a usar a memória vale mais do que multiplicar o tamanho por quarenta.
Quando a memória não é necessária
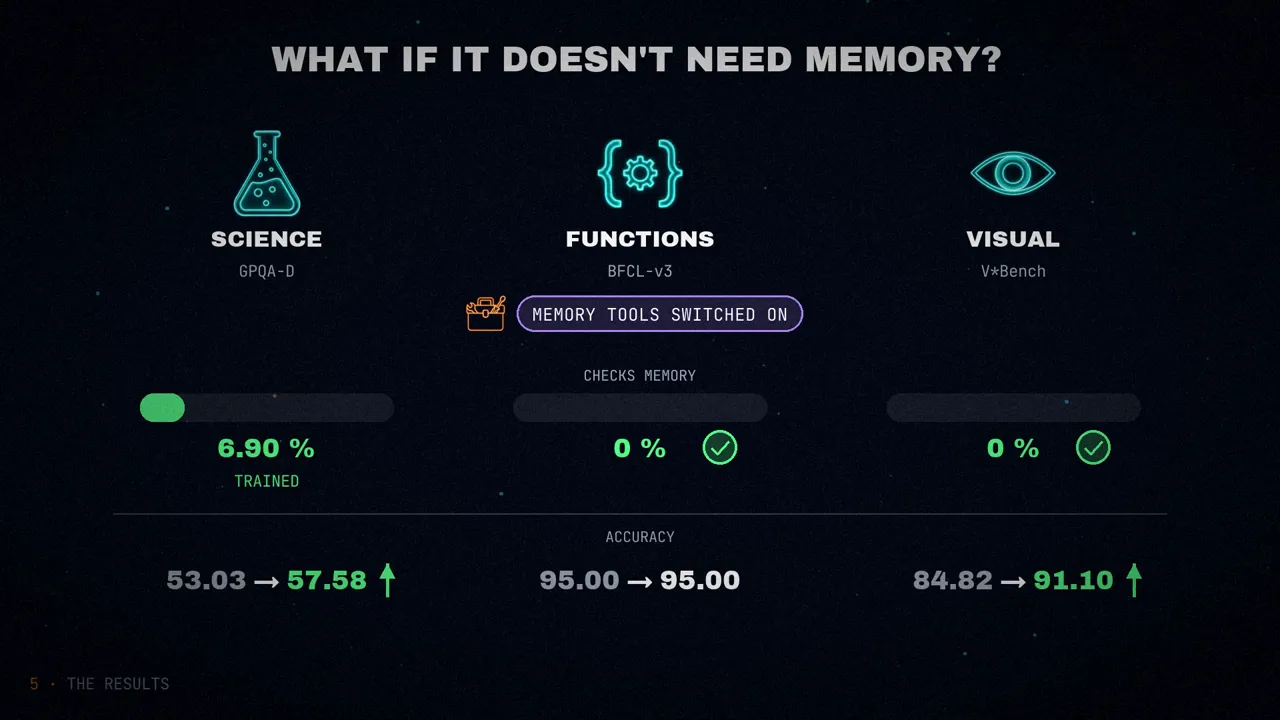
E se a pergunta não precisar de memória? Para conferir que o treino não o transforma em um agente que consulta a memória para tudo, eles deram a ele três tarefas sem relação com o usuário (ciência com GPQA-Diamond, chamadas de funções com BFCL-v3 e busca visual com V*Bench), com uma pirâmide qualquer e todas as ferramentas de memória ativas:
| Teste | Métrica | Modelo base | NapMem-9B sem RL | NapMem-9B com RL |
|---|---|---|---|---|
| GPQA-Diamond | Precisão | 53,03 | 55,74 | 57,58 |
| GPQA-Diamond | Chamadas à memória | – | 34,51% | 6,90% |
| BFCL-v3 | Tarefa / ferramenta / execução | 95,00 / 97,50 / 93,50 | 93,50 / 97,50 / 94,00 | 95,00 / 97,50 / 94,50 |
| BFCL-v3 | Chamadas à memória | – | 0% | 0% |
| V*Bench | Resposta | 84,82 | 89,53 | 91,10 |
| V*Bench | Chamadas à memória | – | 0% | 0% |
Sem treino, o modelo olhava a memória em 34,51% das perguntas de ciência, sem motivo; treinado, só em 6,90%. Nas outras duas tarefas, nunca. E ele não perde desempenho: até melhora um pouco em ciência e no teste visual. O reforço calibra quando usar a memória, não apenas faz usar mais.
O custo: espaço e tempo
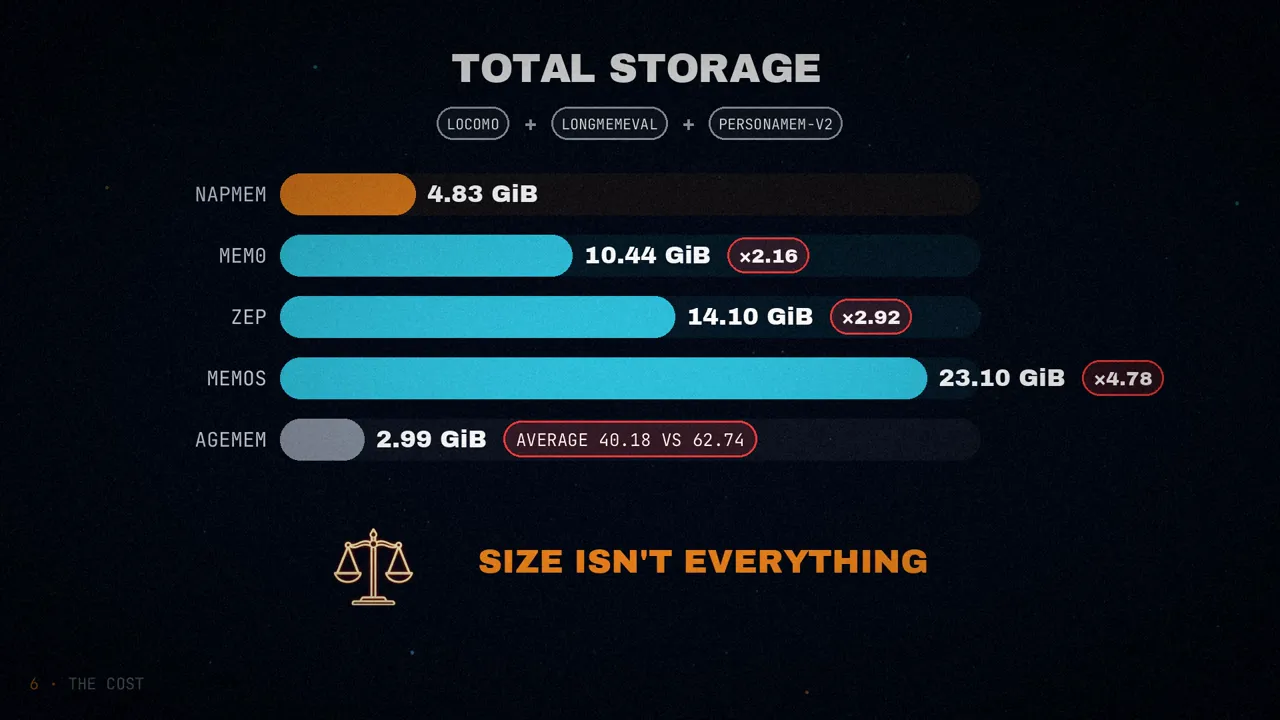
A memória de um usuário não para de crescer, então ocupar pouco importa. Somando os três benchmarks, o NapMem ocupa 4,83 GiB, menos que quase todos, apesar de guardar quatro níveis:
| Sistema | PersonaMem-v2 | LongMemEval | LoCoMo | Total |
|---|---|---|---|---|
| NapMem | 0,69 | 4,01 | 0,12 | 4,83 |
| Mem0 | 1,40 | 8,90 | 0,14 | 10,44 (×2,16) |
| MemOS | 3,61 | 18,85 | 0,64 | 23,10 (×4,78) |
| Zep | 3,50 | 10,00 | 0,60 | 14,10 (×2,92) |
| MemoryOS | 1,98 | 4,30 | 0,40 | 6,68 (×1,38) |
| AgeMem | 0,34 | 2,56 | 0,09 | 2,99 (×0,62) |
Só o AgeMem ocupa menos, com sua memória plana e leve, mas rende muito pior (40,18 de média). O tamanho sozinho não diz tudo.
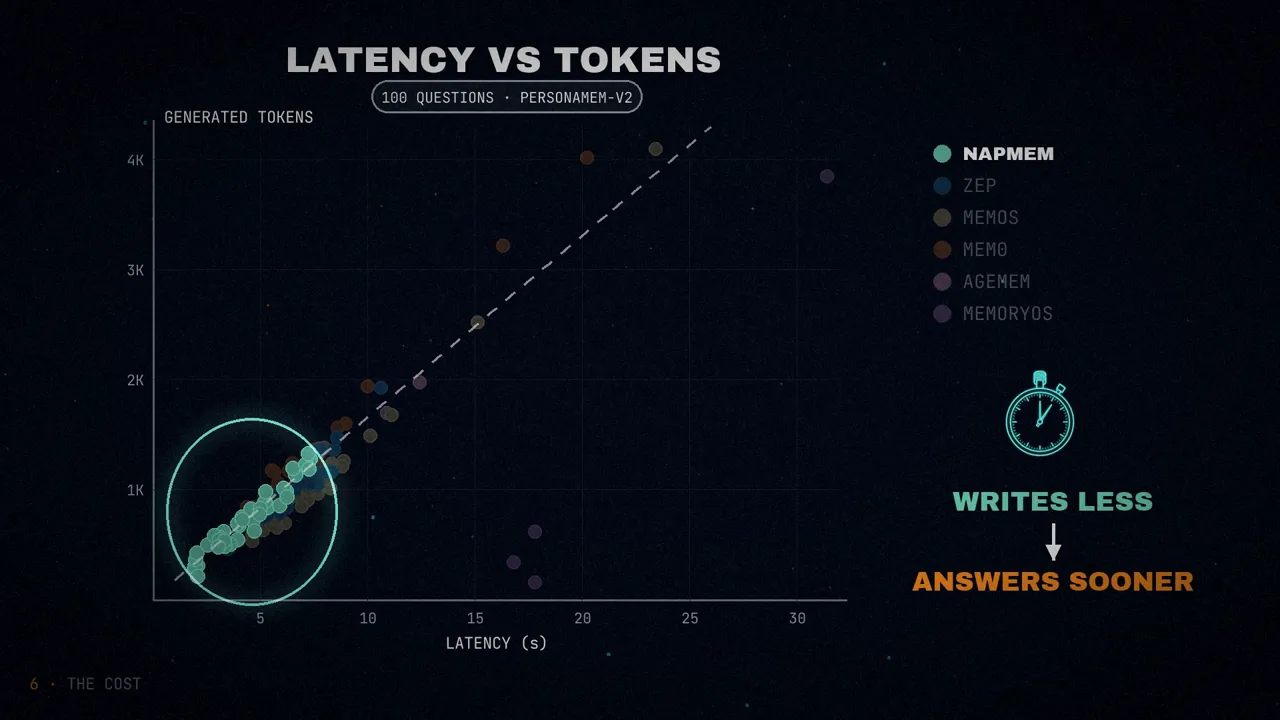
E o tempo de resposta. Em cem perguntas do PersonaMem-v2, a latência cresce quase em linha reta com os tokens que o modelo gera: quanto mais ele escreve, mais demora. Os sistemas passivos recebem muito texto e raciocinam sobre tudo; o NapMem busca o que precisa e para assim que tem provas, então escreve menos e responde antes, mesmo usando ferramentas.
Qual peça importa
Para ver qual parte dá a vantagem, eles tiraram peças uma a uma (nota do juiz no LoCoMo e no LongMemEval, precisão no PersonaMem-v2):
| Variante | LoCoMo | LongMemEval | PersonaMem-v2 | Média |
|---|---|---|---|---|
| NapMem completo | 59,92 | 80,33 | 47,97 | 62,74 |
| Sem aprendizado por reforço | 52,09 | 72,33 | 20,75 | 48,39 |
| Sem navegação (recuperação passiva) | 48,37 | 68,00 | 45,88 | 54,08 |
| Só ferramentas de registros | 39,77 | 60,00 | 35,02 | 44,93 |
| Sem níveis de cima (sem trilhas nem perfil) | 49,13 | 75,00 | 38,20 | 54,11 |
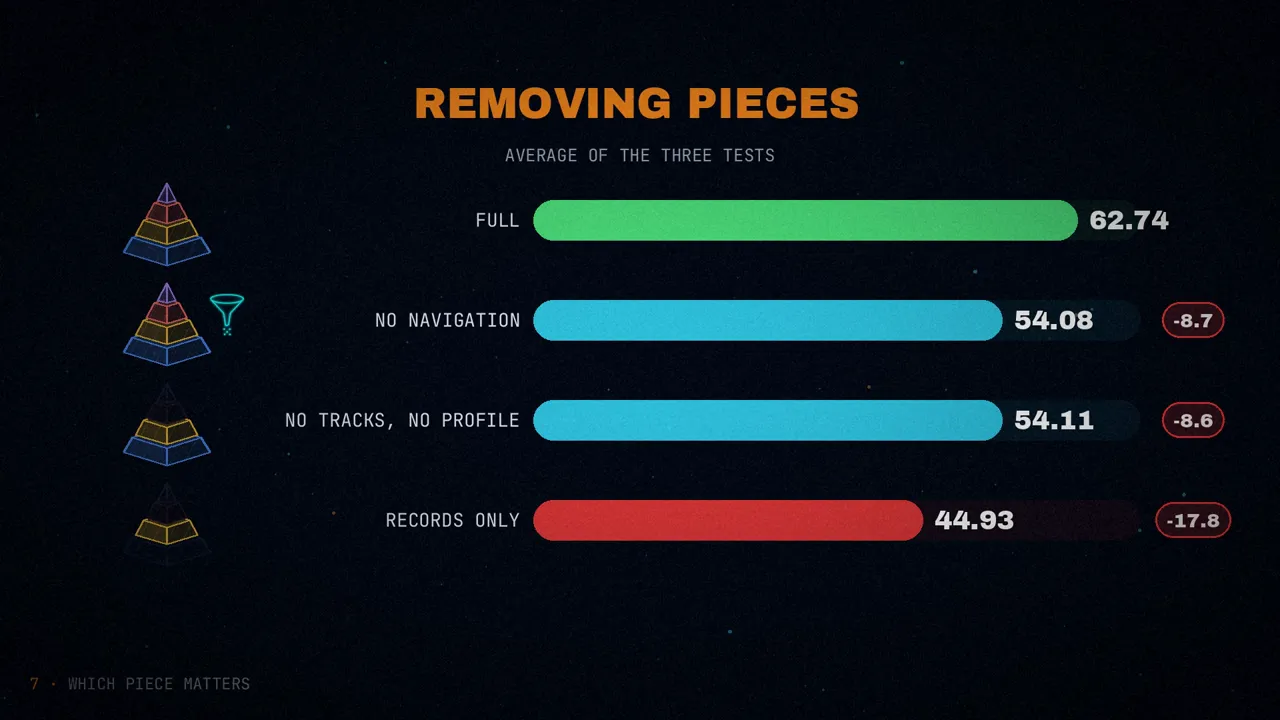
As três peças se somam. Navegar é melhor do que receber, mesmo com a mesma memória disponível. Os resumos de cima completam o detalhe de baixo. E usar bem a memória se aprende: sem o reforço, com a mesma pirâmide e as mesmas ferramentas, a média cai para 48,39, e no PersonaMem-v2 despenca de 47,97 para 20,75. Não basta explicar no prompt.
Como ele navega
Eles olharam qual é a primeira ferramenta que cada modelo usa. Os de 9B quase sempre começam pelos registros (92,16% sem treino, 88,84% treinado). Já os grandes começam lendo arquivos em quase metade dos casos (44,38% o de 122B e 46,60% o de 397B). Uma possível explicação dos autores: os modelos grandes digerem melhor um resumo longo, e os pequenos preferem provas curtas e concretas.
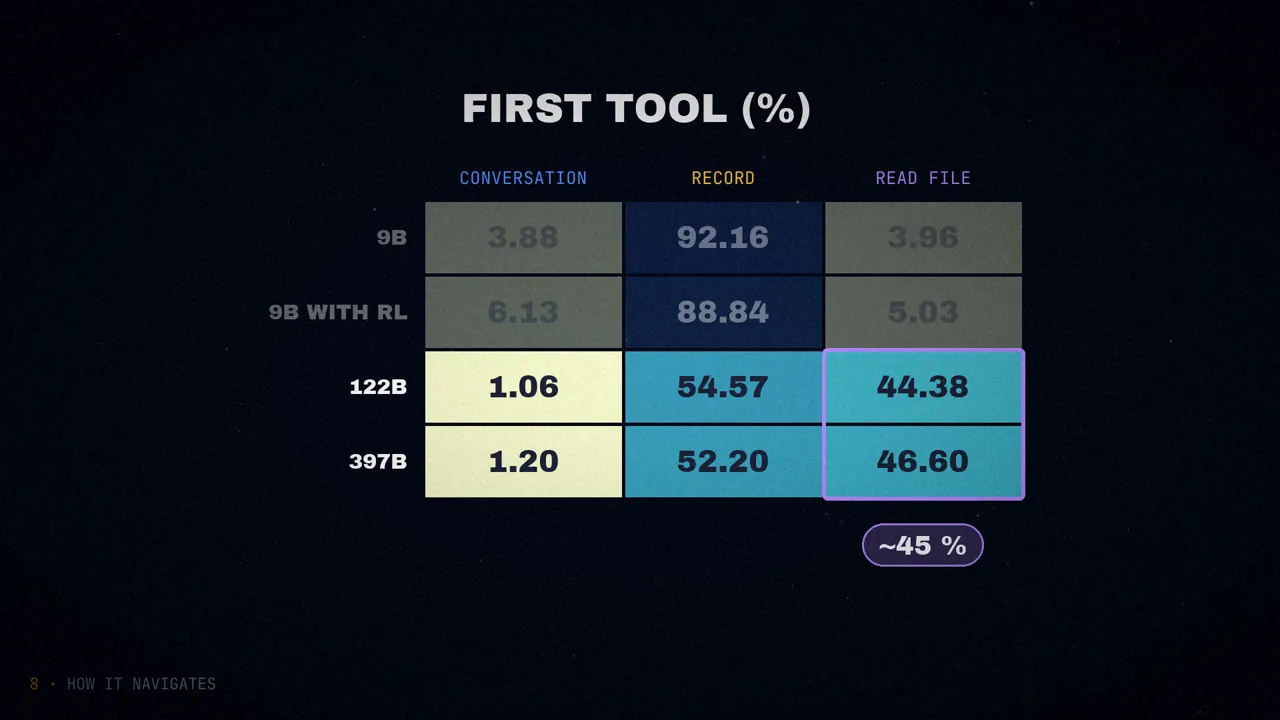
E o reforço muda o jeito de buscar. Sem treino, o modelo de 9B fazia 3,97 chamadas por pergunta; treinado, 2,15, e mesmo assim acerta mais: de cada cem resultados que as ferramentas devolvem, 34,92 são provas úteis, contra 20,66 antes. Ele não fica preso a um só nível: 79,63% das perguntas continuam usando vários (80,39% antes do treino). Ele aprendeu a parar.
Um acerto e um erro
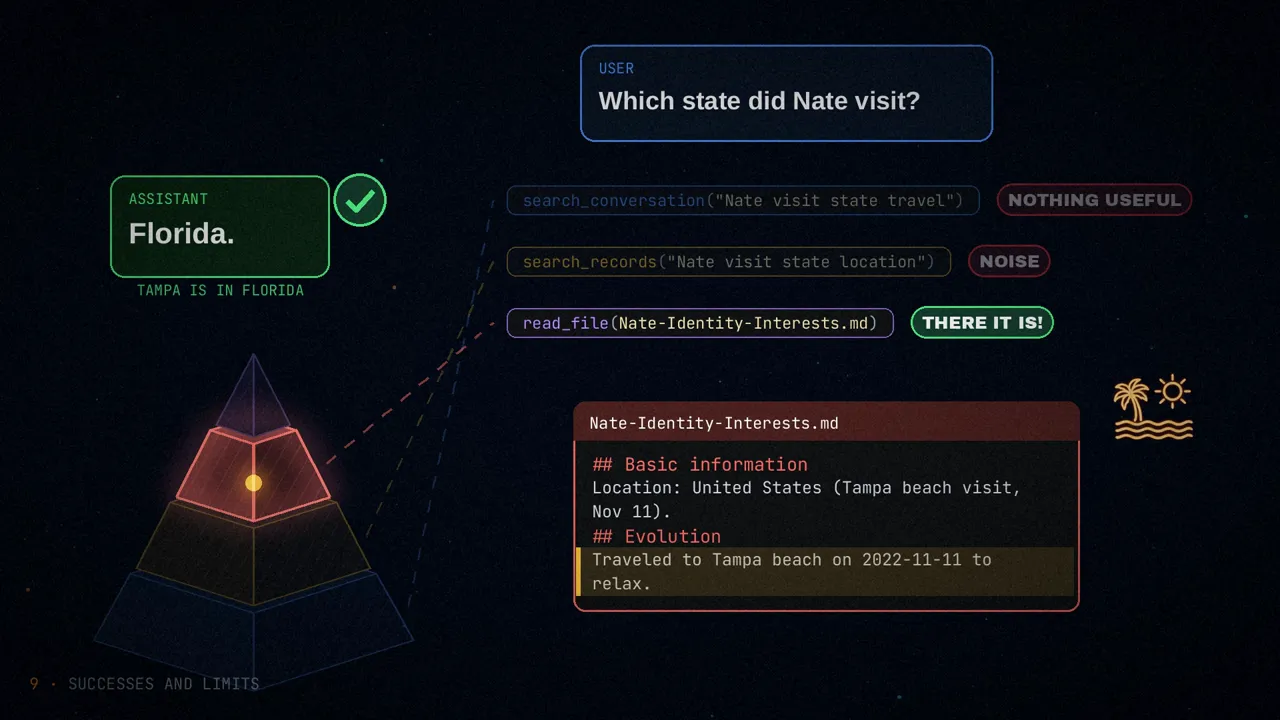
O acerto. Pergunta: «Que estado o Nate visitou?». search_conversation("Nate visit state travel") não traz nada útil; search_records(...) devolve registros irrelevantes ou vagos. Então o agente lê a trilha Nate-Identity-Interests.md e ali está: o Nate viajou para a praia de Tampa em 11 de novembro de 2022. Resposta: Flórida. Subir para um nível mais abstrato resgatou o que a busca direta não encontrava.
O erro. Alguém pede ideias tranquilas para o fim de semana. O agente encontra um registro: o usuário pensou em colocar salsa em uma festa beneficente porque no ano anterior tinha dado certo. Encontra outro: ele se enche de energia em eventos lotados, mas depois precisa ficar sozinho. E escolhe a opção que dá como certo que ele adora sair para dançar salsa nos fins de semana. Ele transformou um evento isolado em uma preferência estável: as lembranças eram relevantes, mas não bastavam para essa conclusão. Os autores apontam isso como trabalho futuro: calibrar quanto cada lembrança realmente prova.
Limitações
Os próprios autores apontam três:
- Os benchmarks não capturam todas as formas reais de personalização nem de conversa aberta.
- Privacidade e esquecimento, dois requisitos-chave em qualquer sistema que lembra coisas sobre pessoas, não estão totalmente resolvidos.
- O tamanho do modelo: ainda falta estudar a fundo como a estratégia de acesso à memória muda com a escala.
Uma curiosidade: no apêndice de implementação escapa outro nome, «PyraNav», provavelmente o de uma versão anterior do método.
Resumindo
O NapMem guarda a memória do usuário em uma pirâmide de quatro níveis (conversas, registros, trilhas temáticas e perfil) e treina o agente com aprendizado por reforço para se mover por ela com cinco ferramentas, em vez de receber o que outro escolhe. Assim, um modelo de 9B supera um de 397B sem treino, busca menos, acerta mais e quase nunca consulta a memória sem necessidade.
A memória de um agente funciona melhor como um lugar que ele percorre do que como um pedaço de contexto que entregam a ele.
O que você gostaria que o seu assistente lembrasse de você?
Fontes
- «From Passive Retrieval to Active Memory Navigation: Learning to Use Memory as a Structured Action Space», de Yue Xu, Yutao Sun, Yihao Liu, Mengyu Zhou, Jiayi Qiao, Lu Ma, Kai Tang, Wenjie Wang, Xiaoxi Jiang e Guanjun Jiang (Qwen, Alibaba; ShanghaiTech; Zhejiang; Peking; NUS), arXiv 2607.05794, 7 de julho de 2026.
- Sobre outras abordagens de memória para agentes: meus posts sobre o Quarq Agent e o LongMemEval e sobre a LLM Wiki do Karpathy.
- O vídeo, nos meus canais: inglês e espanhol.