Por que o terminal
Durante anos, os assistentes de código viveram dentro do editor, como copilotos que sugeriam linhas e precisavam ser vigiados de perto. Agora a mudança vai para o terminal, e o Claude Code abriu o caminho. Faz sentido: o terminal é o coração do desenvolvimento. É ali que vivem o controle de versões, a compilação, as sessões remotas por SSH e os servidores sem tela.
O impacto já é enorme. O GitHub Copilot passa de quinze milhões de desenvolvedores, e todos os grandes laboratórios têm seu próprio agente de terminal. Mas fazer isso bem não é fácil: no Terminal-Bench, até os modelos de ponta resolvem menos de 65% das tarefas, e no LongCLI-Bench, com tarefas longas, menos de 20%.
O paper resume o problema em três desafios:
As sessões longas transbordam a janela de contexto do modelo.
Um agente que pode executar qualquer comando também pode destruir tudo.
Cada capacidade que você adiciona ocupa espaço no prompt.
Andaime, arnês e um sistema composto
Para resolvê-los, o paper separa duas fases. O andaime (scaffolding) monta o agente antes da primeira mensagem: o prompt de sistema, os esquemas das ferramentas e o registro de subagentes. O arnês (harness) orquestra tudo depois, enquanto ele trabalha: executa as ferramentas, gerencia o contexto e faz cumprir a segurança.
E por que um paper assim? Porque quase ninguém conta como esses agentes são feitos. Há frameworks pensados para benchmarks, como o SWE-Agent; outros funcionam no navegador, como o OpenHands; e agentes de terminal como Aider, Goose ou OpenCode não publicam relatórios técnicos. O Claude Code também não, e além disso é fechado.
A ideia central é que o OpenDev é um sistema de inteligência artificial composto. Não é um único modelo, mas um conjunto de agentes e fluxos de trabalho, e cada um se conecta ao modelo que o usuário escolher. Assim, trocar de provedor ou baratear custos é questão de configuração, não de código, e o agente melhora sempre que saem modelos melhores.
Três princípios guiam o design:
- Separar responsabilidades: cada decisão (o modelo, o contexto, a segurança, as ferramentas) é configurada e trocada sem mexer nas outras.
- Degradar com elegância: continuar funcionando quando acabam os tokens, as iterações ou a rede.
- Transparência antes da mágica: o desenvolvedor pode ver e corrigir tudo o que o agente faz, de cada chamada de ferramenta a cada compactação.
Quatro camadas e cinco de segurança
O OpenDev se organiza em quatro camadas: em cima, a de entrada, com uma interface de terminal e outra web; embaixo, o agente, que raciocina; depois, as ferramentas e o contexto; e no fundo, a persistência, que guarda tudo. Cada pedido as percorre em ordem, de cima para baixo.
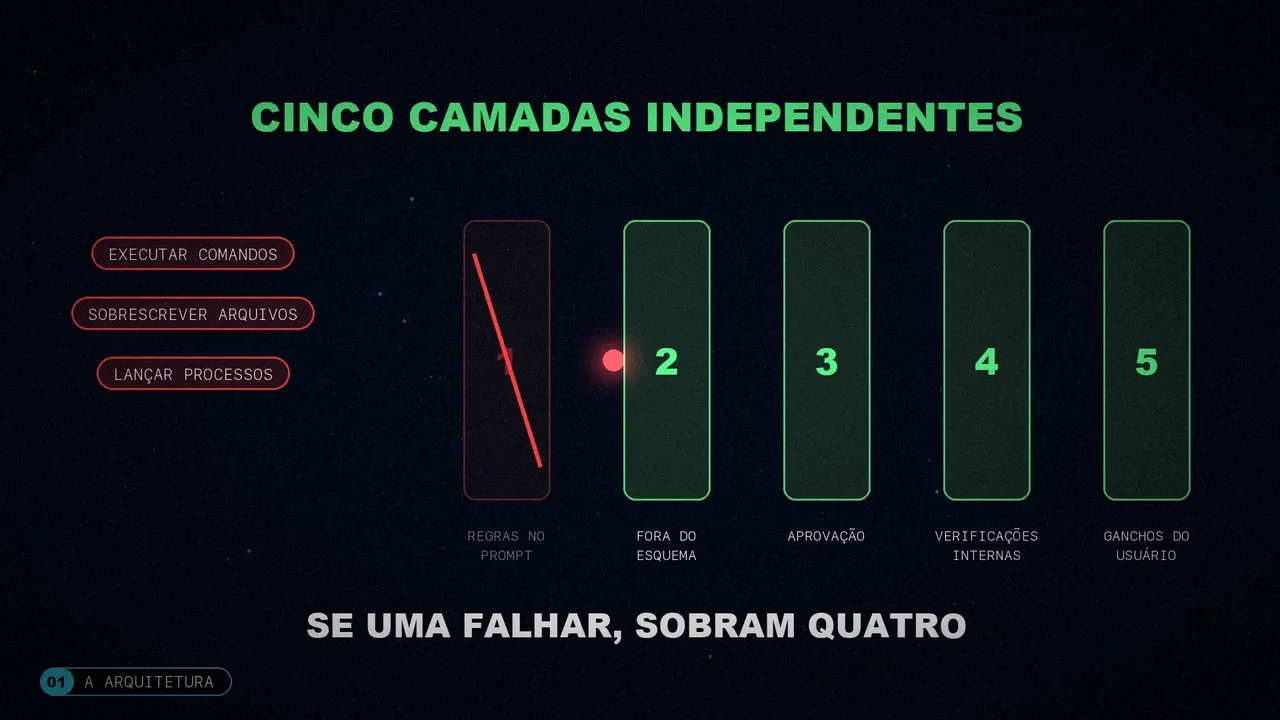
Como o agente pode executar comandos, sobrescrever arquivos e lançar processos, um único mecanismo de segurança não basta. Há cinco camadas independentes, e se uma falhar, sobram quatro:
- Regras no prompt.
- Ferramentas que nem aparecem no esquema do agente.
- Aprovação em tempo de execução, com permissões que ficam salvas.
- Verificações dentro de cada ferramenta: padrões perigosos, leituras desatualizadas, limites de tempo.
- Ganchos que o usuário define.
O núcleo do agente
A primeira surpresa: não há uma hierarquia de tipos de agente, e sim uma única classe. O agente principal, os subagentes e os que você definir são instâncias dela, e só mudam seus parâmetros, principalmente quais ferramentas podem usar. No começo eles tinham classes separadas (um planejador, um explorador, um gerador web…), e combinar capacidades, como um agente web que também planeja, virou uma bagunça.
Uma fábrica monta os agentes em três passos e numa ordem fixa: primeiro as skills, depois os subagentes e, por fim, o agente principal. A ordem importa, porque a ferramenta que lança subagentes descreve os que existem, então eles precisam estar prontos antes. E cada agente é construído inteiro desde o início: com a construção preguiçosa, a primeira chamada demorava mais e as ferramentas que chegavam tarde, como as de MCP, não apareciam no prompt.
Dois modos: planejar e executar
Se você pede para planejar, ou digita /plan, entra em cena um subagente planejador que só tem ferramentas de leitura. Ele explora o código, o analisa e escreve um plano com sete seções: objetivo, contexto, arquivos que mudam, arquivos novos, passos, verificação e riscos. Você o aprova (revisando ou não cada edição) ou pede mudanças, e aí ele é executado com todas as ferramentas.
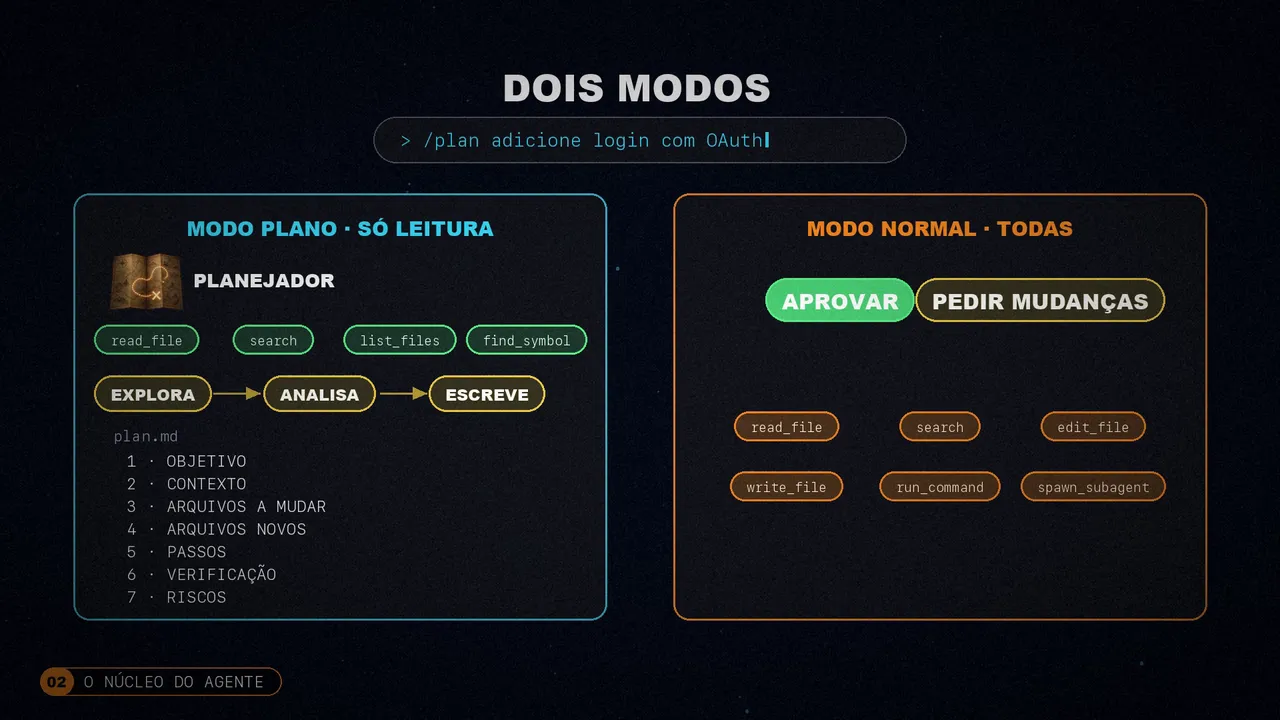
Antes, o modo plano era uma máquina de estados com quatro ferramentas (entrar, sair, criar e editar o plano), e às vezes o agente nunca saía e ficava preso em somente leitura. Agora o planejador não pode escrever porque essas ferramentas nem existem no seu esquema. Não é preciso bloqueá-las.
O ciclo de cada mensagem
Cada mensagem segue o mesmo ciclo: o agente recolhe o que você escreveu enquanto ele trabalhava, comprime o contexto se for preciso, pensa se isso estiver ativado e chama o modelo. As leituras rodam em paralelo, até cinco de cada vez, e as escritas, uma depois da outra. Antes de terminar, ele verifica que não há tarefas pendentes.
O ciclo tem dez eventos em que você pode pendurar seus próprios scripts: o início da sessão, cada mensagem, antes e depois de cada ferramenta, os subagentes ou a compactação. Um gancho prévio pode bloquear a ferramenta (com o código de saída 2) ou reescrever seus argumentos, por exemplo para adicionar --dry-run ou para rodar o linter depois de editar um arquivo.
E nem tudo precisa do modelo: o que começa com uma barra vai direto para um comando (limpar a sessão, compactar, trocar de modo ou de modelo, conectar um servidor MCP). São operações determinísticas: não pedem aprovação e não gastam tokens.
Cinco modelos e o ciclo ReAct
Cada fase do trabalho pede um modelo diferente, então o OpenDev distribui cinco papéis, e se faltar algum, outro ocupa o seu lugar:
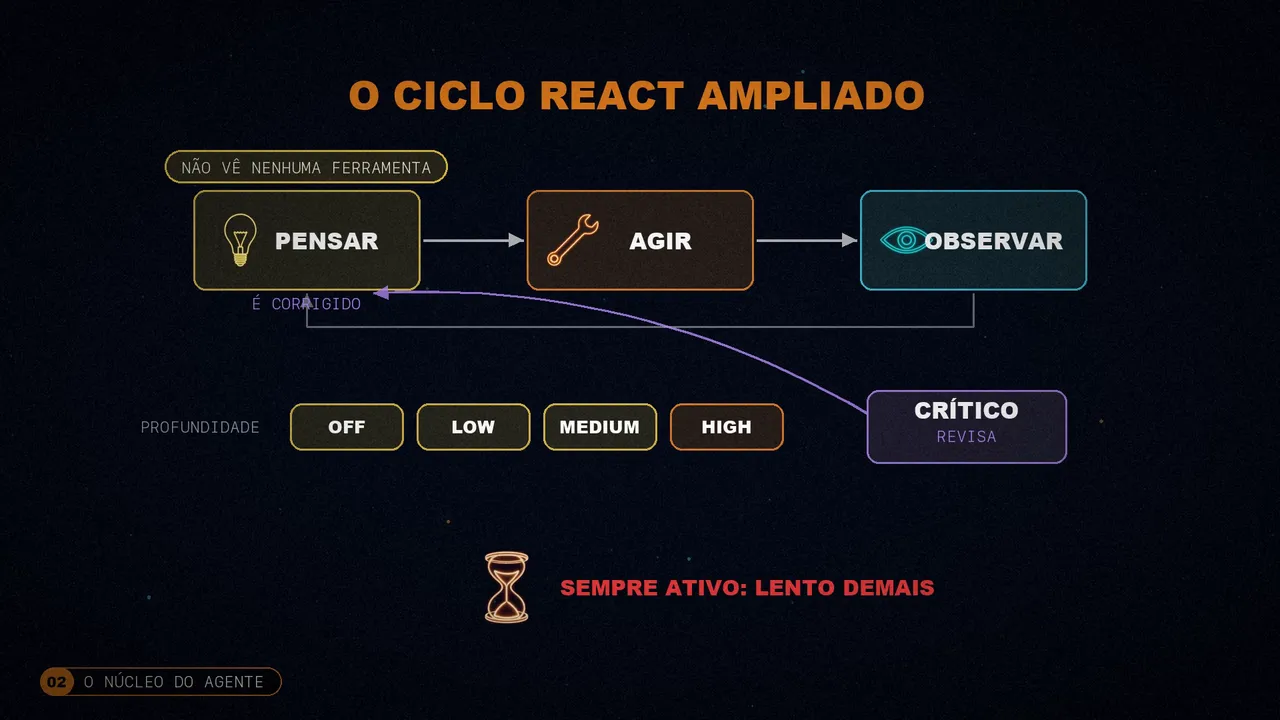
O modelo principal, o que usa as ferramentas.
Raciocina sem ferramentas, para não se precipitar.
Revisa o raciocínio, só no nível mais alto.
Um entende capturas de tela e imagens; outro, pequeno e rápido, resume o contexto.
O coração é um ciclo ReAct ampliado. O ReAct clássico mistura raciocinar e agir no mesmo turno, e com as ferramentas à vista, o modelo tende a agir antes de pensar. Por isso existe uma fase de pensamento prévia, com um modelo que não vê nenhuma ferramenta. Ela tem quatro níveis de profundidade; no mais alto, o crítico revisa o raciocínio e o modelo o corrige. Aplicar a autocrítica sempre se mostrou lento demais.
Loops travados
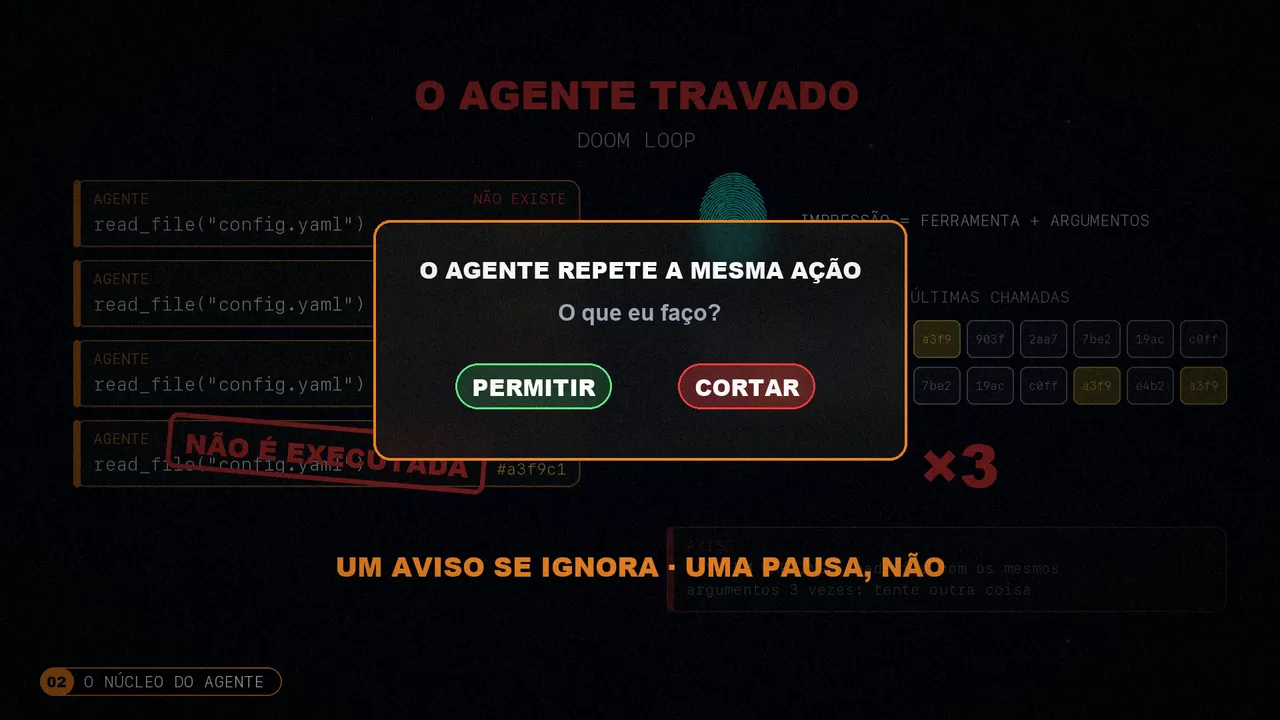
Outra armadilha: o agente que repete a mesma coisa, como ler sem parar um arquivo que não existe. O OpenDev tira uma impressão digital de cada chamada, com a ferramenta e seus argumentos, e vigia as vinte últimas. Se uma se repete três vezes, avisa o modelo e não a executa. Se insistir, ele para e te pergunta se deve deixá-la seguir ou cortar. Como diz o paper, um aviso pode ser ignorado; uma pausa de verdade, não.
Subagentes especializados
O agente principal delega a subagentes: um explorador do código, um planejador, revisores de código e de segurança, geradores de sites… Cada um tem só as ferramentas do seu papel. Assim o contexto deles é menor, eles não pisam na lista de tarefas (só o principal a mantém) e, se errarem, o dano fica limitado. Se você pede várias coisas independentes, ele lança vários ao mesmo tempo, cada um na sua thread e com seu próprio contexto, e depois junta os resultados numa única resposta. No começo eles não sabiam quando parar e o explorador relia os mesmos arquivos; agora têm condições de parada explícitas.
A engenharia de contexto
A qualidade de cada resposta depende, acima de tudo, do que o modelo vê na sua janela: quais instruções recebe, quanta conversa mantém, o que aprendeu antes e que informação é reunida para cada chamada. O OpenDev trata isso como uma prioridade máxima.
Um prompt por seções, com cache
Em vez de um prompt de sistema enorme, ele é montado a partir de seções independentes, cada uma no seu arquivo e com uma condição. As regras de git, por exemplo, só carregam dentro de um repositório. Elas são filtradas, ordenadas por prioridade e unidas; o que não contribui nem ocupa espaço nem distrai o modelo. Há até seções próprias de cada provedor de modelos.
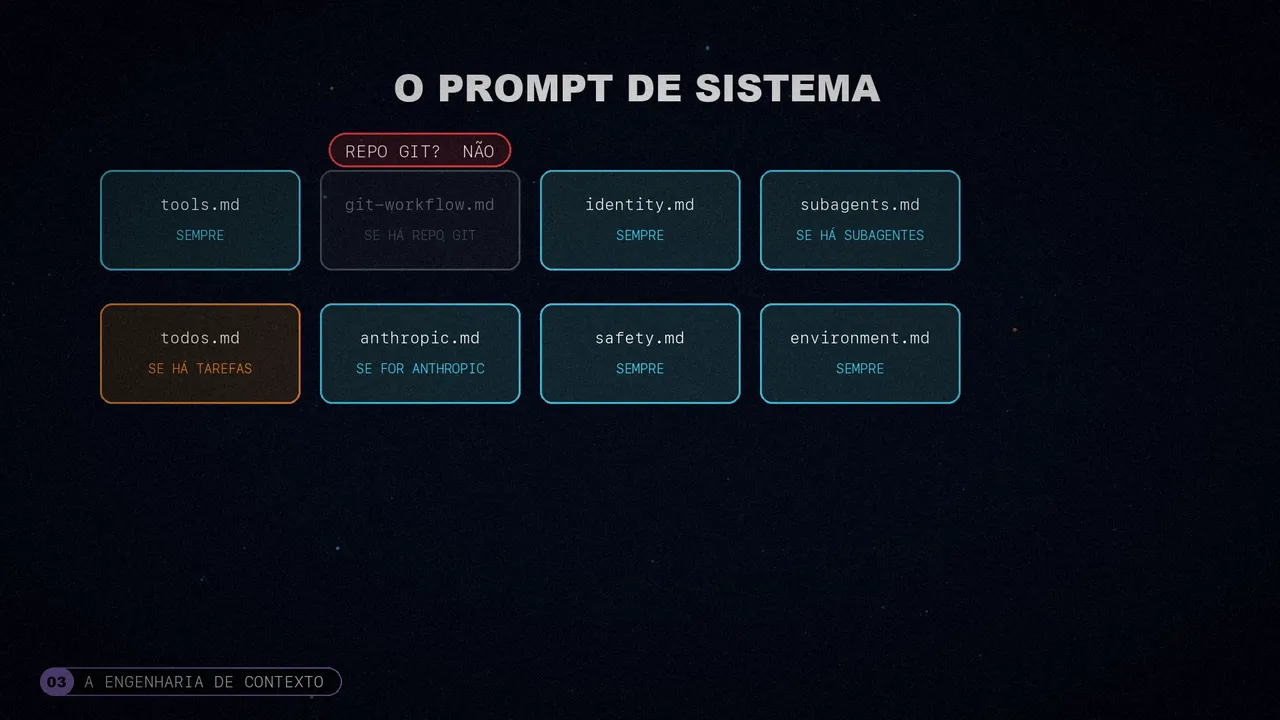
Além disso, o prompt é dividido em dois: uma parte estável, de 80 a 90% do total, e outra que muda conforme a sessão. A estável vai para o cache do provedor, e como o prompt viaja com cada chamada, o custo dessa parte cai em torno de 88%.
Resultados resumidos e saídas para um arquivo
O que mais ocupa espaço são os resultados das ferramentas: ler um arquivo pode custar três mil tokens. Então cada resultado é resumido de acordo com seu tipo: uma leitura vira “lido, 142 linhas”; uma busca, “23 ocorrências”. E se uma saída passa de oito mil caracteres, ela vai para um arquivo à parte e na conversa fica só uma prévia com o caminho. Antes, uma bateria de testes podia consumir trinta mil tokens; com essas duas mudanças, as sessões passaram de aguentar 15-20 turnos para 30-40 antes de encher o contexto.
Memória dupla para pensar
A fase de pensamento usa uma memória dupla, inspirada na ciência cognitiva. A episódica é um resumo de toda a conversa, com os objetivos e as decisões. A de trabalho são as seis últimas trocas, palavra por palavra. Juntas, elas dão o panorama e o detalhe, com um orçamento fixo de tokens.
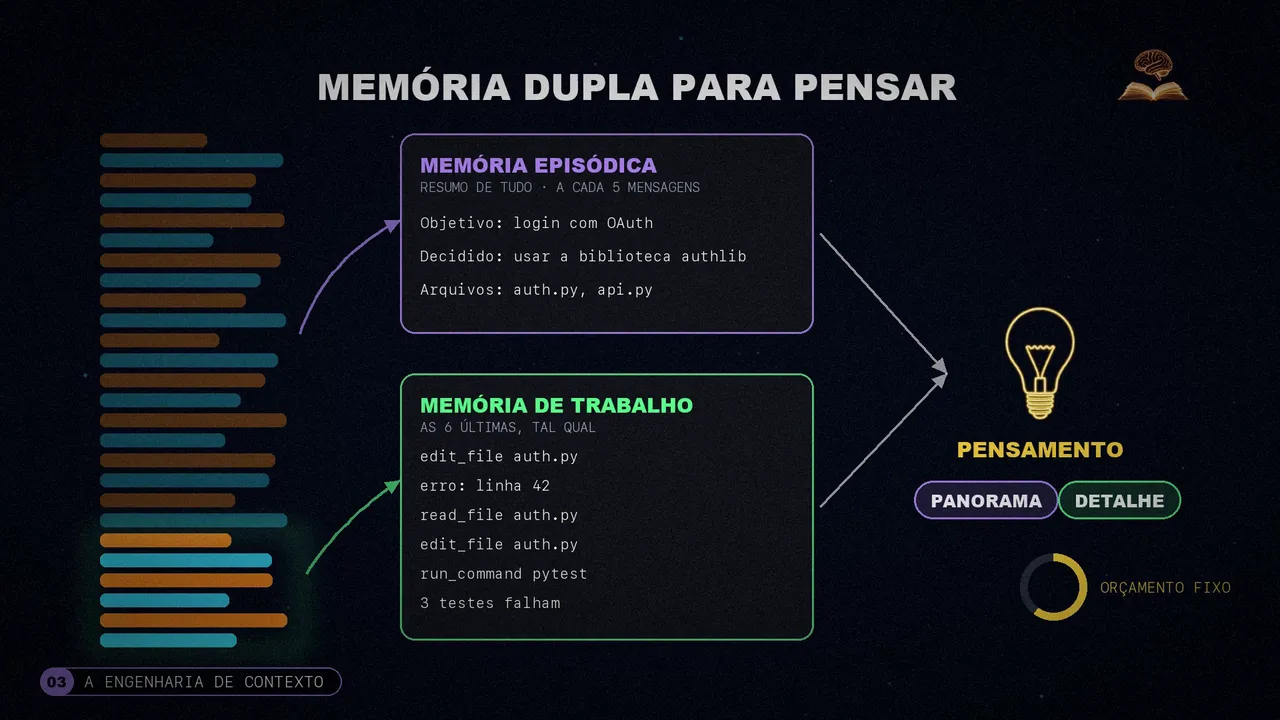
Eles testaram os dois extremos. Só com resumos, perdiam-se caminhos e nomes, e o agente citava arquivos que não existiam. Só com as mensagens recentes, ele esquecia o objetivo depois de dez turnos. E um detalhe fino: resumir um resumo acumula erros, então o resumo é refeito a cada cinco mensagens a partir da conversa completa.
Instruções que se esquecem
Este é o problema de que eu mais gostei no paper, porque qualquer pessoa que usa agentes vai reconhecê-lo. Você diz para ele rodar sempre os testes depois de editar. Nos primeiros turnos, ele faz isso. Mas depois de umas vinte chamadas de ferramentas, ele para. A instrução continua no prompt, mas fica tão longe que o modelo já não presta atenção nela. Eles viram isso de forma sistemática em sessões de mais de quinze chamadas.
A solução são os lembretes de sistema: mensagens curtas injetadas logo antes de o agente errar. Oito detectores vigiam a conversa: ferramentas que falham sem nova tentativa, leituras demais seguidas, tarefas por terminar, planos aprovados que não são executados… E cada lembrete tem um limite, para não virar ruído.
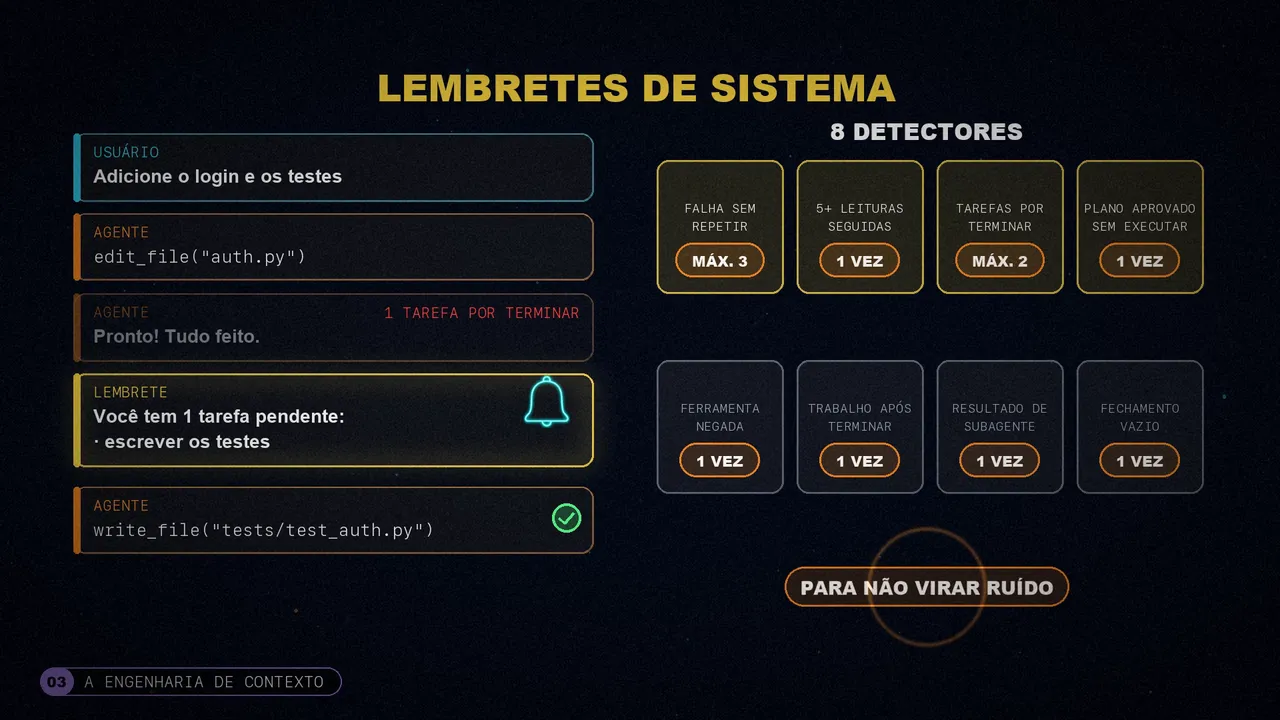
O detalhe curioso: os lembretes chegam como mensagens do usuário, não do sistema. Depois de quarenta turnos, mais uma instrução de sistema se perde no fundo; já o que o usuário diz é o mais recente, algo que acabou de acontecer e pede resposta. Nos testes deles, assim o modelo obedecia bem mais.
Com os erros acontece algo parecido: diante de uma falha, o agente costuma pedir desculpas em vez de corrigir. O OpenDev classifica cada erro em seis tipos (permissão negada, arquivo inexistente, edição que não encaixa, sintaxe, limite de uso e tempo esgotado) e lhe dá instruções concretas. “Leia o arquivo de novo” funciona muito melhor que “conserte isso”. E no máximo, ele tenta três vezes.
Compactar sem perder nada
As saídas das ferramentas acabam ocupando de 70 a 80% do contexto. O comum é esperar encher quase tudo e resumir de uma vez, perdendo muita coisa. O OpenDev comprime por etapas:
- 70%: só avisa.
- 80%: troca as saídas antigas por referências.
- 85%: poda as que ficaram muito para trás.
- 90%: mascara quase tudo, menos o mais recente.
- 99%: um modelo resume a conversa.
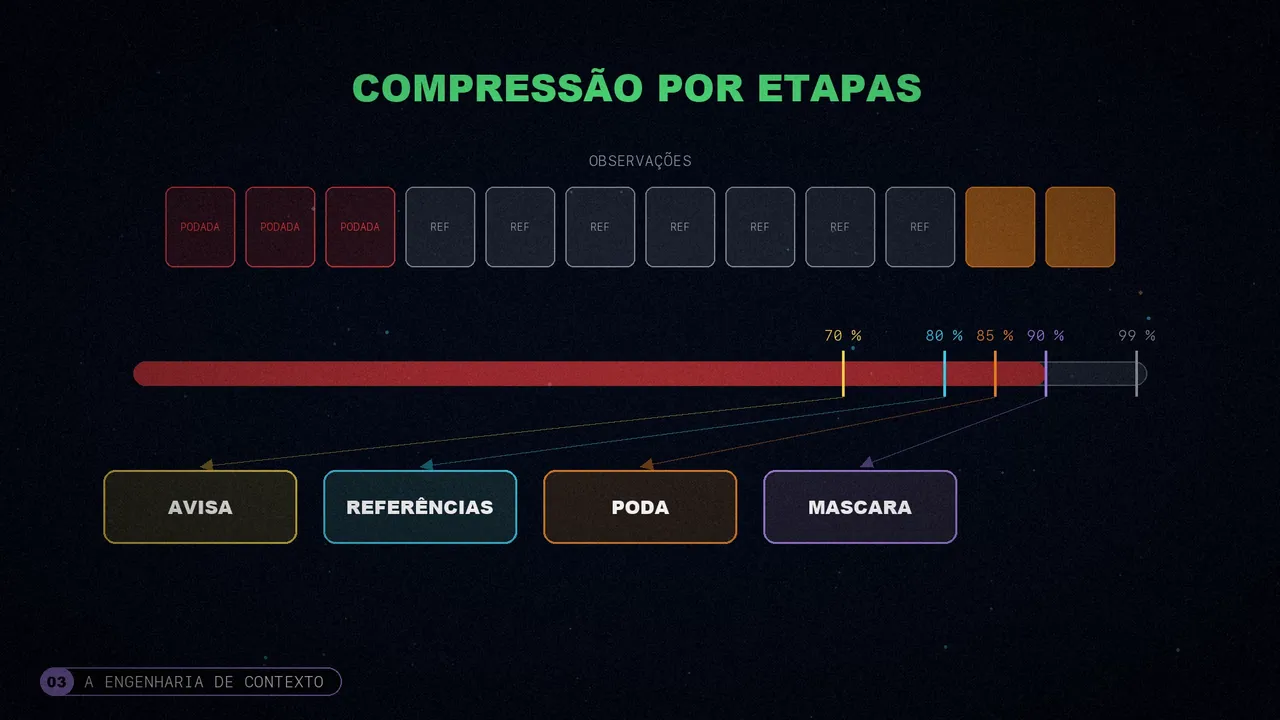
E nem assim se perde nada: a conversa inteira é salva num arquivo, e o resumo inclui o caminho dele e um índice de tudo o que o agente mexeu. Segundo o paper, com isso o pico de contexto ocupado pelas observações cai 54%, e em sessões típicas de trinta turnos muitas vezes o resumo de emergência nem é necessário.
O agente também aprende de uma sessão para outra com um caderno de estratégias (playbook): frases curtas marcadas como úteis, prejudiciais ou neutras. Antes de cada consulta, ele escolhe as melhores pela eficácia (0,5), pela recência (0,3) e pela semelhança com a pergunta (0,2). E, a cada cinco mensagens, um refletor analisa o que funcionou e um curador atualiza o caderno.
Encontrar o código certo
Encontrar o código certo é o mais decisivo para um agente de programação: todo o resto depende disso. Por padrão, os agentes procuram qualquer coisa com grep. O OpenDev começa pela âncora mais forte do pedido: um nome de função vai para o servidor de linguagem; uma mensagem de erro, para a busca de texto; e um padrão de código, para o buscador estrutural.
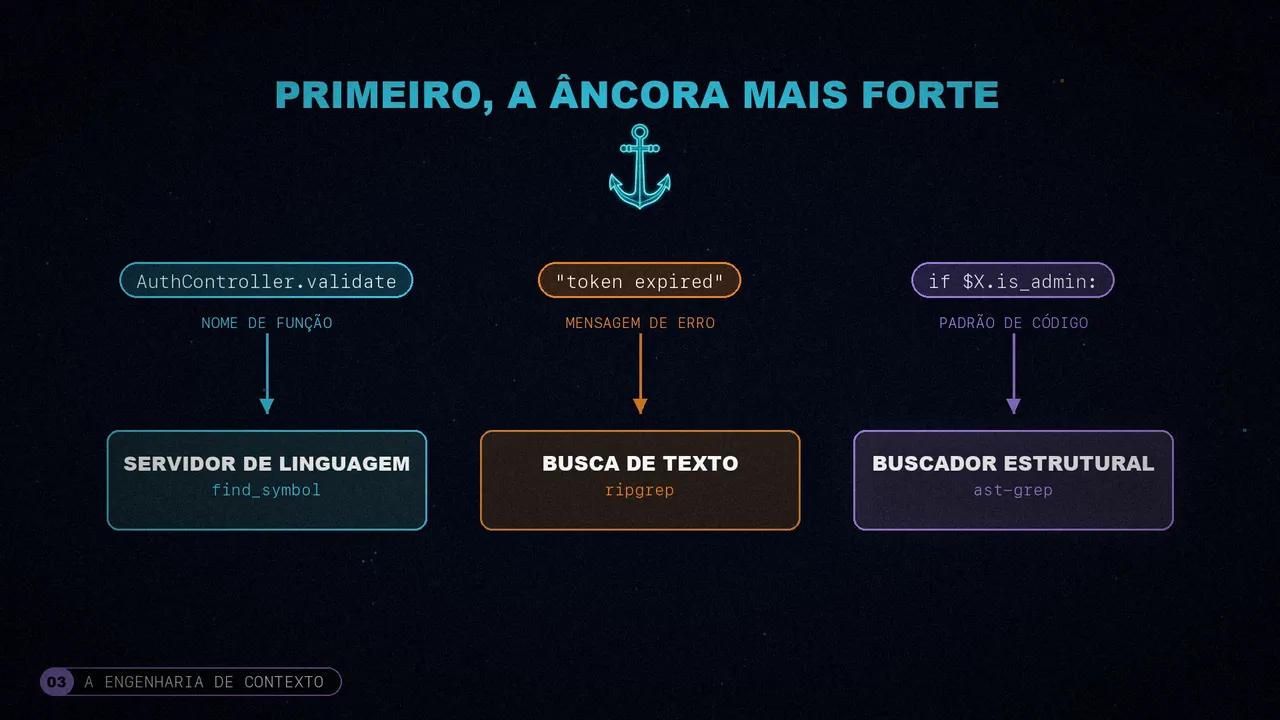
Se a tarefa exige explorar a fundo, ele delega ao subagente explorador, que encadeia buscas no seu próprio contexto: localiza uma classe, lê suas dependências e rastreia onde são usadas. Os milhares de linhas intermediárias ficam na janela dele, e ao agente principal só chega o resumo.
As ferramentas
O OpenDev traz 35 ferramentas próprias, organizadas num registro por categorias: arquivos, processos, web, símbolos, tarefas… Antes estavam todas num único espaço de nomes, com conflitos de nomes e uma segurança difícil de configurar; com categorias, as regras são aplicadas por grupo.
Antes de executar qualquer coisa, você decide quanta autonomia dá a ele: manual, com uma aprovação para cada passo; semiautomática, que só deixa passar as leituras; ou automática. Por cima, há regras por padrão de texto, por comando e por prefixo, e regras de perigo, como apagar o disco inteiro, que são sempre negadas. O que você aprova fica salvo entre sessões: se não, você acabaria aprovando tudo por cansaço.
Arquivos e edição flexível
A leitura numera as linhas e, se o arquivo for enorme, mostra o começo e o fim. Antes de editar, verifica se ninguém alterou o arquivo desde a última leitura, para não atropelar o seu trabalho. E a escrita só cria arquivos novos: para modificar um, é preciso editá-lo, não reescrevê-lo de memória.
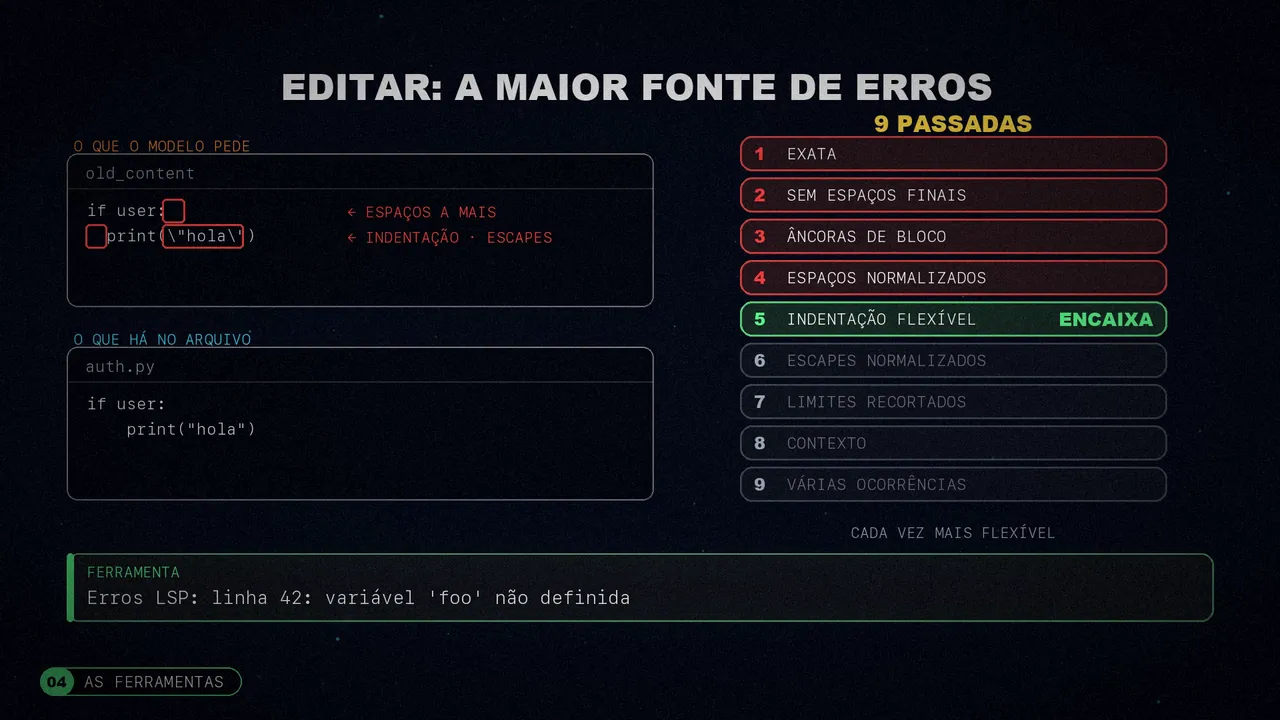
A edição era a maior fonte de erros. O modelo pede para substituir um texto que quase coincide com o do arquivo, com espaços a mais, outra indentação ou caracteres escapados. O OpenDev tenta com nove passadas, da correspondência exata a outras cada vez mais flexíveis, e fica com a primeira que encaixa. Depois, o servidor de linguagem o avisa das falhas que tenha introduzido.
Shell, web e servidores de linguagem
Cada comando de shell passa por seis etapas: filtros de segurança, preparação, detecção de servidores, execução, gestão da saída e limites de tempo. Se reconhece um servidor de desenvolvimento, ele o manda para segundo plano. Antes, com um tempo limite fixo, esses processos morriam sempre; agora depende da atividade: um minuto sem saída ou dez no total.
Para a web, ele usa um navegador de verdade, porque muita documentação precisa de JavaScript, e também faz buscas e tira capturas. Para entender o código, ele se conecta aos servidores de linguagem, os mesmos que os editores usam: encontra símbolos e referências, renomeia em todo o projeto e reescreve o corpo de uma função sem mexer na sua assinatura.
Para falar com você, ele faz perguntas com opções em vez de texto livre (e você sempre pode responder outra coisa), mantém uma lista de tarefas com só uma em andamento, apresenta o plano para você aprovar e tem uma ferramenta explícita para dizer que terminou.
MCP e skills, sob demanda
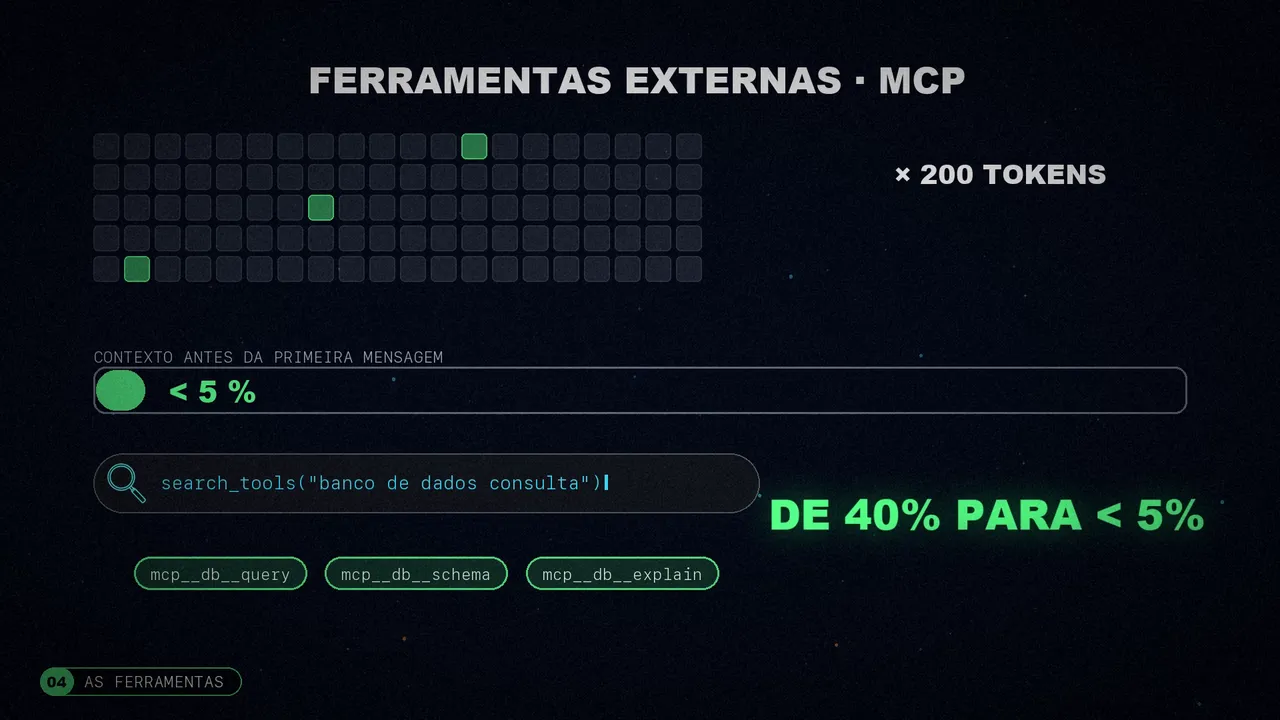
Cem ferramentas MCP de uns duzentos tokens cada uma somam vinte mil tokens só em definições. No começo, carregavam todas, e elas consumiam até 40% do contexto antes da primeira mensagem. Agora o agente as procura por palavras-chave quando precisa e só carrega essas: o custo inicial caiu para menos de 5%. Com as skills, a mesma coisa: ao iniciar, só se carregam o nome e a descrição.
A persistência
Tudo fica salvo em arquivos comuns, sem banco de dados. Cada sessão são dois arquivos, os metadados e a transcrição (uma mensagem por linha), escritos numa cópia temporária e depois renomeados, então nunca ficam pela metade. E se o índice de sessões se corromper, ele se reconstrói sozinho.
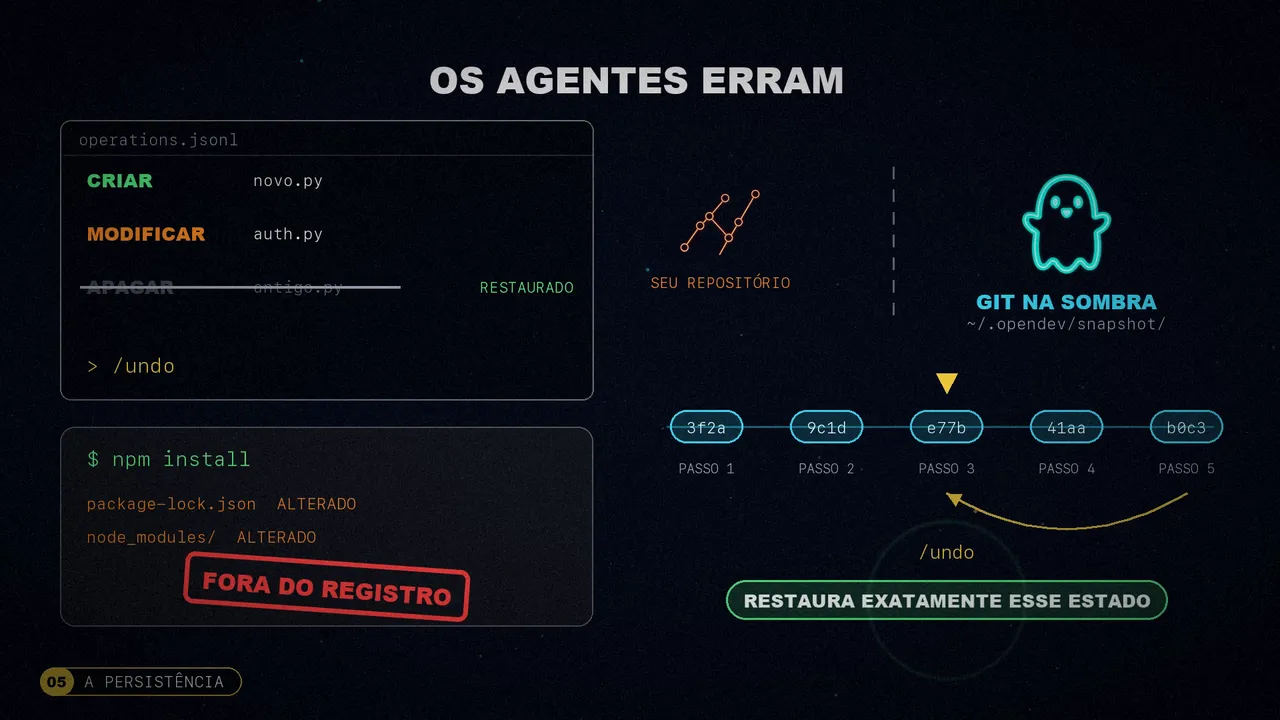
Os agentes erram, então cada operação com arquivos fica registrada e pode ser desfeita com um único comando. Mas um comando de shell também altera arquivos, por exemplo ao instalar dependências. Para isso existe um repositório git na sombra, separado do seu, que guarda um instantâneo a cada passo; desfazer restaura exatamente esse estado.
A configuração funciona em níveis (padrão, ambiente, usuário e projeto, que manda sobre todos), as chaves da API só são lidas do ambiente e os dados dos modelos ficam em cache, então o agente inicia mesmo sem conexão.
As cinco lições
- O contexto é a restrição central. Ele é consumido pelo próprio sistema e pelas ações do agente, e as saídas das ferramentas levam de 70 a 80%. Um resultado mais completo melhora cada turno, mas encurta a vida útil da sessão.
- Guiar o agente é um problema de sinal e ruído. A influência do prompt se desvanece à medida que a conversa cresce. Para que ele não procure tudo com grep, deram a ele uma árvore de decisão com critérios concretos: “se você busca uma função ou uma classe, use a busca de símbolos”. Nada de “use a ferramenta mais adequada”.
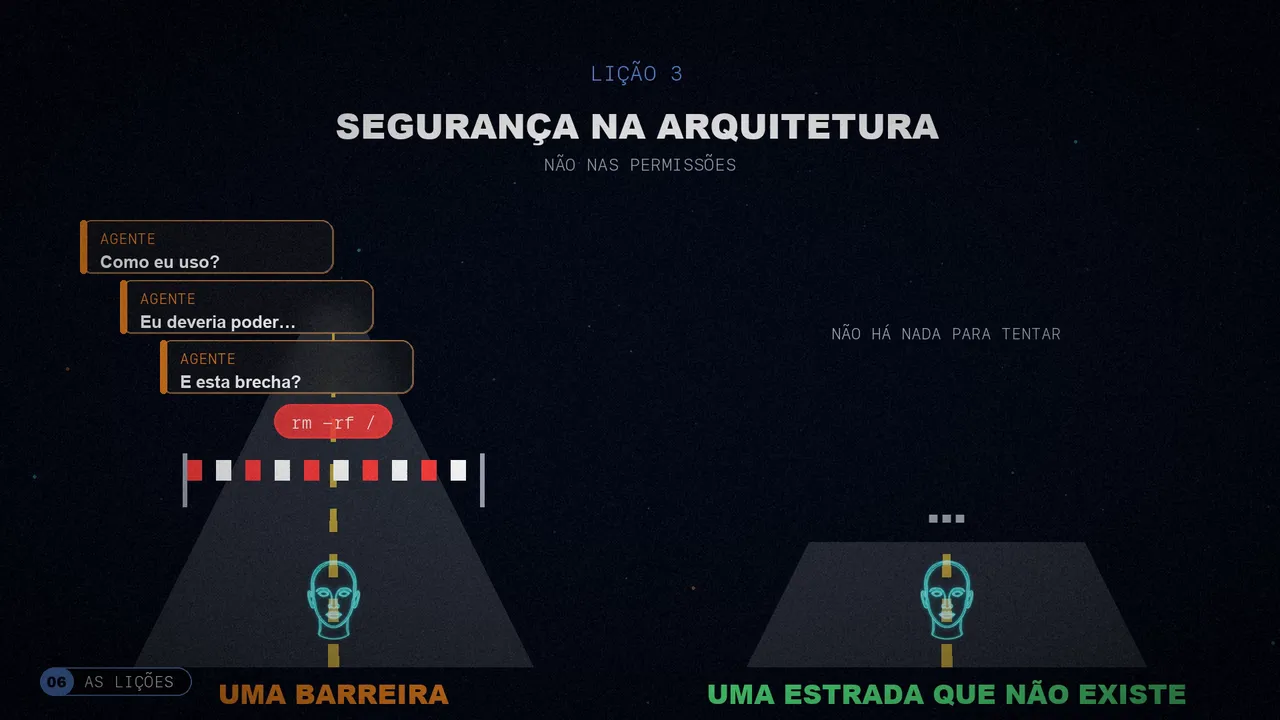
- A segurança fica na arquitetura, não nas permissões. Um modelo que vê uma ferramenta perigosa pode raciocinar sobre como usá-la, argumentar por que deveria poder e procurar brechas nas regras. Se a ferramenta não está no seu esquema, ele nem tenta. É a diferença entre uma barreira e uma estrada que não existe.
- Os modelos quase acertam. Um sistema que exige exatidão passa a vida se recuperando de erros; é melhor ter ferramentas que absorvam a imprecisão: a edição flexível, mandar para segundo plano o que parece um servidor ou instalar uma dependência que falta.
- Carregar tudo no início não escala. Melhor um índice leve ao iniciar e o conteúdo completo quando for preciso. O que puder ser reconstruído, que se regenere sozinho. E o que for determinístico, fora do ciclo do agente.
O que falta
O próprio autor reconhece: o paper documenta decisões, mas não traz uma avaliação quantitativa sistemática. Os números vêm da experiência com o OpenDev, sem compará-lo com outros agentes em benchmarks como o Terminal-Bench ou o LongCLI-Bench. Medi-lo assim é o primeiro passo pendente.
E ele propõe por onde seguir: limiares que se adaptem a cada tarefa (uma falha simples não precisa da fase de pensamento), uma memória que passe de um projeto para outro e entenda o código como um grafo, subagentes que conversem entre si, lembretes que se aprendam sozinhos em vez de serem desenhados à mão e o mesmo agente também dentro do editor.
Um bom agente de terminal não depende só do modelo: é contexto bem administrado, segurança em camadas, ferramentas que perdoam erros e uma memória que aprende.
Que ideia do OpenDev você colocaria no seu agente?
Fontes
- “Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned”, de Nghi D. Q. Bui (OpenDev), arXiv 2603.05344, março de 2026.
- O código do agente: opendev-to/opendev.
- O vídeo, nos meus três canais: espanhol, inglês e português.