El problema: suena bien, pero no deja rastro
Una revisión sistemática no es un resumen de lo que se ha publicado sobre un tema. Es un método: se define una pregunta, se busca de forma documentada, se decide con criterios escritos qué estudios entran y cuáles no, y se deja constancia de todo. PRISMA 2020 es la guía que dice cómo informar de ese proceso (cómo se identifican, seleccionan e incluyen los estudios), y PRISMA-S la extiende a la parte de búsqueda.
El primer problema que el autor quería atacar es la fragilidad de las revisiones hechas con un solo modelo, sea de quien sea. Un modelo resume, compara y propone líneas argumentales muy bien, pero eso no equivale a una revisión seria. Si el proceso no deja rastro de la búsqueda, de los criterios de inclusión, de los motivos de exclusión, de que alguien leyó el texto completo y de un cierre verificable, el resultado puede sonar bien y ser metodológicamente débil.
El segundo problema es operativo. Una revisión no se resuelve con una llamada al modelo. Pide protocolo, adquisición bibliográfica, auditoría de DOI, cribado, recuperación de los PDF, lectura del texto completo, extracción, figuras, escritura del manuscrito, revisión cruzada, empaquetado y sincronización. Si todo eso vive solo en la memoria de una conversación, el sistema es frágil por definición.
Por eso su sistema separa estado, proceso y artefactos persistentes. La frase que lo resume: lo importante no es que el agente «recuerde», sino que vuelva a leer lo que dejó escrito.
Antes de entrar en materia, el autor hace su «pliego de descargo»: no quiere entrar en el debate universitario de si estos sistemas deben usarse; solo enseña cómo está hecho el suyo por dentro para que otros puedan replicarlo o mejorarlo. Y avisa de que todavía no entrega el agente empaquetado: eso, dice, vendrá en otro artículo.
Las seis reglas
El sistema no se construye alrededor de la pregunta «¿qué puede hacer un agente en esta investigación?», sino de otra: «¿qué condiciones mínimas debe cumplir una revisión para que yo me fíe de ella?». La respuesta son seis reglas:
- PRISMA 2020 como marco para elaborar el informe.
- PRISMA-S como marco de transparencia de la búsqueda.
- DOI-first: siempre que exista, el DOI (el identificador único de cada publicación) es la clave de cada estudio.
- Texto completo obligatorio para el corpus final.
- Los recuentos se recalculan a partir de los archivos reales; nadie los escribe a mano.
- Cierre editorial solo con el control final en PASS, no con la impresión subjetiva de que «ya está bastante bien».
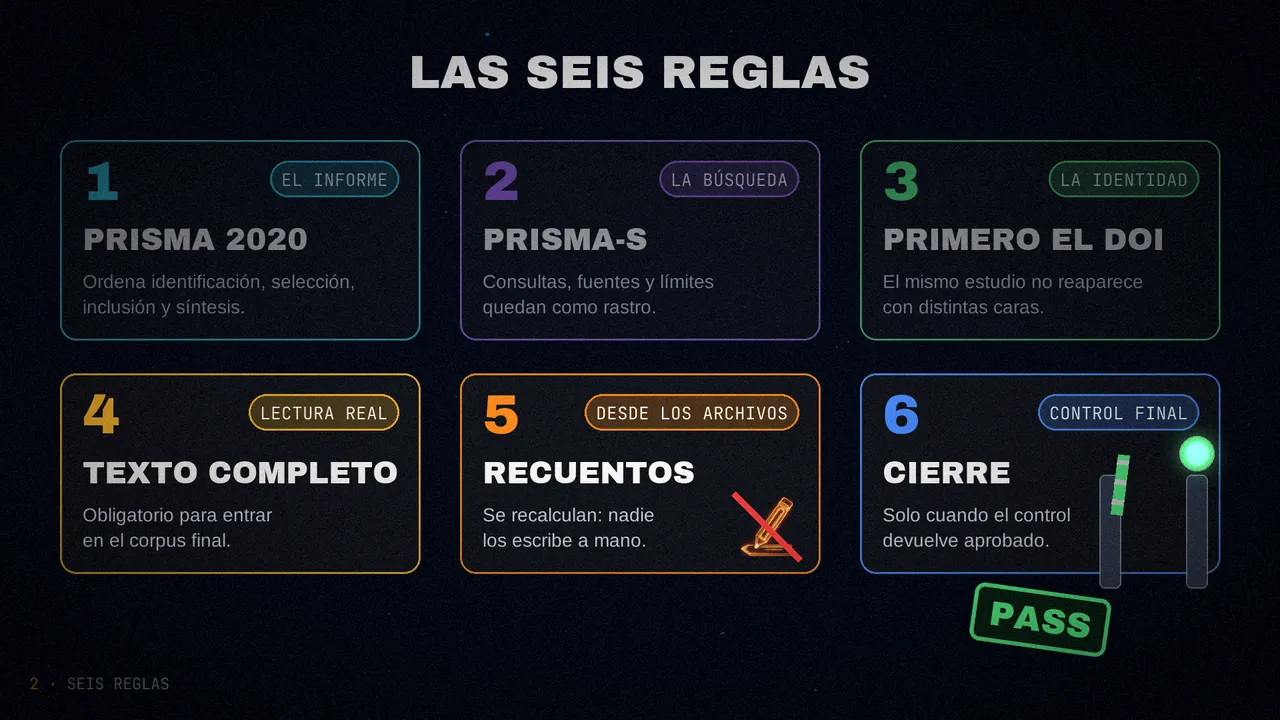
Estas reglas viven en un archivo, la skill base prisma-systematic-review/SKILL.md, que funciona como contrato operativo y metodológico. El autor insiste en este punto: en muchos sistemas de agentes, la parte interesante está en prompts invisibles. Aquí la metodología es una pieza que se puede versionar y auditar.
La regla que más tokens cuesta es la cuarta. Exige texto completo legible para la inclusión final, y un modelo capaz de leer bien ese tipo de documentos. Un resumen ayuda a descartar rápido, pero no basta para declarar que un estudio forma parte del corpus. En palabras del autor, es una frontera metodológica, no una preferencia de estilo.
La arquitectura: cuatro capas
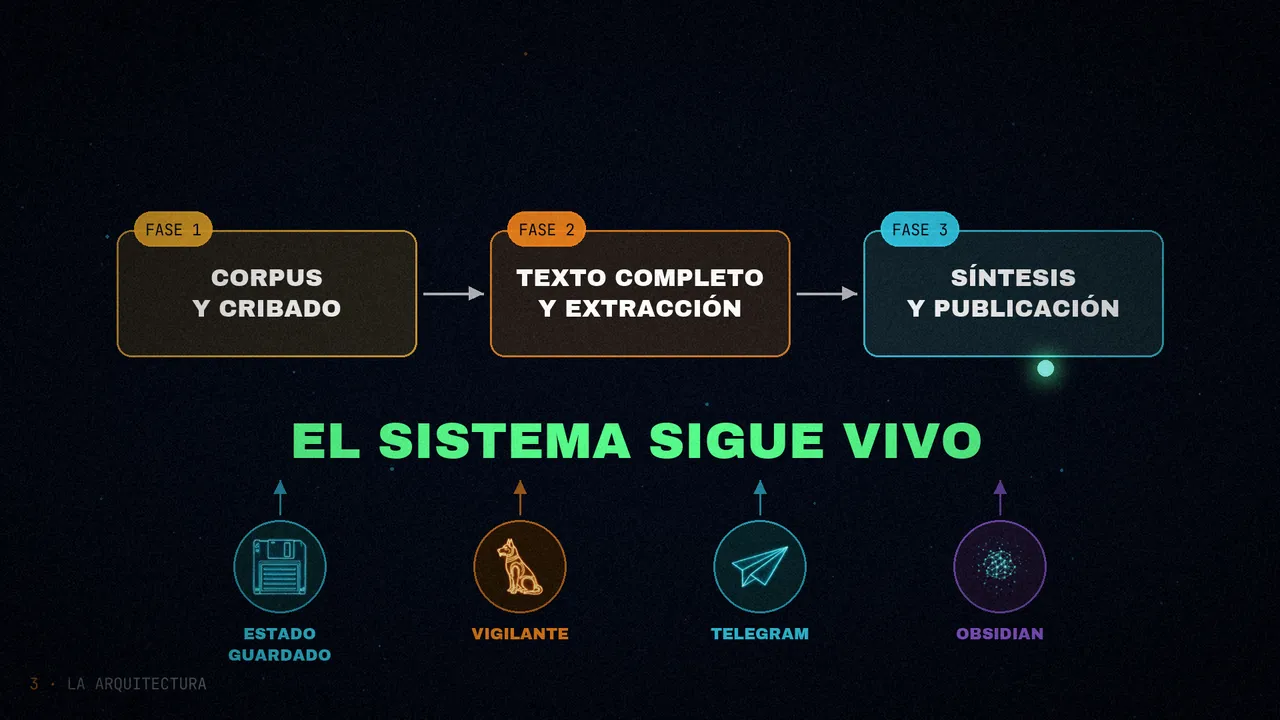
El sistema está construido con Hermes (Hermes Agent, según la figura de arquitectura del artículo) y se apoya en cuatro capas:
- Una superficie mínima por Telegram. El autor no quiere que la operativa dependa de una interfaz propia. Las revisiones se lanzan y se consultan con comandos como
/prisma_systematic_reviewy/prisma_status. - El runtime en Docker, con dos servicios:
hermes-agentejecuta la pasarela y el trabajo principal, yhermes-prisma-watchdogvigila las revisiones vivas y reanuda las fases cuando detecta que se han estancado. - La política de modelos. El modelo primario es Qwen 3.6, servido por NaN Builders. Si falla, hay una cadena de relevo en Ollama Cloud: DeepSeek v4-pro, Kimi K2.6, Qwen3-coder y Gemma4. Todo está en un
config.yamlcon sus parámetros. - La orquestación, con tres scripts:
complete_review.py,publication_autopilot.pyypublication_gate.py.
Hay otra capa que suele quedar escondida: las skills. En su instalación hay diez skills locales de investigación, y en el camino hacia una revisión publicable usa sobre todo cinco: revisión sistemática, estado, revisión académica, integridad y mapa de cambios. La idea de fondo es que la arquitectura no es un superagente que lo hace todo, sino capas especializadas con contratos pequeños. Eso, dice, la hace mantenible para su caso de uso.
Según las figuras del artículo, el trabajo se organiza en tres fases: corpus y cribado; texto completo y extracción; síntesis y cierre.
Cómo empieza una revisión
Una de las ideas más útiles del artículo: una revisión se sesga antes en la entrada que al final, en la discusión. Por eso el sistema obliga a congelar cuanto antes la pregunta, la ventana temporal, el tipo de estudio admisible, el número final de estudios deseado, los criterios de inclusión y exclusión y el marco editorial. Si el tema nace como «vamos a ver qué sale», el resto del sistema solo automatiza ambigüedad.
Esa fase deja rastro desde el primer minuto, en tres archivos:
protocol/intake.md: la pregunta y el alcance.protocol/eligibility-criteria.md: los criterios de inclusión y exclusión.protocol/search-strategy.md: la estrategia de búsqueda.
Lo importante no es solo que existan, sino que otra persona pueda abrirlos y revisar si el sesgo nace en la pregunta, en la búsqueda o en la interpretación.
Hay un detalle que al autor le gusta mencionar. Si no hay una revista concreta a la que enviar el trabajo, el sistema cae en un modo genérico (generic-common-core), una plantilla que pasaría un primer filtro. Esa decisión afecta a la plantilla de LaTeX, al paquete editable y al tono del cierre. Es una forma de no fingir que el trabajo está alineado con una revista que aún no se ha elegido.
Cuatro comandos, cuatro incertidumbres
Aquí la revisión deja de ser una intención. La pregunta, la unidad de análisis, la ventana temporal, los criterios y el límite de calidad quedan fijados en archivos que condicionan todo lo que viene después. Cuatro piezas lo hacen, y cada una cierra una incertidumbre distinta:
| Pieza | Qué fija | Qué hace |
|---|---|---|
bootstrap_topic_review.py | El alcance | No se limita a crear carpetas: materializa el punto de partida (el intake.md, la estrategia de búsqueda y la estructura del proyecto). Si después el corpus queda sesgado, se puede volver a ese origen y ver dónde nació el problema. |
doi_audit.py | La identidad del corpus | Separa los registros con DOI identificable, los duplicados y los ambiguos. Evita uno de los errores más frecuentes: creer que hay más estudios de los que realmente existen, o no saber por qué un artículo se fusionó o se descartó. |
complete_review.py | El orden del proceso | Dirige la secuencia completa: adquisición, cribado, recuperación de textos, extracción y paso a la capa editorial. No se extrae si el corpus no está fijado, no se da por bueno un estudio sin texto completo y no se publica si faltan artefactos intermedios. |
review_runtime_state.py | La memoria operativa | Guarda el estado fuera de la conversación: qué está hecho, qué falta, qué bloqueos hay y qué archivos sostienen cada paso. Si la revisión se interrumpe, el sistema lo relee y sigue. |
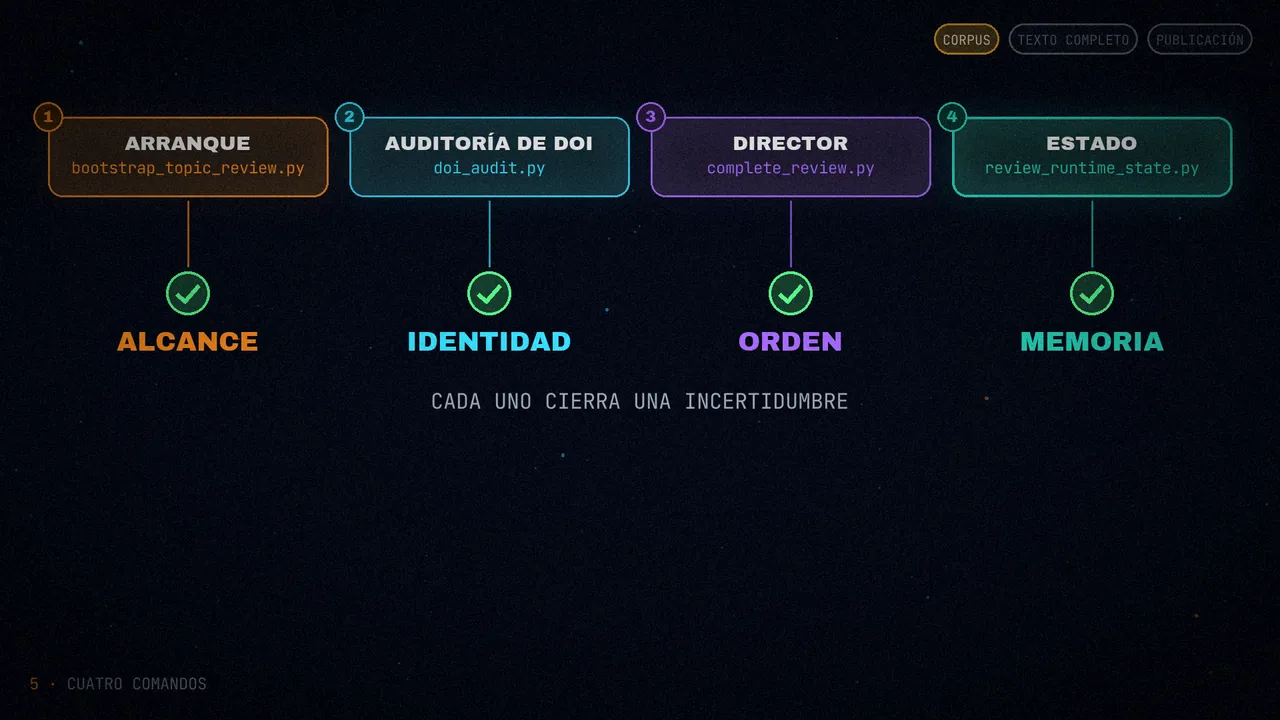
La frontera metodológica queda escrita antes de importar el primer registro. A partir de ahí, el sistema ya no intenta adivinar qué revisión quiere el autor: ejecuta la que dejó especificada.
De cuatro fuentes a un universo «DOI-first»
El sistema consulta varias fuentes porque ninguna basta por sí sola: OpenAlex, Crossref, Semantic Scholar y arXiv, con llamadas HTTP directas. El resultado no es «una búsqueda en abstracto», sino un conjunto con rastro técnico, repartido en cinco archivos:
searches/search-log.csv: la consulta, la fuente, la fecha y cuántos registros devolvió.records/master-records.csv: el universo bruto, normalizado.records/doi-index.csv: la clave canónica de cada estudio, por DOI.records/duplicates.csv: las colisiones detectadas.records/missing-doi.csv: lo que no se puede resolver por DOI.
Cuando un registro no tiene DOI, el sistema le genera un identificador estable a partir de un hash (un RID). Así el mismo artículo, llegado por dos fuentes con el título escrito de dos maneras, cuenta una sola vez. Según una figura del artículo, este enfoque «reduce ruido, baja coste y mejora la fiabilidad»; es una afirmación del autor, no una medida.
En este punto, dice, la revisión deja de ser una colección de búsquedas y empieza a parecerse a una base documental.
Cómo decide: OK, KO o hace falta más
La lógica de inclusión y exclusión no es un algoritmo mágico ni una pregunta al modelo del tipo «¿esto parece relevante?». Es una secuencia de cuatro capas:
- Reglas mínimas. La más visible es un umbral mínimo de texto útil: si el texto completo no llega, no hay base para la inclusión final. El texto del artículo no da la cifra; una de sus figuras la pone en 4.000 caracteres útiles.
- Decisión asistida por modelo. El modelo clasifica y justifica.
- Canonización. Una función normaliza las variantes (
include,include_ft,exclude, «excluido», «excluir»,maybe) a un conjunto consistente de decisiones. - Auditoría con recomputación. Los recuentos del diagrama PRISMA no se escriben a mano: se recalculan a partir de esas decisiones ya normalizadas.
Con eso, cada estudio acaba en una de tres salidas:
Supera las reglas mínimas, confirma el foco en el texto completo y deja una justificación trazable en un CSV.
Falla esos criterios o tiene un motivo de exclusión claro.
El cribado rápido no basta para decidir.
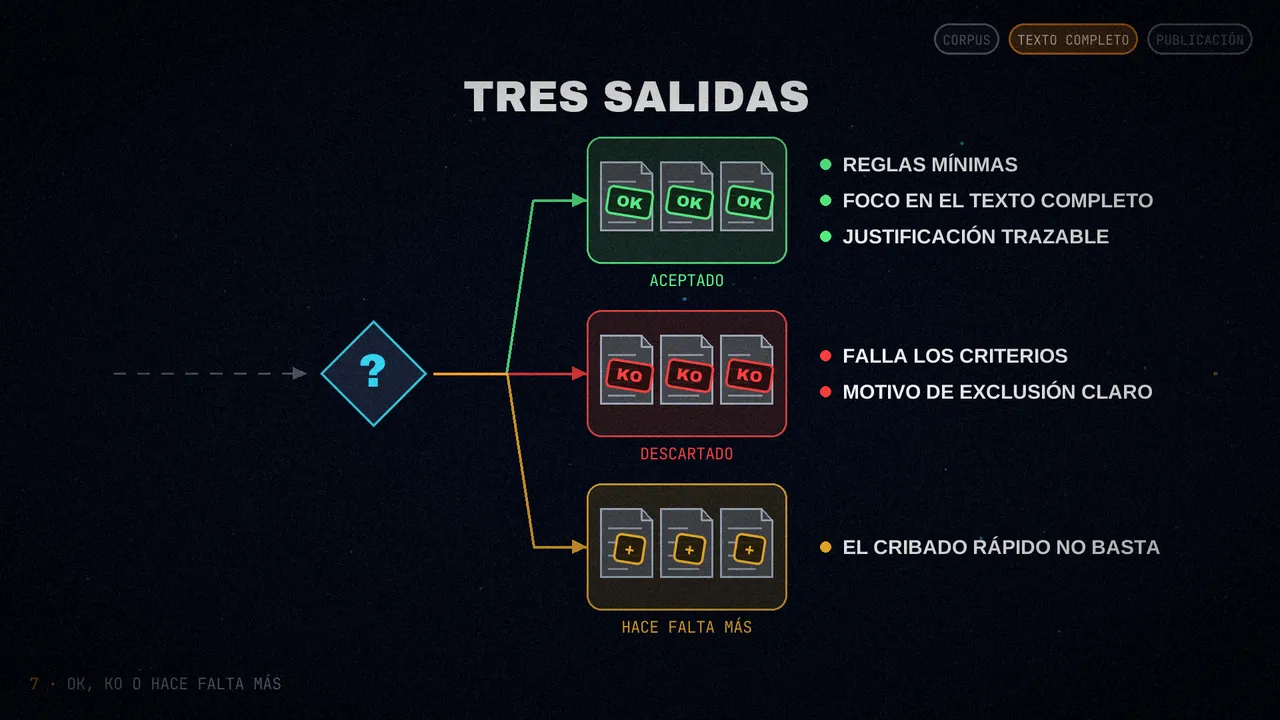
Para el autor, esta lógica se acerca más a herramientas de evaluación estructurada como ROBIS o AMSTAR 2 que a una simple ordenación por relevancia. Es su opinión sobre el diseño, no una equivalencia formal.
Extracción profunda
Saber que un artículo es «experimental» no basta. El autor quiere saber qué sistemas nombra, qué benchmark usa, qué muestra describe, qué variables emplea, qué método reporta y en qué teoría se apoya. Todo eso va a extraction/extraction-table.csv, con campos como work_type, empirical_type, models_or_systems_studied, benchmark_dataset_or_corpus, dependent_variables o theoretical_framework.
Cuando la primera extracción se queda corta, entra refresh_extraction_depth.py, que relee el texto extraído del PDF y fuerza una capa más profunda. Resuelve un problema que el autor dice haber vivido varias veces: artículos que en la primera pasada quedaban etiquetados solo como «estudio experimental», cuando el documento completo sí daba nombres, escalas y métricas. Lo marca como muy importante para quien quiera construirse su propio sistema.
Cada estudio se organiza en cuatro bloques:
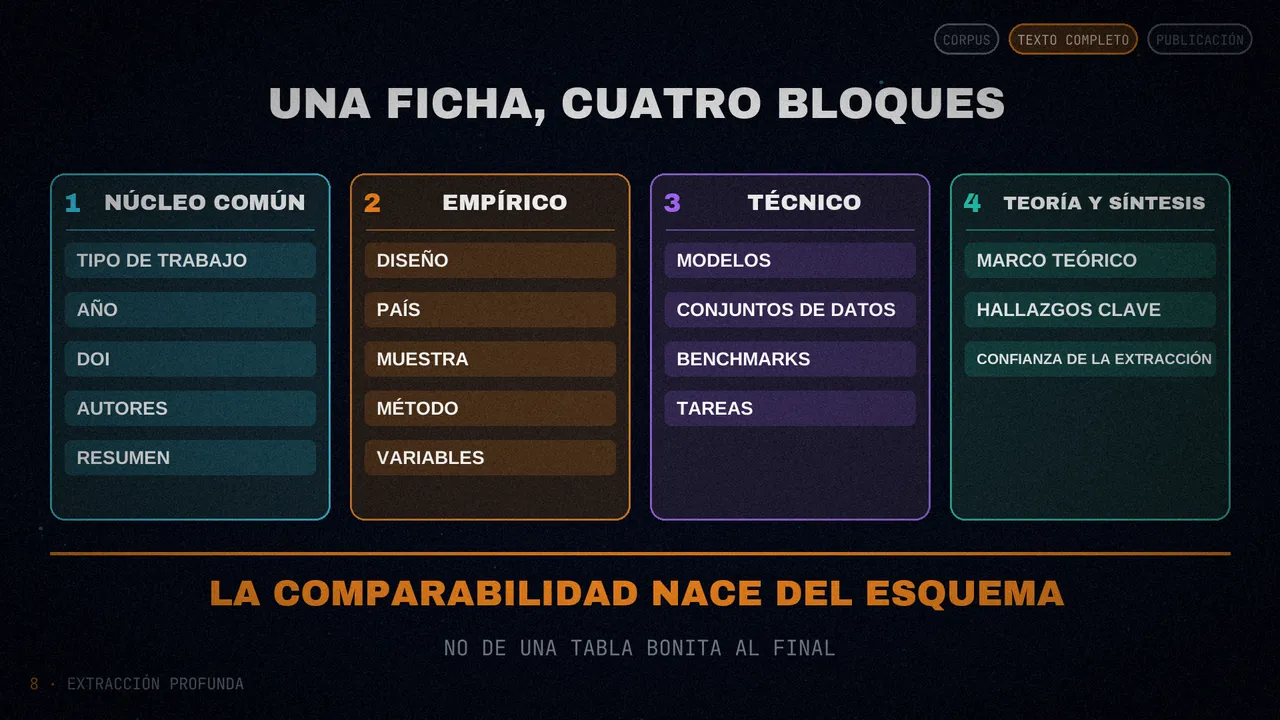
La conclusión de esta parte: la comparabilidad entre estudios nace del esquema de extracción, no de una tabla bonita al final.
Figuras y evidencia visual
En muchos temas, una figura concentra la arquitectura, el diseño experimental o las relaciones entre conceptos que el resumen no recoge. Por eso el sistema tiene una capa explícita de evidencia visual, con modelos capaces de ver y procesar imágenes.
El script clave, prepare_paper_figures.py, separa tres cosas que es fácil mezclar:
- Figuras científicas extraídas de los PDF (
figures/extracted/). - Renderizados de página de apoyo, para diagnóstico (
figures/page-renders/). - Figuras propias, generadas para el manuscrito.
Sin esa separación, una página renderizada entera puede confundirse con una figura reutilizable. La trazabilidad queda en un manifiesto, un catálogo y un ranking (figures/manifest.csv, figure-catalog.md y figure-ranking.csv). Las figuras propias llevan una firma (en su caso, 686f6c61) para distinguirlas de las del corpus: mezclar evidencia ajena con síntesis visual propia es, dice, mala práctica metodológica y mala práctica editorial.
Del corpus al manuscrito
Con el corpus consolidado, el reto pasa de documental a editorial. La pieza central es publication_audit.py: recompone secciones, limpia incoherencias, normaliza citas y referencias, integra tablas y figuras, detecta huecos obvios y genera el manuscrito. Deja tres versiones del mismo documento en paper/manuscript/:
publication-ready.md: la versión editable.publication-ready.tex: la salida en LaTeX, para seguir trabajando en un entorno académico.publication-ready.pdf: la versión compilada, lista para circular.
A eso se suma la bibliografía en BibTeX (references.generated.bib) y la plantilla genérica main-common-core.tex cuando no hay revista objetivo.
Aquí el autor impone lo que llama sus manías: cada estudio relevante debe tener algo más que una fila de tabla. El manuscrito incluye fichas por estudio, con uno o dos párrafos antes de la tabla compacta, y bloques ampliados de discusión, implicaciones teóricas, aportación original, conclusiones y líneas futuras. «Publication-ready» es el nombre de los archivos y el objetivo del autor; el artículo no cuenta que ninguna de estas revisiones se haya publicado.
Revisión cruzada y control final
Esta es, para el autor, la capa que más diferencia su sistema de un flujo convencional con varios modelos. No da por bueno un manuscrito porque un modelo haya escrito un texto sólido. Lo da por bueno cuando supera un circuito acumulativo:
- Revisión cruzada (
publication_peer_review.py). El revisor A trabaja con Qwen 3.6 y el revisor B con DeepSeek v4-pro; Kimi K2.6 queda como primer relevo editorial. La asignación está en un archivo,reviewer-models.csv. - Integridad (
check_manuscript_integrity.py): busca afirmaciones flojas, inconsistencias y huecos de soporte. - Mapa de cambios (
build_revision_roadmap.py): convierte la revisión en una matriz de cambios accionables. - Control final (
publication_gate.py): comprueba que los artefactos requeridos existen y que el cierre es legítimo. - Piloto automático (
publication_autopilot.py): repite el circuito hasta cerrar o hasta documentar un bloqueo real.
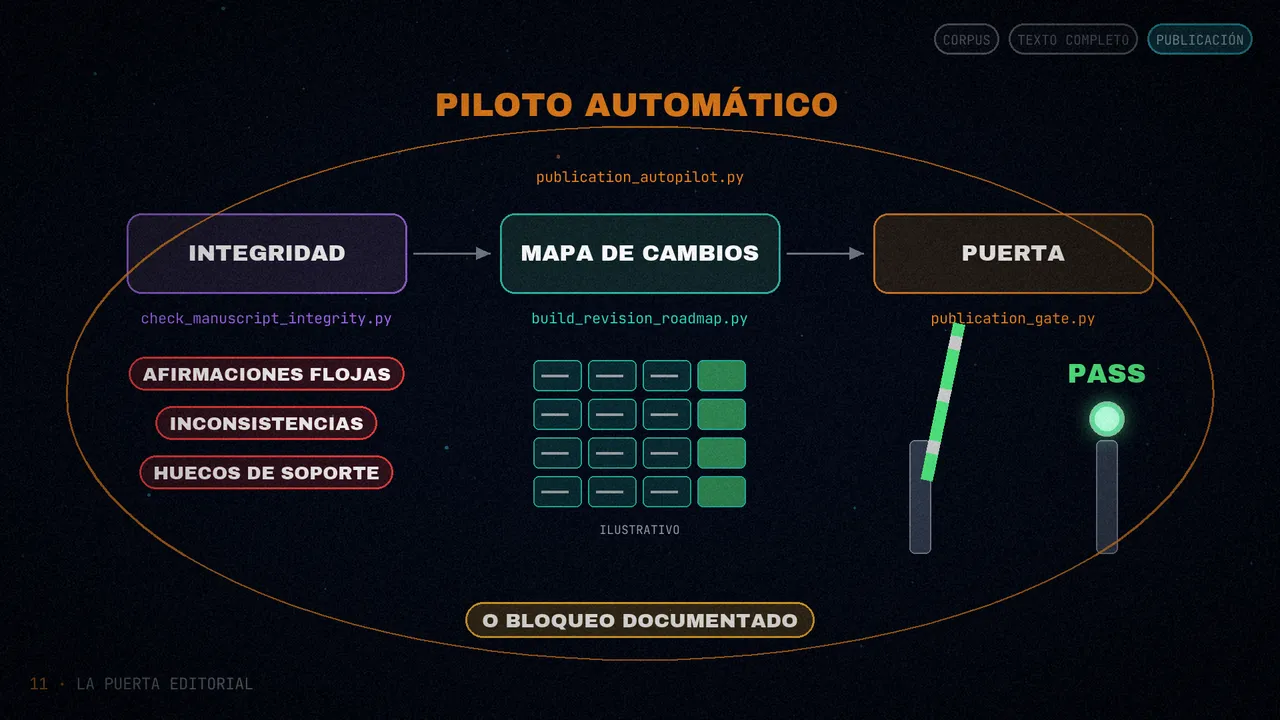
Conviene leerlo con precisión: los dos «revisores» son modelos distintos que se revisan entre sí, no revisores humanos independientes ni una revisión por pares de una revista. Lo que evita, según el autor, es un error concreto: entregar algo que parece terminado cuando no ha pasado los controles que justifican llamarlo publicable.
Paquetes y memoria fuera del chat
Cuando el control devuelve PASS, el sistema no termina en una carpeta suelta. Genera dos paquetes, porque no todos los lectores necesitan lo mismo: publication-package.zip, el paquete editorial general, y publication-latex-editable.zip, para seguir editando en LaTeX.
A la vez, sync_review_to_obsidian.py sincroniza la revisión con una bóveda de Obsidian, donde queda una versión navegable: fichas, vista general, biblioteca visual, notas y el rastro de PRISMA.
La continuidad no depende de recordar una conversación. Depende de archivos de estado (notes/runtime-state.md y notes/runtime-state.json), de manifiestos, de los ZIP y de un vigilante que sabe releer y reanudar. La memoria real del sistema está fuera del chat. Según el autor, desde la lógica FAIR esto acerca la revisión a un activo localizable, accesible e interoperable; no dice que la cumpla.
Los límites que reconoce el autor
El artículo no cierra fingiendo que el sistema es perfecto. Sigue dependiendo de cuatro cosas: la calidad de las fuentes, que el texto completo se pueda recuperar, que los modelos en la nube estén disponibles y que se puedan extraer figuras o tablas complejas sin pérdida.
Y aun con el control endurecido, el autor ve cuatro zonas mejorables:
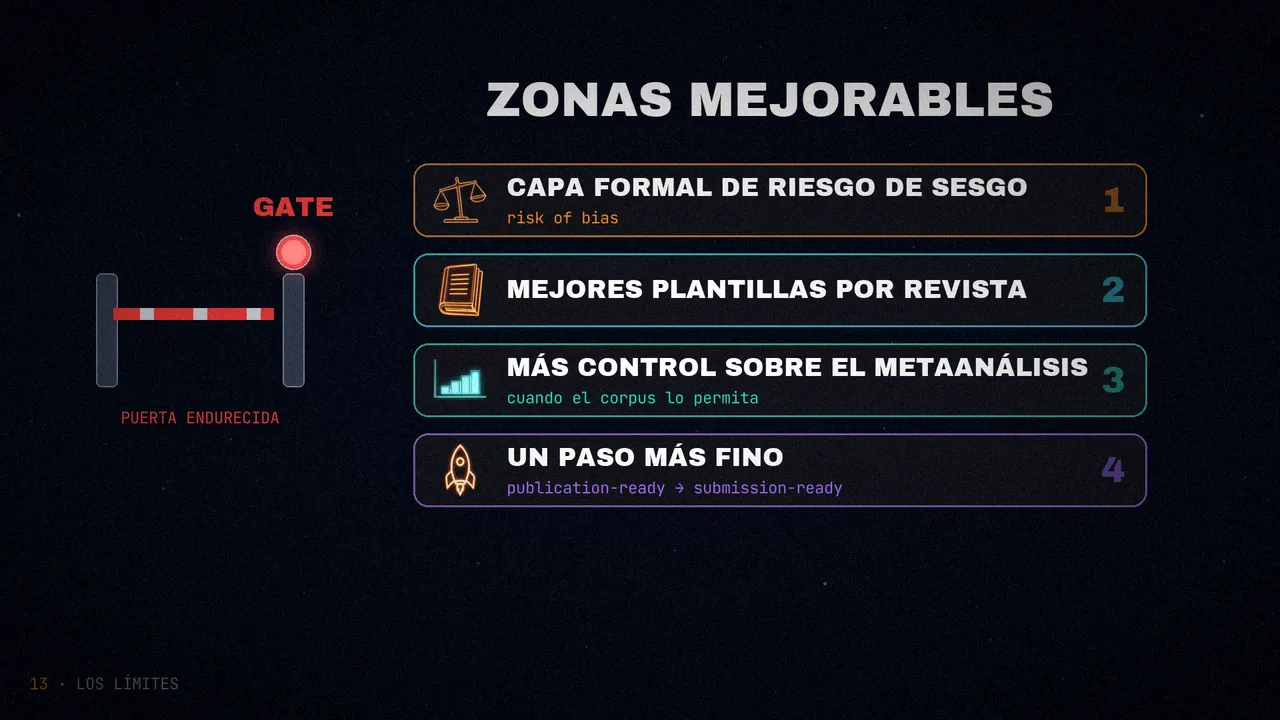
La primera es significativa: todavía falta una capa formal de riesgo de sesgo (risk of bias). Dice que sigue trabajando para publicar algo que se pueda instalar, usar y mejorar.
Cómo leer este artículo
- Describe un diseño, no resultados. No hay cifras de precisión, de tiempo ni de revisiones aceptadas. «Publicable» y «defendible» son el objetivo del autor, no algo que el artículo demuestre.
- Aún no se puede instalar. El paquete no está publicado; el autor lo anuncia para más adelante.
- No elimina el sesgo. Lo que hace es dejar rastro para que otra persona pueda auditar cada decisión.
- Los revisores son modelos. Es revisión cruzada entre modelos distintos, no revisión humana independiente.
- Los modelos y versiones (Qwen 3.6, DeepSeek v4-pro, Kimi K2.6…) son los de su instalación, tal como los nombra.
En resumen
Lo que me llevo del artículo vale para cualquier sistema de agentes, no solo para revisiones científicas: las reglas en un archivo y no en un prompt invisible, un archivo por cada paso, la memoria fuera de la conversación, los recuentos recalculados desde los datos y un control final que decide el cierre en lugar de la sensación de que «ya está».
Una revisión seria deja artefactos, no solo una conversación convincente; la calidad es una condición de salida, no una intención.
¿Te fiarías de una revisión hecha así si pudieras abrir cada archivo y seguir cada decisión?
Fuentes
- «Cómo monto un sistema de revisión PRISMA que se audita solo con HERMES», de Entre Kaczynski y Chinaski (@686f6c61), en X (10 de mayo de 2026).
- Guías que cita el artículo: PRISMA 2020 (Page et al., 2021), PRISMA-S (Rethlefsen et al., 2021), ROBIS (Whiting et al., 2016), AMSTAR 2 (Shea et al., 2017) y los principios FAIR (Wilkinson et al., 2016).
- El vídeo, en mis canales: español e inglés.