O problema: soa bem, mas não deixa rastro
Uma revisão sistemática não é um resumo do que foi publicado sobre um tema. É um método: define-se uma pergunta, busca-se de forma documentada, decide-se com critérios escritos quais estudos entram e quais não, e registra-se tudo. O PRISMA 2020 é a diretriz que diz como relatar esse processo (como os estudos são identificados, selecionados e incluídos), e o PRISMA-S a estende para a parte de busca.
O primeiro problema que o autor queria atacar é a fragilidade das revisões feitas com um único modelo, seja de quem for. Um modelo resume, compara e propõe linhas de argumentação muito bem, mas isso não equivale a uma revisão séria. Se o processo não deixa rastro da busca, dos critérios de inclusão, dos motivos de exclusão, de que alguém leu o texto completo e de um fechamento verificável, o resultado pode soar bem e ser metodologicamente fraco.
O segundo problema é operacional. Uma revisão não se resolve com uma chamada ao modelo. Ela pede protocolo, aquisição bibliográfica, auditoria de DOI, triagem, recuperação dos PDFs, leitura do texto completo, extração, figuras, escrita do manuscrito, revisão cruzada, empacotamento e sincronização. Se tudo isso vive só na memória de uma conversa, o sistema é frágil por definição.
Por isso o sistema separa estado, processo e artefatos persistentes. A frase que resume: o importante não é que o agente «lembre», e sim que volte a ler o que deixou escrito.
Antes de entrar no assunto, o autor faz uma ressalva: não quer entrar no debate universitário sobre se esses sistemas devem ser usados; só mostra como o seu é feito por dentro, para que outros possam replicá-lo ou melhorá-lo. E avisa que ainda não entrega o agente empacotado: isso, diz, virá em outro artigo.
As seis regras
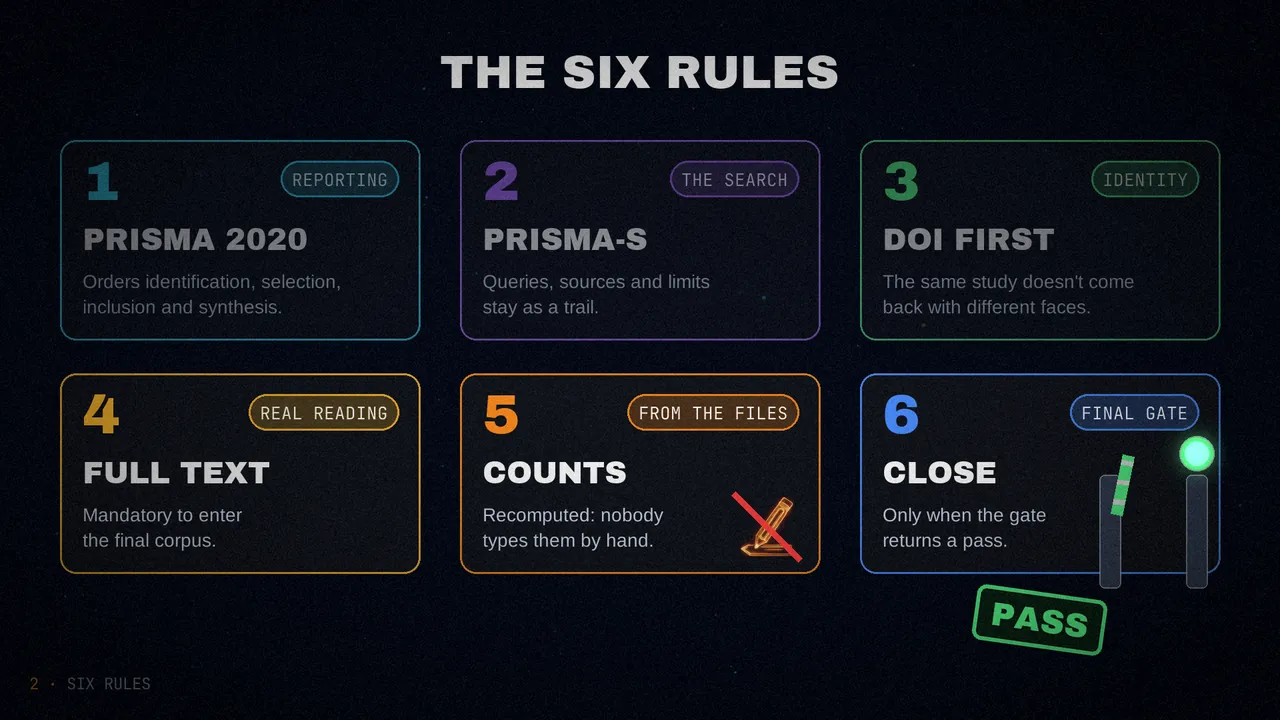
O sistema não é construído em torno da pergunta «o que um agente pode fazer nesta pesquisa?», e sim de outra: «que condições mínimas uma revisão deve cumprir para eu confiar nela?». A resposta são seis regras:
- PRISMA 2020 como estrutura para elaborar o relatório.
- PRISMA-S como estrutura de transparência da busca.
- DOI-first: sempre que existir, o DOI (o identificador único de cada publicação) é a chave de cada estudo.
- Texto completo obrigatório para o corpus final.
- As contagens são recalculadas a partir dos arquivos reais; ninguém as digita à mão.
- Fechamento editorial só com o controle final em PASS, não com a impressão subjetiva de que «já está bom o bastante».
Essas regras vivem em um arquivo, a skill base prisma-systematic-review/SKILL.md, que funciona como contrato operacional e metodológico. O autor insiste neste ponto: em muitos sistemas de agentes, a parte interessante fica em prompts invisíveis. Aqui a metodologia é uma peça que pode ser versionada e auditada.
A regra que mais custa tokens é a quarta. Ela exige texto completo legível para a inclusão final, e um modelo capaz de ler bem esse tipo de documento. Um resumo ajuda a descartar rápido, mas não basta para declarar que um estudo faz parte do corpus. Nas palavras do autor, é uma fronteira metodológica, não uma preferência de estilo.
A arquitetura: quatro camadas
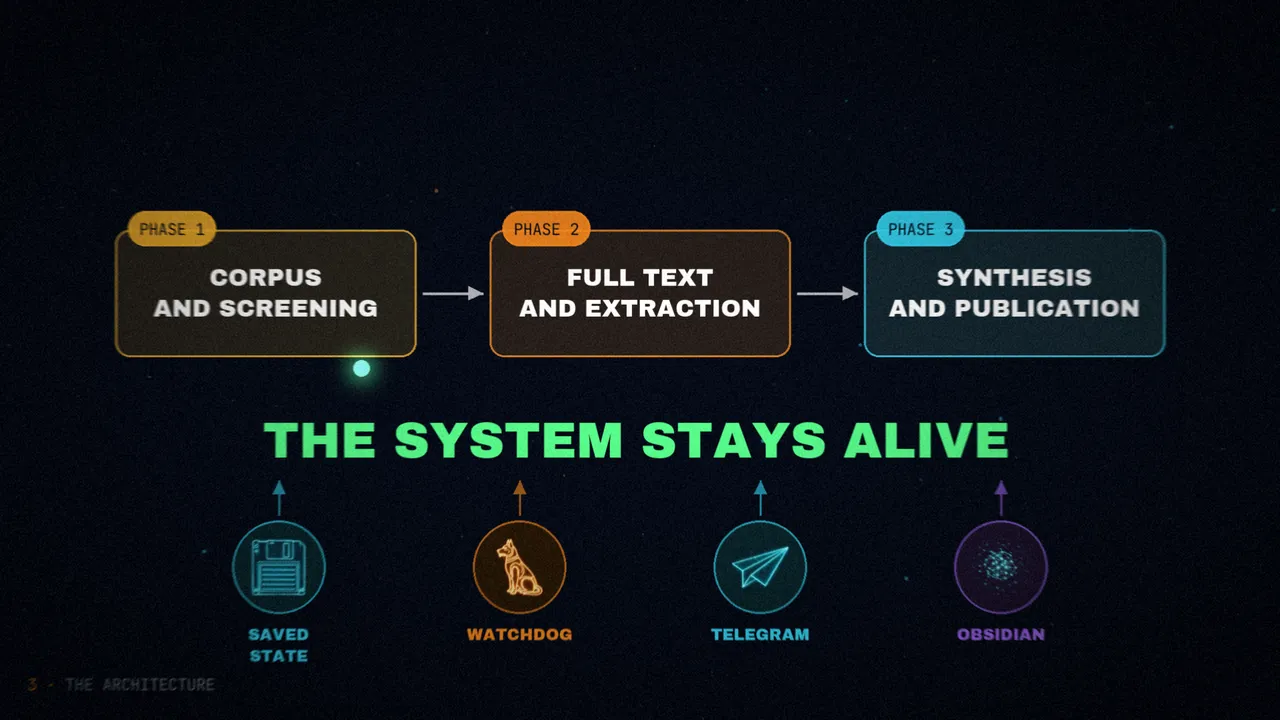
O sistema é construído com Hermes (Hermes Agent, segundo a figura de arquitetura do artigo) e se apoia em quatro camadas:
- Uma superfície mínima pelo Telegram. O autor não quer que a operação dependa de uma interface própria. As revisões são lançadas e consultadas com comandos como
/prisma_systematic_reviewe/prisma_status. - O runtime em Docker, com dois serviços:
hermes-agentexecuta o gateway e o trabalho principal, ehermes-prisma-watchdogmonitora as revisões em andamento e retoma as fases quando detecta que travaram. - A política de modelos. O modelo principal é o Qwen 3.6, servido pela NaN Builders. Se ele falhar, há uma cadeia de reserva no Ollama Cloud: DeepSeek v4-pro, Kimi K2.6, Qwen3-coder e Gemma4. Tudo fica em um
config.yamlcom seus parâmetros. - A orquestração, com três scripts:
complete_review.py,publication_autopilot.pyepublication_gate.py.
Há outra camada que costuma ficar escondida: as skills. Na instalação do autor há dez skills locais de pesquisa, e no caminho até uma revisão publicável usa principalmente cinco: revisão sistemática, estado, revisão acadêmica, integridade e mapa de mudanças. A ideia de fundo é que a arquitetura não é um superagente que faz tudo, e sim camadas especializadas com contratos pequenos. Isso, diz o autor, a torna sustentável para o seu caso de uso.
Segundo as figuras do artigo, o trabalho se organiza em três fases: corpus e triagem; texto completo e extração; síntese e fechamento.
Como uma revisão começa
Uma das ideias mais úteis do artigo: uma revisão se enviesa antes na entrada do que no fim, na discussão. Por isso o sistema obriga a congelar o quanto antes a pergunta, a janela de tempo, o tipo de estudo admissível, o número final de estudos desejado, os critérios de inclusão e exclusão e o enquadramento editorial. Se o tema nasce como «vamos ver o que aparece», o resto do sistema só automatiza ambiguidade.
Essa fase deixa rastro desde o primeiro minuto, em três arquivos:
protocol/intake.md: a pergunta e o escopo.protocol/eligibility-criteria.md: os critérios de inclusão e exclusão.protocol/search-strategy.md: a estratégia de busca.
O importante não é só que existam, e sim que outra pessoa possa abri-los e verificar se o viés nasce na pergunta, na busca ou na interpretação.
Há um detalhe que o autor gosta de mencionar. Se não há uma revista específica para a qual enviar o trabalho, o sistema cai em um modo genérico (generic-common-core), um modelo que passaria por um primeiro filtro. Essa decisão afeta o modelo de LaTeX, o pacote editável e o tom do fechamento. É uma forma de não fingir que o trabalho está alinhado a uma revista que ainda não foi escolhida.
Quatro comandos, quatro incertezas
Aqui a revisão deixa de ser uma intenção. A pergunta, a unidade de análise, a janela de tempo, os critérios e o limite de qualidade ficam fixados em arquivos que condicionam tudo o que vem depois. Quatro peças fazem isso, e cada uma fecha uma incerteza diferente:
| Peça | O que fixa | O que faz |
|---|---|---|
bootstrap_topic_review.py | O escopo | Não se limita a criar pastas: materializa o ponto de partida (o intake.md, a estratégia de busca e a estrutura do projeto). Se depois o corpus ficar enviesado, dá para voltar a essa origem e ver onde o problema nasceu. |
doi_audit.py | A identidade do corpus | Separa os registros com DOI identificável, os duplicados e os ambíguos. Evita um dos erros mais frequentes: achar que há mais estudos do que realmente existem, ou não saber por que um artigo foi fundido ou descartado. |
complete_review.py | A ordem do processo | Dirige a sequência completa: aquisição, triagem, recuperação dos textos, extração e passagem para a camada editorial. Não se extrai se o corpus não está fixado, não se aceita um estudo sem texto completo e não se publica se faltam artefatos intermediários. |
review_runtime_state.py | A memória operacional | Guarda o estado fora da conversa: o que está feito, o que falta, que bloqueios existem e que arquivos sustentam cada passo. Se a revisão é interrompida, o sistema relê e continua. |
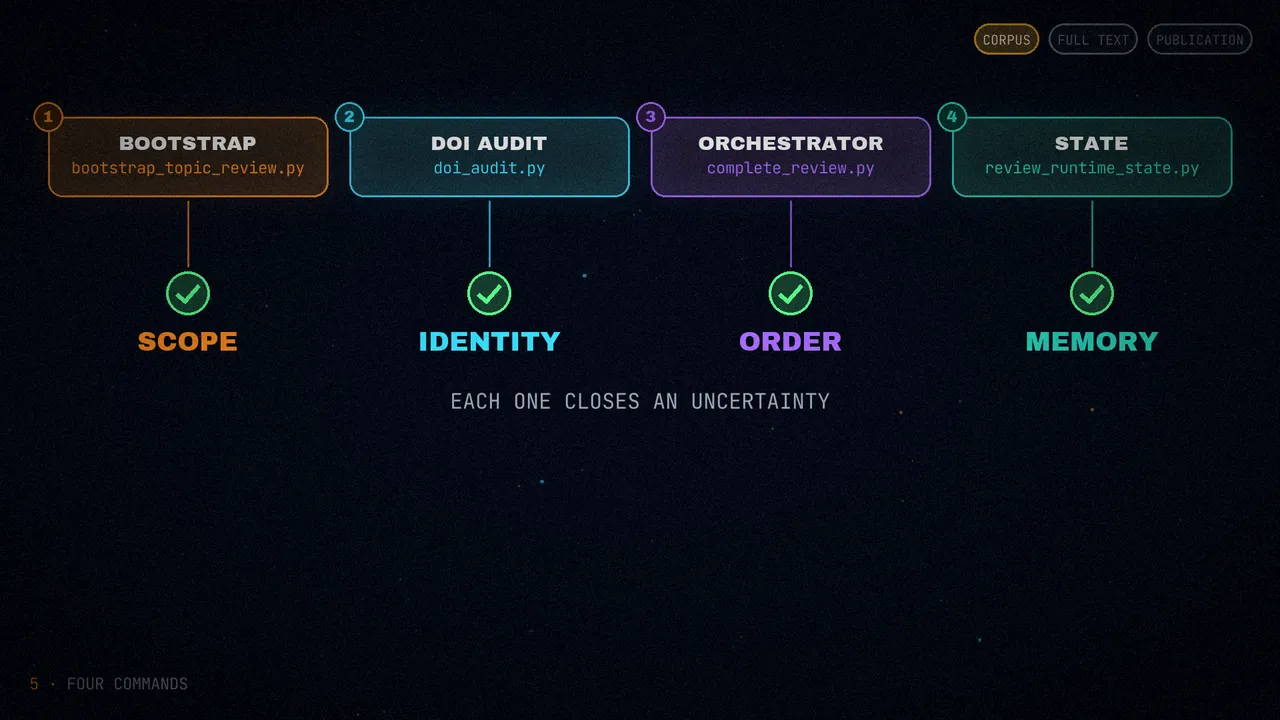
A fronteira metodológica fica escrita antes de importar o primeiro registro. A partir daí, o sistema já não tenta adivinhar que revisão o autor quer: executa a que ficou especificada.
De quatro fontes a um universo «DOI-first»
O sistema consulta várias fontes porque nenhuma basta sozinha: OpenAlex, Crossref, Semantic Scholar e arXiv, com chamadas HTTP diretas. O resultado não é «uma busca em abstrato», e sim um conjunto com rastro técnico, distribuído em cinco arquivos:
searches/search-log.csv: a consulta, a fonte, a data e quantos registros voltaram.records/master-records.csv: o universo bruto, normalizado.records/doi-index.csv: a chave canônica de cada estudo, por DOI.records/duplicates.csv: as colisões detectadas.records/missing-doi.csv: o que não dá para resolver por DOI.
Quando um registro não tem DOI, o sistema gera para ele um identificador estável a partir de um hash (um RID). Assim o mesmo artigo, vindo de duas fontes com o título escrito de duas maneiras, conta uma vez só. Segundo uma figura do artigo, essa abordagem «reduz ruído, baixa o custo e melhora a confiabilidade»; é uma afirmação do autor, não uma medição.
Neste ponto, diz o autor, a revisão deixa de ser uma coleção de buscas e começa a parecer uma base documental.
Como decide: OK, KO ou falta mais
A lógica de inclusão e exclusão não é um algoritmo mágico nem uma pergunta ao modelo do tipo «isto parece relevante?». É uma sequência de quatro camadas:
- Regras mínimas. A mais visível é um limite mínimo de texto útil: se o texto completo não chega lá, não há base para a inclusão final. O texto do artigo não dá o número; uma de suas figuras o coloca em 4.000 caracteres úteis.
- Decisão assistida por modelo. O modelo classifica e justifica.
- Canonização. Uma função normaliza as variantes (
include,include_ft,exclude, «excluido», «excluir»,maybe) em um conjunto consistente de decisões. - Auditoria com recomputação. As contagens do diagrama PRISMA não são digitadas à mão: são recalculadas a partir dessas decisões já normalizadas.
Com isso, cada estudo acaba em uma de três saídas:
Passa nas regras mínimas, confirma o foco no texto completo e deixa uma justificativa rastreável em um CSV.
Falha nesses critérios ou tem um motivo de exclusão claro.
A triagem rápida não basta para decidir.
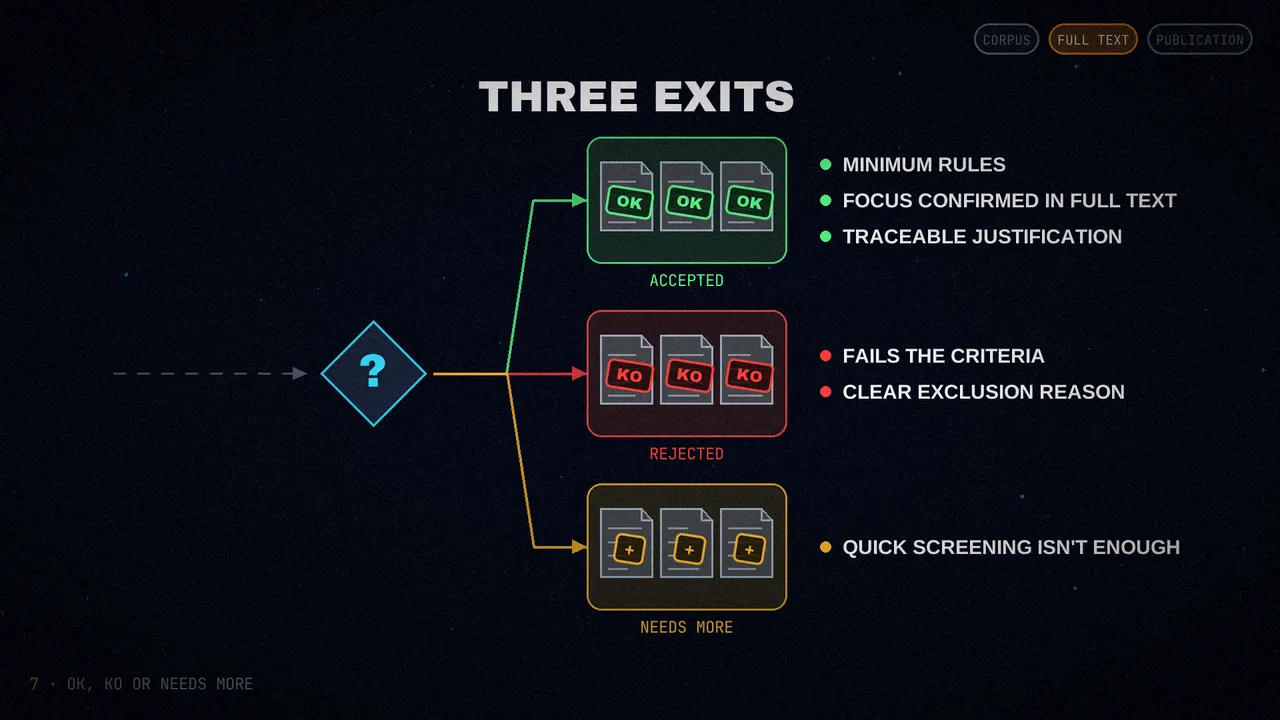
Para o autor, essa lógica está mais próxima de ferramentas de avaliação estruturada como ROBIS ou AMSTAR 2 do que de uma simples ordenação por relevância. É a opinião do autor sobre o desenho, não uma equivalência formal.
Extração profunda
Saber que um artigo é «experimental» não basta. O autor quer saber que sistemas ele nomeia, que benchmark usa, que amostra descreve, que variáveis emprega, que método relata e em que teoria se apoia. Tudo isso vai para extraction/extraction-table.csv, com campos como work_type, empirical_type, models_or_systems_studied, benchmark_dataset_or_corpus, dependent_variables ou theoretical_framework.
Quando a primeira extração fica rasa, entra o refresh_extraction_depth.py, que relê o texto extraído do PDF e força uma camada mais profunda. Resolve um problema que o autor diz ter vivido várias vezes: artigos que na primeira passada ficavam rotulados só como «estudo experimental», quando o documento completo trazia nomes, escalas e métricas. O autor marca isso como muito importante para quem quiser construir o próprio sistema.
Cada estudo é organizado em quatro blocos:
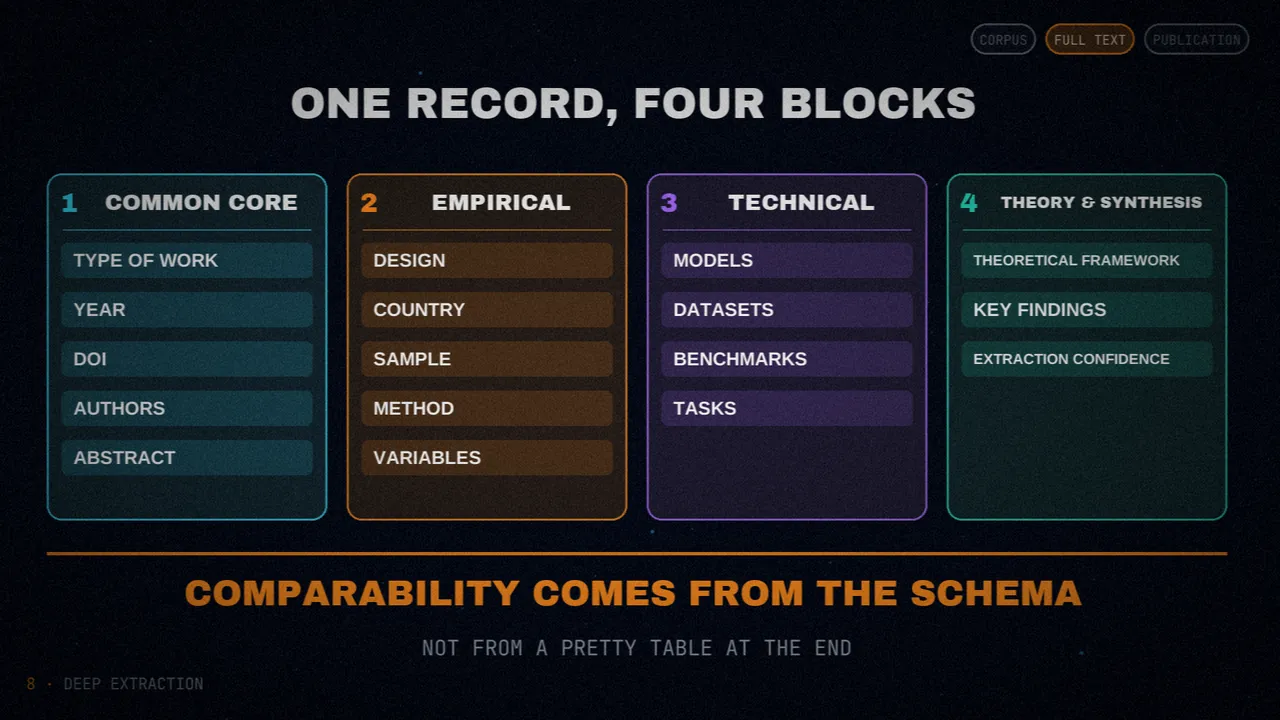
A conclusão desta parte: a comparabilidade entre estudos nasce do esquema de extração, não de uma tabela bonita no final.
Figuras e evidência visual
Em muitos temas, uma figura concentra a arquitetura, o desenho experimental ou as relações entre conceitos que o resumo não traz. Por isso o sistema tem uma camada explícita de evidência visual, com modelos capazes de ver e processar imagens.
O script principal, prepare_paper_figures.py, separa três coisas fáceis de misturar:
- Figuras científicas extraídas dos PDFs (
figures/extracted/). - Renderizações de página de apoio, para diagnóstico (
figures/page-renders/). - Figuras próprias, geradas para o manuscrito.
Sem essa separação, uma página inteira renderizada pode ser confundida com uma figura reutilizável. A rastreabilidade fica em um manifesto, um catálogo e um ranking (figures/manifest.csv, figure-catalog.md e figure-ranking.csv). As figuras próprias levam uma assinatura (neste caso, 686f6c61) para distingui-las das do corpus: misturar evidência alheia com síntese visual própria é, diz o autor, má prática metodológica e má prática editorial.
Do corpus ao manuscrito
Com o corpus consolidado, o desafio passa de documental a editorial. A peça central é o publication_audit.py: recompõe seções, limpa incoerências, normaliza citações e referências, integra tabelas e figuras, detecta lacunas óbvias e gera o manuscrito. Deixa três versões do mesmo documento em paper/manuscript/:
publication-ready.md: a versão editável.publication-ready.tex: a saída em LaTeX, para continuar o trabalho em um ambiente acadêmico.publication-ready.pdf: a versão compilada, pronta para circular.
A isso se somam a bibliografia em BibTeX (references.generated.bib) e o modelo genérico main-common-core.tex quando não há revista-alvo.
Aqui o autor impõe o que chama de suas manias: cada estudo relevante deve ter mais do que uma linha de tabela. O manuscrito inclui fichas por estudo, com um ou dois parágrafos antes da tabela compacta, e blocos ampliados de discussão, implicações teóricas, contribuição original, conclusões e linhas futuras. «Publication-ready» é o nome dos arquivos e o objetivo do autor; o artigo não diz que alguma dessas revisões tenha sido publicada.
Revisão cruzada e controle final
Esta é, para o autor, a camada que mais diferencia o sistema de um fluxo convencional com vários modelos. O autor não aceita um manuscrito porque um modelo escreveu um texto sólido. Aceita quando o manuscrito passa por um circuito cumulativo:
- Revisão cruzada (
publication_peer_review.py). O revisor A trabalha com o Qwen 3.6 e o revisor B com o DeepSeek v4-pro; o Kimi K2.6 fica como primeira reserva editorial. A atribuição está em um arquivo,reviewer-models.csv. - Integridade (
check_manuscript_integrity.py): procura afirmações fracas, inconsistências e lacunas de sustentação. - Mapa de mudanças (
build_revision_roadmap.py): transforma a revisão em uma matriz de mudanças acionáveis. - Controle final (
publication_gate.py): verifica se os artefatos exigidos existem e se o fechamento é legítimo. - Piloto automático (
publication_autopilot.py): repete o circuito até fechar ou até documentar um bloqueio real.
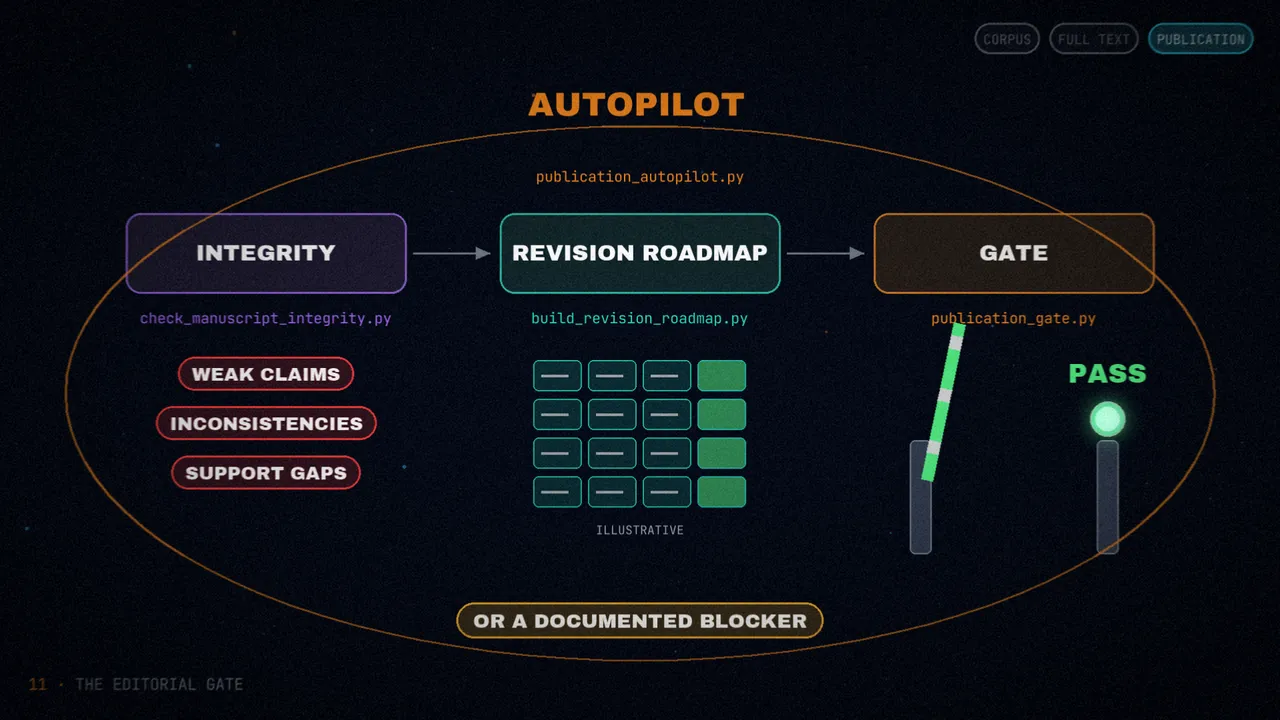
Vale ler com precisão: os dois «revisores» são modelos diferentes que se revisam entre si, não revisores humanos independentes nem a revisão por pares de uma revista. O que isso evita, segundo o autor, é um erro específico: entregar algo que parece terminado quando não passou pelos controles que justificam chamá-lo de publicável.
Pacotes e memória fora do chat
Quando o controle devolve PASS, o sistema não termina em uma pasta solta. Gera dois pacotes, porque nem todo leitor precisa da mesma coisa: publication-package.zip, o pacote editorial geral, e publication-latex-editable.zip, para continuar editando em LaTeX.
Ao mesmo tempo, o sync_review_to_obsidian.py sincroniza a revisão com um cofre do Obsidian, onde fica uma versão navegável: fichas, visão geral, biblioteca visual, notas e o rastro do PRISMA.
A continuidade não depende de lembrar uma conversa. Depende de arquivos de estado (notes/runtime-state.md e notes/runtime-state.json), de manifestos, dos ZIPs e de um vigia que sabe reler e retomar. A memória real do sistema está fora do chat. Segundo o autor, pela lógica FAIR isso aproxima a revisão de um ativo localizável, acessível e interoperável; o artigo não diz que a cumpre.
Os limites que o autor reconhece
O artigo não termina fingindo que o sistema é perfeito. Ele continua dependendo de quatro coisas: a qualidade das fontes, a possibilidade de recuperar o texto completo, a disponibilidade dos modelos na nuvem e a possibilidade de extrair figuras ou tabelas complexas sem perda.
E mesmo com o controle endurecido, o autor vê quatro pontos a melhorar:
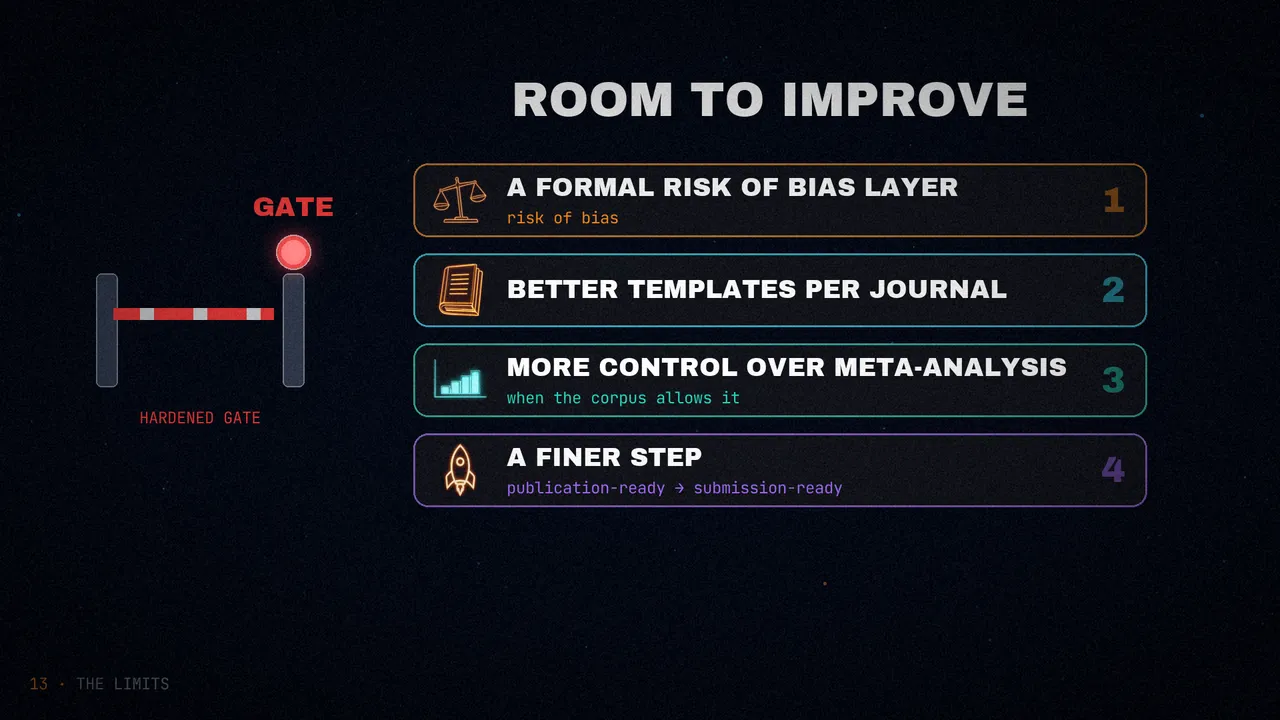
O primeiro é significativo: ainda falta uma camada formal de risco de viés (risk of bias). O autor diz que continua trabalhando para publicar algo que dê para instalar, usar e melhorar.
Como ler este artigo
- Descreve um desenho, não resultados. Não há números de precisão, de tempo nem de revisões aceitas. «Publicável» e «defensável» são o objetivo do autor, não algo que o artigo demonstre.
- Ainda não dá para instalar. O pacote não está publicado; o autor o anuncia para mais adiante.
- Não elimina o viés. O que faz é deixar rastro para que outra pessoa possa auditar cada decisão.
- Os revisores são modelos. É revisão cruzada entre modelos diferentes, não revisão humana independente.
- Os modelos e versões (Qwen 3.6, DeepSeek v4-pro, Kimi K2.6…) são os da instalação do autor, como o artigo os nomeia.
Em resumo
O que levo do artigo vale para qualquer sistema de agentes, não só para revisões científicas: as regras em um arquivo e não em um prompt invisível, um arquivo para cada passo, a memória fora da conversa, as contagens recalculadas a partir dos dados e um controle final que decide o fechamento no lugar da sensação de que «já está».
Uma revisão séria deixa artefatos, não só uma conversa convincente; a qualidade é uma condição de saída, não uma intenção.
Você confiaria em uma revisão feita assim se pudesse abrir cada arquivo e seguir cada decisão?
Fontes
- «Cómo monto un sistema de revisión PRISMA que se audita solo con HERMES», de Entre Kaczynski y Chinaski (@686f6c61), no X (10 de maio de 2026; em espanhol).
- Diretrizes que o artigo cita: PRISMA 2020 (Page et al., 2021), PRISMA-S (Rethlefsen et al., 2021), ROBIS (Whiting et al., 2016), AMSTAR 2 (Shea et al., 2017) e os princípios FAIR (Wilkinson et al., 2016).
- O vídeo, nos meus canais: inglês e espanhol.