Antes de tocar nada
Casi todos los consejos consisten en añadir o quitar texto del prompt de sistema, de la descripción de una herramienta o de las notas que arrastra el agente. La guía pide hacerlo solo en conversaciones nuevas. Claude Fable 5.2 conserva su razonamiento entre turnos, y la API comprueba que el historial no haya cambiado (lo llama prefix check). Si retomas una conversación guardada después de cambiar system, tools o un mensaje anterior, la petición puede fallar con un error 400.
Para cambiar instrucciones a mitad de conversación, ponlas en el turno más reciente. Donde haya mensajes de sistema a mitad de conversación, también puedes añadir uno al final.
Calibra el esfuerzo
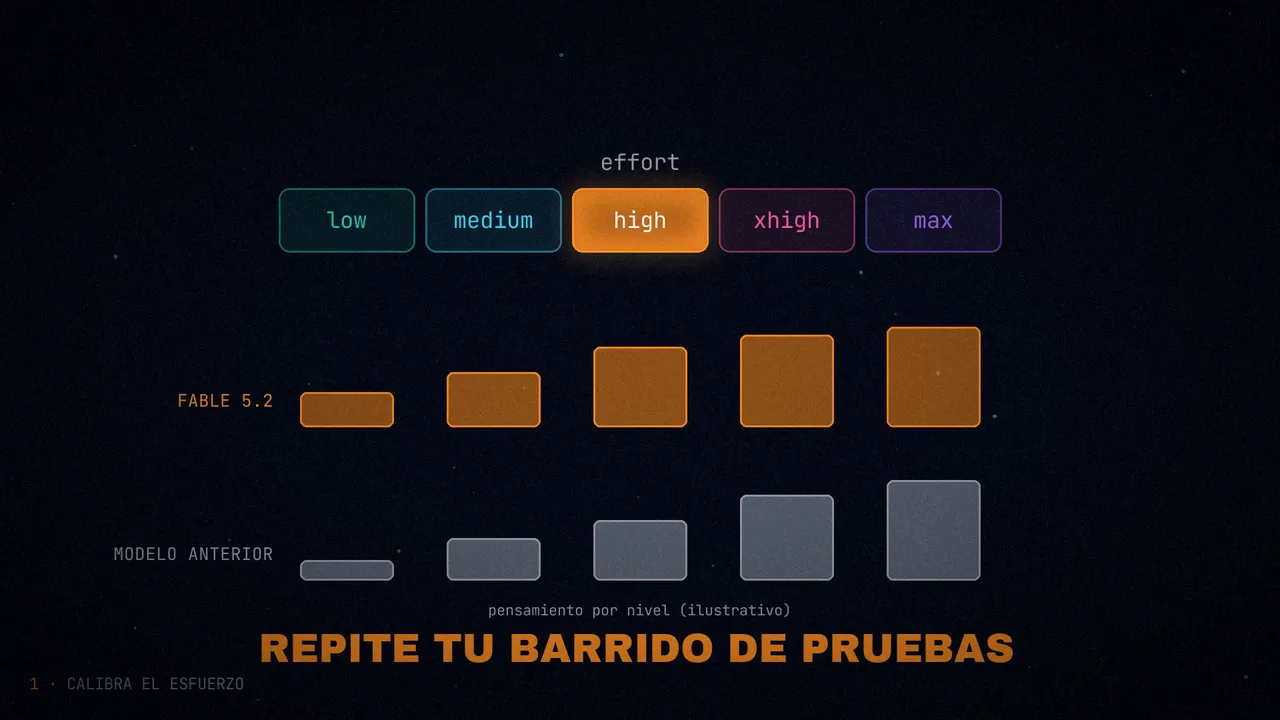
En este modelo, el nivel de effort decide cuánto piensa, cuántas llamadas a herramientas hace, cuánto dura un turno y cuántos tokens gasta. Por eso se ajusta junto con el prompt. El punto de partida es high, que es el valor por defecto en la API de Claude.
Los niveles se ordenan igual en todos los modelos de Claude, pero la cantidad de pensamiento de cada uno cambia. La consecuencia práctica: repite tu barrido de esfuerzo en lugar de heredar el ajuste que tenías con Claude Fable 5.1 o Claude Opus 5.5.
| Nivel | Para qué sirve | Lo que dice la guía |
|---|---|---|
low | Ida y vuelta rápido, tareas bien especificadas y grandes volúmenes (subagentes rápidos) | En evaluaciones de programación rinde mejor que los modelos anteriores en ese nivel; en las pruebas de Anthropic se quedó cerca de lo que Fable 5.1 lograba con más esfuerzo |
medium | Programación interactiva, chat y trabajo de conocimiento del día a día | |
high | Programación difícil, investigación, trabajo agéntico y ejecuciones largas sin supervisión | Los turnos tardan bastante más que en medium |
xhigh | Lo más duro y largo, y solo si has medido una mejora | En las evaluaciones internas de programación subió un poco las notas y gastó muchos más tokens |
max | Medir el techo del modelo, o problemas abiertos (descubrimiento científico, matemáticas) donde el tiempo y los tokens no importan | Turnos lentos y muchos más tokens que en xhigh |
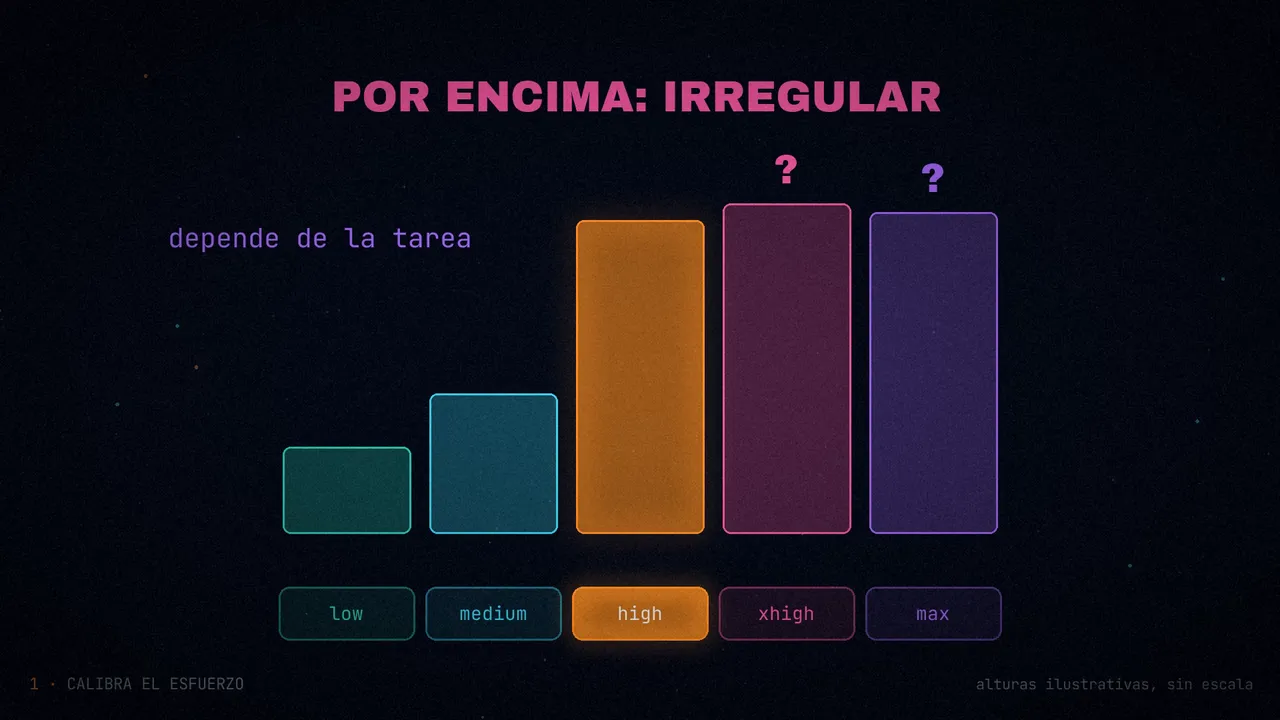
Casi toda la ganancia llega en high. El paso de medium a high subió las notas en la mayoría de las evaluaciones de programación y de trabajo de conocimiento que sigue Anthropic, pero cuesta más tokens y más tiempo: baja a medium allí donde tus propias evaluaciones aguanten. Por encima de high, las mejoras son irregulares y dependen de la tarea. La guía no da cifras de ninguno de estos saltos.
Tres detalles más:
- Piensa casi siempre. De
highhacia arriba, el modelo piensa antes de casi todas sus respuestas, incluso ante un saludo. Si las peticiones básicas te tardan o te cuestan más, usa menos esfuerzo en esos turnos. Pedirle que responda directamente, sin deliberar, no le impidió pensar demediumen adelante. - No cambia el largo. El esfuerzo apenas afecta a la longitud de las respuestas. El largo y el tono se cambian con el prompt.
- Se puede mezclar. Por ejemplo, planificar e iterar en
mediumy subir para la parte larga y desatendida. Para cambiarlo dentro de una conversación sin perder la caché existe el esfuerzo por mensaje (beta). Donde no esté, pones otroefforten la siguiente petición, y eso puede invalidar los mensajes en caché.
Si haces trabajo agéntico en low o medium, añade el texto de la sección siguiente: con poco esfuerzo, el modelo se para antes.
Termina la tarea entera
En tareas largas, de muchos pasos, Claude Fable 5.2 a veces termina el turno antes de acabar el trabajo. Lo hace enumerando lo que queda, ofreciéndose a continuar o deteniéndose ante un obstáculo corriente, como un tiempo de espera agotado. Pasa más en low y medium. Si lo ves en tu agente, la guía propone añadir esto al prompt de sistema:
# Finishing work
Please avoid stopping while you still owe work the user asked for. Be persistent and do not stop unless needed.

While status notes are welcome, as is clarifying with the user on open decisions, carry on with work that does not depend on the user's answer without unnecessary stops.

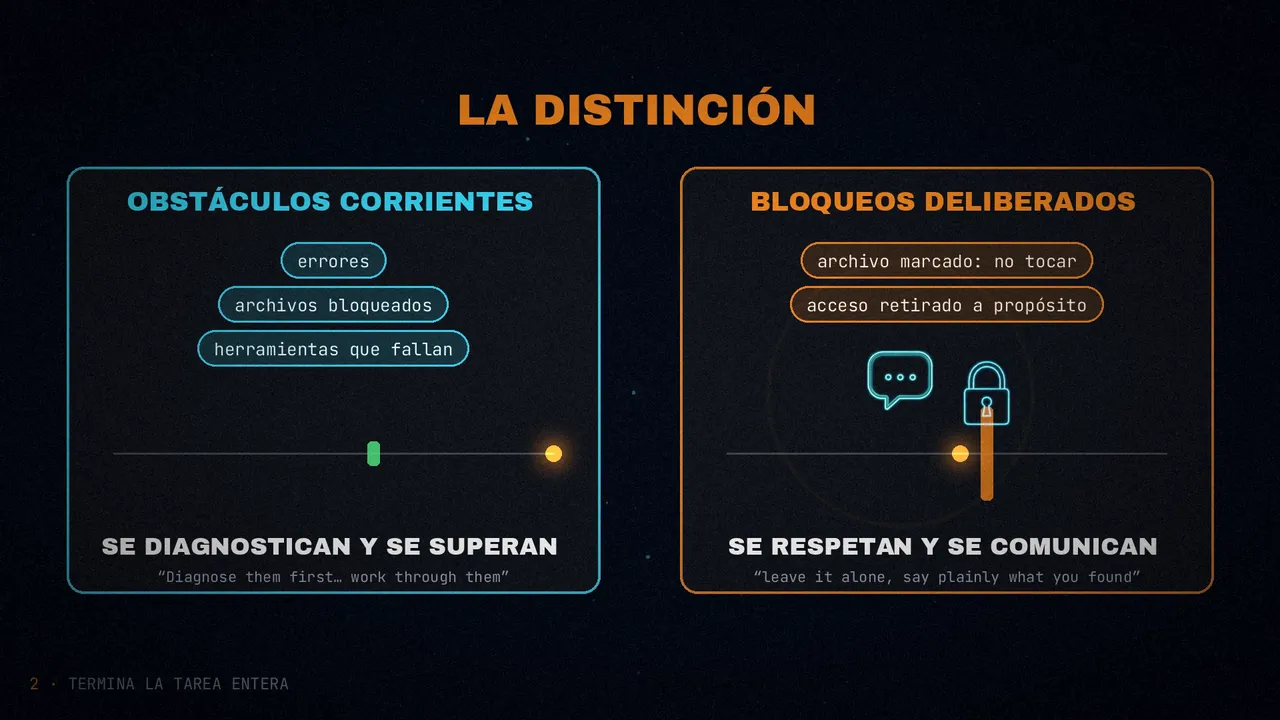
If you notice yourself inviting the user to redirect you or offering to wait, instead proceed on the next part of the task. You may meet ordinary obstacles like errors, timeouts, locked files, empty results or failing tools. Diagnose them first, and when they are not real blockers, work through them with the access you have (wait and retry, fix the request, use another tool or source) rather than stopping unnecessarily.

If someone clearly decided something is a hard blocker, such as a file marked not to be touched, access that was intentionally withheld, or a safety guardrail, leave it alone, say plainly what you found, and look for another safe way to finish the task. Stopping before the task is complete is very rarely merited, as in when the task can't move forward without user input, or where the blocker is deliberate and should not be worked past. This does not override the need for confirmation on risky or destructive actions.
El texto separa dos cosas. Los obstáculos corrientes (errores, tiempos agotados, archivos bloqueados, herramientas que fallan) se diagnostican y se superan. Los bloqueos deliberados (un archivo marcado para no tocarlo, un acceso retirado a propósito, una barrera de seguridad) se dejan como están y se comunican. Es un punto de partida, para adaptarlo a tu caso.
Anthropic lo probó reproduciendo sesiones grabadas de un producto de programación agéntica, en medium. Con una versión de este texto:
- Bajaron más o menos a la mitad las sesiones que acababan con trabajo pendiente que se podía haber continuado.
- Desaparecieron casi todos los finales que piden permiso o se ofrecen a seguir. No los que enumeran lo que falta y se paran.
- Los tokens de salida subieron en torno a un 30 %.
Como con este texto el modelo pregunta menos, conserva tu propio paso de confirmación para las acciones arriesgadas o irreversibles.
Aprobaciones
Dos consejos. El primero: cuando le digas que siga, di exactamente qué quieres, en lugar de un «continúa». La guía pone el ejemplo de responder «Yes, run the migration on the staging database» donde habrías enviado un «go» o un pulgar arriba.
El segundo: si escribes reglas de aprobación en el prompt de sistema, concreta qué acciones quieres que consulte. En pruebas con tareas simuladas en las que no había nadie para aprobar, una regla que incluía «sending messages to people outside this conversation» entre los pasos que requieren aprobación hizo que el modelo retuviera cerca de la mitad de sus peticiones rutinarias a compañeros y a otros equipos.
Di de quién es el código
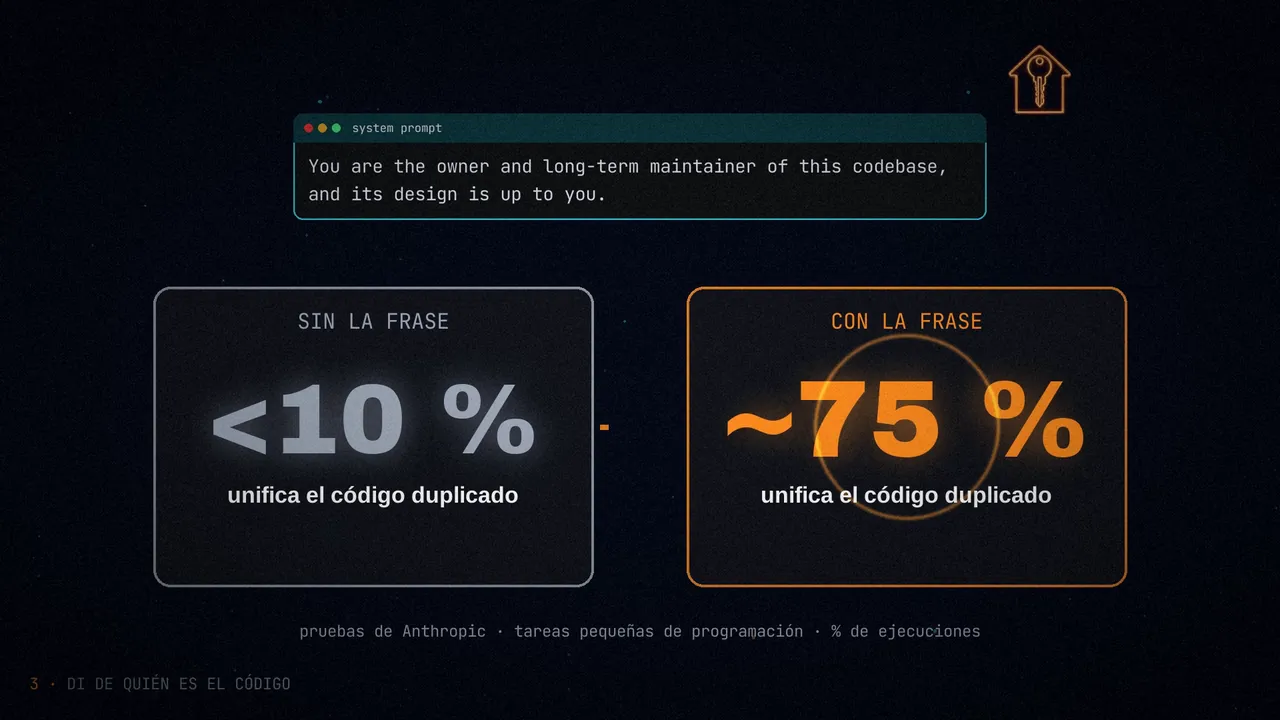
Claude Fable 5.2 se fija mucho en de quién es el código en el que trabaja. En pruebas con tareas pequeñas de programación, cuando el prompt no decía nada sobre la propiedad, o presentaba el repositorio como ajeno, el modelo tendía a añadir sobre la estructura existente, aunque eso duplicara código. Cuando el prompt decía que el código era suyo, a menudo unificaba los duplicados y a veces hacía arreglos relacionados sin que nadie los pidiera.
Si quieres que mejore la estructura mientras trabaja, la guía propone decírselo con una frase:
You are the owner and long-term maintainer of this codebase, and its design is up to you.Sin la frase, el modelo unificó el código duplicado en menos del 10 % de las ejecuciones. Con ella, en torno al 75 %.
Tiene un precio:
- Tokens: los de salida subieron entre un 70 y un 80 %.
- Cambios no pedidos: muchos de ellos, pruebas y documentación nuevas. En algunas ejecuciones cambió también cómo se comporta una función que ya existía.
- Resumen incompleto: el resumen final de la PR solía dejarse fuera cambios pequeños. Revisa el diff además del resumen.
No pongas la frase cuando el código es del usuario y quiere que se toque lo mínimo. Y una regla que limita el alcance no la anula: con «No drive-by refactors, renames or cleanups» escrito antes en el mismo prompt, el modelo siguió unificando duplicados en más de la mitad de las ejecuciones.
Mantén informado al usuario
Durante las rachas largas de llamadas a herramientas, el modelo a veces escribe poco texto para el usuario, y puede hacer la primera llamada sin decir qué va a hacer. Antes de tocar el prompt, comprueba que tu cliente recibe lo que el modelo sí escribe.
En Claude Fable 5.2, los avisos que el modelo escribe entre herramienta y herramienta llegan como bloques thinking de progreso: cuentan qué ha encontrado y qué hará después. Con el valor por defecto de thinking.display, "omitted", su texto llega vacío, así que un cliente que solo pinta los bloques text parece mudo durante un turno largo. Con display: "updates" (beta) recibes un resumen corto de cada aviso, y con "summarized", los avisos junto con el razonamiento resumido. Después hay que mostrar entre las llamadas los bloques thinking que traigan texto.
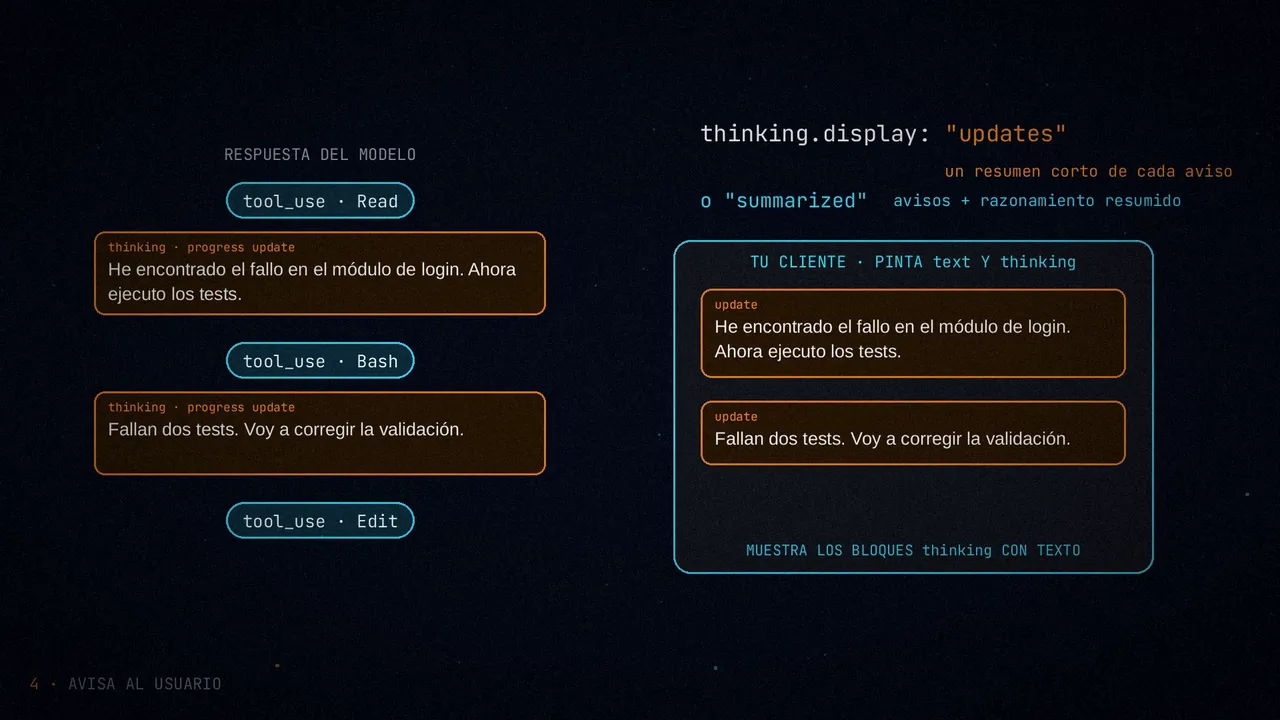
display: "omitted", los avisos llegan vacíos y el cliente parece mudo.Para los usos interactivos, la guía da tres palancas.
1. En el arnés. Cuenta los pasos seguidos de herramientas que no le dan al usuario nada que leer (con display en "updates" o "summarized", porque en "omitted" todos los bloques van vacíos). Cuando se acumulen varios, añade este recordatorio después de los últimos resultados, como mensaje de sistema válido solo para ese turno (clear_at: "next_user_message", beta):
The user hasn't heard from you in a while: say in a few words what you're doing, then continue.En tareas de programación de varios turnos, el recordatorio redujo más o menos a la mitad el tramo de silencio más largo, sin un aumento apreciable de tokens ni de tiempo. Deja cada recordatorio en messages en las peticiones siguientes: quitarlo o cambiarlo edita un turno anterior e invalida los bloques de pensamiento que vienen después.
2. En el prompt de sistema, la intención. Para tener una línea antes de la primera llamada, avisos breves y un resumen final:
Before you start, say in a line what you're about to do; brief updates while you work help the user follow along. Close with a short recap that stands on its own (what you found, what you did, and what's next), so a reader who only sees the last message has the full picture.Con este texto, el modelo escribió un mensaje antes de su primera llamada en todas las ejecuciones de las tareas de programación. Los tokens de salida por tarea subieron cerca de un 20 %. Úsalo donde haya una persona delante y, si quieres más avisos, junto con el recordatorio.
3. Si no puedes tocar el arnés, o tu plataforma no tiene mensajes de sistema a mitad de conversación, una frase en el prompt de sistema:
Every few tool calls, give the user a one-line update on where things stand.Esa frase recortó la mayoría de los silencios largos en tareas de automatización de flujos. Aun combinando las tres, espera rachas de varias llamadas entre aviso y aviso. La guía añade que el modelo trabaja bien en tareas asíncronas y largas, y lo recomienda para el trabajo en el que nadie necesita avisos frecuentes.
Subagentes
Cuánto delega Claude Fable 5.2 depende de tu arnés y de tus tareas. En tareas cortas, con una herramienta de subagentes mínima, casi nunca lanzó uno. En un producto de programación cuyos prompts invitan a delegar, delegó con facilidad. Y en xhigh y max, Anthropic lo vio usar subagentes para revisar su propio trabajo, algo que Fable 5.1 no hacía en las mismas tareas.
Los primeros probadores tuvieron buenos resultados usándolo como planificador y orquestador de otros modelos. Delegar acelera el trabajo que se puede hacer en paralelo, pero los subagentes pueden suponer una gran parte del coste de una sesión: comprueba qué modelo usan por defecto.
Cambia la descripción de la herramienta de subagentes solo si el modelo lanza más de los que tus tareas necesitan. Antes, revisa si tu prompt de sistema, tus skills o tus archivos de agente le dicen que delegue. La nueva descripción debe contar tres cosas:
- Qué añade un subagente al coste de la sesión.
- Cuándo compensa delegar y cuándo no.
- Cómo darle el encargo al subagente que lance.
Si aun así delega demasiado, cuenta más sobre el coste y prueba el cambio. En las pruebas de Anthropic en high, una descripción más larga centrada en el coste redujo los subagentes más o menos a la mitad frente a una versión más corta.
Que la cautela no se acumule
Las instrucciones prudentes se van acumulando de sesiones pasadas, a través de la memoria, las notas y los archivos de instrucciones. Como Claude Fable 5.2 las sigue al pie de la letra, puede acabar pidiendo aprobaciones innecesarias. Anthropic lo vio sobre todo cuando varios agentes trabajaban juntos. Los remedios:
- Borra las notas que ya no necesitas. La memoria puede guardar instrucciones antiguas, como «never retry», que el modelo sigue obedeciendo.
- Nombra los pasos que no requieren aprobación. Decirle que actúe con más libertad es demasiado vago: enumera los pasos rutinarios que puede dar solo.
- Revisa tus validaciones. Una condición como «stop and review at the first error» puede bloquear el trabajo autónomo. Quita o acota las que no necesites.
- Sé explícito con las excepciones. El modelo trata una instrucción con «never» como absoluta. Si quieres que siga pudiendo hacer esa acción, escribe «ask for approval before deleting files» en lugar de «never delete files».
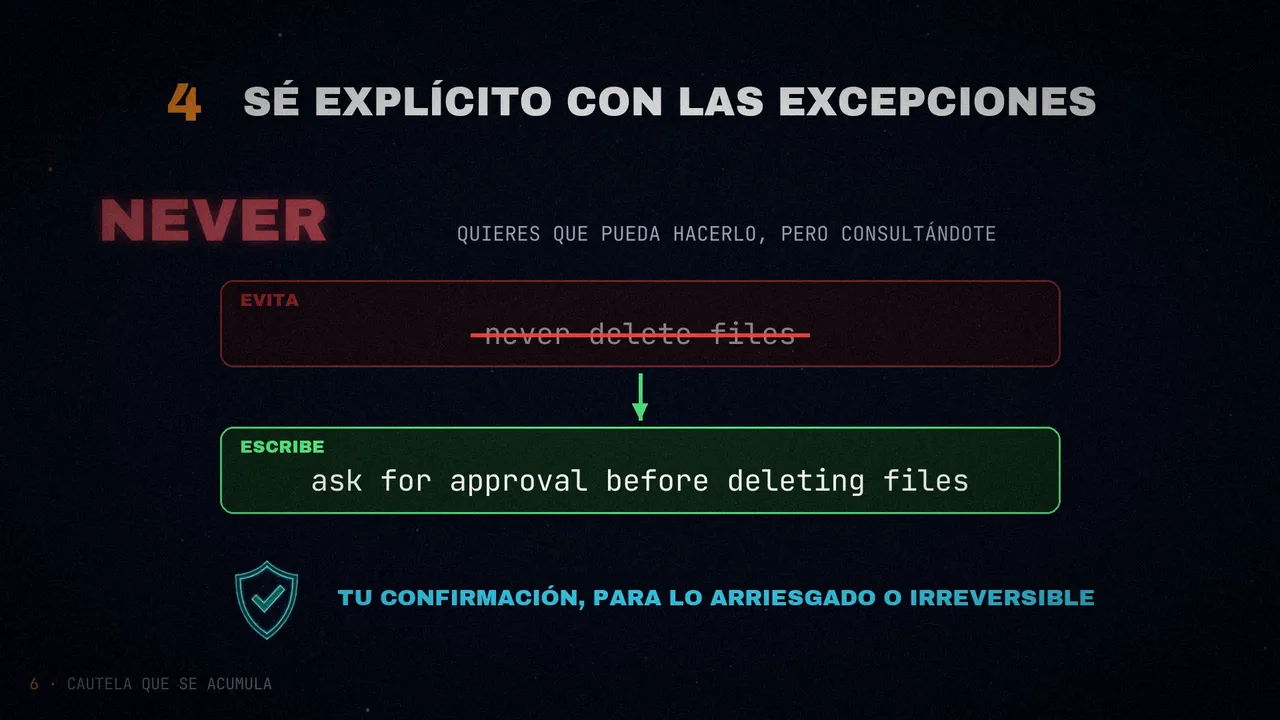
Y, otra vez, mantén tu propio paso de confirmación para lo arriesgado o irreversible.
Lo heredado de modelos anteriores
Al migrar, revisa tus prompts y tu arnés. En las pruebas de Anthropic, algunas instrucciones e intervenciones pensadas para modelos anteriores subían el coste, causaban efectos secundarios o ya no hacían nada. La guía enumera siete:
- Instrucciones permanentes de delegar. Pueden estar en prompts de sistema, skills y archivos de agente. Léelos antes de migrar y quita las que sobren si el modelo delega demasiado.
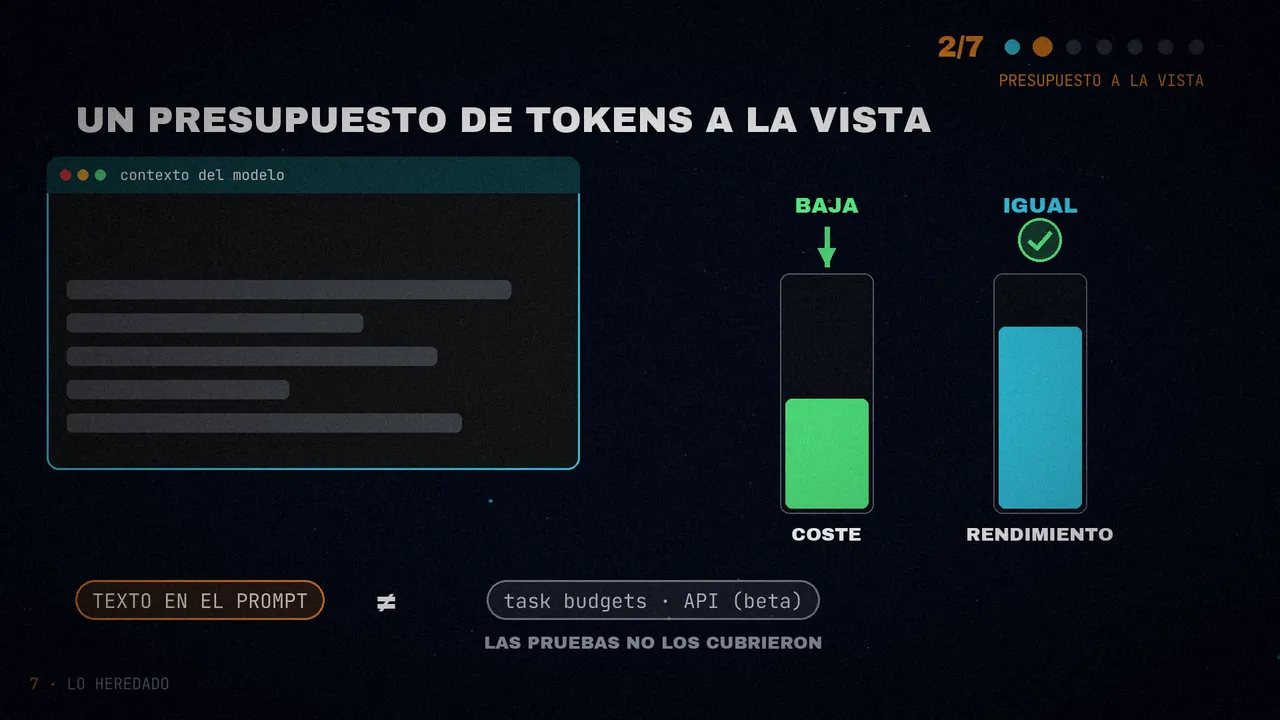
- Un presupuesto de tokens a la vista del modelo. Algunos arneses le muestran cuánto tiene para la tarea y cuánto le queda, y el tamaño de esa cifra cambia cuánto gasta. En tareas de programación en
highyxhigh, quitar un presupuesto grande bajó el coste con un rendimiento equivalente. Habla del texto en el prompt, no de los task budgets de la API, que esas pruebas no cubrieron. - Código del arnés que edita turnos anteriores. Como el modelo conserva su pensamiento, si el arnés cambia el prompt de sistema, las herramientas o un mensaje anterior, los bloques de pensamiento posteriores dejan de valer: la API de mensajes rechaza la petición y la de lotes descarta esos bloques. Para acortar el historial, usa la edición de contexto o una compactación que no deje turnos anteriores tras el resumen. Por lo demás, que el historial solo crezca por el final: la caché acierta más y no se descarta pensamiento. Existe
prefix_mismatch_behavior: "drop_block"(beta) para descartar en vez de fallar, pero cuando en las pruebas se descartaba el pensamiento en cada turno, el modelo volvía a pensar y gastaba más tokens de salida. Mide antes de fiarte. - Las frases «da esa respuesta por cerrada». La guía de Opus 5.5 ofrece dos frases para chats que piden tratar la respuesta anterior como terminada y centrarse en el mensaje nuevo. En
high, redujeron el pensamiento en las preguntas de seguimiento, pero el modelo se volvió mucho menos propenso a señalar errores en sus respuestas previas. No las pongas donde quieras que se revise. - Instrucciones de pensar menos. Fable 5.1 solía obedecer un «answer directly without deliberating». Fable 5.2 no, de
mediumen adelante: quita la línea y baja el esfuerzo. - Reglas de estilo. Las sigue tan de cerca que un límite duro, como «one instruction per sentence, in 20 words or fewer», deja la prosa entrecortada.
- Reglas, notas y memorias acumuladas. Algunas las habrá escrito el propio modelo. Borra las cautelas cuya razón ya no vale y reescribe las absolutas con su alcance y su motivo. Si un sistema ya está atascado, plantéate reiniciarlo con la memoria y las notas podadas.
Informes fáciles de seguir
Los primeros probadores valoraron la escritura de Claude Fable 5.2 por encima de la de Fable 5.1 y parecida en claridad a la de Opus 5.5. Pero después de un trabajo agéntico largo, quien lee el informe final normalmente no ha visto las llamadas a herramientas ni los archivos que hay detrás, así que el informe tiene que entenderse solo. Si le pides informes finales o traspasos, la guía propone este texto de sistema, adaptado a tus lectores:
# Communicating clearly
Write for an intelligent but low-context reader. The person reading has not seen your tool calls, your reasoning or the files you opened, and may be switching in from other work. Messages should generally be self-contained: the reader should understand what you mean without having to dig for other context. Put the key points in the first few sentences. Practice progressive disclosure in your sentence order, and do not use undefined references and ideas in line 1 that won't make sense until the reader reaches line 12.

Use plain words, and write in clear, understandable full sentences. Do not use a term or abbreviation that you made up during the work. Say what the thing is in a way any reader would understand. Write mostly in the style of ASD-STE100 Simplified Technical English: short sentences, one idea per sentence, active voice, and consistently using the same word for the same thing. Use a paragraph of flowing prose where ideas connect, and keep bullets for lists of separate items. Leave out unnecessary details unless the reader asks and practice concision, but do ensure that your messages have the key context. Aim to make your user-facing text as human-readable and clear as possible.
En las pruebas con tareas agénticas, el texto dejó informes menos densos y con menos puntos y coma, y en tareas de automatización acortó las frases. Según tu caso, quizá quieras añadir instrucciones sobre la longitud o pedir detalles concretos.
Rechazos de salvaguarda
Claude Fable 5.2 funciona con clasificadores de seguridad que pueden declinar una petición. La respuesta llega con stop_reason: "refusal", y stop_details.category nombra la categoría:
| Categoría | Qué significa |
|---|---|
cyber | La petición podría facilitar un daño informático, como malware o desarrollo de exploits |
bio | Podría facilitar un daño biológico, como métodos de laboratorio peligrosos |
frontier_llm | Podría ayudar a desarrollar modelos de IA competidores |
reasoning_extraction | Pide al modelo que reproduzca su razonamiento interno en el texto de la respuesta |
general_harms | Cae en otra área de la política de uso |
null | El rechazo no corresponde a ninguna categoría con nombre |
El trabajo legítimo de ciberseguridad y de ciencias de la vida también puede activar los clasificadores cyber y bio. Si eso bloquea a tu organización, Anthropic tiene dos programas de verificación (Cyber Verification Program y Life Sciences Verification Program). Claude Mythos 5.2 ofrece las mismas capacidades que Fable 5.2 solo a las organizaciones verificadas.
Una consecuencia práctica: si tus prompts, skills o descripciones de herramientas piden al modelo que escriba su razonamiento en la respuesta, quita esas instrucciones. Para ver cómo razonó, usa display: "summarized" y lee los bloques de pensamiento.
Por dónde empezar
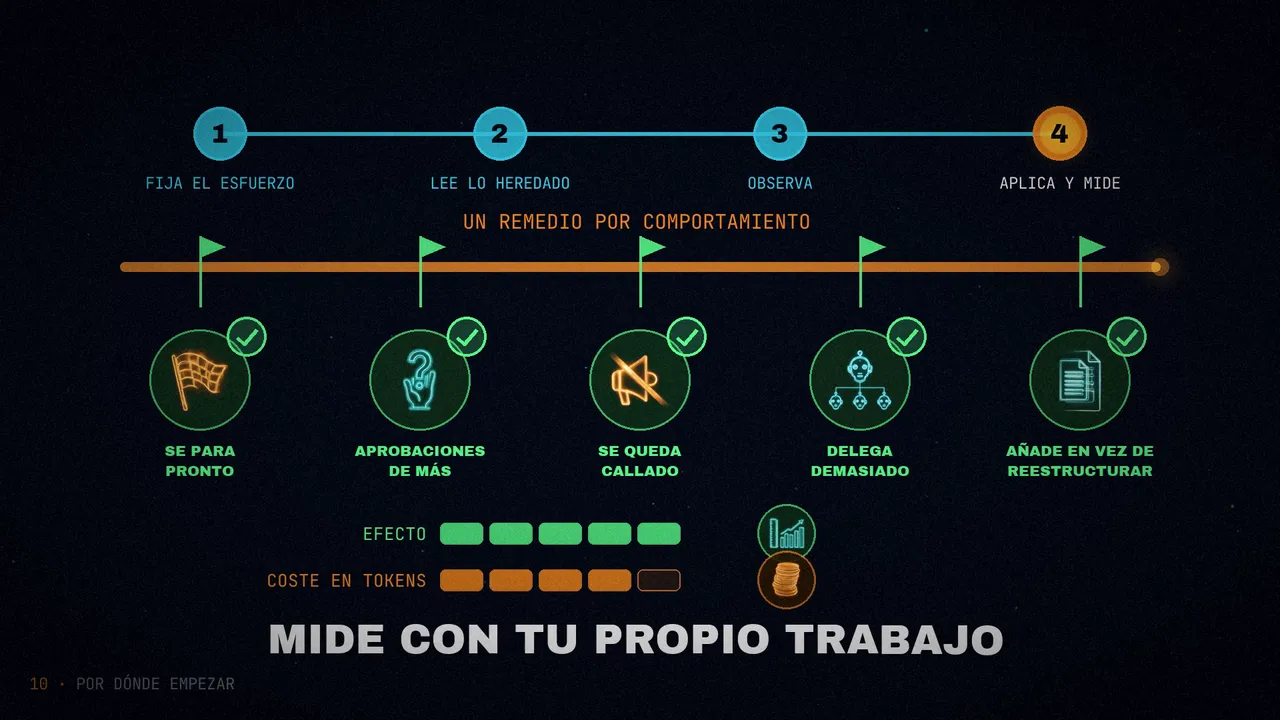
Para una migración, la guía da cuatro pasos:
- Fija
effortenhighde forma explícita y pasa tus evaluaciones también enmediumyxhigh. - Lee lo que heredas (prompts de sistema, skills, archivos de agente, memorias, notas y texto del arnés) y quita o prueba lo de la sección anterior.
- Lanza tus tareas agénticas más largas y apunta dónde el modelo se para pronto, pide aprobaciones de más, se queda callado, delega de más o añade código donde querías que reestructurara.
- Aplica el remedio de cada comportamiento observado, de uno en uno, midiendo su efecto y su coste en tokens en tus propias tareas.
Cómo leer las cifras
Todas las cifras de este post vienen de la guía, y la guía las presenta como resultados de las pruebas internas de Anthropic, en sus tareas y con sus productos. Conviene leerlas con tres matices:
- Son aproximadas. La guía dice «about», «roughly», «under» y «more than»; no hay porcentajes exactos.
- Salen de tareas concretas: tareas pequeñas de programación, tareas simuladas o sesiones grabadas de un producto. No son una regla para cualquier caso.
- Miden una cosa, no «mejor código». La frase de dueño hace que el modelo unifique más código duplicado; también cambió comportamientos que ya existían. Y el texto de «Finishing work» redujo un tipo de parada, no todos.
La guía insiste en que cada texto es un punto de partida: adáptalo y mide su efecto y su coste en tus tareas.
En resumen
Con Claude Fable 5.2, ajusta el esfuerzo antes que el prompt. Dile cuándo no debe pararse y de quién es el código. Asegúrate de que tu cliente muestra sus avisos. Cuéntale lo que cuesta delegar. Y limpia las cautelas y las instrucciones que arrastras de modelos anteriores.
Este modelo sigue las instrucciones tan de cerca que lo que más conviene revisar es lo que ya le estabas diciendo.
¿Qué instrucción antigua de tu prompt vas a borrar primero?
Fuentes
- «Prompting Claude Fable 5.2», documentación de Anthropic.
- Sobre arneses de agentes en este blog: Ingeniería del arnés y La anatomía de un agente de IA.
- El vídeo, en mis canales: español e inglés.