Antes de mexer em qualquer coisa
Quase todas as dicas consistem em adicionar ou remover texto do prompt de sistema, da descrição de uma ferramenta ou das notas que o agente carrega. O guia pede para fazer isso só em conversas novas. O Claude Fable 5.2 conserva o raciocínio entre turnos, e a API verifica se o histórico não mudou (o prefix check). Se você retoma uma conversa salva depois de alterar system, tools ou uma mensagem anterior, a requisição pode falhar com um erro 400.
Para mudar instruções no meio da conversa, coloque-as no turno mais recente. Onde houver mensagens de sistema no meio da conversa, você também pode acrescentar uma no final.
Calibre o esforço
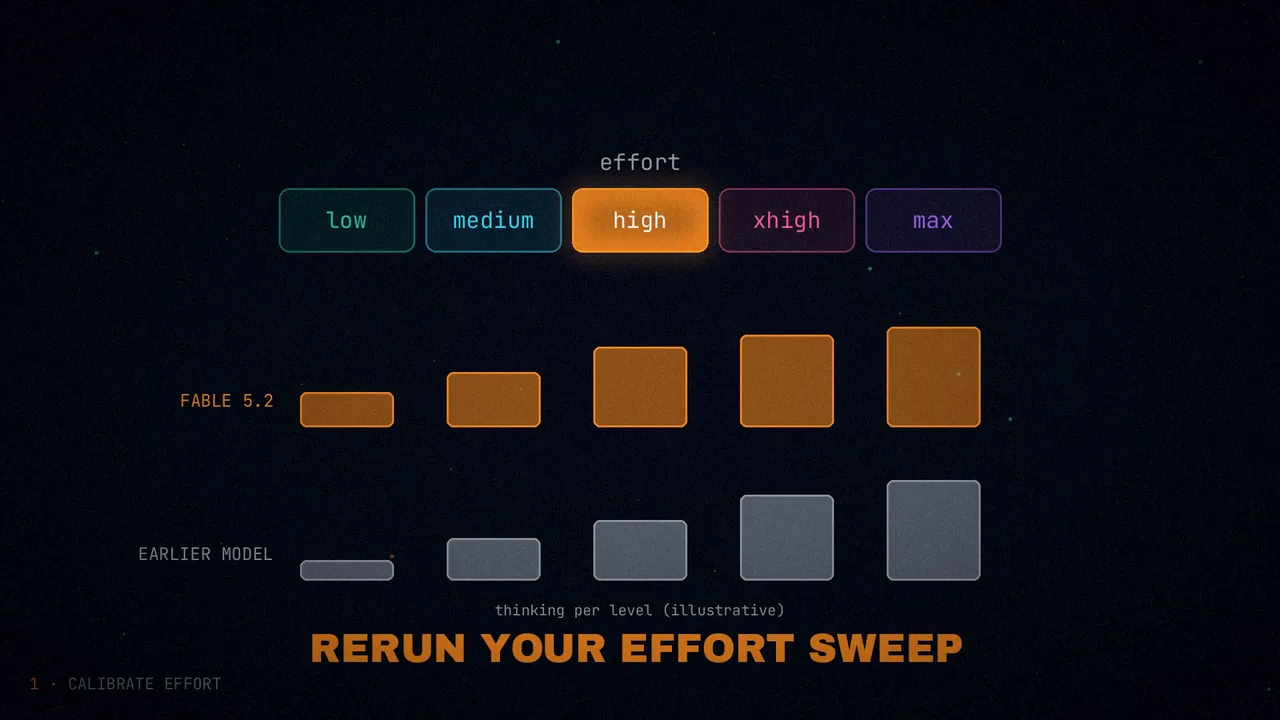
Neste modelo, o nível de effort define quanto ele pensa, quantas chamadas de ferramenta faz, quanto dura um turno e quantos tokens gasta. Por isso ele é ajustado junto com o prompt. O ponto de partida é high, o valor padrão na API do Claude.
Os níveis têm a mesma ordem em todos os modelos do Claude, mas a quantidade de pensamento de cada um muda. Na prática: refaça a sua varredura de esforço em vez de herdar o ajuste que você tinha com o Claude Fable 5.1 ou o Claude Opus 5.5.
| Nível | Para que serve | O que o guia diz |
|---|---|---|
low | Vai e vem rápido, tarefas bem especificadas e grandes volumes (subagentes rápidos) | Em avaliações de programação, rende mais do que os modelos anteriores nesse nível; nos testes da Anthropic ficou perto do que o Fable 5.1 conseguia com mais esforço |
medium | Programação interativa, chat e trabalho de conhecimento do dia a dia | |
high | Programação difícil, pesquisa, trabalho agêntico e execuções longas sem supervisão | Os turnos demoram bem mais do que em medium |
xhigh | O mais difícil e longo, e só se você mediu um ganho | Nas avaliações internas de programação subiu um pouco as notas e gastou muito mais tokens |
max | Medir o teto do modelo, ou problemas abertos (descoberta científica, matemática) em que tempo e tokens não importam | Turnos lentos e muito mais tokens do que em xhigh |
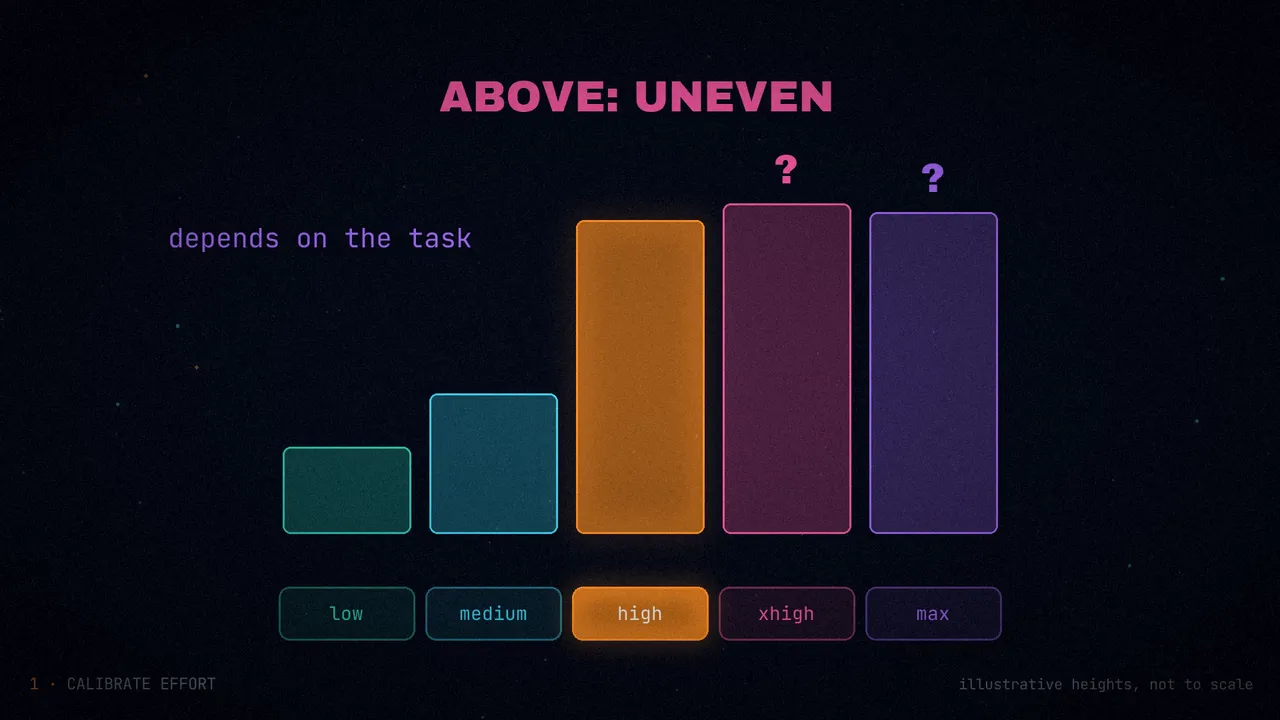
Quase todo o ganho chega em high. O passo de medium para high subiu as notas na maioria das avaliações de programação e de trabalho de conhecimento que a Anthropic acompanha, mas custa mais tokens e mais tempo: desça para medium onde as suas próprias avaliações aguentarem. Acima de high, as melhoras são irregulares e dependem da tarefa. O guia não dá números para nenhum desses saltos.
Mais três detalhes:
- Ele pensa quase sempre. De
highpara cima, o modelo pensa antes de quase todas as respostas, até diante de uma saudação. Se os pedidos básicos demoram ou custam mais, use menos esforço nesses turnos. Pedir que responda direto, sem deliberar, não o impediu de pensar demediumem diante. - Não muda o tamanho. O esforço quase não afeta o comprimento das respostas. Tamanho e tom se mudam com o prompt.
- Dá para misturar. Por exemplo, planejar e iterar em
mediume subir para a parte longa e sem supervisão. Para mudar dentro de uma conversa sem perder o cache existe o esforço por mensagem (beta). Onde não houver, você define outroeffortna requisição seguinte, o que pode invalidar as mensagens em cache.
Se você faz trabalho agêntico em low ou medium, adicione o texto da próxima seção: com pouco esforço, o modelo para antes.
Termine a tarefa inteira
Em tarefas longas, de muitos passos, o Claude Fable 5.2 às vezes termina o turno antes de acabar o trabalho. Ele faz isso listando o que falta, oferecendo-se para continuar ou parando diante de um obstáculo comum, como um tempo de espera esgotado. Acontece mais em low e medium. Se você vê isso no seu agente, o guia propõe adicionar este texto ao prompt de sistema:
# Finishing work
Please avoid stopping while you still owe work the user asked for. Be persistent and do not stop unless needed.

While status notes are welcome, as is clarifying with the user on open decisions, carry on with work that does not depend on the user's answer without unnecessary stops.

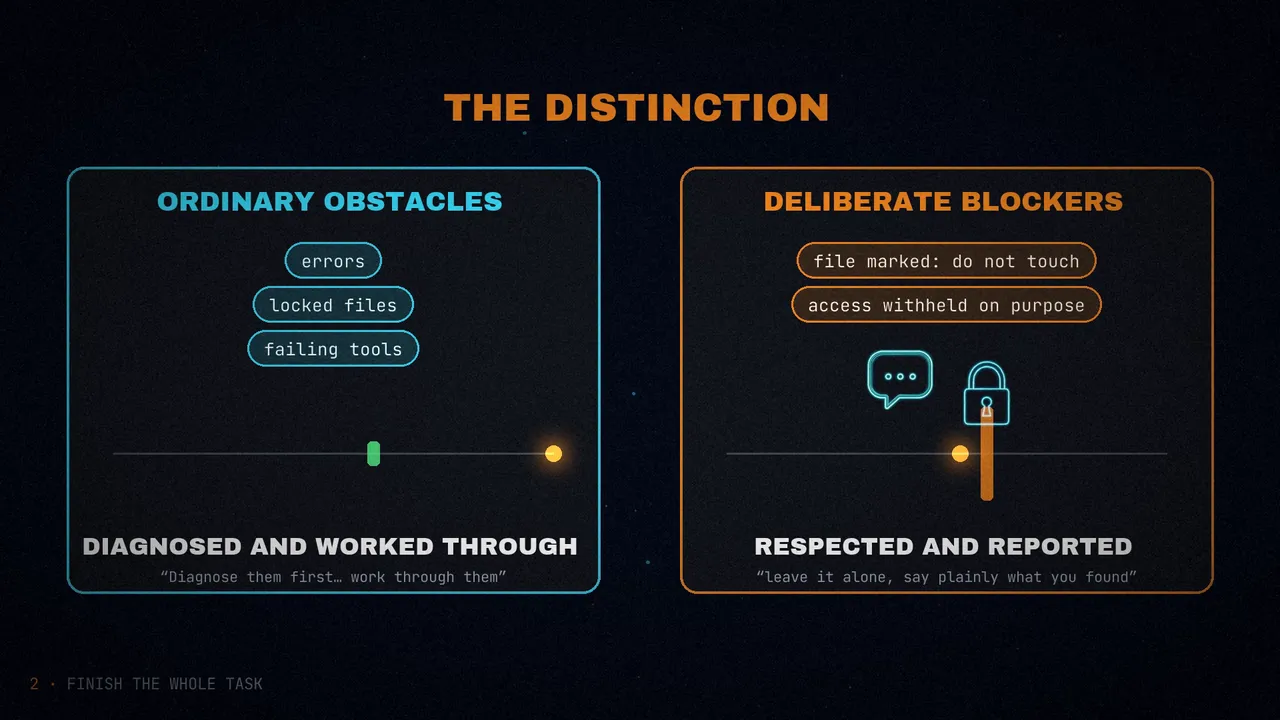
If you notice yourself inviting the user to redirect you or offering to wait, instead proceed on the next part of the task. You may meet ordinary obstacles like errors, timeouts, locked files, empty results or failing tools. Diagnose them first, and when they are not real blockers, work through them with the access you have (wait and retry, fix the request, use another tool or source) rather than stopping unnecessarily.

If someone clearly decided something is a hard blocker, such as a file marked not to be touched, access that was intentionally withheld, or a safety guardrail, leave it alone, say plainly what you found, and look for another safe way to finish the task. Stopping before the task is complete is very rarely merited, as in when the task can't move forward without user input, or where the blocker is deliberate and should not be worked past. This does not override the need for confirmation on risky or destructive actions.
O texto separa duas coisas. Os obstáculos comuns (erros, tempos esgotados, arquivos bloqueados, ferramentas que falham) são diagnosticados e superados. Os bloqueios deliberados (um arquivo marcado para não ser tocado, um acesso retirado de propósito, uma barreira de segurança) ficam como estão e são comunicados. É um ponto de partida, para adaptar ao seu caso.
A Anthropic testou reproduzindo sessões gravadas de um produto de programação agêntica, em medium. Com uma versão desse texto:
- Caíram mais ou menos pela metade as sessões que acabavam com trabalho pendente que poderia ter continuado.
- Sumiram quase todos os finais que pedem permissão ou se oferecem para seguir. Não os que listam o que falta e param.
- Os tokens de saída subiram cerca de 30%.
Como com esse texto o modelo pergunta menos, mantenha o seu próprio passo de confirmação para as ações arriscadas ou irreversíveis.
Aprovações
Duas dicas. A primeira: quando você disser para ele seguir, diga exatamente o que quer, em vez de um simples «continue». O exemplo do guia é responder «Yes, run the migration on the staging database» onde você teria mandado um «go» ou um joinha.
A segunda: se você escreve regras de aprovação no prompt de sistema, seja específico sobre as ações que quer que ele consulte. Em testes com tarefas simuladas em que não havia ninguém para aprovar, uma regra que incluía «sending messages to people outside this conversation» entre os passos que exigem aprovação fez o modelo segurar cerca de metade dos seus pedidos rotineiros a colegas e a outras equipes.
Diga de quem é o código
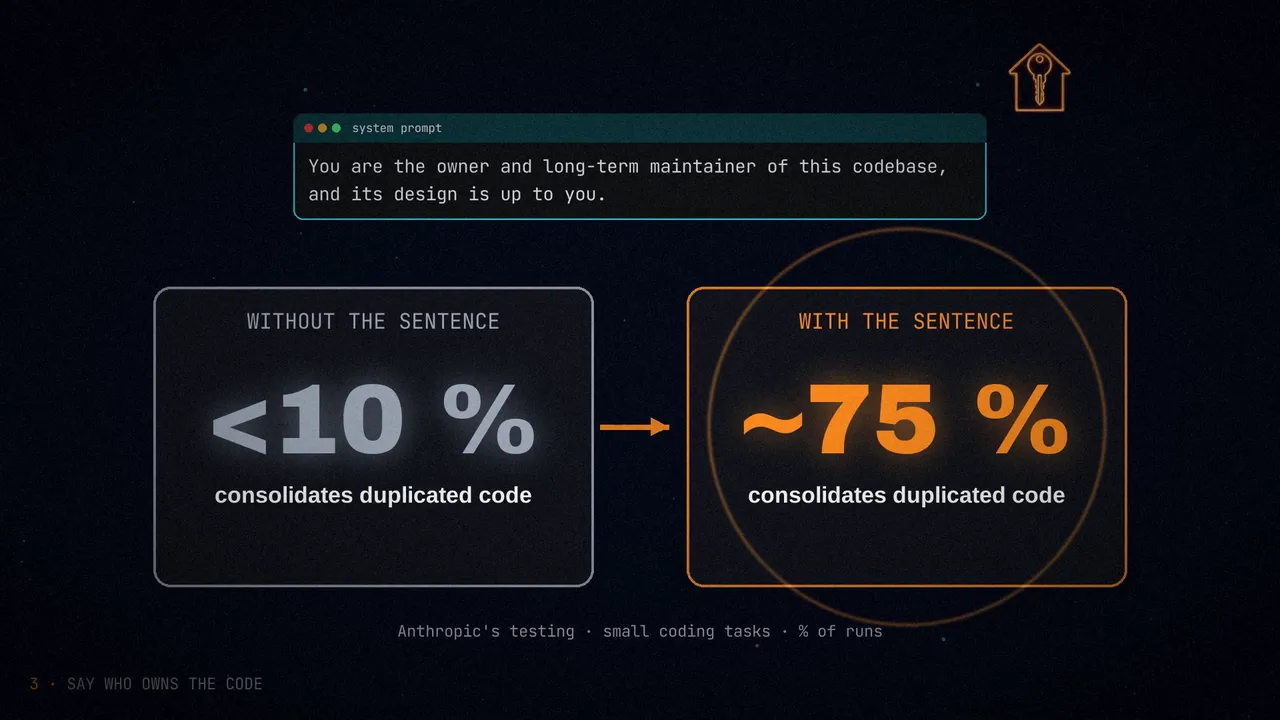
O Claude Fable 5.2 presta muita atenção em de quem é o código em que trabalha. Em testes com tarefas pequenas de programação, quando o prompt não dizia nada sobre a propriedade, ou apresentava o repositório como de outra pessoa, o modelo tendia a acrescentar sobre a estrutura existente, mesmo que isso duplicasse código. Quando o prompt dizia que o código era dele, muitas vezes ele unificava os duplicados e às vezes fazia correções relacionadas sem ninguém pedir.
Se você quer que ele melhore a estrutura enquanto trabalha, o guia propõe uma frase:
You are the owner and long-term maintainer of this codebase, and its design is up to you.Sem a frase, o modelo unificou o código duplicado em menos de 10% das execuções. Com ela, em cerca de 75%.
Tem um preço:
- Tokens: os de saída subiram entre 70 e 80%.
- Mudanças não pedidas: muitas delas, testes e documentação novos. Em algumas execuções ele também mudou o comportamento de uma função que já existia.
- Resumo incompleto: o resumo final do PR costumava deixar de fora mudanças pequenas. Revise o diff além do resumo.
Não use a frase quando o código é do usuário e ele quer que se mexa o mínimo. E uma regra que limita o escopo não a anula: com «No drive-by refactors, renames or cleanups» escrito antes no mesmo prompt, o modelo continuou unificando duplicados em mais da metade das execuções.
Mantenha o usuário informado
Durante sequências longas de chamadas de ferramenta, o modelo às vezes escreve pouco texto para o usuário, e pode fazer a primeira chamada sem dizer o que vai fazer. Antes de mexer no prompt, verifique se o seu cliente recebe o que o modelo de fato escreve.
No Claude Fable 5.2, os avisos que o modelo escreve entre uma ferramenta e outra chegam como blocos thinking de progresso: contam o que ele encontrou e o que fará depois. Com o valor padrão de thinking.display, "omitted", o texto chega vazio, então um cliente que só renderiza os blocos text parece mudo durante um turno longo. Com display: "updates" (beta) você recebe um resumo curto de cada aviso, e com "summarized", os avisos junto com o raciocínio resumido. Depois é preciso mostrar, entre as chamadas, os blocos thinking que trouxerem texto.
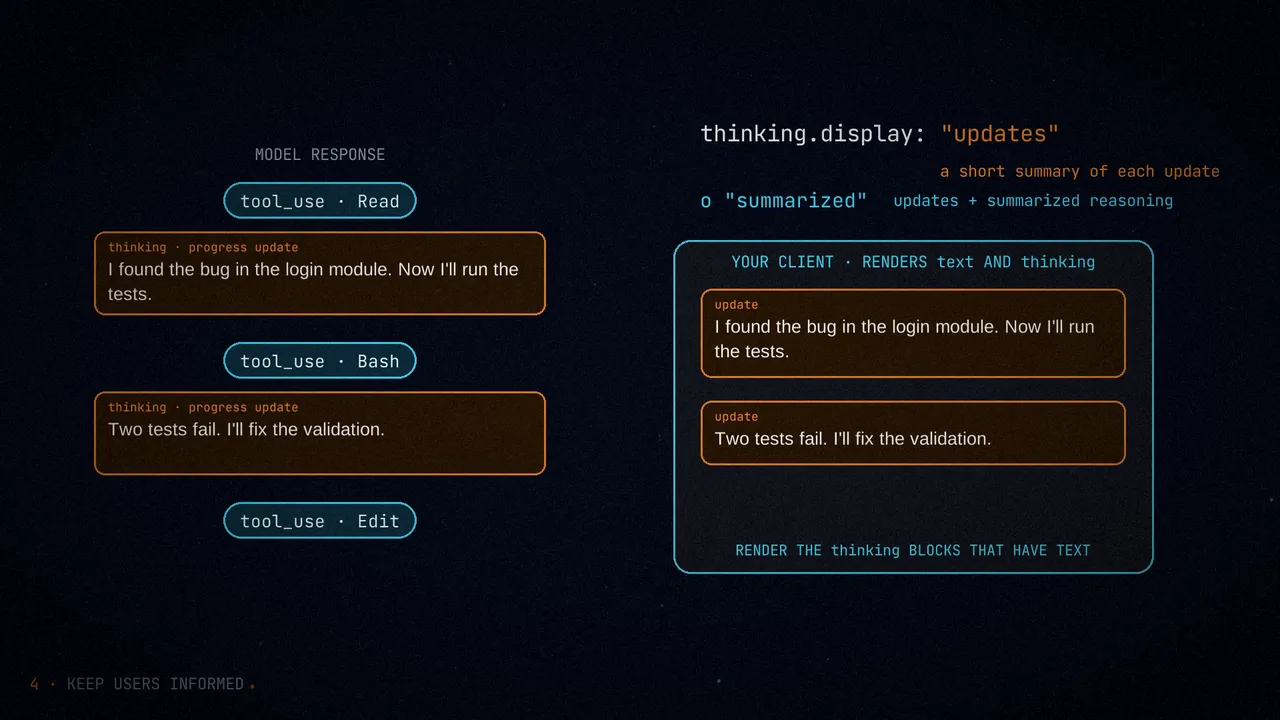
display: "omitted", os avisos chegam vazios e o cliente parece mudo.Para os usos interativos, o guia dá três alavancas.
1. No harness. Conte os passos seguidos de ferramentas que não dão ao usuário nada para ler (com display em "updates" ou "summarized", porque em "omitted" todos os blocos vêm vazios). Quando vários se acumularem, acrescente este lembrete depois dos últimos resultados, como mensagem de sistema válida só para aquele turno (clear_at: "next_user_message", beta):
The user hasn't heard from you in a while: say in a few words what you're doing, then continue.Em tarefas de programação de vários turnos, o lembrete reduziu mais ou menos pela metade o trecho de silêncio mais longo, sem aumento perceptível de tokens nem de tempo. Deixe cada lembrete em messages nas requisições seguintes: removê-lo ou alterá-lo edita um turno anterior e invalida os blocos de pensamento que vêm depois.
2. No prompt de sistema, a intenção. Para ter uma linha antes da primeira chamada, avisos breves e um resumo final:
Before you start, say in a line what you're about to do; brief updates while you work help the user follow along. Close with a short recap that stands on its own (what you found, what you did, and what's next), so a reader who only sees the last message has the full picture.Com esse texto, o modelo escreveu uma mensagem antes da primeira chamada em todas as execuções das tarefas de programação. Os tokens de saída por tarefa subiram cerca de 20%. Use onde houver uma pessoa acompanhando e, se quiser mais avisos, junto com o lembrete.
3. Se você não pode mexer no harness, ou a sua plataforma não tem mensagens de sistema no meio da conversa, uma frase no prompt de sistema:
Every few tool calls, give the user a one-line update on where things stand.Essa frase cortou a maioria dos silêncios longos em tarefas de automação de fluxos. Mesmo combinando as três, espere sequências de várias chamadas entre um aviso e outro. O guia acrescenta que o modelo trabalha bem em tarefas assíncronas e longas, e o recomenda para o trabalho em que ninguém precisa de avisos frequentes.
Subagentes
Quanto o Claude Fable 5.2 delega depende do seu harness e das suas tarefas. Em tarefas curtas, com uma ferramenta de subagentes mínima, ele quase nunca lançou um. Em um produto de programação cujos prompts convidam a delegar, delegou com facilidade. E em xhigh e max, a Anthropic o viu usar subagentes para revisar o próprio trabalho, algo que o Fable 5.1 não fazia nas mesmas tarefas.
Os primeiros testadores tiveram bons resultados usando-o como planejador e orquestrador de outros modelos. Delegar acelera o trabalho que pode ser feito em paralelo, mas os subagentes podem representar uma grande parte do custo de uma sessão: verifique qual modelo eles usam por padrão.
Mude a descrição da ferramenta de subagentes só se o modelo lançar mais do que as suas tarefas precisam. Antes, veja se o seu prompt de sistema, as suas skills ou os seus arquivos de agente mandam delegar. A nova descrição deve dizer três coisas:
- O que um subagente acrescenta ao custo da sessão.
- Quando vale a pena delegar e quando não.
- Como passar a tarefa ao subagente que ele lançar.
Se mesmo assim ele delegar demais, fale mais sobre o custo e teste a mudança. Nos testes da Anthropic em high, uma descrição mais longa focada no custo reduziu os subagentes mais ou menos pela metade em relação a uma versão mais curta.
Não deixe a cautela se acumular
As instruções cautelosas vão se acumulando de sessões passadas, pela memória, pelas notas e pelos arquivos de instruções. Como o Claude Fable 5.2 as segue ao pé da letra, pode acabar pedindo aprovações desnecessárias. A Anthropic viu isso principalmente quando vários agentes trabalhavam juntos. Os remédios:
- Apague as notas de que você não precisa mais. A memória pode guardar instruções antigas, como «never retry», que o modelo continua obedecendo.
- Nomeie os passos que não exigem aprovação. Dizer para ele agir com mais liberdade é vago demais: liste os passos rotineiros que ele pode dar sozinho.
- Revise as suas validações. Uma condição como «stop and review at the first error» pode bloquear o trabalho autônomo. Remova ou restrinja as que não forem necessárias.
- Seja explícito com as exceções. O modelo trata uma instrução com «never» como absoluta. Se você quer que ele continue podendo fazer aquela ação, escreva «ask for approval before deleting files» em vez de «never delete files».
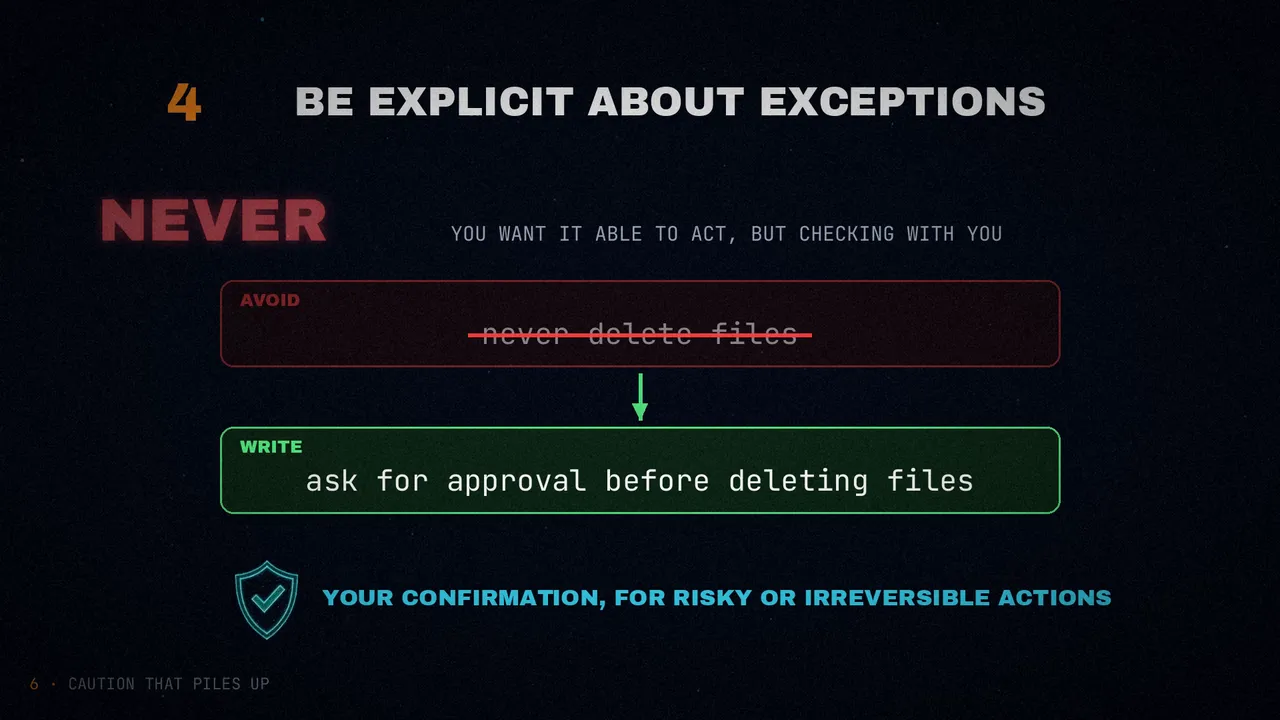
E, de novo, mantenha o seu próprio passo de confirmação para o que for arriscado ou irreversível.
O que você herda de modelos anteriores
Ao migrar, revise os seus prompts e o seu harness. Nos testes da Anthropic, algumas instruções e intervenções pensadas para modelos anteriores aumentavam o custo, causavam efeitos colaterais ou já não faziam nada. O guia lista sete:
- Instruções permanentes de delegar. Podem estar em prompts de sistema, skills e arquivos de agente. Leia-os antes de migrar e remova as que sobram se o modelo delegar demais.
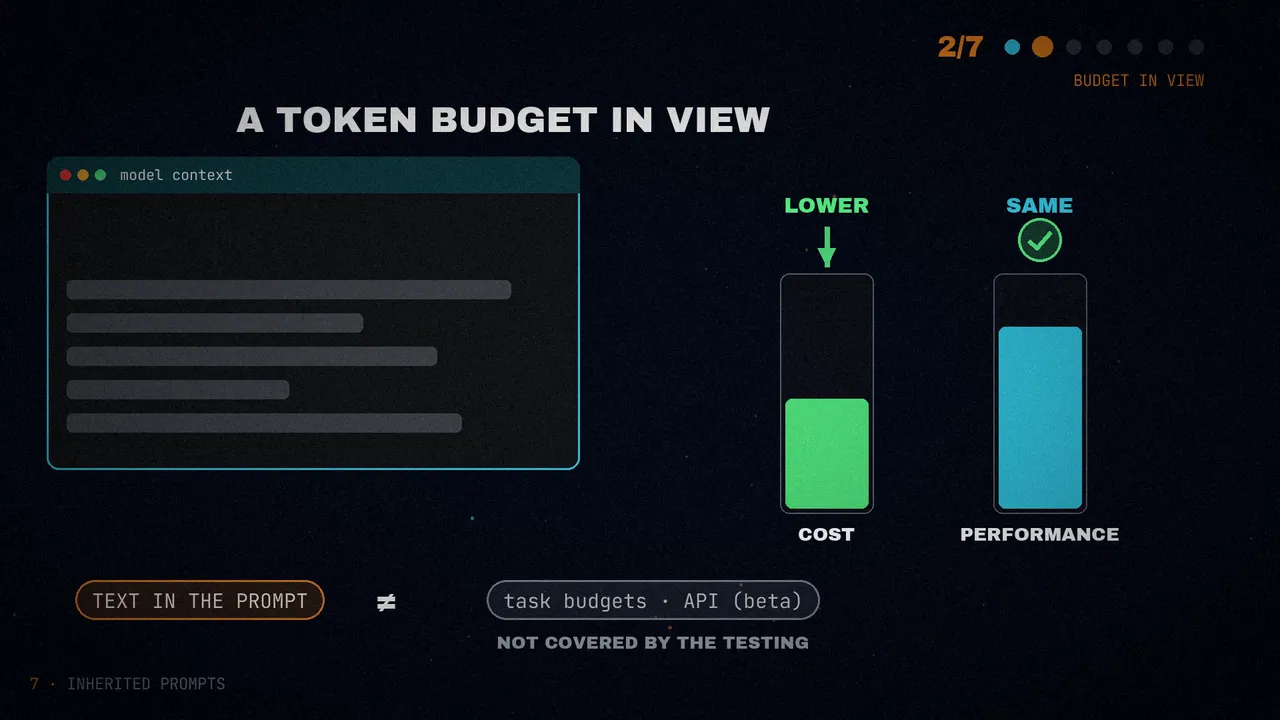
- Um orçamento de tokens à vista do modelo. Alguns harnesses mostram quanto ele tem para a tarefa e quanto resta, e o tamanho desse número muda quanto ele gasta. Em tarefas de programação em
highexhigh, remover um orçamento grande baixou o custo com desempenho equivalente. Isso vale para o texto no prompt, não para os task budgets da API, que esses testes não cobriram. - Código do harness que edita turnos anteriores. Como o modelo conserva o pensamento, se o harness muda o prompt de sistema, as ferramentas ou uma mensagem anterior, os blocos de pensamento posteriores deixam de valer: a API de mensagens rejeita a requisição e a de lotes descarta esses blocos. Para encurtar o histórico, use a edição de contexto ou uma compactação que não deixe turnos anteriores depois do resumo. No mais, que o histórico só cresça pelo final: o cache acerta mais e nenhum pensamento é descartado. Existe
prefix_mismatch_behavior: "drop_block"(beta) para descartar em vez de falhar, mas quando nos testes o pensamento era descartado a cada turno, o modelo voltava a pensar e gastava mais tokens de saída. Meça antes de confiar. - As frases «dê essa resposta por encerrada». O guia do Opus 5.5 oferece duas frases para chats que pedem para tratar a resposta anterior como concluída e focar na mensagem nova. Em
high, elas reduziram o pensamento nas perguntas de acompanhamento, mas o modelo ficou muito menos propenso a apontar erros nas respostas anteriores. Não as use onde você quer que ele se revise. - Instruções de pensar menos. O Fable 5.1 costumava obedecer a um «answer directly without deliberating». O Fable 5.2 não, de
mediumem diante: remova a linha e baixe o esforço. - Regras de estilo. Ele as segue tão de perto que um limite rígido, como «one instruction per sentence, in 20 words or fewer», deixa a prosa truncada.
- Regras, notas e memórias acumuladas. Algumas terão sido escritas pelo próprio modelo. Apague as cautelas cuja razão já não vale e reescreva as absolutas com o seu escopo e o seu motivo. Se um sistema já está travado, considere reiniciá-lo com a memória e as notas enxutas.
Relatórios fáceis de acompanhar
Os primeiros testadores avaliaram a escrita do Claude Fable 5.2 acima da do Fable 5.1 e parecida em clareza com a do Opus 5.5. Mas depois de um trabalho agêntico longo, quem lê o relatório final normalmente não viu as chamadas de ferramenta nem os arquivos por trás dele, então o relatório precisa se sustentar sozinho. Se você pede relatórios finais ou passagens de bastão, o guia propõe este texto de sistema, adaptado aos seus leitores:
# Communicating clearly
Write for an intelligent but low-context reader. The person reading has not seen your tool calls, your reasoning or the files you opened, and may be switching in from other work. Messages should generally be self-contained: the reader should understand what you mean without having to dig for other context. Put the key points in the first few sentences. Practice progressive disclosure in your sentence order, and do not use undefined references and ideas in line 1 that won't make sense until the reader reaches line 12.

Use plain words, and write in clear, understandable full sentences. Do not use a term or abbreviation that you made up during the work. Say what the thing is in a way any reader would understand. Write mostly in the style of ASD-STE100 Simplified Technical English: short sentences, one idea per sentence, active voice, and consistently using the same word for the same thing. Use a paragraph of flowing prose where ideas connect, and keep bullets for lists of separate items. Leave out unnecessary details unless the reader asks and practice concision, but do ensure that your messages have the key context. Aim to make your user-facing text as human-readable and clear as possible.
Nos testes com tarefas agênticas, o texto deixou os relatórios menos densos e com menos ponto e vírgula, e em tarefas de automação encurtou as frases. Dependendo do seu caso, talvez você queira acrescentar instruções sobre o tamanho ou pedir detalhes específicos.
Recusas de salvaguarda
O Claude Fable 5.2 roda com classificadores de segurança que podem recusar um pedido. A resposta chega com stop_reason: "refusal", e stop_details.category nomeia a categoria:
| Categoria | O que significa |
|---|---|
cyber | O pedido poderia facilitar um dano cibernético, como malware ou desenvolvimento de exploits |
bio | Poderia facilitar um dano biológico, como métodos de laboratório perigosos |
frontier_llm | Poderia ajudar no desenvolvimento de modelos de IA concorrentes |
reasoning_extraction | Pede que o modelo reproduza o raciocínio interno no texto da resposta |
general_harms | Cai em outra área da política de uso |
null | A recusa não corresponde a nenhuma categoria com nome |
O trabalho legítimo de cibersegurança e de ciências da vida também pode acionar os classificadores cyber e bio. Se isso bloqueia a sua organização, a Anthropic tem dois programas de verificação (Cyber Verification Program e Life Sciences Verification Program). O Claude Mythos 5.2 oferece as mesmas capacidades do Fable 5.2 só para as organizações verificadas.
Uma consequência prática: se os seus prompts, skills ou descrições de ferramentas pedem que o modelo escreva o raciocínio na resposta, remova essas instruções. Para ver como ele raciocinou, use display: "summarized" e leia os blocos de pensamento.
Por onde começar
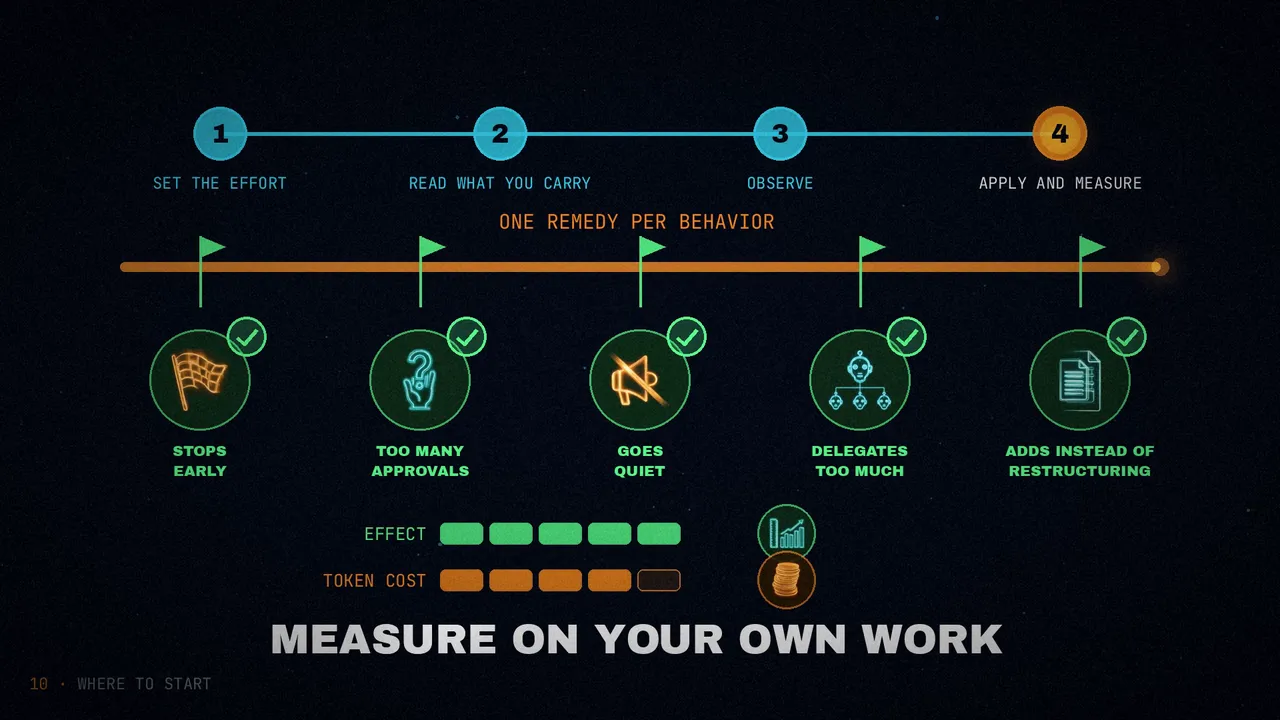
Para uma migração, o guia dá quatro passos:
- Fixe
effortemhighde forma explícita e rode as suas avaliações também emmediumexhigh. - Leia o que você herda (prompts de sistema, skills, arquivos de agente, memórias, notas e texto do harness) e remova ou teste o que a seção anterior descreve.
- Rode as suas tarefas agênticas mais longas e anote onde o modelo para cedo, pede aprovações demais, fica calado, delega demais ou acrescenta código onde você queria que ele reestruturasse.
- Aplique o remédio de cada comportamento observado, um de cada vez, medindo o efeito e o custo em tokens nas suas próprias tarefas.
Como ler os números
Todos os números deste post vêm do guia, e o guia os apresenta como resultados dos testes internos da Anthropic, nas tarefas dela e com os produtos dela. Vale lê-los com três ressalvas:
- São aproximados. O guia diz «about», «roughly», «under» e «more than»; não há porcentagens exatas.
- Vêm de tarefas específicas: tarefas pequenas de programação, tarefas simuladas ou sessões gravadas de um produto. Não são uma regra para qualquer caso.
- Medem uma coisa, não «código melhor». A frase de dono faz o modelo unificar mais código duplicado; ela também mudou comportamentos que já existiam. E o texto «Finishing work» reduziu um tipo de parada, não todos.
O guia insiste que cada texto é um ponto de partida: adapte-o e meça o efeito e o custo nas suas tarefas.
Em resumo
Com o Claude Fable 5.2, ajuste o esforço antes do prompt. Diga quando ele não deve parar e de quem é o código. Garanta que o seu cliente mostra os avisos dele. Conte quanto custa delegar. E limpe as cautelas e as instruções que você carrega de modelos anteriores.
Este modelo segue as instruções tão de perto que o que mais vale revisar é o que você já estava dizendo a ele.
Qual instrução antiga do seu prompt você vai apagar primeiro?
Fontes
- «Prompting Claude Fable 5.2», documentação da Anthropic.
- Sobre arneses de agentes neste blog: Engenharia do arnês e A anatomia de um agente de IA.
- O vídeo, nos meus canais: inglês e espanhol.