Quando o RAG não basta
O assistente da Mintlify funcionava com RAG, a geração aumentada por recuperação: buscava os trechos de texto mais parecidos com a pergunta e respondia com eles. O artigo começa com uma frase que resume tudo: o RAG funciona muito bem… até que deixa de funcionar.
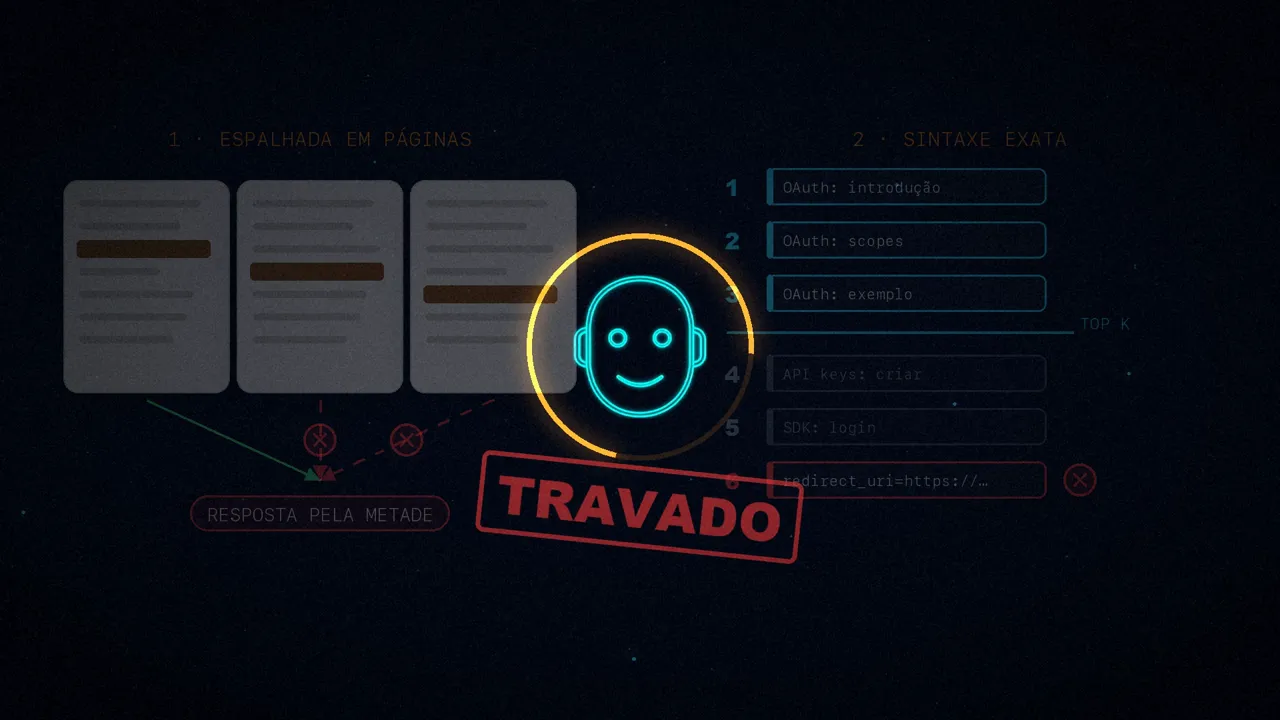
Ele falha em dois casos. Quando a resposta está espalhada por várias páginas. E quando o usuário precisa da sintaxe exata de alguma coisa, e esse trecho não aparece entre os primeiros resultados da busca (o famoso top-K). Nos dois, o assistente travava.
A documentação como repositório
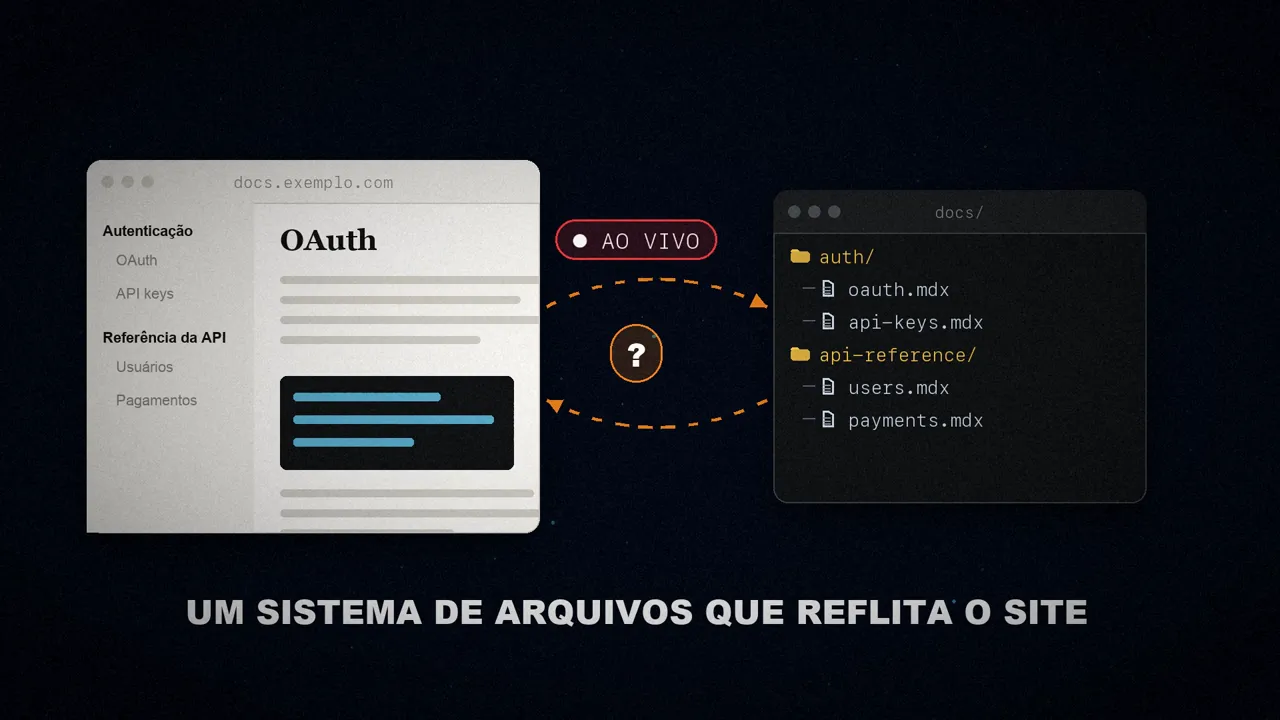
Eles queriam que o assistente navegasse pela documentação como um agente navega por um repositório de código. E os agentes já têm uma interface favorita para isso: o sistema de arquivos. Segundo o artigo, eles estão convergindo para ele porque grep, cat, ls e find são tudo de que um agente precisa.
A ideia é simples: cada página da documentação é um arquivo, e cada seção, uma pasta. Assim o agente busca textos exatos, lê páginas inteiras e percorre a estrutura por conta própria. Só faltava um sistema de arquivos que refletisse, ao vivo, o site da documentação.
O gargalo do contêiner
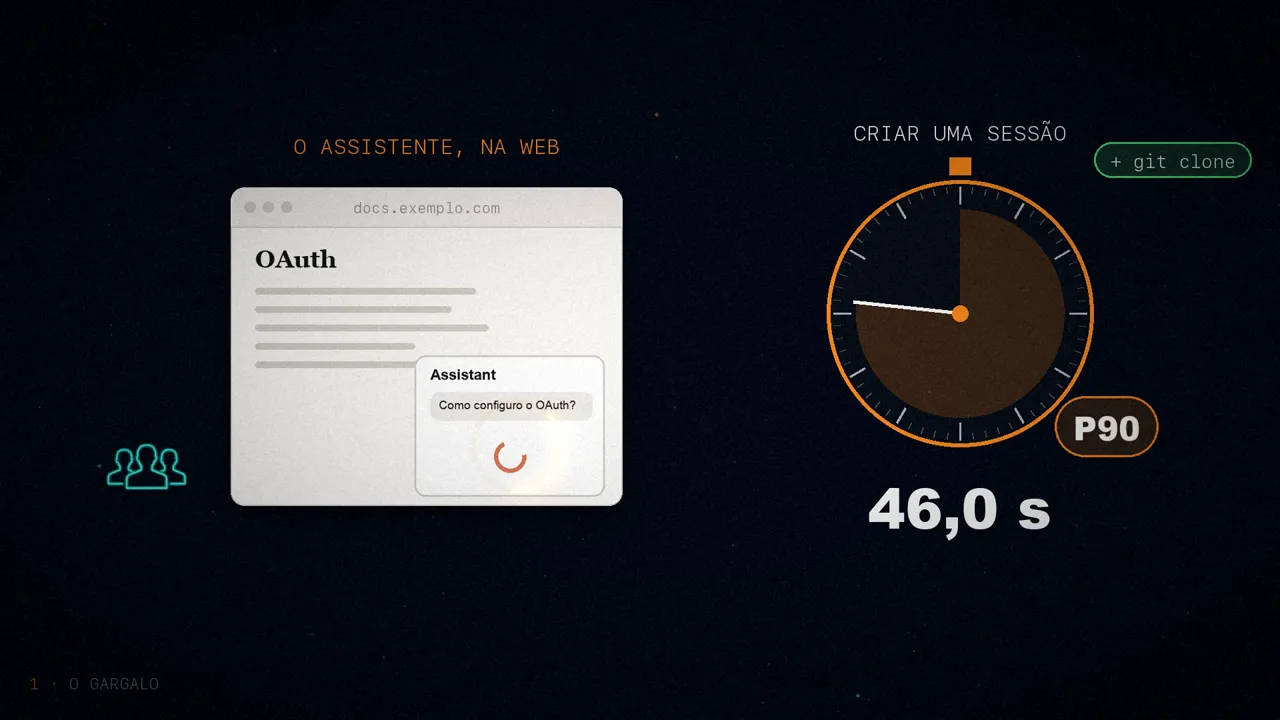
O óbvio é dar ao agente um sistema de arquivos de verdade. É o que quase todos os harnesses fazem: sobem um ambiente isolado, um sandbox, e clonam o repositório lá dentro. A Mintlify já faz isso nos seus agentes em segundo plano, onde a latência não importa. Mas este assistente vive na web, com um usuário olhando o ícone de carregamento girar.
Criar cada sessão, com o clone do GitHub incluído, levava uns 46 segundos no percentil 90. Ou seja, nove em cada dez sessões levavam menos, mas o resto, ainda mais: quase um minuto olhando uma rodinha, só para começar a ler a documentação.
E ainda tem a fatura. O artigo faz a conta: 850.000 conversas por mês, cada uma com a sua própria micro máquina virtual. Mesmo mínima (1 vCPU, 2 GiB de memória e 5 minutos de vida), com os preços por segundo da Daytona (US$ 0,0504/h por vCPU e US$ 0,0162/h por GiB), dá uns US$ 0,0069 por conversa: mais de US$ 70.000 por ano. Com sessões mais longas, o dobro: uns US$ 0,0137 por conversa, o número da tabela comparativa deles.
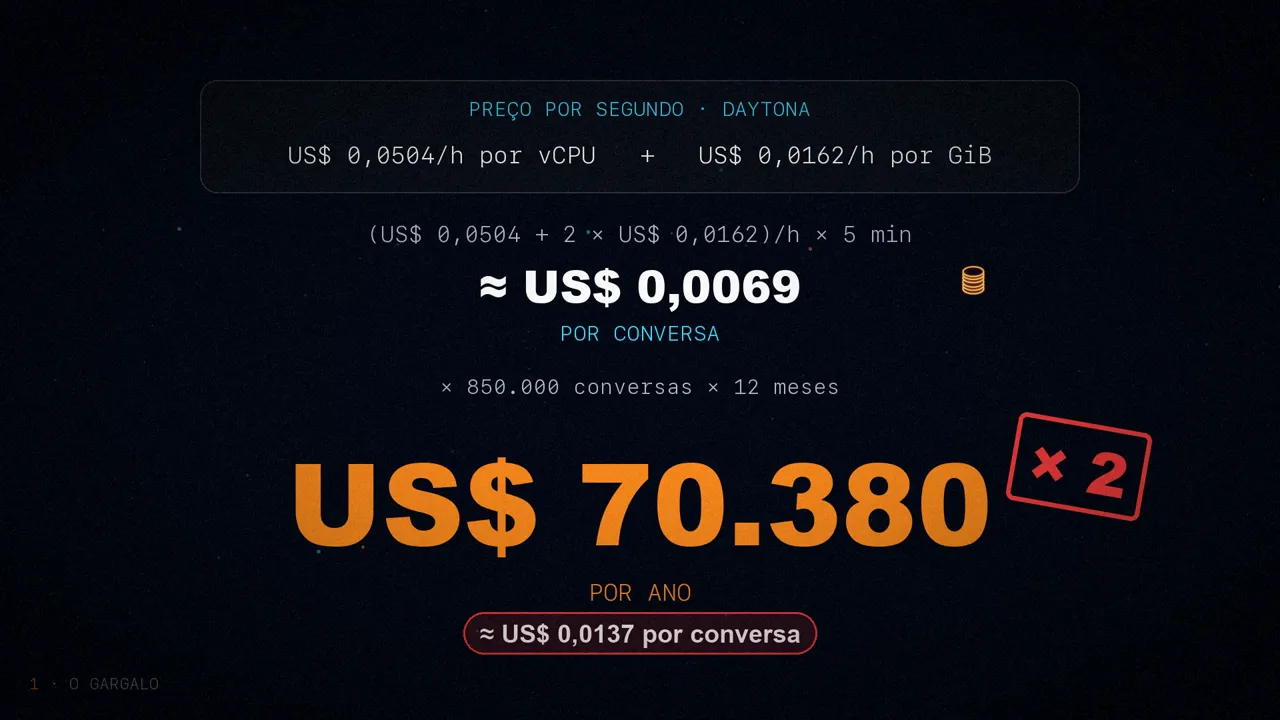
Eles mesmos admitem que é uma estimativa ingênua: em produção haveria máquinas pré-aquecidas e contêineres compartilhados. Mas a ideia se mantém. Para ler documentação estática, uma máquina por conversa é lento e caro. Eles precisavam de algo instantâneo e barato, e isso obrigava a repensar o próprio sistema de arquivos.
Fingindo um shell: o ChromaFs
A chave é esta: o agente não precisa de um sistema de arquivos de verdade, basta a ilusão de um. E a Mintlify já tinha toda a sua documentação dividida em trechos, indexada e guardada no Chroma, o banco de dados da sua busca.
Assim nasceu o ChromaFs: um sistema de arquivos virtual que intercepta os comandos de Unix que o agente escreve e os traduz em consultas a esse mesmo banco de dados. O agente acha que está lendo arquivos; na verdade, está perguntando ao Chroma.
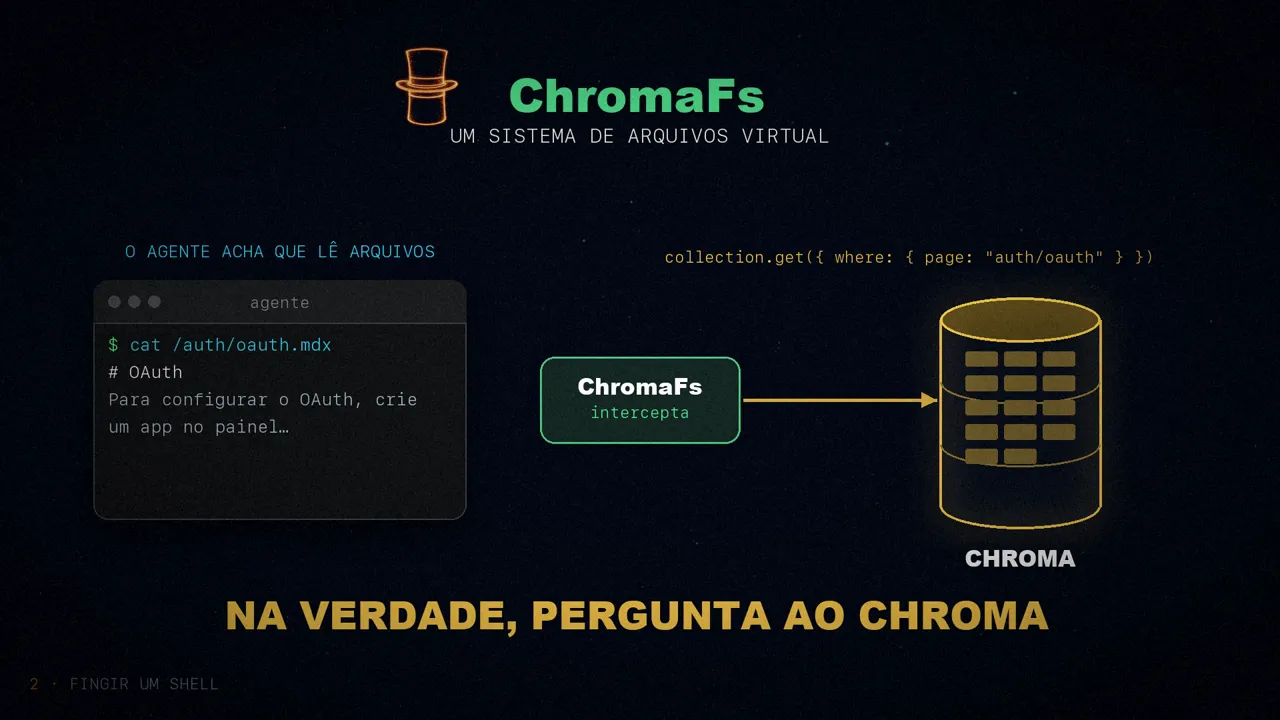
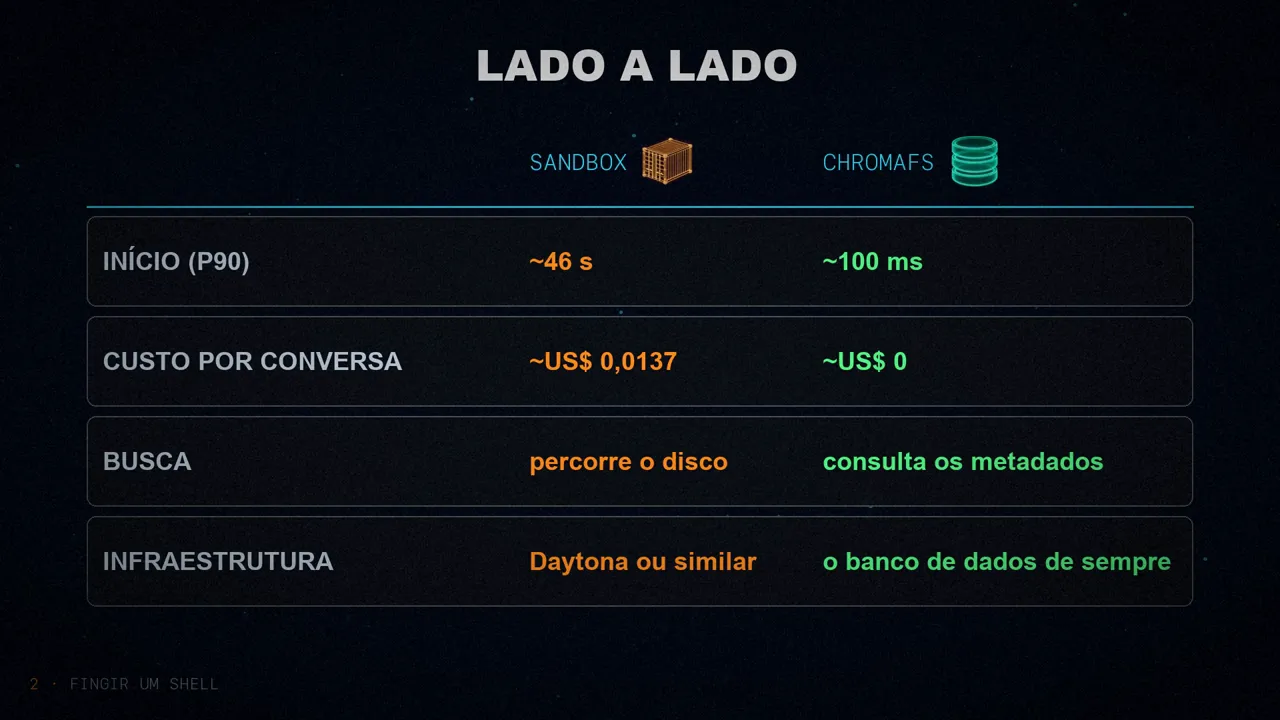
O resultado: criar uma sessão passou de uns 46 segundos para uns 100 milissegundos, umas 460 vezes mais rápido (essa conta é minha). E como reaproveita um banco de dados que eles já pagavam, cada conversa nova não acrescenta custo de computação. Lado a lado:
- Início (p90): ~46 s
- Custo: ~US$ 0,0137 por conversa
- Busca: percorre o disco arquivo por arquivo
- Infraestrutura: Daytona ou similar
- Início (p90): ~100 ms
- Custo: ~US$ 0, reaproveita o banco de dados
- Busca: uma consulta aos metadados
- Infraestrutura: o banco de dados que eles já tinham
just-bash e as camadas
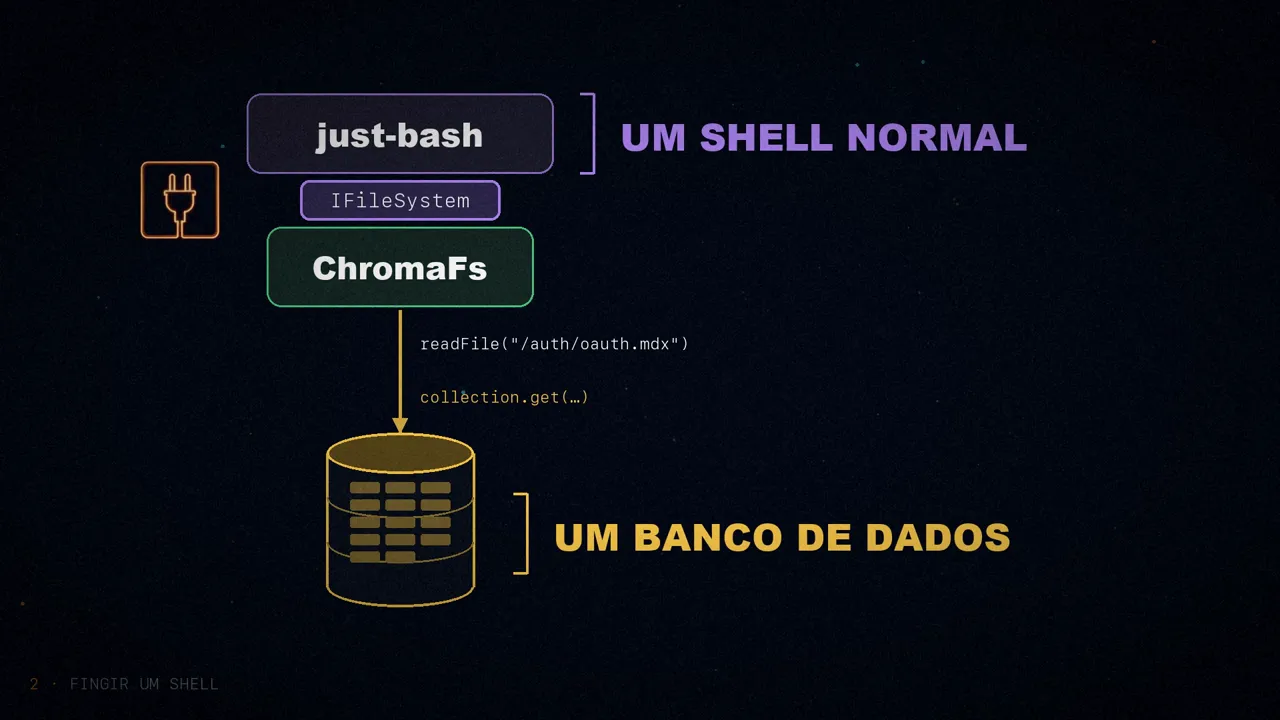
Por baixo, o ChromaFs se apoia no just-bash, da Vercel Labs: uma reimplementação do bash em TypeScript que entende grep, cat, ls, find e cd. Ele cuida de toda a parte difícil: interpretar os comandos, os pipes e as opções.
E o melhor: ele permite conectar o seu próprio sistema de arquivos por meio de uma interface, IFileSystem. O ChromaFs a implementa, e cada chamada ao disco vira uma consulta ao Chroma. Por cima, um shell normal; por baixo, um banco de dados. No código que o artigo mostra, readFile pede ao Chroma todos os trechos da página e os junta, e writeFile, appendFile, mkdir e rm lançam um erro de somente leitura.
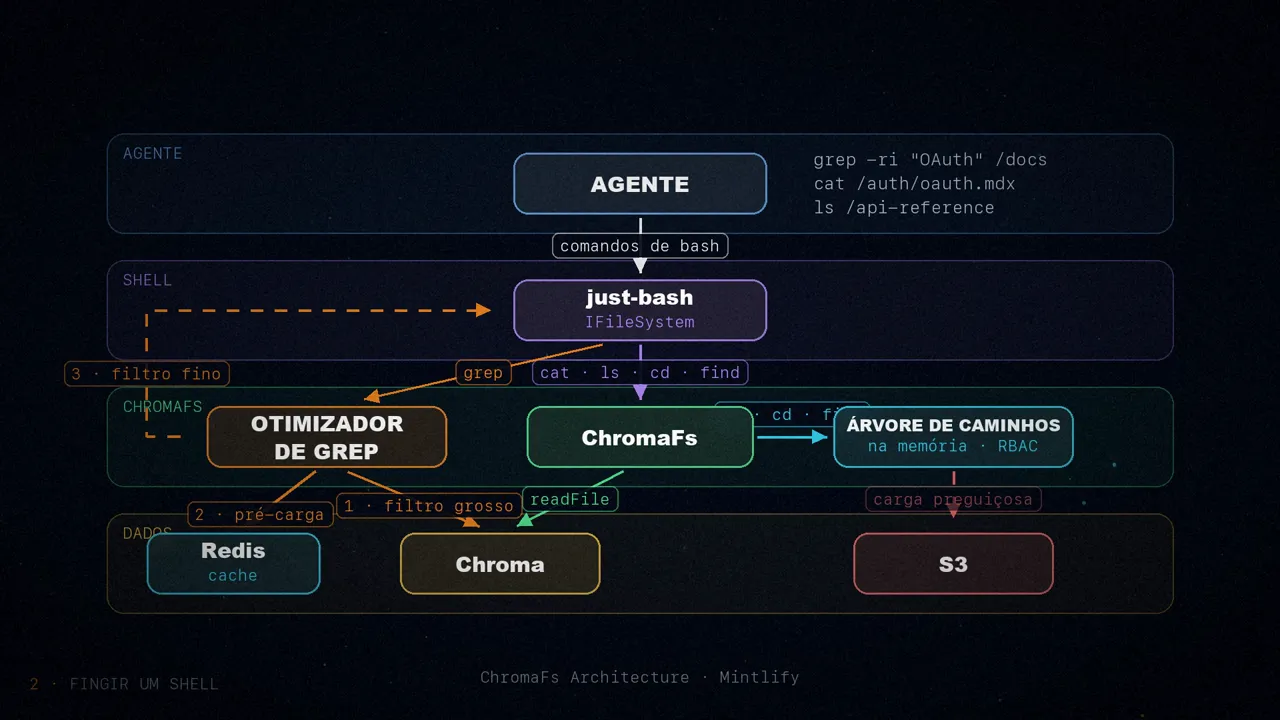
O diagrama do artigo resume isso em quatro camadas. Em cima, o agente escreve comandos de bash. Abaixo, o just-bash os interpreta. Depois, o ChromaFs os traduz. E no fundo ficam os dados: o Chroma, um cache no Redis e arquivos no S3.
A árvore de pastas
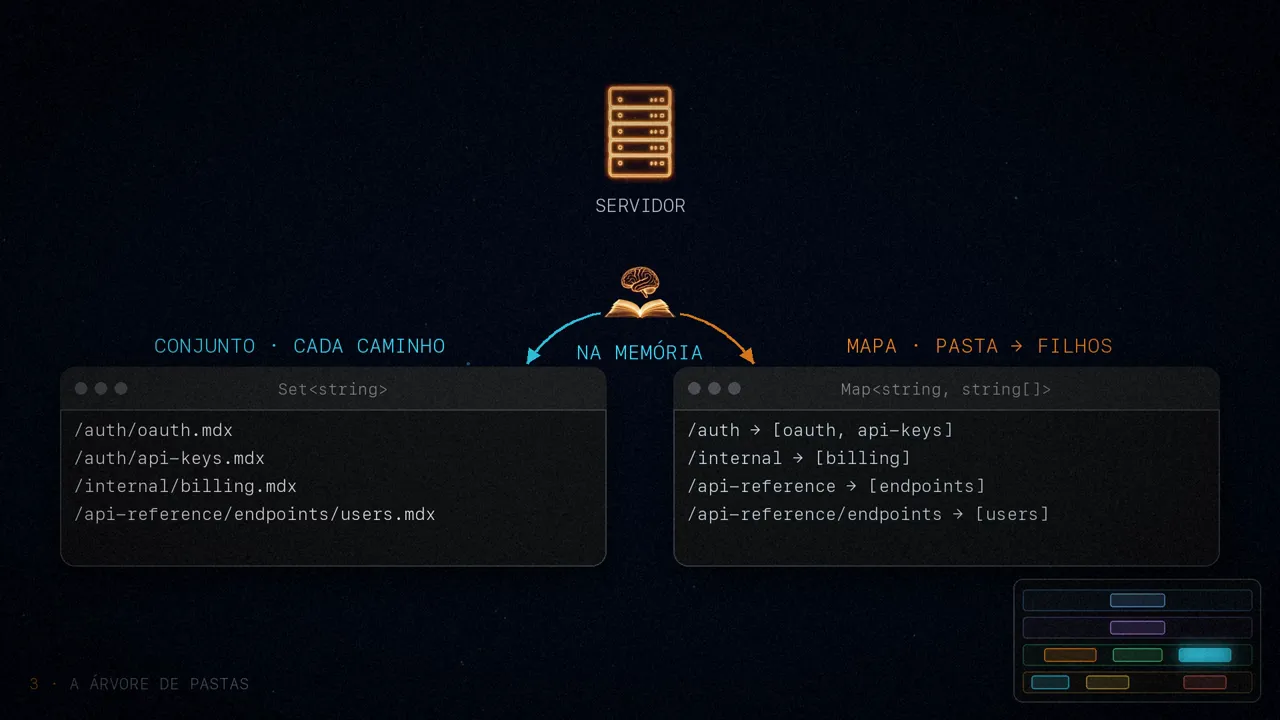
O ChromaFs precisa saber quais arquivos existem antes de o agente escrever um único comando. Por isso eles guardam a árvore inteira como um único documento JSON comprimido, __path_tree__, dentro da própria coleção do Chroma. Cada caminho traz mais dois dados: se é público (isPublic) e a quais grupos pertence (groups).
Ao iniciar, o servidor o baixa, o descompacta e monta duas estruturas na memória: um conjunto (Set<string>) com o caminho de cada arquivo e um mapa (Map<string, string[]>) que diz quais filhos tem cada pasta. A partir daí, ls, cd e find se resolvem na memória local, sem tocar na rede. E como a árvore fica em cache, as sessões seguintes do mesmo site nem precisam pedi-la ao Chroma.
Controle de acesso
Antes de montar a árvore, o ChromaFs poda os caminhos de acordo com o token de sessão do usuário, e aplica o mesmo filtro a todas as consultas seguintes. Se você não tem acesso a um arquivo, esse arquivo não existe: ele some da árvore, e o agente não pode lê-lo nem sequer mencioná-lo, porque para ele esse caminho nunca esteve lá.
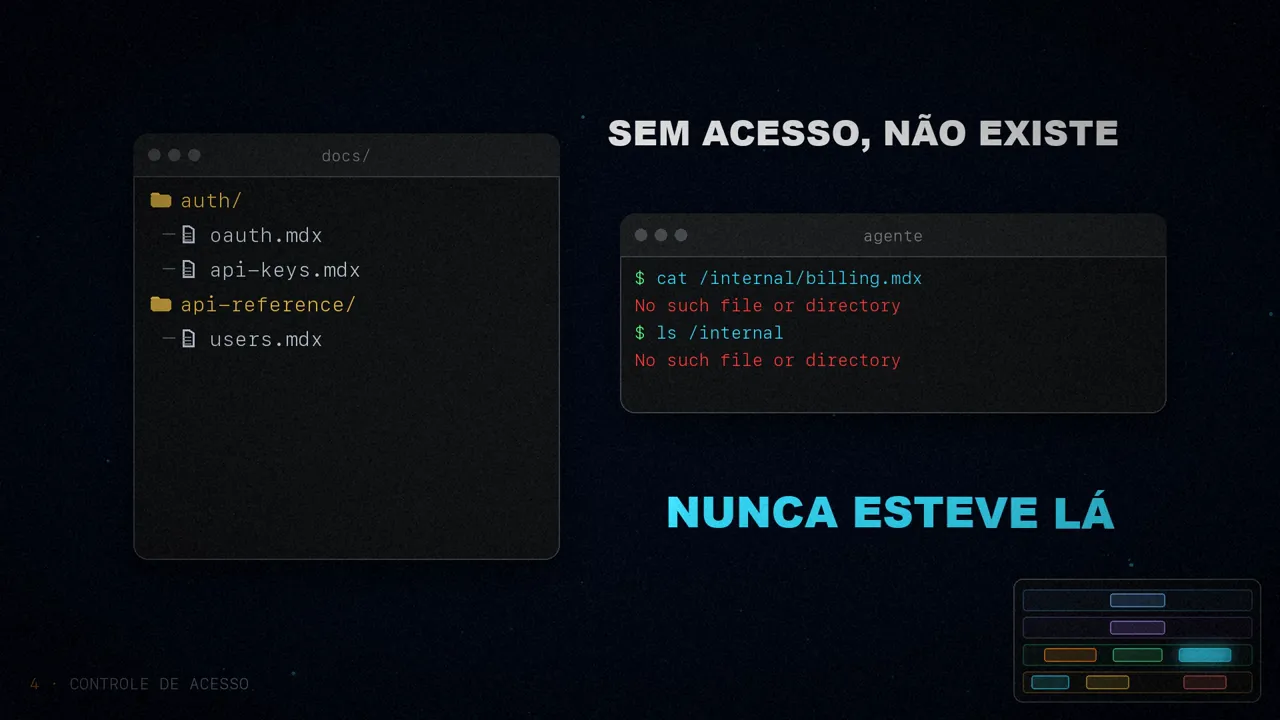
Num sandbox de verdade, isso obrigaria a gerenciar grupos de usuários do Linux, permissões com chmod ou uma imagem de contêiner diferente para cada tipo de cliente. No ChromaFs são poucas linhas de filtro antes de montar a árvore.
Páginas em trechos, cache e somente leitura
As páginas ficam guardadas no Chroma em trechos, porque é assim que são indexadas para a busca. Quando o agente faz cat de uma página, o ChromaFs traz todos os seus fragmentos, os ordena pelo número (chunk_index) e os junta. Além disso, guarda o resultado em cache, então vários grep seguidos nas mesmas páginas nunca vão duas vezes ao banco de dados.
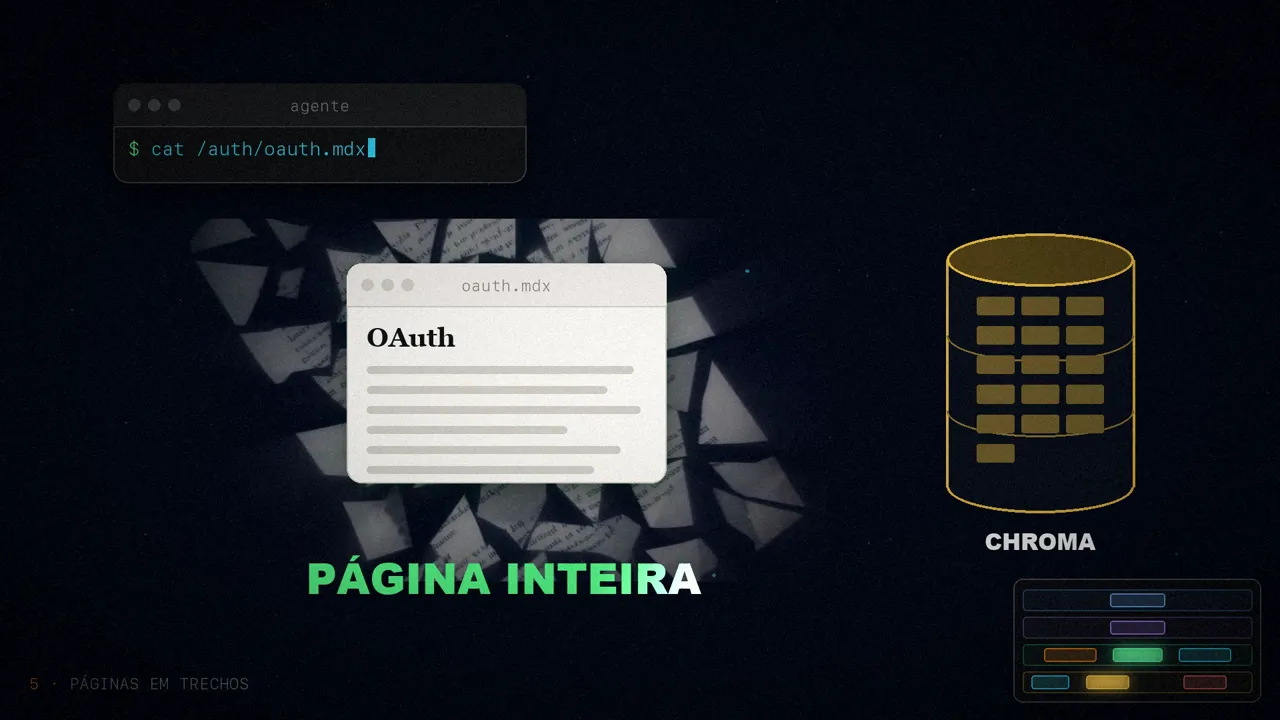
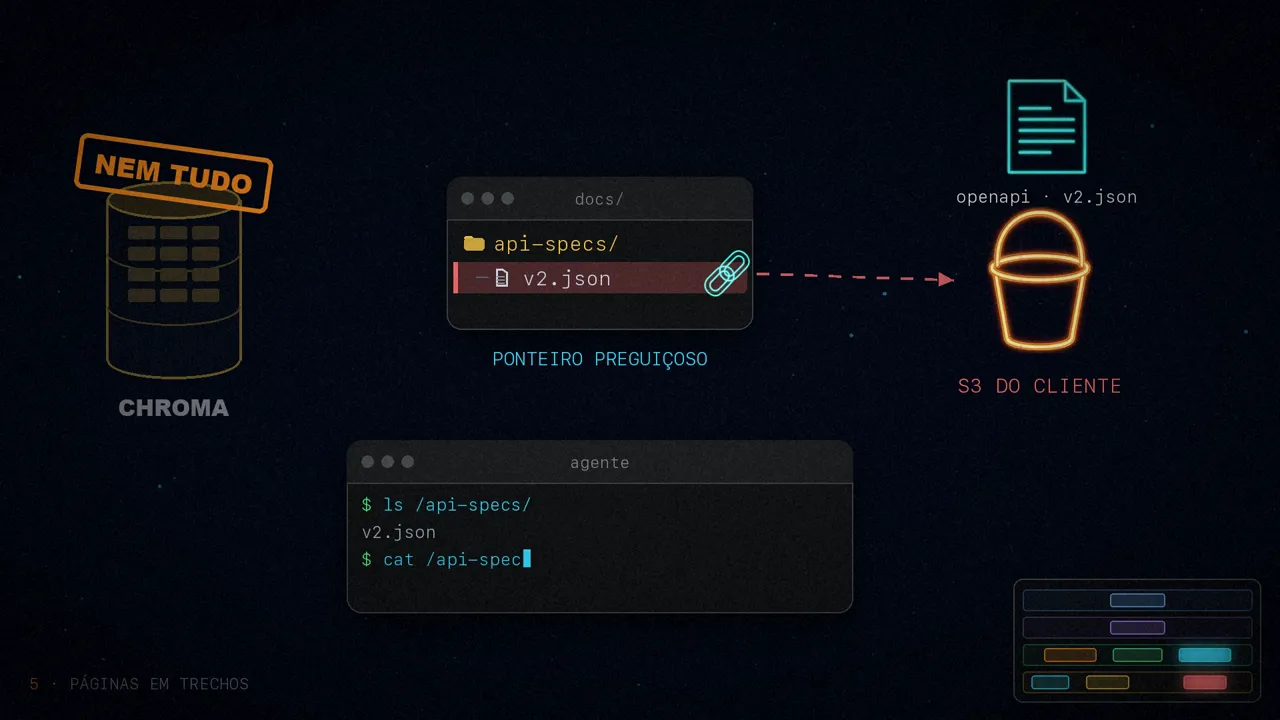
Nem tudo precisa estar no Chroma. Alguns clientes têm especificações OpenAPI enormes guardadas no seu próprio S3. Para elas há ponteiros preguiçosos: o agente vê v2.json ao listar /api-specs/, mas o conteúdo só é baixado quando ele faz cat.
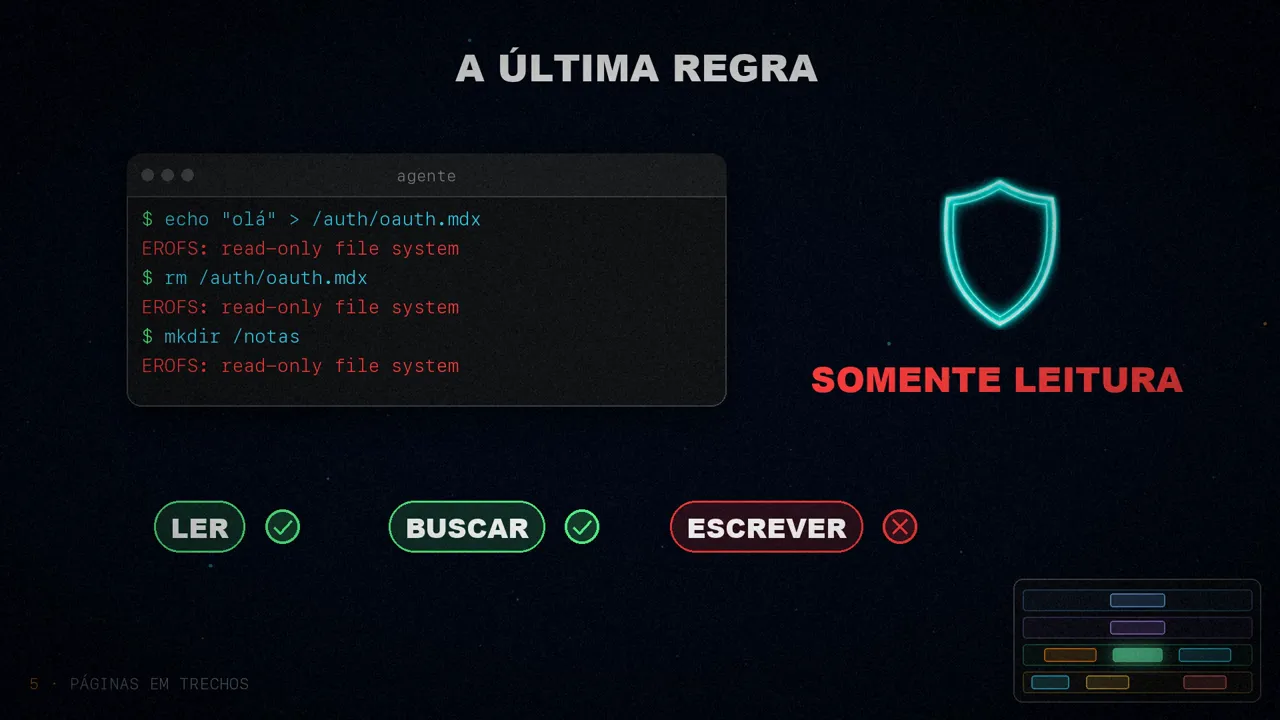
E uma última regra: qualquer escrita devolve EROFS, o erro de sistema de arquivos somente leitura. O agente explora com total liberdade, mas nunca consegue mudar a documentação. Assim tudo funciona sem estado: não há nada para limpar ao fechar a sessão, e nenhum agente estraga o que o outro vê.
Otimizando o grep
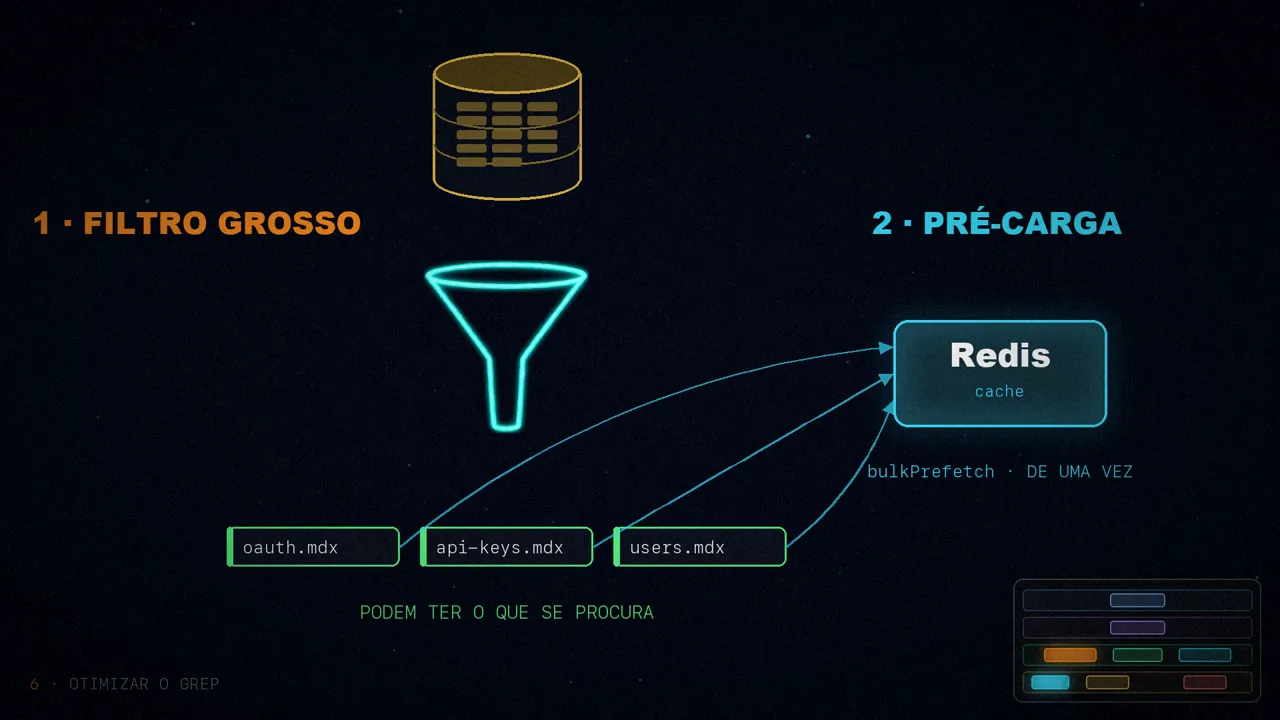
cat e ls são fáceis de virtualizar. O difícil é o grep: um grep -r que lesse todos os arquivos um por um, pela rede, seria lentíssimo. Então eles o interceptam: leem as opções com um analisador de argumentos (yargs-parser) e as convertem numa consulta ao Chroma, $contains para um texto exato ou $regex para um padrão. Depois ele trabalha em duas passadas:
- Filtro grosso. O Chroma aponta quais arquivos podem conter o que se procura.
- Pré-carga. Os fragmentos desses arquivos são baixados de uma vez (
bulkPrefetch) para um cache do Redis. - Filtro fino. Eles reescrevem o
greppara olhar só esses arquivos e o devolvem ao just-bash, que o executa na memória.
O resultado são buscas recursivas enormes que terminam em milissegundos.
Resumindo
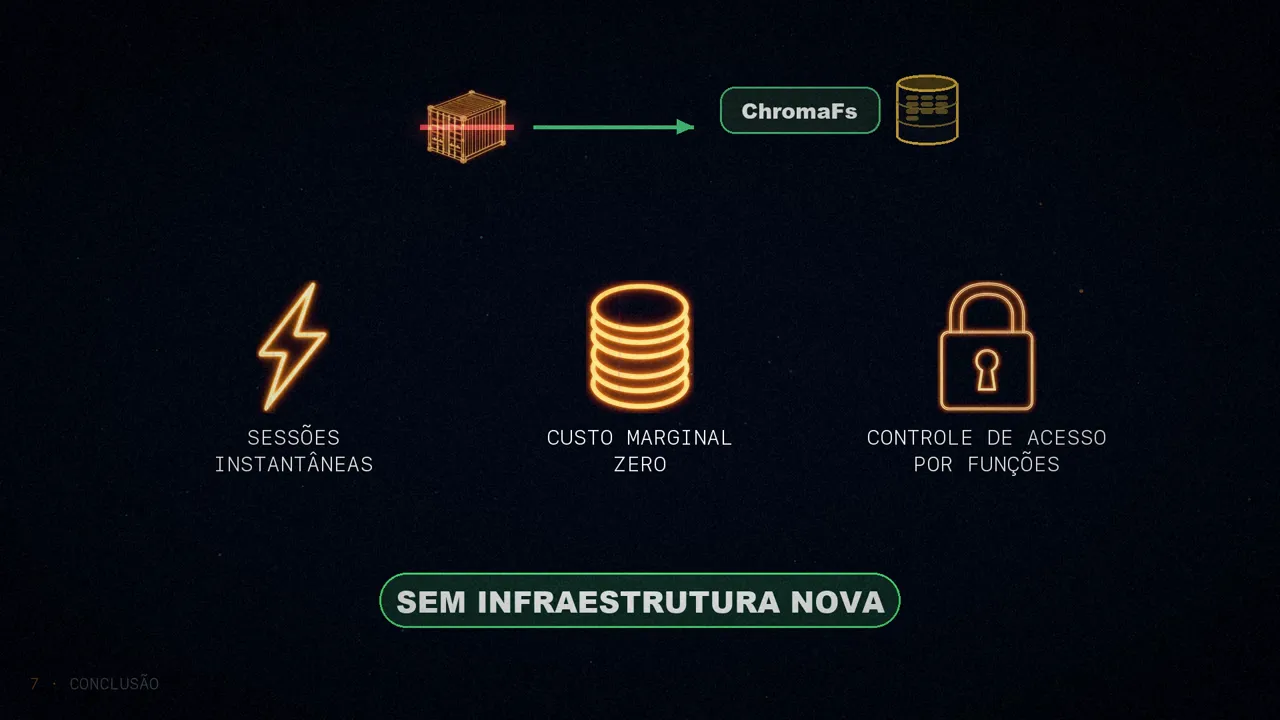
Hoje o ChromaFs move o assistente de documentação de centenas de milhares de usuários, em mais de 30.000 conversas por dia. Ao trocar os sandboxes por um sistema de arquivos virtual sobre o banco de dados de sempre, a Mintlify conseguiu três coisas: sessões instantâneas, custo marginal de computação zero e controle de acesso por funções já incluído, sem montar infraestrutura nova.
O agente não precisa de um disco de verdade: basta a ilusão de um.
O que mais você transformaria em pastas para um agente explorar?
Fontes
- “How we built a virtual filesystem for our Assistant”, de Dens Sumesh, Mintlify, 24 de março de 2026.
- Sobre por que os agentes trabalham com arquivos e bash: meu post sobre “The Anatomy of an Agent Harness”.
- O vídeo, nos meus três canais: espanhol, inglês e português.