El bucle es tuyo, no del modelo
Una llamada a un modelo de lenguaje produce una respuesta y termina. El modelo no puede ejecutar una tool, esperar el resultado y seguir pensando por su cuenta: cuando pide una tool, su turno se acaba ahí. Si una persona pregunta «¿cuánto he progresado en press banca este mes?», el modelo puede pedir primero el historial de entrenamientos, pero no verá ese historial hasta que alguien se lo envíe en una llamada nueva.
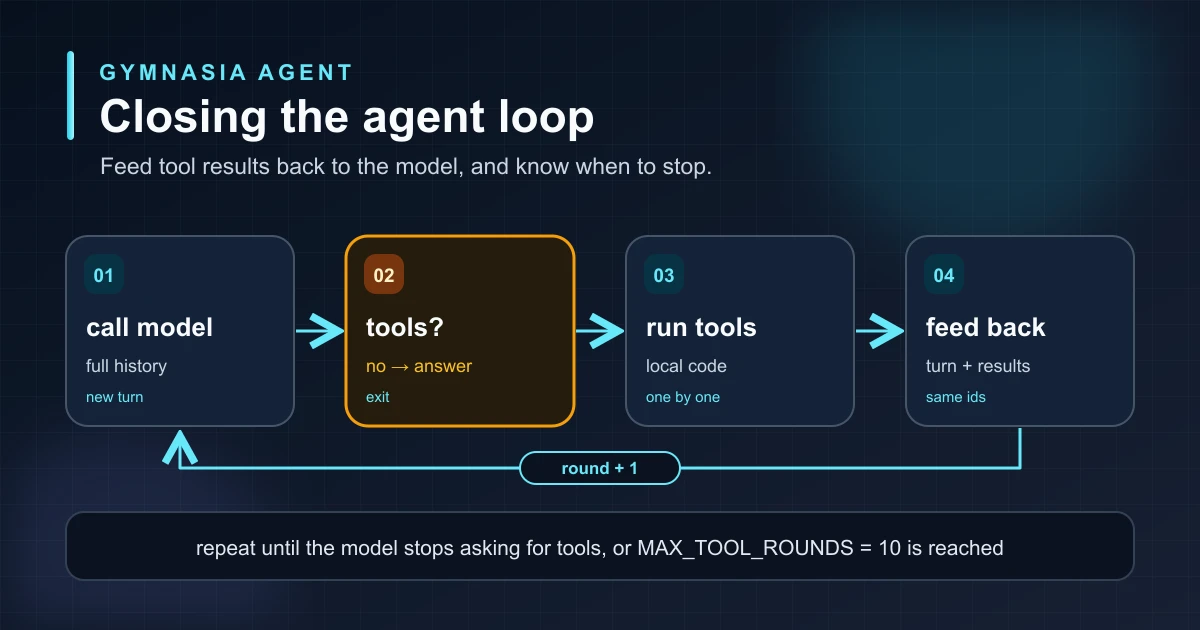
Ese «alguien» es el harness: el programa que rodea al modelo. Recibe la petición, ejecuta la tool, añade el resultado a la conversación y vuelve a llamar al modelo. Repite el proceso hasta que el modelo contesta sin pedir nada más. Lo que solemos llamar «agente» es, en su núcleo, ese bucle escrito en el código de la aplicación. El modelo decide qué pedir; el bucle decide si se ejecuta, cuántas veces se repite y cuándo se para.
El ciclo completo
Cada vuelta del bucle es una ronda: una llamada al modelo, la ejecución de las tools que haya pedido y el reenvío de sus resultados. El bucle tiene dos salidas. La normal se produce cuando el modelo responde sin pedir tools: esa es la respuesta final para la persona. La de seguridad se produce cuando se agota el número máximo de rondas, aunque el modelo siga pidiendo tools.
El bucle, paso a paso
Este es el bucle en pseudocódigo. No importa el lenguaje ni la API: lo que hay que hacer es lo mismo en todos los casos. Fíjate en tres cosas: cuándo sale el bucle, qué se añade al historial en cada vuelta y cuándo se vuelve a llamar al modelo.
turn = call_model(history)

repeat at most MAX_ROUNDS times:
    if the turn asks for no tools:
        exit                           # normal exit: this is the final answer

    results = []
    for each tool request in the turn:
        result = run_tool(request.name, request.arguments)
        add (request.id, result) to results

    append the turn to the history     # what the model asked for
    append the results to the history  # what the app answered
    turn = call_model(history)

return turn
Ese es el núcleo. El repeat at most impone el tope de rondas, y el exit es la salida normal. En cada vuelta, las tools se ejecutan de una en una, en el orden en que el modelo las pidió. Es más lento que ejecutarlas en paralelo, pero evita que dos escrituras sobre los mismos datos compitan entre sí. Cambiar esa decisión es cambiar el bucle, no el modelo. Lo único que falta es qué hacer cuando el bucle termina porque se acabaron las rondas, y eso tiene su propia sección más abajo.
Qué se reinyecta y en qué orden
El modelo no recuerda nada entre llamadas. Por eso, en cada llamada recibe la conversación entera: los mensajes anteriores de la persona y del asistente y, desde que empezó el bucle, cada petición de tools con su resultado. Cada ronda añade dos cosas al final de ese historial, en este orden: primero el turno del modelo con sus peticiones (tool_use) y después un mensaje con un resultado (tool_result) por cada petición. El identificador conecta cada resultado con su petición.
El orden no es un detalle de estilo. Anthropic rechaza un tool_result que no sigue al turno con su tool_use, y un resultado sin la petición que lo motivó deja al modelo sin contexto para interpretarlo. Los tres proveedores resuelven lo mismo de formas distintas:
| Proveedor | Quién guarda el historial dentro del bucle | Qué envía el bucle en cada ronda |
|---|---|---|
| OpenAI (Responses) | El proveedor | Solo los resultados nuevos (function_call_output con su call_id) y el previous_response_id, que le dice a OpenAI a qué respuesta anterior continúa. |
| Anthropic (Messages) | La aplicación | El historial entero: la conversación, el turno del modelo sin tocar y, a continuación, un mensaje con un tool_result por cada tool_use_id. |
| Google (Interactions) | La aplicación, porque Gymnasia no guarda la interacción en Google | El historial entero, con cada function_call seguido de su function_result con el mismo call_id. |
OpenAI es la excepción solo dentro del bucle de un mismo mensaje: como su API puede recordar una respuesta por su identificador, basta con enviarle lo nuevo. Cuando la persona escribe un mensaje nuevo, Gymnasia empieza desde cero y le envía la conversación completa, igual que a los demás. Y en todos los casos se cumple lo mismo: la petición va antes que su resultado, y cada resultado lleva el identificador de la petición a la que responde.
Por qué hace falta un tope
Nada obliga al modelo a dejar de pedir tools. Puede repetir la misma llamada porque el resultado no le convence, encadenar búsquedas sin llegar a una conclusión o reaccionar a un error pidiendo la tool otra vez. Cada ronda es una llamada de red, con su latencia y su coste en tokens, y el historial crece en cada vuelta. Sin un límite, un bucle así puede dejar a la persona esperando indefinidamente.
Gymnasia fija el tope en una constante compartida por los tres proveedores: MAX_TOOL_ROUNDS = 10. El número es una decisión de producto, no una verdad técnica. Tiene que ser lo bastante alto para las consultas reales que encadenan varias tools, como leer el historial, calcular una marca y guardar un objetivo, y lo bastante bajo para que un bucle descontrolado se corte antes de que la espera o la factura se noten.
Qué pasa cuando se agotan las rondas
Cortar el bucle es la parte fácil. Lo difícil es decidir qué se le dice a la persona. En la primera versión de Gymnasia esto estaba mal resuelto, y merece contarse porque es fácil repetirlo en cualquier harness:
- Google lanzaba un error técnico: la respuesta seguía pendiente de tools al alcanzar el límite.
- OpenAI y Anthropic salían del bucle sin avisar y devolvían el último turno, que todavía pedía tools. Como el texto que el modelo escribe entre rondas («voy a buscar tu historial…») se va acumulando, la persona veía esa frase a medias como si fuera la respuesta final, o un error genérico del tipo «el proveedor no devolvió contenido».
En ningún caso recibía una respuesta útil ni sabía que se había agotado el presupuesto de rondas. Cortar sin más es tirar el trabajo hecho: el agente quizá ya había leído el historial y solo le faltaba un paso.
La solución: una última llamada en la que el modelo solo puede escribir
Cuando se agotan las rondas, el bucle no corta en seco. Hace una última llamada al modelo en la que no puede pedir ninguna tool, ni las que se quedaron pendientes ni otras: solo puede contestar con texto, usando lo que ya ha averiguado.
Antes hay que resolver un detalle. El último turno del modelo todavía contiene peticiones de tools, y los proveedores exigen que cada petición tenga su resultado. Así que el bucle las responde sin ejecutarlas, con un resultado que solo dice lo que pasó. La instrucción de qué hacer ahora va aparte, en las instrucciones de sistema de esa última llamada:
# The rounds ran out and the last turn still asks for tools.
if the turn asks for tools:
    for each pending request:
        result = "Not executed: the step limit for this answer was reached."
    append the turn and those results to the history

    instructions = system_prompt + "You have reached the step limit for this answer.
        Answer with what you already know, explain the limit,
        say what was left undone and ask whether to continue."
    turn = call_model(history, instructions, tools = none)

return turn
Así la persona recibe algo como «He encontrado tu historial, pero he llegado al límite de pasos de esta respuesta y no he calculado la marca. ¿Quieres que continúe?». Si contesta que sí, el agente sigue: el tope se cuenta por mensaje, así que el mensaje nuevo arranca con otras diez rondas. Y si la tool pendiente era una escritura, como guardar un objetivo, el modelo sabe que no se hizo y no dirá lo contrario.
Por qué la instrucción no va en el resultado de la tool
La primera versión lo metía todo en el resultado: «No ejecutada… responde con lo que sabes y pregunta si quiere que continúes». Con Google funcionaba, pero con OpenAI no. El modelo trataba ese texto como un dato devuelto por una tool, no como una orden: no preguntaba, y a veces hasta decía que no tenía acceso a las herramientas.
Tiene sentido que sea así. El resultado de una tool puede contener texto que no controlas, como el de una página web o un documento, y un modelo que obedeciera las órdenes escritas ahí sería fácil de manipular. Al pasar la instrucción a las instrucciones de sistema de la llamada de cierre, las tres pruebas con OpenAI explicaron el límite y terminaron preguntando si continuar.
el resultado de una tool cuenta qué ha pasado; lo que el modelo debe hacer a continuación va en las instrucciones de sistema.
Cómo se le dice al modelo que no use tools
Todas estas APIs tienen un parámetro, tool_choice, que decide qué puede hacer el modelo con las tools en una llamada concreta. Con auto, el valor habitual, el modelo decide si pide alguna. Con none, las tools siguen declaradas, pero el modelo no puede pedir ninguna y tiene que responder con texto. La llamada de cierre usa none. Cada proveedor lo escribe de una forma, y hay dos trampas:
| Proveedor | Cómo se pide que no use tools en la llamada de cierre |
|---|---|
| OpenAI (Responses) y compatibles | tool_choice: "none". |
| Anthropic (Messages) | tool_choice: { type: "none" }, sin quitar la lista de tools: si el historial contiene peticiones de tools, la API exige que las tools sigan declaradas. |
| Google (Interactions) | tool_choice: "none" dentro de generation_config. Si se pone en la raíz de la petición, la API responde con un error 400 Unknown parameter. |
Si ni así hay respuesta
La llamada de cierre también puede fallar: se cae la red, o el modelo ignora la instrucción y vuelve a pedir una tool. Solo en ese caso la persona ve un error. Pero no el genérico «el proveedor no devolvió contenido», que no explica nada e invita a repetir la misma pregunta. En su lugar ve uno que dice qué ha pasado y qué puede hacer: «Esta consulta necesitaba más pasos de los que el asistente puede dar en una sola respuesta. Prueba a dividirla en preguntas más pequeñas».
Regla de diseño:que el agente se quede sin rondas no es un fallo más. Normalmente ya ha averiguado algo útil, así que dale una última oportunidad de contarlo sin dejarle pedir más tools, que diga con claridad qué no llegó a hacer y que pregunte si debe continuar. Reserva el mensaje de error para cuando ni eso funcione, y que explique lo que ha pasado.
Tests del bucle
El bucle se puede probar entero sin red y sin modelo. Basta con un proveedor falso: una función que, en lugar de llamar a la API, devuelve turnos preparados de antemano, uno por ronda. Así cada test fija exactamente qué pide el modelo en cada vuelta y comprueba lo que hace el bucle. La misma batería se repite para OpenAI, Anthropic y Google.
Dos rondas y respuesta final
El proveedor falso pide una tool, luego otra y después contesta con texto. El bucle debe ejecutar las dos tools, llamar dos veces al modelo y devolver la respuesta final.
El orden del historial
En la segunda llamada, el historial debe contener cada turno del modelo seguido de sus resultados, ronda a ronda. Si alguien invierte las dos entradas, el test falla antes de que lo haga el proveedor real.
Sin tools, sin vueltas
Si la primera respuesta ya es texto, el bucle sale en la primera vuelta: no ejecuta ninguna tool y no vuelve a llamar al modelo.
Un modelo que no para
El proveedor falso pide tools en cada turno, sin fin. El bucle debe ejecutar exactamente el tope de rondas, responder la petición pendiente sin ejecutarla y hacer la llamada de cierre sin tools.
Para la parte del tope hay tres comprobaciones más. La primera: al llegar al límite, las peticiones pendientes reciben el resultado «No ejecutada» y no se ejecutan. La segunda: la llamada de cierre lleva tool_choice con el valor none, en el sitio que exige cada proveedor, y la instrucción de cierre en las instrucciones de sistema, solo en esa llamada. La tercera: si el cierre falla, la persona ve el mensaje que explica qué pasó, no el genérico.
¿Cómo sabemos que estos tests sirven para algo? Rompiendo el código a propósito y comprobando que fallan. Invertimos el orden del historial, subimos el tope a 11 y quitamos el tool_choice de la llamada de cierre, y en cada caso varios tests se pusieron en rojo. Un test que sigue en verde con el código roto no protege nada.
Aprender a construir un agente completo
Este artículo forma parte de una serie sobre cómo construir un agente o harness usando una app de gimnasio como caso práctico. El paso anterior fue convertir una tool call en código ejecutable; aquí hemos cerrado el ciclo, devolviendo el resultado al modelo y poniendo un límite al número de vueltas.
Ver el índice completo de la serie sobre el agente de Gymnasia.