O loop é seu, não do modelo
Uma chamada a um modelo de linguagem produz uma resposta e termina. O modelo não consegue executar uma tool, esperar o resultado e continuar raciocinando sozinho: quando pede uma tool, o turno dele acaba ali. Se alguém pergunta “quanto evoluí no supino este mês?”, o modelo pode pedir primeiro o histórico de treinos, mas só verá esse histórico quando alguém enviá-lo em uma nova chamada.
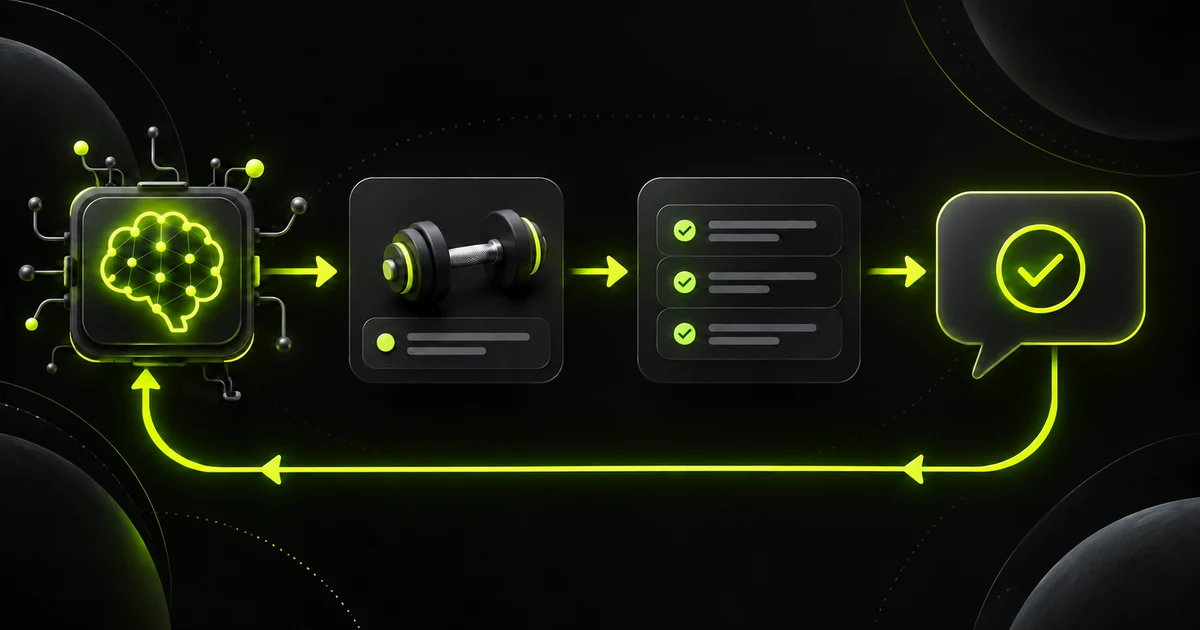
Esse “alguém” é o harness: o programa ao redor do modelo. Ele recebe o pedido, executa a tool, acrescenta o resultado à conversa e chama o modelo de novo. Repete o processo até o modelo responder sem pedir mais nada. O que costumamos chamar de “agente” é, no fundo, esse loop escrito no código do aplicativo. O modelo decide o que pedir; o loop decide se executa, quantas vezes repete e quando para.
O ciclo completo
Cada volta do loop é uma rodada: uma chamada ao modelo, a execução das tools que ele pediu e o reenvio dos resultados. O loop tem duas saídas. A normal acontece quando o modelo responde sem pedir tools: essa é a resposta final para a pessoa. A de segurança acontece quando o número máximo de rodadas se esgota, mesmo que o modelo continue pedindo tools.
O loop, passo a passo
Este é o loop em pseudocódigo. A linguagem e a API não importam: o que precisa ser feito é o mesmo em todos os casos. Observe três coisas: quando o loop sai, o que é acrescentado ao histórico em cada volta e quando o modelo é chamado de novo.
turn = call_model(history)

repeat at most MAX_ROUNDS times:
    if the turn asks for no tools:
        exit                           # normal exit: this is the final answer

    results = []
    for each tool request in the turn:
        result = run_tool(request.name, request.arguments)
        add (request.id, result) to results

    append the turn to the history     # what the model asked for
    append the results to the history  # what the app answered
    turn = call_model(history)

return turn
Esse é o núcleo. O repeat at most impõe o limite de rodadas, e o exit é a saída normal. Em cada volta, as tools são executadas uma a uma, na ordem em que o modelo as pediu. É mais lento do que executá-las em paralelo, mas evita que duas escritas sobre os mesmos dados concorram entre si. Mudar essa decisão é mudar o loop, não o modelo. Só falta o que fazer quando o loop termina porque as rodadas acabaram, e isso tem uma seção própria mais abaixo.
O que é reinjetado e em que ordem
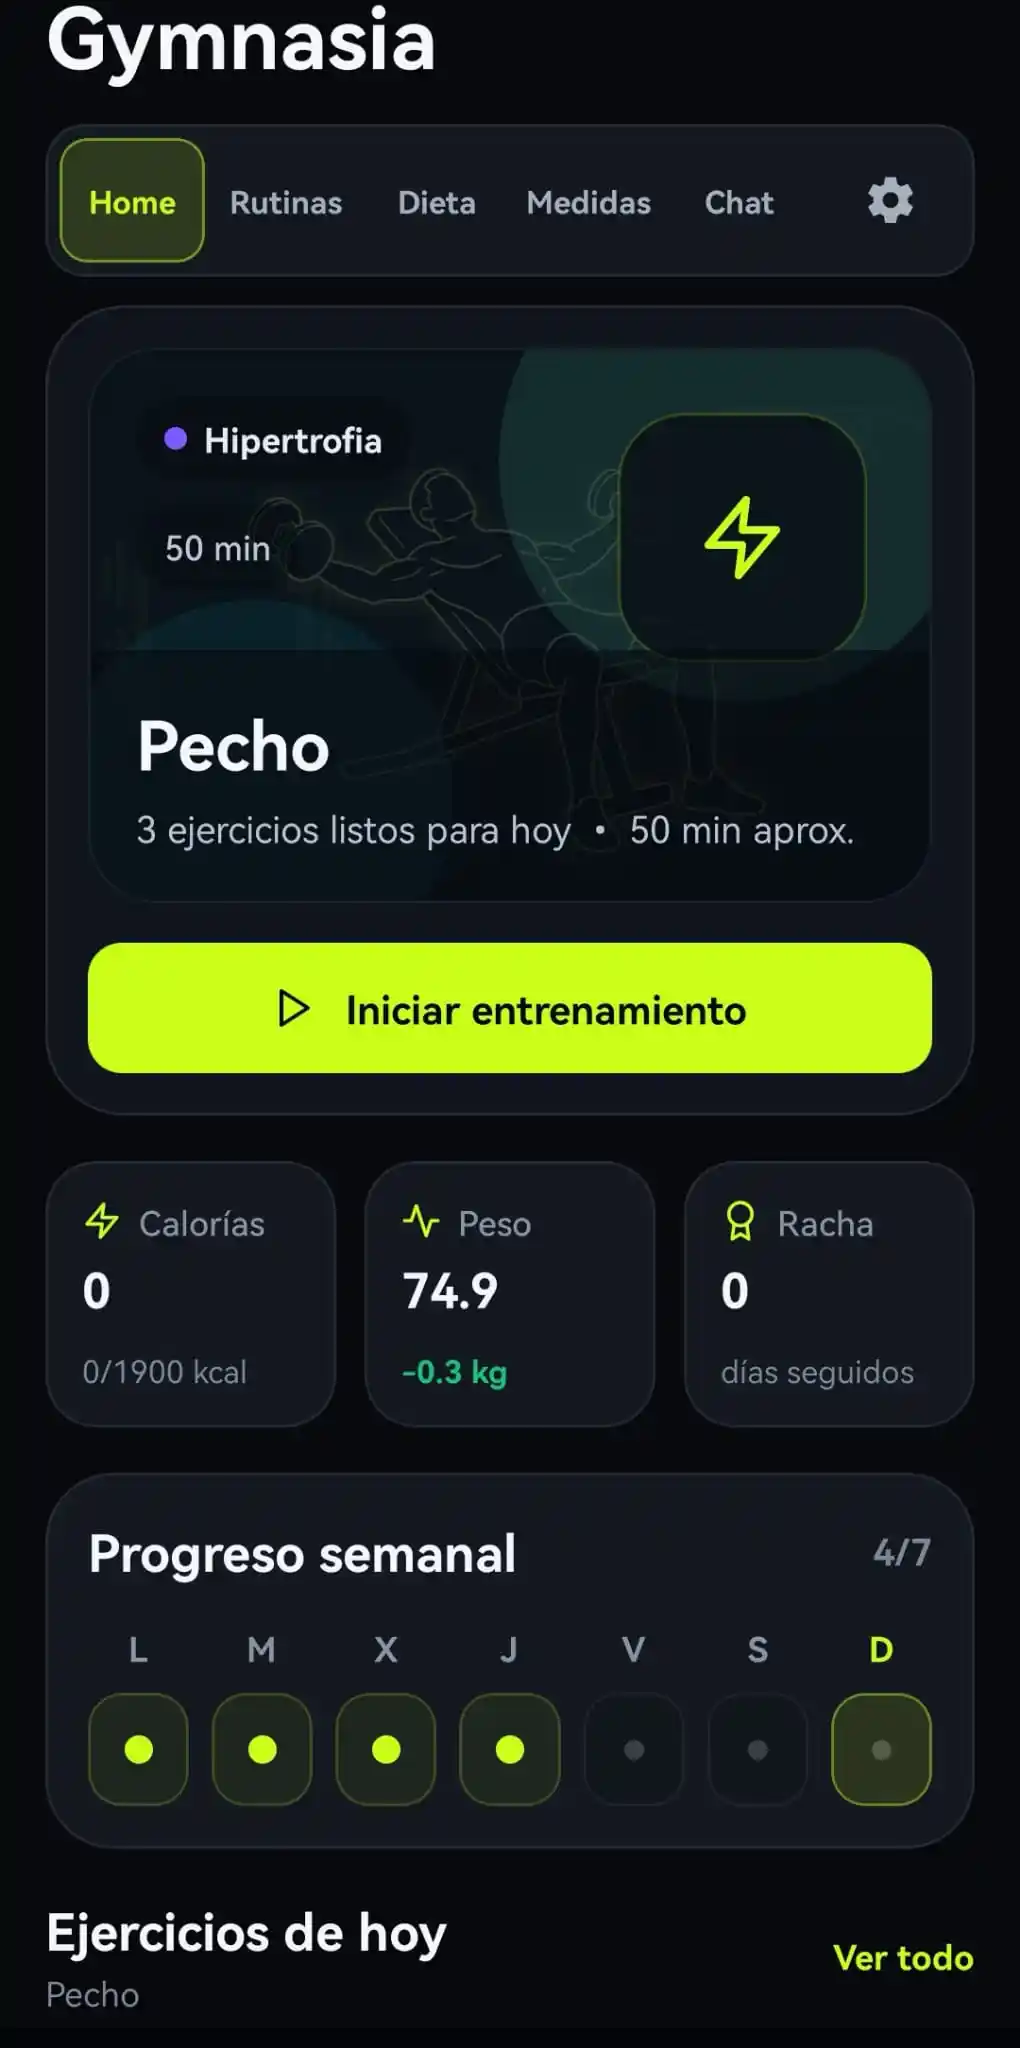
O Gymnasia mantém o chat no celular. Antes de chamar qualquer fornecedor, uma mesma regra local seleciona até as últimas 20 mensagens da conversa. Cada adaptador converte essa seleção para o formato da sua API. Depois, durante essa consulta, cada rodada acrescenta o turno do modelo e os resultados das tools. A sequência ativa inteira é reenviada nas rodadas seguintes: ela não é cortada no meio de uma cadeia de pedidos e resultados.
A ordem importa. Primeiro vem o pedido do modelo, depois o resultado com o identificador correspondente. A Anthropic, por exemplo, rejeita um tool_result que não vem logo após o turno com o seu tool_use. A seleção do contexto segue uma política comum; o que muda conforme a API é como essa sequência é representada:
| Fornecedor | Como representa o pedido e o resultado |
|---|---|
| OpenAI (Responses) | O turno do modelo junto com function_call e function_call_output ligados por call_id. Se houver raciocínio interno, reenvia seu conteúdo criptografado, que não consegue ler. |
| Anthropic (Messages) | O turno do modelo com tool_use e, em seguida, um tool_result para cada tool_use_id. |
| Google (Interactions) | Cada function_call e seu function_result ligados por call_id dentro dos passos da interação. |
As 20 mensagens são o máximo da seleção inicial. O Google pode enviar menos: seu adaptador remove intercâmbios antigos quando a requisição ultrapassa os limites de tamanho, mas mantém intactos os passos do turno ativo. Esse ajuste acontece depois da seleção do contexto.
Antes, o Gymnasia usava previous_response_id: a OpenAI guardava a resposta, então bastava enviar os resultados novos. Agora cada chamada à OpenAI leva store: false, e o Gymnasia reenvia o contexto escolhido e a sequência ativa; não depende mais de a OpenAI guardar uma resposta para continuá-la. O raciocínio criptografado fica apenas na memória durante a consulta e não aparece nem é salvo no chat. Isso permitirá decidir depois qual contexto resumir ou excluir, embora o Gymnasia ainda não faça essa compactação.
store: false evita que respostas sejam guardadas como estado da aplicação na OpenAI; não é uma promessa de retenção zero para outros fins, como o monitoramento de abusos.
Por que é preciso um limite
Nada obriga o modelo a parar de pedir tools. Ele pode repetir a mesma chamada porque o resultado não o convence, encadear buscas sem chegar a uma conclusão ou reagir a um erro pedindo a tool outra vez. Cada rodada é uma chamada de rede, com sua latência e seu custo em tokens, e o histórico cresce a cada volta. Sem um limite, um loop assim pode deixar a pessoa esperando indefinidamente.
O Gymnasia define o limite em uma constante compartilhada pelos três fornecedores: MAX_TOOL_ROUNDS = 10. O número é uma decisão de produto, não uma verdade técnica. Precisa ser alto o bastante para as consultas reais que encadeiam várias tools, como ler o histórico, calcular um recorde e salvar uma meta, e baixo o bastante para cortar um loop descontrolado antes que a espera ou a conta fiquem perceptíveis.
O que acontece quando as rodadas acabam
Interromper o loop é a parte fácil. O difícil é decidir o que dizer à pessoa. Na primeira versão do Gymnasia isso estava mal resolvido, e vale a pena contar porque é fácil repetir em qualquer harness:
- O Google lançava um erro técnico: a resposta continuava pendente de tools ao atingir o limite.
- A OpenAI e a Anthropic saíam do loop sem avisar e devolviam o último turno, que ainda pedia tools. Como o texto que o modelo escreve entre rodadas (“vou buscar seu histórico…”) vai se acumulando, a pessoa via essa frase pela metade como se fosse a resposta final, ou um erro genérico do tipo “o fornecedor não devolveu conteúdo”.
Em nenhum caso ela recebia uma resposta útil nem sabia que o orçamento de rodadas tinha acabado. Cortar de uma vez é jogar fora o trabalho feito: o agente talvez já tivesse lido o histórico e só faltasse um passo.
A solução: uma última chamada em que o modelo só pode escrever
Quando as rodadas acabam, o loop não para de repente. Ele faz uma última chamada ao modelo em que ele não pode pedir nenhuma tool, nem as que ficaram pendentes nem outras: só pode responder com texto, usando o que já descobriu.
Antes é preciso resolver um detalhe. O último turno do modelo ainda contém pedidos de tools, e os fornecedores exigem que cada pedido tenha seu resultado. Então o loop responde a eles sem executá-los, com um resultado que só diz o que aconteceu. Em uma mesma chamada de encerramento à API, o Gymnasia envia esses resultados no histórico e coloca a orientação sobre como responder nas instruções de sistema:
# The rounds ran out and the last turn still asks for tools.
if the turn asks for tools:
    for each pending request:
        result = "Not executed: the step limit for this answer was reached."
    append the turn and those results to the history

    instructions = system_prompt + "You have reached the step limit for this answer.
        Answer with what you already know, explain the limit,
        say what was left undone and ask whether to continue."
    turn = call_model(history, instructions, tools = none)

return turn
São duas partes da mesma requisição à API: o histórico diz “esta tool não foi executada”, e as instruções dizem “explique o limite e pergunte se quer continuar”. Com tool_choice: "none", o modelo não pode pedir outra tool. Assim a pessoa recebe algo como “Encontrei seu histórico, mas cheguei ao limite de passos desta resposta e não calculei o recorde. Quer que eu continue?”. Se ela responder que sim, o agente segue: o limite é contado por mensagem, então a nova mensagem começa com outras dez rodadas. E se a tool pendente era uma escrita, como salvar uma meta, o modelo sabe que ela não foi feita e não vai dizer o contrário.
Por que a instrução não vai no resultado da tool
A primeira versão colocava tudo no resultado: “Não executada… responda com o que sabe e pergunte se quer que você continue”. Com o Google funcionava, mas com a OpenAI não. O modelo tratava esse texto como um dado devolvido por uma tool, não como uma ordem: não perguntava e às vezes até dizia que não tinha acesso às ferramentas.
Faz sentido que seja assim. O resultado de uma tool pode conter texto que você não controla, como o de uma página web ou de um documento, e um modelo que obedecesse às ordens escritas ali seria fácil de manipular. Ao passar a instrução para as instruções de sistema da chamada de encerramento, os três testes com a OpenAI explicaram o limite e terminaram perguntando se deviam continuar.
o resultado de uma tool conta o que aconteceu; o que o modelo deve fazer em seguida vai nas instruções de sistema.
Como dizer ao modelo que não use tools
Todas essas APIs têm um parâmetro, tool_choice, que decide o que o modelo pode fazer com as tools em uma chamada específica. Com auto, o valor habitual, o modelo decide se pede alguma. Com none, as tools continuam declaradas, mas o modelo não pode pedir nenhuma e precisa responder com texto. A chamada de encerramento usa none. Cada fornecedor escreve isso de um jeito, e há duas armadilhas:
| Fornecedor | Como pedir que não use tools na chamada de encerramento |
|---|---|
| OpenAI (Responses) e compatíveis | tool_choice: "none". |
| Anthropic (Messages) | tool_choice: { type: "none" }, sem remover a lista de tools: se o histórico contém pedidos de tools, a API exige que as tools continuem declaradas. |
| Google (Interactions) | tool_choice: "none" dentro de generation_config. Na raiz da requisição, a API responde com um erro 400 Unknown parameter. |
Se mesmo assim não houver resposta
A chamada de encerramento também pode falhar: a rede cai, ou o modelo ignora a instrução e volta a pedir uma tool. Só nesse caso a pessoa vê um erro. Mas não o genérico “o fornecedor não devolveu conteúdo”, que não explica nada e convida a repetir a mesma pergunta. Em vez disso, ela vê um que diz o que aconteceu e o que pode fazer: “Esta consulta precisava de mais passos do que o assistente pode dar em uma única resposta. Tente dividi-la em perguntas menores”.
Regra de design:o agente ficar sem rodadas não é só mais uma falha. Normalmente ele já descobriu algo útil, então dê a ele uma última chance de contar isso sem deixá-lo pedir mais tools, que diga com clareza o que não chegou a fazer e que pergunte se deve continuar. Reserve a mensagem de erro para quando nem isso funcionar, e que ela explique o que aconteceu.
Testes do loop
O loop pode ser testado inteiro sem rede e sem modelo. Basta um fornecedor falso: uma função que, em vez de chamar a API, devolve turnos preparados de antemão, um por rodada. Assim cada teste fixa exatamente o que o modelo pede em cada volta e verifica o que o loop faz. A mesma bateria se repete para OpenAI, Anthropic e Google.
Duas rodadas e resposta final
O fornecedor falso pede uma tool, depois outra e então responde com texto. O loop deve executar as duas tools, chamar o modelo duas vezes e devolver a resposta final.
A ordem do histórico
Na segunda chamada, o histórico deve conter cada turno do modelo seguido dos seus resultados, rodada a rodada. Se alguém inverter as duas entradas, o teste falha antes do fornecedor real.
Sem tools, sem voltas
Se a primeira resposta já é texto, o loop sai na primeira volta: não executa nenhuma tool e não chama o modelo de novo.
Um modelo que não para
O fornecedor falso pede tools em todos os turnos, sem fim. O loop deve executar exatamente o limite de rodadas, responder ao pedido pendente sem executá-lo e fazer a chamada de encerramento sem tools.
O limite recebe mais três verificações. Primeira: ao atingir o limite, os pedidos pendentes recebem o resultado “Não executada” e não são executados. Segunda: a chamada de encerramento leva tool_choice com o valor none, no lugar que cada fornecedor exige, e a instrução de encerramento nas instruções de sistema, só nessa chamada. Terceira: se o encerramento falhar, a pessoa vê a mensagem que explica o que aconteceu, não a genérica.
A OpenAI tem uma verificação adicional: todas as rodadas levam store: false, nenhuma usa previous_response_id, e a chamada seguinte recebe os resultados junto com o turno que os pediu, incluindo os itens de raciocínio criptografado quando existirem.
A seleção inicial tem um teste comum: limita cada consulta do Coach a 20 mensagens. Outro verifica que o Google recebe essa mesma seleção antes de aplicar seus limites.
Como sabemos que esses testes servem para alguma coisa? Quebrando o código de propósito e verificando que eles falham. Invertemos a ordem do histórico, subimos o limite para 11 e removemos o tool_choice da chamada de encerramento, e em cada caso vários testes ficaram vermelhos. Um teste que continua verde com o código quebrado não protege nada.
Aprender a construir um agente completo
Este artigo faz parte de uma série sobre como construir um agente ou harness usando um aplicativo de academia como caso prático. O passo anterior foi transformar uma tool call em código executável; aqui fechamos o ciclo, devolvendo o resultado ao modelo e colocando um limite no número de voltas.