Uma tool é um contrato
Quando um LLM decide usar uma tool, ele não vê a função de Python, JavaScript ou TypeScript que será executada. Ele recebe apenas um contrato que explica qual capacidade a tool tem disponível e quais argumentos deve fornecer.
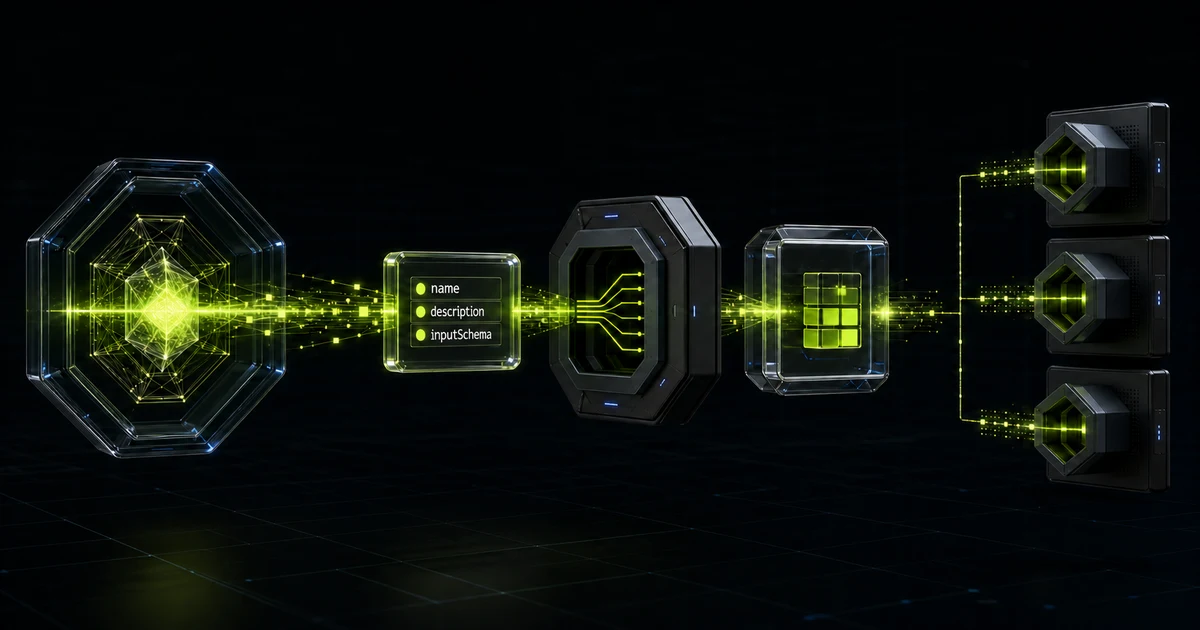
Esse contrato precisa de pelo menos três partes. Ele pode incluir uma quarta para descrever o resultado. Quando elas são claras, o modelo consegue escolher corretamente; quando são ambíguas, o harness precisa lidar com chamadas incorretas mesmo que a tool esteja perfeitamente implementada.
É o rótulo curto da tool. Se o modelo responder “usar read_measurement”, o harness lê esse rótulo e sabe qual ação concreta deve executar.
É o texto que faz o LLM entender que a tool existe, o que ela faz e quando deve usá-la. Também pode explicar o resultado e os passos anteriores necessários.
É o JSON Schema dos argumentos aceitos: quais argumentos existem, o tipo de cada um e quais são obrigatórios.
Descreve o formato do resultado quando a tool devolve dados estruturados. Nem todos os provedores aceitam esse campo com o mesmo nome: ele pode ficar no contrato interno, ser enviado quando a API oferece suporte ou ser documentado em description.
No exemplo do Gymnasia, a lista central do agente não inclui outputSchema: seus handlers devolvem texto ou JSON serializado, e a descrição informa ao modelo o que ele receberá. Adicionar um schema de saída seria útil se o harness precisasse validar resultados estruturados antes de devolvê-los ao LLM.
O que acontece quando uma tool é executada
O fluxo a seguir representa uma resposta que inclui a chamada de uma tool. Ele começa quando a solicitação precisa de uma capacidade externa e mostra o ciclo completo de execução de uma tool: o modelo a solicita, o harness a executa e o resultado volta ao modelo.
read_measurement + dataDefina todas as tools uma única vez e em um só lugar
Se as declarações das tools estiverem espalhadas pelo código e a forma comum de descrevê-las mudar depois, é fácil atualizar algumas e esquecer outras. É mais simples manter uma única lista central: cada tool é definida uma vez e o restante do sistema lê essa lista para informar o provedor, aceitar apenas nomes conhecidos e verificar se cada ação tem código capaz de executá-la.
Em um projeto pequeno, essa lista pode ficar em um único arquivo. Em um projeto grande, ela pode ser dividida por área e reunida em um único módulo exportado. O arquivo exato não importa; o importante é evitar cópias independentes do mesmo contrato.
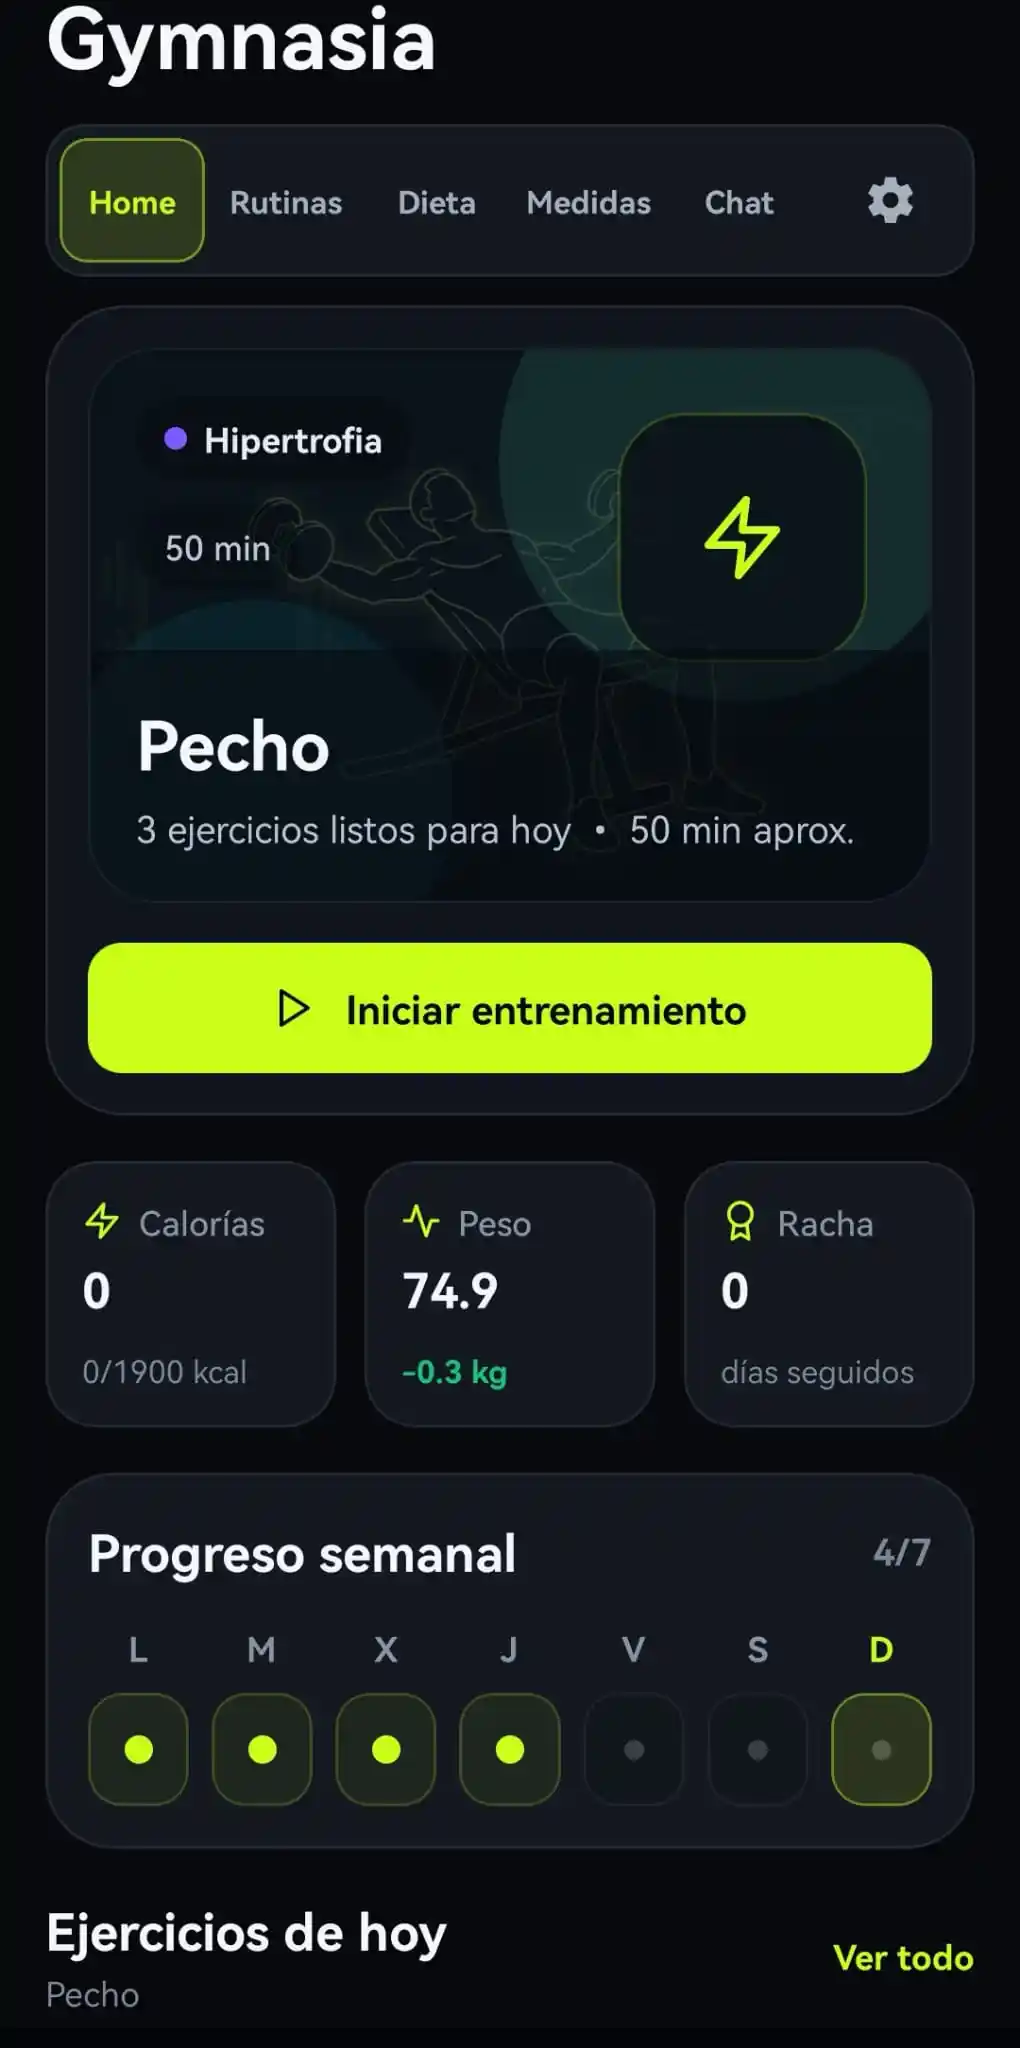
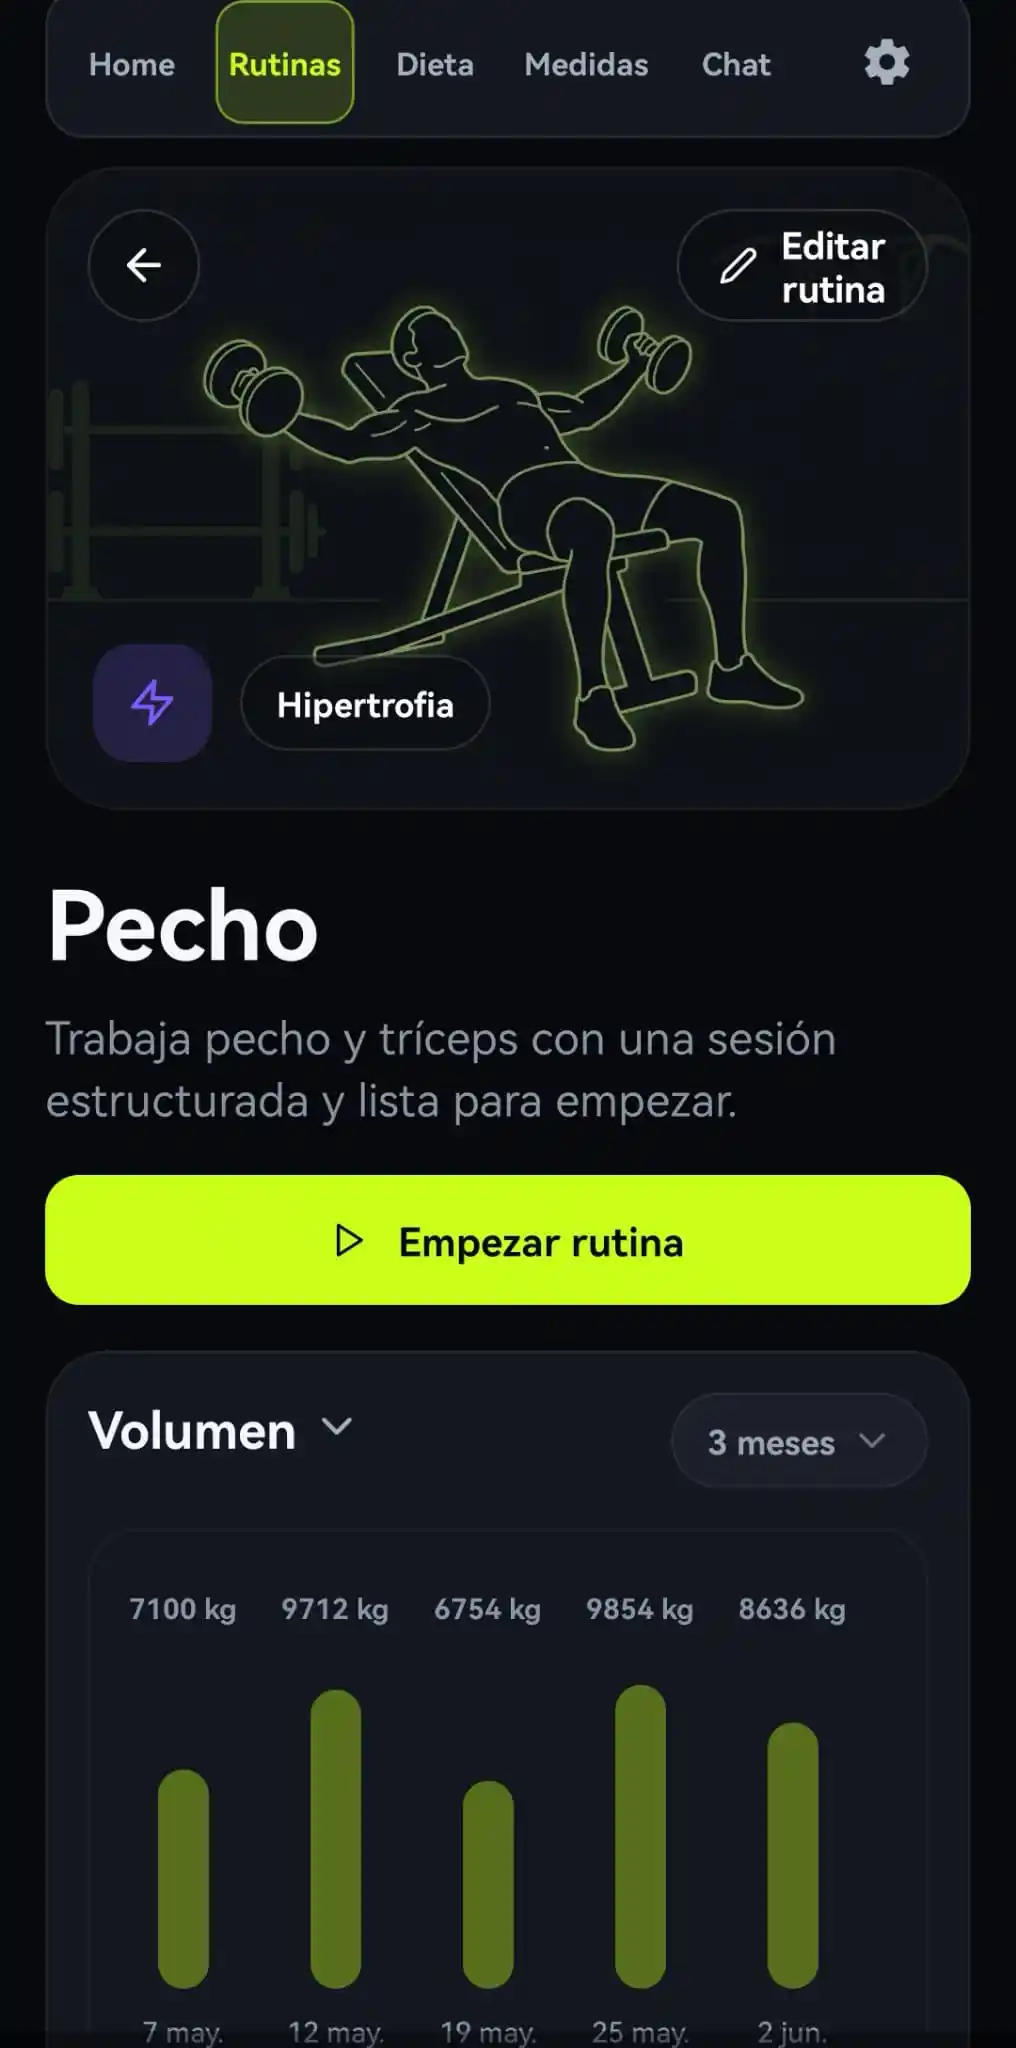
Como exemplo, um agente para um aplicativo de academia pode precisar lembrar dados pessoais, consultar medidas, registrar refeições e criar rotinas. A seguir está a definição de uma tool, read_measurement:
{
  name: "read_measurement",
  description:
    "Lee las medidas corporales del usuario para una fecha específica. " +
    "Devuelve el registro de medidas de ese día si existe. " +
    "Usa esta tool cuando el usuario pregunte por sus medidas de un día concreto.",
  inputSchema: {
    type: "object",
    properties: {
      date: stringProperty("Fecha en formato YYYY-MM-DD")
    },
    required: ["date"]
  }
}
É possível entender o contrato sem conhecer o restante da tool: o nome conecta a chamada à sua ação, a descrição dá ao modelo um critério de escolha e o schema exige uma data.
As 15 tools do Gymnasia
No total, aparecem 15 declarações com formato de tool. Treze pertencem ao agente conversacional principal; as outras duas apoiam um fluxo especializado em estimar refeições. Agrupá-las por finalidade permite entender cada capacidade sem conhecer as telas ou a estrutura interna do Gymnasia.
Memória pessoal
save_personal_dataSalva ou atualiza o perfil que o agente deve lembrar.list_personal_data_keysLista os tipos de dados pessoais disponíveis sem ler seus valores ainda.read_field_descriptionExplica o significado de um campo de memória para permitir a escolha correta.read_field_valueRecupera o valor de um campo depois que ele foi identificado.
Medidas corporais
read_measurementConsulta as medidas registradas em uma data específica.write_measurementSalva ou atualiza as medidas fornecidas pela pessoa.
Alimentação
read_meal_foodsLê os alimentos registrados em uma refeição e uma data.search_foodsBusca alimentos por nome, categoria ou valores nutricionais.add_meal_foodAdiciona a uma refeição um alimento já identificado.
Treinamento
search_exercisesBusca exercícios por músculo, equipamento ou dificuldade.read_routinesRecupera as rotinas de treinamento salvas.create_routineCria uma rotina com exercícios e séries específicos.
Melhorias do produto
create_feature_issueCria no GitHub uma issue estruturada a partir de um pedido de melhoria do usuário.
Estimativa de refeições
scan_barcodeConsulta um código de barras para recuperar os dados nutricionais de um alimento; é uma ação executável de um fluxo especializado.extract_nutritionPede à Anthropic uma resposta nutricional com uma estrutura específica. Tem formato de tool, mas funciona como mecanismo de saída estruturada e não possui handler local.
Uma dessas tools é diferente das demais: create_feature_issue não altera a aplicação nem os dados salvos pelo usuário. Seu único efeito acontece fora do Gymnasia, onde cria uma issue no GitHub. Assim, se alguém quiser sugerir uma melhoria, basta pedi-la ao agente; o LLM identifica a solicitação e pede ao harness que execute essa tool com as informações necessárias para registrar a proposta.
Portanto, há 15 declarações: 14 representam ações executáveis e uma, extract_nutrition, é usada para obter JSON estruturado.
A descrição também é prompt
Uma tool pode estar perfeitamente implementada e ainda assim ser inútil se o modelo não souber que ela existe. A description é um texto visível para o LLM: ela faz parte do contexto usado para decidir entre responder diretamente ou solicitar essa tool.
Uma descrição fraca como "Lê medidas" deixa perguntas sem resposta. Ela lê o registro mais recente ou o de uma data? O que retorna quando não há dados? Deve ser chamada para uma pergunta geral sobre treinamento? Uma boa descrição responde a quatro perguntas:
Descreva uma ação concreta, não o nome de uma tela ou módulo.
Dê ao modelo um sinal reconhecível na solicitação do usuário.
Antecipe o dado que o modelo receberá para continuar raciocinando.
Indique pré-condições, limites e a ordem entre tools.
O último ponto é importante em qualquer domínio. Se uma tool adiciona um item selecionado e outra procura candidatos, a descrição deve dizer para buscar primeiro e adicionar depois. O modelo não consegue deduzir essa dependência a partir de comentários internos que nunca recebe.
Como o system prompt e as tools chegam ao LLM
A descrição de cada tool não substitui o system prompt. No Gymnasia, o system prompt define o papel geral do agente e regras que abrangem várias tools. Por exemplo, uma regra de alimentação pode indicar esta sequência:
## Tools de alimentação
Quando a pessoa pedir para adicionar um alimento:
1. Use search_foods para encontrar o alimento exato.
2. Use add_meal_food com o resultado selecionado.
Antes de chamar o provedor, esse prompt base é completado com políticas locais. As definições das tools não são concatenadas dentro desse texto: elas viajam no campo tools da mesma solicitação. O provedor apresenta as duas partes ao modelo para que as regras gerais e os contratos concretos trabalhem juntos.
name + description + schemasDe forma simplificada, a solicitação da OpenAI fica assim:
const systemPrompt = composeAiSystemPrompt(basePrompt);

const request = {
  instructions: systemPrompt,
  tools: CHAT_TOOLS.openai,
  input: messages
};
A OpenAI chama esse campo de instructions; a Anthropic usa system e o Google, systemInstruction. Os nomes mudam, mas a ideia é a mesma: o prompt define o comportamento global e cada definição explica uma capacidade concreta.
Três provedores, uma definição
Por enquanto, o Gymnasia pode usar suas tools com OpenAI, Anthropic e Google. Outros provedores serão adicionados, por isso a lista central não depende de nenhum deles: oferecer suporte a outro provedor deve exigir um novo adaptador, não a redefinição de todas as tools.
Um harness pode permitir a troca de modelo sem alterar as capacidades do agente. A complicação é que OpenAI, Anthropic e Google envolvem o mesmo contrato com estruturas diferentes. Mantenha uma definição neutra e crie um pequeno adaptador para cada API.
Adiciona type: "function" e coloca o schema em parameters.
Recebe nome e descrição diretamente, com o schema em input_schema.
Agrupa as declarações em functionDeclarations e usa parameters.
const providerTools = {
  openai: definitions.map(tool => ({
    type: "function", name: tool.name,
    description: tool.description, parameters: tool.inputSchema
  })),
  anthropic: definitions.map(tool => ({
    name: tool.name, description: tool.description,
    input_schema: tool.inputSchema
  })),
  google: [{ functionDeclarations: definitions.map(tool => ({
    name: tool.name, description: tool.description,
    parameters: tool.inputSchema
  })) }]
};
O invólucro muda, mas o significado não. Se uma descrição for melhorada ou um campo obrigatório for adicionado, os três provedores receberão a mesma alteração. Manter três listas manualmente transforma cada correção em uma possível fonte de divergência.
O contrato comum do exemplo se limita aos campos que os três provedores aceitam bem. Um outputSchema pode ser adicionado à definição interna quando for útil, mas cada adaptador deve tratá-lo de acordo com sua API: o Google aceita um schema de resposta, o MCP define outputSchema como opcional e outros formatos devolvem texto ou JSON sem esse campo na declaração da tool.
Da definição à execução
Declarar uma tool não implementa a ação. O provedor devolve apenas uma proposta parecida com { name: "read_measurement", arguments: { date: "2026-08-18" } }. O harness mantém o controle e decide o que acontece em seguida.
- 1
Ler o nome e os argumentos da chamada feita pelo modelo.
- 2
Verificar se o nome é permitido e localizar seu handler.
- 3
Validar tipos, campos obrigatórios, permissões e regras de negócio.
- 4
Executar o código da aplicação, em Python, JavaScript, TypeScript ou outra linguagem, e serializar o resultado.
- 5
Enviar esse resultado ao modelo para que ele continue e escreva uma resposta útil.
O handler pode estar em um servidor, em uma função edge ou no dispositivo do usuário. No Gymnasia ele roda no celular porque os dados são local-first e não precisam de backend. A lição geral é a mesma: o modelo solicita uma ação, enquanto o harness valida, autoriza e executa o código.
Testes contra divergências
A divergência aparece quando uma camada muda e as demais não: uma tool é declarada sem handler, um argumento obrigatório é adicionado para apenas um provedor ou o código em runtime aceita um tipo diferente do schema publicado. Os testes devem cobrir o contrato completo, não apenas funções isoladas.
Nomes únicos, descrições significativas e schemas do tipo objeto.
Um validador compatível com JSON Schema verifica se cada schema é válido e se required corresponde a properties.
O catálogo, os handlers e os adaptadores dos provedores contêm as mesmas tools.
Argumentos ausentes ou com tipo incorreto produzem erros controlados.
Valores arbitrários nunca fazem o validador falhar de forma inesperada.
Um provedor falso confirma chamada, execução, resultado e resposta final.
for (const tool of tools) {
  expect(() => schemaValidator.compile(tool.inputSchema)).not.toThrow();
}
A biblioteca compatível com JSON Schema escolhida não importa; o importante é compilar cada contrato nos testes e falhar antes que uma definição inválida chegue à produção. O objetivo não é testar se o provedor é “inteligente”, mas se a ponte construída ao redor do modelo é coerente.
Aprender a criar um agente completo
Este artigo faz parte de uma série sobre como desenvolver um agente ou harness de ponta a ponta. O Gymnasia, um aplicativo de academia, é o exemplo prático usado para estudar memória, tools, provedores, execução local, avaliação e segurança; cada publicação é escrita para que essas ideias possam ser aplicadas a outros produtos.