O que é o Gymnasia
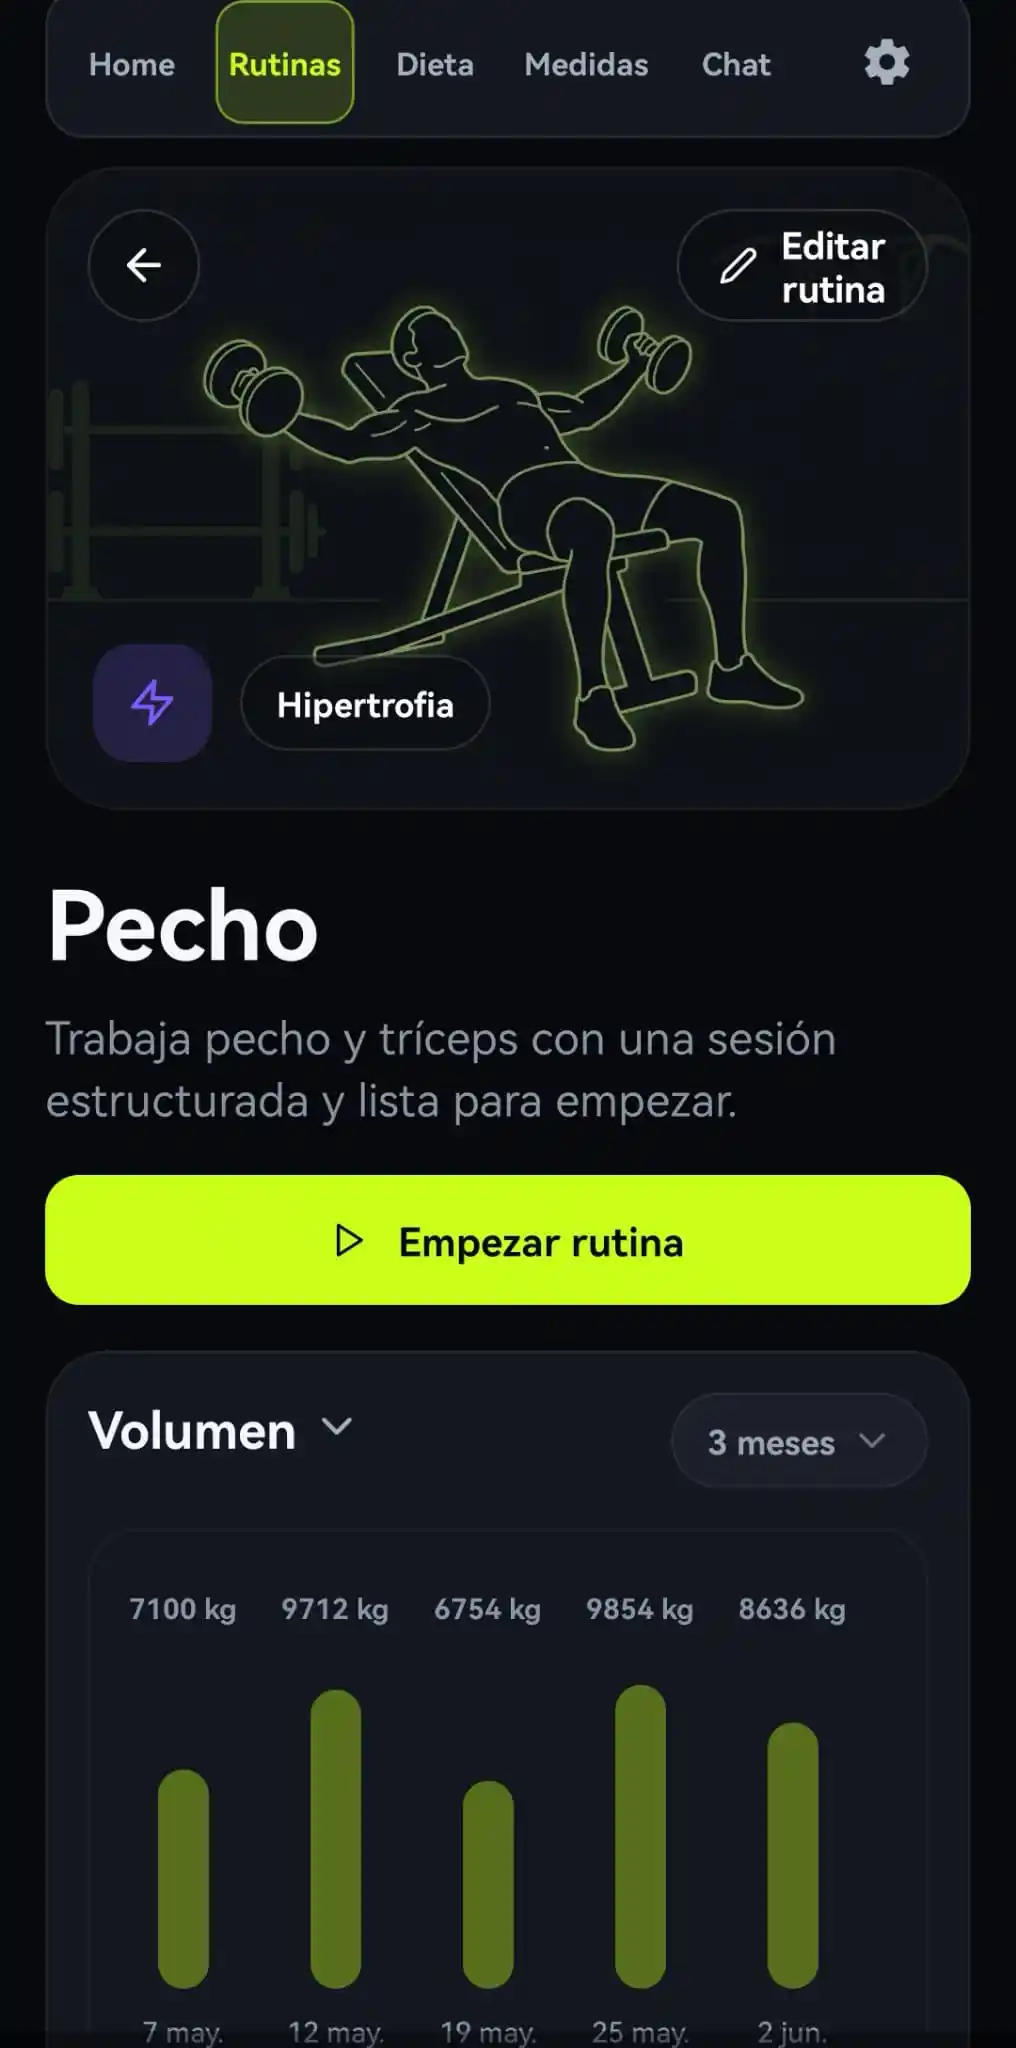
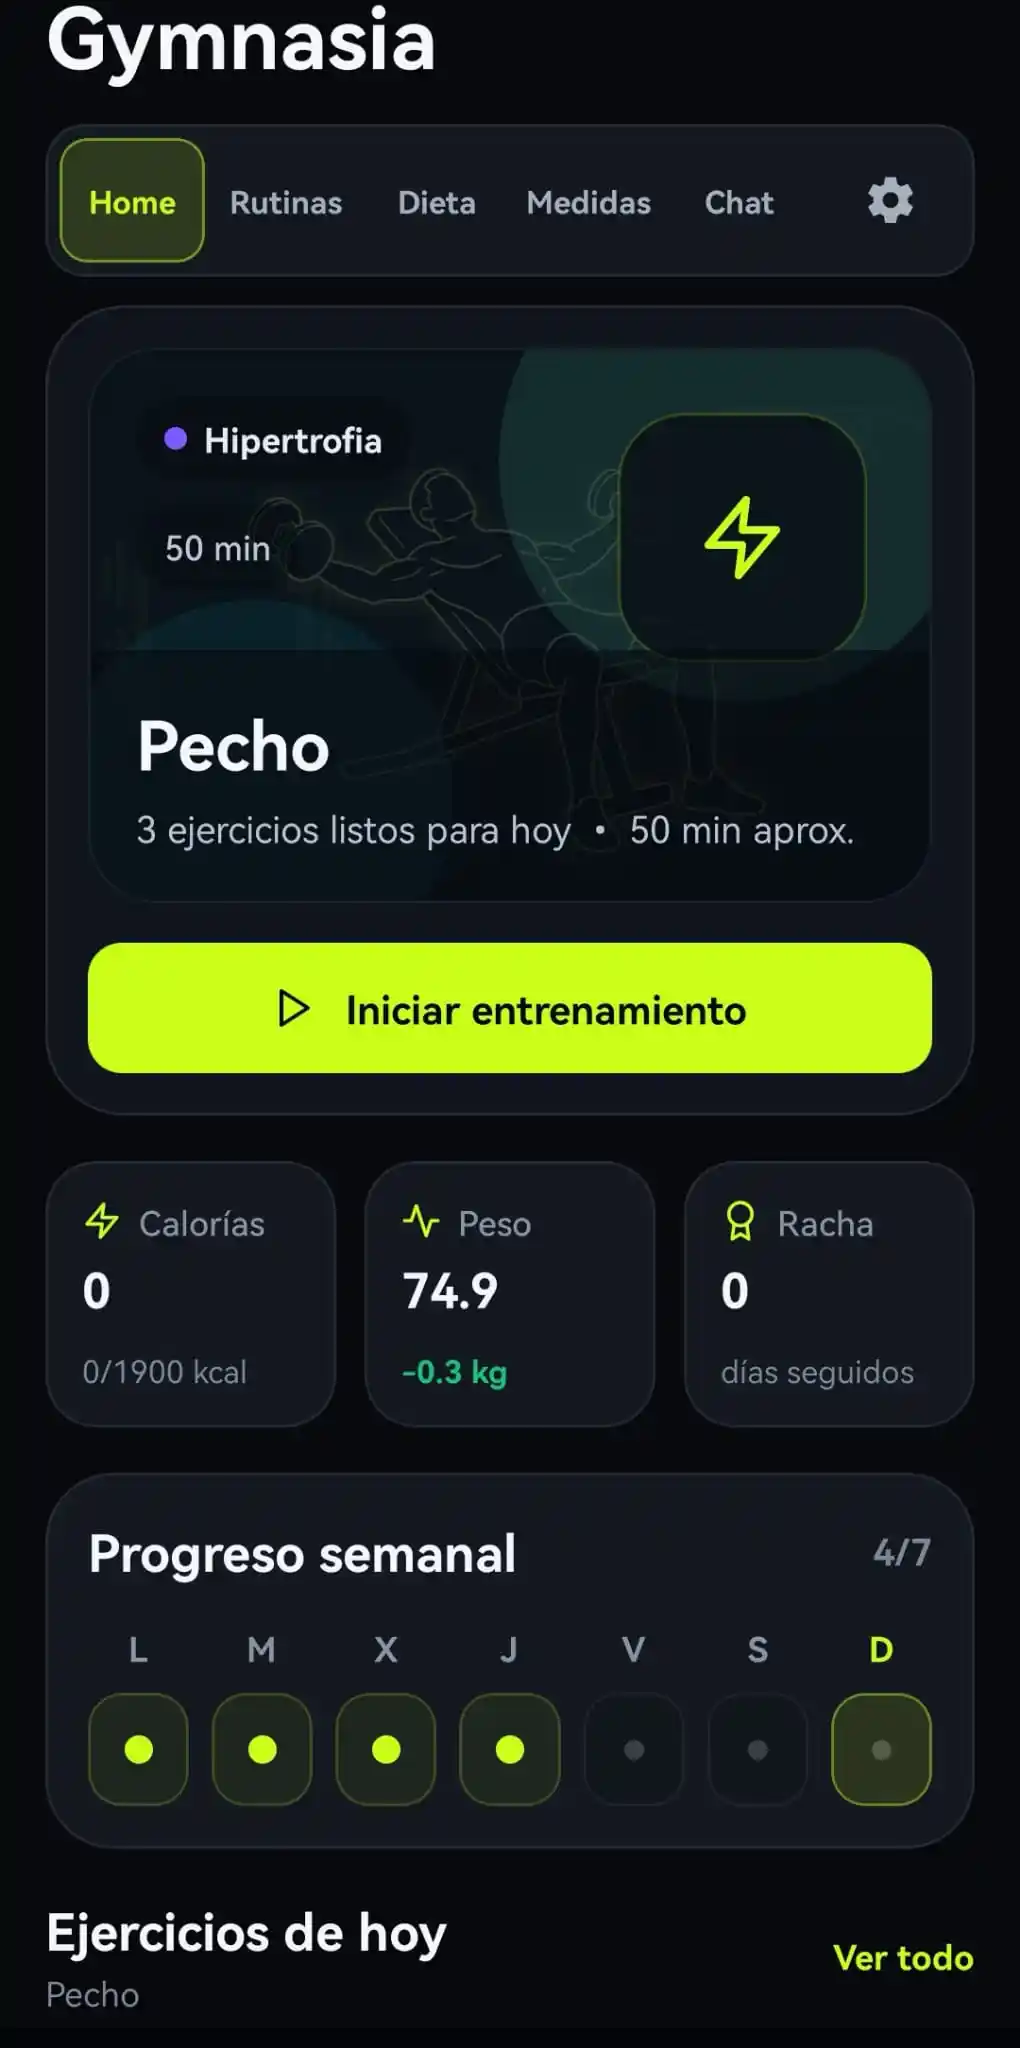
O Gymnasia é um aplicativo móvel de treino pessoal feito com React Native e Expo. Dentro dele há dois agentes de IA: um coach conversacional e um estimador de refeições que calcula calorias e macronutrientes a partir de fotos.
Eles funcionam em paralelo, e não um dentro do outro: nenhum é subagente do outro, não se chamam entre si, vivem em telas diferentes e cada um tem o seu próprio system prompt, as suas próprias tools e o seu próprio fornecedor de LLM. Compartilham exatamente uma coisa: os dados do usuário guardados no celular.
O interessante, e o assunto deste post, é que os dois são executados inteiramente no dispositivo. Não existe backend próprio: quem decide o que fazer, quem executa as tools e quem guarda os dados é o próprio app, dentro do celular. O modelo é chamado direto de lá com uma chave de API fornecida pelo usuário, o que costuma se chamar BYOK, Bring Your Own Key: cada usuário traz a sua própria chave e, com ela, paga e controla o seu acesso ao fornecedor. Os dados do usuário nunca saem do celular, com uma única exceção explicada mais abaixo.
Este é o post principal da série. Abaixo estão os dois grafos de arquitetura e, no final, o índice da série com os posts que cobrem cada parte do desenvolvimento.
O agente geral: Gymnasia Coach
Deslize o grafo na horizontal para o ver inteiro.
O Gymnasia Coach é o agente conversacional geral do app. É um agente BYOK: o utilizador configura a chave de API do fornecedor de LLM que preferir, e o app chama esse fornecedor diretamente a partir do dispositivo. Não existe backend próprio: a orquestração, a execução das tools e o armazenamento acontecem dentro do próprio app.
Configuração e escolha de fornecedor
O utilizador guarda a sua API key
Guarda a chave dos fornecedores que quiser e escolhe qual atende o chat. O chat e o estimador de refeições configuram-se em separado: cada um pode usar um fornecedor diferente.
O prompt não viaja dentro do app
O system prompt é descarregado de um ficheiro público no repositório, guardado em cache local, e recorre a uma cópia embutida se a rede falhar.
Isto último não é um capricho de arquitetura, é uma válvula de segurança. Se um dia o agente anda a dizer barbaridades como «passa uma semana sem comer para baixar a gordura» e coisas assim, quero poder corrigir as instruções, ou seja, o system prompt, o mais depressa possível, não daqui a duas semanas, e muito menos dependendo de cada usuário se lembrar de atualizar o app. Com o prompt remoto, corrigir é editar um ficheiro de texto: a mensagem seguinte que qualquer pessoa enviar já vai com a versão corrigida. A cópia embutida existe apenas para o app continuar a funcionar sem ligação.
O preço é que esse ficheiro passa a ser uma entrada de confiança para todos os usuários ao mesmo tempo, por isso tem de ser tratado como código: revisto, versionado e com cache.
Chamada ao fornecedor
O app não fala com um fornecedor concreto, fala com «o fornecedor da vez». Hoje há três suportados, e a lista foi pensada para crescer:
Cada fornecedor tem o seu próprio adaptador de request/response, porque os formatos de tools, de streaming e de blocos de conteúdo são diferentes em cada um. Adicionar um fornecedor novo é escrever mais um adaptador, não mexer no agente: todos partilham o mesmo laço agentic que vem a seguir.
Laço agentic (tool use)
O modelo responde
Texto em streaming e/ou blocos tool_use / function_call.
O app executa a tool
O modelo não executa nada: só pede. Quem executa é o app, em local e sobre os seus próprios dados.
Resultado → modelo
É reinjetado como tool_result / function_call_output. Repete-se até não pedir mais tools.
As tools
O coach mexe sim nos dados do utilizador: lê-os e escreve-os. Pode apontar o peso de hoje, adicionar um alimento a uma refeição ou criar uma rotina inteira. O que não pode é sair daí: a sua capacidade de agir é exatamente a lista de tools declaradas, nem mais uma. Estão agrupadas em quatro famílias, e todas são executadas dentro do celular.
🧠 Memória pessoal
Ler e guardar o que o utilizador conta sobre si: objetivo, lesões, preferências. É o que faz o coach lembrar-se de uma conversa para a seguinte.
🍽️ Dieta
Procurar alimentos no catálogo que vem com o app, ler o que já foi comido numa data e adicionar alimentos a uma refeição.
🏋️ Treino
Procurar exercícios por músculo, equipamento ou dificuldade, ler as rotinas do utilizador e criar rotinas novas.
📏 Medidas
Ler e escrever medidas corporais por data: peso, percentagem de gordura, perímetros.
create_feature_issue
A única tool que sai do dispositivo: quando o utilizador pede uma melhoria do app, abre um issue no repositório. É o único ponto por onde algo escrito no chat acaba fora do celular, e por isso está separada das restantes.
Como se declara cada uma destas tools, nome, descrição, esquema de argumentos, e como esse catálogo é traduzido para o formato que cada fornecedor espera dá para um post inteiro, e tem um: Como declarar tools confiáveis para OpenAI, Anthropic e Google.
Armazenamento e saída
Tudo no dispositivo
Dieta, rotinas, medidas e dados pessoais vivem no armazenamento local do celular. Os catálogos de alimentos e exercícios são ficheiros estáticos empacotados com o app.
A criação de issues
Único ponto de saída para um serviço externo diferente do fornecedor de LLM: create_feature_issue.
O segundo agente: o estimador de refeições
Deslize o grafo na horizontal para o ver inteiro.
O estimador de refeições tira calorias e macros de uma foto do prato. Não é um subagente do coach: o coach nunca o chama, nem sabe que ele existe. É um segundo agente, com o seu próprio system prompt, a sua própria tool e a sua própria escolha de fornecedor, que se abre a partir de outra tela e escreve nos mesmos dados locais.
Entrada
1–6 fotos da refeição
Câmara ou galeria. Também aceita texto (perguntas de seguimento sobre a estimativa), reutilizando o contexto da conversa.
O seu próprio fornecedor
O estimador não herda o fornecedor do chat: escolhe-se à parte, nas definições. E faz sentido que assim seja, porque os dois agentes não competem pela mesma coisa. Ao coach pede-se raciocínio sobre texto; ao estimador pede-se olhar para uma foto.
Se o utilizador não mexer em nada, o estimador arranca com o fornecedor que hoje dá melhor relação custo/qualidade em visão, e só procura outro se essa chave não estiver configurada. A lição geral: a escolha de modelo é por tarefa, não por app. Assim que um produto tem dois usos de IA com perfis de custo diferentes, prendê-los ao mesmo fornecedor é pagar a mais no caro ou render menos no barato.
System prompt especializado
Nutricionista visual
Estima sempre kcal, proteína (g), hidratos de carbono (g), gordura (g) e peso total (g). Dá intervalos se houver incerteza.
Classificação
Determina se é producto_comercial, receta ou alimento base genérico.
Saída estruturada
Se o utilizador pedir "Devuelve json", responde apenas com JSON: dish_name, calories_kcal, protein_g, carbs_g, fat_g.
Laço agentic com o código de barras
Há um código de barras na foto?
O prompt obriga o modelo a usar a tool se detetar um EAN/UPC em qualquer das imagens.
scan_barcode(barcode)
Chama o OpenFoodFacts (API pública) com o código lido e devolve dados nutricionais exatos do produto.
Produto comercial confirmado
Se foi usado scan_barcode, a classificação é sempre producto_comercial, com dados exatos em vez de estimados.
Tal como no coach, o resultado da tool é reinjetado no modelo e o laço repete-se, com um máximo de 5 rondas, até obter uma resposta final. Esse limite não é decorativo: sem ele, um modelo que insista em chamar a mesma tool fica a dar voltas e a gastar tokens do utilizador.
Persistência do resultado
Confirmação do utilizador
A estimativa é mostrada primeiro em linguagem natural. Só quando o utilizador a aceita é pedida uma segunda resposta, desta vez em JSON, e feito o parse.
add_meal_food
É adicionado à dieta local do dia e refeição selecionados, nos mesmos dados que o coach usa.
Variante: estimativa manual
O utilizador descreve um alimento por texto
Fluxo conversacional: o utilizador nomeia o alimento, o modelo pergunta ingredientes e quantidades em falta, calcula valores por 100 g ou unidade, o utilizador confirma e devolve o JSON para guardar no catálogo de alimentos.
A série
Este post é a capa. Cada parte do desenvolvimento do agente tem o seu próprio post, e todos são ligados a partir daqui.
- Como declarar tools confiáveis para OpenAI, Anthropic e Google: criar tools que um LLM consiga descobrir, adaptá-las a qualquer fornecedor, executá-las com segurança e protegê-las com testes.
- Como parsear tool calls da OpenAI, Anthropic e Google: transformar três dialetos de resposta em uma execução comum sem perder os identificadores de correlação.
Entretanto, a página do projeto está em maximofn.com/pt-br/gymnasia e o código é aberto, no GitHub.