Quería usar Qwen Image 2.1 en wallabot, un ordenador de sobremesa que uso como servidor de inteligencia artificial, desde una interfaz cómoda. Generar una imagen era solo el principio: también quería editar referencias, conectar nodos y aprovechar las herramientas que la comunidad estaba publicando.
Este proyecto continúa el trabajo que conté en Qwen3.8-27B en local con dos RTX 3090: vLLM, MTP y API privada. Allí expliqué cómo instalé el modelo de texto en wallabot, comparé motores y configuré el servicio bajo demanda con Home Assistant y acceso privado por Tailscale. Para Qwen Image 2.1 seguí el mismo enfoque: medir primero en mi hardware y después integrar el modelo en el servidor. No hace falta haber leído aquel artículo: aquí explico el equipo y las decisiones necesarias para seguir este proyecto desde cero.
Partí de los Spaces oficiales de generación y edición y workflow. Un Space es una aplicación alojada en Hugging Face, una plataforma donde se comparten modelos y demostraciones de IA. Gradio es la biblioteca de Python que convierte las funciones de generación en una web con botones, formularios e imágenes. También crea una API.
Primero, medir en mi hardware
Qué ordenador utilicé y por qué importa
Wallabot ejecuta Ubuntu. Tiene un procesador AMD Ryzen 5 3600, 32 GiB de RAM y dos tarjetas gráficas NVIDIA RTX 3090.
Cada RTX 3090 tiene 24 GiB de VRAM. Las dos no se convierten automáticamente en una tarjeta de 48 GiB: hay que repartir el trabajo y respetar lo que cabe en cada una. Las GPU se conectan a la placa base por PCI Express, abreviado PCIe, el enlace por el que intercambian datos con el resto del ordenador. En este montaje una usa 16 carriles de comunicación, x16, y la otra cuatro, x4. Eso limita de forma distinta el intercambio de datos; no significa que una imagen tarde exactamente cuatro veces más en una tarjeta.
No hay un puente NVLink, una conexión física directa entre tarjetas. Tampoco obtuve acceso directo de una GPU a la memoria de la otra, llamado P2P. Por eso importaba decidir qué parte del modelo ejecutaba cada tarjeta y cuántos datos tenían que moverse entre ellas.
Durante las pruebas limité cada GPU a 150 W, frente a su límite habitual de 350 W. Los vatios indican potencia: cuánto puede consumir en ese momento. Ese techo limita la potencia que puede utilizar la tarjeta y ayuda a controlar el calor; no fija el consumo total del ordenador en 300 W, porque también funcionan el procesador, los discos y la refrigeración. Ejecuté un modelo cada vez y separé el tiempo de cargar sus archivos en memoria del tiempo de generar la imagen.
Qué cambia entre las seis variantes del modelo
Un modelo almacena lo que ha aprendido en millones de números, llamados pesos. Esos números ocupan espacio en el disco y en memoria. Cuantizar consiste en representar parte de ellos con menos bits, aproximando sus valores para que ocupen menos. Un bit es la unidad mínima de información digital. Reducir la precisión puede cambiar la imagen y exige software compatible; no garantiza por sí solo más velocidad.
Comparé la versión original y cinco distribuciones alternativas. Unsloth, BennyDaBall, ModelsLab y abenzerps son los autores o equipos que publican esas conversiones. Los nombres que aparecen en la tabla indican cómo se guardan o se utilizan los números del modelo:
- Original BF16: la versión de referencia de Qwen. BF16, abreviatura de bfloat16, representa los pesos con números de 16 bits. La usé para comprobar el funcionamiento sin añadir una conversión a 8 o 4 bits. Necesita más memoria para los mismos pesos; además hay que reservar espacio para los cálculos temporales.
- Unsloth FP8: utiliza representaciones de 8 bits para reducir el espacio de los pesos convertidos. FP significa floating point, o coma flotante: una manera de representar números con un rango amplio. En mis RTX 3090, el programa adapta esos pesos para calcular con una precisión compatible; estas tarjetas no ejecutan las multiplicaciones FP8 de forma nativa. El ahorro de memoria y la velocidad tienen que medirse por separado.
- BennyDaBall NVFP4: usa un formato de NVIDIA que guarda grupos de pesos con valores de 4 bits y escalas auxiliares para interpretarlos. En el ensayo conservé ese almacenamiento y descomprimí los valores para calcular en las RTX 3090, que no tienen cálculo FP4 nativo. No quiere decir que todos los componentes del modelo ocupen cuatro bits ni que el consumo total de memoria sea una cuarta parte del original.
- ModelsLab NVFP4 W4A4: propone 4 bits tanto para pesos, W, de weights, como para activaciones, A, los resultados intermedios que pasan entre capas del modelo, en su componente de generación. Su motor Nunchaku utiliza rutinas de cálculo que requieren tarjetas de la generación Blackwell. Mis RTX 3090 pertenecen a una generación anterior, Ampere, así que rechacé esta variante por incompatibilidad. No llegué a generar imágenes con ella.
- Unsloth GGUF Q4_K_M: GGUF es un formato de archivo que empaqueta pesos y la información necesaria para cargarlos. No es una precisión por sí mismo: hay GGUF con distintas cuantizaciones. Elegí Q4_K_M, una receta que usa principalmente 4 bits por peso, con bloques y precisiones distintas según la parte. Lo ejecuté con un cargador GGUF en ComfyUI; los componentes de interpretación de referencias y conversión final de imagen siguieron en BF16.
- abenzerps GGUF Q4_K_M: otra distribución en GGUF, probada con la misma familia de cuantización. Su autor la llama «Uncensored» y describe la ausencia de un comprobador de contenido incorporado. Esa etiqueta no describe una mejora de precisión o velocidad. Mis pruebas usaron escenas e instrucciones benignas, así que no verifican esa propiedad ni permiten afirmar que se comporte igual en cualquier programa.
Cada variante ejecutable pasó nueve casos: una prueba inicial pequeña de 512 × 512 píxeles, generación a 1024 × 1024, repetición de la misma semilla, otra semilla, texto en español, transparencia, edición con una imagen de referencia, edición con dos y generación a 2048 × 2048. La semilla es el número que inicializa el ruido aleatorio del que parte la generación; repetirla ayuda a comparar resultados con los mismos ajustes. Los pasos son las iteraciones con las que el modelo va refinando la imagen. Usé 40 en los casos principales. Llamo 1K a 1024 × 1024 y 2K a 2048 × 2048 píxeles; 2K tiene cuatro veces más píxeles, no dos.
| Variante | Carga | Generar 1K | Editar 1K | Generar 2K | VRAM GPU 0 / 1 | GPU Wh / 1K |
|---|---|---|---|---|---|---|
| Original BF16 | 33,0 | 173,2 | 215,3 | 988,2 | 19,01 / 20,68 | 10,48 |
| Unsloth FP8 | 20,1 | 162,8 | 187,0 | 738,1 | 9,88 / 13,26 | 8,47 |
| BennyDaBall NVFP4 | 16,3 | 126,1 | 165,8 | 723,3 | 8,62 / 10,52 | 6,70 |
| ModelsLab W4A4 | Incompatible con este hardware. No hay tiempos de inferencia. | |||||
| Unsloth GGUF Q4_K_M | 17,9 | 109,3 | 133,4 | 472,5 | 10,49 / 17,52 | 5,94 |
| abenzerps GGUF Q4_K_M | 16,8 | 111,4 | 136,0 | 473,1 | 10,86 / 17,52 | 6,23 |
Un valor menor indica menos tiempo en este ensayo. No es una puntuación de calidad.
Los números necesitan contexto
Los Wh, o vatios-hora, miden energía acumulada: cuánto se ha consumido durante un intervalo. Por ejemplo, mantener 100 W durante una hora consume 100 Wh. Tomé muestras de potencia de las dos GPU aproximadamente cada dos segundos y sumé su consumo a lo largo de cada generación. No medí el consumo en el enchufe. Esa cifra no incluye todo lo que gastan el ordenador y sus fuentes de alimentación.
Cómo vigilé el ordenador durante las pruebas
Wallabot tiene refrigeración líquida para el procesador y para las dos GPU: tres circuitos, cada uno con una bomba que hace circular el líquido y un radiador que transmite su calor al aire. Cada radiador de GPU tiene tres ventiladores; el de CPU, uno. Otros tres ventiladores introducen aire fresco en la caja: son diez ventiladores en total, además de las tres bombas. Los radiadores expulsan el aire caliente por el techo, el suelo y la parte trasera.
El ordenador se alimenta mediante dos fuentes: una principal para la placa y el resto del equipo, incluida la GPU superior, y otra para la alimentación auxiliar de la GPU inferior. Una fuente convierte la electricidad de la red en las tensiones que necesitan los componentes. Ambas reciben alimentación a través de un SAI, un sistema de alimentación ininterrumpida: una batería con electrónica que mantiene el equipo encendido durante un corte. El mío es un CyberPower CP1500EPFCLCD, con capacidad nominal de 900 W, y comunica su estado al ordenador por USB.
No quería elegir un modelo solo porque acabara antes. Registré estos datos para saber también si el equipo seguía en condiciones de trabajar:
- Temperaturas: lecturas de los sensores de las GPU, en grados Celsius. La carga de IA genera calor; la vigilancia permite detener el ensayo si las tarjetas superan el límite fijado. Un sensor no mide necesariamente todos los puntos calientes ni todos los picos breves.
- RAM y VRAM: cuánto espacio ocupaban los programas en la memoria general y en cada tarjeta. La columna GPU 0 / 1 muestra por separado las dos tarjetas tal como estaban numeradas en el ensayo; no es un depósito común de memoria.
- Estado del SAI: si funcionaba con la red eléctrica o con batería, el porcentaje de batería y su carga. Aquí «carga» significa la fracción de su capacidad de potencia utilizada, no la batería restante. No utilicé ese porcentaje como una medición precisa del consumo en el enchufe.
- Bombas: sus señales de giro disponibles, expresadas en RPM, revoluciones por minuto. Observé una bomba de GPU y la de CPU; no tenía una lectura independiente de las tres. Ver girar una bomba no demuestra por sí solo que el líquido circule correctamente ni informa de las RPM de todos los ventiladores.
- Errores del controlador: mensajes del software de NVIDIA que permite al sistema operativo comunicarse con las GPU. Busqué fallos de cálculo o pérdidas de acceso a una tarjeta, además de comprobar que las imágenes se generasen.
Las guardas exigían ambas GPU presentes y por debajo de 80 °C, SAI funcionando con la red eléctrica, al menos 80 % de batería, carga del SAI no superior al 80 % y señales de las bombas observadas de al menos 2000 RPM. Son límites elegidos para esta instalación, no requisitos universales para usar Qwen. Si una GPU desaparecía, el ensayo se detenía y no se admitía otra carga sin confirmar la limpieza.
La primera generación 1K se ejecutó después de la prueba inicial pequeña. Por tanto, su tiempo no representa un arranque completamente frío: parte del software y de los datos ya podía estar preparada.
Para ejecutar BF16 usé Diffusers, una biblioteca de Python para modelos de imagen. Para las variantes cuantizadas usé ComfyUI, que organiza la generación en operaciones conectadas. Son motores de ejecución distintos. Además, para los GGUF invertí el reparto de tareas entre las tarjetas. La tabla compara estas configuraciones completas: no permite atribuir cada diferencia de tiempo únicamente a reducir los bits de los pesos. Por eso tampoco copié a mi tabla tiempos de una GPU Blackwell publicados por otro autor.
La generación tiene varias partes: el encoder convierte las instrucciones y referencias en representaciones que el modelo puede procesar; el DiT es el componente que refina la imagen durante los pasos; el VAE convierte la representación interna final en los píxeles que vemos. Repartirlas entre tarjetas permite alojar el conjunto, pero también obliga a transferir sus resultados.
Qué cambió al invertir las GPU
Al colocar el encoder en GPU 1 y DiT/VAE en GPU 0, repetí generación y edición con FP8 y Benny. A 1K y 40 pasos, FP8 pasó a 102,1 s y Benny a 88,5 s; la edición fue de 126,1 s y 113,3 s, respectivamente. Son ensayos posteriores, separados de la tabla inicial, sin vaciar la caché de archivos.
Esto me enseñó que la colocación del trabajo importa. No podía elegir un formato mirando solo el tamaño del archivo o mezclando resultados de distribuciones diferentes.
También hubo dos bloqueos reales
Durante una edición con NVFP4 Benny y otra con GGUF Unsloth apareció Xid 79: el sistema dejó de poder comunicarse con una GPU a través de su enlace PCIe. NVIDIA identifica ese código como pérdida de la GPU del bus, la vía de comunicación entre componentes. Es un síntoma; el mensaje por sí solo no identifica la pieza o condición que lo provocó (catálogo Xid de NVIDIA).
Después llegaron los aceleradores Turbo
Después añadí Viggle v0.3, Turbo8 e isHeSatoshi, adaptadores LoRA sobre la base BF16. Un LoRA es un conjunto adicional de pesos que modifica el comportamiento del modelo sin sustituir todos sus archivos. En estos perfiles Turbo se usa para obtener imágenes con menos pasos. Cada uno tiene una receta de ejecución, pasos y otros ajustes, así que no basta con cambiar el archivo del adaptador y dejar los parámetros del anterior.
| Perfil | Pasos | Generación | Edición | GPU Wh / generación |
|---|---|---|---|---|
| Viggle v0.3 | 6 | 28,31 s | 37,13 s | 1,771 |
| Turbo8 | 8 | 35,11 s | 46,02 s | 1,934 |
| isHeSatoshi r128 | 6 | 26,73 s | 35,47 s | 1,614 |
La reducción de tiempo fue útil para trabajar desde la web. La fidelidad merece una evaluación aparte: algunas ediciones alteraron texturas o el fondo y aparecieron artefactos finos. Menos pasos no demuestra una calidad equivalente a la base.
Convertirlo en un servicio de wallabot
Separé la interfaz, la web que se ve en el navegador, del motor, el programa que carga los pesos y genera imágenes. Gradio no tiene acceso directo a las GPU: envía las operaciones a un broker, un coordinador que comprueba si se pueden ejecutar y reserva las tarjetas. Se comunican por un socket Unix, un canal local entre procesos del mismo ordenador que no necesita abrir un puerto de red. Una pasarela separada ofrece las órdenes que utiliza Home Assistant, mi sistema de automatización doméstica, para mostrar el estado y controlar el modelo desde su panel.
Home Assistant llega a la pasarela de control con su autorización propia.
El broker es una pieza específica de mi instalación. Clonar el repositorio público del Space no reproduce por sí solo ese servicio local; la rama autohospedada necesita un broker instalado y configurado por separado. Utilicé contenedores Docker, entornos que separan los procesos y permiten limitar sus recursos y archivos accesibles. La interfaz queda en una red interna de contenedores, sin acceso directo desde fuera ni GPU. El código y los pesos se presentan en solo lectura para impedir que la generación los modifique; las imágenes producidas van a otra carpeta. systemd, el gestor de servicios de Linux, mantiene en marcha broker, web y pasarela. Para las tareas administrativas usé tmux, que conserva una terminal aunque se desconecte la sesión remota. Introduje yo la contraseña para obtener permisos de administrador, sin guardarla en scripts.
La reserva se comparte con el gestor de recursos del servidor. Solo hay un motor activo: si quiero cargar otro perfil, primero tengo que descargar el anterior. Aquí descargar de la GPU significa detener el motor y liberar su memoria, no borrar los archivos guardados en disco. Al hacerlo se restauran los límites de potencia; tras 15 minutos sin generar, el modelo se libera automáticamente. Consultar el estado no reinicia ese plazo.
Una selección independiente en cada pestaña
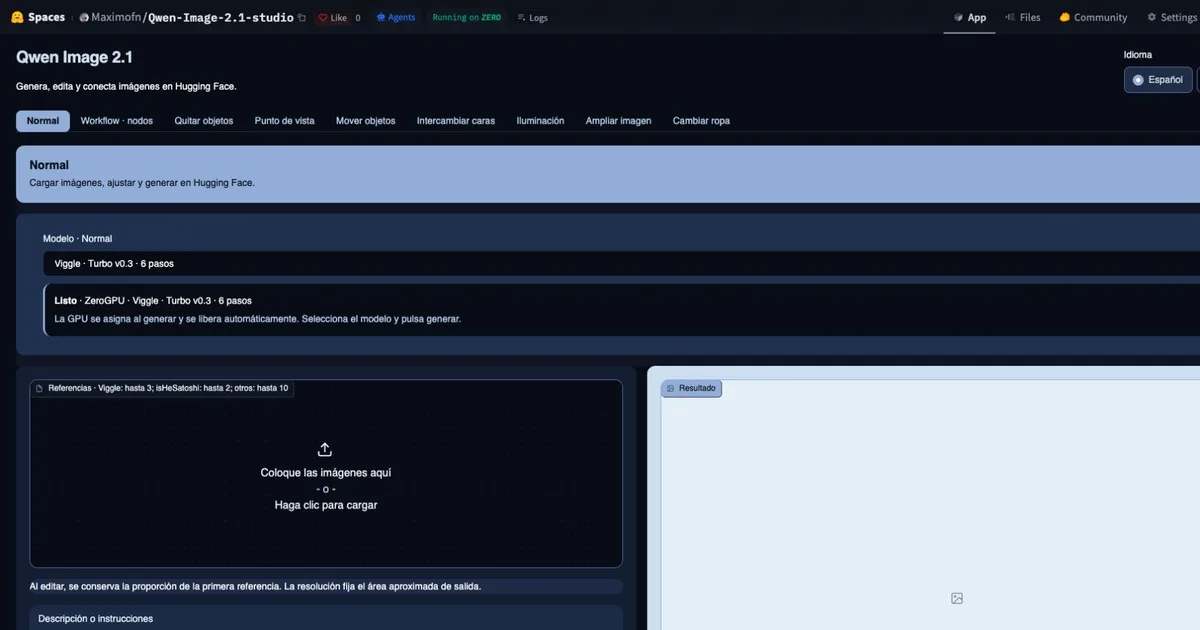
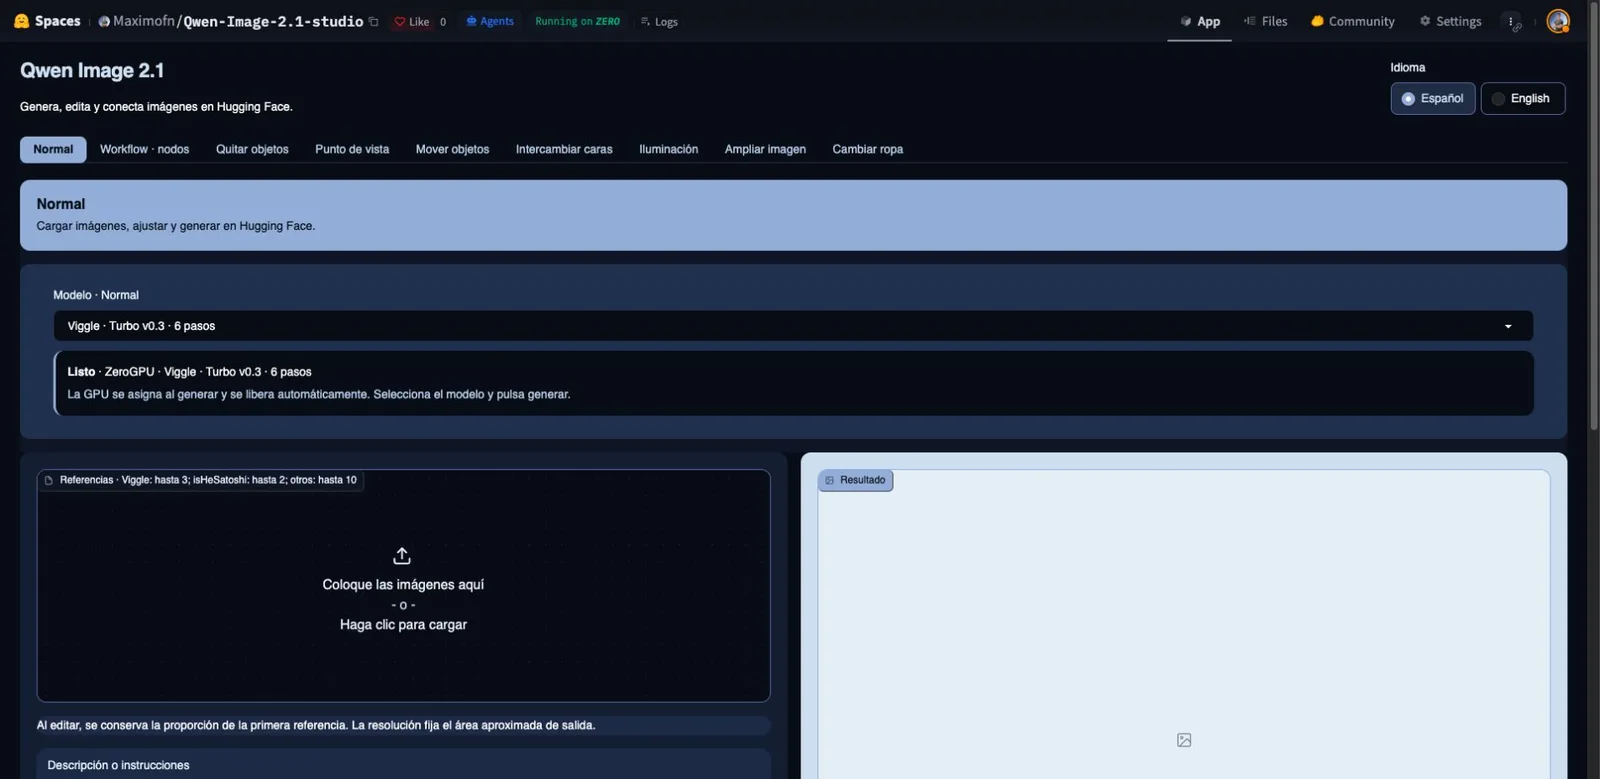
Empecé con Normal y Workflow, y fui incorporando los Spaces especializados hasta llegar a nueve herramientas. El selector global inicial dejó de tener sentido cuando añadí modelos válidos solo para una operación. Ahora cada pestaña tiene su selector, controles y estado; las GPU siguen siendo compartidas.
- Normal y Workflow: generar y editar, en formularios o conectando bloques llamados nodos; por ejemplo, texto → generación → imagen.
- Quitar objetos: dibujar recuadros; los dos perfiles Object Remover aparecen recomendados.
- Punto de vista: rotación y altura con Viewpoint Orbit.
- Mover objetos: seleccionar y recolocar elementos de una escena.
- Intercambiar caras: referencia de rostro e imagen destino.
- Iluminación: colocar luces y volver a generar con Relight.
- Ampliar imagen: extender el encuadre con Outpaint.
- Cambiar ropa: foto e instrucciones, con una referencia de ropa opcional.
Si el motor cargado no es válido para la pestaña, generar devuelve un error antes de procesar las imágenes. Si intento cargar otro motor mientras hay uno activo, la web pide descargarlo primero. Esa comprobación se repite en el broker para evitar que dos peticiones simultáneas eludan la exclusión.
También añadí estados y botones en Home Assistant, probé cancelaciones y recargas, y verifiqué los PNG descargados por HTTPS. El editor de nodos ocupa todo el ancho. La web arranca en español, permite cambiar a inglés y muestra las resoluciones con proporción y píxeles de ambos ejes. Los ejemplos se sirven desde archivos estables, para que las miniaturas no dependan de rutas temporales.
Usarlo dentro de mi red Tailscale
Tailscale conecta mis dispositivos en una red privada cifrada, aunque no estén en la misma casa o Wi-Fi. Esa red se llama tailnet. Con Tailscale Serve puedo presentar la web por HTTPS, que cifra la conexión del navegador y permite verificar el servidor mediante su certificado. Serve envía las peticiones a un proxy local: un programa que comprueba el acceso y dirige cada dirección a la aplicación correspondiente. Mi proxy utiliza Caddy. La ruta /image21/ conduce a Gradio. No habilité Funnel, la función que permitiría publicar el servicio fuera de la red privada.
Permití expresamente mis cuatro dispositivos: Mac, móvil, Raspberry y el propio servidor. Así puedo abrir la web sin otro formulario de usuario y contraseña. La autorización sigue existiendo en Tailscale y en las reglas del proxy: no equivale a permitir cualquier dispositivo de mi red doméstica, la LAN, o de la tailnet. Las APIs administrativas conservan sus credenciales independientes.
Mi flujo de uso en local
- Conectar el dispositivo a Tailscale con su identidad autorizada.
- Abrir la dirección HTTPS privada del servidor y la ruta
/image21/. - Elegir la herramienta y un modelo compatible en su pestaña.
- Pulsar Cargar en las GPU y esperar al estado listo.
- Subir la imagen o escribir el prompt, generar y descargar el resultado.
- Descargar el modelo antes de cargar otro, o al terminar.
La dirección sigue este formato; aquí uso un nombre ficticio y no mi dirección real:
https://equipo.tailnet-de-ejemplo.ts.net/image21/Comprobé acceso HTTPS real desde Mac, Raspberry y el servidor, y rechazo de orígenes no autorizados. Las reglas del móvil se verificaron, pero la apertura real desde Android no quedó comprobada en aquella batería. Configuré el proxy para confiar únicamente en la cadena conocida de Serve; aceptar cabeceras de identidad desde cualquier origen habría permitido suplantar al cliente.
Una corrección importante al poner Gradio detrás del proxy
La web inicial construía enlaces de archivo sin el prefijo /image21. Ajusté los montajes de Normal y Workflow y probé la descarga real del PNG. Que el HTML abra correctamente no garantiza que los archivos, el iframe o los eventos de generación funcionen bajo una subruta.
Llevar el Studio a Hugging Face
Después creé el Space Maximofn/Qwen-Image-2.1-studio. Preparé un repositorio separado para el Space. Incorporé el código y los ejemplos públicos y los envié al repositorio del Space con un push. Git LFS se encarga de guardar los archivos grandes, como las imágenes, sin incluir todo su contenido en cada versión de Git.
git clone git@hf.co:spaces/Maximofn/Qwen-Image-2.1-studio
cd Qwen-Image-2.1-studio

# Con Git LFS instalado y la clave SSH configurada en HF:
git lfs install --local
git lfs pull
Elegí el modo de aplicación Gradio del Space, llamado SDK en su configuración, con Python 3.12 y Gradio 6.28.0 para conservar gr.Workflow y la integración de idioma que había probado. El archivo README del Space contiene la configuración del SDK; las dependencias y revisiones de modelos se fijan en el repositorio. Las 46 imágenes de ejemplo son públicas y sus hashes, huellas digitales que permiten comprobar si un archivo ha cambiado, quedan documentados; Git LFS almacena 45 objetos, porque dos archivos comparten contenido.
Detectar el entorno, no el nombre del equipo
Hugging Face proporciona SPACE_ID como variable de entorno: un dato que el sistema entrega al programa al arrancar. El código comprueba si tiene un valor para elegir entre dos formas de funcionar:
- En wallabot, sin
SPACE_ID: aparecen los botones para cargar y descargar el modelo de las GPU y se consulta su estado. La interfaz envía las órdenes al broker local. Antes de cargar otro motor hay que liberar el anterior. Los selectores incluyen las variantes compatibles con cada pestaña, también los motores FP8, NVFP4 o GGUF en las herramientas que los admiten. - En Hugging Face, con
SPACE_ID: no se crean los botones de carga y descarga, sus funciones de API ni las consultas al broker de wallabot. El Space ejecuta su propio motor y ofrece únicamente los perfiles implementados allí: la base BF16 y sus adaptadores. Para cambiar de perfil basta con seleccionarlo y generar; cada petición activa los adaptadores correspondientes.
Estar en Hugging Face no significa necesariamente tener ZeroGPU. El código comprueba además ACCELERATOR y SPACES_ZERO_GPU. En ZeroGPU, el proveedor asigna la GPU al generar y la libera al terminar. Con una GPU dedicada, el motor permanece preparado en esa GPU. En un Space solo CPU, la web puede abrirse, pero generar muestra un error porque esta implementación necesita GPU. Ninguna de esas variantes cloud usa el broker ni la configuración privada de wallabot.
Así, la detección cambia los controles, la lista de modelos y la ejecución, sin depender del nombre del ordenador. Esta es su parte esencial, reducida para explicar la idea:
import os

IS_SPACE = bool(os.getenv("SPACE_ID"))
MANUAL_GPU_CONTROL = not IS_SPACE
ZERO_GPU = IS_SPACE and (
    os.getenv("ACCELERATOR", "").startswith("zero-")
    or os.getenv("SPACES_ZERO_GPU", "").lower() in {"1", "true", "t"}
)

# Solo crear botones y callbacks manuales en el entorno local.
if MANUAL_GPU_CONTROL:
    crear_controles_locales()
La función final del ejemplo representa el montaje de los controles, no una API de Gradio.
En el código real, en Spaces no se crean ni esos botones, ni las direcciones de API que los ejecutarían, ni las consultas periódicas al broker local. El código que ejecuta las operaciones también rechaza las operaciones de carga y descarga manual. Un Space CPU puede abrir el editor, pero devuelve un aviso de GPU requerida al generar.
En ZeroGPU cambia el ciclo de vida
Con ZeroGPU, la aplicación utiliza una GPU compartida del proveedor durante la generación y la libera al terminar la función que la necesita. No tengo una tarjeta permanentemente reservada para el Space. Preparé una base BF16 y once adaptadores al arrancar, manteniéndolos separados en lugar de incorporar sus cambios definitivamente a la base. Cada petición activa los adaptadores y ajustes correspondientes. Al volver al modelo original se desactivan, para que no herede el comportamiento de otra herramienta.
Carga y descarga manual
1. Seleccionar un perfil válido en la pestaña. 2. Cargar: el broker reserva las GPU. 3. Generar con un único motor activo. 4. Descargar con el botón o tras 15 minutos sin generar. Para cambiar de motor hay que liberar el anterior.
Elegir y generar
1. Seleccionar una receta BF16 y sus adaptadores. 2. Generar: la petición activa la receta. 3. Asignar GPU: ZeroGPU ejecuta la inferencia. 4. Liberar GPU: el proveedor la libera al finalizar. Los pesos compartidos siguen preparados; no hay botones manuales.
El selector de la versión en la nube ofrece 15 perfiles, es decir, combinaciones de modelo, adaptadores y ajustes, que comparten esa implementación BF16: los generales y los especializados. No añadí FP8, NVFP4 o GGUF a esa lista, porque sus motores locales no forman parte de esta adaptación. Cada pestaña y cada visitante conservan su selección. Una GPU dedicada en un Space es otro caso: en la implementación actual mantiene preparado el conjunto de operaciones de generación, llamado pipeline, y también usa selección de adaptadores.
En Python, la marca @spaces.GPU sobre una función indica a Hugging Face qué operación necesita una GPU y cuánto tiempo reservarla. Solicité tamaño xlarge en esa asignación. Cargué la biblioteca spaces antes que Torch, la biblioteca que ejecuta los cálculos del modelo, y arranqué Gradio con demo.launch(). La primera adaptación no registró correctamente una función GPU al iniciar. Corregí el arranque y desactivé SSR en Workflow: ese modo construía parte de la interfaz en el servidor y provocaba problemas en la aplicación de nodos. La experiencia mostró que había que adaptar el inicio al entorno de Hugging Face.
import spaces  # Antes de importar Torch y el backend.
from hf_backend import run_pipeline, gpu_seconds

@spaces.GPU(duration=gpu_seconds, size="xlarge")
def generate_on_gpu(body):
    return run_pipeline(body)

# La aplicación completa usa el lanzamiento nativo de Gradio.
# Este fragmento es explicativo, no una app independiente.
Otros ajustes fueron menos vistosos, pero necesarios: corregir rutas de ejemplos, preparar las conexiones iniciales entre los nodos de imagen y dimensionar la reserva de tiempo con los pasos efectivos. Un perfil Turbo de seis pasos no debe reservar cuota como si fuese a ejecutar cuarenta. El primer arranque descargó aproximadamente 33 GB para la base; el conjunto preparado con adaptadores rondó 37,9 GB.
Probar la web, no solo que termine la instalación
Desde el navegador hice 14 inferencias en las nueve pestañas, usando 13 perfiles distintos y los ejemplos públicos. Probé alternar modelos en Normal, Object Remover e Iluminación, y utilizar perfiles distintos en pestañas diferentes. Los selectores conservaron su estado y cada petición produjo una salida con la receta correspondiente.
| Pestaña | Perfil | Pasos | Salida | Tiempo |
|---|---|---|---|---|
| Normal | BF16 / Turbo8 / Viggle | 40 / 8 / 6 | 1024 × 1024 | 10,02 / 3,14 / 2,66 s |
| Workflow | isHeSatoshi | 6 | 1024 × 1024 | 3,10 s¹ |
| Quitar objetos | Turbo / Estándar | 6 / 40 | 1280 × 832 | 3,61 / 13,33 s |
| Punto de vista | Orbit | 40 | 768 × 768 | 6,83 s |
| Mover objetos | Move Turbo | 6 | 1248 × 832 | 6,65 s |
| Intercambiar caras | BFS Turbo | 6 | 832 × 1248 | 4,32 s |
| Iluminación | Pruna / Viggle | 8 / 6 | 832 × 1248 | 3,81 / 4,65 s |
| Ampliar imagen | Outpaint v2 | 25 | 1376 × 768 | 17,90 s² |
| Cambiar ropa | Outfit Swap | 25 | 832 × 1248 | 8,89 s |
¹ Tiempo de ejecución del nodo. ² Más 2,9 s para describir la escena. Relight generó a 832 × 1248 px y exportó a 1021 × 1536 px.
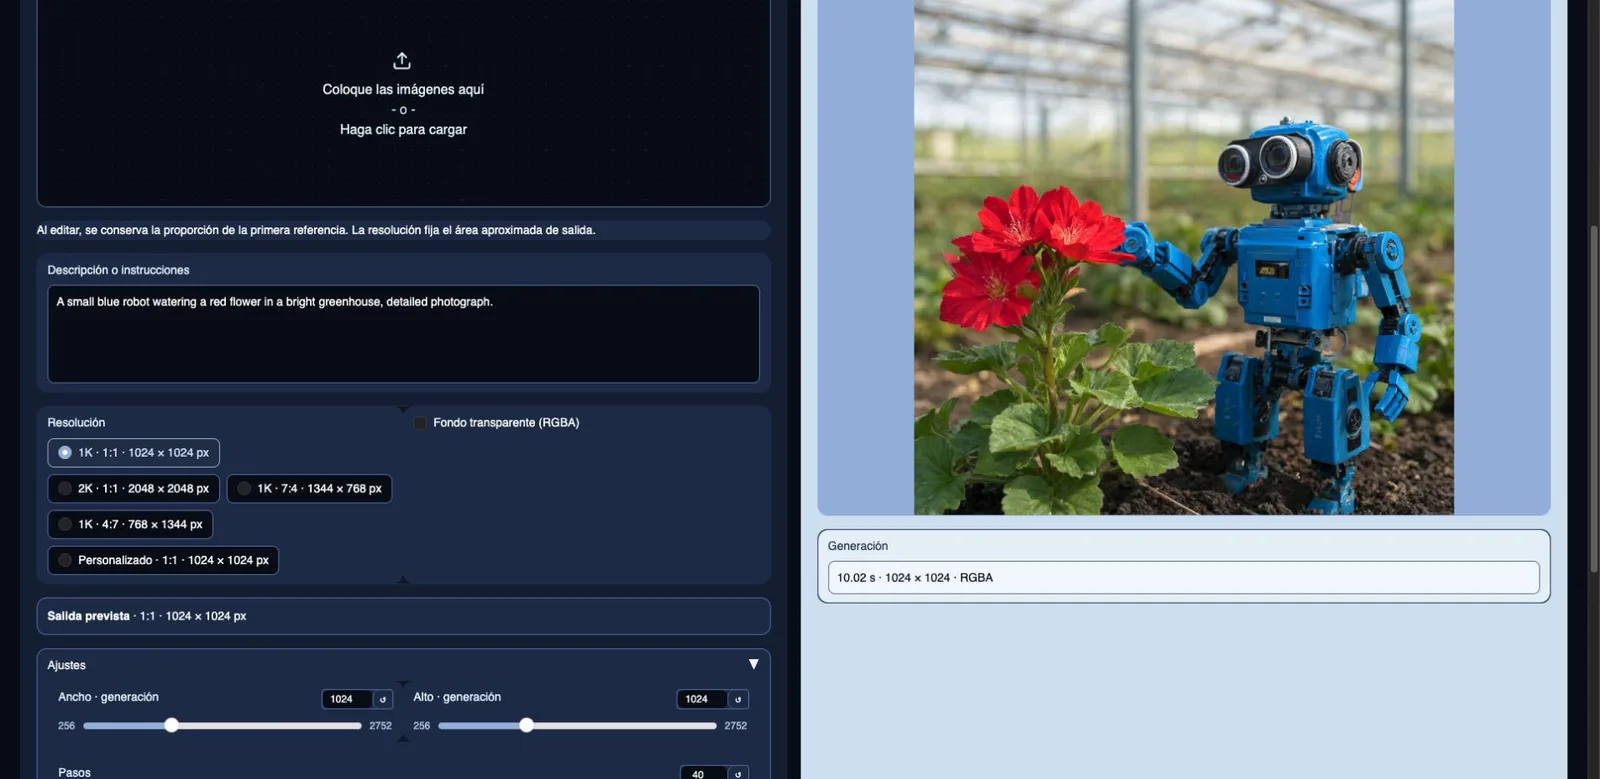
Estos tiempos no constituyen un benchmark uniforme frente a mis RTX 3090: cambian hardware, pasos, imágenes y medición. Tampoco medí energía ni VRAM del proveedor. La liberación física de la GPU es el comportamiento documentado de ZeroGPU; no la verifiqué con telemetría propia.
Quedaron límites concretos: no probé BFS Base ni Outpaint v1 en esa batería, ni el GIF de siete vistas o el nodo de edición de Workflow. Object Remover Turbo dejó restos en un caso que Estándar limpió mejor. Orbit generó una vista posterior al pedir un giro de 90° a la derecha. Una inferencia que termina no garantiza geometría, identidad o fidelidad perfectas.
Dos formas de usar la misma herramienta
En casa tengo control explícito del modelo y de mis GPU, con acceso desde los dispositivos autorizados. En Hugging Face puedo compartir la interfaz y elegir una receta por generación, dejando la asignación temporal de GPU a ZeroGPU.
Lo más útil fue medir primero, mantener separadas la web y la inferencia, y adaptar las capacidades de cada entorno. El resultado es un Studio con nueve herramientas, un comportamiento claro al cambiar de modelo y pruebas que distinguen lo que funciona de lo que todavía queda por comprobar.
Código y referencias
Los números de las tablas proceden de mis ensayos del 5 al 8 de octubre de 2026. Las fuentes externas describen los modelos y las plataformas, no certifican mis medidas.
- Código público del Studio y Space en funcionamiento
- Proyecto Qwen Image 2.1 y presentación oficial
- Documentación de ZeroGPU
- Tailscale Serve
- Catálogo NVIDIA Xid