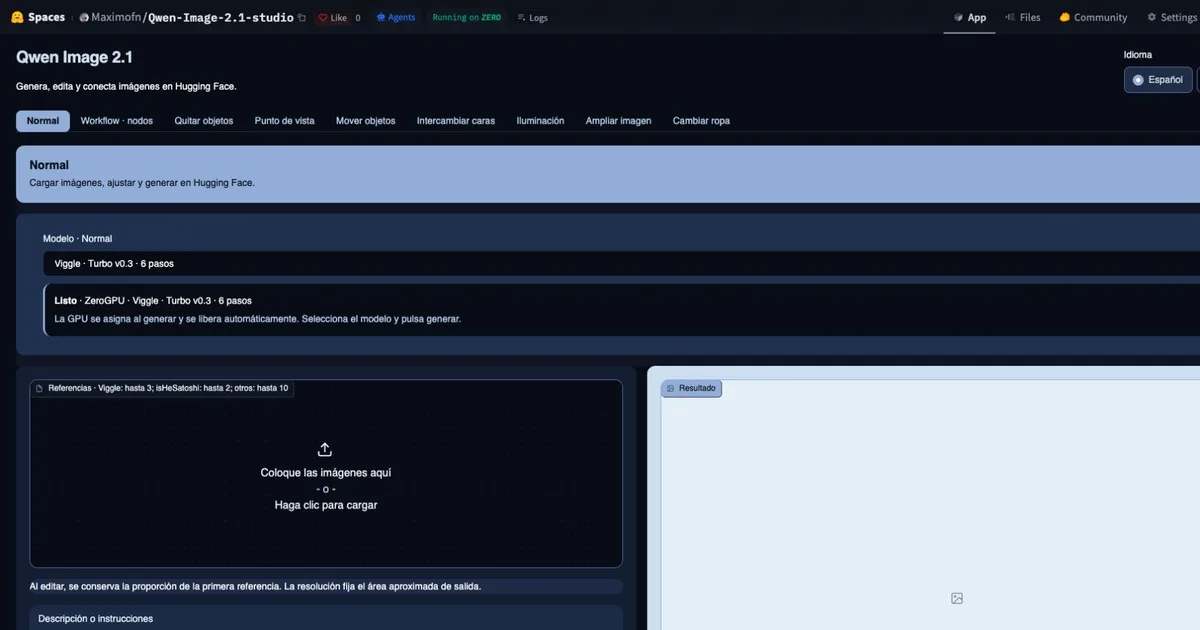
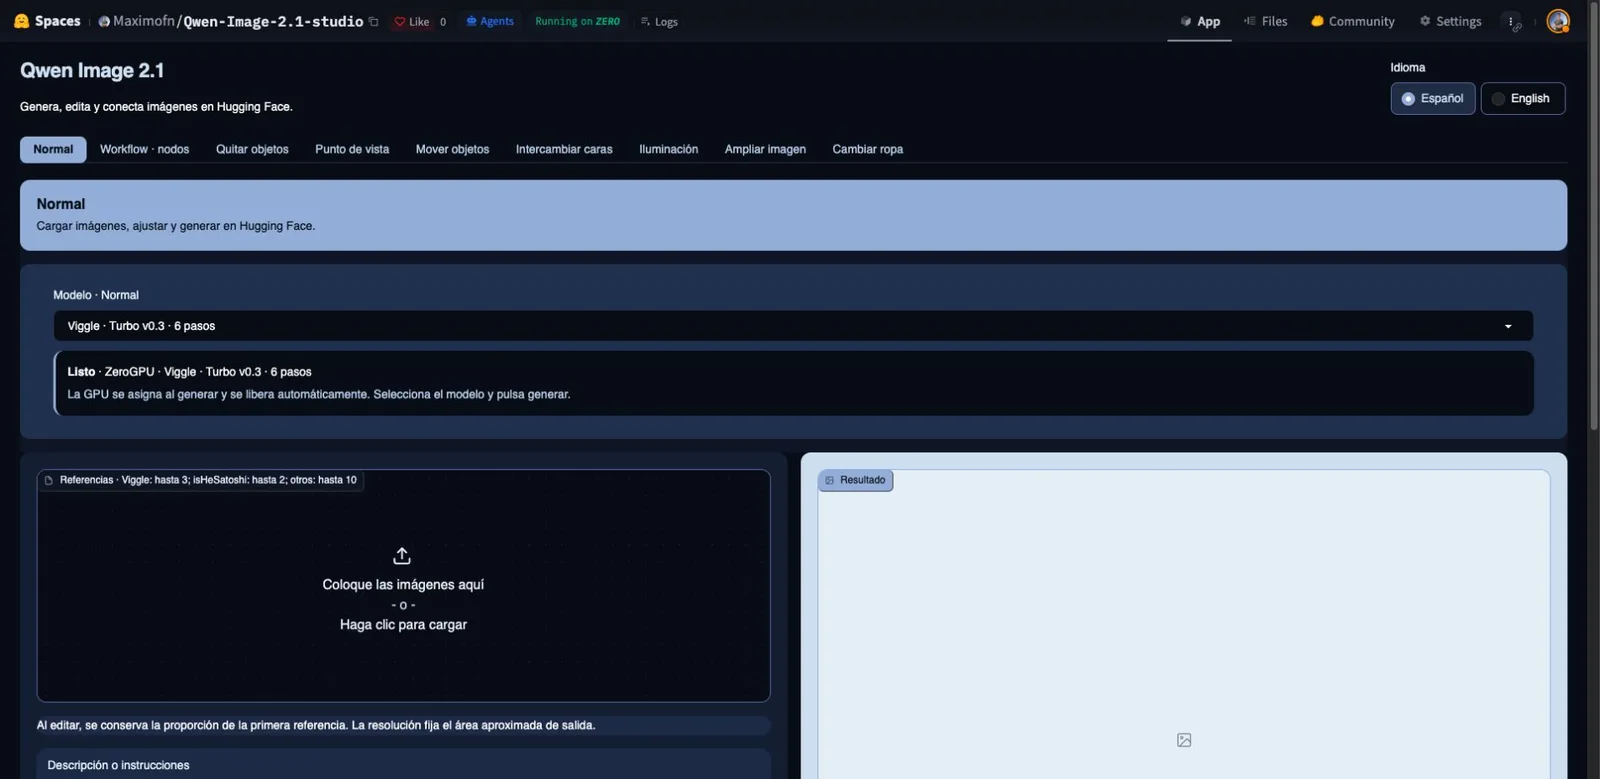
Eu queria usar o Qwen Image 2.1 no wallabot, um computador de mesa que uso como servidor de inteligência artificial, a partir de uma interface confortável. Gerar uma imagem era só o começo: também queria editar referências, conectar nós e aproveitar as ferramentas que a comunidade estava publicando.
Este projeto continua o trabalho que contei em Qwen3.8-27B local com duas RTX 3090: vLLM, MTP e API privada. Lá expliquei como instalei o modelo de texto no wallabot, comparei motores e configurei o serviço sob demanda com Home Assistant e acesso privado por Tailscale. Para o Qwen Image 2.1 segui a mesma abordagem: medir primeiro no meu hardware e depois integrar o modelo ao servidor. Não é preciso ter lido aquele artigo: aqui explico o equipamento e as decisões necessárias para acompanhar este projeto do zero.
Parti dos Spaces oficiais de geração e edição e workflow. Um Space é uma aplicação hospedada no Hugging Face, uma plataforma onde se compartilham modelos e demonstrações de IA. Gradio é a biblioteca Python que transforma as funções de geração em uma web com botões, formulários e imagens. Também cria uma API.
Primeiro, medir no meu hardware
Qual computador usei e por que isso importa
O wallabot roda Ubuntu. Tem um processador AMD Ryzen 5 3600, 32 GiB de RAM e duas placas de vídeo NVIDIA RTX 3090.
Cada RTX 3090 tem 24 GiB de VRAM. As duas não se tornam automaticamente uma placa de 48 GiB: é preciso dividir o trabalho e respeitar o que cabe em cada uma. As GPUs se conectam à placa-mãe por PCI Express, abreviado PCIe, o enlace pelo qual trocam dados com o resto do computador. Nesta montagem uma usa 16 pistas de comunicação, x16, e a outra quatro, x4. Isso limita de forma diferente a troca de dados; não significa que uma imagem demore exatamente quatro vezes mais em uma placa.
Não há uma ponte NVLink, uma conexão física direta entre placas. Também não obtive acesso direto de uma GPU à memória da outra, chamado P2P. Por isso importava decidir qual parte do modelo cada placa executava e quantos dados precisavam se mover entre elas.
Durante os testes limitei cada GPU a 150 W, frente ao seu limite habitual de 350 W. Os watts indicam potência: quanto ela pode consumir naquele momento. Esse teto limita a potência que a placa pode usar e ajuda a controlar o calor; não fixa o consumo total do computador em 300 W, porque o processador, os discos e a refrigeração também funcionam. Executei um modelo de cada vez e separei o tempo de carregar seus arquivos na memória do tempo de gerar a imagem.
O que muda entre as seis variantes do modelo
Um modelo armazena o que aprendeu em milhões de números, chamados pesos. Esses números ocupam espaço no disco e na memória. Quantizar consiste em representar parte deles com menos bits, aproximando seus valores para que ocupem menos. Um bit é a unidade mínima de informação digital. Reduzir a precisão pode mudar a imagem e exige software compatível; por si só não garante mais velocidade.
Comparei a versão original e cinco distribuições alternativas. Unsloth, BennyDaBall, ModelsLab e abenzerps são os autores ou equipes que publicam essas conversões. Os nomes que aparecem na tabela indicam como os números do modelo são armazenados ou usados:
- Original BF16: a versão de referência do Qwen. BF16, abreviação de bfloat16, representa os pesos com números de 16 bits. Usei-a para verificar o funcionamento sem adicionar uma conversão para 8 ou 4 bits. Precisa de mais memória para os mesmos pesos; além disso, é preciso reservar espaço para os cálculos temporários.
- Unsloth FP8: usa representações de 8 bits para reduzir o espaço dos pesos convertidos. FP significa floating point, ou ponto flutuante: uma maneira de representar números com uma faixa ampla. Nas minhas RTX 3090, o programa adapta esses pesos para calcular com uma precisão compatível; essas placas não executam as multiplicações FP8 de forma nativa. A economia de memória e a velocidade precisam ser medidas separadamente.
- BennyDaBall NVFP4: usa um formato da NVIDIA que guarda grupos de pesos com valores de 4 bits e escalas auxiliares para interpretá-los. No ensaio mantive esse armazenamento e descomprimi os valores para calcular nas RTX 3090, que não têm cálculo FP4 nativo. Não quer dizer que todos os componentes do modelo ocupem quatro bits nem que o consumo total de memória seja um quarto do original.
- ModelsLab NVFP4 W4A4: propõe 4 bits tanto para pesos, W, de weights, quanto para ativações, A, os resultados intermediários que passam entre camadas do modelo, em seu componente de geração. Seu motor Nunchaku usa rotinas de cálculo que exigem placas da geração Blackwell. Minhas RTX 3090 pertencem a uma geração anterior, Ampere, então rejeitei esta variante por incompatibilidade. Não cheguei a gerar imagens com ela.
- Unsloth GGUF Q4_K_M: GGUF é um formato de arquivo que empacota pesos e as informações necessárias para carregá-los. Não é uma precisão por si só: há GGUF com diferentes quantizações. Escolhi Q4_K_M, uma receita que usa principalmente 4 bits por peso, com blocos e precisões diferentes conforme a parte. Executei-o com um carregador GGUF no ComfyUI; os componentes de interpretação de referências e conversão final da imagem continuaram em BF16.
- abenzerps GGUF Q4_K_M: outra distribuição em GGUF, testada com a mesma família de quantização. Seu autor a chama de «Uncensored» e descreve a ausência de um verificador de conteúdo embutido. Esse rótulo não descreve uma melhoria de precisão ou velocidade. Meus testes usaram cenas e instruções benignas, então não verificam essa propriedade nem permitem afirmar que se comporte igual em qualquer programa.
Cada variante executável passou por nove casos: um teste inicial pequeno de 512 × 512 pixels, geração a 1024 × 1024, repetição da mesma semente, outra semente, texto em espanhol, transparência, edição com uma imagem de referência, edição com duas e geração a 2048 × 2048. A semente é o número que inicializa o ruído aleatório do qual a geração parte; repeti-la ajuda a comparar resultados com os mesmos ajustes. Os passos são as iterações com que o modelo vai refinando a imagem. Usei 40 nos casos principais. Chamo 1024 × 1024 de 1K e 2048 × 2048 pixels de 2K; 2K tem quatro vezes mais pixels, não duas.
| Variante | Carga | Gerar 1K | Editar 1K | Gerar 2K | VRAM GPU 0 / 1 | GPU Wh / 1K |
|---|---|---|---|---|---|---|
| Original BF16 | 33,0 | 173,2 | 215,3 | 988,2 | 19,01 / 20,68 | 10,48 |
| Unsloth FP8 | 20,1 | 162,8 | 187,0 | 738,1 | 9,88 / 13,26 | 8,47 |
| BennyDaBall NVFP4 | 16,3 | 126,1 | 165,8 | 723,3 | 8,62 / 10,52 | 6,70 |
| ModelsLab W4A4 | Incompatível com este hardware. Não há tempos de inferência. | |||||
| Unsloth GGUF Q4_K_M | 17,9 | 109,3 | 133,4 | 472,5 | 10,49 / 17,52 | 5,94 |
| abenzerps GGUF Q4_K_M | 16,8 | 111,4 | 136,0 | 473,1 | 10,86 / 17,52 | 6,23 |
Um valor menor indica menos tempo neste ensaio. Não é uma nota de qualidade.
Os números precisam de contexto
Os Wh, ou watts-hora, medem energia acumulada: quanto foi consumido durante um intervalo. Por exemplo, manter 100 W durante uma hora consome 100 Wh. Tirei amostras de potência das duas GPUs aproximadamente a cada dois segundos e somei seu consumo ao longo de cada geração. Não medi o consumo na tomada. Esse número não inclui tudo o que o computador e suas fontes de alimentação gastam.
Como vigiei o computador durante os testes
O wallabot tem refrigeração líquida para o processador e para as duas GPUs: três circuitos, cada um com uma bomba que faz o líquido circular e um radiador que transfere seu calor para o ar. Cada radiador de GPU tem três ventoinhas; o da CPU, uma. Outras três ventoinhas trazem ar fresco para o gabinete: são dez ventoinhas no total, além das três bombas. Os radiadores expulsam o ar quente pelo topo, pela base e pela traseira.
O computador é alimentado por duas fontes: uma principal para a placa-mãe e o resto do equipamento, incluindo a GPU superior, e outra para a alimentação auxiliar da GPU inferior. Uma fonte converte a eletricidade da rede nas tensões de que os componentes precisam. Ambas recebem energia através de um nobreak (UPS), um sistema de alimentação ininterrupta: uma bateria com eletrônica que mantém o equipamento ligado durante uma queda de energia. O meu é um CyberPower CP1500EPFCLCD, com capacidade nominal de 900 W, e comunica seu estado ao computador por USB.
Eu não queria escolher um modelo só porque terminava antes. Registrei estes dados para saber também se o equipamento continuava em condições de trabalhar:
- Temperaturas: leituras dos sensores das GPUs, em graus Celsius. A carga de IA gera calor; a vigilância permite interromper o ensaio se as placas ultrapassarem o limite definido. Um sensor não mede necessariamente todos os pontos quentes nem todos os picos breves.
- RAM e VRAM: quanto espaço os programas ocupavam na memória geral e em cada placa. A coluna GPU 0 / 1 mostra separadamente as duas placas tal como estavam numeradas no ensaio; não é um depósito comum de memória.
- Estado do nobreak: se funcionava com a rede elétrica ou com bateria, a porcentagem de bateria e sua carga. Aqui «carga» significa a fração da sua capacidade de potência utilizada, não a bateria restante. Não usei essa porcentagem como uma medição precisa do consumo na tomada.
- Bombas: seus sinais de rotação disponíveis, expressos em RPM, rotações por minuto. Observei uma bomba de GPU e a da CPU; não tinha uma leitura independente das três. Ver uma bomba girar não demonstra por si só que o líquido circula corretamente nem informa as RPM de todas as ventoinhas.
- Erros do driver: mensagens do software da NVIDIA que permite ao sistema operacional se comunicar com as GPUs. Procurei falhas de cálculo ou perdas de acesso a uma placa, além de verificar que as imagens fossem geradas.
As salvaguardas exigiam ambas as GPUs presentes e abaixo de 80 °C, nobreak funcionando com a rede elétrica, pelo menos 80 % de bateria, carga do nobreak não superior a 80 % e sinais das bombas observadas de pelo menos 2000 RPM. São limites escolhidos para esta instalação, não requisitos universais para usar o Qwen. Se uma GPU desaparecia, o ensaio parava e não se admitia outra carga sem confirmar a limpeza.
A primeira geração 1K foi executada depois do teste inicial pequeno. Portanto, seu tempo não representa uma inicialização completamente fria: parte do software e dos dados já podia estar preparada.
Para executar BF16 usei o Diffusers, uma biblioteca Python para modelos de imagem. Para as variantes quantizadas usei o ComfyUI, que organiza a geração em operações conectadas. São motores de execução diferentes. Além disso, para os GGUF inverti a divisão de tarefas entre as placas. A tabela compara essas configurações completas: não permite atribuir cada diferença de tempo unicamente à redução de bits dos pesos. Por isso também não copiei para a minha tabela tempos de uma GPU Blackwell publicados por outro autor.
A geração tem várias partes: o encoder converte as instruções e referências em representações que o modelo pode processar; o DiT é o componente que refina a imagem durante os passos; o VAE converte a representação interna final nos pixels que vemos. Dividi-las entre placas permite acomodar o conjunto, mas também obriga a transferir seus resultados.
O que mudou ao inverter as GPUs
Ao colocar o encoder na GPU 1 e DiT/VAE na GPU 0, repeti geração e edição com FP8 e Benny. Em 1K e 40 passos, FP8 passou a 102,1 s e Benny a 88,5 s; a edição foi de 126,1 s e 113,3 s, respectivamente. São ensaios posteriores, separados da tabela inicial, sem esvaziar o cache de arquivos.
Isso me ensinou que a colocação do trabalho importa. Eu não podia escolher um formato olhando só o tamanho do arquivo ou misturando resultados de distribuições diferentes.
Também houve dois travamentos reais
Durante uma edição com NVFP4 Benny e outra com GGUF Unsloth apareceu o Xid 79: o sistema deixou de conseguir se comunicar com uma GPU através do seu enlace PCIe. A NVIDIA identifica esse código como perda da GPU do barramento, a via de comunicação entre componentes. É um sintoma; a mensagem por si só não identifica a peça ou condição que o provocou (catálogo Xid da NVIDIA).
Depois chegaram os aceleradores Turbo
Depois adicionei Viggle v0.3, Turbo8 e isHeSatoshi, adaptadores LoRA sobre a base BF16. Um LoRA é um conjunto adicional de pesos que modifica o comportamento do modelo sem substituir todos os seus arquivos. Nestes perfis Turbo ele é usado para obter imagens com menos passos. Cada um tem uma receita de execução, passos e outros ajustes, então não basta trocar o arquivo do adaptador e manter os parâmetros do anterior.
| Perfil | Passos | Geração | Edição | GPU Wh / geração |
|---|---|---|---|---|
| Viggle v0.3 | 6 | 28,31 s | 37,13 s | 1,771 |
| Turbo8 | 8 | 35,11 s | 46,02 s | 1,934 |
| isHeSatoshi r128 | 6 | 26,73 s | 35,47 s | 1,614 |
A redução de tempo foi útil para trabalhar pela web. A fidelidade merece uma avaliação à parte: algumas edições alteraram texturas ou o fundo e apareceram artefatos finos. Menos passos não demonstra uma qualidade equivalente à base.
Transformá-lo em um serviço do wallabot
Separei a interface, a web que se vê no navegador, do motor, o programa que carrega os pesos e gera imagens. O Gradio não tem acesso direto às GPUs: envia as operações a um broker, um coordenador que verifica se podem ser executadas e reserva as placas. Eles se comunicam por um socket Unix, um canal local entre processos do mesmo computador que não precisa abrir uma porta de rede. Um gateway separado oferece os comandos que o Home Assistant, meu sistema de automação residencial, usa para mostrar o estado e controlar o modelo pelo seu painel.
O Home Assistant chega ao gateway de controle com sua própria autorização.
O broker é uma peça específica da minha instalação. Clonar o repositório público do Space não reproduz por si só esse serviço local; o ramo auto-hospedado precisa de um broker instalado e configurado separadamente. Usei contêineres Docker, ambientes que isolam os processos e permitem limitar seus recursos e arquivos acessíveis. A interface fica em uma rede interna de contêineres, sem acesso direto de fora nem GPU. O código e os pesos são montados somente leitura para impedir que a geração os modifique; as imagens produzidas vão para outra pasta. O systemd, o gerenciador de serviços do Linux, mantém broker, web e gateway em funcionamento. Para as tarefas administrativas usei o tmux, que mantém um terminal mesmo que a sessão remota se desconecte. Eu mesmo digitei a senha para obter permissões de administrador, sem guardá-la em scripts.
A reserva é compartilhada com o gerenciador de recursos do servidor. Só há um motor ativo: se quero carregar outro perfil, primeiro tenho que descarregar o anterior. Aqui descarregar da GPU significa parar o motor e liberar sua memória, não apagar os arquivos guardados em disco. Ao fazer isso, os limites de potência são restaurados; após 15 minutos sem gerar, o modelo é liberado automaticamente. Consultar o estado não reinicia esse prazo.
Uma seleção independente em cada aba
Comecei com Normal e Workflow, e fui incorporando os Spaces especializados até chegar a nove ferramentas. O seletor global inicial deixou de fazer sentido quando adicionei modelos válidos só para uma operação. Agora cada aba tem seu seletor, controles e estado; as GPUs continuam sendo compartilhadas.
- Normal e Workflow: gerar e editar, em formulários ou conectando blocos chamados nós; por exemplo, texto → geração → imagem.
- Remover objetos: desenhar retângulos; os dois perfis Object Remover aparecem recomendados.
- Ponto de vista: rotação e altura com Viewpoint Orbit.
- Mover objetos: selecionar e reposicionar elementos de uma cena.
- Trocar rostos: referência de rosto e imagem de destino.
- Iluminação: posicionar luzes e gerar novamente com Relight.
- Ampliar imagem: estender o enquadramento com Outpaint.
- Trocar roupa: foto e instruções, com uma referência de roupa opcional.
Se o motor carregado não for válido para a aba, gerar devolve um erro antes de processar as imagens. Se eu tentar carregar outro motor enquanto há um ativo, a web pede para descarregá-lo primeiro. Essa verificação se repete no broker para evitar que duas requisições simultâneas burlem a exclusão.
Também adicionei estados e botões no Home Assistant, testei cancelamentos e recarregamentos, e verifiquei os PNG baixados por HTTPS. O editor de nós ocupa toda a largura. A web começa em espanhol, permite mudar para inglês e mostra as resoluções com proporção e pixels de ambos os eixos. Os exemplos são servidos a partir de arquivos estáveis, para que as miniaturas não dependam de caminhos temporários.
Usá-lo dentro da minha rede Tailscale
O Tailscale conecta meus dispositivos em uma rede privada criptografada, mesmo que não estejam na mesma casa ou Wi-Fi. Essa rede se chama tailnet. Com o Tailscale Serve posso apresentar a web por HTTPS, que criptografa a conexão do navegador e permite verificar o servidor por meio do seu certificado. O Serve envia as requisições a um proxy local: um programa que verifica o acesso e direciona cada endereço para a aplicação correspondente. Meu proxy usa Caddy. A rota /image21/ leva ao Gradio. Não habilitei o Funnel, a função que permitiria publicar o serviço fora da rede privada.
Permiti expressamente meus quatro dispositivos: Mac, celular, Raspberry e o próprio servidor. Assim posso abrir a web sem outro formulário de usuário e senha. A autorização continua existindo no Tailscale e nas regras do proxy: não equivale a permitir qualquer dispositivo da minha rede doméstica, a LAN, ou da tailnet. As APIs administrativas mantêm suas credenciais independentes.
Meu fluxo de uso local
- Conectar o dispositivo ao Tailscale com sua identidade autorizada.
- Abrir o endereço HTTPS privado do servidor e a rota
/image21/. - Escolher a ferramenta e um modelo compatível na sua aba.
- Clicar em Carregar nas GPUs e esperar o estado pronto.
- Enviar a imagem ou escrever o prompt, gerar e baixar o resultado.
- Descarregar o modelo antes de carregar outro, ou ao terminar.
O endereço segue este formato; aqui uso um nome fictício e não o meu endereço real:
https://maquina.tailnet-de-exemplo.ts.net/image21/Verifiquei o acesso HTTPS real a partir do Mac, da Raspberry e do servidor, e a rejeição de origens não autorizadas. As regras do celular foram verificadas, mas a abertura real pelo Android não ficou comprovada naquela bateria. Configurei o proxy para confiar apenas na cadeia conhecida do Serve; aceitar cabeçalhos de identidade de qualquer origem teria permitido falsificar o cliente.
Uma correção importante ao colocar o Gradio atrás do proxy
A web inicial construía links de arquivo sem o prefixo /image21. Ajustei as montagens de Normal e Workflow e testei o download real do PNG. O HTML abrir corretamente não garante que os arquivos, o iframe ou os eventos de geração funcionem sob um subcaminho.
Levar o Studio ao Hugging Face
Depois criei o Space Maximofn/Qwen-Image-2.1-studio. Preparei um repositório separado para o Space. Incorporei o código e os exemplos públicos e os enviei ao repositório do Space com um push. O Git LFS se encarrega de guardar os arquivos grandes, como as imagens, sem incluir todo o seu conteúdo em cada versão do Git.
git clone git@hf.co:spaces/Maximofn/Qwen-Image-2.1-studio
cd Qwen-Image-2.1-studio

# Com Git LFS instalado e a chave SSH configurada no HF:
git lfs install --local
git lfs pull
Escolhi o modo de aplicação Gradio do Space, chamado SDK na sua configuração, com Python 3.12 e Gradio 6.28.0 para manter o gr.Workflow e a integração de idioma que eu havia testado. O arquivo README do Space contém a configuração do SDK; as dependências e revisões de modelos são fixadas no repositório. As 46 imagens de exemplo são públicas e seus hashes, impressões digitais que permitem verificar se um arquivo mudou, ficam documentados; o Git LFS armazena 45 objetos, porque dois arquivos compartilham conteúdo.
Detectar o ambiente, não o nome da máquina
O Hugging Face fornece SPACE_ID como variável de ambiente: um dado que o sistema entrega ao programa ao iniciar. O código verifica se ela tem um valor para escolher entre duas formas de funcionar:
- No wallabot, sem
SPACE_ID: aparecem os botões para carregar e descarregar o modelo das GPUs e seu estado é consultado. A interface envia as ordens ao broker local. Antes de carregar outro motor é preciso liberar o anterior. Os seletores incluem as variantes compatíveis com cada aba, inclusive os motores FP8, NVFP4 ou GGUF nas ferramentas que os admitem. - No Hugging Face, com
SPACE_ID: não são criados os botões de carga e descarga, suas funções de API nem as consultas ao broker do wallabot. O Space executa seu próprio motor e oferece apenas os perfis implementados ali: a base BF16 e seus adaptadores. Para mudar de perfil basta selecioná-lo e gerar; cada requisição ativa os adaptadores correspondentes.
Estar no Hugging Face não significa necessariamente ter ZeroGPU. O código verifica também ACCELERATOR e SPACES_ZERO_GPU. No ZeroGPU, o provedor atribui a GPU ao gerar e a libera ao terminar. Com uma GPU dedicada, o motor permanece preparado nessa GPU. Em um Space só com CPU, a web pode abrir, mas gerar mostra um erro porque esta implementação precisa de GPU. Nenhuma dessas variantes na nuvem usa o broker nem a configuração privada do wallabot.
Assim, a detecção muda os controles, a lista de modelos e a execução, sem depender do nome do computador. Esta é a sua parte essencial, reduzida para explicar a ideia:
import os

IS_SPACE = bool(os.getenv("SPACE_ID"))
MANUAL_GPU_CONTROL = not IS_SPACE
ZERO_GPU = IS_SPACE and (
    os.getenv("ACCELERATOR", "").startswith("zero-")
    or os.getenv("SPACES_ZERO_GPU", "").lower() in {"1", "true", "t"}
)

# Só criar botões e callbacks manuais no ambiente local.
if MANUAL_GPU_CONTROL:
    criar_controles_locais()
A função final do exemplo representa a montagem dos controles, não uma API do Gradio.
No código real, nos Spaces não são criados nem esses botões, nem os endereços de API que os executariam, nem as consultas periódicas ao broker local. O código que executa as operações também rejeita as operações de carga e descarga manual. Um Space CPU pode abrir o editor, mas devolve um aviso de GPU necessária ao gerar.
No ZeroGPU o ciclo de vida muda
Com o ZeroGPU, a aplicação usa uma GPU compartilhada do provedor durante a geração e a libera ao terminar a função que precisa dela. Não tenho uma placa permanentemente reservada para o Space. Preparei uma base BF16 e onze adaptadores na inicialização, mantendo-os separados em vez de incorporar suas mudanças definitivamente à base. Cada requisição ativa os adaptadores e ajustes correspondentes. Ao voltar ao modelo original eles são desativados, para que não herde o comportamento de outra ferramenta.
Carga e descarga manual
1. Selecionar um perfil válido na aba. 2. Carregar: o broker reserva as GPUs. 3. Gerar com um único motor ativo. 4. Descarregar com o botão ou após 15 minutos sem gerar. Para mudar de motor é preciso liberar o anterior.
Escolher e gerar
1. Selecionar uma receita BF16 e seus adaptadores. 2. Gerar: a requisição ativa a receita. 3. Atribuir GPU: o ZeroGPU executa a inferência. 4. Liberar GPU: o provedor a libera ao finalizar. Os pesos compartilhados continuam preparados; não há botões manuais.
O seletor da versão na nuvem oferece 15 perfis, ou seja, combinações de modelo, adaptadores e ajustes, que compartilham essa implementação BF16: os gerais e os especializados. Não adicionei FP8, NVFP4 ou GGUF a essa lista, porque seus motores locais não fazem parte desta adaptação. Cada aba e cada visitante mantêm sua seleção. Uma GPU dedicada em um Space é outro caso: na implementação atual mantém preparado o conjunto de operações de geração, chamado pipeline, e também usa seleção de adaptadores.
Em Python, a marca @spaces.GPU sobre uma função indica ao Hugging Face qual operação precisa de uma GPU e quanto tempo reservá-la. Solicitei o tamanho xlarge nessa atribuição. Carreguei a biblioteca spaces antes do Torch, a biblioteca que executa os cálculos do modelo, e iniciei o Gradio com demo.launch(). A primeira adaptação não registrou corretamente uma função GPU ao iniciar. Corrigi a inicialização e desativei o SSR no Workflow: esse modo construía parte da interface no servidor e provocava problemas na aplicação de nós. A experiência mostrou que era preciso adaptar a inicialização ao ambiente do Hugging Face.
import spaces  # Antes de importar o Torch e o backend.
from hf_backend import run_pipeline, gpu_seconds

@spaces.GPU(duration=gpu_seconds, size="xlarge")
def generate_on_gpu(body):
    return run_pipeline(body)

# A aplicação completa usa a inicialização nativa do Gradio.
# Este trecho é explicativo, não um app independente.
Outros ajustes foram menos vistosos, mas necessários: corrigir caminhos de exemplos, preparar as conexões iniciais entre os nós de imagem e dimensionar a reserva de tempo com os passos efetivos. Um perfil Turbo de seis passos não deve reservar cota como se fosse executar quarenta. A primeira inicialização baixou aproximadamente 33 GB para a base; o conjunto preparado com adaptadores ficou em torno de 37,9 GB.
Testar a web, não só que a instalação termine
Pelo navegador fiz 14 inferências nas nove abas, usando 13 perfis diferentes e os exemplos públicos. Testei alternar modelos em Normal, Object Remover e Iluminação, e usar perfis diferentes em abas diferentes. Os seletores mantiveram seu estado e cada requisição produziu uma saída com a receita correspondente.
| Aba | Perfil | Passos | Saída | Tempo |
|---|---|---|---|---|
| Normal | BF16 / Turbo8 / Viggle | 40 / 8 / 6 | 1024 × 1024 | 10,02 / 3,14 / 2,66 s |
| Workflow | isHeSatoshi | 6 | 1024 × 1024 | 3,10 s¹ |
| Remover objetos | Turbo / Padrão | 6 / 40 | 1280 × 832 | 3,61 / 13,33 s |
| Ponto de vista | Orbit | 40 | 768 × 768 | 6,83 s |
| Mover objetos | Move Turbo | 6 | 1248 × 832 | 6,65 s |
| Trocar rostos | BFS Turbo | 6 | 832 × 1248 | 4,32 s |
| Iluminação | Pruna / Viggle | 8 / 6 | 832 × 1248 | 3,81 / 4,65 s |
| Ampliar imagem | Outpaint v2 | 25 | 1376 × 768 | 17,90 s² |
| Trocar roupa | Outfit Swap | 25 | 832 × 1248 | 8,89 s |
¹ Tempo de execução do nó. ² Mais 2,9 s para descrever a cena. O Relight gerou a 832 × 1248 px e exportou a 1021 × 1536 px.
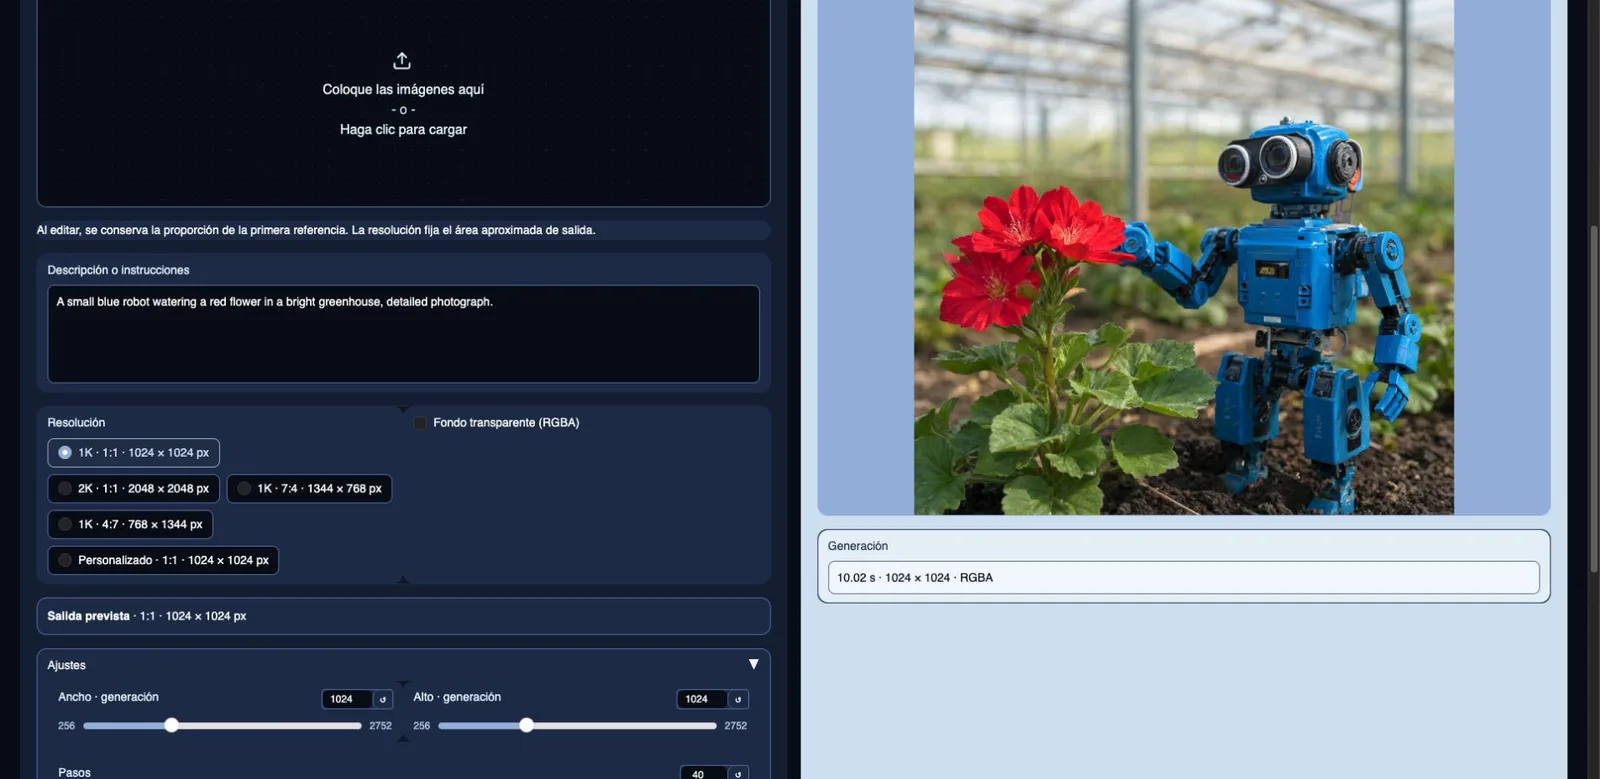
Esses tempos não constituem um benchmark uniforme frente às minhas RTX 3090: mudam hardware, passos, imagens e medição. Também não medi energia nem VRAM do provedor. A liberação física da GPU é o comportamento documentado do ZeroGPU; não a verifiquei com telemetria própria.
Ficaram limites concretos: não testei BFS Base nem Outpaint v1 nessa bateria, nem o GIF de sete vistas ou o nó de edição do Workflow. O Object Remover Turbo deixou restos em um caso que o Padrão limpou melhor. O Orbit gerou uma vista traseira ao pedir um giro de 90° para a direita. Uma inferência que termina não garante geometria, identidade ou fidelidade perfeitas.
Duas formas de usar a mesma ferramenta
Em casa tenho controle explícito do modelo e das minhas GPUs, com acesso a partir dos dispositivos autorizados. No Hugging Face posso compartilhar a interface e escolher uma receita por geração, deixando a atribuição temporária de GPU ao ZeroGPU.
O mais útil foi medir primeiro, manter separadas a web e a inferência, e adaptar as capacidades de cada ambiente. O resultado é um Studio com nove ferramentas, um comportamento claro ao trocar de modelo e testes que distinguem o que funciona do que ainda falta verificar.
Código e referências
Os números das tabelas vêm dos meus ensaios de 5 a 8 de outubro de 2026. As fontes externas descrevem os modelos e as plataformas, não certificam minhas medições.
- Código público do Studio e Space em funcionamento
- Projeto Qwen Image 2.1 e apresentação oficial
- Documentação do ZeroGPU
- Tailscale Serve
- Catálogo NVIDIA Xid