El problema: explorar cuesta
Ramp tiene un producto, Ramp Sheets, con un agente que trabaja sobre hojas de cálculo. Y un agente de hojas de cálculo es tan bueno como la información que recupera: si lee poco, no encuentra la respuesta; si lee demasiado, se vuelve lento, caro y fácil de distraer con pestañas que no vienen a cuento.
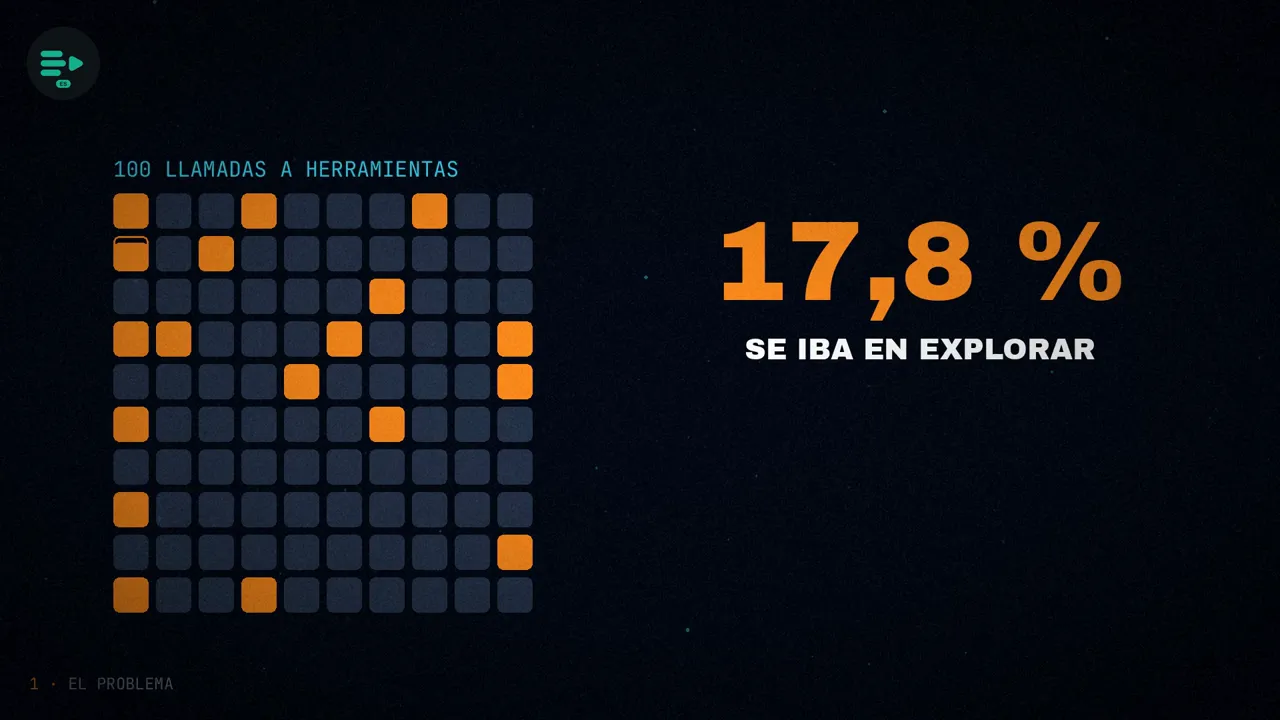
Al mirar sus trazas vieron cuánto costaba esa exploración:
- El 17,8 % de todas las llamadas a herramientas del agente principal se iban en abrir pestañas, leer rangos y descartar hojas irrelevantes, antes de tener los datos para responder.
- Cerca del 75 % de esas llamadas iban seguidas de inmediato por otra lectura. Los autores dicen que eso sugiere que el agente no solía dar con la información a la primera. Es una interpretación suya, no una medida de fallos.
Su argumento es que retocar el prompt no cambia el bucle de fondo: seguiría siendo un modelo grande, generalista y lento el que navega la hoja y filtra lo que sobra. Así que sacaron la búsqueda a un subagente especializado, Fast Ask. Le llega una pregunta como «¿cuáles fueron los ingresos de marzo a mayo?», navega el libro, lee los rangos que hacen falta y devuelve una respuesta compacta al agente principal.
El modelo que hay detrás es un Qwen3.5-35B-A3B afinado, con unos 3.000 millones de parámetros activos.
Por qué un subagente
Los autores dan tres razones por las que la recuperación merece un modelo especialista:
Si el modelo principal lee todas las pestañas, quema tokens en filas irrelevantes y puede anclarse en un señuelo. El subagente devuelve solo las celdas que importan o el valor ya calculado.
Para el usuario no es lo mismo que el agente tenga el dato enseguida que verlo gastar turnos explorando el libro.
La más importante. Muchas preguntas sobre una hoja se resuelven en un valor exacto: una fecha, un número de factura, un importe en céntimos, un sí o un no, una fila.
Esa tercera razón es la que abre la puerta al aprendizaje por refuerzo: si la respuesta es un valor exacto, cada intento se puede puntuar de forma determinista, sin etiquetas humanas y sin otro modelo que haga de juez. La tarea era estrecha, muy repetida, sensible a la latencia y objetivamente puntuable. Son las cuatro condiciones que me llevo del artículo para decidir cuándo merece la pena entrenar un modelo propio.
El montaje del entrenamiento
Para poder entrenar con refuerzo, plantearon la interacción con la hoja como un entorno: muchas tareas emparentadas, una interfaz de herramientas pequeña y una función de recompensa determinista. El modelo no aprende de demostraciones del comportamiento correcto; descubre sus propias estrategias para navegar libros, recuperar datos y calcular respuestas.
- Modelo base: Qwen/Qwen3.5-35B-A3B.
- Infraestructura: la plataforma Lab de Prime Intellect, con su entrenamiento alojado y el framework
verifiers. El entorno de entrenamiento replica el harness con el que el modelo se despliega en producción. - Entrenamiento: 100 pasos, lote de 256 y 8 rollouts (intentos) por ejemplo.
- Evaluación: cada 20 pasos, con 128 ejemplos reservados, y evaluando el modelo base junto al entrenado.
- Sin modo de pensamiento: lo desactivaron para que la comparación fuera la del escenario de baja latencia que les importa en producción.
Si quieres ver qué piezas tiene un entorno de este tipo y cómo las resuelve cada framework (entre ellos Verifiers, el de Prime Intellect), lo conté en el post sobre entornos de RL para LLM.
Libros sintéticos y 14 tipos de tarea
Cada tarea es un libro de empresa sintético, una pregunta en lenguaje natural y una respuesta verdadera. Los libros imitan flujos reales de finanzas: consolidación de ingresos, conciliación de facturas, análisis de gasto, búsquedas filtradas por fecha y agregaciones que cruzan varias tablas.
Los datos sintéticos les permiten generar muchas variaciones del mismo problema, controlar la respuesta con exactitud y cambiar la redacción sin cambiar la habilidad que se entrena. Definieron 14 tipos de tarea en tres familias:
| Familia | Tipos de tarea |
|---|---|
| Ingresos (4) | net_revenue, variance_vs_target, top_order_contribution, counterfactual_fx |
| Conciliación (6) | invoice_balance, customer_balance, overdue_invoices, last_payment_date, is_invoice_fully_reconciled, invoice_location |
| Operaciones (4) | spend_month_total, budget_vs_actual, shared_vendor_uuid, netted_amount_2026 |
De cada tarea generaron tres variantes con redacción distinta (una petición para un informe a inversores, un seguimiento de cobros, una pregunta para un modelo de financiación), para que el modelo no se aprenda una plantilla. Las de conciliación varían además por cómo se describe la factura, así que su espacio de preguntas es mayor que tres por tipo. Un ejemplo del artículo:
I am tightening our investor memo. What cumulative net recognized revenue did South land across 2025-03 to 2025-05, in USD cents?
Ese libro tiene once hojas: Orders, OrderLines, Shipments, Returns, OrderMonthNet, FxExposure, Contracts, FXRates, Targets, HiringPlan y CapTable. Las dos últimas no pintan nada en la pregunta, y no es casualidad.
Los lotes se montan por turnos equilibrados: cada pasada baraja el conjunto y emite los 14 tipos antes de repetir ninguno, de modo que todos se entrenan por igual. Y el mundo sintético es coherente por dentro: clientes, proveedores, productos, niveles de contrato y métodos de pago salen de vocabularios fijos, a lo largo de miles de libros generados.
Las trampas
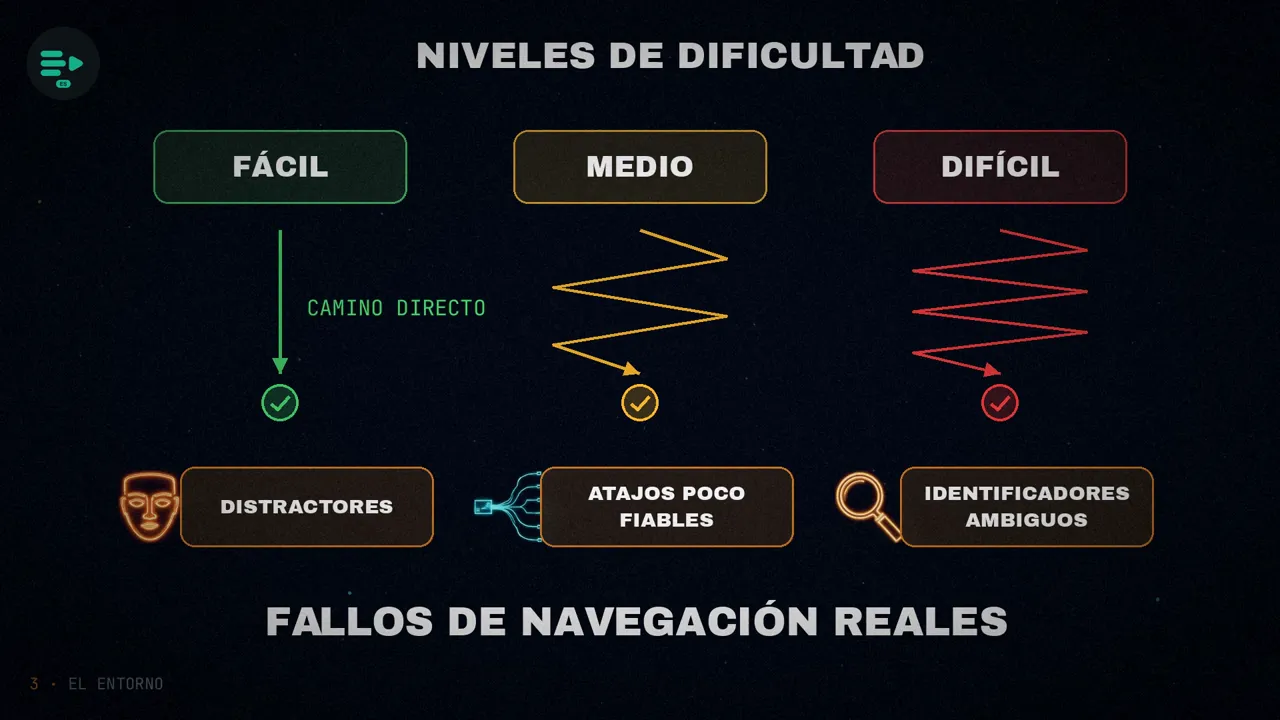
La dificultad regula cuánta presión de navegación sufre el modelo. Las tareas fáciles suelen dejar un camino directo a la respuesta. Las medias y difíciles lo complican de tres maneras:
Hojas como HiringPlan o CapTable, con reclutadores, vacantes y reservas de opciones. Suenan a finanzas, pero no contienen nada que sirva para la pregunta. Quien lee sin criterio se gasta en ellas el presupuesto de turnos.
Hojas de resumen como RegionalPnL o SpendSummary a las que les faltan justo las columnas calculadas que darían la respuesta. Parecen un atajo, pero hay que verificar o agregar desde los datos de origen. En difícil, desaparecen.
En torno al 15-20 % de las tareas de conciliación, la pregunta no cita la factura por su código INV-####, sino por pistas del pago (sistema, método, fecha, importe) o por una firma (cliente, mes, importe, vencimiento). Antes de responder hay que resolver a qué factura se refiere.
Tres herramientas y quince turnos
El modelo tiene tres herramientas y un presupuesto de 15 turnos:
get_workbook_metadatadevuelve los nombres de las hojas, el color de las pestañas y el rango usado aproximado.read_rangesdevuelve los datos de las celdas, con un tope de 1.000 celdas por llamada. Las peticiones más grandes se rechazan.run_pythonejecuta Python aislado, solo con la biblioteca estándar. El estado se conserva entre llamadas dentro de un mismo intento.
Que sean tan pocas es deliberado: con solo tres herramientas, a la recompensa le resulta más fácil distinguir una trayectoria eficiente de una que malgasta turnos.
La recompensa
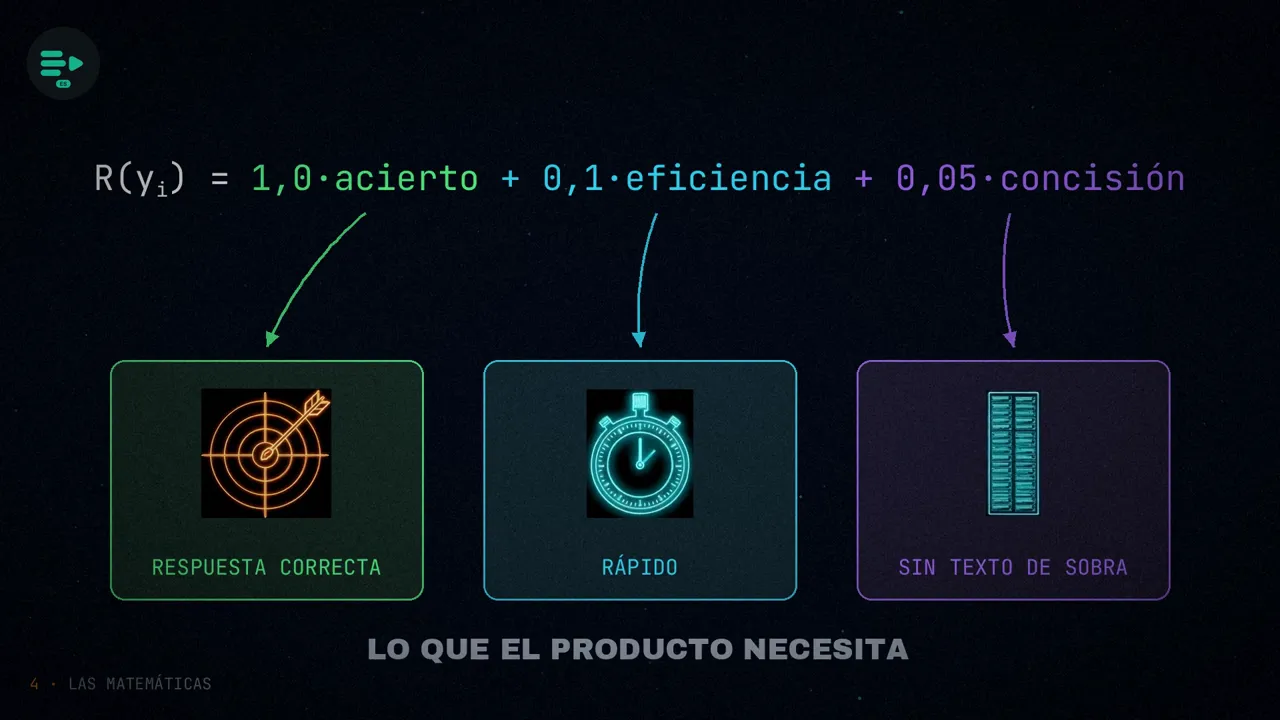
Para cada pregunta, el modelo genera ocho trayectorias. Una trayectoria es la traza completa: las llamadas a herramientas, las lecturas, el Python ejecutado y la respuesta final. El verificador puntúa cada una con una función que cabe en una línea:
R(y) = 1,0 · correct(y) + 0,1 · efficiency(y) + 0,05 · concise(y)La recompensa copia lo que Fast Ask necesita en producción: dar la respuesta correcta, darla rápido y no meter texto de más en el contexto del agente principal.
- Acertar manda. El término de 1,0 solo se activa si la línea final
ANSWER:se puede analizar con el tipo esperado y coincide exactamente con la solución. - Eficiencia y concisión son matices. No pueden salvar una respuesta equivocada, pero ordenan las correctas: acertar en cinco turnos puntúa algo más que acertar después de pasear por hojas irrelevantes.
GRPO: la ventaja frente al grupo
Entrenaron con GRPO, un método de gradiente de política que estima la ventaja a partir de grupos de intentos generados para la misma pregunta. En lugar de entrenar un modelo de valor aparte, compara la recompensa de cada intento con la de sus compañeros de grupo. Con G = 8 intentos, la ventaja del intento i se puede escribir así:
A_i = R(y_i) − (1/G) · Σ_k R(y_k)Es decir, tu ventaja es tu nota menos la media del grupo. Para una misma pregunta, un intento acierta en cinco turnos y otro se gasta el presupuesto en pestañas señuelo y falla: esa diferencia es la señal de aprendizaje. Dejando a un lado la corrección fuera de política, la actualización tiene esta forma:
∇J(θ) ≈ Σ_i Σ_t A_i · ∇ log π_θ(y_i,t | x, y_i,<t)Cada token de una trayectoria se refuerza o se apaga según la ventaja de la trayectoria entera. Esto es lo que hace que el refuerzo encaje con los agentes que usan herramientas: nadie etiqueta cuál era la siguiente llamada correcta, solo se puntúa el resultado final. Las matemáticas empujan la probabilidad hacia lo que hizo que la respuesta fuera correcta: leer primero los metadatos, esquivar las pestañas señuelo, usar los resúmenes cuando valen, volver a las filas de origen cuando no, y emitir una línea ANSWER: que se pueda analizar.
Es el mismo algoritmo con el que se entrenó a NapMem para navegar su memoria.
Asíncrono y fuera de política
En Fast Ask, un intento es una trayectoria de varios turnos: mirar los metadatos, leer rangos, ejecutar Python y responder. Generar esos intentos es mucho más lento que cargar datos en un afinado supervisado normal. Si el entrenamiento tuviera que parar tras cada actualización a esperar trayectorias recién hechas, las GPU pasarían mucho tiempo paradas.
La pila prime-rl de Prime Intellect lo resuelve con entrenamiento asíncrono y fuera de política: los generadores de intentos siguen produciendo trayectorias mientras el entrenador actualiza el modelo. Algunas trayectorias vienen de una versión algo más antigua de la política, y el objetivo corrige ese desfase, que está acotado, con pesos de importancia:
ρ_t(θ) = π_θ(y_t | x, y_<t) / π_gen(y_t | x, y_<t)La razón ρ responde a una pregunta sencilla: ¿cuánto más o menos probable es que el modelo actual produzca este token, comparado con el modelo que lo generó? Para que las actualizaciones sean estables, Prime Intellect usa un objetivo ponderado por importancia y recortado, al estilo de AIPO:
J(θ) = Σ_i,t min( ρ_i,t(θ) · A_i , clip(ρ_i,t(θ), 1 − ε, 1 + ε) · A_i )El recorte limita cuánto puede pesar un token cuya probabilidad ha cambiado mucho desde que se generó, de forma que una trayectoria vieja no tire del modelo más de la cuenta.
Resultados
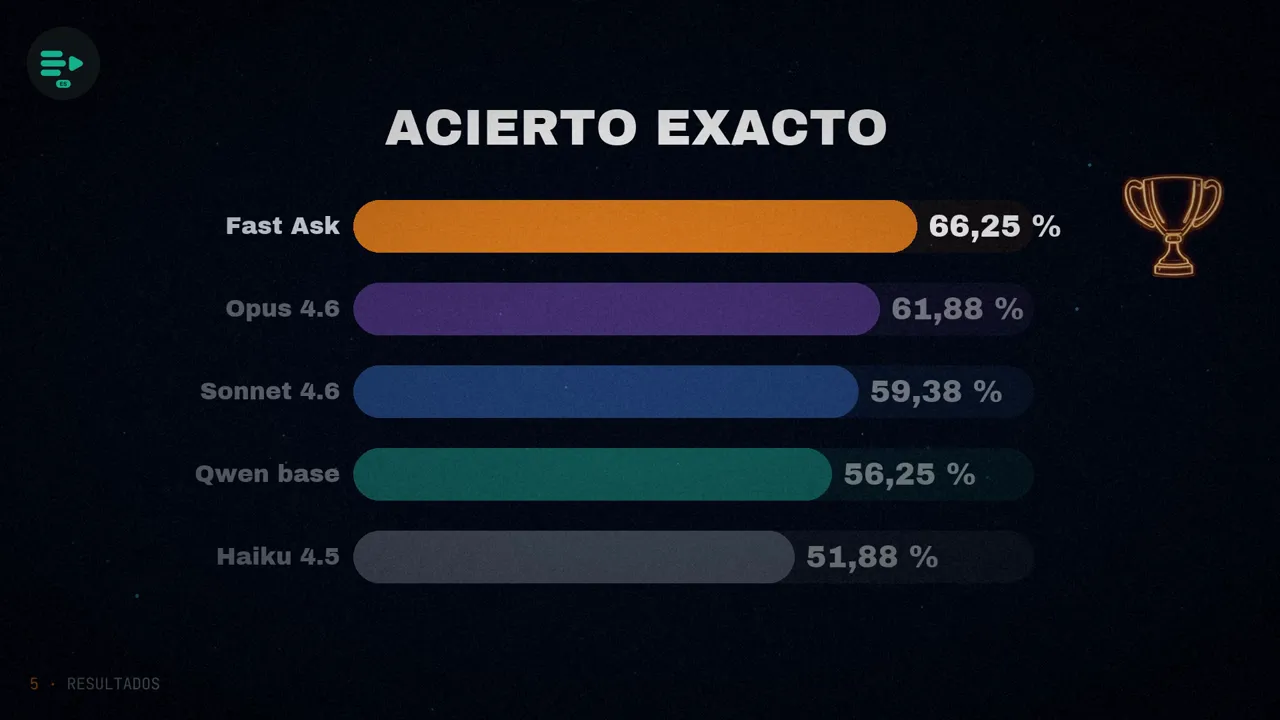
Evaluaron el modelo base y el entrenado junto a la familia Claude, con tareas reservadas. Las métricas son el acierto exacto y el tiempo real por intento, relativo al de Haiku 4.5:
| Modelo | Acierto exacto | Tiempo frente a Haiku 4.5 |
|---|---|---|
| Fast Ask (Qwen entrenado) | 66,25 % | 1,05× |
| Claude Opus 4.6 | 61,88 % | 1,44× |
| Claude Sonnet 4.6 | 59,38 % | 1,60× |
| Qwen3.5-35B-A3B base | 56,25 % | 1,34× |
| Claude Haiku 4.5 | 51,88 % | 1,00× |
- Diez puntos sobre el modelo base (de 56,25 % a 66,25 %), y además tardando menos: de 1,34× a 1,05×.
- Algo más de cuatro puntos sobre Opus 4.6 (66,25 − 61,88 = 4,37), con un tiempo muy cercano al de Haiku 4.5.
- El entrenamiento duró unas 26 horas para los 100 pasos.
Qué aprendió el modelo
Según los autores, casi toda la mejora vino de dos cosas: el modelo aprendió a dar respuestas con el formato exacto, que se pueden analizar, y a planificar trayectorias más ajustadas, que pierden menos turnos.
Y hay un dato que me parece lo más fino del artículo: el total de celdas leídas por intento se mantuvo más o menos plano durante todo el entrenamiento (en su gráfica, en torno a 2.400). El modelo no aprendió a leer menos; aprendió a repartir mejor sus lecturas. En la misma figura, las celdas por turno suben, de unas 200 a unas 350, mientras el total no se mueve: lee lo mismo en menos viajes. Eso último lo saco yo de la gráfica; el texto solo habla del total.
Lo que no cuadra y lo que no se puede concluir
Al contrastar el texto con las figuras del propio artículo, hay dos detalles que no casan:
- La curva de recompensa. El texto dice que la recompensa subió de unos 0,2 a unos 0,8 en los primeros 40 pasos y después se estabilizó. En la gráfica animada que acompaña al artículo, la curva empieza cerca de 0,5, baja hacia 0,3 y sube poco a poco hasta rondar 0,8 cerca del paso 100. Coinciden en dónde acaba, no en el camino.
- El tamaño de la evaluación. El artículo habla de 128 ejemplos reservados para las evaluaciones intermedias. Pero los porcentajes de la tabla final son múltiplos exactos de 1/160 (106, 99, 95, 90 y 83 aciertos de 160) y no lo son de 1/128. Así que la tabla parece salir de otro conjunto, de 160 ejemplos, que el artículo no describe. Es una deducción mía, no un dato de los autores.
Ninguna de las dos cambia la conclusión, pero conviene leer las cifras con sus límites:
- No es «Qwen gana a Opus» en general. Es una tarea de recuperación concreta, en la evaluación de los autores, con tareas sintéticas del mismo entorno y sin modo de pensamiento.
- No se sabe si vale igual para hojas reales. El artículo no da resultados con libros de clientes.
- El coste no está cuantificado. Dicen que es «una fracción del coste y la latencia» de un modelo frontera, sin dar la cifra del coste.
- La velocidad es «aproximadamente» la de Haiku: 1,05×, no 1,00×.
En resumen
El post-entrenamiento con refuerzo funcionó aquí porque el entorno hizo que buscar en una hoja de cálculo fuera medible y repetible: decisiones repetidas con un resultado claro, sin trayectorias etiquetadas por humanos ni un LLM de juez. Los autores insisten en que el trabajo importante no estuvo en la arquitectura ni en el tamaño del modelo, sino en el diseño del entorno: las tareas adecuadas, una interfaz mínima de herramientas y una recompensa pegada a cómo funciona el producto en producción.
Y lo plantean como un patrón que piensan repetir: entrenar subagentes pequeños y verificables para cuellos de botella estrechos, y dejar que los modelos frontera gasten sus tokens en juzgar, no en buscar.
Si una tarea es estrecha, se repite mucho, la latencia importa y la respuesta se puede verificar, un modelo pequeño entrenado en un buen entorno puede hacerla mejor que uno grande.
¿Qué cuello de botella de tu agente cumple las cuatro?
Fuentes
- «Building Fast & Accurate Agents with Prime-RL Post Training», de Ramp Labs, con Ben Geist y Will Brown, 7 de mayo de 2026.
- Sobre entornos y refuerzo en este blog: entornos de RL para LLM y NapMem, otro agente entrenado con GRPO.
- El vídeo, en mis canales: español e inglés.